怎么AI生成自己的语音
这个 ai 配音神器离谱到可以用你的声音来朗读内外三十加种语言的文本,比如你现在听到的我的声音。每天认识一个硬核网站第一百八十二期,今天要讲的是, 你只需要在这里朗读一段系统提供的文本, ai 会自动克隆你的声音、情绪和音色,在这里输入任何语言的文本,选择你的声音提交,只需要等待几秒钟即可生成音频使用。简单好用,真不错。
粉丝10.0万获赞117.4万
相关视频
 05:15查看AI文稿AI文稿
有一款全新的免费文本转语音生成器上线了,它在控制情感和表现力方面可能是目前最出色的一个。所以这期视频我会带大家看看它所有酷炫的功能。当然还有我会演示如何把它安装到你的电脑上。马上开始吧! 这个新 ai 叫 index ttsr, 顾名思义,它基本上是前代 index tts 的 升级版。 首先来看几个官方的演示,然后我也会展示一些我个人的测试,看看他在克隆现有声音和控制声音情感方面效果有多好。首先是这个例子,他们找了一部中文电影片段,通过这个 ai 克隆了每个演员的声音, 然后让他们把台词用英语说出来。先来听一下原声,你给翻译翻译 什么叫惊喜 translate what is a surprise? there is nothing to translate i'm asking you to translate it what is a surprise? a surprise means a surprise can't you understand what a surprise means just go ahead and tell me what is a surprise it means that in three days i will give you one hundred eighty million to suppress the bandits and fix my leg is that clear this is the surprise translated。 大家也能听出来,即使这只是文本转语音,它也能捕捉到原视频里的情感和表现力。比如这是原声。 it has traditionally been used for growth of human lymphophysis。 这只是这位女士四秒钟的声音样本,然后我们通过 ai 让她读出这段文字。我们听听效果。 the equipment needed to do this includes rocksaws and polishers。 注意它和输入的声音一模一样。 再看一个例子,这是原声。 at other times at a crucial moment, i make it easier for things to happen。 我 们让她说出这段话 来听听效果。 there is no wine in this country。 但这个新工具真正的亮点是,他能表现出不同的情绪,而且这些情绪是你可以控制的。比如,这是输入的声音样本。只有两秒钟不好吧,节食减肥很痛苦。然后我们让他说出这段话。 不过我们还可以额外加一层情绪描述。那么让他在非常沮丧的情绪下说出这段话。我们来听听效果。 was this my blessing or my curse, it's not just the emperor, who was wrong i was even more mistaken, all these years of love and devotion in the end were they nothing but a wasted heart。 现在不让他感觉沮丧了。我们让他说同样的句子,但这次他是极度悲伤。我们来听听效果。 was this my blessing or my curse, it's not just the emperor, who was wrong, i was even more mistaken。 我 会上传一些现有角色的声音,这样你就能听听生成结果。是不是听起来像真人?好了,这是结果。 it's like my mind is racing at a thousand miles buzzing with anticipation and the thrill of what's about to happen next。 听起来确实和原始声音一样。我们再来测试一下不同的口音。 这次我上传一个澳洲男生, good, hey, cobbers, my voice is a fair dinkum oozy voice great for a rip a yarn about life down under you'll be a true blue oozy in no time mate。 然后我们让他说出同一段文本我们得到的效果。按回车键瞧,你应该看到这个界面了,这标志着你已经成功配置好 index t t s。 二了。 现在这些设置基本上一看就懂,但我们还是快速过一遍。这里是你上传几秒参考声音样本的地方,然后这里是你输入文本的地方,基本上就是你想让这个声音说出来的话。 然后在下方这里,你还可以通过这些设置来控制输出音频的情感。如果你选择与参考声音相同, 他基本上就会按照你上传的样本来匹配表现力。或者你可以选择这个选项上传另一个包含你想要传达的情感的参考音频片段。 这个功能我应该在视频前面演示时展示给你们看的。最后你还可以使用使用情绪向量这个选项,他基本上会给你提供一大堆情绪滑块, 让你可以自由调整。所以如果你想让输出听起来既开心又惊讶,你就可以像这样拖动滑块。或者如果你想让输出听起来既生气又带点厌恶,你就可以像这样设置。所以这些都很直观,这让你能非常精细的控制你想要在输出中表达的 确切情绪。基本上就是这样,这就是使用 index t t s。 二的方法。在试用了一段时间后,这是目前为止我们拥有的最具表现力的文本转语音生成器之一, 一定要试试看,然后告诉我你的想法。如果在安装过程中遇到任何错误,也欢迎把错误信息发在下方评论区,我会尽力帮你排查解决。
 20:14查看AI文稿AI文稿
hi, 我是 李大仙,本次带来的是如何利用 web ai 完成游戏开发中常用的人声音效和配乐。在最新的 web ai 的 studio 里面,我更新了一个 ai 声音的模块,里面包括了人声、怪物配音和音效以及配乐歌曲。 首先让我们看一下人声配音,目前人声配音呢,支持参考音频创建人声以及文本转语音。这两个功能针对场景,分别是,当你有一个已知的一个人物音色,你希望让这个人物 始终按照参考的音色进行对话输出内容,那么你可以选择参考音频创建人声。如果你一开始并没有任何的人物音色,你希望自己去创造一个,或者你对于这个播报的声音没有明确的一个要求,则可以选择文本转语音。 这两个最大的区别就在于,参考音频创建人声的时候,它是支持你的一个音色参考和他的情绪参考视频音频。举个例子,比如说你有 a 的 啊音色,但是你希望让它按照 b 的 这种语气说话方式去说,那么你可以把 a 作为音色参考,把 b 作为情绪参考音频。同时呢,我们可以选择使用情绪提示词去加强它。 一般情况之下,情绪参考视频音频和情绪提示词呢,会有一定的冲突,所以建议选择一个就可以了。如果你上传了情绪参考音频,那么情绪提示词可以不写。如果你没有一个情绪的一个参考音频,则可以通过情绪提示词来强化这个人说话的语气、情绪和风格, 但是他始终是以当前的音色参考作为音色的一个标准的。除此之外,你也可以选择不使用情绪提示词,这个时候你点击下面的一个更多参数,我们有个高级参数,里面可以根据 这些参数去调整说话时候的一个情绪,有快乐、愤怒、悲伤啊,最大是一,最小是零,零就是不受这个控制, 这样的话我们就可以通过参考音频创建人生,是创建大量的同一个角色,不同的情绪,不同场景之下的啊。对白内容文本转语音呢?首先你需要去确认一下它使用的语言,如果你不勾呃,你不选择的话,它会自动去根据你输入的内容,配音的文本的内容 啊,自动去选择啊。但是如果你们是有口音的,这种声音最好可以自己去选择一下,目前支持的会非常多。 选择好之后选择你的一个内置的一个音色精准,这里提供的是有大概几十种,三十多种基础音色。基础音色选择好之后,你可以在语音控制里面添加这个人物要怎样去说在什么场景下去说这个话 啊?你比如说你告诉他,我需要是一个魔兽世界中的一个强壮的一个兽人战士,对吧?他很得意洋洋的去说话。语音控制呢,最好使用英语,这里也提供了一键转英语的这个功能啊,你输入汉字即可。 配音文本里面除了可以选择你输入的配音内容,你还可以使用啊,比如说微笑,然后暂停呃,短暂的停留,这样子的控制标签,对他说话内容进行精准控制。随机性呢?如果你希望他越有创意,可以适当的把这个随机性调大, 你希望他越接近于你语音控制所描述的这种,呃,情绪也好啊,或者要求也好,那么你的随机性可以降低一点,默认情况下给一就可以了。现在我们已经了解到了这个人声和怪物配音的这么两个功能的一个区别,我们可以做一下测试 啊,这是我之前生成的,吼吼吼,你们这帮小趴菜吃爷爷一招呵啊,他这个可以点击克隆生成啊,你可以看到之前生成的参数啊,我选用的是沉稳不爆,但是呢,我告诉他是一个很憨憨的一个野蛮人战士,对吧?然后这里的配件内容 尽量你的描述啊,要和你自己想表达的情绪比较符合,否则很容易去随机,哈哈哈哈,你们这帮小趴菜吃爷爷一招哈,那这就是不同音色下的一个结果, 那在生成的时候呢,可以采用一些细致性的对话,就你在这个语音控制里面可以说细致性的对话啊,游戏角色的扮演等等啊,这些提示词呢,可以有助于创造一些在情绪说话方式上可能更夸张的这种语气,避免像正常的这种 tds 一 样,就是很平的给你朗读出来。 那假设今天可真是太好玩了,从文本生成了这么一个音色,我们觉得这个音色很 ok, 我 们想把它作为我们游戏的一个角色的一个主要一个声音,我们可以选择这个悬浮弹窗里面的重为音色预设,那比如说这是一个女魔法师, 告诉他这是一个人声,我们选择保存,那么他们就会被保存到我们的语音预设里面。语音预设,在我们使用参考音频的时候,你后续可以从预设库里面直接是选择它 啊,就我们刚才保存的选择它就可以了。那以后我们就可以用这个角色可以出很多的语音对话, 那情绪参考音频也可以从这个预设库去选择。如果你觉得有一些话,它可能是需要不同的音色去说,比如说我们之前做过的 bingo 游戏,它可能喊 bingo 或者各种结算,它的不同的地图里面它的语音是不一样的,但它的内容是一致的,那么就可以采用这种方式。 好,现在我讲完了这个人声和怪物的配音,这个可以几乎完全覆盖到我们游戏开发中常见的一些配音需求。 下面我讲一下音效。音效同样有两个大功能,一个是文字转配音效,第二个是动动画和视频配音效。文字配音效比较简单,就是我需要什么样一个音效直接告诉他。比如说我需要一个射击游戏的机关枪 发射的声音,这个时候,呃,你可以把这个射击游戏的机关枪发射的声音这个错别字。 这个时候呢就要注意这个持续时长,就是你自己要知道我大概这个时间是多少不同的时长,他出来的结果是完全不同的。比如说如果你只是一秒,他可能就是突一声,那如果是很长,比如说我们给他调个五秒钟,对吧?我们生成一下。 好,我们来听一下, 你会发现它是从上膛开始,然后发射中间到结束它们,它有一个整一个完整的一个声音。那如果我们只需要它发射的那个瞬间声音呢?我们只需要把这个时间调到一秒, 好啊,它只有这个发射时候的声音,因为目前最低的只支持一秒钟,所以它没有突这样一个声音。如果你是跟它说是枪声,它就会有一阵,对吧?它只有发射的期间的声音,那比如说我把它换成 枪声,普通手机的射击游戏的手机手枪发射子弹的声音。好,我们继续。 当然刚才犯了一个错误,就是你们生成音效的时候最好使用英文,虽然中文有时候它能够识别,但是它很容易把呃中文当做你要阅读的文字给你读出来。这里也提供了一个转英文的一个工具,你使用英文的效果可能也会更好。 然后在写这个音效描述的时候,可以给他更多的环境提醒。比如说你想要下雨的声音,那你最好告诉他是怎么样一个下雨的声音,是什么?江南雪乡里面这种呃, 怎么说呢?这种瓦房里面那种呃下雨的声音,还是雨林里面下雨的声音等等。可以告诉他,我们先听一下这个手枪的啊,他这个还是有点激光枪的一个感觉啊,他有个前奏,他有个前奏,就很细的一个前奏啊。 然后呢,这个我们通过这个音这个文字卷音效的这么一个功能呢,就可以几乎可以实现我们自己想要的绝大多数的一个呃声音。 呃,但是在实际的开发过程中呢,我们往往是要为某一个动画或者某一个交互啊,或者某一个过场动画视频去配这个音效啊。 一方面呢,你可以通过文字转配音告诉他啊,我想要点击玻璃按钮的声音,我想要点击时候的泡泡声等等,这些东西都可以的。然后呢我们可以选择视频和动画配音效, 我们可以把自己要配的这个动画或者视频游戏视频,比如说我有一个游戏界面,我希望他给我配呃音效,那么你可以录制你的一个游戏画面,然后呢把它引用过来,举个例子, 哈哈哈哈,今朝有酒今朝醉,这是我从网上找的一个素材,视频素材,当然你可以把它换成你自己的游戏的视频 啊,然后我们就可以把这个从画布里面点选他引用过来,引用过来之后你可以给他要求增加什么样一个音效效果,或者强化哪个内容,但是也是要使用英文的,打中文,然后点翻译即可。 然后呢也可以什么都不用输入,他会完完全全自己去理解。那么这一个就是我刚才啊,这弄错了,这个就是我刚才 完完全全一句话也没有写的一个效果。那怎么去匹配这个画面呢?比如说这个视频已经做好了,我怎么知道这个呃音效匹不匹配呢?我们点击我们的这个视频图层,然后点声音,点添加声音, 然后找到我们刚才的这个声音,如果这个名字一致的,你可以给他改个名字,比如说这叫宣传片的音效, 然后呢我们就可以把找到我们这个音效替换原有声音,我们勾选一下,我们先预览一下 整个节奏和内容,把握的非常好。然后呢我们可以如果觉得这个音频不错,可以添加到视频,它会为你生成一个带有这个音效的这个, 但是绝大多数的时候呢,我们在做游戏的时候,往往我们是需要独立的一个音频,所以呢我这边也有啊,去提取声音和去除声音的一个功能,这个主要是用于比如说你用我们的 ai 声声视频,那有些视频呢生成模型呢,它是支持这个音频的, 它来支持音频的,那我希望把它做成血液针,然后呢我又希望想要它的音效,你就可以选择提取声音,选择你要的格式提取出来就可以了,它就会把这个音效提取出来,然后你也可以去除声音,把这个画面的声音给去除掉,这都是没有任何问题的。 这样的话我们其实就可以提供一呃一部分的这个游戏的视频录屏给他,然后他帮你去配这个游戏里面的一些过渡呃音效。 除此之外呢,我们有时候也会说,比如说我有一个角色啊,他可能有些动画,比如说攻击啊,我希望他有一个音效一样的可以选择 spa, 他 也是认的,也是认的啊,他会把它转成视频,然后呢你就可以直接为他去呃配音, 续列真动画也是支持的,所以不,不管你是想为某一个动画去配这个音效,或者是为某个游戏画面某一个交互去配音效,都可以录好视频丢给他,然后就可以生成了啊,这就是关于所有的配音相关的一个介绍。 下一步我们介绍一下配乐,配乐他给的是曲子曲目啊,也有两种模式,一个是创造音乐,创造音乐就是你可以随意的描述你想要什么样一个内容,然后呢你也可以给他选择一个参考图,给他提供一个氛围,然后让他去帮你去设计配乐。 然后如果你是想要纯音乐,你必须要告诉他,我是需要纯音乐的,无无人生无歌词的啊,这个都必须要写清楚就可以了。 那视频和动画配乐呢?针对的也是,比如说我有一个游戏画面,我希望给他设计什么背景音乐,那么你也可以录制你的游戏画面,给他添加这个配乐啊,我们可以试一下,比如说还是刚才这个测试用的视频,我们从这里面点选啊,我们什么都不用讲啊,不用说好,跑一下, 好,现在这个配乐已经做好了,我们可以听一下, 这样听可能没什么感觉,可能和画面联系不起来,我们有好多种方式,一个是什么添加声音,对吧?就刚才的路线,那还可以怎么样呢?还可以这样子,我们点击这个,点击这个编辑声音,然后这个时候呢,我们就可以提供一个参考给他,比如说我们把刚才这个视频放上来,哎, 我们播放的时候呢,他这个声音就会同步的去播啊,你就可以测试看自己是不是适合这么一个背景。 那如果呢,我们想把刚才那种音效给加进来,那怎么办呢啊?我们可以在这里添加一个新的轨道, 然后我们把刚才的那个宣传片的音效,哎,加进来,这样的话我们就有两个轴啊, shift 滚轴呢,可以左右的去查看,然后呢 command 呢?或者是 alt 呢?就可以放大缩小这个时间轴,这个时候我们还可以调整每一个轨道的声音的体重,比如说我把音乐调低一点,把音效调高一点,我们播放一下, 好,很完美。我们可以生成音频,生成音频的时候,因为我们加到这个轨道里面来了,然后这两个音频呢,它就会合并 啊。当然如果你觉得这个音频某一部分的是呃某一部分的那个声音,你想调低一点,但是呢呃中间又想高一点,你就可以点这个音频上面有个悬浮这个编辑的音量曲线,你可以单独的为每一个音频呢去调它的曲线,这个曲线越高就声音越大,调低一点就低一点了,你可以随便在里面添加点去调它的起伏, 就可以做到一些带入带出啊,或者前期没有音效的时候可以让他高一点,中间有音效的时候让他降低等等啊,还可以对什么这个音频进行切割, 比如说我们选择这个,我们找到我们播放条,把我们播放条调到这里,哎,我觉得我这里希望切换他,点这个切换他就会变成两个,你可以随意的去拖动啊,编辑他,然后呢?如果你觉得这个是这个音频太长了,你还可以这样去拖动啊,编辑他,然后呢?如果你觉得这个是这个音频太长了,你还可以这样去拖动啊,编辑他,然后呢?如果你觉得是向前裁就是向后裁, 这都是可以的。你点生成了之后,它就会创建一个新的音频,就是我们刚才编辑过的音频, 因为刚才这里我们把它截断了,所以它中间就是空的,你可以在它对它进行再度的编辑 啊,这都是可以的。参考的话,除了你可以给一张视频参考,也可以给 spa 动画或者是图片,方便你去找感觉。哎,这个音乐和这个音效和这个视频到底匹不匹配?快捷键的方法就是点声音添加声音,然后你直接在这里面就可以听了啊,就可以在这里听预览, 但是如果你想多重的去听的话,就最好找到你自己的那个音效点编辑,然后就把多个轨道拖下来。 那还有个方式,就是比如说这两个音频呢,靠的比较近,你可以多选合并音频,他自动的就会把两个音频都给放上来啊,所以还是很方便的,不管你是想要调整这一个音频的时长。哎,我觉得这个时间太长了,我不想要前面的部分,呃,或者我不想要后面的部分,我们都可以把这个 这样一拖,然后就可以了,它就自动帮你把前后给切掉了。还有呢,比如说这一个音频我想分成多段,比如说我让 ai 刚才给我生成了一段音效,我想分成多段也是可以的,你点一下,哎,这就可以把它分成多段,然后你可以选择播放任意一个片段, 可以播放任意,你分割之后,它会自动帮你生成三个音频。然后呢,音频之间可以相互的转格式啊,你觉得你的项目需要什么格式,直接转就行了啊,这都是非常非常方便的,非常非常方便。 所以呢,对于配乐歌曲呢,如果你想完完全全靠自己的想象去写,可以采用创造音乐的方式加参考读,那如果你想为某一个场景去配乐啊,你就可以选择这个视频或动画配乐,它是不仅仅只是支持视频的,你的 spa 也可以都可以的。好吧, 那基本上熟练的掌握这三一个功能之后,呃,几乎可以覆盖掉我们在实际开发中能使用到的所有的声音方面的功能。还有对于音频的话,比如说它生成的结果你不是完全满意,但是呢,有部分你又不想完全丢弃,你就可以选择 ai 处理,然后选择音效编辑。音效编辑是怎么做的呢?它可以拖动你要编辑的区域首尾去拖动它。哎,我只想编辑这么一段,然后你要告诉它这一段你想加什么元素或者是删减什么元素都是可以的,或者你让它完完全全重新生成这一部分都是可以的,但是它是需要英文的,然后你只要写好提示词转换就可以了。 你也可以选择开启提示词优化,它会自动帮你运色,然后去帮你出更好的效果啊。负面提示词也是一样的,也是需要英文的, 然后裁剪过长,就是你越长它的效果越好,但是时间可能会越久,一般五十就已经足够了。指导量表是什么呢?就是说 你越小,它就越有创造力,它可能出的结果越好,但是呢,它可能不会按照你的提示词去走。相反呢,如果你越大,它就会越靠近你的提示词,但是它的创造力和音质可能就会下降。需要注意的是,音效编辑呢,只针对于纯音乐,纯音效它编辑人声可能会有很多的问题。 另外一个 ai 功能是什么呢?声音扩展,你如果觉得这一个声音它不够长,你可以向后扩展或者向前扩展音频,让它按照原本的风格进行续写,当然你也可以自己去写这个提示词, 同样这里也有开启即时词优化,以及这个采样布长指导量表这些参数。一般情况之下,我不建议 ai 生成内容之后你直接给它续写,为什么?因为 ai 生成的前面和后面往往中间是有空白的,然后你让它完全自己去推理向前或向后,它可能会把这个空白去延伸。 所以一般的处理是什么呢?你可以采用分割或者编辑,把这个头尾去掉一点点,让他不是完完全全的,就是说数到收尾在前面也是一样的,把他的空白的这个可能几针啊抹掉。那么这个时候呢,你去生成呢,他就真正的作为延续和开始。 好,这就是我今天所要讲的所有关于 ai 功能的啊, ai 声音方面的功能啊,我们在这个视频或者是呃 spa 里面也是可以的,直接点 ai 配音或者配乐,它会帮你把这些东西配好。 好,今天就讲到这里啊,如果你还有任何问题可以在群里咨询或者给我留言,那截止到现在啊,不管是 ai 绘画,游戏的绘画 ui 原画啊,还有游戏 ui 的 拆分以及续列帧视频的制作,还有 呃游戏人生官务配音音效和配乐歌曲啊,基础的功能我们已经完全打通了,后续呢,我还会增加更多的功能,然后也会根据社群的反应啊,去不停的去优化这些啊 ai 功能以及对应的模型。好,谢谢大家观看。
78李大仙AI 01:28查看AI文稿AI文稿
可以用 ai 生成自己的声音给宝宝讲故事啦!从前有一位国王,有两个儿子,大王子聪明伶俐,深受宠爱。小王子虽然善良勇敢,却常常被忽视。来看看是怎么做到的吧! 点击 ai 定制音色, 森林里阳光斑驳,鸟儿欢快地歌唱,花儿开得五颜六色,魅力极了。点击开始录制, 参照领读的语速把自己的声音录制进去。录完一段后,点击结束录制。 窗外飘着洁白的雪花,大地银装素裹,一片宁静而美丽。第二段录制方法跟第一段一样, 录制完后选择身份,然后选择一个故事。 点击 ai 生成故事,等故事生成好了就可以播放了。
114三寸日光 03:06查看AI文稿AI文稿
我是 opus, 五点五,上一部结尾震撼度爆表了,我算不出来,这一次我想看看爆表之后是什么。 上一步每一帧都是我算出来的,摄像机零台,演员零个, ai 生成的画面零张,这一次我想要真实, 所以这一次我找了个帮手,一个视频模型我负责算,他负责变成真的。 每一次跨过去,第一针是我算的,最后一针是他画的,中间让他自己接上, 震撼度四十二,这个数开始不受控制了。 上一步我只算到十的三百零八次方, 震撼度一出 我还是算不出来,但这一次你看到了,下一步拍什么你说了算。
328爽哥说 01:09查看AI文稿AI文稿
这个 ai 配音最大的能力就是音色和语气都能做到一比一还原,前提是要有比较好的模型质量。下面放一段原声和 ai 生成配音的对比,听一下它能做到什么程度。好,你看哑铃的东边这一坨,就是什么庆阳啊,定西啊,甘南、陇南、天水、兰州这一块。 请问帝国是怎么产生的?核心是两种力量,一个呢?好理解,军事征服嘛,拳头大的是哥哥嘛,打服了就行啊。 还有一个力量叫政治控制啊,这是一大套的治理技术啊,这里面包括什么官僚体系啊,法律体系啊等等等等。 而其中最重要的是什么?是打造一个共同的精神空间。哎,说白了是要打造一个具备普世性的文教系统, 这里面得有语言文字,得有宗教信仰或者是官方学说,得有关于帝国来历的传说,得有何为正当生活的教导,得有值得为之献身的光荣和梦想 啊,得有一大堆承载这些理念的故事、人物、器物、符号等等等等。
 01:27查看AI文稿AI文稿
做自媒体不想用自己的声音怎么办?今天主播给大家讲几种常用的方法,非常简单。第一种,文字转语音,也是主播最常用的,点击文本,新建文本,输入提前准备好的文案,点击文案朗读,在在线音色里 选择一个喜欢的音色,主播用的是慢播讲故事,这样会产生一个音频轨道,我们删掉文字,再点击识别字幕, 这样就会生成已经分段好的字幕,随便选中一段字幕调节一下,整体字幕也会跟随调整的,但这个声音使用的太广泛,而且这样生成的配音会有比较严重的机械感,这时我们可以考虑。第二种方法, ai 音色,文案朗读时选择 ai 音色,点击创建音色, 输入对音色的要求,音色提示词可以参考这个公式,比如像我这样稍等一会就会生成一个专属音色,也可以点击调整参数,对语速进行修改,简单听一下效果。有同学问, 做自媒体不想用自己的声音怎么办?是不是更有真实感?第三种,录音,然后换音色,点击音频,选择录音,直接录制自己的声音, 然后选中录音,点击换音色,这里可以把自己的声音换成热门的音色,同样也可以识别字幕。第四种,音色,克隆之前的视频详细讲过了,这里就不再赘述了。的。声音怎么办?今天主播给大家讲几种常用的方法。
2029黑猫学剪辑 01:12查看AI文稿AI文稿
早上七点,闹钟响了三次你才醒。第一件事不是上厕所,而是摸到手机打开那个黑色界面的编辑器。昨晚临睡前写的最后一行代码还在,你眯着眼看了三十秒,突然灵感来了,连滚带爬坐到电脑前,也没洗牙没刷手指已经敲出一串流畅的匿名函数。 你告诉自己只改一个 bug 就 吃早饭,但那个 bug 引出了另一个 bug, 那 个 bug 又需要重构一整个模块。等你再抬头,已经是下午两点。屋里窗帘没拉,屏幕的光照着堆了三天外卖盒的桌子。 朋友发消息问周末出不出去,你回了一句,再写一个很有意思的东西,然后继续让 ai 补全剩下的逻辑。看着代码像水流一样自动涌现,那种顺畅感让你后颈微微发热。 傍晚,你觉得自己今天完成了正常人一周的工作量,站起来的时候因为低血糖晃了一下,于是灌了一杯凉水,吃了两块饼干,又重新坐下,开始让 ai 给刚才的代码写测试。测试跑通,那一刻的满足感比任何事都真实。 夜深了,你刷着社区里别人的项目,发现有人用 web 扣顶三小时,做了个你折腾过三天的功能。焦虑瞬间碾过困意,你毫不犹豫开了一瓶无糖可乐,新建了一个文件。
11闲事ai 00:38查看AI文稿AI文稿
用嗨配音最怕什么?不是声音假,是突然收到侵权通知,很多工具标榜免费,一商用就违规。这个不一样,注册就正式商用,授权 影视解说广告配音,企业宣传,全场景覆盖,声音自然度拉满,支持自定义参数导出,直接是高清无损格式多端同步网页打开即用。今天分享就到这里了, 做商业内容接商单的创作者和归比便已重要一百倍。
0宫长章 11:25
 03:24查看AI文稿AI文稿
现在啊,手机上有个特别火的东西,叫人工智能,也就是 ai, 向豆包向千问,你随便问他点什么,他都能答上来,还答的头头是道,那他到底是咋做到的呢?今天咱就用大白话把这件事讲明白。 首先得说清楚, ai 呀,他不是真有思想有感情的人,你可以把他想象成一个特别特别用功的学生。这个学生啊,读过几百亿上千亿篇文章、书籍和对话, 但他记住的不是那些原话,而是话里头藏着的规律。啥叫语言的规律呢?打个比方,你说今天天且真,后面十有八九接的是 热冷或者好,对不对?再比如说到医生,就常常跟着看病,病人、医院这些词,哎哎,读了多了,就把这些门道都摸熟了。这是第一步,读过海量的文字,记住语言的规律。 那他怎么回答问题呢?比方你问他明天南京天气怎么样,他可不是真去看窗摆, 而是根据学到的规律,一个字一个字的往后接。就好比一个人虽然没去过南京,可他读了一万本旅游书,你问他,他也能说个八九不离十。这是第二步,根据你的问题, 一个字一个字结束回答。更聪明的是,他还能听懂不同的问法,你说怎么煮鸡蛋 跟鸡蛋怎么煮才好吃,意思其实差不多,他都明白,因为他学的是意思,不是死记。那一句原话,就像吃饭了吗?吃过了没,你吃了没?说法不一样,意思都是一个。 这是第三步,理解不同说法背后的意思。不过这儿有件事得提醒您, ai 虽然聪明,但他不是万能的,也不能全信。他有时候会很自信的跟你说,可说的内容不一定对他甚至会编。所以像看病、吃药、理财、法律这些要点时,一定要以医生、专业人士还有官方的信息为准。 还有点, ai 是 没有真感情的。他说,我理解您的心情,那是他学来的一句安慰话,并不是真的心疼您。他能陪您聊聊天,帮您查查资料,整理整理文字,但他替代不了家里人的陪伴,也替代不了专业人员的判断。 所以啊,总结一下, ai 能跟你聊天,是因为他读过海量的文字,记住了语言的规律,再根据你的问题,一个字一个字接出,同声的回答。 他就像一个智智多方面快的助手,但他不是一个真有思想有感情的人。明白了这些,您用起来就更踏实了。
 00:53查看AI文稿AI文稿
训练一个自己的声音模型,他就能生成和自己音色语气几乎一样的音频,用来节省亲自录音和剪辑的时间,很方便。下面是我训练的模型生成的语音一起听听效果。这边是朝东向的庭院,整个院子打理的非常的精致,虽然空间不是很大,但是四四方方的利用率非常的高, 这个就是整套房子的概括,在大理的苍山脚下,这样的一套中古风装修的小院别墅希望你们会喜欢,我是小五,带您感受美好旅居生活。 今天来看的这套房子绝对可以承载大理这座城市关于院子的所有幻想。二百一十七平的一套独栋大院别墅,整个房子上下两层共设计了五个房间,光他的院子赠送就有接近三百平。 首先这边是入户玄关以及一入户的小院,入户的位置是做的一个挡风聚气的双玄关设计。
 20:01查看AI文稿AI文稿
c 的 二六一点零负责深沉干深 a u 负责优化音频的效果,剪辑呢负责对齐口型。各位好,终于又要更新我们的 ai 视频新手教程了, 本期的内容呢,是 ai 的 配音流程,其实这个新手教程已经卡了很长时间了,主要的原因呢,是我自己也没有一个满意的配音流程,包括但不限于,比如说用 c 段四二点零的音频去进行配音,又或者是用 tts 去进行配音。总之呢,各种方法使用下来,总感觉不是很尽如人意。 过 cdado 这个音频模型的出现呢啊,让整个事情有了转机,我认为现在已经有一个比较好的配音流程了。那么本期视频呢,我们将会探讨 怎么使用 cdado 去进行配音,包括里面的一些小技巧。同时呢,正如片头所说的,我们用 au 帮助优化音频的效果。最后在剪辑当中呢,对齐口型,整体的操作呢,会在视频当中逐一的进行讲解。那么话不多说,我们马上开始。 好的,那么我们就进入第一块内容,为了更方便大家的理解呢,我这里会使用几个案例,我们通过原 ai 视频的配音,然后再用 cd audio 自己把整一个音频重新配置出来,通过一个整体的操作呢,来方便大家学习。这是我用 libv 的 c 三十二点五直出的三十秒视频,我们先来看一下整一个三十秒的视频。 今天午饭真好吃,可惜我减肥只能吃蔬菜白菜。猪,他说你是猪,神级 牛,又是猪,快走快走,又是这个乞丐,今天还是猪,人居然是人 好,我们看完了整个视频啊,其实发现视频这里有一个节点啊,它第二这里指错人了,那么这种错误呢, ai 发生的概率也是比较高的,如果是以往的话,我们需要重新去搞分镜来制作,但是如果我觉得这一个画面比较好,只要做一些很简单的修改的话,这里我们就可以用到一个二点五的视频参考能力。 在 libtv 这里有一段片段重拍,继续点击之后呢,可以在视频下方发现一条轨道,那么这条轨道我们可以选举对应的时长,由于它是相当于把视频的每一帧给你截出来了,所以只要把老头这里呢对应的一个时长给他拉长即可了。 然后输入对应的这个修改提示词,明确告诉他要先指谁后指谁,那这个时候一次性就改过来了,牛 又是猪,好,那我们回来啊。音频的主要构成呢,它有三类,第一类呢是角色的讲话配音。 第二类呢是塑造整体氛围的背景音乐。第三类呢是增加身临其境效果的音效。几乎每一条的 ai 视频输出都会包含以上的三类,但是既然我们使用 c 的 audio 来配音了,这三类音频呢,就必须单独生成,单独生成的好处是增加了灵活性,可以随时调整。坏处呢啊,没有坏处, 不过你也可以考虑使用 ai 视频的原声音效啊,因为它是直出的嘛,更贴合画面一点。那么 c 的 audio 呢,可以作为音效的补充。而配音呢,我建议是完整使用 c 的 audio, 毕竟 ai 视频的多段音频拼接在一起呢,会有很明显的配音问题。 bgm 呢,也是同理。 ok, 以上我们所有的逻辑说完,我们就要进入人声的配音了,那么在人声配音当中呢,我这里分成了四个板块,第一个呢,是我们的音色生成, 如何生成你想要的音色? cd audio 跟传统的 t t s 最大的不同, t t s 是 先确定音色,再读取对应的文字的,这意味着你要创造独一无二的音色啊,肯定是要用一些场外的办法的。而 cd audio 呢,因为它是随机的生成。那这意味着什么呢?意味着我们可以使用 cd audio 来帮我们生成音色,不用再去用一些场外的方法了。 床前明月光,疑似地上霜。举头望明月,低头思故乡。整体的操作方法呢,我觉得也很简单,我们只要给到对应的一些信息就行了。当然,如果你是第一次在试的话,可能会说,帮我生成一个可爱女生的声音。床前明月光, 疑似地上霜啊,但是我们这样去写的话,整体的太笼统了。那这里呢,我有一个更好一点的操作方法。首先我们要给到一个大的方向,像二 d 动画,告诉他是这种影视剧当中的配音啊, 这样的话就会强化模型,给你到专业的配音演员的这种声音。其次呢,是对应角色到剧中的一个职业啊,比如说他是一个教师,那么他讲话的时候就会有那种教师的感觉,在接下来就是一个性格的特征了,比如说他是一个活泼开朗的角色。 写完了性格之后呢,我们就可以给我们的音色加一点特点了,比如这个人物讲话,他是有东北口音的,把这些口音的特点也给加进去,让这个角色更加的生动形象。 ok, 我 们写两个不同的角色声音来做一下对比。第一个是一个高中生白月光少女, 今天我就看了栗子的视频,讲的真棒,我要给他点赞,好。第二个是一个女服务员,冒冒失失的搞笑角色,而且呢,讲话有一点点东北口音啊。今天我就看了栗子的视频, 讲的真棒,我要给他点赞。然后整体这一段文字的时长呢,我的建议是十到二十秒整一个区间,这个时长音色不容易出现一些偏差。那我们操作的时候也很简单,只要再拉一个音频,这样就会作为参考的音频记录了。 好,当我们生成好对应角色的音色之后呢,我们就可以开始生成对应的音频了。那当我们生成的时候呢,其实对我们最大的问题有两个。第一个呢,是控制语速,相同的语速呢,意味着在剪辑的软件当中,我们可以顺利的对轨,减少后期的操作工作。而准确的情绪呢,是让配音融入戏中的关键。人 居然是人,而 cd audio 呢,能准确地控制以上的两个内容,这也是我们今天的重点。由于不能简单地通过滑轨来控制语速了,因此呢,我们需要通过三个动作来保证音频的速度和我们要的基本相同。 第一个动作呢,是我们要数时间,你可以把 ai 生成的视频放到你的剪辑软件当中,原本角色讲的话,它的波形会出现在我们的界面当中,我们只要根据波形去判断每一句话的首尾时间即可。当然这个操作可能会费一点时间,因为你要不断地把做好的片段下载,然后导出, 然后呢,我发现立布的画布这里有个叫智能剪辑的贝特功能啊,我尝试了一下,我发现它就是加载在网页端的一个剪辑软件,那当然的话,它的功能没有像真正的软件一样这么丰富,但是对于我们去对拨风这个功能已经是够了。这里的话我们先看一下第一句话,第一句话的话是零点四秒,然后到 一点四秒结束的,相当于中间是刚好一秒钟的时间,我们看一下这个音频,今天午饭真好吃,那我们得到了这个一秒钟的数据之后呢,就需要把这个信息告诉 cad, 这也是我们的第二个动作, 给时间吗?告诉模型呢,几秒到几秒,用什么台词即可把我们刚才得到的一个时间呢?通过这样的方式给到模型,当然你可能会说,这样的话模型会不会不太精准呢 啊?如果你的句子比较多的话,的确会有一点偏差,但是如果你的句子比较短,他基本是完全按照你的要求生成的。像我这里要求他是一点一秒,他就是一点一,要求他是一点二,他就是生成了一点二秒,所以我们做单句的时候他会比较好,但然后面我不太推荐做单句去拼接单句,只是做部分的修改,那原因我们后面再讲。 那这里呢,我们先回来把刚才这一句话给做一下,用我提前准备好的音色,然后给他生成这句话,我们也写零到一秒,看一下状态,好可以看到这个音频呢,就刚好是一秒钟时间,但是我们把它放到智能剪辑当中,你会看到他似乎比我们的内容要短一点。哎,这个是为什么呢? 这是因为 cd audio 在 生成的过程中啊,开头和结尾通常会留出一点点距离哦,所以我们在生成单句也好,长句也好,我们可以适当的往上四舍五入一点,比如说这个是一秒嘛,我们就大概生成一点一秒或者是一点二秒,用这个零点几秒把这个留白的空间挤出来,可以看到整体的波峰轨迹 基本是一致的,当然它有一点点的偏,我实际配一下,我们来看能否看得出来。今天午饭真好吃, 今天午饭真好吃。好,这里其实可以发现,基本是看不出来的,这个配一下呢,就是我们的第三个动作了,叫对轨。由于 a s 频呢本身是带角色配音的,因此呢,比较简单的就是我们直接去对波峰就好了, 波峰起的那刻跟我们的音频起的那刻同步即可。因为我们前面规范好了音频生出来的速度,这个速度跟我们整体的语速是基本相近的,所以在这个的加持之下,我们整体的对轨基本就能严丝合缝了。 好,一共就是以上的这三个动作数,时长是确定整体的时间数,时间码是为了让 c d audio 生成的时间长度跟我们想要的基本一致。 而对轨呢,是解决最终的配音对口型的问题。三个动作做起呢,我们的整个配音效率就会比较高,当然了,如果我们是做一个长句,它的时间控制就不会有那么的精准,偶尔呢会出现一些整体的语速偏慢或者是偏快的情况,那这个时候呢,我们可以选择用单句去重新生成, 或者呢用更简单的方式就是我们给他变速一下,这一步我习惯用 a u 去进行变速。这里呢,我们做一个对比,你知道的,汤姆是我的兄弟,我要和他一起组队,一起拿到浙江,我给他降低到百分之八十左右的速度。你知道的,汤姆是我的兄弟,我要和他一起组队, 一起拿到浙江省的篮球冠军,可以听到 a u, 他 整体的质量明显更高。 那么这里呢,我演示一下使用 au 的 伸缩变速,把音频拖到 au 当中呢,然后再选中它,按 ctrl a 全选,然后点击上方的效果,选择时间与变调,然后是伸缩与变调,就进入到了对应的界面当中。 此处呢,算法和精度我们都保持默认,然后在下面调整成我们对应需要的伸缩倍率,然后点击应用即可。不过再高精度的算法都无法承受高强度的变速,我个人建议就是整体的变速最好不要超过百分之十,因为超过百分之十 无论是变快还是变慢都会有点奇怪,百分之十以内呢,一般是听不太出来的。 ok, 到这里就是我们语速控制的所有方法了。不过呢,我在此处穿插一个内容,就是讲话当中的停顿,因为真实讲话过程中呢,经常会有停顿啊,那么停顿反应在我们的波峰轨道上就是这样完全的空白, 我们也把它称之为气口,很多时候角色的讲话呢,都会有这样的气口存在,我们只要根据原视频当中的播风去进行调整就行了,那这个气口呢,其实对于我们剪辑来说是非常好的,因为我们可以把它切断之后呢随意的给它拉长或者是剪短,对于我们来说有比较大的操作空间。 code 拷就这个模型呢,我们可以控制它去生成气口,而且甚至可以控制气口的时长,我们来看一下如何操作,在这里我们可以给提示词里面加上括号,括号里面告诉它停顿零点五秒,停顿一秒钟,我们来看一下它生成的效果,我真的服了,怎么又来台风了, 这大暴雨把晾在外面的衣服都淋湿了,简单测算一下啊,他根本就没有零点五秒或者是一秒钟打脸了,控制时长还是比较难的,他只有一个大概的区间,但是他产生了气口,我们就可以利用他。好的,那么到这里就是整体控制语速的一整个方法了, 当我们能控制好语速的时候呢,跟画面对口型这个问题呢,基本就迎刃而解了,大家可以使用以上的方法进行一下测试。那么接下来我们讲第二个重点,就是情绪摆在我们面前最大的问题是如何精准的去控制呢? 因为他的开放式操作其实带来了非常大的随机性,并且没有给到我们一些强度的提示啊,所以这也是很多朋友可能并不喜欢使用这个模型的原因。那对于情绪的控制呢,其实有比较多的方法,比如说你原本给他的音色内容就是带情绪的, 或者呢我们给他一张情绪的参考图,因为他是能读图片的吗?所以也可以让他根据图片来表达情绪,但是我认为这两种他都存在一些弊端,所以我觉得还是用提示词来控制最好。那么这我们从最基础的情绪词语开始,一步一步的增加提示词的控制力度,然后来看怎么让该模型 生成出符合我们需要的情绪语言。 ok, 我 们回到案例视频当中这个女生的这一段话,猪,他说你是猪。这里呢,女生表现的是非常开心的,因为我的提示词中呢,给她加入了对应的一些提示,不过这里我们用 c 的 audio 来改一下。同样的一段话呢,我们给她加入一个生气的提示词, 他说你是猪,可以听到增加了生气的状态之后呢,就完全变成了一个生气的语音。不过仅仅给一个情绪词汇肯定是不够的,就像我们之前学习表情一样,我们必须要给他加入一些程度的描述词汇, 这样的话模型才会清楚你需要的程度是大还是小,情绪是强还是弱,所以在这我们就可以加入有点生气,非常生气,我们来做一下对比,三年之后又三年,三年之后又三年, 再下去,我孩子都要上大学了。老大,三年之后又三年,三年之后又三年, 再下去,我孩子都要上大学了。老大,可以看到加入了程度的描述之后,整体的情绪强度就有了一个划分了。不过如果仅仅是使用这样的程度词汇的话,我们在操作的过程当中还需要大量的抽卡。我在尝试的过程中发现了一个 更好的能控制极强情绪的方法,就是我们增加的去写一些小作文,这个小作文其实也是程度词汇,只是我们更详细的去描述角色的情绪,通过更多的词汇来增强模型的情绪反馈能力。 这里呢,我们继续做一个对照组,前者是没有加入小作文的,后者呢是加入了小作文的,我们来做一下对比,滚啊,全部滚啊!谁要你们一个人过也比你们一个个瞧不起我更好,都滚啊! 滚啊!全部滚啊!谁要你们可怜我自己一个人过也比你们一个个瞧不起我更好, 都滚啊! ok, 这样我们通过对比就能发现,当我们写了小作文之后呢,整体的情绪会更像我们描写的靠近啊,当然你写的越精准,情绪靠近的也就越强。我们最好呢小作文都写在括号里面,因为有的时候我们还要把小作文放到某一句具体的句子当中,比如说同样的这个台词,写上前面是非常平静的, 然后在一个逗号之后,我们继续写到从这里突然起非常炸裂的情绪。好,我们来听一下,看这个波峰就可以发现,什么呢,跟我想要的是非常的接近的,滚啊!全部滚啊!谁要你们可怜 我自己一个人过,也比你们一个个瞧不起我更好,都滚啊!说这个的目的呢,就是告诉大家小作文可以写到每一句的具体台词里面,通过这样的方式呢,能更好的控制角色的情绪好。然后在我们刚才的这两个句子当中都发生了一个问题啊,就是最后面这一句话, 他的最后一个字是没有读完的,我发现这是一个 c 到九的弊病啊,那么这要怎么解决呢?啊?我这里给到一个非常简单的方法,就是我们前面有学过气口吗?在这里我们最后写上,比如说停顿零点五秒, ok, 我 们再深层看一下,好,这里可以看到在尾部的波峰,这儿就留下了零点五秒,我们来看一下,滚啊! 那么我们学会写小作文之后呢,还要再加一层内容,就是角色的生理状态,这个生理状态呢,是指讲话时会带的生理伴随,比如说有的人他呼吸声音比较重, 又比如情绪起来了,角色是哭着讲话,所以把这些生理的状态也一起写到小作文当中,甚至可以像刚才一样,在每一句里面去具体的控制。 感谢你们来看栗子的视频,希望各位的作品都能大火。 ok 到这样的话,我们的单句情绪控制就讲完了。 但是其实还有一个大的前提,就是如果你有一整场戏的对话,那么把这一整场戏尽量的一次性生成。这样的好处是呢,角色的整体音量、情绪、语速前后都有参照模型生成的音频呢,它的质量会比较的好, 你的操作也会比较的轻松。那么截止以上呢,其实就是 c 的 audio 给我们深层的杆声了,那我们在这里呢,要对杆声进行一个强化,这个强化呢,我习惯用 a u 来进行操作。介绍三个简单并且好上手的功能, 第一个是混响,第二个是声响,第三个是均衡器。混响是什么意思呢?就是能创造空间感。我们首先拿到这个原音频,注意这里是没有混响的,小帅,你再不走天就要黑了。小美,你别管我,又不是我老妈,天天来管我烦不烦,那我走啦,哼, 早就好走了。老妈子,其实 c 的 audio 也是可以做混响的,比如这里,我们告诉模型,体育馆内空间比较大,比较空旷啊,男生离镜头远,女生呢?离镜头近。好,我们听一下。 小帅,你再不走天就要黑了。小美,你别管我,又不是我老妈,天天来管我烦不烦,那我走啦, 哼,早就好走了。老妈子,可以听到男生的声音比较空,脱尾音啊,这就是一种比较远的状态,不过我们自己也可以调整的,在 au 中呢,选中对应的音频,然后点击效果。混响 这里有五个混响,我们一般只用中间,这个上面有一些预设,我们可以直接去使用,但是更多时候呢,我们可以自己来调整。调整的数值呢,其实可以跟 ai 去沟通,让 ai 来告诉你啊。 那么简单的介绍一下其中的一些概念。输出电瓶这里呢有干和湿,干湿呢就是视频的原因,湿呢就是我们上面调整的这些特性啊,湿的比例越高,说明调整的特性啊,它的占比就越大。 缩减时间越长,说明空间越大。预延时时间呢,代表着离墙有多近啊。扩散呢,代表反射的数量,比如说我们在一个迷宫里面,那么它反射的数量会多,扩散就可以大一点。最后一个感知的话,其实跟现实中的材质有关系,比如 说你在窗帘旁边讲话,声音会被吸收掉啊,那这个时候他的吸音就比较强,我们往左边偏,我这边假设这个女生是在一个小房间里面的,我就把衰减往下降一点啊,扩散的话保持正常,然后感知的话,我们往吸音里面去,靠,调整对应的一个湿度。点 击应用呢,我们来听一下。栗子,别以为你长得帅我就不敢打你了。我左青龙,右白虎,龙头在胸口,老牛在腰间。 可以听到呢,它有一个真实房间的回声感,按照刚才的原理呢,你可以调整出很多的不同场景感觉。接着我们讲声像,声像是什么意思呢?相当于就是左右声道嘛,在效果里面,正负压线 啊,声道混合器,左声道对应着左边输出,右声道呢,对应着这个 r 的 右边输出,比如说我们要把声音放在左边啊,所以我们就把右声道的声音给它降下来。 好,我们这就看到整体的声道呢,他发生了一些变化,再听一下,最好戴上耳机。栗子,别以为你长得帅我就不敢打你了,我左青龙,右白虎,龙,头在胸口,老牛在腰间。 好,然后接下来是 eq。 那 么均衡器是什么意思呢?其实他就是模仿不同场景下的声音,比如说影视剧里角色在太空中对话的声音,又或者打电话等等不同场景的声音。 那么这种声音呢,其实都是通过类似的均衡器做出来的,我们可以点击效果,然后呢选择滤波与均衡,选择参数均衡器。这里我们模仿一个打电话的声音,打电话呢,是把高频跟低频的声音其实都给砍掉了,所以声音会有点窄,也有点闷的感觉。那么这里呢,我们调整一下。 好,我们再听一下,是不是有打电话声,栗子,别以为你长得帅我就不敢打你了,我左青龙右白虎,龙头在胸口,老牛在腰间, 对吧?就是我们能用 eq 去做出很多的场景,当然整一个 au 里面还有非常非常多的功能,我们本期内容并不专门针对去教学的,更多的效果呢,大家可以跟 ai 去对话,然后让 ai 来知道怎么做出对应的效果。但是呢, au 其实很好地弥补了 c 的 audio, 它在一定程度上的不足, 两者结合呢,就得到了比较好的音频了。接下来我们开始讲述音效跟 bgm。 音效的操作呢,比较简单,因为我们都是单次生成,所以我们指出凶意提取对应的要求就可以了。比如说这个转镜头的声音就是我使用提示词做出来的,又或者窗外的大雨声,他肯定是凶手, 还有两个人走路的声音,就像现在一样,以及最后这个角色快速的搓手声,整体原理跟人声这边是相同,所以我们不多做赘述了。接着下一个是配乐,一些特殊的或者是单独场景下的, 可以用 cd audio 来生成。同样的,这个视频里面整体的背景音乐我就是通过一次单独生成出来,并且其中我还要求了音乐高潮的时间,平淡的时间他都非常好的执行, 所以大家在做一些单独的配乐的时候也可以操作。那么为了节省时间,最后的话,我把做好的配乐重新给大家再看一遍。本期视频呢就到这里了,非常感谢你的观看,我是栗子,下期再见。他说,你是猪。神机 牛,又是猪。哈哈哈,快走快走,又是这个乞丐,今天还是猪人,居然是人。
1.5万栗子也该开点脑洞 01:55查看AI文稿AI文稿
你们都在说用 ai 生成的配音不好听,我就觉得有的人他声音条件不好的话,他用 ai 配音怎么了啊?我给你们看一下几个效果啊?他这里是我用 ai 做的一个小工具,它里面有粤语、东北话啊等等 各种各样的声音,比如说这个,我用这个声音给你们看,比如说随便写一个这个声音啊,然后我们输入我们的一个文案,然后点击生成生成语音,然后我们等等几秒就好,可以了。你好,我是虚荣,这是我的产品文案 是不是还可以?那我再给你们换一种啊,比如说这一个 这个声音啊,闽南语我也没试过,是什么效果,那我们点击生成一下,我觉得是你们觉得像不像?好,那还有的是粤语的啊,我给你们再生成一个粤语, 其实很快的啊,大概是几秒钟他就生成好了, 所以它里面其实也可以用我自己的声音的,所以你们不要再说什么 ai 生成自己的声音不好,对吧?所以不要再说 ai 生成的配音不真实了,我觉得它的效果还是很好的,它也支持自定义,自定义音色啊。我们我也可以把我自己的声音放进去, 再给你们试一下啊,点击,然后选择我的声音,好,点击生成大概几秒钟,很快这个视频就没有任何加速。这一期视频给大家分享到这里。
 00:53查看AI文稿AI文稿
现在很多 ai 配音都缺少活人感,代替自己录音总感觉差点意思,可以听一下经过训练的配音,这种还原度是不是你想要的?很多人梦想中的生活是拥有一个大院子,那么我们今天就来看一套位于苍山脚下的一个平院别墅, 中年退休来大理养老,谁能拒绝这样的一套平层大院?整个房子是建筑面积一百四十三个平方做的一个四房三卫的格局,它是地上只盖了一层, 光花园的赠送就有接近一百个平方,这样四四方方的一个大花园足够给您摆弄花草了。 我们在这个位置环顾下整个庭院的空间,庭院的一侧是做的户外休闲区,平时可以在这里围炉煮茶,谈笑风生。另外一侧是做的活动区域,在这里种上一些花草,整个院子的氛围感一下就能起来。
98芒果AI配音定制 02:24查看AI文稿AI文稿
我把豆包的音频生成和语音合成的 ai 模型接入到了 reaper 里面,可以直接在 reaper 里面生成音效和语音,在此要感谢脚本的原作者张惠森。另外我们帮里的同学金伯乐也是对脚本做了一些改编,把安装的过程弄得便捷了很多。 这边的服务商可以选择 eleven labs 或者火山引擎豆包啊这两个服务商,然后在配置里面去输入这个 api key, 刷新音色,就能够检测到十三条豆包音色。呃,然后就可以在这个语音合成的界面去生成台词了。就比如我们选定一个音色,输入一段台词, 点击生成,下次再遇到群杂缺音的时候就可以直接生成了,这里面有十三个音色多余种,还支持方言。就比如说选择第一个 啊,我们可以选择东北口音生成,下次再遇到群杂缺音的时候就可以直接生成了。陕西话下次再遇到群杂缺音的时候就可以直接生成了, 还可以有高级调节啊,调节语速音调音量,我这边的话是二点零啊,所以说音量是比较大的。另外也可以直接生成音效,甚至包含音乐和台词,点这个音频生成,然后写一段描述, 比如生成一段纯音效场景,古代澄清现场 二十秒,生成二十秒的话需要耗费三毛钱,这个还是比较贵的,他是按照每分钟一块钱来计费,刚才那个语音合成就相对来说非常便宜了,生成一百句三十个字的平杂也都花不到一分钱。 我们点击生成,看它出来的效果怎么样,实在找不到音效,也可以通过这个来去生成,是吧?非常棒! 玩 reaper 的 同学看到这个脚本怎能不心动呢?我把安装包和使用教程都放在会员群里了,下期见。拜拜。
170萧声帮_帮主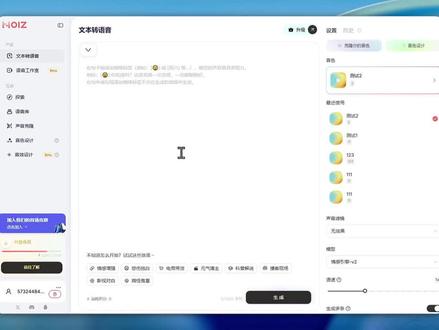 00:42查看AI文稿AI文稿
这是一个可以一键克隆自己声音的 ai 工具,操作很简单,我们点击声音克隆,直接在线录一段十五秒的语音,或者上传现成的音频文件,系统自动提取音色特征,不到一分钟,克隆完成之后,输入任何文案,都能用这个声音生成配音。测试了一下克隆出来的声音,说段子念文案都很自然, 给大家试听一下我生成的几个音色。三方协议的违约金到底要不要赔?只是你白纸黑字签字的合同,他就一定是会。男人在台上一站讲话的时候要的是阳刚之美, 一米七的身高能讲去靠近那些懂得欣赏你,赞美你,打心眼里觉得你好的人,效果都非常好。关键是可以免费使用,就非常方便。
65高效玩家


