粉丝4016获赞2.2万
相关视频
 09:00查看AI文稿AI文稿
小伙伴们大家好,今天来跟大家聊聊怎么用 s p s s 来进行卡方检验中的多重比较。 在后台看到一个小伙伴留言说他有三组变量,卡方检验的结果显示 p 值是小于点零五的,是显著的,那么他想看看到底是哪两组有差异,该怎么办呢?那么这种情况下就涉及到卡方检验的多重比较了, 我在上一期啊不对,上上一期答疑中啊,给大家简单的提到过,有一种方法叫做卡方分割法, 那么它就是可以解决这样一个问题,比如说我们有这样一个数据啊,其中有组别是组 a、 b, c, 有三个组,然后音变量呢, 是某种用药的效果,有效果或没效果,这样他就构成了一个交叉表格,对吧? 这样的一个数据形式啊,最终我们肯定可以用卡方检验来求得一个批值,这样我们打开 s p s s 来实践一下, 这是数据的一个大致情况啊,一共有三个变量,一个是年龄段,然后组别和效果。我们看看变量式图,变量式图中年龄段有三个年龄段, 组别有组 a、 组 b、 组 c, 有三个组,然后效果。这个音变量呢,有有两个类别,一个是有效果,一个是没有效果。 哦,顺便提一句,有小伙伴说他录入数据的时候不知道这个类型应该怎么变换 啊,就在这里我们点击一下,现在是数字,我们可以改成科学技术法或者是字符串,字符串是因为你有,就是姓名之类的这个文本信息的时候就选字符串。一般情况下我们为了分析数据方便,默认的都是数字类型。 好的,我们回到数据视图,啊,这样一个数据啊,我们怎么样来进行卡方检验呢?首先点击分析,然后我们用交叉表格描述统计中的交叉表, 我们可以选择行是组别,列是效果,然后在精确里默认是仅渐进法统计,我们把卡方打上勾,点击继续 点击确定,这样我们就看到了组别和效果的一个交叉表,有三个组,他们的总计都是十五人, 然后分别有效果和没效果的人数都出来了。卡方检验的表格的啊,我们看最后一列,就是双侧的这个显著性啊,发现 皮尔逊卡方的这个显著性是零点零二八,是小于点零五的,说明这三个组确实在因面量,有效果和没效果这方面是存在显著的差异的。那么就回到这个视频刚开始的时候,那个同学提出的问题, 这三个组是有差异,那么我具体想看到底哪两个组之间有差异呢?应该怎么办?这样的一个情况我们就要用 到啊数据的一个筛选,我们点击数据,在这个结果页面操作,和回到数据,这个数据及文件操作是一样的效果。我们点击数据,然后倒数第二个选择个案, 目前是选择了所有个案,对吧?那么接下来我们只想看两两个组之间的两两比较,该怎么办呢?我先重置一下, 我们如果想满足两个条件的话,就需要呃,点击这个,如果啊,如果你是英文版的话呢,就是 e, 那么选择组别,组别等于一,或者或者就是这个横杠, 如果你敲这个呃,记不住,你就敲 all 也行, 我是比较习惯用这样一个符号啊。旁边这个,呃,这个加号,这不是加号啊,这样一个符号呢,就是并的关系,然后一个竖杠呢,就是或的关系 等于三,这样的话,我就筛选了组别中的第一组和第三组,点击继续点击确定。 那么接下来我再运行一下卡方,呃,选择这个按钮,然后直接看到我的历史操作,然后点击交叉表,所有操作都不变,直接点确定。哎, 这一次就只看到了组 a 和组 c, 为什么呢?因为我们只选了这两个组,对吧?回到数据文件,我们也可以看到所有的组二这个类别 的前面啊,都打上了一个横杠,就是说明啊,不是横杠,是斜杠,就是说明这些样本在这次分析中都没有纳入进来,哎,这次分析我们就只看一和三这两个类别。 回到这个,呃,结果式图,我们可以看到组 a 和组 c 的一个交叉表已经出来了,以及它的卡方结验的值 啊,这两个组的卡方结验呢,是大于点零五的,是不显著的啊,说明组位和组 c 在这个啊音变量上面是没有显著差异的。那么我们 就再来看看主 a 和主 b 怎么样,还是点击历史操作,然后选择个案重新点,则重新选择这个 if, 把三 把组别改成二以后呢,我们就点击继续点击确定, 然后依然打开交叉表的历史操作,什么都不用变的情况下,直接点确定 啊。我们这就能看到组 a 和组 b 的一个比较了。回到数据视图上,我们也可以看到所有的组三这个类别全都打上了斜杠,这说明这些样本都没有纳入进来,都没有考虑,那么组 a 和组 b 的一个卡方结呢? 结果呢?是小于点零五的,是有显著差异的。最后我们再看看组 b 和组 c 怎么样,依然是选择个案,对吧? 点击继续点击确定,我的操作逐渐加速,因为大家都比较熟悉这个过程了,点击交叉表,点击确定,哎,我们可以看到主 b 和主 c 呢,它也没有存在显著的差异, 所以不同组别在音变量有效果和没效果方面有显著差异,主要是由于 a 组和 b 组有差异而导致的, 这就是两两分析能得出来的一个结论。那么还需要注意的一个方面就是这个批值,我们都拿这个批值一般是和零点零五来进行比较, 那么在这里呢,并不能直接拿点零五来进行比较,为啥呢?因为我们把三个组分成了两两去比较,对吧,这样就增加了一些误差。 所以我们在选择交叉表的时候,点击单元格啊,可以勾选上这个调整批值啊,用这个调整批值的方法点击确定。这样生成的这个交叉表啊,下面都会带一个小小的 a, 注意到了吗?啊,这个下标 a 呢,它就是表示啊,这些子级在点零五级别,然后这些列比例之间相互是不是有显著差异,他会给你调整,以后来啊给你公布出来。那么还有一个比较直观的方法,就是如果你 已经得出了这个卡框检验的 p 值,可以直接用点零五来除以三。为什么是三呢?是因为我们有三组,如果你有四组,你应该用点零五来除以四,用这样一个值来啊,代表显著性的水平来和 p 值来进行比较, 如果 p 值要小于点零五除以三,那么就说明是显著的。 好的,这个就是今天想跟大家介绍的整个卡方检验呃,多重比较的方法,觉得有帮助的小伙伴别忘了一键三连。谢谢大家,我们下期再见。
969菜鸟学数据分析 05:45查看AI文稿AI文稿
好,我们先点左下角的变量试图啊,我们要录入的第一个变量应该是组别变量, 组别变量要复职的啊,就是陈老师在上一期的这个新花开医学统计的公众号里面已经详细讲过了变量的编码,这个技术资料的编码复职,我们的一组是试验组, 二组是对照组。 好,一组是试验组,二组是对照对照组。然后呢?这个,呃,然后呢?我们还有一个,这个还要录入一个数据,就是疗效数据,疗效数据我们在信号 开医学统计的这个公众号里面商业奖已经讲到了,我们一般都是用一来代表有效无效的,这种没有发生的一般都是用零来编码。 好,最后呢,我们要录入的一个就是人数,注意这个人数的话呢,他是属于那种人数,他是属于。陈老师在这个上一讲已经讲到了,人数属于 离散型计量资料,他是不需要进行复制的,我们这直接插掉就可以。好,这么三个变量我们建立好了之后呢,我们就可以开始录入数据了,我们录入数据的界面是数据师图。 好,我们可以详细的看一下,我们是在变量师图里面进行的这个变量 名称及编码的输入。然后呢?再然后我们看一下,我们是在这个 数据师徒里面开始录入数据。 好,刚才那个组别是。呃,组别一是代表实验组,二是代表对照组。然后呢疗效呢?一代表有效,零代表无效。那么这个九十七个人,他是什么组的?九十七个人,我们先录九十七吧,第一个格子九十七,这个九十七 他是什么意思?他是试验组,也就是一疗效是有效的,所以呢,我们横着来看,试验组有效的九十七个人, 那么试验组无效的,试验组无效的就是五个人。好,我们再来看看对照组,对照组有效的是六十七个人, 对照组无效的是十一个人。好,同学可以仔细的体会一下这个呃,编码的来历啊, 我们可以点这个看一下,你看这个试验组有效的九十七个人,我们横着读,试验组无效的五个人,对照组有效的六十七,对照组无效的十一对,我们就是横着来的, 然后呢,这个人数是标度的,我们可以把这个这个组别和疗效我们可以改一下,改成那种名义资料啊,一般来讲不改也是可以的,改一下呢,比较规范一点。好,我们这个数据录入好了之后呢,我们接下来就要进行这个呃, 原始这个卡方检验了,然后我们再进行卡方检验的时候,我们实际上检验的是不同的组别在疗效上有没有差异,实际上只用到了组别和疗效数据,但是这个人数呢,它是累加于组别和疗效上的, 我们实际上就是试验组有效的九十七个人,那么九十七个人是需要加权到这个组别和疗效上的,所以呢,我们在做卡房检验之前,需要对数据进行加权,点,数据 点数据加个案加权,对最下面一个个案加权。好, 个案加权,我们是对个案加权的系数,个案加权的系数是什么?就是这个人数直接点确定好,提示为他摆人数,就提示我们的这个加权成功了。 好,提示了我们家庭成功之后,我们再回到我们刚才的这个界面, 加权成功。加权成功就意味着 spss 软件已经知道了试验组有效的是九十七个人,他也知道了试验组无效的是五个人,所以人数这一列变量其实我们就可以不要了,我们仅仅只对这么两列组别,它的疗效差异仅 一个卡房。检验操作是这样的,点分析描述统计交叉表分析描述交叉表,好,我们把这个, 我们把这个组别选进行疗效选进列,其实这个行列是无所谓的啊,把那个疗效选进行组别选进列都是可以的啊,这个是无所谓的。注意,我们要点击这的一个统计,统计 点了统计之后呢,自动会弹出这样一个窗口啊。
873杏花开医学统计 00:31查看AI文稿AI文稿
一招看懂卡方检验分析结果新手小白必看!卡方值和批值是卡方检验结果的重中之重,批值如果此值小于零点零五,说明呈现出差异性,如果大于零点零五,则说明没有差异性产生卡方值。卡方值越大,偏差越大。卡方值越小,偏差越小,越趋于符合 体差异所在。还要对比选择百分比括号内值。用 sto 做卡方检验,各类图表一应俱全。卡方检验分析结果可是画图形。卡方检验统计量过程值深入分析效应量指标,多种比较表格,还有智能分析分析建议帮助你理解卡方检验,你学会了吗?如有其他疑问,请在评论区告诉我。
624SPSSAU 00:33
 04:00查看AI文稿AI文稿
啊,大家好,今天给大家分享的是卡方检验的实操。卡方检验呢,在我们的这个医学研究当中是比较常用的统计学方法,比如说我们想要弄清楚这个某种疾病的发生率, 他在患者性别之间是否存在显著差异,也就是说我们想要弄清楚这个疾病的发生与患者的性别是否有关 啊,或者是我们想要弄清楚我们的这个呃药物效果或者手术疗效,手术安全性啊,护理满意度等等等等啊,就是 当我们需要做这个对照研究的时候啊,我们通常把我们的这个研究对象分成两组,也就是以这个今天的这个数据为例,把我们的研究对象随机分成了观察组与对照组。 我们想要弄清楚我们这两组患者他这个手术之后的并发症发生率是否存在显著差异, 或者我们想要弄清楚这两组患者他对这个手术效果总体的满意率是否存在差异。那么进而我们可以得出我们这啊两组患者他的采用的这个药物治疗方案或者手术方案啊,哪哪一种 啊更让患者能够接受,哪一种的安全性更高啊?哪一种方式能够让患者更加满意? 那么我们通过这个数据可以得出来结论。首先呢我们需要把这个数据整理一下啊,比如说我们今天的这个观察组, 那么他一起是七十个人,他发生这个皮下淤血的人数呢?是两例,对照组是七例啊,以及这个其他的还有一些并发症,他总的来说的话,这个观察组里面有五个人啊,发生了这个并发症, 然后呢对照组里面有十八个人发生了这个并发症,他这个并发症发生率是前面几种并发症 发生人数之和啊,你看这个观察组五个人,他是这个二加二加这个一啊,也就是五个人, 对照组是这个二七十四加四十八个人啊。那么我们现在想要弄清楚这两组患者,他在这个 懂得并发症发生率上是否存在显著差异啊?我们该怎么办?首先呢,我们需要把这个数据去整理一下啊,整理成这个 spss 他认可的格式,那么也就是说我们给他编码一下这个观察组,我们用一代替, 对照组就用二代替,那么他的这个病情他分成了两种,哎,也就是他的这个并发症,他要么就是发生了并发症,要么就是没有发生并发症, 也就是说这七十个人里面有五个人他发生了并发症,那么剩余的六十五个人,他就是没有发生并发症的人数,是吗?就是这个是否发生并发症, 也就是事的话,发生了的话,我们就用一代替啊,否的话我们就用二代替。 为什么我们要编码呢?因为这个 spss 他是只认阿拉伯数字,他不认汉字的啊。那么我们需要把这个数据整理一下,也就是说观察组当中发生了并发症的有五个人。 观察组,也就是观察组当中发生了并发症的人数人数有五个人,那么观察组里面没有发生。
1226spss数据分析帮 14:36查看AI文稿AI文稿
统计分数据分类啊,包括二分类,也包括多分类,包括有序分类,也包括无序分类,他们一般不描述均数,一般他们会描述 其他的指标,比方说率或者构成。对这类数据,它的统计分项一般采用咖坊级或者 fisher 具体概率法。所以我 这阶段我们主要介绍啊,第十十一、十二十三,主要主动介绍他方企,顺便会提一下致和解, 今天我们主要介绍两个绿比较的卡方解,那么这个题目呢,我们主要讨论绿的比较,主要采用方法是卡方解方法,因为啊,我们数据库常见的描述方法, 定量的用均数中位数分类数据的,就用绿或者构成比,这个绿跟构成比啊,他们有共同的特点,都是百分比,最常见的就是我们绿的比较,那么绿的比较呢 啊,包括有效率啊,发病率,死亡率等等等。那么绿的背后呢,是两组数据的比较, 两组序列比较,比如说有效,无效啊,有效无效,有无效,那么就会算出有效率到百分之三十, 那么有实验组有效率,对照组有效率,那么就两个有效率比较,我们要去研究,去分析我们才能方法,就是 比如说引达潘安片治疗原发性高血压疗效,将患者随机分为两组,也就是引达潘安片加辅助治疗,另外就是对照组用 m g 加辅助治疗,问两组有效率有没有差别? 我们这里这个表格大家可以看出来,有两种人群,那么有效无效,可以算出来有效率, 一种有效率百分之四十五点四五,另外一种有效率百分之八十七点七七啊,这个百分比,这个数,这个表格啊,我们称为汇总表,他汇总了对照组的有效人数、无效人数、事业组的有效人数和无效人数,同时在此基础上计算两组有效率。大家可以看出来,这两组有效率是有差别的, 但这种差别呢,是样本的差别,还不能上升到总体人群的差别。我们统计学需要探讨样本背后总人群的差异性,所以我们要进行统计分析。在这个表格里面, 大家看看,我们把这个表格称之为二乘二交叉表,为什么叫二乘二交叉表呢? 它的数据是由两行分别代表两组,预兆组跟事业组有两列,分别反映了结局有效或无效。所以呢, 它主要数据啊,存在,在存在,在四个表格里面,四个单元格里面,二十二四,二十一五,它不是原始数据,是汇总的个数,其他的数据都是由这个四个单元格的数据计算而得到的,这样数据成为二乘二的交叉表,它是分类数据比较研究 一种常见的汇总格式。这种汇总格式我们称为四格表,因为这个本例的资料经整理,就会形成这么四个单元的格式,四个单元格的数据, 我们把这样子的二乘二的交叉表成为四格表资料啊。交叉表, 交叉表又称为行列表,有两行,两列啊,就是二乘二,所以两组率的比较往往体现的表格就汇总表格啊,不是原始数据的表格,汇总表 就是二乘二的四格表,假组一组发声未发声, a、 b、 c、 d 四个单元格有四个汇总数据,那么你可以说是四格表资料的比较或者两组率的比较都是可以的。 对,这样的分组是两个水平,其余指标也是二分类,是完全随机设计或者成组设计比较,两个构成比,而且啊,是比较两组二分类结局的分布,那么通俗一点,往往是两个绿的比较,我们采用卡方结的方法来开展,采用卡方结的结果来开展。 那么卡方结或者卡方结它的写法啊,是希腊字母平方啊,不是 x 平方,是卡方。我的写起来比较奇怪啊,那么卡方结 是比较绿,它就像 t g 发达分析一样,它首先会换算出一个卡房值,再根据这个卡房值计算的 p 值。这里面的原理我这里不多讲,它的卡房值主要探讨理论评述与实际评述的吻合程度。 我们的实际平数我们称之为 a, 就是我们刚才看到的四格表实际的数字, a、 b、 c、 d 二十二十四,二十一五实际上发生的数据。 另外一个我们成为理论平数 t 又称为七万平数。 e 是假设计 h 零成立的情况下, pa 一等于 pa 二,也就是两个 率相等的情况下,算出来一个假想的评数。理论上的评数,也就说在 h 零乘零时候的时候的一个评数。我们假设界有 h 零, h 一对不对? 一般我们先假设 h 零成立,那么 h 零如果他们相等会怎么样?相等的时候会算出一个理论平数,我们称为总体平数,实际平数我们是量平数,那么卡番茄就会先计算理论平数啊。然后呢,计算理论平数跟实际平数的吻合程度,这个吻合程度就是实际平数跟理论平数的差别, a 是实际平数, t 是零的平数, a 减 g 平方除以 t, 这个就是每一个单元格的零的平数和单元格的实际平数的差值,他差 差别 四个单元格就可以是算出四个理论平数跟四个实际平数。然后呢,每个单元格都可以算出实际平数跟理论平数差别。外面公式是 sigma 累加累加,就可以把把所有单元格的理论平数跟实际平数的差别加起来,这个加起来就是卡方值。 当然我想很多人朋友圈周老师什么是理论名数,怎么算出来的?当然我们本科生教学的时候会讲怎么算,但对这门课程来说,大家无需 不需取算,软件会给你算出来,甚至你什么叫理论评述,什么意义都不需要,不需要掌握,你只要知道我们可以根据理论评述采用合适的方法就可以了。如果假设题 h n 真的成立,就拍 等于他这种成立,那么理论名数跟实际评数应该相差不大, h 的成立相差不大,那么这个时候卡方值会比较小。如果卡方值比较大,那意味着理论名数跟实际评数相差就大了,这个一大,反过来就要怀疑 h 的成立。如果这个值很大, 我们就要认为 h 零不成立,谁成立呢? h 一, h 是谁呢? h 是怕一不等于怕二。 所以卡方值的大小决定了到底相等还是不等, h 零是相等, h e 是不等,当然它实际上决定的是它的屁值。卡方值先 确定 p 值,在下结论,也就是我们跟之前学过一样, p 值可以算出 p 值,这里咖方值也可以算出 p 值, p 值在零点零五, 那不拒绝群差有没有统计协议啊?这个都懂,对吧?反过来,平时小于等于零点零五,我们是差有统计协议。 那么一般情况下,咖方值越大, p 值越小,当咖方值大于他的小概率世界界时的时候啊, 大家可以看这公式,对吧?看完值逼大大于小概率世界计时的时候, p 值小于零六,开完值小于小概率事件计值的时候必是大于零。 这具体的东西我们想问去讲,这 t 级方法分析也一样,他都有个小概率系的戒指,这个戒指多少我们也不用去管它,统计软件都会根据这个戒指会帮助我们去算 p 值,因为我们最重要的就是了解去计算 p 值,具体怎么算出来的,请忽略啊。 它的假设结过程, h 零 pa 等于 pa, 两组有效率相等。 h 一 pa 不等 pa, 两组有效率不等。阿尔法等于零点零五, p 值小于零点零五,有同缺异。 然后呢,我们都可以通过软件可以算出卡方值来啊,这是卡方值的计算公式啊,连列米数跟实际米数的吻合程度可以综合算出来,等于八点四八,怎么算的,软件给你算。 接着我们可以根据他的 p 值啊,可以根据他他方值,他方值八点四八,他的小概率数据地值是三点八四啊,为什么三点八四?不要想,不用去考虑啊,这个是统计学原理,他方值大于三点八四,这 p 值小于零点五, 开方值越大, p 值越小,所以大于三点八四, p 值则小于零点零五。小于零点零五,我们总认为要拒绝选择 in 接算 c 差异额统权益差异额统权益 有差别,说明两组率不同。这个就是卡方解的一个解步骤,大家听得云里雾里,但其中的东西不需要讲太多, 这个东西两组列的比表或者四格列四格表之间的分析。二乘二行列表就四格表采用的是咖方结,我们最终是希望是计算 p 值来下结论, p 值小于零五,两组率由统继续差异。 大家重点掌握的是这张 ppt 卡方体的应用条件,也就是说卡方体并不是所有的四个表都可以分析的。什么时候可以用卡方呢?两种情况要不然大于四十七等于五,则第六乘法 总要不要大点四十 t 呢?每个单元格的零的名数啊,七是零的名数对吧?每任何一个单元格零的名数都大点。五,我们用卡方解, 第二种情况是另外一种开放,叫第二种开放,要不要大点试试?至少一个单元格,至少一个单元格啊这是,我们四个表不是有四个单元格吗? 剩下一个单元格里面的名数小于五。大一,我们采用的方法是校正开放。这校正两个字大家不陌生了,我们在介介绍 t 结的时候就讲过,对吧?有 t 结和交正替结, t 结是放他起的手,交正替结是放他不起的手。 那么如果上述调节的不符合,要么让小一试词 who 至少一个 t, 至少一个单元格的理论平数。小一,我们不再用卡方解,用的是 fisher 确切概率法。 fisher 确切概率的方法, 你说卡方企业和调动卡方都属于广义上的卡方,它只有硬条件,如果要买小于四十或者至少一个单元格理论平数小一,卡方,企业就不能用了。用 facial 确切代理法来判断 啊。这个是交通卡方公式,这个减去零点零五,多了一个减零点零五的操作。 比如说某医师,一比较花令胆结与神经碱干支治疗脑血管疾病的疗效,花令胆结组、神经结干支组具体指标也是有效无效,因此他也是二乘二的交叉表或者行列表这个表资料了。 然后呢,我们在计算理论平数的时候,发现这里有两个单元格理论平数是小于五的, 都大一,而且样板量呢,也都大于四十,因为是五十八嘛,总的样板量是大于四十。在这种情况下,我们采用方法就是调动卡放,第一步,建立假设,第二步, 采用卡方校正的公式去计算卡方值。卡方校正的公式计算卡方值啊,算出来是零点三七六。第三步,根据卡方值算, 一直可以吃大零点零五,因此不积极。 h 零差异,五桶积血液上部分人认为两种药物治疗脑血管疾病有效率不等,还看不出来差别来,从统计学上来,看不出差别来。 另外是非洲人法,非洲人法是一种精确解决的方法,卡方解是禁词法,非洲人法是精确法。 那么 fashion 法呢?是卡方其的重要补充。那么有些场合它甚至不是配角,而是主角。比如说样板量,总样板量小于四十,不能用卡方制造一个单元格的理论平数小一,不能用卡方,都要用 fashion 法。 有些时候,第三种场景,当开放器 p 值接近零点零五的时候,就开放器 p 值约等于零点零五,零点零五一,零点零 四九。那么这个时候你到你说到底是大零点零还是小零点零啊?有些时候不好说,因为卡方杰的 p 值,卡方杰是近视法,他算出来 p 值近视值而非求法的精确法。 你现在想知道到底我的结果是 p 是大零点零五还是小零点零五?有些时候我们要借助精确法, 所以当卡番茄 p 值低至零点零五的时候,你要不明确到底是阴性结果还是阳性结果,就可以用精确法,也就是非选法来一锤定音。所以以上这种场景都可以用非选法。 不过非选法有个缺点,你的它样本来一大,往往它就算不出来,因为它它对计算机,计算机的性能有一定的考验。所以一般情况下,如果卡方解条件允许的话,多用卡方,卡方解条件不允许用非选法, 你明白了吗?更多的大家可以参考今天的课程推文,了解更多的 facial 法结 好这段视频就讲这里。
53YYL在学习 04:38查看AI文稿AI文稿
然后呢,清不清除的话,他都是不影响斯皮尔曼相关分析的结果的,我们再看看斯皮尔曼相关性分析的结果,和我们刚才还是一样的啊,这个呢,我们就不用多管了。接下来呢,陈老师再进行一个这个卡方检验,双向有序的卡方检验 点分析描述交叉表,好这个统计量勾选卡方,然后呢,这个单元格可以勾选一个行点继续,然后点确定。这个呢,就是我们的这个双向有序资料的一个卡方检验个按摘要表和这个并成年龄的交叉表,我们先不看, 我们着重先看这个卡方检验,这一张表里面,皮尔逊卡方这一行的数值仅仅只有双向无序资料才能够使用, 但是我们现在面临的年龄是有序等级资料,并称也是有序等级资料,那么皮尔逊卡方对于双向有序资料而言是失效的,无效的, 那么我们就要就就应该改用现行关联卡房的检验结果,也就是说年龄和病程都是有序的,那么皮尔逊卡房检验我们这一行就不能要了啊,看都不能看, 我们仅仅只能够以线性关联的卡方值零点幺零三和线性关联的卡方检验的批值零点七四八为最终的检验结果, 为最终的年龄和病程的交叉表的检验结果。因为年龄他是等级的啊,病程也是线性的啊,不是病程也是等级的,所以呢,两 个等级的话,我们就可以看作一个现行关联的这种呃方式的一种检验。所以呢,我们最终的检验结果是卡方值等于零点幺零三,渐进显著性水平是零点七四八,大于零点零五,就意味着,呃,这个不同的年龄,他的这个病程的分布是不存在显出差异的。 我们可以看一下,二十五岁这样一个年龄段,呃,零到一年的占比百分之七点一,一到两年的占比百分之五十三点七。好,这个行占比 就是这么看的,这一行代表着二十一到二十五岁这样这样一个年龄段下,不同的年龄的人数的占比,不同的病程的人数的占比啊。嗯,就是二十一到二十五岁这样一个年龄段下,不同的病程的人数的占比就是这一行,我们可以大概看一下,基本上 都是差不多的,不存在显著差异。这个结果呢,和斯皮尔曼的结果算出来,其实其实也是差不多的,只不过斯皮尔曼得到的结果只能得到两裂变量之间整体的一个关联关系, 而这个线性关联,卡方的检验结果,我们得出来的是不同的年龄段,他的病程的分布有没有差异?好,嗯, 接下来还有一个重点,陈老师要讲一下,其实双向有序资料就是意味着年龄是有序的,病程也是有序的。对于这种双向有序的资料,其实最严谨的一种检验方法应该是趋势卡方检验, 但是这个趋势卡方检验 spss 软件里面没有提供,大家可以在 sars 软件里面自己写程序计算。如果大家想学会趋势卡方检验的话呢?请持 关注陈老师,请持续关关注我们的这个杏花开医学统计微信公众号,我们后期会持续更新更多的有关 sarsmata 等统计软件的视频操作案例。好, 就是这个重点,就是年龄和病程两个有序变量,他要进行这个分布上的 构成比率的差异,最严谨的方法是趋势卡方检验,但是在 spss 软件里面也可以选择现行关联卡方,他近似的,他的这个结果和趋势卡方的结检验结果基本上是一致的。 好,今天呢,我们详细的讲到的就是这个双向有序资料,双向有序,双向有序的分类资料,他的卡方检验应该选择现行关联卡方,而双向无序的,呃,分类资 资料的卡方检验应该选择皮尔逊卡方检验。好。关于这个呢,大家如果有疑问的话,可以在杏花开医学统计微信公众号里面留言给我,我们的微信公众号是 xhk 三四五, 今天的课程就讲到这里,我们将持续更新更多更实用的医学统计教程,欢迎大家关注我们的微信公众号, xhk 三四五。品质源于专业,服务源于真心,感谢大家的收看,下期再见!
24杏花开医学统计 00:11查看AI文稿AI文稿
s p s s 里的值是什么意思?
502SPSSPRO数据分析 00:32查看AI文稿AI文稿
毕业论文数据分析卡方检验建议收藏备用。卡方检验主要处理分类变量之间是否存在显著关联,比如男女得病的比例是否一样。在 spss 中点击分析描述统计交叉表, 将性别选入行,是否得病选入列统计量中选择卡方,点击继续。单元格中选择型百分比,点击继续,点击确定就可以了。
750论文小助手! 00:25查看AI文稿AI文稿
如何用 spss 做卡放检验?打开 spss, 输入数据,点击分析,选择非参数检验,就对话框卡放命令,将需要描述的变量选入对应列表框中,单击右侧的选下按钮,勾选描述,点击确定, 潇洒结束分析验证结果说对,你学会了吗?
268纳兰程 07:23查看AI文稿AI文稿
大家在看文献时经常会看到批小于零点零五则结果有意义。那么问题来了,为什么批小于零点零五结果有意义?结果有什么样的意义?以及怎么计算一个研究的批值呢?我们一起通过一个例子来看一看。 已知某地一般新生儿的头为平均数为三十四点五零厘米,也就是说这一个地方的一个正常新生儿的头为标准平均数就是三十四点五零厘米,标准差是一点九九。为研究某矿区新生儿的发育状况, 什么意思呢?就是想了解一下你在这矿区生活的新生儿是不是头尾受到了这个矿区的影响,我们就要从该地的某矿区随机抽取新生儿五十五人。注意,这里是随机抽取了五十五人,不代表这个矿区只有五十五个新生儿。这个矿区可能有很多新生儿,但是我只是随机抽取了五十五人, 凑得了起头为均数是三十三点八九厘米,我们可以看到三十三点八九厘米和这个标准的数字是是不一样的。那么我们问的就是该矿区新生儿的头为总体均数与一般新生儿头为总体均数是否不同? 他问的就是这个矿区的整个新生儿的均数是否与这个标准的均数有所不同。但是我们怎么通过抽样样本的一个均数去推定总体的均数不同呢?我们就要用到假设检验的方法, 那么本力中标准的军术称为六零,就是三十四点五零厘米。而 x 呢,就是样本的军术,就是这个矿区抽出来的一个抽样样本的军术三十三点八九厘米,造成这两个值不同的原因有二,一就是抽样误差造成的。 什么意思呢?就是可能你这个矿区的总体均数和标准均数是一样的,但是因为你抽样物差导致,因为你是抽出了一部分人,你不是抽出整体的人去做的一个均数,所以因为抽样物差导致了你这个样本均数与这个总体均数不同,这是其中一个原因。 还有一个原因就是本质差异造成的,就是说你这个矿区的总体均数本身就与标准的均数不一样,你的矿区实际上是影响了新生儿头围的发育的, 所以你才造成了样本军术也产生了不一样。那么我们如何判断这个差别是由抽烟误差造成的,还是他本质差异造成的?我们要做假设检验啊,这是一个非常形象的一幅图啊, h 零呢,就是无效假设,就表示你的一个矿区的 一个总体军术和你的标准军术实际上就是一样的,只不过我是因为抽样误差,因为抽出了其中一部分,所以造成了这个样本军术不一样。而 h 一呢,就是贝泽,假设就是你这两个东西,其实就是两个东西完全不一样,你这个矿区的 总体军术本身就跟标准军术是不一样的,你矿区严重影响了新生儿的头围的发育,所以我抽出了样本的最后的军术与你们是不一样的,就叫被子的假设。 那么建立假设检验呢?还要确定检应水准、经验水准。我们一般取零点零五,无效假设呢就是 h 零,贝则假设呢就是 h 一。好,我们来实战一步啊, h 零冒号 mill 就是你这个 矿区的一个总体均速,他跟三十四点五零就是标准值是相懂的,就表示该矿区新生儿的头围与当地一般新生儿头围均数是相同的,矿区并不影响新生儿的头围发育。 h 一呢,就是他们两个是不一样的,该矿区新生儿的头围与当地一般新生儿头围均数是不同的,矿区影响了新生儿的头围发育。 啊法等于零点零五,下面有解释。啊法就是检验水准,它就是确定小爱愿的标准。在实际工作中,我们都取零点零五,但是如果你想让这个结果更可信一点,你可以取零点零一,但是零点零五已经是非常足够可信了。 那么一定要记住这样的一个公式,这个妙非常重要,它等于就是你的一个抽样样本的一个值,减去一个标准的妙龄的值, 然后再除以那个一般情况的标准差,再除以个根号 n, n 是样本量。 有了这个公式后呢,我们就可以计算他的检验统计量了,我们用这样的方式把没有计算出来了,是等于二点二七三,一般的这个没有是要去绝对值的,所以就算他最后值是负二点二七三,我们要把它变成正的二点二七三,然后我们怎么判断批值呢?这就要根据我们的一个 检验戒指,检验戒指的是一个标准制,没有零点零五情况下,它等于一点九六,这是一个固定的一个指,大家可以记住,当你的检验水准是零点零一的时候呢,这个固定值是二点五, 也就是说你最后得到了密欧的绝对值,如果大于一点九六,那你的批就小于 零点零五。如果这个 mia 的值大于二点五八,那你这个 p 的值就小于零点零一,如果小于就相反,就大于的意思就是 mia 越小批越大,没有越大批越小的意思。那我们得出了这个 mia 值,它的绝对值是二点二七三,它是 大于一点九六却小于二点五八的,那他的值呢?就是小于零点零五却大于零点零一的,那他的值批是小于零点零五的, 所以我们拒绝 h 零,接受 h 一,那么 h 一是正确的。 h 一是什么意思呢? h 一是被子的架势,就表示矿区的新生儿的口味和 一般情况的总结军术是不一致的。所以就得出了结论,如果 p 小于零点零五,我们就接受了 h, 以差异有统计 学意义。我们可以认为矿区性舍得的头围均数与一般性舍得是不同的,矿区性舍得的头为小于一般性舍得的,这就是专业的结论。 如果 p 小于等于啊法的话,按索去检验水准呢?我们是要拒绝 h 零,接受 h 一的,这就是一个规则,就是 p 小于你设定的戒指,我们设定戒指都是零点零五嘛。所以他 p 小于零点零五,我们就要拒绝 h 零,无效。假设接受 h 一被责,假设就是下一个有差别的结论,这就是我们为什么 p 小于零点零五,我们就认为结果有意义,有的是什么意义呢?他就是差异有统计学的意义。 如果批大于阿发的话,就是批大于你所设定的零点零五,那就不拒绝 h 零,就是不能下无差别或相等的结论,但是也不能下 有差别的结论,就表示他们两个是否是真的有差别,我们不能确定就是这个意思。简单小结一下,批纸是用来剪烟。 差异是否有统计学意义的。在科研中,一个数值与另一个数值的比较制,不能纯靠数值的大小进行比较的,需要进行假设检验,判断这个差异是否有意义, 有意义才能判断他最后的优势和劣势。不要以为这两个数值,因为他零点零一和零点零二他们两个是有大小之分的,你就判断这个总体一样本和另一个总体一样本是有显著性差异的,实际上并不是这样的。 通过这么复杂的假设检验,最后判断这两个量本的来源是否有统计学意义。
1910药事 05:16查看AI文稿AI文稿
我们勾选卡方,然后点继续,然后呢这个,嗯,关于这个他其他的这个什么单元格,嗯,单元格,还有 单元格里面的这么一些这种统计量,还有这个格式里面的这么一些统计量等等。嗯,关于这样一些呢,陈老师在后期的公众号中会更新对这么一些统计量的一个讲解,在本次的这个视频讲解中,就不详细讲这么一些统计量了。 好,勾完了之后直接点确定就可以了。 好,这个呢就是卡方检验的运算结果。卡方检验的运算结果呢,会有三张表,第一张表是个案处理表,这个个案处理表实际上就是展示一下参与本次调研一共有多少 个人,然后呢,他实际上就是对照组和试验组整合在一起,一共有一百八十个人,并且是没有缺失的。满足我们卡方检验的第一个前提条件就是总量本量要大于四十。好,这一个条件满足了。 好,满足了之后呢,我们再来看他的运算结果啊,这个呢就是交叉表,基于这样一张交叉表,这个交叉表里面我们可以看一下,这写了零个单元格的期望技术小于五, 也就是说这么四个单元格。注意啊,这个是理论,这个是实际评书啊,理论评书呢,我们没有勾选,所以他就没有展示出来,但是呢,这个没有展示,没有关系,我们只用看这儿就行了。没有一个单元格的期望评数小于五,所以呢,并且总样本来 是大于四十的,那么根据这么两个条件,一个是一百八,一个是这个。呃,零个单元格的期望技术小于五,那么满足卡方检验的前提条件,呃,就是,嗯, 我们可以选择这个皮尔逊卡房检验为最终的检验结果,因为呃,样本量大于四十,单元格的这个评数全部都是大于五,所以呢,我们就可以选择这个卡房检验,我们就不用看其他的了, 关于其他的这么一些呢,嗯,如果有同学不懂的话呢,可以在公众号,在我们的这个杏花开医学公众号里面留言给我, 我们将针对大家的提问集中进行解答。我们的微信公众号是 xhk 三四五。好,本次的呢,我们就直接选择皮尔逊卡方检验,卡方值是四 点六二零,然后呢,他对应的显著性水平是零点零三二,小于零点零五,那么这个就意味着这个就意味着,呃,试验组和对照组他的疗效,他的这个有效率是存在显著差异的, 那么我们得出来的试验组和对对照组他的有效率是存在显著差异。之后我们一定要判,我们一定要更进一步的判断哪一个组别的疗效更好。那么这个怎么做呢?我们一般都是选择有效的人数除以总人数,这个组别的总人数, 比如说试验组的有效率就等于九十七,除以一百零二,他就是等于九十五点一零的,试验组的有效率高达百分之九十五点一零。而对照组的有效率呢,就是对照组有 条人数除六十七除以对照组的总人数七十八六十七除以七十八,等于百分之八十五点九零,这个呃,试验组的有效率是百分之九十五点一,这个对照组是百分之八十五点九, 结合这个显著性,零点零零点零三二,小于零点零五,我们可以最终的肯定试验组的有效率显著高于对照组。 我们再来看看提干试验组,他用的是新药药物 a, 对照组用的是旧药药物 b, 由此我们就可以推测药物 a 的有效率显著高于药物 b 的有效率。 好,这个呢,就是卡方检验。卡方检验呢,嗯,不难,但是呢,卡方检验我们尤其是要注意,他必须要求总样本量大于四十, 并且,呃,期望评数小于五的单元格啊,不能,不能这个超过百分之二十。呃,这个的这句话的解释在四个表卡方检验里面,实际上就是不能有任何一个单元格的期望评数小于五, 如果某一个单元格的期望评数,嗯,在一到五之间,也就是小于五或者是总样本量小于四十的时候,我们需要选择连续校正的卡方检验。 如果样本量小于四十,或者是出现了某一个单元格的理论评书为零的话,这个时候我们应该选择非选确切概率法。 好啊,我们会陆续更新更多的卡方检验的医学呃,医学数据的这个案例的应用。好,今天的课程就讲到这, 我们将持续更新最最嗯,最实用的医学统计教程。欢迎大家关注我们的微信公众号, xhk 三四五,品质源于专业,服务源于真心,感谢大家的收看,下期再见!
306杏花开医学统计 10:02查看AI文稿AI文稿
好,我是大白,从今天开始,我们学习基于 spss 的统计分析技术应用这门课程, 那么出门课程的测试呢,主要有三个,一,他是将统一学的理论方法与 spss 软件相结合进行教学,也就说我们不仅要讲理论方法,而且要展示 spss 软件的操作。 第二,这个课程啊,突出理论方法的应用,每个知识点呢,都有案例,也就说我们讲完一个理论,讲完一个方法,我们就需就要进行这个案例分析啊。第三, 通过学习呢,大家能够使用统一学的理论方法分析实际问题,其实啊,这 这个呃这一点是最重要的,我们通过这门课的学习啊,我们就要达到这样一个目的,就是我们能够比较熟练的使用从医学理论方法分析实际问题。 那么这门课程的主要内容呢?有三部分,第一部分,概述,在概述当中呢,我们主要讲解统计学的几个基本概念,以及啊对 s t s s 软件的介绍 和一些基本操作的认识。第二部分呢,我们主要讲描述成绩啊分析。第三部分,推算成绩分析。那么这两部分呢,是我们本课程的 主要内容啊,也是重要内容。描述统计和推算统计相比较而言,描述统计是比较简单的,我们放在前面, 总计啊是比较难的,我们放在后面,那么下面我们看啊,呃,第一部分,概数 概述当中的主要包括六个方面的内容,成绩数据啊,成绩学 变量类型,数据类型统计学方法。其实前面这五个内容呢,他都是统计学的一些基本概念啊,基本概念。那么最后一个问题,我们要介绍 spss 的基本操作啊,那么我们首先来看 统计学的第一个概念啊,统计数据。那么什么叫统计数据呢?在日常和经济发展当中呢,我们经常会遇到一些数据啊,比如说身高呀,人均 gdp 啊,是吧? 分数呀,体重呀,这些数据啊,其实都是统计数据。那么一般我们所说的统计数据呢, 他都是和实际问题联系在一起的,他有实际意义的,你像一般的数据啊,就像我们数学上的一些啊,数据,他啊,他没有。呃,实际意义啊,那些数据呢,我们不把它叫做统计数据, 那么我们这门课所提到的啊,数据都是统计数据,那么对于统计数据,我们使用什么样的方法去处理呢啊,就需要学习啊, 统计学的方法啊,我们用应用啊,统计学的方法对我们搜集到的啊统计数据进行处理。呃,第二个概念, 统计学,那么一般的教材上啊,他是这样去定义统计学,统计学是收集、处理、分析则造结论的科学。在这里啊,我加了一个录入啊,加个录入,因为我们要用 spss 软件 对数据啊进行处理啊,就涉及到文把收集到的数据啊录入软件,那么这个是非常重要的, 将我们收益到的数据啊,入了 s t s s, 这个是这点比较重要,因为不同的 统计学方法的使用的要求,我们入入的数据是不一样的,不一样的啊,我们首先来看收集数据,所以收集数据啊,就是曲折数据,曲折数据单的话,我们有两 种渠道,两种来源,一个是直接来源,比如说我们通过调查问卷我们搜集到的数据, 那通过调查问卷,通过观察,通过实验啊,我们收集到数据,这样的数据呢,就是我们直接收集到的数据,他就是直接来源, 那么间接来源啊,就是我们通常所说的二手数据,比如说我们网络媒体的数据啊,统计年纪的数据,像这些数据的话,我们一般通过一个基本的考察的话,我们拿来以后可以直接用,直接用。 那么二手数据啊,在我们研究的问题当中的是首选,首选就是我们在收集数据的时候啊,首先应该考虑啊,通过建筑的渠道能不能收 道数据,因为这样的话和效率是比较高的啊,比较高的,那么我们搜一到的搜搜一到数据之后呢,我们需要把这个数据啊录入软件, 也就说啊将我们收集到的数据数据呢录入 spss 软件啊,这个是有讲究的啊,刚才我们提到了啊,不同的 数据啊,有不同的录入方法,录入方法入入之后呢,我们要对数据要进行处理,所以处理的话就是我们需要用 spss 软件对我们录入的啊,收集到的数据呢进行计算啊,进行整理, 目的是使啊之前我们杂乱无章的数据啊,所反映的规律啊,更容易识别啊,或者说我们能够更好的描述我们收集到这个数据的主要一些特征啊特征, 那么书籍处理的呃结果呢?主要表现为啊,图表和报表啊和报表, 那么这个处理的话,我们一定是用呃计算机软件进行处理,而不是手工啊,不像我们过去一样说我们计算机技术不是很呃发达的时候,我们啊用手工去处理或者是计算器啊进行处理啊。 第四啊分析数据,也就说啊,我们使用从医学的理论方法结合实际啊,对图表或者是报表进行解释分析啊解释分析, 这里啊我们强调什么呢?强调就是图表和报表的解读,那么 s p s s 出来这个结果之后呢,我们大家呢一定要 要能够看得懂,要看不懂的话我就我们就没有办法对这个 呃实际问题啊进行分析啊,分析,如果我们的统计学的理论知识啊掌握着不扎实是吧?不扎实 也会影响我们对这个呃输出结果的解读啊,解读啊,就说我们对这个报表和图表啊进行这种啊解释分析啊,解释分析, 最后呢是得到结论据,通过分析研究实际问题,我们能够得到什么样的结论呢? 这个往往是结合什么呢?结合呃定性和定量的分析啊,我们统计学校其实是一种定量的分析,我们可以结合我们的对数据的分析, 我们得到一种呃一些结论,同时呢我们还要结合啊问题的实际啊,综合起来我们看得到什么样一种结论啊?得到一种什么样一种结论?那么以上 收集录入处理分析得到结论啊,这是一个流程啊,流程他的逻辑性是比较强的,比较强的,那么我们在学习中呢,我们拿到实际问题啊,就要想想 我们如果用统计学的方法进行处理的话啊,应该怎么去处理?我们应该按照什么样的流程去处理,其实统计学的概念啊,就告诉我们这样一个流程啊,流程就说我们首先呢要收集数据,然后把收集到数据呢,我们录入 spss, 然后 我们让 spss 执行命令啊,去梳理数据,最后呢 spss, 呃,输出啊,图表,输出报表,我们结合统计学的理论方法呢,对报表进行解读啊,进行分析,最后呢我们得到结论啊,结论,那么这个逻辑顺序呢, 不能颠造啊,并不能颠造,那么这一点呢,大家一定要注意啊,因为整个这个流程啊,在我们这门课的学习过程当中呢,是非常非常重要, 后面的学习啊,如果我们拿到案例之后呢,我们都是这样,先想想关于这个案例的数据啊,如何去收集,收集到的数据啊,如何去录入,那么我们怎么用 spss 软件对我们搜集到的数理啊进行处理啊,我们需要哪些工具呢?哪些常用工具是吧?哪些工具啊,是处理哪些问题的啊,他都有对应关系。最后呢,我们要 通过对报表的解读分析啊,在结合实际问题啊,我们得到结论,结论,所以这个流程呢,大家呢一定要把它记住。 第三,统计变量的类型,那么我们所提到的啊,统计变量的通常有三种 啊,有分类型变量,顺行变量,数字型变量,那么什么叫分类型变量呢?他就是说明啊,事物类别的变量,比如说我们说性别,他是不是说明事物类。
 11:32查看AI文稿AI文稿
learning statistics does not need to be difficult now instead of bombarding you with complicated formally and statistical theory i'm gonna walk you through a way of thinking and that's gonna enable you to address the most common statistical questions when we look at sample dot for the most part, we see two things we see differences between groups so men are taller than women and we see relationships between variables like taller people way more than shorter people and the big question is are those differences and are those associations or relationships real and i'm going to talk you through what it is that we mean by the term real over the next few minutes we're going to take a look at a very simple goddess it and we're going to see how by looking at various combinations of variables and variable types we can identify very specific differences between groups and very specific relations ships between variables and i'm going to walk you through when and how to use statistical tests and how to interpret your results now let's imagine that we have a research question and it's about the height and the weight of people living in ireland of course we can't measure the height in the weight of the entire population so instead we take a random sample of the population and we measure the weight and the height of that sample and we clicked some additional information like gender and age group from each of the people in our sample and we arrange these dart in a spreadsheet or dartest hit with the various attributes in columns and these are called variables and these variables will be the object of our inquiry now most data sets that you work with will contain two types of variables, categorical and numeric variables gender contained categories as the name suggests think of them as groups or buckets that the dart can be arranged into in this case, males and females numeric variables like height are numbers as the name suggests and can be arranged on a number line now to better understand our daughter and to make sense of it we summarize it and we visualize it in the case of categorical data we can count up the number of observations in any given category and we can represent them in a table and on a bar chard and to summarize numeric data we firstly interested in the spread or the distribution of the data so we might describe the range of the data the intercoat hall range we could also include the standard deviation to get a sense of the middle of the daughter we use the median which divides the daughter into two equal halves and we use the mean which is the average the mean is probably the most commonly used summary value to represent this kind of data we can visualize our data using a box plot which is a visual representation of the range, the intercordal range and the media and of course we can create a histogram and this gives us the shape of the data i hope you can see that this process of summarizing and visualizing the data takes it from being just numbers and words on a spreech heat and turns it into something that is meaningful to us something that we can get our heads around something that we can think about now in this very simple dataset we've got two categorical and two numeric variables and things start to get interesting when we start looking at combinations of variables for example, we can take a look at a categorical and a numeric variable like gender and height and so we can group the data by gender which is the categorical variable and create a summary of the numeric variable in this case height that is separated out into those two groups and looking at the summary we can see that in our sample men are on average taller than woman what i want you to see here is that we've looked at a combination of a categoric land in numeric variable, but as you can imagine there are other possible combinations of variables that we could have looked at we could have looked at height and weight which are both numeric we could have looked at janitor and age group both categorical and in each case we might see either differences between groups or relationships between variables and in each of these cases there are specific statistical tests that we can apply to see if what we are seeing in the sample data has implications for what we think about the wider population can we infer anything is what we are seeing statistically significant so let's take a quick look at the five most important combinations of data that we have and we'll look at firstly what might we observe in our sample data given that sort of combination of data types and secondly what statistical test we might apply to determine whether or not we can infer anything about the wider population so we might look at a single categorical variable like gender and we could do a one sample proportion test for two categorical variables we would do a kai squared test for a single numeric variable we do a tea test if we have a categorical and a numeric variable we do a tea test or analysis of variants or a nova if they're more than two categories in our categorical variable and for two numeric variables we do a correlation taste now i'm going to come back to each of these scenarios and each of these tastes so don't panic at this point what i want you to see is how the data can be divided up and in just a few minutes we're going to take each of these scenarios and work through exactly what questions you can ask and how it is that you can apply statistical tastes and importantly how to interpret your results at this point i want to say this it's not good science to take a daughter's head and just randomly stab around blindly hoping to find something that's statistically significant before you interrogate the daughter you start off by defining your question your hypothesis you define your null hypothesis you identify the alpha value that you're going to use and then you analyze the data so let's look at what we can do with just one categorical variable like gender we might ask the question is there a difference in the number of men and women in the population now, we could state that as a hypothesis which is that there is a difference between the number of men and women in the population and we could check to see whether or not we think that that is the case and when we look at our sample data well, we do in fact see that there's a difference in the proportion of men and women so should we get excited well, no not yet remember this is just sample data we could have by chance selected a sample that just happened to show a difference so let's consider the possibility that in actual fact there is no difference in the number of men and women in the population and we call that our null hypothesis and if that were true how likely would it be what are the chances what is the probability that we would see the difference that we have observed or a greater difference for that matter and if we can show that that probability is low then we can have a degree of confidence that the null hypothesis is wrong and we can reject it but before we calculate this probability which we're going to call our p value we must be clear about how small is small enough below what value of p would we reject the nal and we must decide on that cut off before we calculate the p value and we call that cut off the alpha value and for the rest of the examples in this video, we're going to use an alpha value of point, zero, five or five percent so we've really got two scenarios we've got the null hypothesis which is that there's no difference and the alternative hypothesis which is that there is a difference and the next step is to apply a statistical test and in this case we do a one sample proportion test and we generate a p value if the p is less than the alpha then we can reject and all have others and state that the difference that we observe is statistically significant if we add another categorical variable in this case age group we may have a research question like does the proportion of males and females differ across these groups so our hypothesis is that the number of men and women that we observe is dependent on the age category that we look at in other words the proportions change or depend on or are dependent on the age category now we can collect our sample data we look at it and we can see that years in fact the proportions do change across the age groups in other words in our sample data the proportions are dependent on age category now is that due to chance well, let's test the idea that the proportions are all the same or that they are independent of age category that's our null hypothesis now here we can conduct a kai square test and that gives us a p value and if the p value is less than the alpha, we can reject the null hypothesis and state that our observation is statistically significant if we want to look at just one numeric variable on its own like hide then we don't have any groups to look for differences between and we don't have another numeric variable to look for some sort of associational relationship with so what questions can we ask well we might have some theoretical value that we want to compare our daughter to for example in the case of average height we might have some historic daughter we might wonder if the current population is significantly different from that historic daughter so our question might be is the average height different from a previously established height let's imagine that the previously established height was one point four meters we want to know if the average height in our current population is different to that our hypothesis is that there is a difference again we collect some sample daughter we find that the average height is indeed different from the historic height is that statistically significant well, if there were no difference what would the chances be that we observe the difference that we do or a greater difference we conduct a tea test comparing the averages and if the p value is less than the alpha then we can reject the null have notices that the observed difference is statistically significant nile is considered a categoric and a numeric variable and we may ask the question is there a difference between the average hint of men and women in this case our hypothesis is that there is a difference in our sample, we do observe a difference let's assume that there's no difference we conduct a t test which gives us a p value if the p is less than the alpha, we reject the ball and we say that the observation is statistically significant if we had a categorical variable with more than two categories like age group that's got three categories then instead of doing a tee tit we would do an analysis of variance or anover now let's look at the large combination of variable types in the start, i said two numeric variables height and weight here we might start with the question is there a relationship between height and weight our hypothesis is that there is a relationship we collect sample daughter we look at it and wala we do see some sort of relationship is drill well let's assume that it's not it's assume that there's no correlation between the two variables and if it weren't real that one of the chances that we'd see the relationship that we do and here we conduct a correlation taste now a correlation taste is going to give us two things firstly it's going to give you a correlation coefficient which tells us something about the nature of the association between the two variables, but of course it also gives us a p value and again if the p value is less than the alpha we can reject the non hypothesis in state that the correlation that we see is statistically significant and the correlation that we see can be represented by a number that we call the correlation coefficient so let's talk about that for a second efficient is a number between negative one and one and it looks at the relationship between two numeric variables if as the eggs variable gets larger the y variable gets smaller we say that they are negatively correlated if they are perfectly negatively correlated then the correlation coefficient will be negative one if there's no relationship between the two variables, then the correlation coefficient will be zero and if this is perfectly positive correlation as x goes up, y goes up then the correlation coefficient will be one and of course you can have any value in between and by the way it doesn't matter which of your variables is on the x and the y axis the correlation coefficient will be the same。
882临度科研 02:15查看AI文稿AI文稿
sbss 操作步骤讲解系列第五课,交叉卡方检验 般来说,交叉卡方检验常用于现状研究中两分类变量间的差异检验方法,也可以用作两边量间选项间交叉频率情况及列连表,是将观测数据按两个或分类变量进行分类时列出的频率表。 第一步,首先将我们需分析的数据导入 spss 中并复制,完成后点击分析描述统计交叉表。 第二步,进入图中上方对话框后,先将需分析的变量放入对应的变量框中。注,在做交叉卡方检验时,自变量或因变量均可放入行 和列,点击统计,进入下方对话框后勾选卡方。如果要看两分类变量的相关性,可勾选相关性,点击继续。 若需要增加致信区间勾选,精确勾选。图中红框标记处可填写致信区间范围,点击继续。 第三步,点击单元格,勾选图中下方百分比中行或列图中右侧 c 检验下的选项。注,一般情况不需要勾选,特殊情况可以勾选。该方法也是差异检验的一种方式,点击继续确定, 然后交叉卡方检验的结果就出来了。第四步,将 我们的结果粘贴复制到 excel 表格中进行整理。首先将交叉频率表的结果粘贴复制到表格,在技术行里手动填入比例右侧加入卡方值和选择性批值。一般情况采用皮尔逊卡方检验结果, 如果有超过百分之二十的单元格的期望技术小于五,看费希尔精确检验结果为准。 感谢观看,观看完记得点赞关注呦,可以带座指导学习交流!
376艾吖法数据 09:25查看AI文稿AI文稿
大家好,欢迎来到 spas 课堂,我是李博士,今天跟大家分享的是 s p s s 四表格的卡方检验。 好,首先我们来了解一下卡方检验的基本原理,卡方检验呢是用来检验样板数据是否来自特定分布的一种方法,它呢主要是运用于定性资料的一个统一 统计推断,也就是我们通常所说的技术资料。考方检验的零假设呢,就是比较假定呢,比较样板还是总体率是相等的总体,也就是说呢,他的实际评述与理论评 相吻合的一个程度的一个指标,差值越小呢吻合程度越高。卡方检验的统计量呢是卡方值,这里呢是用的是实际频数和理论频数的一个 呃求和的景致公式,它的数值越小呢,就是说明它的吻合程度越高,然后它呢是由呃可以培训提出的,所以说呢,它这个也叫做培训卡方。 好,我们重点来看一下它的使用条件。四表格卡方检验呢,它是有严格的使用条件的。呃,我们主要来看一下这三点,第一点呢就是理论平复大于等于五,并且呢总体样本量大于等于四十, 这时候呢我们就用皮尔逊卡方检验。第二种情况呢是理论数小于五,但是呢他是大于等于一同时满足呢,样板总量大于等于四十,这样呢我们就需要用连续矫正卡方检验。 第三种情况呢,就是理论数小于一,或者呢样板总量小于四十,这时候呢,我们就需要用到的是 face 精确简介这种三个条件呢, 我们就需要来在做的时候呢,需要判断一下他满足哪个条件,然后我们就需要用取对应的统计量和相应的批值。好,我们来看 一下呃卡方检验在 spss 里面的几个重点模块,第一个呢,他的主对话框呢,主要就是这种形式,然后左侧呢就是放置我们的变量,右侧呢是我们设置行和列,然后 在这最右侧呢有些精确呢,里面我们可以设置一个呃灰色精确检验在里面,然后统计呢就是这里统计量对外框,我们重点呢 是用到的是这个卡方,然后还有一些情况下呢,我们需要用这卡帕一致性检验和迈克尼玛尔检验,这两个用的比较多一些。呃,第三个呢,单元格显示呢?呃,我们重点呢就是,呃 在显示的时候,这个百分比,这里面一行列总计这两个呢是通常使用的。还有一个呢就是非检验比较列的时候,我们呃选上它呢就可以比较呃列之间它是有没有差异的。 好,我们再通过一个案例呢来进行一个卡方简介的讲解。呃,这个数据呢主要是针对 饮酒情况呢?呃,是否关于高血压进行一个交叉分期,通过交叉分期呢,我们来看一下饮酒和高血压是否存在一定联系。呃,这里呢数据有两种形式,一种形式呢就是我们已知每个样板的具体情况, 就是比如说样板一,呃饮酒是然后患有高血压时,这是一种情况。第二种情况就是使用汇总部的数据,比如说饮酒啊否高血压,然后对应人数值多少, 然后饮酒是否高血压,是啊,对应人数是多少,这样呢就是呃通常用到的四表格,两种 ctrl 减去的一个数据形式,我们通过数据呢来具体做一下。 好,这是第一种形式,我们来做卡方检验呢,就是通过分析描述统计交 交叉表行呢,我们可以选定饮酒猎马。高血压统计呢,我们选定卡方继续,单元格呢,我们可以选上行列都选上继续。 好,其余呢我们就不用管了,确定这样呢我们就可以看出来呢,饮酒呢,呕呢对应高血压。呃,呕呢是六十九人,肾呢是十六人,然后肾呢?五呢?二百四十六人,肾呢一百五十六人 啊,这个皮尔俊卡方呢就是对应值呢,这是卡方值,然后这个批值呢是零点零零零,就是说明呢,呃,饮酒呢和是否饮酒 在高血压上呢是具有显著差异的。呃,不饮酒的患有高血压的占比呢?呃,是百分 之占,高血压的占比是百分之九点三。然后饮酒呢,呃占高血压的占比呢是百分之九十九十点七。 然后我们再来重点看一下它这个最小呛频数就是我们的 t 呢是三十点零二, 也就是说理论平数呢,最小期望平数大于五,他的样板总量呢大于四十,所以呢是满足卡方检验的使用条件,我们就使用卡方值对应 p 值就可。 呃,如果不满足其他条件呢,我们需要用连续矫正卡方或者 facer 检验。然后我们再来看呃,第二种情况的数据, 第二种情况下呢,就是针对汇总后的这个数据,就相当于这个表格的数据了,这个符对是面对六十九,然后符呃 呃,这样呢对应的是 off, 对应四对应十六,这样呢就是相当于对这个表格进行了一个汇总。呃,我们呢首先呢整理好 这个数据呢,需要对数据进行一个个案加权, 这样呢就对数据进行了加权确定, 然后呢我们就可以同样进行相同的操作了。好, 列统计可方单元格行列继续确定,这样呢得到的是跟刚才相同的结果,所以呢这个结果呢就不再过做过多解读了。 好,我们再来通过一篇乱文来看一下。 呃,这呢是一篇呃毕业论文里面的一个表格,他呢就是做的一个是单元素分析,你看这里呢分析,呃性别下呢两组, 呃有没有差异?然后这个你看这个性别男女对照组呢,男性是多少,女性是多少,分别括号内的这占比。 呃对于卡方值 p 值呢?呃, p 值角于零点零五呢,就是比如说这个年龄啊,就说明, 嗯,年龄大于五十一岁,是否大于五十一岁呢?在这两个组上是有差异的啊,这呢就是一个通常见的一个卡方检验四表格的一个结果展示形式,他呢对应的是这篇论文里面的一个表格。 好,关于字表格卡方检验呢,就介绍到这里,大家如果有疑问呢,或者有合作事宜可以联系我们,这是我们的联系方式。好,谢谢。
34数据分析李博士 02:12查看AI文稿AI文稿
大家好,我是苏平万,今天给大家解释一下 s p s s 和格瑞派的 present 为什么算出来批值是不一样的,以及究竟应该选择哪一个为准。呃,我以单一速度防查分析为例,给大家演示一下, 其实这里面就涉及了一个细节问题, sps 事后多重比较呢?它是需要我们自己选择统一学方法的,而 garry pad preser 我们来事后多重比较,它是默认的,只要知道了这点差异,大家就能理解为什么皮质不一样了。 哦,我先从 girl pad 里面给大家展示一下啊,单元素防查分析 事后多重比较,我习惯选择组与组之间,他隐藏的细节呢,主要就在这里,此时让他默认了使用的时长。 这个 took 法中文叫做突击,所以大家一般是不会调这里的,所以他就会以突击法的方式进行事后多重比较。这里面其实是可以选的,一般默认这个我们再打开 s p s 看一下, 我不演示具体的操作了,只给大家展示一下细节一样单一素这里这里面事后都很比较呢, 一般大家用的比较多的就是 l s, d s, n k 帮扶你以及这个图片,但大家在 s p s 操作里面,大家很少选择这个,更多的选择是前面几个放一个中文对照在这里大家可以看一下 啊,大家理解这种细小差别的,就能理解为什么算出来皮质不一样了。来回答第二个问题啊,就是 具体应该选择哪一种同学方法,这个影响不是很大,大家可以选择默认的投屏,也可以选择 sps 里面的。虽然算出来批制结果不一样,但一般都会小于零点零五,只有同学差异的,你只需要在同学方法描述里面标明你选择的是什么同学方法就行 啊。好了,今天就给大家解释一下这个问题。
130stupidman1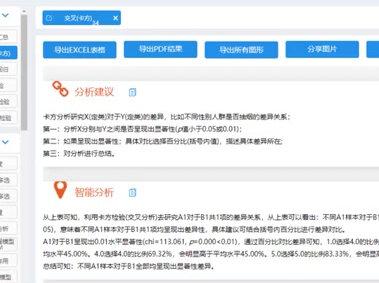 00:18查看AI文稿AI文稿
今天教你做卡方检验,第一步,导入数据,选择分析方法。卡方检验第二步,拖转样本查看结果,分析结果超清晰,可以导出多种格式,还可以调整复制表格,调整图表样式,智能分析分析建议,帮助你进一步完善卡方检验。你学会了吗?如有其他疑问,请在评论区告诉我。
464SPSSAU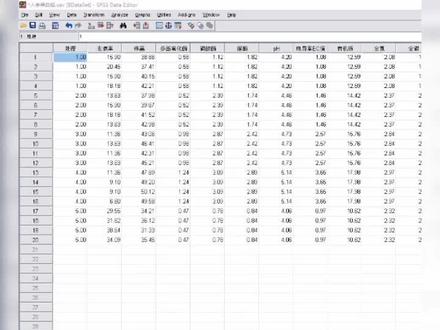 05:10查看AI文稿AI文稿
哈喽,大家好,我是豪杰学长,这期呢完整的给大家看一下在 spass 当中怎样去进行数据分析。 嗯,首先来看呢,在 spas 文件当中呢,我们放入了这样的一些数据,这个数据呢我们可以通过在 excel 里面编辑,直接复制粘贴呢,就可以 把数据复制进来,可以看到的是每一列的数据呢,他有相应的名称,名称在这个最上面这一行, 这个最上面这行我们在这里进行双击的时候呢,他在下面会跳转到另外一个变量,试图的这样的一个窗口对他进行编辑,那么这里我们可以看到每一行对应的就是在这个数据试图的每一列, 好可以看到是这样,那么我们嗯在这个嗯变量师图这里可以对变量的一些特征进行编辑,包括这他的宽度,他的这个小数点位数,比如说处理呢,我们是用这个 嗯一二三的标识,他不需要带小数点就可以了。那其他的这个嗯测定的相应的指标呢?我们可以指定他有几位小数点,嗯,另外呢是我们把这个嗯值对应的进行给他负值处理。 好的,我们来把这个相应的这个带数字给它复制一下,那么我们这里的一呢是代表的是嗯一代表的是 t 一的这个处理就是第一个处理, 那么我们这里点添加他就可以被复职了。二是 t 二的一个处理,三是 t 三 体式,嗯,然后五呢是对照, 我是店长, 好的,我们点 ok 呢,他就会把这些纸进行复制给他了,然后我们点确定。 好的,那么复制之后呢,我们需要对嗯数据进行单数方渣分析的一个检验,那么在检验之前呢,我们需要对这个嗯数据进行一个呃, 这个探索或者是一个描述,那么我们也可以先来看一下这个数据的一个描述,我们来看一下这个把所有的数据放在右边进行描述,描述 选择这里呢,我们可以选择他的嗯平均值求和标准标准差最大的最小值,平均值和他的范围,这些我们都可以选择, 然后点确定,他就会跳,跳出另外一个界面,另外一个数据分析结果展示的一个界面,包括这里 嗯有多少个样本量,然后范围平均值最大的最小值呢?他都会把所有的数据进行一个基本的描述,这是一个基本情况,我们可以看到上面的界面是数据界面,这一个是分析结果的展示界面, 因为这个界面和这个嗯数据结果的这个界面呢是嗯有数据连接关系的,所以这里他上面表投这些菜单来,我们这里可以点分析,这里可以点分析两个在他有数据链接的情况下呢,是两个都可以的。好,我们可以在这里进行数据分析。 嗯,继续的,我们刚才是对他进行描述的是 craft, 然后我们去探索一下他的是否满足正太检正态分布,我们 explore 一下,嗯,把这个需要检测的一些指标呢全部放到 这个检测的这里面来统计量来,这里我们可以不统计了,因为刚才已经做过描述性统计了,我们这里要做正态检验的时候呢,我们就需要去点一个这样的 一个嗯,是否满足正太检验的一个图,哎,点确定,然后他就会计,计算出相应的结果。他还是计算当中啊,数据有点多的话,他还是计算当中啊。 ok, 来了。嗯, explore 这检测的结果这里。 嗯,好的,那我们首先来看这个是否满足这个,嗯,正态分布的一个一个检验在哪里去了? 来,在这里。哈,我们来看这有两种检验方法,当我们数据点的个数小于两千的情况下,我们用后面的这个这个检验,然后当数据样本量大于两千,我们用前面这个检验。那这个检验的原 假设呢?是说是什么呢?嗯,假设这个,嗯,数据是服从正态分布的。
147豪吉学长
