什么样的数据适合做验证性因子分析
论文效度检验方法验证性因子分析验证性因子分析适用于测量因子与测量项之间的对应关系是否与研究者预测保持一致的一种研究方法。验证性因子分析主要目的在于进行效度验证,同时还可以进行共同方法偏差 cmv 的分析。在 spell 系统中选择验证性因子分析,按维度拖拽样本至右侧分析框中开始分析, 你学会了吗?
粉丝3.9万获赞19.9万
相关视频
 00:48查看AI文稿AI文稿
验证性因子分析分析结果怎么看?看这两个笑度就够了!聚合笑度强调本应该在同一因子下面的测量效,确实在同一因子下面,需要重点关注 iphone 和 c 二指标。通常情况下, iphone 大于零点五,且 c 二之大于零点七,则说明聚合效度较高。区分效度,强调本部应该在同一因子的测量效, 确实不在同一因子下面,需要重点关注 f 路平方根植,并且需要和相关分析结果对比。 f 路平方根植可表示因子的聚合性, 相关系数表示相关关系。如果因子聚合性很强,明显强于与其他因子间的相关系数绝对值,则能说明具有区分效度。如果某因子 iphone 平方根值大于该因子与其他因子的相关系数绝对值,并且所有因子均呈现出这样的结论,则说明具有良好的区分效度。你学会了吗?如有其他疑问,请在评论区告诉我。
126SPSSAU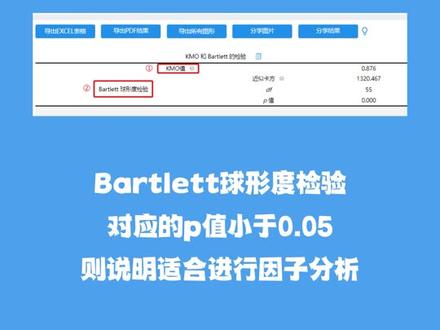 00:27查看AI文稿AI文稿
一秒搞懂因子分析结果做因子分析需要重点关注这三个指标, k 某值用于检验是否适合因子分析的指标,一般大于零点六即可。 birtwitch 球型度检验对应的屁值小于零点零五则说明适合进行因子分析。分叉解释率是因子 取的信息量累计方差解释率是所有因子提取出的信息量,该指标值一般大于百分之五十即可。用 so 做因子分析不仅可以得到多样化图表,还有智能分析分析建议帮助你理解表格指标,你学会了吗?如有其他疑问,请在评论区告诉我。
433SPSSAU 00:28查看AI文稿AI文稿
验证性因子分析,看这个就够了。验证性因子分析适用于测量因子与测量上之间的对应关系是否与研究者预测保持一致的一种研究方法。第一步,选择分析方法,验证性因子分析。第二步,多赚样本开始分析, 一键得出分析结果。还有智能分析与分析,建议帮你解读分析,你学会了吗?
37SPSSAU 00:34查看AI文稿AI文稿
验证性,因此,分析指标解读,如果某项呈现出显著性且标准在二系数值大于零点七,说明有较长相关关系。反之,没有呈现显著性或标准在二系数值小于零点四,可考虑于出。该上 下表格主要扎盖聚合效度和区分消度情况通常要稳。五值大于零点五, co 值大于零点七,说明数据聚合效度较好。下表用于区分消度研究,如果某因子 boss 六平方更值大于该,应自于其他应 子的相关系数绝对值,并且所有印子均呈现出这样的结论,则说明具有良好的区分政策。你学会了吗?
76SPSSAU 06:53查看AI文稿AI文稿
大家好,欢迎来到 spas 课堂,我是李博士。呃,接下来我跟大家分享的是 spas 校度检验。 好,首先我们了来了解一下他的一些基本概念。校度呢,就是有校警 是衡量综合评价体系是否能够转确反应评价目的和要求的,而是测量工具能够测出其左右测量特征的正确程度。效度越高呢,就是表示测量结果越能显示 呃索要测量的特征,反之呢,就是效度越低。通常呃,我们调查问卷呢。呃,效度分析的方法主要就是结构效度的分析。结构效度呢,就是指测量结果 体现出来的某种结构与测量值之间的对应程度。呃,在结构角度分析呢,一般采用的方法呢是因子分析。 好,我们呃用这 kmo 和巴特莱的精心检验呢,主要就是用它来判断是否适合做因子分析的,然后如果他满足这些条件呢,我们就可以进进一步做 因子分析,也就是我们通常所说的探索性因子分析。这 k m o 检验呢,它呢主要是用于检查变量之间的相关性。数值呢,是在零到一之间, 他的数值呢,越接近于一,就说明变量之间的偏相关性越强。因子分期效果呢, 就约好。呃,这个数值呢,一般是大于零点七我们要求的。然后呢,如果小于零点五呢,就不适合做因子分机了。呃,关于这个巴特莱的球形检验呢,它主要是用于判断相关局证是否是单位证, 就就是各变量之间呢,是否具有较强的相关性的。然后他的要求呢,是 呃求人检验的显著性批值小于零点零五就说明呢变量之间具有较强的相关性, 如果它们之间的显著性 p 大于零点零五呢就说明,呃各变量之间是相互独立的,就不能做因子分析了。好,我们通过来看一下 s p s s 因子分期的相关模块,呃,他这个效度检验呢,主要是通过因子分析这个模块呢来输出他的相关结果的,他是在哪分析降为因子下面呢? 呃,展开这个主主对话框之后呢,我们可以看到是这样的一个形式,左侧呢帮助我们变亮,右侧呢 就是放置我们进行因子分期或者消毒分期的变量的,然后在这最右侧呢就是有些我们需要输出的一些内容,我们接下来再看 啊描述对话框呢,我们是通常选择这 kmo 和巴特利的球形度检验,这呢就是输出了我们需要的角度检验的结果,他 如果满足刚才我们所说的条件呢,就说明他适合做因子分析。接下来呢我们就可以做因子分析了,然后旋转对话框呢,我们通常选择这个最大方插法, 然后选项对话框呢,我们一般选择的是按大小白序,或者呢有些时候呢我们需要把呃小技术像呢就是不展示,这样呢可以把这个选项禁止减去小区数小技术,同时呢我们可以设定他的一个数值绝对值, 呃小云某一个绝对值呢,他就不展示了,在输出的表格里面。好,我们通过一个案例呢来分析一下他的效度啊,还是限度分析,用限度分析时候的用到 的数据,就是说呢这是呃九个量表题目,然后呢我们来做一下它的一个效度检验,也就是 kmo 和八之类的检验,我们打开这个数据 分析,降为因子,把这九个题目呢选进来, 然后描述呢, k, m, o 和巴特利的球星度假面继续提取呢,我们这里可以不用管继续旋转最大方插法 得分呢,这里不用管取消选项呢,按大小排去继续确定。好。这里呢我们 可以看到巴特利的球星 kmo 和巴特利的球硬度检验呢,是点八五零大于零点七,这巴特利的球经检验呢,是显著性呢是零点零零零,他呢是小于零点零五,就说明呢,呃,这个量表数据呢 满足效度检验的一个条件,说明呢他适合做因子分析。我们接下来呢就可以呃做因子分析了。然后因子分析呢是我们下节课介绍的内容,这节课呢就不做过多讲解。 好,我们再来看一下他的一些相关乱文里面消毒分期的展示结果。首先呢,他是展示了一个 km 五和巴扎利的检验的一个输出结果,就说呢,还是展示他这样一个结果,满足条件呢,就是展示了一下他的一个因子分析的一个结果,他呢就是对这些 输出结果呢,就是对这些条目呢进行合并。这些地以地开通的呢,是工作投入成就动机呢,是转化也开通的这几个题目组织支持呢,是 i 的这几个题目。呃,这呢就是在一篇学问论文里面的一个校度分期的一个展示结果,大家如果有兴趣呢,可以看一下这篇论文。好,关于校度检验呢,就介绍到这里, 大家如果有疑问或者数据分析相关的合作市民呢,可以联系我们,这是我们的联系方式。好,关于本次内容呢,就分享到这里,谢谢!
338数据分析李博士 00:13查看AI文稿AI文稿
两步搞定验证性因子分析。第一步,导入数据选择验证性因子分析。第二步,拖延样本查看结果, later 分析结果超清晰,图表全面可复制分析。建议智能分析帮助你理解验证性因子分析。两步完成验证性因子分析,你学会了吗?
66SPSSAU 07:54查看AI文稿AI文稿
今天呢,我们先来看一下第三章,第三章呢,我们将主要介绍验证性因子分析。验证性因子分析呢是在处理结构方程模型软件中一个必不可少的一个程序,因此呢,我们今天先来学习一下第三章。第一节验证性因子分析的介绍。 验证性因子分析是什么呢?验证性因子分析与普通与探索性因子分析的一同,我们再来强调一下验证性因子分析的主要目的是什么。 验证性因子分析啊,就是说他是主要就是用来检验变量键的一个区分度测量,验证测量题目与因子的一个存储关系。 就说我们在利用我们自己开发的量表来构建了一个我们的我们认为的这个,用来用这个浅变量,用这些测量变量来测量我, 我们无法测量这个浅变量,但是这个理论基础是否能够得到一个支持呢?因此呢,我们就需要应用数据来进行一个检验,使得呢,我们检验得到的各项指标能够直观的反映出我们所构建的模型,我们的量表是符合我们理论研究的需要的, 这就是验证性因子分析的一个主要的一个一同,主要的一个点。然后验证因子分析与探索性因子分析的一同呢,就是说我们在 呃相信大家在多元统计分析里边,大家都接触过因子分析,当时的因子分析呢,就叫做探索性因子分析,就是说我们有了一些数据,我们需要从数据中提取出来几个因子,简单的来说就是降维,比如说我们刚开始有十几二十个因子, 然后我们需要通过降维呢来提取几个公共的因子,使得这几个公共的因子能够最大可能的解释原始变量的信息,这就是探索性因子分析需要做的一点。 然后下面我们就来简要的分析一下,探索性因子分析和验证性因子分析有什么不一样呢? 就说最简单的,我们就可以通先来直观的来看一下,就是说探索型因子分析呢,他是一个先有一个数据,跟 根据你所测量的这个数据呢,来对其给出一个最终根据你的结果给出一个理论上的一个解释,是先有数据,再有理论,然后利用数据来探索,探索出测量变量的一个框架,这是探索型因子分析一直 在做的一个点。然后验证性因子分析呢,就是说验证性因子分析是我们先进行的理论的理论的观点或概念架构的一个 一个准备。我们在有了理论之后呢,我们想要通过数据来对这个理论进行一个检验,我们来看看这个理论模型是否适当,是否合理。 因此呢,我们就是先有理论再来做一个检验,这是验证性因子分析的验证性因子分析的逻辑。然后验证性因子分析呢和探索性因子分析呢,我们首先能发现的一个点呢,就是说他们的理论基础是不一样的,然后验证性因子分析先有理论,然后根据数据来进行检验。探 探索性因子分析是我们只有数据,然后通过数据我们想要得出一个理论上的一个解解释,然后这是探索性因子分析 与验证性因子分析,一个呃最直观的一个差异,下面呢我们再来看一下从其他几个方面,我们再来看一下这个是否有一定的差异呢? 呃,我们首先来看一下他们的理论上的一个贡献。我们刚开始前面已经讲了,就是说呃探索性因子分析呢,是做一个理论上的一个 呃产出,然后验证性因子分析呢,是做一个理论上的一个解释,探索性是通过数据来产出一个新的理论,验证性是通过 呃我们现有的数据,现有的理论,现有的理论基础,我们来对理论进行一个验证,所以这这是两个在理论上的一个差异,同时呢,然后两个在处理的逻辑上也会存在一定的差异。就是探索性因子分析呢, 我们就是说他先是理论启发,然后文献基础薄弱,就说他没有相应的文献的研究基础,没有前任理论的研究基础,他仅仅是只能通过数据来对他进行一个相应的解释。 然后验证性因子分析呢,他就有一个非常强大的一个理论基础来做支撑,有了这个理论基础之后,我们再用我们的实际数据来对这个理论基础进行一个检验。 然后同时呢再再有一点不同的呢,就是说探索性因子分析呢,我们是最终为了决定这个因素的数量,我们最终要决定提取多少个公因子,能 能够最大限度的解释我们所提出的这个我们所原始的这些变量的一个情况。然后验证性因子分析呢,就不同了,他是说他在我们在分析之前 前呢,我们根据现有的理论,我们每个浅变量所具有的测量变量,也就是我们这个模型的因素都已经是固定好的了,我们只不过来对他进行一个检验,所以说呢,这就是两 两个决定因素的两个,两个理论的两个研究的方向的一个差异。探索性因子分析呢,是为了确定这个数量,然后验证性因子分析呢,是为了给出一个,是为了给出理论已经确定好的一个模型的一个合理的解释, 然后最终呢就是说还有一点就是说呢,呃,就是说这个变探索性因子分析啊,我们是用来做探索的,对吧?我们不知道呢,这个变量是需要归位哪一类的 三者性因子分析呢?最简单的一个一个一个直观的一个猜,直观的一个解释就是说我们是原始信息,我们把原始信息 绘制在呃,绘制在坐标系中,我们通过来进行一定的转轴,大家二维的就可以想象的出来,我们把 x 轴和歪轴来进行一个旋转,使得我们的变量 尽可能的集中在第一个主轴,也就是 x 轴,然后在 y 轴上呢,也会尽量的尽量的大,这样之后呢,我们就相当于把原来一个不太相关的 信息给他转换到一个非常相关的 x 主轴上,第一个相当于他的话就叫第一个因子,然后和 y 另外一个因子得 这个一个一个过程。然后验证性因子分析呢,我们是说的是这个某一个测量变量,他归属于某个浅变量,他是我们在研究分析之前已经通过理论给出一个确切的分类的,这个是我们没有没有办法进行更改的,然后这个就是 两个是否是否确定这个因素因素的归类,探索性因子分析呢?因素的归类是可以随机的,比如说我们这一次做,我们根据不同的准则来选的话,可能可能这个 a 问题就可以归到不同的 电量里边去。然后呢验证性因子分析就是说我们这个 a 问题是用来测量某个浅变量的,那他就只能归属于某个浅变量,这个就是这个。我们我们就从四个方面给出了验证性因子分析和探索性因子分析的 各个方面的一个一同,希望大家能够对验证性因子分析和探索性因子分析有一个直观细致的一个了解。然后今天呢就是我们简要的介绍了一下验证性因子分析的一个介绍,我们通过今天的介绍呢,希望大家能够对验证性因子分析和探索性因子分析产生一个宏观的认, 最终呢为了后边学习各个模块,为了后面学习呢,我们下节课程的验证基因子分析的实际的求解以及后续的解释呢,会先打下一个坚实的一个理论基础, 希望大家能够对今天的课程能够在课下进行一定的熟悉,对这个理论呢有进一步的了解。呃,以上就是今天课程内容,谢谢大家,我们下节。
211贰壹壹项目数据分析服务 14:01查看AI文稿AI文稿
嗯,大家好,我是君磊,上一个视频呢,我们呃简单介绍了一下关于信度分析如何去操作,以及啊我们通过一些方法来改善这个信度值。 从这几个开始呢,我们就连续做几个视频来去介绍这个笑度检验如何操作。嗯,笑度检验呢,可能是在我们做假设检验之前啊啊做的最大的一个检验了, 当然有的同学可能是用的非常成熟的量表啊,这一步呢,有可能会跳过啊,但是啊,我们发现啊,就是即有的同学即使是用了非常成熟的啊量表啊,导师依然会建议你去把这个笑度再做一遍啊,这也是有可能。 所以说,嗯,这一步呢,你需要跟自己导师啊去沟通,如果是你是用了成熟的链板,你需要去沟通确认一下你是不是要做这一步啊。如果是你是自己设计的文件,那么一定是要去做这一步检验的 啊。我们可以先看一下他的,看一下他的定义啊,这个定义是我自己写的啊,跟一些概念啊,可能啊,不太一样,但是表达大家都是一样的。嗯, 效度检验其实它代表一是数据的有效性啊,也就是说啊,通俗一点讲,就是你心中所想的,跟你实际所测量出来他是有一致性的,嗯, 如果一致性比较高,就说明你数据的有效性较高啊。放在我们的这个问卷的分析当中呢,就是说你的量表的这个设计啊, 跟你的实际测量出来这个维度啊啊和音子他是一致的,或者是基本是一致的。比如说你有二十个题目,你设计的六个因子, 那么我们用探索性因子分析呢去把它给呃探索出来哎呃,刚好你这个探索出来因子跟你实际所设计的是一致的。 ok, 那么你就说明这个消毒是通过的, 那我们应该用呃什么样的呃呃特征来去表征这个效应呢?或者说用什么样的指标来去探来去验证这个效应呢? 那我们我一般是会把这个度减压区分三个难度啊。第一个难度呢就是用 k m 和巴特利求生减压来去操作啊。其实是,其实说呢这个这两个指标呢,他并不是来去减 的这个笑度,他是来去啊来去呃看一下这个数据是不是适合做这个因子分析。嗯,但是呢就是,呃 嗯,原则上讲这不是消毒检验,但是我发现很多的文献当中都是把这个当成一个消毒检验,这个很有意思啊。所以说呃当你的当你的这个笑度实在吞不过的时候,你可以哎浑水摸鱼一把,然后只用这个。呃 啊,只用这两个指标就去表扬这个笑度啊,当然可能会不会通过啊,也可能也有可能会被通过。嗯,好,那么一般呢,我们是用探索性因子分析啊去做这个笑度的言,这是啊用的最多的,最多的一个。 嗯,他其实是在我们积极学习当中他是一种降为的一种方法啊,我们叫 啊因子分析,降为嘛啊?在这里叫他投降因子分析,他本身上是啊有 n 个题目,有二十个题目你给他降为降成了四为或者五为,然后呢我们能通过因子和载去呃找到这个因子下他跟哪些题目是 啊比较亲密的,因为他哪些题目是归属到哪个因子的,那么这种呢就跟可以跟我们的设计呢所哎呃有一个匹配关系,如果匹配比较高就说明你的效度比较高,我们叫 efa 探索性因子分析,那么嗯, 另外一个比较高难度的这个消毒检验呢,我们叫探索性因子分析加验证性因子分析。嗯,简单来讲就是我们探索出来这个因子之后啊, 再用啊结构方程或者是啊验证性因子分析啊,去跑一下,看一下你这个啊,你探索出来这个是不是一个良好的一种啊?结构啊,这两个用探索性因子分析加验证性因子分析呢, 这种方法呢,他是呃最能够让人幸福的,当然他的一些指标想达标的话也是最难的,所以说啊, 一般本科是很难很少去做这个这两个呃分析来做泄露检验的,一般是研究生阶段呢会用这个分析, 本科生我建议就是用探索性因子分析就够了。好,我们今天呢就先讲这个探索性因子分析。 好,我们还是先看一下这 这个呃表格的样式。呃,因此分析呢,他有很多种表格样式。嗯,但是这种呢是我觉得呃是最方便的。因为什么呢?因为他是直接可以从 spss 中呃 去输出的,也是直接可以用的啊,我觉得不需要再大改了。嗯,当然也有其他一些比较啊,综合的形式啊,那种也是可以的啊。嗯, 好,我们先先介绍一下这些表格。第一个表格呢,他是啊刚才我说的 km 和巴特利群体验这个指标呢怎么看呢啊?首先要看 kmo 值啊,这个值呢?呃,也是要看他是不是大于零点六, 嗯,也有的时候要看大本,嗯,是不是大于零点七,这个不是很严格,一般大于零点六我觉得就可以了。呃,当然你要看你导师是不是, 呃,要求你大于零点七啊,或者零点八,呃,然后通过这个,这个通过之后呢要看他这个屁,再看那个他的群里面的配置啊,这个配置如果是小学零点,呃, 小于零点零五,那一般他都是小于零点零一的啊,他,呃,这很容易通过的。这个如果这两个都通过呢,就说明这个数据啊,他可以进行因子分析。好啊, 嗯,可以做印子分析。之后呢,下面我就就开始看那个音。嗯,主持分的 t 恤以及宣传成本矩阵。好,我们下个这个表怎么看呢?嗯,这个表出来之后呢?嗯,首先要看这一列我们叫什么叫啊?特征值。 这节车上知道要看他是不是大于一,或者说要看一下他大于一的有几个,能够大于一的有吗?有四个, 有这四个,也就是说我们,嗯有十三个题目,十三个题目呢,他提取出来四个音字,而这四个音字呢?呃,我们再往后看后看,这里有一个累计 多少多少,我们叫什么叫累计的方差解释度啊,这个呢是百分之七十六点几 啊,这个是比较好的啊,这个累计发达。呃,几十度呢?这个呢也没有一个非常严格的标准,有的地方呢说达到百分之六十,有的地方达到百分之七十啊,这个确实是没有谁严格的标准,反正是越高越好。嗯, 你大家记住,主要是看这个 t 恤度,还有就是这个,呃大于一的个数。好,然后呢,看完这一个之后 啊,我们会看一个碎石图,嗯,这个碎石图呢,我们要看一个拐点,比如说这个地方大概是在这个地方出现拐点, 这地方出现拐点之后呢,我们就会说他,呃,提取二到五个啊,之间就可以了,而不是说他拐点出现在哪里,你就说提取几个适合,这个是没那种绝对的啊,比如说他拐点出现在这,你就说他 说是三到六啊,这样来表达就可以了啊,你看这里,嗯,在这前五数出现平缓之前继续下降,所以提取四个比较合适啊,其实他就是在五出现之后呢,然后说四到六个就比较合适,然后就说啊,提取四个合适,这样好,下面就是我们重头戏 叫悬崖成分矩阵,嗯,这个悬崖成分矩阵呢,他是这样的,就是每个题目呢,在 每个因子下面都有一个值,但是他最大的那个值呢,是他的那个因子的归属, 这里是都有直的,只不过我们把它给省略掉了啊,给他删掉了,因为我们只保留他最大的那一个,所以说我们取最大的这四个呢,那么这啊, t 第一就要提第三、第二、第四这四个题目就属于英子一,那么这三个题目就属于英子二 啊,这三这几个题目都数银子三啊,这都排序好的。好,然后下面你就解释一下啊, 根据学院成分得学院学院成分基本得知。然后啊,哪个题目是属于啊?哪个因子,然后他因子喝了有多少,这里的他解释就比较啊,就比较简洁,如果你想凑字数的话,你就可以啊啊,这个题 他的因子喝的是多少啊啊?写一下,然后他都是打游戏的,然后都可以问他命名为什么好,那下面呢,我们就接着一个数据来操作一下,给大家看一下啊,操作呢也比较简单, 但是有些细节需要好好的注意啊,我来操作大家一定要看清楚。首先我们点击这个分析,分析里面有一个降维降位,里面有因子分析,然后呢我们就把你的量本的题目给它塞进来, 比如说我们把这里的这这个这几个题目给他塞进来啊,加上这个吧。 好,然后呢我们一个一个点这里呢,先点这个描述,描述里面我们需要点什么?点这个 km 和巴特利,这个是一定要点的, 继续,然后抽取,这里呢我们是要点啊,这里我们就不动,一个是觊觎特征值的一个抽取啊,这里是我们不动的啊,有时候我们的抽取效果不是很好,比如说啊,我们 本来想是呃抽取四个,结果他就出来三个,那么这里呢,你就点他强制抽取四个,这里输入一个四,然后你看他出来是什么样子,你就可以去简单的看一下,但是呢我们还是要去看刚才说的特征值的。 好,我们先点他,然后四十图啊,就在这里点个四十图。好,然后我们点这里就旋转,旋转什么?就是旋转成分矩阵嘛,对吧?然后我们这里用最大方叉法好,其他方法就不需要了解,你就记得记得一个最大方叉法就可以了啊,这个是我们嗯 最常用的一个方法。好,我们今天继续,然后得分,这个保存为变量呢,一般是在,嗯, 在哪里会用到呢?就是在那个,呃呃,财务类的这个,因此分析里面,主持人的分析里面会用到这里呢,因为我们主要讲一部件分析吗?这里暂时先不讲了啊。嗯,我们这个也可以点上。好,我们再点这个选项,这里注意啊,我们 有这么一个注意的事项,一个是使用均值去替换这个确实值,然后呢按大小排序,这个是一定要点的,然后取消系数,这里我们点到零点三, 取消系数就是我们呃把那些呃因子核载低于零,低于零点三的我们都给他不敢试,然后我们就确定 好,那么这个就出来了。好,我们可以看一下,其实这个表格呢, 就是我们那刚才我展示的那几个表哥的样子,只不过我们稍微稍加去修饰了一下。好啊,这个就是 kmo 值和巴特利啊,他,他是零点八七七,还是比较高的,然后配置也是良好的。 好,这里呢就是刚才我说的那个啊,特征值,我们看他是不是大于一啊?大于一的有六个,也就是说这六个呢,也就是说这二十一个题目提取了六个因子, 然后累计解释百分之七十二点四的一个方差,这个是比较理想的。然后这个就是,那你就啊,这个地方其实没那么严格,你就大概说一下啊,他是在七这地方出现了 一个拐点,所以呢啊,从五到八提取五到五到八个因子是可以的,所以说我们提取六个因子是合适的,这是六吧,这六个因子是合适的。 好,然后这是成分矩阵,这个成分矩阵跟后面那个矩阵他是不一样的,这是还没旋转之前的,我们不管这个直接看这个。好,这个就是旋转成分矩阵。 那么这个举证呢?你们看他就是啊,这一堆是在一起的,然后呢?我们,呃,这零点,你看这是零点四吧,这零点四我们要看他大的,所以我们要从这开始看,从零点八这地方开始看,然后这停止,然后在这里看, 他给你排泄好了啊,这个地方就是一个宣传成本举证。嗯,那么关于制表呢,我在这里就不多讲了,大家只需要把啊这个宣传成本举证跟这个解释, 磨砂还有开摩托力啊,给他复制一下。这天他到表哥里面已经稍加休啊,稍加那个加工就可以啊,直接 coffee 到味道里面去了。嗯 嗯,燕子飞行到这里就并没有结束,因为我们还要解决一些问题啊,一些我们很常见的一些问题 啊,比如说我们的因子因子分析的效果,比如这指标不达标,我们怎么办?还有就是啊,我们出来结果啊,学院成分举证并不是我们想要的结果,我们怎么办 好这些这些问题呢?我们放到下一节课来处理啊,今天我们就不不多讲了,好啊,我就啊先到这里这个视频,谢谢大家。
343Junlei_D 01:44查看AI文稿AI文稿
sbss 操作步骤讲解系列第十九课探索性因子分析 探索性因子分析用于检验量表的结构效度情况,先采用 k 梦和巴特利特球形度检验检验数据是否适合使用探索性因子分析后采用主成分分析提取供音子最大方差法对提取的供音子进行旋转。 第一步,将数据导入 spss 中并复制后点击分析降为因子。 第二步,进入图中对话框后,先将量表提像放入变量框中,点击描述勾选 k 梦和巴特利特球形度检验,点击继续旋转,勾选最大方程 夸法,点击继续选项勾选排除小细数绝对值如下,框中输入零点五,点击继续确定。 然后探索性因子分析的 k 梦和巴特利特球形检验供因子方差,总解释方差成分矩阵,旋转后的成分矩阵结果就出来了。 结果出来后,将旋转后成分举证结果粘贴复制到表格中后,将供应子方差下的提取数据放入表格右侧,再将 k 梦和巴特利特检验结果,即总解释方差中的初始特征值和累积方差百分比放在表格的下方。 观看完记得点赞关注哟,可以带座指导学习交流!
772艾吖法数据 01:24查看AI文稿AI文稿
一百五十秒教你学会 amos 验证性,因此分析可代作指导学习。第一步,先将数据导入 spss 软件中并保存,打开 amos 插件并根据每个维度题像画模型图并命名前变量名称。 第二步,选中前变量框,添加相关信息后添加误差项。 第三步,点击图中 filength, 导入保存的 spss 数据,点击 ok。 第四步,点击图中左侧标记处后,跳出图中数据提相框后选中对应提相,放入对应的框中,助拖动提相到对应框中时,须等提相放入框中 方可。第五步,勾选图中所示选项后点击运行,然后我们需要的结果就出来了。 第六步,将结果粘贴复制到 excel 表格中进行整理,可参照图中整理结果整理。 将整理好的结果粘贴复制到 word 文档中进行表格的制作和文字描述可参照图中制作和解释。
72艾吖法数据 11:27查看AI文稿AI文稿
今天呢,我们来看一下第三节的内容,验证性因子分析的结果解释。做完验证性因子分析之后,我们需要对做出的验证性因子分析的结果给出一个合理的一个解释。首先呢我们来看一下验证因子分析做完之后,我们主要来关注的是哪些指标 阴性分析的结果呢?我们主要关注以下几点指标,第一个咔方值,也就是模型拟合出来的咔方值, 第二个是自由度,第三个是咖方除以自由度,也就是第一个和第二个咖方除以自由度的比值,这个比值呢,一般小于五就是我们可以接受的一个标准, 如果说最理想的就是让他小于三,越小越好,一般小于五就可以接受,小于三的话更加理想一点。第四个是金丝误差军方根,金丝误差军方 根的话,一般让其小于零点零八的标准就就属于可以了。然后如果你想要再进一步让这个模型更好的话,一般就让他小于零点零五,当然也是越小越好。 然后 cfi 大于零点九是 cfi 和 nfi, nfi 呢有时候也叫 tfi, 他俩呢都是一个关于验证性分析的整体的拟核的一个指标,这两个指标呢都是越大越好,一般大于零点九就可属于可以接受的范围了。 呃,在看完这个验证芯子分析需要关注的一些指标变量之后,我们再来看一下验证芯子分析做完之后,一般是一个一般要做成一个什么样的一个结果。 一会我们还会结合这篇文献来对大家进行一个讲解,我们大家可以看一下这个作者呢,在这个文献中,他提出了有八个浅变量, 相当于他首先做的是要做一个八因子模型,我们上次课所讲的也是老师数据所对应的一个五因子的一个模型,对不对? 八因子模型做完之后呢,我们还需要将因子进行一些合并,比如说他的七因子模型给出的就是工作家庭冲突,妻子的工作家庭冲突和丈夫的工作家庭冲突 合并为一个变量之后,和其他六个变量构成了一个七因子的模型。大家可以想一下,七因子模型肯定不止这一种组合方法对不对?还有其他的组合方法,但是呢,作者不可能将所有的都列出来,所以一般的学术界的处理方法,就是说 我们在做的时候呢,将随机的进行一些组合,也可以是根据一些文献的,根据一些自己研究理论的一个需要。当然这个比如说这个就是工作妻子的工作家庭冲突 和丈夫的功能加强冲突,他们俩更可能归于一类去,所以呢七英子模型里边这一展示就是这个,当然你也可以展示别的,然后相应的呢,他分别做了七英子、六英子、五英子、四英子、三英子、二英子、单英子, 最终呢得到这样一个表格,最终的验证结论呢,就是说我们首先来看这个八音字模型,他的各个指标呢,喀方除以 df 小于五金丝误差,军方跟也小于零点零八, 然后 csi 呢大于零点九, nnfi 也就是 tli 虽然只有零点八八,但是也非常接近零点九的,也可以作为我们的一个合理的一个解释。 再来看呢,就是七因子、六因子、五因子、四因子、三因子、二因子、单因子。模型之后呢,他的咔方值明显变大了,就变差了,而 msea 呢就误差近似误差,军方根变大了,也变得不好了, cfi 和 nfi 也有减小的趋势,就是不符合我们的预期了。因此呢,我们就说我们最终构建这个八因子模型呢,是一个理想的模型,是符合我们预期的需要的。 在看完这个之后呢,我们通过数据来实际对大家进行演示。首先呢现在回顾一下我们上节课是怎么做的,我们上节课绘制完模型图之后呢,我们先需要选择数据对不对?我们把把老师给的这个数据呢选择进来之后点击, ok, 在这个分析属性里边呢,我们还需要设置一下输出选项对不对?我们这里呢让他输出一个标准化的结果,这样我们在模型图里边呢,就可以呈现出标准化的一个输出结果在模型图里边, 然后点击完这个之后呢,我们就直接可以点击呃那个运算,运算呢,这里就会呈现一些运算的过程,就说他通过十一步的叠 代取得的这个最小值,最小值已经达到了他给出的一些结果,就他给出的这里简单的给出了一个开放值和自由度。 我们首先来现在已经是已经是那个标准化的视图了,已经是那个结果呈现的视图了,如果我们点击左边这个,就会切换为那个数据模型图的视图,然后我们点击这个就会切换为这个数据结果的视图,然后我们可以在这里呢进行切换,选择非标准化和标准化的一个结果, 不管是标准化,非标准化,我们在这里都可以看到一些简略的信息,我们我们需要的一些信息,比如说我们可以看到咖方处理自由度,我们可以看到金丝乌纱,军方跟可以看到 cfi, 你可以看到 tli, 也就是 nnfi, 可以看到这些值。如果我们想要进一步的分析看一下所有的结果的话,我们就 点击 vipast, 这里呢给大家呈现的就是所有的一个数据分析的一个结果。首先呢我们来给大家逐个来讲解一下数据分析所有的结果是一个什么样的一个情况,这个呢是一个分析的汇总,就说呈现了分析的日期,时间以及标题, 这个呢是群组的分析的一个注视,我们这个这个群组呢只有一个群组,总共样本量呢我们可以看出来是两百三十三个,在下一个呢就是变量的一些摘要,这里给出的一些呃浅变量,观测变量以及以及那个浅变量, 同时呢还给出了一些变量的一个汇总表,就说我们总共用到的呢四十五个变量,其中有二十个是可以观测的变量,有二十五个是不能观测的变量,有二十五个外省 面量,有二十个内胜变量,以及这个就是变量的一些汇总,同时呢还会给出的是一个呃参数的一个汇总,我们大家点击这个就可以看到参数的汇总,在这里呢我们可以看到固定参数, 有这个标签,有飞机标签,还有这个总和,同时呢这里有呃回归的,有有相关的,有方差的,有均值的,有拮据的,有所有的,就是说所有的变量,所有你要估计的一些参数都在这个表里边给你汇总出的一个 一个数据的一个分析结果,方便大家进行一个查找。然后这个呢就是模型礼盒的一些,这个是模型的一些信息,模型的信息的话就说我们这个模型呢,总共是 总共用到的这个自由度,他给你的自由度,同时还给你的一些结果,自由度的话就是说我们这里边呢就是呃模型的 nobods, 第一次 summom 次是两百一, 然后第三个拍二米特图比森的,是的是的呃五十,然后他两个相减之后呢,我们就得到我们的自由度是一百六。我们这个模型结果里边呢给大家说的是我们的最小值呢,已经达到了, 我们的最小值已经达到了,同时呢这个咖方值呢是三百一十一点零一三,自由度呢是一百六,然后咖方值所对应,在这个自由度下,咖方值呢所对应的显出性屁值是零点零零零, 就是小一点点零零一的意思。下面呢再给大家看的就是这个呃估计的一个参数,估计的一个结果, 我们可以看到呢,就说 a 这个浅变量有四个测量变量,他的估计值呢这个是给出的是一个非标准化的一个估计值, 可以看到下面呢就会给出标准化的一个估计值,大家都可以就是说既可以看非标准化的,也可以看标准化的,我们就可以看到呢,所有的这些拟核指标,所有的测量变量在这个题项上都是显著的,这个虽然标出来是零点零三六,但是也小于零点零五的标准也都是显著的,对吧? 这是非标,这是标准化的一些结果。然后同时呢也给出了这个斜,这个方斜方叉,斜方叉矩阵,就是说 方差,斜方差就说 a 和,就说因为时间的性子分析,所以两两之间都会有个斜方差,斜方差的值呢,我们也给出来了标准物 cr 值,然后他的 显著性 p 值也都给大家进行的标注,还有相关系数,同时呢还给出了变量的值,这个所有的变量,我们我们的浅变量,包括我们的这个误差,各个误差项都给出了一个结果的,然后这里呢还给出了一个最小化的计算过程, 我们在刚刚的参数的分析过程中呢,模型的分析过程中,我们就看到总共这个模型,通过十一步迭代我们找到最小值,那么他这里就给出了你的十一步迭代分别是一个什么样的样子。 同时呢还给出了一个模型礼盒的一些信息,这里边呢就是一些参数信息,我们可以看到这里边呢就是咖方值, 还有一些 rmig, f i, 然后还有一些基准的模型,还有一些还有其他的一些参数的一些结果, 近似误差,军方跟呃信息量, ecvi, 霍特林统计量的一些检验结果,这里都给大家进行了一个呈现,这个就是呢以上呢就是本节课程所讲解的关于验证性因子分析的一个结果的一个解释部分, 下面呢我们就再简单的通过这个文件来对大家进行一个讲解, 我们打开这个文件,然后我们就可以看到, 我就可以看到这个,在这个在这个文献中呢,验证因子分析是这样应用的,就是说 学者现在提先提出的一个理论假设,然后根据相关的理论假设提出了相应的研究方法,收集了相应的数据。实证检验结果呢,就说他做了八因子、六七因子、 六英子、五英子、四英子、三英子、二英子、单英子的一个模型图。验证性子分析呢主要就是作为这个一个使用,同时呢验证性子分析也会在后期的同源偏差检验里边也会发生一个作用,这得看就说单因子的模型你和结果与八因子模型相比没有显著显著变差, 说这结果表明呢,同源偏差并不是一个严重的问题,也就是说呢,验证性子分析也会用在同源偏差这个检验中,希望大家注意。 然后好了,分析完这些之后呢,我们来看一下我们第三章呢验证芯子分析的过程,现在所有都讲完了,那么我们现在来简单回顾一下验证芯子分析所讲解的内容。 我们首先讲解的验证性因子分析的概念,验证性因子分析是什么?验证性因子分析与探索性因子分析的一同,同时呢,我们还讲解了如何绘制模型图来求解 分析这个求解过程也对大家进行了详细细致的讲解。最终呢,今天的课程我们还讲解了验证因子分析的结果解释,结果解释呢,都逐条的带大家进行了一个回顾。 然后以上就是呢验证性因子分析的内容,希望大家学习完验证性因子分析的内容之后,能够熟练的运用 emox 来处理验证性因子分析的相关的理论,相关的模型。 我们这节课程呢就到这里结束了,我们下次课程呢会着重介绍路径分析的内容,希望大家能够在学习完今天的课程之后,对路径分析进行一个预习,我们下次可见,谢谢大家。
228贰壹壹项目数据分析服务 08:06查看AI文稿AI文稿
大家好,这一次的内容是我们的这个共同方法偏差 c m v 么? cmcmv 是什么意思呢?是指的是说你用了一种测量形式啊,比如说你有一个量量表,那你用了温卷这种测量形式,但温卷这种测量形式呢,也很可能的, 这一个他从上而下的是有很多两秒题,大家回答的时候呢,他也是真实回答的,但是呢,他可能会受到题与题之间的干扰, 或者是什么样的一些原因导致呢?他都比较偏好于选三四三四这样子的,其实是普遍存在的,对吧?啊,并没有说哎,有的他确实选三,有的又选二这样子,那么他是由于这种测量方式的而导致的这种测量误差,那么 我们要去肯定是要减少这种误差的情况,对吧?所以说呢,啊,那他就会有一个叫做共同方法偏差这么一个东西,那你要去测量他,看一下你的这个共同方法偏差的问题是否存在啊,或者是说严不严重之类的啊, 那么他的这个啊,测量方式呢,有几种?一个叫通过验证信息来分析啊, 啊,也可以通过这个啊,那通过探索性因子分析,也可以通过这个厌者性因者分析啊来进行分析,当然了,还有一种叫做 marker veroble 啊,对吧,这也也是可以的,但这种使用很少,最常见的是使用探索性和厌者性因者分析。嗯, 那么验探索性因子分析的时候啊,如果说你的一个量表啊,你只需要把它的这个探索性因子分 c 的这个因子提取的个数给他设为一,如果你发现了这个发生显示率小于百分之四十呢,就说明没有,如果说他大于百分之四十呢,可能就有啊,一般百分之四十是一种常见的指标,但文不同,文线可能有有有有不一样的地方, 那么这是怎么样去测量它?那燕子系银子飞机又怎么样去测量它呢?也是一样的,你把所有的这个测量项,把它放在一个框框里边,让它运行一次,如果说那些礼盒指标都不达标啊,那么就说明没有共同方法偏差啊, 这是比较常见的两种车辆方式啊,当然他还有其他的一些车辆方式啊,这个就看文献上啊,怎么样去写了,一般是探索性因子分析或者是验证性因子分析,这个要 也叫 harmman 的这个啊,共同方法偏差,那么我们来看一下怎么样去操作啊?以这个 s p s a u 系统为例啊, 我们先找到这个因子,今天方法里面因子把所有的这个两表题啊,放在一个框框里边去,放在一个框框里面去,而且因子的个数提取为一开始分析, 如果说他的这个方差减速率小于百分之四十,对吧?啊?小于百分之四十说明是没有的,那我这里是说明是有的, 因为这个是大于百分之四十的。那么我们接下来可能要讲一下,出现这种情况的时候怎么样去啊,解决它啊,或者是说减少这种情况的产生,那原理上是什么意思呢?那你提取成一个因子说明呢啊,这 十四项啊,可能表示成一个因子,都表示一个东西会比较好一点,那说明呢?很可能大家啊都是在选择的题项差不多都是三四满意,非常满意之类的,才会导致他的关系很紧密, 说出来导致啊,他所有的都集中在了一个音质上,这就是他的一个原理啊,当然了,你出现这个问题的时候怎么解决啊?第一个其实是避免这种情况产生,那么你的两秒题啊,可能给他打乱一点 啊,以及呢,还有哪些啊?收集的这个数据稍微多一点啊,因为啊以及呢还有一些注意下无效样板啊,你比如说这个数据处里面注意下无效样板啊,我们把这些选中,对吧?有可能他选择相同的数, 你比如说百分之七十十四个题,百分之七十就十个题都选一样的一个答案,那这种可能是不太真实的,他会导致这个共同方法偏差的啊,给他标识一下这个五项样本,标识 标识好之后呢,我们再来分析,当他分析之后你肯定要筛选一下,对吧?把这个筛选出来啊,把这个筛选出来等于一啊,啊,等于有效啊,其实就是等于一对吧?点这个确定 他就八十五个样本了,对吧?他就已经是八十五个样本了,有一百一十五个无效样本,然后再来分析啊, 看吧,现在是不是就没有这个共同方法偏差了?很可能呀,有很大程度上都是因为这个有无效样板,就是那些不认真回回答问题的人,他都选择同样一个答案啊,这是 用探索性因者分析啊,也叫因者分析的方法来验证这一个共同方法偏差,当然你可以查看这个帮助手册里面也有啊,帮助手册里面也有说明啊,我们搜索一下 共同方,共同方法偏差,对吧?在这里面也有描述哈。啊, 这是也叫同源方差啊,或者加入共同方法变异偏差。那么还有一种方做法呢,是用这个验证性因子分析, 在这个啊,温娟研究里边的这一个印证性印证分析,那他做法是什么?把这个所有的测量线放在一个框框里面,放在一个框框里面,然后就没有放了啊?啊?我算一下, 把这个验证性因子分析,把所有的这个测量箱放到这个框框里边看,没有啊?相当于就放成一个因子了,然后开始分析,开始分析出来之后啊,只需要看这个礼盒指标,像这些礼盒指标, 这礼盒指标啊,大部分都不达标的,对吧?其实只需要几个关键的,比如说这个什么 rmsei 值,什么 gfi 值, cfi 值,对吧?像这几个常用的指标他不达标,那就说明呢,他放放在一个因子,变成一个因子不适合,不合适的, 他本来就是应该隶属于几个维度的,结果放成一个音质了,那么他是从这个原理上来说明了这个没有存在共同方法偏差。这是啊,共同方法偏差,当然还有一种叫做 marker 万荣宝,他是用于这一个 原理上啊,他是在这个问卷里面啊,放一些测谎题,测谎题肯定和你研究的这个维度没有任何关系,对不对?没有任何的相关关系的, 因为他是测谎题,毫无关联性的。然后呢,你把这个测谎题和你的研究的这个变量做一下相关分析,你会发现他没有相关 啊,没有任何的关系,对吧?没有任何的关系,那就说明了这个测谎题他确实是 测起到了测谎的作用,他确实是没有说谎,对吧?那么就说明了没有共同方法偏差,这也是一种做法, 这是我们这一次的内容哎,同时提示一下啊,如果出现了这像这种啊,各种的这个有疑难杂疑难问题啊,这些啊,尽量的就看查看这个包装手册啊,包装手册里面应该 都会有这个共同方法偏差啊。啊,共同方法偏差,对吧?这里面也有描述的共同方法偏差,看到没有? 这两秒题放在同一个音质里面进行分析啊,结合这个礼盒指标,比如说 i m s e r i m r c f i 值来判断,如果说这个啊,这些指标都不达标啊, 那不达标就说明了没有共同方法变差,如果达标了才说明有共同方法变差啊,这是我们这一次的内容,谢谢大家。
63SPSSAU 00:11查看AI文稿AI文稿
s p s s 里的值是什么意思?
502SPSSPRO数据分析 04:26查看AI文稿AI文稿
amos 操作步骤讲解系列验证性因子分析验证性因子分析需要采用 amos 软件进行检验,验证性因子分析用于检验数据的内容效度情况,它属于结构方程中较为简单的一种模型。 amos 软件可以直接打开,也可以在 s p s s 中打开,但需要安装同版本的。在 excel 表格中对数据进行预处理后,导入 s p s s 中并保存好数据。打开 amos 软件进行内容校度的检验。 打开 amos 的界面。前变量的构建,点击椭圆,在右侧白色画布中画出对应的前变量个数。 显变量的构建,选中显变量。添加图标后,在前变量上添加对应题像数的显变量框。变量整体调整,选中旋转图标,点击前变量框旋转到合适的位置, 变量整体移动,同时选中保持整体和移动图标,然后将所有的变量移动到对应的位置。 导入数据,点击导入数据后点击 file name, 找到对应数据保存位置,并选择对应的数据后点击 ok。 显变量放入显变量框中,点击数据展示,将对应的题像拖入显变量框中。选中前变量框,点击单手指图标, 选中前变量框。变量间连接相关线,点击 plug in stroke variances 变量间的相关线就连接好。调整相关线,点击改变形状,放在最外层,拖动到想要的位置, 现调整。点击变量为调,点击想调整的地方取消选定,点击取消选定变量。名称修改,点击变量设置,在名称框中填入变量名, 添加未命名的变量。长指残叉,点击点击 propines name an observed variables 添加未命名的变量名称勾选选 项,验证性因子分析中只用勾选标准化系数即可。模型保存,点击运行后选择保存的地点,按保存名点击保存。 运行完成,在运行过程中未出现报错情况,即图中红色箭头变红,按红色方框中显示结果,表明结果运行完成。 结果查看,点击结果查看模型是配度结果,点击 model fit 就可以看到 模型的适配度指标,一般主要看 seeming d f, 即 baseline comparisons 中的指标。重要的 reserve 指标系数结果,点击 estimates, 在右侧结果框中有对应的结果标准化的因子在和系数看标准化的相关性,系数结果添加,将标准的因子在和系数看相关性添加到模型图中。首先选中标准化,然后点击上方红色箭头 模型图,即结果复制,点击复制,将模型图就可以复制到表格中。 结果整理,将结果复制粘贴到 excel 表格中。首先整理的是模型适配度, seeming d, f, v, c, r 等指标,然后是根据标准化的因子载合系数计算 evernu 和 c 二值后根据标准化的相关系数与 ever 的平方根进行比较, 最后展示模型图,然后将整理的结果复制粘贴到 word 文档中,进行三线表的制作及文字解释。 学会了么?记得一箭三连呦,可以代作指导。
482艾吖法数据 13:51查看AI文稿AI文稿
大家好啊,在前面的一节课程中啊,在那个一节验证性因子分析啊,那那个那个视频中啊,我曾经提到过 啊,关于这个一节验证性因子分析啊,分为两种啊,一种是正交验证性因子分析啊,一种是斜交验证性因子分析,对吧?啊?正交就是假设我们所有的这个前边上之间啊不存在相关系,都是相互独立的, 对吧?然后这是正交,然后呃,斜交的话就是他们之间存在相关关系,这种是叫做斜交斜交线的阴影的分析 啊,那么在那些视频里面呢,我也简单的介绍过啊,我们怎么去设置这个正交和斜交的这个约束,对吧?我们限制这个这个这个这个 弧线啊,相关的这个弧线,把这个参数设置为啊,设置为零啊,设置为零我们就可以设置为设置他的一个正交性啊,不设置啊,不设置这个参数,那么他就是一个斜交的,对吧?就是不对,他约束他就是一个斜交的,对他约束的话,他就是一个正交的,对吧? 那么呃,我们如果想要啊,当前面这个视频中我们提到的这个是我们预先知道了啊,知道的这四种啊,四种关系,他是存在正交或者是斜交关系,对吧?啊,我们预先知道了这种情况,那么如果我们啊就是说 存在两种假设啊,就是他啊,可以是相交的啊,也可以是直交的,对吧?那么这种情况下,我们怎么来通过模型的对比来判断哪种模型更为 合适呢?那么现在的话,我来给大家介绍一下我们这个异界验证金啊,这个验证性因子分析的一个啊,多模型的比较啊,多模型的比较,哪种模型更为适合啊?这种方法的话也同样适用于这个啊,全模型和其他的这种啊分析,对吧? 让我们来先看一下我们这个图啊,这个图的话还是我们的这个啊,易捷验证件印子分析的这个图啊,没有任何的变化啊, 那么首先我们第一个假设啊,我们第一个假设是他啊,第一个模型,我们假设他是存在这种相交关系的啊,存在这种啊协交关系的啊,相关的就是 这个,我们四个变量,四个前变量,他们相互之间是存在相关系的啊,那么第二个第二个假设呢?我们就要假设他们之间啊,有两组啊,有两组是, 呃,比如说这个理论认同和这个制度认同啊,他是独立的,然后其他的变量啊,是相关的啊,其他变量是相关的啊, 然后啊第三个假设,我们假设是所有的变量啊,所有的变量全都是啊,这个这个这个独立的啊,全都是不相关的啊,选正交,正交验证验证分析啊, 那么在这样的情况下啊,我们来进行一个啊操作啊,来给大家介绍一下怎么来进行这个多模型的一个比较 啊。那么第一个模型呢啊,我们不对他进行任何的改动啊,这个图形的话啊,这个图形我们就不对他进行任何的改动,因为我们假设他是一个啊,斜交的,对吧?也就是这个参数,我们的这个相关系数是不应该被约束的啊,对吧?那么我们来看一下我们怎么设置这个啊?第二个 模型啊啊,我们先,我们首先在我们的左边中侧啊,中中间这一栏,中间这一栏啊,中间这一列啊,这一列啊,这一列的第二个栏里面啊,这个模型栏里面我们双击 啊,双击,然后我们可以看到我们关于这个模型的名称,以及他的这个参数约参数限制的这个约束的这个框。那么我们把第一个先改一下第一个名字啊,改下第一个名字改成啊, model 一啊,或者是 model a, 我们改成 model a 啊, 第一个大写一下啊,啊,改成 model a, 那么这这是第一个模型啊,是我们的斜交的模型,对吧?斜交验证性印纸分析的模型,然后这个参数控制呢?参参数控制,我们啊不记得进行设置, 那么我们新建一个啊,新建一个,那么我们改成啊,改成一个 model b, 对吧? model b, 那么这里面呢? 我们限制,我们说是添加了一个约束,对吧?添加了一个约束,那么这个约束叫什么名字呢?啊?我们这里面首先看到我们这个呃,是添加的是理论认同和这个制度认同他的一个呃,这个执教关系,对吧?也就是他们相互独立的啊,不存在相关系。 那么这时候我们首先要对我们的这个参数进行一个命名啊,我们对我们的参数进行命名啊,点击这个争略的这个这个选项,然后点击这个命名参数啊,点击这个命名参数,那么我们选择对我们这个相关系数啊,相关系数对进行一个命名 啊,相关技术进行命名,就是这个啊, convice 这个这个这个选项啊,打上勾之后点, ok, 那么我们的这个所有的相关系数啊,全部都被我们命名了,命名之后我们发现这个理论认同和这个制度认同,它是它的相关系数,就是 被命名为 c 四了啊,那么 c 四啊,我来对他这个参数进行一个限制啊, c 四等于零,对吧?这就是我们关于这个,那么我们这样的话就会把这个 理论认同啊,和这个认同,这个这个给相关性,给选择成这个独立的啊,独立的相关性,那么呃, 同时啊,你也可以在这里啊,你也可以双击这个地方,然后去去改变它啊,但是这样的话会呃比较麻烦,如果你有很多的话,你可以一个一个去点啊,那么这是第二个模型啊,第二个模型, 那么接下来第三个模型,第三个模型,我们再新建一个啊,新建一个,我们是模型 c 啊,模型 c, 那么模型 c 里面呢?我们是要求所有的这个啊,所有的这个前面量啊,全都是一个,呃,不 相关的独立的一个啊,情况,对吧?不相关独立的情况,那么他呢?就是我们要就是建立这所有的参数啊,全部为零,全部为零。那么有两种方式啊,两种方式,第一种 我们一个一个输进来啊,输进来等于 c 二,等于 c 三,对吧?等于 c 三啊,等于零,对吧?这种这种方式我们输进来,那么还可以,我们还可以去套用一下我们的这个模型 b 里面的一个结果,对吧?我模型 b 也限制了一个啊, 这个这个这个母 c 四啊, c 四等于零啊, c 四等于零,那么我们这时如果你这里面 c 模型 b 里面限制了很多的话,已经限制了很多的话,你这里面就不用再重复的输入这个限制了,可以直接套用这个模型 b 的这个模型 限制。然后我们接下来,对,还有一个就是模型啊,模型五和六,对吧? c 六啊, c 五等于 c 六等于零,对吧? 那么这样的话,我们就限制了所有的这个啊,参数啊,所有的参数为这个,呃,所有的这个,不是所有的这个相关系数啊,所有的相关系数为零,也就是我们的这个呃纸胶模型啊,就已经限制完成了啊, 那么这样的话,我们现在是三个模型啊,三个模型,然后我们去点击这个运行啊,点击这个运行 啊,点击这个离合运行啊,当我们计算完成之后,把三个模型全部显示 ok 状态啊,全部显示 ok 状态,那么说明我们三个模型呢全都是离合成功了啊,没有出现这种呃不收敛的情况啊,没有出现这种不收敛的情况,那么我们来看一下这个结果啊,看一下这个结果 啊,看一下这个结果啊啊,首先啊模型 a 啊,模型 a 这里啊,我们的这个模型汇总啊,没有出现这个, 呃,没有出现这个错误提醒啊,但是这个地方的卡方啊,卡方是四千多,然后我们这个 p 值是小于零点零五了啊,这个在一般的这个模式分析里面认为呢他是一个呃不可接受的,那么那么 这种情况下我们就可以考虑的对他进行个调整啊,当然啊,当然也是有,也也是有一定的原因的,因为我们这个这个这个这个呃变量啊,我们这个样本样本数量是非常大的,因为我们这个样本数量是六百多个 啊,对于这个这种稍微大的样本的这个数据来说的话,他的这个卡方啊,是是天然的会会要大一些啊,天然要大一些,然后他的这个 p 值呢,也很容易就 小于这个零点零五啊,就达到这个显示性水平了,这个是对大样本来说是一个很难避免的一个事情啊,对,很难很难避免的一个事情,所以说这个地方我们也不用太 还在意啊,我们如果能够调整啊,能够根据这个 m i 指数啊,进行一个调整啊,进行一个调整,调整到我们能接受的范围就 最好,如果调整不不到的话,那只能是因为是我们这个样本量的一个问题啊,除非你愿意缩减自己的样本量啊,或者然后调整这个啊,这个这个这个变量数量啊,对吧?不降低这个模型的复杂度啊,否则的话你很难去有效的去降低这个卡放值以及这个啊,降低它的一个显著性, 对吧?啊?那么这是一个问题,然后我们再看一下我们的这个,呃,模型的一个离合效果啊,这个和我们之前看到的那个一件一件分析的这个结果啊,很相似啊,对吧?这是 相似的,那么同样的啊,我们来看一下我们的这个模型 b 啊,模型 b, 模型 b 他的也是啊,模型 b 也是一样的,我们这里面啊是类似的一个结果啊,对吧?类似的一个结果啊, 然后他的这个参数也是啊,参数的话这边是三个模型全部在一起啊,我们可以进行一个综合比较,这里面我们可以看到啊,我们的这个模型 a 啊,他的卡棒值是最小的,然后模型 b 增加了一些啊,模型 c 的话就增加了非常大,那么说明这个模型 c 的话,可能就对我们的这个啊,是 特别特别的这个,呃,不,不适合我们的这个模型分析的啊,不适合我们这个数据的啊,这是一个方,这是一个比较的方法啊,这是一个比较的方法,那么除了这种,除了通过这种直观的这种系数,多个系数这种比较呢,那我们还可以通过一种叫做模型 界定搜寻的一种方法啊,模型界定搜寻的一种方法,那么我们点击这个分析啊,分析里面我们有一个啊,模型界定搜寻的这个啊程序啊,我们点开 啊,我们点开,点开之后啊,在这个地方我们点击这个啊,我们点击这个 启动选项啊,点击这个启动选项,嗯,那么这样的话计算完成啊,计算完成之后我们可以看到这个模型界定的一个搜搜索结果啊,搜索结果里面呢,这个 啊,这个 c 呢,也是我们的这个卡方啊,也是我们的这个卡方,然后我们这个 d f 还是我们的自由度,还还还是我们的自由度,那么这个 c 减 d f 就是这个卡方减自由度,那么 c 除以这个 d f 呢?就是我们的这个 卡方除以自由度啊,它除以卡方除以自由度。那么呃其他的这个这个参数呢?我们主要还在看这个叫做啊,我们的这个 b b i c 啊, b i c 值和这个 和这个 a i c 值啊, a i c 值, b c c 值啊, b c c 值和这个,呃, a i c 值,呃, 有一个叫 aic 值的东西啊,但是我们这里面可以看到只有一个 bic 啊,因为我们在在在这个,在这个低版本的这个,呃貌似里面的话,它会同时给出这个 aic 和 bic 啊,那么 a s 和 b a c 它是有相相似的作用的啊,有相似的这个自然尺度,就是这个评价尺度。那么所以说在新版的这个,呃,貌似里面它就只给了一个 b a c 这个值,那么在这个里面我们主要看的就是这个 b c c 和这个 b i c 这两个值啊。那么我们这个这两个值呢,一般都是表示我们越大啊,这个值越大啊,他就越 不适合啊,这个模型就越不越不适合,越不适合我们这个数据啊。那么呃什么是最适合我们这个数据的这个指标呢?那么一般在说的话,我们要求 b i c 啊, b i c 要要是这个 小于二啊,小于二的话,那么我们是认为它是非常可靠的一个模型啊,非常可靠的一个模型。当然我们现在因为我们这个对这个数,对这个初始模型没有进行任何调整啊,所以说这里面这个 bic 值啊,是特别大的 啊,是特别大的,但是我们可以对他进行调整之后,我们再来判断这个 bic 值啊,呃,不过,呃,不过这个,呃如果你只有一个模型的话啊,你你你, 你去按照这个我们这个严格的标准啊,去根据这个啊,是否小于二来判断这个,呃模型是否合适是可以的。但是如果你呃是用来比较这三种模型的关系的话啊,三种模型的关系的话,你可以这个啊,你可以先通过这种数字大小的一个 关系,然后来判断来做一个初步的判断。那么我们这三个模型啊, abc 三个模型,显然话 a 在两个指标上都是最小的啊,那么 也就是说我们这个模型 a 相对于模型 b 和 c 啊,是一个更为理想的一个状态啊,更为接近我们这个数据的一个真实情况。那么在这种情况下,我们就可以针对这个模型 a 啊,这个模型,我们这种协交的这个验证性,因为分析的这个模型,然后我们去根据这个 mi 的 指数啊,根据这个 imad 指数进行一个调整啊,把这个模型结构进行一个优化,然后再来进行这个,呃,我们的模型这一个啊,我们那个模型的一个,呃 呃,就是说我们的这个理论分析,对吧?那么 b 和 c 呢?我们在这一步就可以把它给抛抛抛掉,对吧?就不再不再去考虑这种啊,这种直交的这种理论关系了,对吧?那么这就是我们的这个模型界定,和我们的这个啊,多模型比较啊,多模型比较。
 00:31查看AI文稿AI文稿
主成分分析只要解读 k m 值和 bartel 检验测中值和分叉解释率, kmoji 如果高于零点八非常适合进行分析。介于零点七到零点八之间说明比较适合分析。介于零点六到零点七之间,说明可以进行分析。 kmoetz 小于零点六则不适合进行分析。如果 bartel x 检验对应批值小于零点零五,也说明适合进行主成分分析, 会根据特征根大于一的标准自动确认主成分的个数。从上表可以看出,主成分分析将构建出三个主成分方差解释率代表因子提取的信息量累计方差解释率一般在百分之八十以上较好,你学会了吗?
335SPSSAU


