粉丝1263获赞1.1万
相关视频
 00:25查看AI文稿AI文稿
看好了保子们,秋叶大佬康福 u i v 八整合包横空出世,内置上百套现成工作流安装包和使用教程,我已经给大家准备好了, 跟着我操作,小白也能轻松用上,而且免费!首先点击本视频右下角分享键,点分享链接,然后打开手机上的这个,打开后会跳出一个弹窗,如果没弹的话,重复一次就有了,然后点开进入保存下载就可以了。
296大眼猫游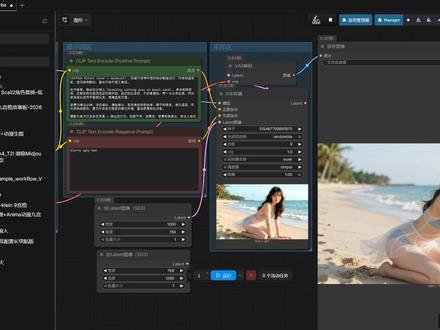 03:32查看AI文稿AI文稿
拥有全套 comui 工作流是什么体验?大家都知道 comui 很 强,就在前几天秋叶大佬更新的最强 ai 工作流,耗时七万八千五百八十八秒,我终于整理好了,内置了三百加 ai 模板,具体味道直接抄作业。多图参考生视频、 ai 仿 cg 动画视频、高清修复,还有几大神机,工作流,人物一致性等等,懂得都懂还不够?每个工作流还配备了详细的图文教程,让你直接成为 ai 界雷军整合包。感兴趣的人六六六好的,回到我们的工作流当中。其实图声图和文声图的核心逻辑是一致的, 一个是通过文字描述进行生图,一个是通过图片参考进行创作,前者更加适用于去进行创意构思,而图生图更加适合对自己喜欢的图片进行二次创作。我们首先来到基础文生图的页面, 首先我们需要一个加载图像的节点,双击空白处搜索加载图像节点,这个节点是负责将图片上传至工作流当中。那么接下来我们需要把节点连接至 k 彩样器中,但这里有个问题, 如果直接将节点拖到彩样器中是没有反应的,所以我们首先需要将 collate 先删除掉,这里的图片分辨率是可以直接 用我们上传的图像分辨率的。除此之外,我们还需要一个 v a e 编码作为图像与彩样器的转接口。之所以这样,是因为原图是像素格式, ai 是 看不懂的,得转成在前空间的图像。把节点都放置出来后,我们就可以进行节点连接了。 点加载图像的图像输出与 ve 编码器的图像相连接,再把 ve 编码器的 layton 输入, 同时记得把 checkpoint 加载器的 ve 输出连到 ve 编码器的 ve 输入,这样 ai 才能用模型的 ve 来解析原图节点之间相连接之后,那么图生图工作流的搭建就完成了。我们先上传一张图试试看效果, 提示词可以都删掉,用来做效果演示。点击运行, 点开生成好的图片,我们看到它与原图几乎没有什么关联,基本没有任何相似的地方,所以这里我们就需要去调整彩样器中的降噪,也就是重绘幅度。这里我大致说一下不同参数对图像的影响程度,比如降噪零点五到零点六, 保留原图大部分细节,只微调风格。降噪零点七到零点八改变更明显,同时保留原图构图, 降噪一点零,相当于完全重绘,只参考原图的大致风格。当然具体适合的参数还是需要根据模型或不同工作流来观察的,我们还是选择一个常用的 checkpoint 模型,那么这里我将降噪调整为零点五。尝试一下, 我们会发现除了一些细节,基本与原图的相似度还是非常高的,我们再试试零点七的参数,稍等一下, 我们会发现这次生成的图改变会非常的明显,但是它仍旧为我们保留了其风格和构图。当然大家也可以去多尝试一下 其他不同参数生成的图片。那么今天对康复 u i 的 图生图教程就结束了,喜欢本视频的小伙伴们可以三连支持一下,有需要相关资料的小伙伴可以到评论区下方回复六六六,我会逐一发给你们,我们下期见。
229AI视频工作流 00:28查看AI文稿AI文稿
兄弟们,这次真的是核弹级更新,秋月大佬又出全新的康菲又爱的懒人整合包了!这一波绝对是小白的神之一手, 不用担心本机电脑带不动我折腾半天一直报错!这个包已经帮大家把最难的安装和环境配置搞定了,真正的解压即用原生支持全中文键!最狠的是,他直接内置了市面上最主流的三百多套大神级爆款工作流,只需要把大白话敲进去,点击生成,一键搞定,东西全打包好了!具体什么味道,老规矩,垫个牌试试!
 10:33查看AI文稿AI文稿
家人们,核弹级更新来了!秋叶大佬全新 comfy 懒人整合包来了,简直是小白神器!不用折腾 python 环境,不用愁节点报错,全部提前配置好,双击就能启动全套汉画界面,零基础也能闭眼玩,还内置三百三十七套爆款大神工作流拉图就能一键生成,无套路全打包 创作的验验牌开始教学。 hello, 小 伙伴们大家好!我们将深入探索纹身图的奥秘以及提示词的语法规则,让你在使用 ctrl u i 时能够更加得心应手地创作出 理想的图像。那么我们正式开始吧!工作流程解析,首先,当我们输入正向和负向提示词后轮本编码器中的 clip 模型会将提示词转化为特征向量传递给 k 参照器。 这时候有个疑问,文本编码器 clip 模型是从哪里来的呢?我们可以看到它来自于 checkpoint 加载器,主要用于加载各种大模型。不同的大模型有不同的内置 clip 模型,而不同的大模型之间 clip 模型也可能会 有所差异。接下来, checkpoint 加载器输出会经过 ve 模型, ve 解码的作用是将经过降噪后的图像从浅空间解码为我们肉眼可见的像素空间图像。 让我们做个实验,如果我们断开 v a e 模型的连接,试图生成图像会出现错误提示,显示缺少 v a e 输入,只有重新连接 v a e 模型,图像才能 成功生成。另外,记住生成图像的快捷键 ctrl 加 enter, 这个快捷键非常实用。此外,生成图像的宽度和高度尺寸可以通过空 latin 节点来调 调整控制。比如说我们将高度调成七百六十八,注意这个数值一定是八的倍数,宽度也一样。至于批次的话,则是控制单次生成的图片数量。比如说我们设置成二好,我们按 control 加 enter 开始生成。图片生成后,我们是不是可以看到它的比例 已经成功变成了竖屏的比例,并且它依次生成了两张图像?接下来让我们一同学习提示词的相关语法。首先是书写规范,无论是正向提 诗词还是副象提示词,都必须使用英文以及英文标点符号,否则系统可能会出现识别错误。比如我们输入 one girl, garden 和 yellow dress 黄色的裙子,使用快捷键 ctrl 加 enter 生成,就能得到一个穿着黄色裙子在花园中漫步的女孩图 片。但如果我们使用中文输入一个女孩花园以及黄色的裙子生成的图片,虽然都有女孩,但黄色裙子和花园却未能很好的呈现出来。那么接下来是 提示词权重。什么是提示词权重呢?简单来说,权重就是某个提示词在生成图像中的影响力,权重越高,该提示词在画面中的占比越大。例如输入 one girl 权重一点二,而 garden 权重零点八十,生成的图像会更加突出 one girl 的 部分。那我们有什么技巧调整权重呢?比如中 括号代表零点九倍权重,降低该提示词的重要性。小括号代表一点一倍权重,增加该提示词的比重。大括号代表一点零五倍权重。用于微调权重,还可以通过快捷键调整权重。将光标移到某个提示 词上,按住 ctrl 加上箭头增加权重, ctrl 加下箭头减少权重,不过权重不能过高,否则图片会过敏, 进行失真。接下来是短句与长句,提示词长度与起手势。我相信不少小伙伴都有这么一个疑问,为什么我写提示词的时候一定是一个一个词这样去拼写,而不是用一句话去描述我们想要生成的内容呢?虽然两者都可以,但短句更能准确表达生成意图, 且便于调整权重。使用短句时可以通过按顺序调整关键词的权重,从而优化生成效果。提示词的数量也非常重要,过长的提示词可能会影响图像生成的准确性, 那么我们最好把提示词控制在什么数量之内会效果最佳呢?经过众多 a i g c 玩家的经验以及研究表明,提示词控制在七十五个之内是效果最精准的。超过了七十五个提示词的话,可能会对提示词的识别 不精准,整体的表现会降低。在 stable diffusion 各个大模型训练的过程中,会加入许多的比如四 k、 八 k 或者 masterpiece 各种各样高质量的图形去训练。当我们输入提示词的时候,比如输入四 k masterpiece 就 可以使我们生成的图像更加的精美。反向提示词的话就相反,比如我们输入模糊,就 我们不想要模糊,那么相当于也是会让图片变得更加的清晰。在输入提示词时,顺序也会影响生成的效果。在一组提示词中,越靠前的提示词权重会有所增加。所以我们在书写提示词时尽量按照以下格式。首先是提升画质的词汇,例如 masterpiece, high quality, high detail。 接着是描述主体,例如 one girl。 然后描述环境或背景,例如 garden, snow。 最后可以加入 laura 的 触发词或其他模型的提示词。为了避免多个提示词相互干扰,可以使用 break 命令来隔开它们,尤其是避免颜色污染。若要融合多个提示词,可以使用大写的 end 或 符号,也可以使用书写风格不同的关键词,从而创造出新的组合效果。比如我们写 one girl, cat 这边我们可以看到生成了一张女孩和猫的图片。好的,现在我们在 one girl 和 cat 之间添加上 and 注意这里的 any 必须 是大写。这边我们可以看到生成了一张猫娘的图片。这个 any 作用就是将两个提示词融合在一起。我们还可以通过调整迭代步数,精确控制生成过程中的每个阶段。格式为 提示词一,提示词二权重数值。权重是指提示词一的权重。当权重数值大于一时,单位为采用迭代步数。当权重数值小于一时,单位为采用迭代步数。百分 比。例如,想要前百分之三十生成 forest, 倾向后百分之七十生成 one girl, 只需要输入 forest, one girl 零点三, 其中零点三代表百分之三十的比例。当采用迭代步数为三十时,表示前九步用于生成与 forest 相关的内容,后面二十一步用于生成与 one girl 相关的内容。在介绍图生图的工作流之前,我们先来讲讲什么是图生图。在我们使用图生图功能时,我们一般使用一张图片与一组 关键词共同作为输入生成的图像,这样受到这两个输入的共同调节作用,比如使用下面这张初级草图以及一段指令作为输入图,升图功能会将其转化成一张完成度较高的图 片。图。升图基于 stable diffusion 模型,将输入的原始图片转化为模型能够理解的潜在空间表示,再结合用户输入的提示词在潜在空间中进行有针对性的修改和优化。最后将修改后的潜在表示转换回图像空间,生成新的图片。 同时选择合适的模型很重要,不同模型对不同类型的图片生成效果各异。接下来我们回到 confui 中,我们先加载一个默认工作流,随后将 call latent 给删去。接着我们点击 latent 拖出来,选择 v a e 编码,那么我们就成功加载了 v a e 编码器。接着我们将 v a e 编码器的 v a e 输入连接到 checkpoint 加载器的 v a e 输出上。随后我们将图像节点给拖出来,选择加载图像 load image。 这边我们上传我们需要的参考图像,这边我上传的是一个戴着蓝色帽子的小姐姐。接下来我们要编辑一下提示词,这边我们可以接一个 w 一 四反推提示词节点,方便我们获取图片精确的描述提示词,然后将我们的正向颗粒文本编码器转换成输入。接着把 w 一 四反推提示词 的自辅串端接到输入端的文本处,副向提示词一般输入模糊、最差质量、低质量、低分辨率水印等。现在我们来到到采暖器这里,可以看到这边有个降噪,我们将该值修改成零点六,对于降噪值,零点三到零点五之间属于安全的重回幅度区 区间,而零点五到零点七则赋予了 ai 更多的想象与发挥的空间。那么低于零点三或者高于零点七,图像都有可能会发生扭曲变形。那么这边我们取个中间值,将数值设置成零点六,生成一张图片试一下。这边我们可以看到生成的真实人像跟目前给到的图像, 无论是帽子还是服饰都是很相似的。那么我们把数值调成零点四五,再生成一张,来看一下效果是不是又更好一些。如果你觉得图片不太满意,那么我们可以多生成几张,直到得到你满意的图片为止。接下来我们讲一下什么是高清修复,比如说我们现在生成的这张图片我们非常满意,那么我们怎么 增加它的分辨率以及图片的细节呢?我们回到 k 彩样器,我们先将种子值选择固定模式,双击界面的空白处输入 upscale, 然后我们选择 latent 按系数缩放,我们将该节点的 latent 输入 连接到 k 彩样器的 later 输出上。随后我们按住 alt 键,点击 k 彩样器拖出来,那么我们就复制了一份相同的 k 彩样器。我们将这个 latent 按系数缩放的 latent 输出节点 连接到我们新建的 k 彩样器的编辑输入中。最后我们将文本编码器的条件输出分别连到 k 彩样器的正面条件以及负面条件上。模型也是一样,我们回到 checkpoint 加载器,将模型连接到我们新建的 k 彩样器上。随后我们回到新建的 k 彩样器中,我们将步数设置成二十五步, f g 值五就可以,彩样器和调度器默认就可以。接下来我们新建一个 ve 解码器,随后我们将 ve 解码器的 ve 输入端连接到 checkpoint 加载器的 ve 输出上,接着我们新建一个预览图像节点,最后开始生成。好,现在我们可以看到生成的结果,五官是和原图非常相近的, 我们再来对比一下图片的细节,放大之后我们可以看到右边,也就是我们新生经过高清处理后的图片细节要比原图多很多,图片还是比较清晰的好。这时有的小伙伴可能会说,这还不够清晰,那怎么办?别着急,我们还有高清修复的方法,接下来我们将进行第二重高清修复,我们搜索 s d upscale, 就是 这 sd 放大,接下来我们将这些节点一个一个的连上。首先是图像,我们连接的是这个 v a e 解码之后的图像输出,接着模型我们还是老样子,连接的是 checkpoint 加载器的模型输出,接下来是正负相条件好,我们连接 v a e 模型,接下来点击这里 选择我们的放大模型。四 x ultra, 这个放大模型是我试用下来效果最好的。最后我们加载一个预览图像节点,我们点击开始生成,图片已经生成出来了,我们可以放在一起对比一下效果,这张图的分辨率已经达到了二 k 的 清晰度,我们可以看到细节都还是不错的。然后我们再来和第一次放大的图 片来进行对比一下,差异还是非常大的,这时有的小伙伴可能会说,觉得这张图清晰度还不够,那怎么办?别着急,我们还有最后一重放大之后, 也就构成了所谓的三重放大,这边我们搜索 upscale, 接着选择这个图像,通过模型放大,这个节点非常简单,只有两个输入以及一个输出。图像的话,我们连接到 s d 放大之后的图 放大模型,这边我们同样选择的是该模型,随后我们加载一个预览图像节点,好,我们可以看到最终生成图像已经出炉,我们来欣赏一下它的效果到底怎样?这是一张达到四 k 的 图像了,清晰度非常的夸张,发丝都看得见,完全没有那种模糊马赛克的感觉。我们再来对比第一张,小伙伴们觉得怎么样呢?图升图 以及三重放大的效果,这是我们的原图,然后这是我们图升图之后,这是第三重放大。
1037AI绘画妞妞 01:15查看AI文稿AI文稿
东西在身上, 你会爱,他们 也自娱 自乐。悲伤,但我这边的人最大的一面只是。
6079耳机煲兔(🎶版) 01:00查看AI文稿AI文稿
嗨,如何通过手机号查询对方的信息呢?有的时候我们会接到 sorry 电话或者陌生电话,不确定对方是谁,那么下面几点建议也许会帮到你,通过手机号看一下对方是谁。 第一,通过营业厅查询,去该号码通讯商的营业厅,帮该号码进行花费充值,要求开具发票,发票上会显示该号码所属人的个人信息。 第二呢,通过支付宝查询,打开支付宝直接搜索该手机号码,在操作过程中会出现对方的姓氏和名字的最后一个字。 第三呢,通过期限宝、天眼查起查查等软件进行查询,直接输入对方的号码,点击搜索会显示出绑定了该手机号的企业公司,了解到对方相应公司的名称、地址等。第四,如果发生了侵权行为,立刻报警,公安会帮忙核实对方的身份信息。 当然,害人之心不可有,防人之心不可无,适当了解一些法律知识,对于我们的日常生活是有帮助的哟。
1.0万微尘里娜一缕风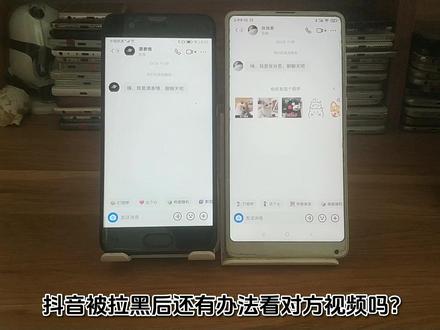 01:04查看AI文稿AI文稿
抖音被拉黑后,还有办法看对方视频吗?好,现在这两个是正常的好友关系。拉黑之前是可以进入对方的主页的,就是可以看到他的作品,现在我们直接把他给拉黑,右上角三个点,然后这边有一个拉黑,确认拉黑 好,我们再重新返回,然后进入他的主页,拉黑过后对方的主页是这样的,那么还有什么办法能够看到他主页的视频呢?我们先返回进入抖音设置, 然后往下边翻最下边一项退出登录退出。 好,现在我们点击右上角的放大镜,搜索一下对方的昵称,当然如果是抖音号更好, 好,又能看到他的作品了,我们点击进去就是这么简单,有这方面困扰的朋友可以去试一下。
8327设置侠 00:58查看AI文稿AI文稿
哈喽,大家好,关于我的法令纹是怎么从之前这样变成现在这样的,这里给大家分享一下我自己一直在用的方法。首先我会用到这两个东西,一个是这个鸡血干软膏,还有一个去法令纹的护理膜,我一般是拿这个鸡血干涂在我这个法令纹的地方, 用手指去均匀的涂抹,我是鼻子两边比较干,然后用它去舒缓一下我的皮肤,涂开之后敷个五六分钟让它吸收就行了, 现在吸收的差不多了,然后就可以拔掉,然后就是拿出这个胶原蛋白的护理膜,也是一样挤在这个法令纹的地方, 我一般都是晚上厚敷,一定要厚敷,不要抠搜的去用它均匀的涂抹,和刚才一样,等待大概十到十五分钟左右,时间到了,看到现在已经吸收的差不多了,然后我们就可以正常的去洗脸护肤了。
24IU 01:46查看AI文稿AI文稿
个人认为是哔啦哔啦讲雅思大神级别的九位 up 主,别相信轻轻松松雅思就能上期的说法, 雅思没有捷径,但是找对学习资源确实可以少走很多弯路。我没有报高价课,全靠 b 站上的视频,最后八点零上岸了。今天分享我亲测的大神级别的 up 主。 不知道考雅看啥课的,直接来听乔来雅斯阅读提升,他讲黑顶题和判断题很有一套,不是带你逐句翻译,是教你怎么拿题干里的词回原文卡位置。我原来一篇做四十分钟,跟完他的方法压缩到二十分钟以内。不爱学习的木木小作文,他专门拆了动态图,静态图怎么写,概述段怎么挑,主要特征,它的框架都是能直接套的, 看完直接拿真题练就 ok。 梅林的胡子肯大刮大作文,他会用真题示范怎么从题目里拆限定词,比如 some people think to what they stand, 完全是两种打法。 先教你审题,在总结模板小黄雅思听力速成,他会手把手代练听力真题,而且还会免费提供 pdf, 每节课就三十分钟,专讲怎么在录音开始前从选项里反推考点,适合考前突击手感。刨着老师听力高频词, 他把剑桥真题里重复出现的填空词扒下来,按场景归类,图书馆旅游、学术讨论这些用的先听再拼写的形式,跟着背完再去听真题, 反应速度能快一截。三言两语杂货社外刊精读两个同传出身。精读外刊时不光讲词句,还拆文章逻辑结构,长期看对阅读速度和写作思路都有帮助。不是短期题分型,但属于打底子的 瑞秋英语 richuo 口语发音,美式发音的地道程度没话说。他把中国人容易发错的原因连读弱化挨个拆,适合每天花十分钟跟练刘黑眼圈子口语串讲。他用个人经历做素材库,教你怎么把旅行这个话题串导 难忘的人。重要决定这些事,能省具备几十个素材的时间。米勒学长速成语法三小时的课,专挑雅思写作里高频出现的语法点,比如定语从句和非谓语,他会给你看错误句子和正确句子对比。


