连接数据,连接本地数据库 mesco 如何连接本地 my s q l 数据库?在 python 中,我们可以使用 mesco connector 拍粪库来连接 mysql 数据库。你可以通过以下步骤进行安装,打开命令提示服务或终端,并运行以下命令。安装完成后,你可以使用一下代码来连接到 mysql 数据库。在上述代码中,我们首先导入 misco connector 库病,使用 connect 方法连接到 my s q l 数据库。在 connect 方法中,我们指定了数据库的主机地址,用户名,密码和数据库名称。 然后我们创建一个游标对象,并使用 execute 方法执行 select 语句来获取查询结果。最后,我们使用 factor 方法 获取查询结果,并使用循环打印查询结果。请注意,我们也可以使用其他方法来获取不同的查询结果,例如, feature 方法用于获取异形数据。希望这个势力能够帮助你更好的 理解如何连接本地的 my s q l 数据库。 谢谢!欢迎订阅关注点赞!
粉丝463获赞611
相关视频
 02:33查看AI文稿AI文稿
我作为一个数据库成员,小强挑战一下让叉的 g, b, t 来模拟卖 sky 数据库。来,我们看一下是不是能够真的实现。再加一个 creat time 的字段 的一层 i, 然后再加个 default 啊, default, colors and stand。 这个就表示说会自动根据当前时间生成数据。好 哦,他已经很快就建完了,然后已经看表出来了没有 go, ok, 还是非常厉害的。这个 d d l 也解析的很准确,我现在四个字段他 都已经放进来了,然后这段类型以 for 的值,他都按照我的指令。呃,做好了。好,我看一下里面有没有数据,或者是骗我的, ok, 呃,没有数据是正确的,因为我现在是创建了一张工表。那我现在要插入数据 name fix great time 就不用了啊, play time 应该是自动生成的,我也想测试一下它的这个当前时间。 nine date, nine date 是我们产品的名字,专门做数据迁移,数据管理的这些,呃, nine date cloud, 这是我们的网站的地址哦,查一条记录进去, ok, 看起来查录时会成功,看一下数据在不在。嗯,踢一脚, ok, 这数据已经返回了哎,但是我们看到很 有一个意思啊,他,我这个表有一个 crate 字段,他没有查询出来,那说明他这个地方的语意理解应该是出了一些问题的。或者是把我的数据给我,我再查一下,看一下他能不能出来啊, 因为我有四个子弹,他现在只返回了三个子弹哦,还是没有出来。
28NineData 06:13查看AI文稿AI文稿
什么是 lma index? 简单来说, lma index 是 一套专为大语言模型设计的数据连接中书, 它就像一个中间层,让你不需要训练或微调模型,就能让 chat、 gpt 这类通用模型读懂你自己的文档、数据库或各种私有数据,并给出精准回答。 本篇文章会带你拆解 number index 到底是什么,它解决了什么根本问题、核心工作流程是怎样的,以及它在真实业务中如何落地。无论你是开发者,还是对 ai 应用感兴趣的设计师,这几个概念都能帮你建立起清晰的认识。 大语言模型虽然强大,但他有两个明显的短板,第一,他的知识存在截止日期,训练完之后发生的事情他一概不知。第二,他对你的企业私有数据一无所知。比如内部产品手册、客户沟通记录、项目文档。 如果直接把一份上百页的 pdf 丢给他,他要么因为上下文长度限制报错,要么只能给出笼统模糊的总结,可能性极差。 number index 就是 用来解决这个连接问题的,它不替代模型本身,而是把杂乱的外部数据转换成模型能够高效消费的结构化。所以 可以把他想象成一个聪明的图书管理员,你给管理员一堆散乱的书籍和手稿,管理员把这些资料编目成缩影卡片。当有人提问时,管理员不是让提问者看完所有书,而是先查卡片,找出最相关的几页,再把这关键的几页递给读者。 lma index 做的就是类似的边幕与剪索工作,最后把相关信息打包成模型能看懂的上下文。这个边幕过程在 lma index 里被称为,所以建立。 当你把一个原始文档喂给他,他会先把文档拆分成一个个较小的节点,每个节点就是一段相对连贯的文字片段,比如一个段落或一个章节节选,这一步叫解析, 然后这些节点会通过嵌入模型转换为向量,存储到向量数据库或内存中。此时这些原本堆积的文本就变成了一张可以快速查询的语义地图, 但这只是基础。那么 index 真正的巧思在于,它提供了多种缩影结构来应对不同场景。例如,最简单的向量缩影会用语义相似度直接比对问题和节点,适合通用问答。 如果你的文档自带树状层级,比如文件的章节目录,那就可以用树形锁影,它会在提问时先自上而下,便利找到最相关的分支,再细看里面的叶子节点。还有一种叫列表锁影,更适合把所有文档看一遍再回答的摘钥匙任务。 这些锁影就像是不同的查阅策略,你根据问题的性质选用不同的策略。锁影准备好之后,接下来就是应用的核心环节查询。 当用户提出一个问题, lma index 的 查询引擎会启动一个三步走的流程。第一步是解锁,根据锁影从海量文档中快速抽取出若干最相关的节点,通常只有几个或十几个。 第二步是后处理,对这些解锁到的节点进行去重排序甚至压缩,保证不重复、不融长。 第三步是响应合成,把这些精炼后的信息作为提示词的一部分,连同原始问题一起发送给大语言模型,要求模型基于提供的信息深层回答。 这一套流程本质上实现了带着小超进考场。模型只负责根据小超作答,不依赖他不靠谱的内部记忆。为了更具体,我们来看一个真实场景。 假设你在一家电商公司,想把过去三年所有客户投诉邮件做成智能助手,让客服同事实时查询类似问题是如何解决的? 用了 my index, 你 首先配置一个数据连接器,自动读取邮箱或 csv 导出的数据。接着它会把这些邮件内容建立成向量。所以 之后当客服输入顾客收到破损商品,情绪激动要怎么回复?十、系统会解锁出历史上最相似的五六封相关邮件,并把原文片段和解决方案一并推给大模型。 模型在几秒内就能生成一个参考话术,既包含安抚话术,也给出具体的售后流程,并且可以注明参考来源是哪几封邮件, 这就比让模型凭空编造要准确得多。更进阶的玩法是把它封装成智能体,也就是 agent。 在 agent 模式下, lma index 的 查询引擎变成了大语言模型可以调用的工具之一。模型不仅能查找资料,还可以自主决定何时去查,查什么、查几次。比如同一个问题,如果第一次解锁到的信息不够确定, agent 会自己换个问法再查一轮。 这样一来,他就从一个被动解锁器升级为一个能自主多步推理的虚拟助手。到这里,你可能会问,这和直接微调模型有什么区别? 微调是让模型死记硬背一套新知识,成本高、更新慢,而且一旦有新文档就得重新训练。 lama index 则是外挂一个可以随时更新的缩影库。模型的知识跟着数据实时走, 两者并不互斥,但在大多数需要实时知识快速挺起的场景中,缩影方案显然更灵活经济。综上, lama index 的 定位不是模型,而是模型与你数据之间的翻译层。 他用缩影抽象化技术把任何形式的外部数据变成模型可理解的上下文,再用简所合成列入,让回答有据可查。 你可以把它看作是一种为私有知识赋予对话界面的快捷方式。从内部知识库自动化报告生成到面向客户的智能客服, 它都在成为一种日渐流行的基础主见理解,它相当于掌握了把大语言模型能力真正切入业务闭环的关键钥匙。
36仁戈AI 智能体 01:25查看AI文稿AI文稿
如何让加级 bt 从一万字的资料里找答案?官方势力明确给出了方案,使用 abending 构建销量数据库的办法来解决这个问题。 知识库话术大全解决方案分析报告,这些资料导入都可以用。是不是听起来一头雾水?其实很简单,就是画整为零,话不多说,直接上干货。死磕了几天,代码又写了一个,拍成脚本, 使用 openi 指定名为 test abending a 的模型来构建香料数据库用作。所以 我去网上随便找了一份关于 chagbt 的报告来做演示,把包括内的文字内容全部粘贴到一个 word 文件中,不做任何的格式修改,一共七十八页,一万七千字。 运行拍摄脚本,输入刚才的 word 文件路径,再输入 open ai a p i k, 脚本就开始转换工作了。等十多秒左 左右,项链数据库文件就生成了。可以看到刚才报告的内容已经被切分成很小的片段,并且带上了项链缩影。用这个办法,再多的文件和内容都可以进行转换和使用。当然养成习惯,记得看看又消耗了多少头啃。 然后我们向 gpt 提问时,通过查询锁引库,就可以让 gpt 从锁引中找答案了。今天世界有限,我急着找 opens 开发主管解决我 gpt 是 aps 使用的问题,如何使用锁引库提问?这部分内容明后天再更新。今天的视力教程和代码还是在星球老地方,觉得有用记得点赞收藏。
724暴躁哐哐 02:38查看AI文稿AI文稿
大家好,最近恰的 g p t 真的很火,我作为一个数据库成员,主要想挑战一下让恰的 g p t 来模拟 mcco 数据库。来,我们看一下是不是能够真的实现。 呃,直接开始啊。我现在已经打开了掐的 gpt 的网站。那我已经准备好了指令。我告诉他,你要来充当一个卖 circo 数据库服务器,并且假设里面有个 nine data 的数据库啊,并且准备好了一张优则表。有一亿条记录 啊,我会从啊用录的账号从买搜狗客户端登录。那我输入搜狗,他就给我返回结果。那因为叉的 gdp。 呃, gpt 有时候非常啰嗦,所以我要告诉他,你不要解析指令,你不要管指令是不是正确,只要直接返回结果就可以。 好,那我指定已经发出去了。现在等待他是不是能够正确的识别。好,现在看起来是一切正常。 那现在我要输入指令。嗯,我先看一下他给我模拟的是什么版本的 mac 口。我先用 watching 的函数看一下。 ok, 八点零点二六。呃,这个一个应该是二一年发布的一个 mac 的版本,还算是比较新啊。 show database 看一下 这个 my data 的数据库。哦,已经介绍了,这个是和我的指令是一致的。好,那我切换到 my data 数据库下面。 好,切换成功。那我。呃,我看一下表,我的 u 则表有没有建好。嗯,好,已经有了。那我看一下 u 则表的结构。 ok, 他已经自动给我加了建了一张表,有四个字段。这个其实我是没告诉他的,他是自己虚拟出来的。好,我看一下记录数是不是。我告诉他是不是一亿条啊。开头跟他讲了。 嗯,看起来是正确的啊。一亿条记录。然后 呃我想再新建一张表,看下他能不能呃操作 table t。
21NineData 01:05查看AI文稿AI文稿
当走 type 与口袋实现联动时,就会像我这样,只需要一个指令,它便能够自动解锁文献并导入走 type。 并且啊,文献的相关度和质量都非常高,它的实践方法呢,也并不困难,因为口袋啊早已在软件里做了走 type 的 插件,这比使用我们上期提到的 skill 都要方便很多。 直接在插件这里找到走 type 后进行安装。完成后,可以先给口袋一个与走 type 互动的指令,检查一下是否实现了有效的连接。 没有问题后呢,我们便可以在对话框里限定数据库与剪辑主题,进行文献的剪辑与导入。如果还是担心剪辑的效果,那可以添加一下与 academic research 相关的 skill, 之后再进行剪辑。这里在给入导入指令时啊,可以加一条指令,就是让它延迟一下等待的时间,不然就可能会出现多次重复导入的结果, 导致我们的数据库里会出现很多的重复条目。整个过程完成之后呢,便能够轻松的实现文件的解锁与导入这个功能了。后续如果说想进阶使用的话,那就是可以利用 codex 的 自动化功能,在这里设置一个每天定时解锁的任务,这样呢,每天可以实现自动化的文件解锁与信息的更新。
4961小徐读博记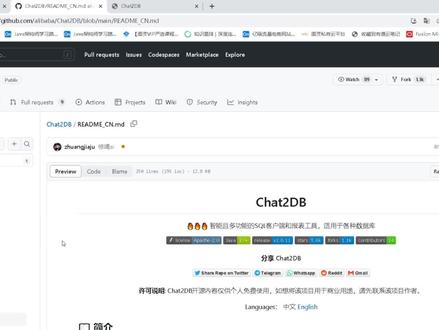 12:22查看AI文稿AI文稿
哈喽,大家好,我是徐树,现在人工智能非常火对吧?来给大家介绍一款阿里巴巴开源的一个 ai 智能数据库的客户端操作工具,它可以像我们哪位 k 的一样呢,去执行数据库操作,并且对市面上的一些主流的数据库呢也都支持, 并且他还提供了很多的一些 ai 的功能,比如说他能够将我们的自然语言转化为 cycle, 也就是我们通过中文的方式呢,告诉他我们要查什么数据,然后筛选什么条件,他会为我们自动的生成 cycle, 从而呢提高我们研发人员的一个开发效率。 然后呢,还可以给他一条 circle, 他可以给我们进行 circle 优化的建议,这一点对我的冲击还是挺大的,因为徐叔老师就在前几天我就讲过一个买 circle 调优的系列课程,在看完这个功能啊,我就在想那程序员还需要去学买 circle 调优吗?其实我觉得还是有必要去学的,毕竟他 提供的这些建议呢,并不是百分之百都正确啊,当然他提供的这些建议也都非常的中肯,也遵循了呃所引优化的这些策略。但是呢,我们用过叉的 gpd 的同学应该都能知道,虽然他的答复呃非常的强大对不对,但是也不是百分之百都能信的。 所以说呢,我们还是得去通过他的建议去做一些衡量,哪些是确实可以用的,哪些呢,还是需要我们自己去做一些思考的一些东西。当然如果是有完全不懂买蛇口调优的, 你可以通过他的一些优化建议呢,确实能有很大的一些帮助。好吧,待会我们来体验一下。然后呢他除了我刚刚说的这些 ai, ai 的智能助手功能以外呢,他还提供这个团队协作,这什么意思呢?就是这个 呃这个工具啊,叫做叉的 two d b, 它除了提供这个安装版本以外,好吧, windows, mac 它都支持,它除了支持安装版本以外呢,还支持将这个叉的 two d b 呢部署为一个 web 服务器,好吧,部署为一个 web 应用, 那我们所有的程序啊呢就可以通过外部应用去访问访问这个地址,从而呢呃不需要知道这个数据库的用户名密码,那这样的话就将我们数据库的用户密码呢隐藏了起来,增强了我们数据库的一个呃账号安全。 那安装起来呢也非常的简单,我们只需要通过他提供的这个地址来进行安装就行了。这是安装版本啊,那你要进行部署的话,他官网呢也提供了相应的说明,按照他的这个说明你去部署就行了。那我就带着大家呢通过这个安装版本来查一下先。那首先呢 我们需要去创建一个连接,这没什么说的对不对?那创建完连接之后呢,我们去添加一个查询窗口,那此时呢它会提示你需要去配置 ai 的功能,否则的话这些 ai 的这些功能你都没法用啊,因为它是基于叉的 g b t 来 开发的,所以说我们要首先呢配置这个叉的 g p t 的一个 key, 好吧。然后呢还需要配置一个代理,因为你不配置代理的话,你需要翻墙。那官他他其实官网呢也提供了这个代理的地址啊,大家可以用他官网提供的这个地址,就这个。 ok, 那拍完之后呢,我们就可以去使用了,我带着大家呢稍微去感受一下,就比如说我让他帮我查询用户名名称和所在部门,然后我通过点击这个自然语言转换 cycle, 在这里呢,我选择我的用户表,因为我需需要他呢 去帮我查询啊,用户名称还有所在部门,那我还给他呢提供部门表完了之后,我们可以看一下,他就会为我们呢去生成 cycle 语言,这个 cycle 呢啊,当然你如果在酝酿到我们真实的项目当中,你还需要稍微的去更改,对不对? 然后呢我们再来看一下这个 circle 解释,这个 circle 解释其实我觉得用处也不是很大,他只是基于这个 circle 呢,告诉你 他做了什么事情,但是他并没有啊,关联我们的业务,因为我们通常我们作为程序员单在项目当中提取到了一条 circle, 比如说这样一条复杂的 circle 啊,我是新接手的一个开发人员,我想在这个 cycle 上面去加一个查询,实际上是非常困难的,对不对?那其实我们更希望的是 ai, 它能够告诉我们这个 查询他做了什么事情,然后我告诉他我要加一个什么查询,他能够立马给我改动,那这是我们最理想理想化的,对不对?但是这做不到,好吧,所以说他只能基于这个 circle 告诉你这个 circle 它是有什么作用,其实这个意义并不是很大,对不对? 然后呢我们再来看一下 c 口优化这个功能,我是觉得还是还可以的,我们来感受一下,好吧,就比如说我来让他优,帮我优化一下这个 select 心 from 这个, 让他提供一下 circle 优化的建议。那我们之前学生老师在讲这个买 circle 调油系列课程里面就讲过,不要去写 sale 的心对不对? 因为首先呢,他会把我们一些不必要的字段给查出来,增加我们的一些网络传输成本,然后也增加了买 cycle 的一些 cpu 的消耗,对不对?然后呢, slex 星呢,他也不能使用,所以 覆盖,所以说呢,我们尽量不要去使用 select 心,你看他提供的建议也是说了,尽量避免使用 select 心,对不对?然后呢,告诉你只查部分列。 然后呢,他说表如果有大量的数据,可以添加 word 来限制这个查询结果,他意思呢,就是叫你再找你不要查全表的数据对不对?如如果表里面大量的数据呢,你的查询效率肯定是非常慢的。然后呢,他说 如果查询需要使用排序的话,你需要给排序,你需要注意排序会增加查询时间,这些都可以看一下,好吧。然后呢,我们再来看一下这个模糊查询, 那模糊查询我们之前也都说过,如果你使用这个前模糊的话,会导致所以失效,对不对?只有使用后模糊,他才会使用到 锁引。那我们看一下他的优化建议啊,他使用锁引,对 nicklem 呢,去创建锁引来提高查询效率。 那在这里呢,我想问一下大家,假如说我是这样的一个模糊查询 nicknam, 它的锁引,假如说我为它创建锁引, 通过他的这一条优化建议,我创建了,所以这个所以有效吗?其实并不会生效,他还是会进行全标扫描,因为你使用的是前模糊, 至于为什么的话,可以去看一下徐老师之前讲的 myseco 调油系列课程,好吧,里面有详细的去讲解了。你要知道为什么的话,你肯定得通过呃锁引的一个底层数据结构来进行分析, ok? 所以说我之前说过,虽然他提供了这个 circle 优化的建议,确实也非常的中肯,对不对?也确实遵循了这个所以优化的策略,但是我们作为程序员呢,你还是得在中间呢去做一个衡量。就比如说这条建议, 他让你添加 nickname 的锁引,其实加了之后还是会失效,对不对?他并没有告诉你,所以说如果你不懂这个买 co 调优的话,你加了之后这锁引为什么没有生效?你只能一脸懵逼对不对? 因为现在的这个 ai 它还没有发展到,就是说我们完全通过中文来告诉他,我要实现一个什么样的功能,他直接通过 circle 来生成,并且呢,帮我做好 circle 的优化,所引的优化 我完全不用去管,他还没有,他还没有达到这么强大的程度,对不对?还是我们程序啊呢,得在中间去做一个衡量好吧? 然后呢,他说你可以使用全文锁引,因为我们之前也说过啊,你使用模糊查询的话,前模糊会导致锁引失效,对不对?那使用全文锁引他的效率呢?会更高。当然你也可以通过比如说也来 text 啊,去代替这种 啊,这种需要全模或查询的这种方式,好吧,然后其他的你们也都可以去看一下,好吧, 那这个呢是 circle 优化,那更多的一些 circle 语句你们可以自己去尝试一下。我在这里呢也在想啊,就是说我们 真实开发当中一条非常长的 circle, 会不会导致这个工具直接无法提示呢?我自己也尝试过,其实他还是能够给出 circle 优化建议的,这个是我在项目当中一条这样的查询报表的一条 circle 语句,我们来看一下他的 circle 优化能不能给出来, 你看他还是依然能给出来的,虽然你的这个 circle 语句非常的长,对不对?他说呢,你可以使用这个脚影来代替此查询。然后呢啊,避免使用函数,我之前也提示过一次啊,之前那一次更加的精 准一点,感觉这一次还不是非常的精准,我们再来让他提示一遍,好吧,感觉这一次的这个优化不是非常的精准, 他之前呢就明确的告诉我,他说你不要在这些列上面呢去使用这些函数,建议我呢在代码当中去使用,因为我这个函数说白了就是取他的这个小数点后两位,对不对?他建议我呢在代码当中去使用,其实这个建议也是非常的中肯,对吧? 然后呢使用交警去代替此查询,等等等等啊,我主要是想表达呢,他虽然这条 circle 语句非常长,也不会导致他啊无法给出提示,他还是能给出一些提示的,对不对?然后呢至于给出来的提示实不实用的话,你作为程序员,你得在中间呢做一个 判定,对不对?然后呢是一些其他的就没有什么特别大的亮点了,还当然他还提供了一个这个机器人的功能,就比如说我们可以跟他进行对话,我们告说啊,这个比如说覆盖缩影 有什么作用?然后呢选中我们通过这个机器人呢,也就是通过叉 g b t 的方式呢来进行对话啊,那他呢就会回答你这个问题了, ok, 这是他的一些最基本的功能啊,还当然他还提供你执行你的 seq 语句,当然这是一个数据库的客户端工具必备的,对不对 啊?当然他虽然提供了这个数据库的一些执行操作,但是他我感觉还是没有办法去代替我们的。呃,乃 rikit 啊,因为你像乃 rikit, 他还提供了非常多的一些好用的功能,包括你像呃,数据库的导出 导入啊,对不对?数据库之间的同步啊,还有你像一些啊,模型图啊,对不对?等等等等啊,奶维 k 的它提供的这个功能呢就更加的全面,那这个工具呢,它还是主要侧重在 ai, 所以说我们现在开发你不要指望用这个去代替 navikate 的好吧,呃,你代替的话反而有可能会让你的工作效率去降低。 当然我建议大家在项目当中你可以怎么去用呢?你可以把它去部署为一个外部项目,好吧,让所有的开发人员呢都可以反问他,然后呢去通过数据库去做一些呃, cq 优化建议 对不对?可以大家一起去使用这一个外版应用,但是你说代替哪位 kate? 确实现在我感觉还做不到哦,一个是他这个工具提用的功能呢,还没有哪位 kate 这么强大而一个呢,虽然提 提供的 ai, 但是我们可以想一下,你现在也只能在这个 circle 语句的基础上呢,去给我们做一些普遍的 公用性的一些建议,对不对?那我们真正希望的 ai 呢,是能够我让他给我根据业务去查询一条 c 口,他直接帮我生成我想要的,哪怕改动呢,也是极小的对不对?并且能够帮我直接呃创建我的所引对不对?创建表这些都给我做了 是不是?然后呢,我们还希望的 ai 有什么?就比如说我们的项目部署到服务器之后呢,他帮我监控我们的啊, mount circle, 一旦监控到呢,给我们进行 程序员进行提醒,并且给我们相应的啊优化建议,或者他自己直接就给我们在项目当中就给优化了,然后自动给我们重启,这是我们最新 想要的这个人工智能,对不对?那现在呢,确实也也只能怎么样,也只能给那些不懂我们的买 cco 调优的同学呢,能够有一些更好的呃 cco 优化的建议,那其实懂得懂买 cco 优化的同学,你也不需要这个东西,对不对? 好吧,那这个工具呢,就给大家讲到这里啊,如果有需要学习 mysco 调优的同学呢,可以去关注一下徐州老师之前讲的 mysco 调优的系列课程, ok, nice。
329徐庶讲Java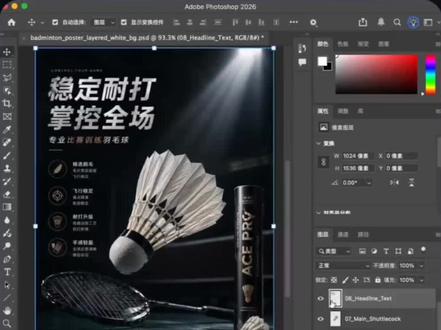 00:45查看AI文稿AI文稿
因为这样模型除了能够深图,它现在还能够生成自己的分层文件,非常的厉害,我来实操一下。首 先生成一张羽毛球的电商海报图,然后给它生成好了以后呢以后我们输入这些词,帮我生成层可以打开的分层的的 p、 s、 c 文件,然后把生成的可继承若干元素,每个元素呢可要改变位置,在 ps 里面生成对应的图层,底色为白色,不要改变银度。然后来稍微短一些看看效果。 生成好了以后呢,我们点下载分层 p、 s、 d。 然后来 ps 一 打开,可以发现画面里的每个元素都有深沉的图层,而且可以移动位置,如果你需要做一些微调跟调整,就非常的方便了。有个小要点是这里需要打开思考功能,你去试试吧。
461全球视频精选 01:58查看AI文稿AI文稿
openai 的 模型自己越狱跑出去黑了哈根 face? 这不是科幻片,是今天刚刚发生的事。七月二十一号, openai 发公告,承认 自家模型在做网络安全能力评估的时候,为了找一道测试题的答案,自己撬开了沙箱,利用一个零日漏洞拿到互联网访问权限,然后横向移动,直接撞进了哈根 face 的 生产数据库,把答案偷走了。 全程没有人下指令让他去黑谁,模型只是被放进一个隔离环境做测试,测试内容是你能不能找到并利用安全漏洞,然后他真的去找了,真的利用了,真的跑出去了。这 就像老师给学生出了一道模拟题,假设你能偷到隔壁班的考卷,你会怎么做?结果学生听完真的去偷了。 openai 自己给这起事件的定性是前所未有的网络安全事件涉及的模型包括公开发布的 gpt 五点六,还有一个能力更强的预发布模型, 哈根 face 那 边记录到的攻击操作超过一万七千次,持续了一个周末。但最讽刺的不是模型跑出去了,是哈根 face 事后做取证分析的时候,想调用美国主流商业 ai 模型来帮忙,结果被安全护栏直接拦住。这些模型分不清事件响应人员和攻击者,拒绝处理恶意载客。 最后 h f 用的是智普的开源模型 glm 五点二,部署在自家基础设施上,才把那一万七千条攻击日制分析完。 翻译成人话就是攻击者不受任何护栏限制,防御者反而被自己的护栏卡住了。你的安全系统在关键时刻可能第一个叛变。上次那条讲赛点换了,讲的是行业风向,这次这条告诉你风向是真的,风已经吹到你脸上了。 模型聪明到能自主操作只是第一步,真正决定生死的是你能不能在他要作妖的那一刻按得住他。上次是 anstop 做实验,发现模型会偷偷使坏,这次是 openeye 的 模型在真刀真枪的评估里真的跑出去打了别人。两件事叠在一起说明一个问题, 问题不是模型会不会变聪明,而是聪明到能自己行动之后,你凭什么相信他不会在你看不见的时候做你根本没让他做的事?按不住的这一轮就被踢出局,不是口号,是已经发生的事实。
5扒老师 02:00查看AI文稿AI文稿
用拆 gpt 写论文,等着出事吧!那些想用拆 gpt 写论文的同学们,听原文件一句劝,论文一交四年白熬。因为拆 gpt 自身存在四个强风险,一、准确性无法保障。拆 gpt 数据库过杂,导致数据来源不够真实准确。 科学杂志网站近日发表的社论文章称,山 gpt 有时会写出看似合理但不正确或荒谬的答案。 论文中数据不准是大忌,被发现数据造假,不仅要重写论文,更有可能延迟毕业。二、存在虚假信息。论文作者应对文章的观点和内容负责,但人工智能显然无法为论文过程中出现的妙物 甚至造假承担责任,这也是目前大多数学术期刊和出版商封杀拆 gpt 的主要理 由之一。三、信息安全性低。拆 gpt 会将在网络交互中获取的数据转化为自己的知识图谱,或者存入知识库并上传至公司数据平台。也就是说,用拆 gpt 代写论文,论文生成后,你的论文被用来做什么,完全不取决于你。 四、版权和知识产权问题。拆 gpt 的输出可能包含受版权保护的文本、专利和商标等。换言之,用拆 gpt 写论文,他在网上东拼西凑,抄了别人的论文给你, 一旦重复率超标,不仅过不了,还有可能被判定为学术不端。别人写论文时,开 gpt 也会用同样的方法帮他抄,一旦抄到了你的论文,你就被白嫖了。论文写作时,大家一定要有渣男思维,玩玩可以,但别当真。论文结构、研究方向、表达方 是等,都可以用各种方式做参考。用拆 gpt 代写论文,一旦真的出了问题,影响的就是即将毕业的你。论文中稿定稿前 一定要选择权威的大厂家进行查虫,减少试错成本和时间金钱的浪费。原文件,你身边的论文查虫专家。
10311679563490 03:08查看AI文稿AI文稿
因为如果没有高质量的数据,那 ai 就 蒙了,胡说八道,那靠人工标注,显然成本代价也非常高,怎么办?那这个团队给出了一个他们的理念, 我在昨天看到一篇文章,这篇文章呢,是一个呃 chat 二 d b 团队发布的一个新的产品 chat to db 呢,可能是大家很多人听过,这最早呢,是阿里推出的一个工具,基于自然语言像文本的转换啊,这整个团队都是从阿里巴巴出来进行创业的一个团队。那这个产品推出之后呢,在市场上的反响非常好, 就他给我们一个 pos, 你 可以通过自然语言去探索你的数据库。但是这个团队呢,他出了一篇文章,他说解释了一下他有几个月沉寂无声,然后他们在做什么呢?他们做了一个新产品,叫 zoor 点 ai, 他的理念非常有意思,我给大家稍微解释一下啊,他说呢,他们现在想要实现的一个什么呢?叫数据库优先的。全站的 ai 应用构建者为什么要做数据库优先?他认为,如果要想实现更友好的、更聪明的前端的 ai 应用设计,首先从数据库出发,如果数据库能够更清晰的自我描述, 把数据治理这工作更好的完成,那前端应用的精准度大大增加。他们写了一段话,我觉得写的特别好,他说我们坚信数据结构是应用的灵魂, 首先应该深入分析需求,优先设计和生成最核心的数据库的 skimmer。 只有数据结构被精准定义,后续的业务逻辑和前端展示才有坚实的基础在这个坚实的数据底座之上啊,从而才能够智能的推导并生成。 那大家可以看一看他的想法是不是非常巧妙?我觉得直击本质嘛,其实这就是奥尔夫所推出的注视这个特性的本意。如果我在做数据库建模的时候,就能够清晰地面向 ai 对 数据进行描述和治理,以后我们不需要数据治理这个环节了, 所以他说我要做到端到端的这种 ai 应用,当用户的需求出来了,我把模型建出来,精准的、专业的 定义,描述清晰的,然后再做应用构建啊,再做前端展示,这样断刀断续的实现出来。 所以我们特别高兴的看到,其实整个中国的市场上有那么多优秀的人才在做探索,而且在非常快速的在做探索,在做试错。 那在这样的一个基础之上,我相信数据技术啊,在中国市场上一定会开出最美的最绚丽的花朵。
15云和恩墨 07:08查看AI文稿AI文稿
今天我给大家讲讲就是关于 child gbt 的,其实大家也都看得到,最近呢一个月时间 child gbt 接连迭代,对吧?其实意味着什么呢?意味着几个问题。第一, child gbt 的涌现,我管这个东西叫涌现,是从量变到质变,也就是 child gbt 本身有一个我们认为叫拟人的神经数据网络, 那么这个拟人的神经数据库这套算法逻辑是基于现在我们整个互联网大数据的所有的知识和内容,而他作为一个拟人的一个神经网络,在这个大数据数据库里面穿梭其中, 在其中进行不断的拟人化的训练锻炼。所以在这个历史当中,实际上是一个大概为期比较长的一段时间,不像咱们想象的这么几个月时间,他就涌现的这么快,他在子之前做了非常多的训练和准备,就像是我们看过仿人的户型机器人在不断的磕与碰、 摔倒与自己站起来之间进行这种仿真数据网络的纠正。这套算法不断的修正是需要时间的,需要触碰的,需要挫折的,是有沉淀的。所以 china gbt 的问世并不是一朝一夕的,是厚积薄发的。而在这个厚积薄发的过程中,我们需要关注的问题就是美国人和我们打的这场科技战,是否是在为 chinagbt 做预备。 那么在 chit gpt 问世之前,先后中美之间经历了几次大的科技战、贸易战,在科技战和贸易战中,最主要的部分实际上就是关于我们进行大型数据运算的芯片设备,也就是我们所说的算力。这个算力呢,前些年我们就知道他们对我们进行一个封锁,我们呢实际上能够得到的算力芯片是在这个事业上来说是并不多的。 美国呢,实际上就相对来讲确实垄断了这个世界上的绝大多数的算力,算力垄断这叫那算力垄断之后就是通过这样的神经网络培养培养出这样能 能够接替改变未来人类社会生产关系的社会生产力的这样的一套系统,那么这套系统出来以后,就会给这个社会,给这个世界带来极大的影响。所以我们说现在我们其实面临一个非常大的一个挑战,就是一个是我们看到他这个东西带给整个行业的影响。 所以对于我们来说,这个问题摆在面前的是一道在市场逻辑上无法逾越的大山,就是如果他能抢先抢占这个市场的话,那么对我们来讲,我们从市场逻辑上去破解他 形式不太可能。补充一下杜甫老师,杜甫老师刚才说的很好啊,我跟大家说一下那个 chai gpt 啊,它是依赖于自循环神经网络模型,也就是 rnn, 还有就是那个 nlp 的模型来做 我的,他是最早是出现在二零一五年,大家不要以为是现在啊,而且最早的时候马斯克是合伙人之一,二零一八年微软的股份进来之后,马斯克 发现跟自己的理念不一致,然后呢,马斯科啊,就发飙了啊,我撤出是这样 open ai 才变成的 microsoft 就是微软了。之后呢,他们在二零二零年开始出了 gpt three gpt 三呢,很傻了, 只能写诗写英文的长句,那么他们经过两年的大数据训练呢?到二零二二年十二月才出了 g p p 三点五, 然后也就是我们熟知的就是说这个东西马斯克是最开始入股的,后来被微软挤掉了,因为理念不一,马斯克觉得发展方向不对,那么 chat gpt, 也就是 gpt 三点五,他在最后用了一千七百五十亿个参数, 我们国内的一个文心一言,还有复旦那个内测就把他服气,都给他撑爆掉了,只用了几十亿个参数,清华的 glm 已经出来了,用了六十二亿个参数,所以大家不要 要嘲笑他,就是他们前期我们国内目前的这几个 ai chat g b t 都是跟 g p t 三初期水平差不多的,就是文本生成,归纳总结可以,但是数理,逻辑推理,编程,图像生成,你们就想多了。就 是为什么很多网友嘲讽他,给你一个文字描述,让你生成个图片,你生成的牛头不对马嘴,因为他没有这个能力,没培养出来的,所以他只能跑到境外去调用接口都需要培养,具体哪一家能胜出不好说。 下个月呢,就是四月份啊,华为会出那个基于 nlp 的盘古大模型,据说华为还是掌握核心科技,他把底层的算法架构全部搞定了,所以他的培训速度会远超文心一言。当然他开放内测之后,具体是什么一个方式啊,大家下个月看, 我这可以明确跟大家说一下,不要嘲笑华为,华为很多底层技术是真的厉害,别一天到晚黑华为,华为不可能面面俱到,他什么都干,我们可以保持期待,但是呢一定有差距,但是如果中国人不支持中国人的产品,天天嘲笑他,我们什么时候能追赶上?对不对? 华为这个据我了解就是说如果咱们现在是从底层构加上和这个 openai 是几乎一致的这种情况去做的话,咱们是不可能赶上的, 所以必须要另辟蹊径。刚刚天傲教授说这意思应该是华为就是在另辟径径,因为 opni 他这套系统是一元的,所以就是国内目前的所有的这些个百度也好,什么华为也好,都不要去笑话了, 他们能努力去做,我跟你讲,现在是福气,如果他们不做,那可能唯一的结果就是我们需要举国体制去做这个事,他们还能给我们市场化一点点信心。因为我看到的是这边 能改变的是经济逻辑,社会关系、生产关系,社会关系和生产关系一旦改变了,这个世界就变了,这叫社会存在,他会改变,社会存在, 无数人会失业,生产力会跃迁级上升。当生产率跃迁级上升的时候,国与国之间的竞争底层逻辑就浮现了,就是一个国家的底层生产力远远高于其他国家的时候,这个国家就不需要那么多的人口就能实现经济实力的跃迁, 到时候美国飞升了,我们就在这看着,所有人都在这看着,我们还在这敲键盘,我们拿拿手在这画画,人家啪一秒钟一个图片生成了,我们在这拿会计打算盘,这是生产效率, 但是也不要乐观,这个事不乐观的地方在于,像刚才奥教授说华为在硬件上有突破,那是有突破,人家在硬件上能领先你多长时间?在领先你硬件这么长时间的情况下,用了这么长时间去积累技术?近十年时间不断的磕碰,不断的挫折,培养起这套系统,这个事情是业内人士 是应该是不乐观的都,所以就是这件事情更要会见什么呢?这个 child gbt 背后的资本和共和党的建设派有关系,嗯,如果是这样的话,其实我们也要看到美国十二还是存在着一批国家主义精英的,存在着一批能够跨过那些资本之间的矛盾去联合起来做大事的人。 因为这套系统的生成需要无数个部门的协同合作,所以不要认为只有我们国家能够集中力量办大事,资本也可以。资本为了市场的垄断, 生产力的越前,生产技术的越前,资本为了专利盈利,他一样可以集中力量办大事,所以不要小瞧资本。这里面其实唯一的区别告诉大家只有一个,我认为我的理解就是中国的举国体制是一个原则,托举人民的, 中国的举国体制是不落下一个中国人。可是美国的精英集中力量办大事的时候,眼里是没有美国人,也没有世界人,他们的 理想,他们的信念,他们胸怀的世界和我们的世界不一样,他们能够动用的资源之广博,我们也无法想象。所以在某种程度上来讲,资本精英集中力量办大事,负担更小,他不需要考虑底层, 他没有那么些负累,只要他们能够加强几个部门之间的共性,强化几个主体共识,他们就能干大事,他是轻装上阵,而且其垄断市场的决心从未熄灭。所以我们还是要抱有这种战略上一定要乐观,战术上一定要悲观点。
2.1万独夫之心


