P100显卡华为服务器能用吗
我们今天要改的卡来自特斯拉 p 一百, 好,我们看完 p 一百的外观以后啊,大家都知道,其实这张卡应该是利用在服务器的风道吉祥里的这个运算卡,那特斯拉的显卡我们已经改过很多个了,从 p 一百, a 一百,然后 v 一百,还有 这个未来我们也可能会去改这个 h 一百,那么这张特斯拉显卡有很多朋友会把它用在这个机箱里面,就 pc 机箱里面,那么这个时候封道是不正常的啊, pc 机箱里面他会在右侧入风,他这个被动上,虽然整卡的工号并不是很高,大概也就是两百五十万到三百万之间,但是如果说你要对这机箱进行撤推,然后出风,那么你的这个风扇的风量 必须达到非常非常高,要么就是转速极高,那种服务器内的万转即的侧吹风扇,才可以达到它的散热效果,同时还要避免这个灰尘,最好是在无尘机房里面进行运行,不然的话长时间这个里面全部都会被灰灰尘给堵住, 那么这种情况下,这张显卡上的效率都会大幅下降了。如果在 pc 机箱里面去应用这张显卡,其实也有很多咸鱼,上面去搜这种显卡,然后 把这张显卡 pc 画,然后放到自己机箱里面啊,用作这个训练用啊,包括这个什么, 呃,做作业啊,啊,利用人工智能运算啊,在这里做开发啊,然后甚至一些这个学生群体啊,用 p 一百 非常非常多,我们建的非常多,但是实际上这种没有主动散热的情况下,这个显卡是完全顶不住的。好,那这样显卡原装散热我们就不用测试了,因为没有测试通道啊,温度肯定很高。拆这样显卡非常简单,我们先把挡板的三克螺丝拆掉, 那所有的背板螺丝拆完以后,挡板就可以分离了,这个散热器也就可以从 psp 上分离下来。 拆完散热器我们可以看一下,其实这个显卡其实应该是客户换过自己换过规矩,但是可能没什么作用啊,不管你画再好的规矩,我说的风道因素啊,是最重要的因素, 抛开风道因素,那么就是你散热器体量在 pc 画的里面,其实是不够给这个信用卡进行散热的。好,我们把柜子清理干净,开始改装,现在我们 pc 清理干净了,然后我们给正面贴上这个导热膏, 因为这张显卡显存是 hbm 的显存,直接结集成在核心,封装在核心旁边的,所以我们只需要给这个 供电的及散热导热就可以了,然后把这个零点七五导热膏按照配件尺寸裁定好贴上。好,现在我们把 上面的这个供电大膏都贴好了,那么在这地方有两个小的电感啊,魔术管,不要忘了,贴好以后,我们把感应键拿过来,然后 大致对齐螺丝孔位,把它贴合上去,接着我们把 pcb 和改正键捏紧,然后倒置过来, 到背面来以后我们要对齐所有的螺丝孔位,这个时候对齐的话,你不要把皮皮拿下来,你就只需要在他贴合的平面上面去左右挪动对齐就可以。 然后接下来我们把这个挡板和他的这个位置对对齐,然后将背板拿过来 对齐螺丝孔位,那么因为挡板只有一个螺丝需要固定,所以我们先把这个螺丝把它放进去,然后固定住,把它拧住,这样挡板就不容易掉,我们再来把所有其他的螺丝啊全部都放进去,注意拧紧 所有螺丝放进去以后,我们先把螺丝啊全部都拧进去,这个时候你不要每一颗螺丝都拧紧,确定所有螺丝都可以拧进去以后,我们再来逐步收紧 所有的螺丝,拧紧以后,我们到侧立面去观察一下,看一看所有的背板台阶,螺丝台阶和正面感见台阶是否和 pcp 正反面接触紧密,接触紧密就表示我们螺丝引领到位, 然后挡板处其实只有一个螺丝固定,那我们需要把拿一个自攻螺丝啊对准其中一个螺丝孔位,然后把它拧进去,这样就可以在侧里面去 去把这个掌板固定一下,那么这样固定住以后,我们就比较稳当,可以装到机箱里面去,好到正面来,我们给核心涂上我们附赠的 p 二三规矩,规矩涂抹均匀以后,我们拿出水龙头, 那么摄像头我们是使用库伦之尊的这个一体式水篮进行设计,嵌入式安装,他是利用这四个螺丝孔位置于固定,所以他不支持其他品牌的一体式水。 那接下来我们安装水龙头有四个螺丝,那么其中第一个螺丝你选安装这个螺丝,那这个螺丝他的螺丝帽啊 放进去会和这个水龙头这个管子,这个模块数量,模块会有干涉,因此我们拿螺丝刀啊,然后顶住这个螺丝,一直顶住,拧到顶, 拧到底部以后就可以排除掉这种干涉,那么这样我们就可以第一个安装这个螺丝,那这样安装就容易成功。如果说第一个不是安装这个螺丝,那么最后装这个螺丝的时候,他是清洁进去的, 就容易安装失败。这个地方尤其要注意,我们拿小螺丝刀,然后捏住这个旋转头管,让跟头平面和 gpu 平面平行,用螺丝刀顶住第一颗螺丝,然后下压 啊,这里一定要注意,下压是用螺丝刀用手指去顶住下压,让你手指感受啊,在第一个螺丝孔位在那,然后拧个三五圈,这个时候不要拧紧,不要拧紧,那么对角螺丝还有这个雨量,我们可以左右挪动对齐, 接下来我们上对角螺丝,那么只要对角螺丝装好以后,另外两个螺丝也就非常简单了。四个螺丝你好,那么这个改装就已经完成, 那这四颗螺丝的拧紧啊,不需要使用马力,也不需要使用大螺丝刀, 用这种小螺丝刀反复拧啊,拧到刚好用一点力气就拧不动,就表示这个核心已经贴好,那因为这张显卡所有的发热源呢,基本上都在这个核心上面,所以核心拧好了后,温度 表现正常,那么效率是极其的高了。

粉丝2.6万获赞7.1万
相关视频
 07:32查看AI文稿AI文稿
最近我们买两特斯拉,不过不是开的那个,是涮的那个, 没错,开的那个和算的那个呢,都叫特斯拉,算的那个是英伟达,他们家的不少人都没听过,但是呢,他们都用一样的名字, 这个名字呢,很多科技公司都喜欢哈这个名字的故事背后还有段野史,说的是大神特斯拉,爱迪生,莫根大同,三个牛逼的男人 相爱相杀一生的三角关系,有兴趣的可以去搜一下哈。大家好,这里是即刻买,这一期呢,我们买了两张英伟达的计算卡, 特斯拉 p 一百十六 g 回来玩玩啊。先介绍一下特斯拉计算卡啊,这个是英伟达用于科学计算解决方案的 gpu, 基本呢都 是没有显示输出的,我们可以看到啊,然后纯粹是用来计算的,相对于普通的 rt 叉游戏显卡来说呢,特斯拉计算卡配备了 ecc 纠错,并且显存一般也更大, 然后因为一般呢都是放在无尘机房服务器里面去做计算的,所以呢是没有做这个主动散热的啊,服务器都是从这边很多风扇排进去,然后 输入的一些风扇,然后呢我们呢就给他配了这个散热器,还有电源转接线,然后呢就可以在我们的普通的 pc 平台使用,当然还得配一张输出卡啊, 也有朋友摸改过这个特斯拉的显卡来玩游戏啊,譬如说之前特别热门的 p 四零,那现在来说的话呢,现在最火的特斯拉计算卡当然就是禁售给中国的 a 一百和 h 一百了,然后还有针对中国特工的缩水版的 a 八百和 h 八百,但是大家要注意啊,虽然数字大了,但是在带宽速率方面是缩水了的。 好,我们先看一下我们这个特斯拉 p 一百啊, p 一百是二零一六年推出的,实际应用呢,是在二零一七年有些年头了,不过当年可是天价的旗舰, 我们后面都看到像什么 v 一百啊, a 一百啊, h 一百,其实一样的叫一百的基本上都是全能旗舰,我们再看看英伟达官方是怎么去介绍 p 一百的 啊,相当的霸气啊,世界首款 ai 超级计算数据中心 gpu 啊,已加速 hpc 和 ai 发展,那至少是能用于 ai 计算的,那它的算力是怎么样的呢?我们先上一个图对比一下哈。哎,这还是从英伟答 查官网找到的资料可以看到,在特斯拉 p 百的这个排名还是比较高的,这个算力排名仅次于目前很多云厂商使用的这种 v 一百计算卡。但是我们要知道, v 一百的这个云服务器一年也要差不多十万啊, a 十就更贵了,那 a 一百你想找都找不着了,那 a 系列就算了,那我们在网上也找了一张图片,横向对比一下其他的显卡的一个算例哈,其实 p 一百除了不支持那个 tenser y 整体都还行 呃,毕竟也是当年的旗舰嘛。不过这里也要说一下, p 版也不支持 i n t 八和 i n t 四的加速的,所以人脸识别这一块呢, p 版呢,就用起来就够呛了啊。当然了, ai 计算方面的话,浮点 数是计算机上最常用的这个数据类型之一,那常用的浮点数有双精度啊,还有单精度啊,除此之外呢,英伟达呢,还提出了为了降低数据传输和存储成本的半精度的浮点度啊。双精度和单精度主要是为了计算 半精度,更多呢就是为了降低数据传输和存储成本了。呃,其实很多场景呢,对精度的要求也没那么高啊,例如说在分布式深度学习里面,如果用半精度的话,可能比起单精度还可以节省一半的传输成本,对吧? 当然了,前提条件是这个精度的降低对训练的结果呢,是没有影响才行哈,毕竟浮点精度的这个降低必然会导致模型训练的精度的损失。好呃,那么我们就上街 来测试吧,两张的 p 摆放这一块还是挺大的啊。然后考虑到后面的对比呢,我们就用了一张 gtx 一零五零作为输出卡,替换掉原来的那个绘图专业卡。另外说一下哈, 如果 pc 平台要装特斯拉计算卡的话呢,需要在 bells 去做一些设置啊,先不要插这个特斯拉的计算卡,先打开你的 bells 去设置一个好像叫什么 above 四 g 这样的一个设置,打开了,然后再插入计算卡去开机, 否则有可能会黑屏哦。然后好,我们看一下我们的图哈,如图,我们已经识别到两张特斯拉计算卡,并且可以正常运作了,那通过 gpu 在我们可以看到详细的参数。然后接下来呢,我们先进行单张 p 一百 对比 r t x 一零五零的跑分,然后再三张显卡对比双 c p u 一五二六八三 v 三的跑分啊,让大家看一下 g p u 跟 c p u 的差异哈,前面也给大家说过了,单精度跟双精度的算力的影响,那我们回来再考一下,看看一下这个跑分测试。 在单精度和双精度的算力以及涉及到 open c 幺算力的 e s 和 s h a 中, p 版的算力都是很强的, 对比 cpu 的话就更加是要按倍数去超越了,所以这个特斯拉还是特斯拉,而且我们看到一加一接近等于二的这样的结果呢,也可以让我们放心的去堆卡。 那当然了,我们还测试一下功耗,在这个 x 九九平台,搭配双二六八三 v 三 cpu 以及三张显卡,满负载的功耗基本呢已经接近了七百瓦了,所以耗电 也不算低哈。到最后呢,还要说一下是 tensor coral 这个张亮计算核心呢,是由 amidia 研发的新型处理核心,那 tensor coral 这个张亮计算核心呢,其实可以实现这种混合精度计算,然后呢,可以根据精度的 降低动态调整算率,那在保持准确性的同时呢,也可以提高吞吐量。 p 百的后续 v 百呢,是首款搭载 tensor 核心的这个特斯拉计算卡啊, p 一百是没有的哈,所以 mvd 的这个 tensorco gpu 支持这个多精度和混合精度计算呢,其实可以让我们的这种 开发者更加优化的去进行计算啊, ai 的程序以及推理啊,训练啊这一块都 ok 的,那大概有多好呢,就按照 mvd 官方的说法啊,可以将训练的时间从数周 缩短到数小时,这这个就很快了,那研究人员和这个公司依靠这个技术呢,就可以更好地去支持科学模拟啊, ai 还有像我们现在很火的这个自然语言的处理工作啊, 那没有天审核的 p 一百就在新的这个 ai 计算叙事中呢,确实是比较吃亏的,但呢, 也不代表 p 一百就没有用哈,毕竟我们看到闲鱼的价格才一千多,哎,要知道 a 十都要一万多了,那真的是 a 七呢,可能就是 aa 一百可能就是十万了,所以这个一千多的特斯拉 p 一百还配备十六 g 的显存,作为数据中心以及处理一些轻度的 ai 工作呢,也是没有问题的。 好,这一期就到这里,谢谢,希望大家一见三连,感谢感谢!
702极客买Geekbuy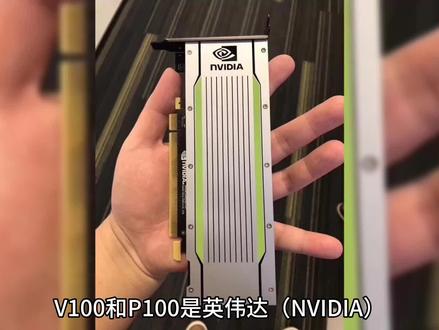 01:39查看AI文稿AI文稿
v 一百和 p 一百是英伟达 n v d r 推出的两款高性能计算显卡,他们在性能架构和用途上有一些差别。首先,从性能方面来看, v 一百相对于 p 一百有着更高的计算能力。 p 一百采用了 volt 架构,具备五千一百二十个 q 的核心和六百四十个张亮核心,拥有十六 g b 到三十二 g b 的高速 h b m 二显存以及九百 g b s 的内存带宽。而 p 一百则采用了 pascal 架构, 具备三千五百八十四个 q 代核心和三千五百八十四个张亮核心,拥有十二 g b 到十六 g b 的 g d d r 五 x 现存 以及七百三十二 g b s 的内存带宽。总体来说, v 一百在计算性能上要优于 p 一百。其次,从架构方面来看, v 一百引入了新的 voter 架构,采用了第五代 and vling 互联技术, 提供更高的贷宽和更低的延迟,可以实现多个 gpu 之间的高速数据传输和协同计算。而 p 一百则采用了 pascal 架构,使用第三代 and v link 技术,这意味着 v 一百在处理大规模并行计算任务时具备更好的性能和扩展性。 最后,从用途方面来看, v 一百主要用于深度学习、人工智能和科学计算等高性能计算领域,它的强大计算能力和专门优化的碳臊 c 技术使其在深度学习任务中表现出色,而 p 一百则更适用于科学计算、数据分析和渲染等工作负载。总结起来, v 一百相对于 p 一百具备更高的计算能力、先进的架构和更广泛的应用领域。 但需要注意的是,选择哪款显卡要根据具体需求和预算来决定,以确保最佳的性价比和适用性。
37阿里云张小云 01:05查看AI文稿AI文稿
华为、百度、腾讯等的大模型和 obanei 大模型的算力区别?目前国内已经发布的大模型产品只有百度文星一言,在国内处于 ai 一哥的地位。但是从试用结果看,和差 gpt、 gpt 四的相差还是很大。百度的算力、硬件算法、模型层面都没有做到差 gpt 的水平。 范例基础设施规模小于微软的规模水平,因此训练精度水平较低。国内对 ai 研发时间相比国外还是短了不少, 后续需要优化的地方还是很多。其他几家大型互联网企业在大模型领域应该都有提前布局,但由于在欧本 ai 做出产品之前, 这个领域一直没有商机和盈利,因此大家都没有落地该应用,没有百度重视这个领域。叉 g p t 火了之后,很多互联网企业才加速了推动自己的产品。现在 恋爱在工具链层面,语音交互层面已经展现出无限价值。我们也是一直在硬件上支持国内企业提供 a 一百和 a 八百的服务器解决方案。希望国内也能有流畅使用的人工智能大模型。
14咨钛服务器硬件 00:38查看AI文稿AI文稿
来看一看啊,这个是十几万的一台服务器, t 六十零。先看一下外观啊。呃,硬盘呢,用的是九百六十 g 那个固态硬盘, 用了一二三一二三四五六七八八个风扇。这个显卡大有来头啊,是 p 一百十六 g, 一共用了四块,用了四块。 这就是两万块钱一个,能把加起来就八万多。凑一个十几万的服务器也很简单啊。
 03:14查看AI文稿AI文稿
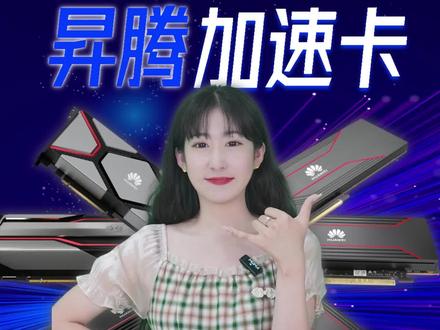
之前呀,讲了那么多期大火的英伟达,那么在 aigc 的赛道上国产化的表现又如何呢?相信也有很多人关注,那我们这期就来讲讲国产加速卡,华为升腾。 升腾 ai 卡呢,大致可以分为推理和训练两大类。先说推理卡,四个 atlas, 三百 v 是经济适用难, 主要用于多录视频的解析,对标的是英伟达七四,比如一口气处理上百个视频监控画面啊,或者说车牌识别呀,功耗只有七十二, 可谓是经济又好用。三哥呢,三百 v pro 属于经济加强版,更高的算力,更大的内存,更多的解析路数,性能优势也更明显,配置要求高一点的闭眼冲就完事了。二哥呀,三百 i pro 理性分析难,主打对视频和图片的识别推理,还有分析两 tops, 每瓦的能效笔懂的都懂, 对于文字、图片、视频各个维度的识别和推理都不在话下。最后呀是大哥,三百 a 多全能高富帅,对标 a 三零双新打底,算力内存核心数通通翻倍, 视频编辑码加分析,那也是全能,简而言之就是前面三位小哥会的,他都会干起活来赔本快。 关于训练卡,主打的就是大规模作战,算力要高,互联性要好,所以三百 t pro 半径度和 a 一百也是不相上下。 qs fp 杠 dd 接口就是类似于 nvlink 的技术,可以加速卡与卡之间的互联速度。 三百 t 杠 a 二也是在此基础上支持 pcie 五点零,互联速度翻倍。当然,要想完成 ai 生态系统的闭环,除了硬件层,还需要编程框架与解决方案的护航。 升腾 ai 框架 mid sport 可将模型直接运行在升腾芯片上,并且早在二零二零年 mid sport 就进行了开源,并且接受更多的工程师参与生态构建。解决方案上可以打开升腾社区里面 提供的各种软件包,开发工具链,专业计算引擎教学说明,方便客户直接调用。总的来看呀,升腾的六款加速卡,开源的 madspo 框架以及丰富的软件社区,已经形成了一套完善且成熟的 ai 生态系统。 同时荣科也是和华为升腾达成了进一步的合作,推出了多款 aigc 人工智能解决方案。相信随着 aigc 市场的不断壮大以及国产化的不断进步,国产加速卡也将彻底崛起。 好了,今天就先聊到这里,融科联创制算力量,关注我们,为计算赋能融科联创制算力量!
118融科联创 01:08查看AI文稿AI文稿
有朋友想问华为 itas 加速卡,今天我们就聊一聊。二零二二年生成,推出了新一代 itas 三百系列卡,场景覆盖全面,包括推理卡 itas 三百 idoitas 三百 ipro、 视频解析卡 itas 三百 vpro、 训练卡 itas 三百 tpriatias 三百 i pro 是 itas 三百 i 的升级版, 具体成绩方面包括兼容 a r m 和 x 八六。原来 f x 三百 i 区分 cpu 处理器是 a r m 还是 x 八六的,两者不能互通。也就是说在华为自家空投机 常用的卡插在英特尔机上是不能用的。现在的 itas 三百二 pro 能很好做到兼容做联通原来的英特八八十八 tops 到英特八一百四十 top, 同时支持 pu tost om 的部署动线。 这些卡大小没变,都是半高半长卡。而 atas 三百爱度则是全高全场卡。 idas 三百 v 图是分解 c 卡,除了小红心发这个是高赖, 家中孩子还像个爱婆一样,你以为是 他想三百替补充 中心提供前会选择 ai 加速卡,三卡可能超过二百八十七个 w 十六加一关注我,我是 itv 成交带你了解更多的科技干货!
111IT梦想家 01:30查看AI文稿AI文稿
大家好,今天我们为华为公司配了台深度学习的工作站,对于深度学习工作站这个词大家可能有点陌生,那么我们来看一下这台工作站的一些配词。好,我们来看一下这台工作站。主机的核心是超微七零四八 gr 杠 tr 卷系统, 它包含了主板、机箱和电源,主板支持英特尔双路至强 cpu, 支持 r ecc 迪迪二四服务器内存,还有多达四路的显卡,支持四卡并联。 cpu 是英特尔至强一五二六七八比三两颗,这款 cpu 是十二和二十四线程三级缓存,达到三十兆频率可达三点三 g, 两颗同时工作,可以拥有更大的数据运算和处理能力。显卡是英伟达公版特斯拉 t 四十六计运算卡两张,这款显卡是英伟达专门用来深度学习和人工智能运算的显卡, 不要看显卡这么小,但是单卡的价格是要一万多元哦,高达十六 g 的显存也可以完全满足深度学习的需要, 快速的处理要求,最严格的高性能计算和超大规模数据中心工作。附带内存是三星二一 cc 服务器,迪迪二四二六六六十二 g 内存,两根服务器内存的主要特点就是支持内存数据教练和纠错,可以保证主机长时间稳定工作。好了, 这台深度学习的工作战主机就介绍到这里,我们这边除了游戏主机、商务办公主机,还有工作战主机和服务器主机哦,这方面需求的小伙伴可以联系我。本期视频就到这里,感谢大家的观看,我们下期再见!
 00:50查看AI文稿AI文稿
手机,我们已经遥遥领先了,遥遥领先显卡,其实我们也快要赶上了。为啥这样说呢?就在近日啊,英伟达联合贝莱德资本啊,一起给台阶店施压,要求台阶店啊,停止给国内避任科技的。 br 一百芯片啊,继续代工。 为啥这样呢?因为啊,英伟达说啊,这款。 br 一百的芯片啊,性能上已经快要赶上他们的 h 一百了。正好知道啊, h 一百这个芯片做了显卡,现在是卖到三十二万元一张。英伟达啊,他担心这个。 br 一百的芯片出来啊,做了显卡, 可能以后啊,会抢夺它的市场,这是英伟达所不允许的。所以英伟达啊,只能联合别的资本公司一起啊,给台阶店施压,让他停止给国内这个避任科技代工。通过这个事,我们已经看到了未来国产显卡的曙光。而且我看到了英伟达啊,他是真的害怕了。
2717黑冰电脑科技 00:38查看AI文稿AI文稿
服务器由于是长期不间断运行,在散热外观方面与普通 pc 电脑有所不同,又因其配置高,扩展性好,所以在性能方面非常优异。 服务器一般会安装专门的服务器级别的操作系统,然后来架设外部。其实个人 pc 电脑具有的功能服务器也具有。如果把服务器安装上显卡, pc 操作系统在外界的显示器,然后是可以当做普通 pc 机使用。由于其硬件配置高,因此服务器当做电脑用的话,性能会比普通电脑高很多。如果你是电脑发烧油,可以购买一台高配服务器,然后安装普通电脑操作系统当做普通电脑。
52我爱那封信 09:38查看AI文稿AI文稿
哇,苹果出来了,华为有没有可以给大家讲,我们不是宇宙第一就是宇宙第二哦,我觉得苹果已经在做 m 二了,华为肯定是做的了, 今天我讲的不是宇宙第一就是宇宙第二,我们很有信心啊,希望你们能做出更好的体验。今天我们其实已经把我们的能力已经给大家,已经开放一个能力了,叫手势的交互的能力,可大家可以感觉到我们已经在布局了很多了。嗯,我们预计应该明年, 应该在明年上半年左右。哇,我们预计啊,或者今年底左右,我们根据情况把我们的钱打得很很好的时候,一定会给大家见面的。好,谢谢大家! 书接上回啊,继续开脑洞。第四个,有人问 mate 六零 pro 到底是不是五 g 手机呢?因为下载速率已经达到了五百兆 bps 和八百兆 bps, 所以已经可以算作是五 g 手机了。可是天津地铁的那个一点四 gbps 的,这就有点惊到我了,按理说五 g 的下行速率也就是一 gbps 左右,而五点五 g 的最高速率又是五 g 的十倍,要达到十 gbps, 如果算,可是也是将将超过了一点,远远没有达到十 gbps 速率。而且华为不是说了明年才要正式推出五点五 g 商用的设备吗?难不成五 g 加? 而且关于卫星通信,华为分了三步走,第一步发送和接收卫星消息,第二步就是开通卫星通话功能, 第三步可能就是使用微信网络了。这难道不是六 g 应该干的事吗?要说这是全世界第一部六 g 手机,应该也不会有什么人反对吧,这个时候友商们真的不用纠结, 赶紧找华为买吧。第五个,目前有网友跟我说,已经收到了华为做笔记本的问卷调查。首先声明啊,我还没有收到,这个我也无法确认谁收到了,可以说明一下,我说说华为的问卷调查的用意,以及如果华为要做游戏笔记本, 那么会怎么做。当然了,如果华为没有这个问卷,其实我们也可以看做我们对于华为未来做相关项目的一个期盼。 听说文件调查我的亲身体验啊,我在预测盘古大模型介入小艺可以做什么?那一期的视频里说过,在盘古大模型发布之前,我收到了关于如何登记管理 代办事项,于是我分析盘古大模型接入小一后,就会有相关的代办事项的管理,结果被我完全预测对。假如华为笔记本要做游戏版的问卷调查 卡是真事,那么我们就来分析一下是否可行。做游戏板一定是需要用到显卡的,但是现在显卡受制裁,因为他不会卖给华为。 华为有几条路子,第一是和国内的场上合作,第二就是升腾下放做图形化,第三就是低端本地渲染,高端结合云渲染。我家之前生产技术横向比较和用途拓展那一期说过,华为可以低端在手机,高端在云渲染, 所以你觉得这三种里面,哪种最可能促使华为做出自己的游戏本来呢?因为现在国内已经可以生产七纳米制成的芯片了, 所以生产制造上是不存在问题的。而且华为在 npo gpu 上的能力是有实力和英美达拼一下的,比如升腾九幺零和 a 一百,可以打的有来有回, 而 npo 和 gpo 又都是属于病情计算的,想转做图形渲染的无非就是需要生态,也就是说华为是有机会做 gpo 的。 今年华为的开发者大会上其实就有提到关于游戏生态的搭建,而且华为已经和 unit 游戏引擎合作了, 直接让 unit 鸿蒙化,基于这个游戏引擎上面的游戏还是非常多的。而且华为从今年开始发理鸿蒙生态,其中很重要的一点就是游戏生态,所以说在这方面应该是有机会的, 而且涉及到游戏,那必然是要在手机和电脑端都要做适配,这就是一个绝佳的机会,不做白不做。而且还有人提到了华为目前正在做鸿蒙的 pc, 结合着华为的服务器上,英特尔不供货,华为已经用升腾和鲲鹏处理器顶上了飞行 cube 的熏车一体 以及就是例子,那么鸿蒙 pc 直接用空腾下放的 cpu 和生腾下放的显卡做出自己的游戏本或者工作站就完全有可能。所以会不会存在有那么一天,就是华为出一款个人工作站, 出一个类似于 mac pro 那样精致的高性能工作站,然后呢,从硬件到软件全部都是自己的系统,直接用功能,然后再加上当前使用的游戏引擎以及游戏生态。 为什么我会认为华为有机会做显卡呢?为什么有机会从游戏切入呢?因为 gpu 的运算能力,渲染能力在未来是非常重要的,看看现在英伟达的布局,一家独大就能够说明问题。 另外 g p u 在未来的产业上,比如 x r 眼镜,那也都是需要的,而且我认为华为可能不会和第三方合作来做这一 快,因为一是市场足够大,二是自己适配更容易,所以我认为华为一单做显卡只能依赖于后两种自己做,然后同时低端本地渲染,高端结合云渲染,是不是这个道理? 因为本地做渲染是本地的 gpo 的算力问题,华为有技术本地和云端同时做到,而且利用云端进行渲染,华为可以通过足够快的网络以及足够稳定的网连接方式来做到。第六个 现在七纳米搞定了,也就是说百分之九十五的芯片都有机会搞定。那就不妨更大胆一点,看看华为的终端业务能发展成什么样子。 上面提到了低端本地渲染,高端语音渲染可以结合起来一起用,而且华为可以通过足够快的网络和足够稳定的连接方式来搞定。其实另外还有一点就是通 云端渲染不需要在本地部署更多的算力,也不需要消耗更多的手机的电量。那我就开一个脑洞,我就来说一说未来华为的终端可能做成什么样子。上面提到了华为自己有必要做显卡, 那么接下来先说眼镜,因为毕竟这个已经提上了议程,就是类似于苹果的 vizen pro 的功能。而且华为的相关负责人已经公布了, 不是今年年底发布就是明年年初发布,就是本期视频开头华为的相关负责人讲到的那样,不是宇宙第一就是宇宙第二, 而相关的技术和苹果的那款设备搞定的方式类似,首先眼睛跟踪技术华为已经有了,隔空操作华为也可以做得到,这些都是华为在开发者大会分论坛上的内容,这个没有必要质疑。另外一个呢,显卡是一定要有的,而且是必须要有的,否则 渲染不出来,后续的河图也没有往上落地。显卡有了,还有一个电量的问题,我还是坚持我的观点,处理器不能在眼前当蒸汽,眼罩。处理器只管低端的处理,高端的渲染还是必须要在云上去做,一是云上的算力足够,二是可以大大节省本地段的电量。焦虑的问题, 在这里唯一卡着的就是是不是有足够快的网络,以及可不可以有足够稳定的连接方式。恰巧呢,华为都有超快的网络,五点五 g 足够稳定的连接方式。星闪啊,而且星闪已经在 mate 六零上搭载了, 未来普及只是一个时间的问题,很可能在未来的一两年内大爆发。回到 xr 的眼镜,我们完全可以通过 xr 眼镜通过星闪连接手机或者电脑,把图像传过去。根据星闪的说明,首先实验上没问, 其次短距离上星闪传八 k 的家庭影院的内容都没有问题,所以传个游戏或者传个渲染的内容也不会有问题。星闪相关的内容可以看我之前做的关于星闪技术的两期视频, 所以手机算例,通过星闪无线传给眼镜发热也不会有问题。眼镜上只需要有相关的解码芯片就可以了, 如果用现在的电视解码芯片,洪湖就可以,不需要像苹果一样需要在眼镜前面直接计算,而相关的计算呢,就可以放在手机上或者电脑上,现在华为有通过云实时渲染的技术, 其实手机上也不需要进行大运算,只需要用星闪就可以保证网络足够快以及足够的稳定。既然手机上可以,那么华为在电脑上也应该可以才对啊,所以接下来华为的台式机笔记本显示器的连接完全只需要 用到一根电源线,中间的连接线全都不需要,家庭影院都八 k 的视频都可以传电脑上,还要那么多线干嘛呢?走星闪就可以了。而且我们可以想象一下未来的电脑,那就是一个芳芳的主机箱, 甚至没有其他的接口,只需要有一个电源线和一个电源按键就可以了。而且未来的电脑有没有必要做成方形的,是否还可以做成其他的形象,直接颠覆到现有的电脑主机的形态,而且显示器还有必要吗? 我可以用星闪连电视、投影仪、眼镜等等一切可以连的显示设备,然后可以随时连主机,更方便,而且五点五 g 的网络足够快,都可以再次启用云电脑或者家庭里的电脑, 就和我之前华为平板如何调用电脑算计的那个视频一样,可以用手机和眼线等等,通过远程桌面随时随地的 调用,加重在工作站的性能。这样呢,手持中单的算力也可以解放了,只是需要一个带网络的显示设备就可以了,电量的焦虑问题也解决了,而且人工智能、大数据和图这些完全也都可以在未来加进来, 以上的一切的一切都需要华为先把 gpu 的芯片做好,剩下的那都是水到渠成的事。你觉得华为的中端设备离这一步还有多远?记得关注再走哦!
1353三号脑洞 02:44查看AI文稿AI文稿
好,这个呢是华为刚刚发布的 mate 布格 e 啊,是一个多合一的笔记本,你看上去呢,非常的轻,非常的小,特别像一个平板电脑,对吧?但其实他是装了温度的十一的一台笔记本电脑,那内置呢?是 i 七幺六零 g 七的这个处理器,还有集成的显卡,十六 g 内存, 现在呢是把它脱离的键盘当做平板使用的一个场景,可以进行触屏触屏操作,那你把它连接的键盘之后呢,就变成一个笔记本电脑了,底下触摸板包括键盘呢都可以直接使用,然后我们现在把它插上电来看一看他玩游戏到底怎么样呢? 现在的集成显卡其实已经也很很强了,所以现在呢,我是呃开了这个最高的分辨率啊,就是这个平板是两 k 的分辨率,最高的分辨率,然后呢是中档的画质,然后十六比十的比例啊,这个这个屏幕还是十六比十的,所以现在的真率大家可以看到啊,现在已 已经是五十多六十多,非常的稳定啊,非常的稳定,所以现在是守望先锋不吃配置了,还是说现在的处理器都变强了呢,所以这个 就是这样一个提升显卡,能玩到五六十针的一个效果,我觉得还是挺不错的,而且还是啊这个两 k 的分担率,但因为它是英特尔的处理器,所以说这边的接口呢,还是一个雷电四的接口,如果说你刚好有这个闲置的显卡扩展物的话呢,哎嘿,我就有,所以我们就可以 把它连接显卡扩展屋呢啊,来把它显卡的性能进行提升,就可以让这个游戏的表现呢就更强一些了,所以接下来我们把线插上试一下。 好,我现在已经把这个仙卡破产物接上了,里面装的是一个比较老的仙卡,是 gt x 九七零的仙卡,然后现在呢,把它设置到游戏的最高分辨率,就是这台显示器的最高分辨率,是四 k 的分辨率啊,比四 k 还 高一点,然后呢啊,十六比十的比例,然后底下的画质呢,调到了啊,这个极高啊,这个时候呢,我们再看这个真率, 维持在七十针左右,所以这个效果还是挺不错的嘛,对吧?所以理论上如果说你的显卡更高的话呢,这个效果肯定也会啊更高的。那这个时候我们再来看看这个 cpu 的占用啊, cpu 的占用只有百分之三十四三十多,所以这个游戏的表现我觉得还是 挺不错的啊,现在的这个轻薄本也可以啊,就这么流畅的去玩游戏了,然后我们再来爆炸一下,看他这个真率啊,没有什么影响,所以还可以吧,所以大家感觉怎么样? 这样一台轻薄本幺幺六零 g 七集成显卡,再加这个显卡破产屋就可以达到这样的一个效果,当然这是英特尔的处理器的优势啊,他有雷电 四的接口,你就可以接线看,快让我。当然如果说你有的话,里面再装一个高端的显卡,理论上是可以玩一些大型的游戏的,大概就是这样感受一下。
1.7万科技小辛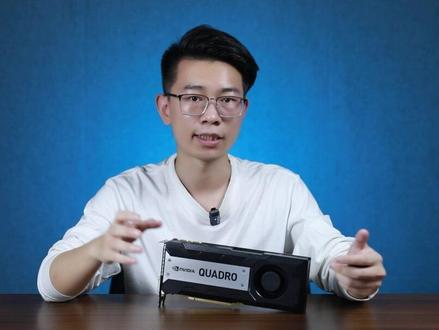 00:51查看AI文稿AI文稿
超级计算机不用买显卡了,通过浏览器就可以连接,性能直接起飞。近日,英伟达发布了 dg 叉 pro 的,也就是云服务器,企业能够实时接入用于训练生成式 ai, 里面还配有英伟达配套的 ai 软件 服务呢,使得每个企业都可以通过浏览器就能访问自己的 ai 超级计算机,而无需在本地部署自己的服务器。因为拿创始人老黄表示啊,我们现在正处于 ai 的 iphone 时刻,初创企业正在竞相打造颠覆性的产品和商业模式,老牌企业则在寻求应对之法。 目前,英维达正在与全球领先的云服务器厂商甲骨文联合托管 dj 叉 pro 的基础设施,微软预计会在下个季度跟进,不久之后还会扩展到骨骼云上。 此外, dj 叉 pro 的售价是按实力来计算的,一个实力配有八个 h 一百或者 a 一百的 gpu, 每月三万六千九百九十九美元起,折合人民币二十五万五千七百四。不知道这个定价大家觉得是否划算呢?
111李哥说显卡-AI 02:49查看AI文稿AI文稿
装一台机架式徒刑工作站,这台服务器来自华为超巨变,型号 rh 二二八八 hvo, cpu, 志强十核心二十线城四二一零 r 两颗, 内存三十二 gdr4ecc 四条,总容量一百二十八 g 显卡因为达专业图形卡 isa 四千十六 g, 现存两张 硬盘,一个九百六十 g 企业级固态硬盘,两个八 t 企业级机械盘,祖瑞的一、数据备份 萨斯十二 gb 瑞德一阵列卡 rh 二二八八 hv 五、系统采用二 u 外形设计,前置十二个三点五寸硬盘, 后置两个实际万兆网卡,四个千兆网卡支持横插转接八个 pcie 设备。 系统内部四把系统散热风扇,配合导风罩为整机提供散热。 两个二油被动式 cpu 散热器,电源两个九百瓦一加一荣誉电源。 这边啊,另类系统已经安装好,对应一下配置, cpu 四二一零 r 两颗,内存一百二十八 g, 两张 a 四千液晶识别下面压力测试服务器。
364易加服务器工作站 01:04查看AI文稿AI文稿
昨天冲浪的时候看到一张图,属实是把我给整不会了,原价幺零九九九的电脑,还要经过多方商谈,终于砍价到五九九九的价格。我们来看一下是什么配置。 cpu w 三六七零主板叉五八,华为十六 g 内存,红星六百瓦电源 g 七三零显卡。并且还加上了防辐射,地宫号护眼之类的形容词。我们来看一下这一套捡垃圾捡出来要多少钱。 cpu 老朋友了,志强洋垃圾 cpu, 均价八十块,主板比叉七九还 要拉垮,一百三十纳米的工艺,属实是烤火炉工业,均价在一百五左右。内存说实话这个内存我是挺吃惊,华为哪来的内存啊。后来我在海鲜市场发现,原来华为的内存指的是华为服务器上退役下来的 ecc 内存,那也是一百七的均价。 电源红星,鼎鼎大名的红星电源,著名的战术核电源,一发就可以机会一个航母战斗群,非常的强烈,也是一百七左右。 gt 七三零相当于是 什么水平的显卡,相当于幺零四零年的和弦,水平非常的弱,价格在两百左右。我们核算营销总价七百七十块钱。这波啊这波是学校多方协商,含泪血赚五二二九。我是老美老七,科技趋势。
8.7万洋捞机


