4090显卡可以训练ai模型吗
上一个视频我已经组装好了四零九零显卡的电脑,具体的电脑配置可以参看我上一个视频。今天这个视频呢,我们一起看一下 nvda a 一百和 nvda 四零九零在模型训练和推理运算中的性能表现。 a 一百隶属于恩威利亚的特斯拉系列,四零九零隶属于 gfos 系列,前者是面向数据中心的产品,后者是面向消费者桌面端的产品。 今天的测试呢,我们就选择用阿里达摩院开园的 facetchen 这个 ai 项目,它的原理是我们上传三到十张照片,然后他马上会对照片进行处理,然后进行在线的捞二训练, 训练结束以后,用训练好的 lord 结合风格 lord 进行推理运算,生成六张新的写真照。我这里已经在 a 一百和四零九零这两台机器上布 数好了飞子称,如果大家也想不数飞子称,可以看我之前发的一键安装开源命啊相机飞子称的那个视频。 今天的测试方法呢,是使用两组相同的照片,测试两者的训练速度和推理速度。接下来就让我们开始吧。首先我们先测试一百这台服务器的性能, 现在看到这个界面呢,就是 facetchen 的界面,现在这个 ip 地址呢,就是我的 a 一百服务器。然后呢,我们选择三张照片, 然后我们在这点击开始训练,然后我们看这已经开始训练了,我们就在这等, 我们看一下现在 a 一百这台服务器上显卡占用情况,这是我的 a 一百服务器, 我们能看到一百四十 g 的现存,然后呢,这是它的 gpu 的占用,然后呢,这是现存的占用,现在就是在做训练, 我们看多长时间能训练完。 用了二百零一秒,然后我们在这点推理, 现在就开始推理了,我们看多长时间能推理完? 推理用了五十六秒,生成了六张, 接下来我们换三张, 然后点击开始训练。 第二次训练用了一百九十秒, 我们点击开始推理计时,看这次用多长时间能推理完。这次推理用了五十四秒。 现在的这个画面呢,还是 facechen 是四零九零上运行的,然后我们导入相同的照片, 然后我们点击开始训练, 看四零九零用多长时间, 现在四零九零上面的也跑满了,然后这是现存,现存的消耗四零九零, 四零九零第一次用了一百五十秒, 然后我们执行推理, 看四零九零退了,用多长时间。 四零九零推理用了三十八秒, 然后我们换三张照片, 然后点击开始训练, 这次训练用了一百五十秒, 这次推理用了三十七秒。 通过测试来看,四零九零二十四 g 显存在跑捞儿训练和图像推理时的性能是高于 a 一百四十 g 显存版的,这应该是得益于更新的架构和制成工艺以及裤带数量的提提升。 今天的分享就到这里了,希望通过今天的对比测试,让大家能够对四零九零的性能表现有个认知,希望对研究 ai, 准备购买四零九零的朋友有所帮助。另外说一句,四零九零这台电脑我安装的是国产的 linux 操作系统,低频二十点九, linux 在训练和推理中的性能和稳定性更好,推荐有条件的朋友可以选择系统平台性能对比,大家 可以参看我之前发的不同平台对 sleep defusion 出图速度的影响的那个视频,大家如果有什么疑问也可以在评论区给我留言,大家一起友好的交流,谢谢大家!
粉丝3071获赞1.4万
相关视频
 03:54查看AI文稿AI文稿
今天给同事装了一台四零九零显卡的电脑,用作模型训练服务器, cpu 选择的是英特尔的幺三六零零 kf, 六大盒八,小盒二十,现成最大锐频五点一级。 之所以选择 i 五而没有选择 i 七,是因为在工作中大部分时间 a i 都是利用 gpu 在运算, cpu 只是完成工作负载的卸载,所以这颗幺三六零零 kf 挺合适的。 散热器选择的是利民的 pa 幺二零风冷散热器选择 pa 幺二零是因为工作中使用不需要像水冷的那种花里胡哨,而且也是为了避免漏液的风险。 主板选择的是华硕 top game b 七六零 m plus, 华硕是玉三家的老大,这个就没什么可多说的了。对于 ai 训练, ddr 五的高带宽还是要优于 ddr 四的,所以内存开始买的是金百达的 ddr 五六千四六十四 g, 结果安装完了以后翻车了。装完以后开机点不亮,屏幕一通排查,最后发现是内存的问题,降频到五千六可以开机了,所以赶紧联系京东做了退货, 然后又采购了今日顿的 d d r 五六千六十四 g 硬盘。我们选择的是智泰的太 plus 七幺零零 p c i e 四点零两 t。 智泰是咱们国货之光,就是他把三星和西数的价格给打下来的,自打有了智泰,我们发现其他品牌的 s s d 的工厂也不着火了,也不污染颗粒了,所以呢,能支持还是支持一下。国货显卡呢, 选择的是七彩虹的四零九零 adoc, 包装盒里附赠了显卡支架,四零九零的显卡是又大又重,一块卡占用了三个槽位,如果没有显卡支架,我感觉都不是说用久了会变弯的问题了,而是感觉时间久了金手指都有可能会被掰断。 所以大家如果购买四零九零呃,没有辅赠显卡支架的话,一定记得自己买一个显卡支架。电源选的是微星的一千瓦 atx 三点零,然后原声的十六频的显卡接口。 机箱呢,选择的是长城的引刃 h 五幺三,这个机箱说不上有多扎实,但是散热设计特别好,对于我们这种七乘二十四小时运行模型训练的场景就比 比较合适了,不用担心散热问题。即将风扇选择的是先马冰冻十二厘米,买了六把, 这个风扇最大的特点就是静音特别好,本是想把整个装机的过程都录下来给大家看的,结果昨天内存翻车了,然后开始的时候不知道是内存的问题,然后一直在排查,把电脑拆了装,装了拆,然后弄得乱七八糟的,所以呢,也就没能录成这个装机的过程。 然后呢,大家就先看一下最后装机完了这个整体的效果吧。机箱的封道设计是前面装了三把风扇,后边装了一把,顶部装了两把, 然后呢,整个风道呢,就相当于前进后出加上出。然后呢,细心的朋友应该能发现,上面上面其实能装三把风扇,然后故意装 装了两把,最边上这把没装,是为了防止冷空气刚进入机箱还没有形成循环,就被上面这把风扇直接把给抽出去了,所以呢就没装边上的这一把。然后呢,大家看到的这个立柱就是他附赠的那个显卡支架, 因为这个显卡真的很重,大家如果买四零九零的时候一定要记得装个显卡支架,现在看到的画面呢,就是机箱安装了侧头面板之后的整体效果,现在正在安装操作系统。下一个视频我们一起看一下四零九零和 a 一百这两张卡在做模型训练和推理运算时的性能对比是怎么样的。
59titan909 01:02查看AI文稿AI文稿
ai 训练深度学习什么方向?选什么级别的显卡?今天我们来说一说相关专业学生。从业者从一块 it 叉四零七零开始进一步学习。建议卖掉 it 叉四零七零,并购买多路 it 叉四零九零。 自然语言处理研究人员如果不从事机器翻译、语言建模或任何类型的预训练工作,那么二 tx 四零八零就足够了,而且颇具性价比。计算机视觉预训练和机器翻译研究人员 建议四路 r t 叉四零九零涡轮显卡注意配备相应的大功率电源及散热设备用于模型病情训练。少于一百二十八个 g p u 的 g p u 集群建议八路 r t 叉四零八零和八路 r t 叉四零九零用于模型病情训练。高于一百二 十八个 gpu 的 gpu 集群,八路 a 一百是最好的选择。深度学习 ai 训练电脑怎么选?关注霞姐,持续给你分享!
163咨钛服务器硬件 00:48查看AI文稿AI文稿
现在是凌晨两点,我准备用四零九零的显卡把我之前画的草稿用 i 细化一次,咱们来看看他究竟给我画成个什么东西出来。 哇哦,效果很不错哎啊,这个脸可能需要得往右拉一拉,这个手的透视不对,这手是啥?没关系,咱们弄到那个 creat 里面重新绘制一下。我们首先先施个法,拉一下液化,稍微往右边拉一点, 这个是原图,将 ai 画的一秒就变这样。不愧是四零九零。
1582喂鱼AI+IP自媒体 01:01查看AI文稿AI文稿
这个画的也太抽象了吧,怎么三条腿啊?今天用四零九零去跑一下,能否应该看出一张图需要几秒?那么我上期视频呢,就说了,推荐大家用 stapple dps, 你去绘图,这个文件夹里面呢,也都标出来,比如你显卡只有六级显存,那你就用这个八 g 呢,就用这个八级以上显存,那就下边这个,那么看到文件都加载出来以后呢,就代表成功了,然后我们复制 ip, 加短款号,打开浏览器, 回头之前呢,我们来拉一下三 plus, depths, 裁阳部署 batch 抗震,这个是一次给你生成几张,拉到一,就是每次只生成一张,一次类推 cfg 拉到十一, 那我们随便加点 tag 四零九零出去当图只需要八秒,这就体现出大显存的优势了。那比如我还想再让他穿上黑色,那我们后面再加一个 black tokins, 哦吼吼,这个比上次那个好看太多了。那我们再多生成几张玩玩。那这个是我从其他地方找来太子,然后我们来生成一下。 这个画的也太抽象了吧,怎么三条腿啊?那这个 ai 呢?开始变得不聪明起来了是吧?后续呢,还得给他训练一下。好了各位,我是林青,我们下个视频再见。
2432凌清 01:05查看AI文稿AI文稿
说到一题啊,之前有客户找我们买了四零九零,他说他这个四零九零还干不过他的三零九零,我们后来把他的驱动更新到最新啊,才解决这个问题。所以说为了避免这种花了钱没办事的情况发生,我们一定要记得更新 呢。对于 md 和英特尔显卡的用户啊,虽然说有相应的资源包整和支持啊,但是由于它产生的性能,偶尔玩一玩可以啊。那如果说你是跑大模型的话,小刘这就不推荐了。在硬盘方面呢,没有特别大的一个需求,硬盘的容量越大越好, 反正现在在长江消防队的带领下,这个硬盘的价格已经来到一个白菜价了。视频最后给大家简单总结一下, cpu 呢,要求不高, 单合金越强,操作越丝滑。内存这块呢,建议是十六 g 起步啊,最好是两倍于显存大小。显卡呢,当然是同级别显卡,显存越大越好啊,能上四零系就上四零系啊,这个显存是决定了你出租的上限。现在呢,小 给大家准备了几套 ai 汇足的整机配置,希望能够节省大家的选购时间。至于更加专业的方案呢,也欢迎大家可以多找我聊一聊。好吧, ok, 那本期视频到此结束了,我是小黑,一个专注于做生产定制博主,我们下期视频再见。
60楼下小黑 01:44查看AI文稿AI文稿
上期聊到八块四零九零,今天啊,给兄弟们装机上去,整一台真硬核计算机,价格看起来有点离谱,二十六万九千九百九十九,但这可不是普通的计算机,我们在上面安装了现阶段最强游戏卡,接下来就带大家体验一下二十六万九千九百九十九的 ai 图像应用解决方案。 机箱是全新的浪潮 f 五四六八 m 六服务器,拥有超强的散热性能,巴掌双宽巨屏扩展性显得美劲啊!这一台服务器啊,不仅拥有一颗强大的英特尔智强金牌五三幺八 y, 还有一颗,没错,两颗叠加也就四十八,核心九十六线程锐平啊,也就三点四九赫兹而已。 内存方面,我们给它配备了五百一十二 gbl, 在多任务运行时呢,也不用担心内存不够哦。硬盘吧,我们准备了两块 九百六十据步态和四块车踢萨塔的硬盘,穿出你所有的学习资料也够了哦,哈哈哈哈, 这台服务器还有重头戏啊,一二三四,想要还有四块呢,一个搬砖的配吗啊, ok, 一共八个 itx 四零九零涡轮版显卡,让你在渲染、 ai 深度学习等场景下都能得心应手哦,兄弟们心动了吗? 最后别忘了四个三千瓦的勇于电源,让这台伏器稳定运行,不会突然出现掉电的尴尬场面啊!总之,这台伏器不仅外观炫酷,配置强悍,而且啊,价格值得,谁不想拥有这样的大玩具呀?
6864IT绿灯侠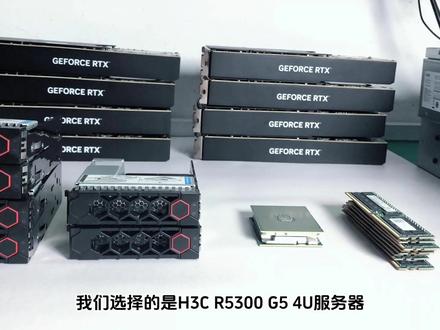 01:40查看AI文稿AI文稿
杨哥,哎,最近有个客户联系我,说想做一个可以做基础训练的问答机器人模型服务器,但是客户预算有限,要我们二十六万以内帮他搞定, 没问题交给我。接下来就带大家看一下集训练为一身的问答机器人 ai 三零亲民解决方案。我们选择的是 h 三 c r 五三零零 g 五 c u 服务器, 他在拥有超高的 ai 算力的同时,又有一线品牌的品质和服务,我们给他配上两个因特尔之强金牌六三三零 cpu, 没错,两个叠加也就五十六盒幺幺二线乘二点零 hg。 内存方面,我们给它配上八个 d d r 四三千两百六十四 g b, 也就是五百一十二 gb, 再多任务运行时也不用担心内存不够。两个 pm 八八三九百六十 gb sata 企业及固态盘做系统,四个 meme 固态七点六 t 做数据盘,满足性能的同时又获得大容量的存储空间。 最后加上 ai 的心脏八块 r t x 四零九零涡轮显卡,让你在预算有限的情况下,通过并行的八块 r t x 四零九零可以顺畅的跑起来。 ai 深度学习训练等场景,同时可以获得即问即答的 ai 沟通体验, 这样还打动不了客户吗?这台服务器不光有一线的品牌质量,我们还可以给客户提供专业的 gbt 及 ai 分析服务,这下客户该满意了吧?
109旭鑫集团 01:46查看AI文稿AI文稿
上周我们针对四张四零九零做了整机功耗和温度测试,今天和大家分享一下八卡四零九零的整体测试情况。众所周知,在四零系显卡发布的时候,老黄声称四零九零显卡的性能将会是三零九零它的二到四倍,那在 ai 方面的性能究竟如何? 我们实际测试一下。此次测试配置和上期的一样,平台是四二零 gp 杠七二, cpu 也同样选择的是英特尔志强六三四八处理器,只不过四零九零的数量由四张变成了八张。 另外,为了更加直观的体现,我们将用四零九零与 gbox 同系列用于机器学习的三零九零和三零八零做下性能对比。首先我们使用了最新的 ngc 容器,简单测试一下 resnite 五十的性能表现。分别测试呢, f p 十六 x 赛子为一百二十八和二百五十六,以及 f e 三十 sss 为六十四和一百二十八的几种情况。结果显示,四零九零性能相比三零九零提升了百分之四十以上,最高提升有近百分之八十。同时,我们对比测试了单卡、四卡、八卡的性能,由于 pcie 贷款限制以及额外的通信开销, gpu 多卡性能相对单卡提升巨大,但并非呈现性提升,实际应用可依据具体环境优化代码,多 gp 的性能加速还有提升空间。 总结一下,新一代 itx 四零九零显卡性能相比上一代 itx 三零系列有了巨大的提升,最高将近百分之八十。且此次涡轮版的四零九零卡应强化了自身涡轮风扇散热的能力,无需在机箱尾部外挂辅助风扇也能很好的控制温度, 同时与超威巴卡 gpu 机型依旧适配,在整机满负荷的情况下,做了七十二小时压力测试,依旧可以持续稳定的运行。
640赋创AI算力 02:27查看AI文稿AI文稿
baby, i love you to them stars talking like mufasa no you got some scars but i promise that i got you stars singing legs and natro flamming to the moon there ain't nothing that can stop you baby, i love you to the back baby, i love you too cars yeah we made it。
419大圣爱装机 00:45查看AI文稿AI文稿
今天给粉丝安排一套高性价比的 ai 绘画电脑,接下来我们来看看具体的配置。 cpu 我们选用的是英特尔最新发布的幺三九零零 k 二十四和三十二现成的处理器,配上雅骏三六零 ga 五一体水冷散热,主板选用华硕的 z 七九零杠 p wifi 主板主打的就是性价比。存储方面我们选择英特尔家族血统的后代海力士 p 四四 pro m 点二硬盘 稳定性有保障,两千的容量存个图片简直是易如反掌,嘿嘿嘿。海内饰原厂的三十二 g 五六零零内存装上四条,总共一百二十八 g, 再也不用担心内存容量问题。最关键的是显卡,我们选用微信的四零九零魔龙 ai 生成,图片效果八群,整机的功耗不到八百瓦, 用全焊额定一千瓦金牌 at 叉三点零电源绰绰有余。下期视频我们将分享这个平台的 ai 绘画实际测试效果。
47小黄豆设计师电脑 13:23查看AI文稿AI文稿
好,大家好,我是剑阁。从去年三月就开始大火的 novo ai 绘画激发了很多年轻人对于深度学习和人工智能的好奇心。哎,即使自己学的并不是相关计算机或者相关理科的内容啊, 对于二次元的绘画创作需求也有是源源不断,毕竟谁不喜欢看艺术图呢? nova 的背后的开源项目 stable diffusion, 正好有个同学让我要组一台双四六零的 ai 画画,但是呢,又要比较省钱的配置, 想花钱的配置好弄完的直接服务器内躺拉满就可以了。想省钱的话,那就需要精打细算一点的。所以说我们就借此机会来简单探索一下 cable diffusion 对于计算机硬件配件需求,看看哪边可以省一省。 虽然我们这次用的是双四零九零啊,但是很多用户可能并没有这么多预算,或者想用到现有的显卡试着玩一玩。 所以首先就说一说显卡的需求。其实这个课题啊,在之前外媒汤词啊 how well 就已经有编辑发表过测试文章了,链接在节当中啊,这位编辑就测试的非常认真,他把 a n i 三大显卡都尝试测试一遍。 从三家软件的思维来说,深度学习领域就是恩卡的天下, amd 的显卡和 inter 显卡在这里就表现不佳,毕竟像 coda 探测课啊,都是老黄搞出来的, 开发了也是基于 cuda 和 tenthsocore 去开发的。虽然这几年因为打在游戏玩家口中他经常被骂,但是当 a m b 还在折腾 g c n, 英特尔还在 吹 a b x 五幺的时候啊,老黄他早就已经提前布局人工智能赛道了,领先 a m、 d 和英特啊,都不知道哪里去了,而且市值啊还是他们的四倍。 作者测试了五一二乘五一二分辨率的小图和二零四八乘幺幺五二的大图,两种情况下的每秒钟的迭代次数,小图是每张图一百次迭代,一次跑十张去做计算,匹配迭代速度。结果小图测试下四零六零的效率大约是三零六零的四倍, 而且这个性能表现基本算是符合三 d max 里的理论性能差距,前提是只开恩卡。但是到了高分辨率的大图下就不太一样了,大图是二十五次迭代,每次生成三张图片取拼音值。在这里四零系的效率就大幅领先于三零系的, 这主要得于四零系新一代的探测课,让深度学习的效率大幅提升。顺便提一下,这张调节图中还有一些深色 的数据条款,那么正在关闭 x former 下的成绩,这该子 former 是什么东西?我们接下来会提。接着就是我们自己的测试了。测试开始之前,我们先过来介绍一下测试平台和项目。 cpu 是英特尔的 i 七幺三七零, kf 主板卫星的 b 七六零,排气泡 max d 五,内存支持十六 g 乘二, ddr 五六千 c 三十。现在用的是电竞盼克的四零九零三六零钛和三六零,另外还有公版的三零八零,我目前我手头就只有这些卡了, 家的配件还有软件的环境相关配置图就不一一念了。驱动版本五二八点四九。测试的设定我们仿照上面他们猜不到。文章里的设定共分为了三个预设,分别是五一二乘五一二分辨率,每张图片一百次迭代共十张。 幺二八零乘七二零分辨率五十次叠带共十张。一九二零乘一零八零分辨率二十次叠带共五张啊!在这里肯定有观众问,为什么不去设定二 k 或者 四 k 分率的图片啊,这个就直接看最终成就知道了。那三六零跑一八的一分率的话,都要花的时间就已经很长了,一百次点赞每次都要两到三秒左右,跑一次都需要四分钟二 k 四 k 的分片率的时间,没有时间去等了, 看到我们在低分辨率下,我们这个四零九零的效率甚至还不如三零八零,跑了很多次都是如此,可能是和我们的叉 pro 的文件有关,或者和设定有关,但是高分辨率的图像还是非常符合预期的, 而且分配率越高,四六零优势就越明显。显卡的性能跑完了,但也曾出了很多和显卡相关的问题,比如说显存容量、多卡并行、 pce 贷款问题。 说实话,这些问题也困扰了我们很久,既然这次有机会测这么多显卡,那就研究一下吧。先来研究第一个问题, ai 绘画图片到底需要多大显存?我们试了一下,使用我们拿到的拆个 out 文件,在不加载 x form 下并且生成一零八零分率图片的情况下,它的 x 三零六零的显示占用可以有到十 g 左右,而多数二十系、三零系的显卡显示容量都是八 g, 图还没有跑,显示就爆了 啊。就像这个 r t x 三零六零 t x 三零八零一样,就直接报错了,只能降低生成图片的分类率去跑啊,这样就会非常尴尬。 所以 x form 这个工具库就尤为重要了,它不仅可以大幅度的提升图片说能速度,而且能显著的降低显存的占用。比如说三六零,在有 x form 加的之后,速度就提升大概百分之八十二,显存占用也就只有五 g 左右了。 所以我们强烈建议在使用 sabletifiction 的时候加载 x formals。 至于如何加载和下载,网上教的还比较多的,我们这里就不做教学了。上面显卡成绩和加来的占用数据都是启用 x formal 的,我们就不开 分开讨论了。这两再多提是有意思的决定不少。有所谓的二零八零泰摩改二十二 g 的,最早是俄罗斯这个博主发出来的,所以现在都有这些店铺去专门做改装方案的。那大概就是说如果显卡的 bios 知识的话,把以前的一 g 显容换成两 g 的啊,享受一下二零八零泰变成类似于 itx 六千的感觉。 一些跑计算吃血存的学生党会比较关注,有兴趣的可以自己搜索去了解一下,我这里没有多研究,就不去多发表意见了。 第二个问题啊,就是可以多张显卡一起跑吗?如果是多个显卡同时运行一个图片去完成作业,那肯定是不行的, 目前软件还没有去做这方面的适配和优化。两张三六零要往上一插,同时也只有一张在跑。所以说让两张三六零都跑起来的话,只能采取一些比较笨的办法,就开两个 stable 的 q 式的进程,让第二个进程十 使用另一张显卡去跑啊。这里需要一个小代码,以 window 系统文例啊,复制一段这个 bat 的文件,右键编辑在下方输入这样一行的啊,命令 x, x 是数字,这样就可以指定这个 cbod future 的进程要用哪个 gpu。 比如说我想用四六零打游戏,在打游戏的同时使用闲置的三六零画画, 管理器的 g p u 零是四零九零, g p u 一是三六零,那我就可以在上面的值里面写一,这样我就可以指定 g p u 一,也就是三一六零去画画,就没有四零九零什么事了。同样的,如果说你还有两张的四九零同时跑,那就要同时进行两个进程,其中一个进程选择 g p u 零,另一个进程选择 g p u 就行了。 第三个问题,如果说我有多张四零九零,那 p 三六带宽够不够啊?那正好我上周这个时候也提到了他一个十万块下装飞的水的视频啊,硬盘里装的 cpu 通道的五点零的 mdr 叉槽, 他就和显卡会抢动到四零九零,会跑在四点零叉八的速度上,那看着呢,就很膈应。我们现在要用双四零九零来画画,那目前的主流的家用平台都是没有办法给出两个 p c i e 四点零乘十六的满速插槽的。 好多个四人称使用的码子插槽的话,你的选择就是像 a m d 和英特尔的高端平台,比如说 t r 叉四零, w r 叉八零这种 搭配现成四叶者处理器,或者说十大米的至强 w 三千三系列,加上 c 六二幺 a 芯片组的主板,或者说是最近刚出的最强的 w 三四零二四零系列,加上 w 七九零芯片组的主板, 那这些的价格就分分钟起飞了,相对便宜些的就只能去捡垃圾的,你可以捡到一千块左右的拆机的骁龙三二零二 p 或者七 d 幺二这种 cpu。 但是相对应的主板,它的涨价就挺多了,比如说像五个 p 三一四 凌晨十六的超威的 h l s s l i, 从两千多又涨到了三千多,你要去组四卡的话可能还比较划算,双卡的话感觉还是有点贵了。 所以说在试售的常见的家用的平台,主要情况下,那四点零就只能跑到四点零乘八的速度。于是我们也测试了车内内容啊,结果发现其实对于 stable diffusion 的图片上来说,这几乎是没有太大区别的。这里我们使用了四点零乘八的实验方式是把插槽降到三点零乘十六, 三零乘十六和四点零乘八的带宽是一样的,甚至即使是插到走芯片组的 pc, 四点零成色画面效率也并没有去降低多少,也就是小几个百分点。所以说 pc 这个带宽的问题哦,不用太担心, 这样其实左上滑就会很多便宜的血流了。因为目前主流的樱桃的闭合这系列主板,这下面基本都有一个 p c s 二零产 四规格的乘十六的插槽,反而这个时候面临问题也少,四零九零它基本是三槽甚至三槽办的卡,选择机压的时候就得注意它有几个 pc 插槽的位置,或者说你干脆去用 pcie 的延长线。接下来是 pcie 的一些相关情况化。既然都拿四零九零来测试了, 我们就顺便测试一下三 t max 和实际游戏中 p c 一带宽对于四零九零影响,四点零确保 p 三一四点零乘八甚至乘四到底有多大影响? 但是三零 max 可以看到,除了专门测试 pc 一带宽的 pc 一特性测试能直接开出带过来区别以外,常规的理论显卡得分四点零乘十六和四零长八甚至基本上没有区别,到了四点零乘四才稍微掉了点,性能大概是百分之八左右。 二六四的 g p u 的测试也表明了除了显存的读写受到了 p 三一贷款的影响比较大以外,其他系统的影响都不是很大。现在看下,实质有 分分钟是四 k, 除了 cs, go 是替换的,这把去游戏都是最高画质。游戏中的平行针数区别其实和跑分类似,四点零乘十六和四点零乘八差距不大,但是四点零乘四就有了百分之十左右的区别了。 这方面乘十六和乘八其实还能接受,除了采用像围攻最低针跌百分之八以外,其他都是和平针一样,在百分之二和百分之三之间,四点零乘四最低针就会掉的非常多了。所以说打游戏的话还是非常不建议四零九零去跑在四点零乘四或者三零乘八上, 但是那些还有老平台就比较只想的只换显卡平台也得去跟上去。虽然四零九零在不同的 pce 速率下的测试表明,四点零乘八的贷款其实并怎么影响四零九零的发挥。 不过讲句玩笑话,一张两万块钱四零零就算按照损失百分之二的心愿,也快四百块钱了,买几万块钱的电脑,人到底会不会就在意这四百块钱呢?以上 呢,都是和显卡相关的测试,接下来是内存和 cpu 的测试,看看这部分能不能去省点钱。内存频率第五第四内存有没有区别呢? cpu 我们用稍微差一点的,有没有区别呢?我们也凑测试了一下, 除了内存设置,如图, ddr 五组,我们选择十六 g 乘二四千八这一带默认规格和六千 c 三十的游戏规格啊。 ddr 四选择了八 g 乘二的三千六 c 十八,还有三千二 c 十六的两种规格。从结果来看,用低五还是低四,高频还是低频基本是没有区别的,四九零表示都能吃得消。 第一部分我们就是把这颗幺三七零 kf 关闭,所有小盒只保留了六个大核心,并且把频率降到了四 g, 用的频率也降到了四 g, 模拟一颗 i 五幺四零 f, 不过三环是无法关闭的,所以是三环还是 it 的三十兆的三环。结果是性能有一丢丢的损失,类似于四点零乘十六降成四点零乘四那种,所以 cpu 性能这块不予太过担心。不过我们还是推荐去 i 五幺三四零 f 起步。但是测试过程中我们也发现一些和内存相关的问题,比如说我们的一零八零 p 的图片,每张大约大小是四兆左右,这张牌的图片可能会被重复到内存中, 一旦生成的图片数量过多,这个就会被占用的很多。我们使用 ddf 三超级乘二的内存,跑一米八零分率的图片跑八千张,每张图片迭代二十次,一开始的时候内存占用是七点六 gb, 看着还行, 第二天下午就占用了四十多 gb, 到了第二天晚上也就是二十二个小时以后呢,内存就占用了六十 gb 了,而且在图片出阶段的话,内存会直接吃满电脑会夹死, 所以说十六 g 只能是平时闲的无聊,简单跑跑画画。如果说要正经生成图片的话,还得去准备较多容量的内存,比如说虽然对内存的性能要求不高,但是对于容量的要求还是比 比较高的,尤其是七至二十四小时不间断运行的快用户内存容量的话还是越大越好,没有上限。呃, ddr 四三十二计的,一根也就四百块钱了,直接插两个三十二计算了,后续觉得不够用再去加。 主要投资还是以显卡为主。工号和温度方面是留在跑了五月二乘五月二这种小图片时候,其实负债并不是很高,可能是因为啊迭代次数太快了,导致 gpu 占空比更低。工号大概是三百瓦出头,而跑一零八六的图片工号就是四百瓦了, 比打游戏的功放还要高一些。考虑到很多人跑图的电脑肯定是不关的,甚至是七至二十四小时不间断运行,同样单杠情况下,比两年的挖矿的时候的发热还要大,所以说机箱的散热透风还是要做好的。 不得不感慨啊,四人际显卡逃过了挖矿,最后还是没能逃过深度学习。简单总结一下, ai 绘画非常看重显卡的探索口 的性能,四零四显卡优势非常大,有这样的需求应该是优先考虑四零四显卡,如果说有多张显卡也可以分开跑,对于平台的贷款要求并不大,对于 cpu 和内存性能也没有什么太大要求,主要还在显卡上面。另外如果是重负债的密集型的跑的话,还是需要准备去大量的内存, 并且做好显卡的散热。最后我是给同学选择了 i 五幺三四零加入门级的 z 六九零加三叉六乘高的 d 四加三 t pm 九幺两 t 加吸收企业级硬盘十六 t 加上运动电竞派克的四零九零两张加海盗船七八零 t 加海域 plum p 三千三百瓦白金电源纸箱呢?又塞了几个匿名的便宜风扇, 相信这个配置给他做 a 绘图还是足够了吧。那今天节目到这里,不知道看我们视频对你去选择 a 画图的电脑配置有什么帮助呢?欢迎留言弹幕与我们交流。在朝阳课,我是剑客,下期见!拜拜!
504潮玩客 01:36查看AI文稿AI文稿
大家好,给大家简单分享一波数码资讯啊,前一段时间吧,有讲过那个 amd 显卡那个驱动更新了,然后刚好那个驱动更新介绍里呢,说到那个七九零叉叉这个型号,他那个 ai 性能呢,提升了很多。 今天呢,看到一个新闻啊,就是说一个华人大神,然后他的 a m d 显卡 a i 炼丹性能呢追上来了, 他现在七九零叉叉的显卡跑出了令人满意的成绩,性能已经达到了四零九零显卡百分之八十二, 或者是三零九零太显卡百分之九十四。那这个提升性能还是挺大的,也就代表现在有这些团队呢,专门在研究这个 amd 显卡,在 ai 炼丹这个领域啊,这个 不断去更新这个技术,不断去优化这个技术,那么未来也就代表 a m d 的大显存型号的显卡呢,可能也会大量应用于 a 领域啊,那就代表这个 amd 的显卡可能高端型号也不太好降价了,不知道该说什么好啊,如果说你已经买这个显卡的话,那我觉得这是一个好消息啊,如果说你没买这个显卡的话,我觉得后面这个七九零叉叉降价可能都有点难了,特别是最近这段时间,价格好像也确实没有往下降。 那么今天这个显卡价格吧,最近这段时间我是能感觉到厂家这个深深的恶意的,就是限价限的特别猛, 然后今天看到一个勉强还算可以吧,就是汉凯的七六零零啊,合金版,看这个颜值的话还算不错。 然后因为是拼多多这块的,所以如果你有券的话,那么你减免一下就是一千七百九十九价格,这还算可以,其他的话就是这样子吧,价格变化不是很大,那么这期视频呢?就到这了,谢谢大家。
261可莉的奶瓶 01:21查看AI文稿AI文稿
amd 显卡 ai 性能追上英伟达深度学习领域华人大神陈天琪做出了 amd 显卡 ai 大模型解决方案,这是连 amd 自己都没做到的事情啊!这意味着有 ai 需求的客户并不只有英伟达这一个选择了 突破了垄断和技术封锁,根据大神的优化算法,七九零零叉七叉跑 ai 大模型性能已经达到了四零九零的百分之八十,三零九零太的百分之九十四。要知道七九零零叉七叉的价格是远低于四零九零的百分之八十的。 这下英伟达的显卡终于也不能再高高在上了,赶紧速度降价吧!五零七显卡核心爆料,英伟达下一代显卡核心有五款, gb 二零二, gb 二零三, gb 二零五, gb 二零六, gb 二零七,可以发现对比网贷来说有明显不同, gb 二零四核心 被砍没了,以往代号零四核心的都是七零太系列显卡,这意味着什么呢?五零系显卡高端型号和低端型号的差距可能依旧会很大。 英特尔部分显卡存在安全漏洞,去年十月到十二月售出的 a 七五零和 a 七七零显卡被爆出显卡的硬件保护机制失效,这意味着如果有攻击者的话,可以利用漏洞对用户进行打击。目前英特尔的解决方案是购买这批显卡的用户联系所在地区的售后已得到帮助。
2537数码嬉皮士(DIY电脑) 00:47查看AI文稿AI文稿
今天我们这个粉丝本来打算买四零七零显卡,结果走了弯路,直接上了四零九零,为了帮助他选对显卡,我特意搭建了四零七零的平台让他进行测试。但是结果呢,四零七零太的 ai 绘画效率并不能满足他的需求,所以我们又重新搭建了四零八零和四零九零的平台。 这下好了,他一眼就看上了四零九零。那么四零九零显卡搭配幺三九零零 k 的电脑进行 ai 绘画的计算效率到底有多快呢?但分辨率是七六八乘七六八采样,一百二十步的设置下,生成十张图片竟只需要九十二秒 速度!一个字,萌!看到这里我就不多逼逼了,相信你们这些聪明的老板已经知道该用什么显卡来进行 ai 绘画了。好了,今天我们的视频就到这里了,如果你觉得对你还有所帮助,别忘了给我点赞加关注。如果你对其他的软件的电脑配置还有所疑问,欢迎在评论区交流,我们下期再见!
15小黄豆设计师电脑 00:52查看AI文稿AI文稿
实验室配置服务器四零九零, a 八百, a 一百,选哪个?实验室用来跑大模型的显卡怎么选?直接上结论,没有双精度需求,追求性价比,选四零九零。有双精度需求,选 a 一百,没有 a 一百,选 a 八百。 目前国内实验室主流的还是四零九零和三零九零涡轮。霞姐昨天刚出了台巴卡,四零九零的服务器是给浙江知名大学的实验室,按照霞姐交付的案例, 十万加的预算,配置四张四零九零是没有什么问题的。二十到三十万的预算则可以去考虑八张四零九零或者两张 a 一百八十 g。 如果预算不限, a 一百八卡服务器当然是最佳选择。什么你找不到? a 一百八十 g 看霞姐这儿都有。
161咨钛服务器硬件


