sd如何训练室内模型
粉丝7.9万获赞98.4万
相关视频
 08:29查看AI文稿AI文稿
大家好,今天我们来说一下秋叶大佬的训练劳尔模型的整合包工具 sd 春呐,他的这个整合包呢,跟我们之前讲的这个扣呀 ss gui 的这个训练训练参数呢?训练源码和模型 是一模一样的,只不过这是秋叶大佬进行了一下整合和优化,还有中文化,也就算是中文化的版本。那么我昨天试着用这个秋叶的这个版本呢,训练了一个模型,我是找了圣斗士的图片素材来训练一个模型, 训练好的模型呢,只有三十六兆,但是也可以用了。训练完成的模型是这个后面不带编号的这个模型,将这个模型呢复制到 stable diffusion 里面来,我们去使用这个 lower 模型,因为这个我们训练这个模型是 是二次元,是动漫的吗?所以说在 sleeper defusion 里面 check point 这个模型,你要选择一个二次元动漫的一个模型去给他生成。一开始呢,导入这个模型会发现我们生成的图片这种已经花掉了,模糊不清楚了,这是由于我们训练 过泥河的原因。过泥河的话,我们就把这个 lora 的这个权重呢,从一给它降到降低一点零点六到零点八,可以偏向于我们这个 lora, 但不至于过泥河。你设置为零点四到零点五的话,它是偏向于拆个 pose 模型,而仅仅加了一点这个 lora 的元素。 后面呢,我把这个权重给他降低,降到零点六以下,零点零点四到零点六,我们看一下结果, 那么这个输出结果呢,就能保持保持好我们这个画面的完整性,还能够加上圣斗士的这种铠甲元素, 就生成的模型质量上来说,秋叶大佬的这一款工具呢,和我们之前用 koya s s g u i 的这个工具去训练出来 模型,结果呢,其实是一模一样的,没有没有说谁好谁坏,只不过秋叶这个是更利于偏向于新手,而且不需要原码安装,直接解压缩就能用。那么他的这个安装包呢, 我已经上传到我的网盘里面了啊,也分享给大家,可以去下载了,大家可以去直接去找雀跃大佬的 这个下载地址,也是可以的。那么之前呢,我出过八戒以下现存宝马训练的安装与操作步骤这个详解,那么讲的就是我们这个 扣一 s s g u i 的这个训练教程。那么之后呢,又出了一个 local licurice loha 训练模型的这个方法都是八界显存以下的训练,所以说我们这个秋叶大佬的这个整合包呢,其实也是低显存可以训练的,也是八界以下的。他这个操作非常简单, 我来给大家就是讲一下他这个操作,我们下载好他这个压缩包之后解压缩,你用国内加速更新或者是强制更新都可以,这个看你有没有魔法了,如果你有魔法的话,你也可以用国内加速啊, 但是同时呢,你又能用这个强制更新点一下,这强制更新呢就开始更新一些库,更新完成之后, 我们点击这个启动脚本就可以直接一键启动了。一开始我们启动界面是来到这个界面训练通用模型,这一边你要设置一下通用模型呢,就是用来训练罗拉模型的基础模型, 它存放在 s d 杠 models 这个文言夹里面,你可以去你之前的 stable diffusion 的这些模型里面呢,去找到你的这个 v 一点五或者是 v 二点一的这些基础模型。 行,去给他复制到我们的这个文件夹里面,然后呢将这个模型基础模型的模型名字呢给他粘贴到这里面就可以了。那么下面这个数据及设置呢?也就是放在这个 trin 这个文件夹里面,我们来看一下,在这个 trin 文件夹里面, 这个你可以新建一个文件夹,我的比如说这是我自己创建的一个文件夹,然后里面放图片的数据集,名字呢也有讲究。嗯,在里面再创建一个文件夹,然后前面要打上一个数字,后面横杠,然后后面跟名字, 前面这个一百呢,什么意思呢?比如说我们这里面有十六张图片,那么前面这个一百就是将我们这个十六张图片呢,训练一百次就是一百,乘以十六就是一千六,那么一千六呢?再乘以我们这个训练相关参数,最大训练轮数十, 那么一千六再乘以十,也就是总共要训练一万六千步,训练一万六千步呢,大概需要四个小时,我是十二 g 的现存训练了四四个小时。那么来说一下这个正则化数据路径,这个是用来存放你的正则化。什么是正则化? 就是在之前的啊,训练 lora 的,训练 lora 分类图片的时候给大家讲过,这里面是放分类图片级的啊,如果大家不知道分类图片级是怎么来训练设置的,可以去看我前面的视频 lora 分类训练,那么下面呢是一个分辨率五幺二乘五幺二的,如果你现存 很低的话,设置成五幺二乘五幺二的,中等的话设置为七六八乘七六八的,高档的话你可以设置为幺幺零二四乘幺零二四。好,下面这个保存设置呢,这个我们要起我们的 logo 模型最终生成的文件, 这是输出目录,输出目录保持默认,你不要变啊,因为这个也不影响你。然后下面是这个每几轮保存一次,他是每二轮保持保存一次,那么输出的这些模型的结果呢?就是二四六八啊,每过二保存一次,但是呢总共他要保 我总共他保存五个模型,这个保存五个模型呢,也是你自己可以设置,你想保存十个就保存十个,想保存一百个就保存一百个。 好,下面这个相关参确认相关参数,这个十呢,一般我们也是保持默认不动,如果你这个设置设置为二十呢,一千六乘以二十,你就三万二了,三万两千步了,你就再加四个小时 pc 大小啊。如果你显卡非常好的话,也可以设置为二,显卡一般设置为一。学习率,这个默认保持不要动,因为他这个学习率呢啊,跟我们之前 在 step 第六任这个学习率显示的方式不一样哈,因为我们之前显示的方式都是零点几,都是数字,他这个啊不知道代表什么,大家可以去学习一下秋叶的这个参数的这个概念,这个保持默认不变啊,这些都是保持默认不变的,大家可以看他下面的这些中文解释吗? 这些中文解释一般都能看得懂啊,忘了给大家说那个数据级是怎么来训,数据级是怎么来产生的? 数据级是在这个 wd 一点四这个标签器里面,这个标签器里面我们把这个数据级目录呢,也就是我们这个 trend 这个文件夹里面这个目录 路径给他复制一下,给他复制到这里面。下面呢参数我们保持不变啊,我们直接点启动就能够生成这些数据及文档了啊,我们还回到新手,这里面这些可调的参数也是比较少 啊,我们就可以保存一下我们的这些参数,也可以读取我们刚才保存的参数,也可以删除进行管理。下面呢我们直接点击直接开始训练,就可以直接开始训练我们的模型了,如果你对参数比较了解的话,你可以选择专家模式、 自然模式,这里面可调的参数更多,更为细节一些。那么既然我们是用 ai 啊,当然是让他更简单更好,我们更希望呢是 用一键导入别人设置好的参数去进行训练,因为我们自己去设置参数参数的话,我们对概每个参数的概念并不清楚啊,也不知道生成的结果会怎样,那这里面呢还有一些参数讲解,大家如果想学的话,可以去学习一下这些参数讲解 好了,那么今天呢,关于这个秋叶版的这个低配版 lower 训练的整错包呢,就给大家分享到这里,如果大家觉得有用,那么请为我点击关注加三连,我们下期 ai 课程再见!
572浪喵小北 03:04查看AI文稿AI文稿
你知道吗?你现在看到的这些图都是我通过训练 lower 模型自动生成的。可能你会觉得训练 lower 很复杂, 其实只需要四个步骤就可以完成属于自己的 lower 模型了。先关注收藏,防止下次找不到我了。首先你需要有一个拍葬环境,你可以输入这个地址去下载拍葬三十以上的版本。安装的时候记住一定要勾选这里, 然后命令行中输入 python 杠杠 version, 出现版本号代表你安装成功。打开 powershell, 输入 set execution policy execution policy remote sign, 选择 yes。 接下来运行 laura 训练安装包中的 install c n p s e 此时 会安装一些依赖包,我们耐心等待,安装完成即可。创建两个目录来保存图片素材和处理后的图片。第二步,素材的获取。你可以自己准备素材,我为了方便自己写了一个拍葬爬虫脚本, 素材获取完毕后记得一定要把不合格的图片删除掉,这一步非常的重要。第三步, sd 中图片的预处理和 lower 训练的准备工作。指定路径和配置向后开始预处理工作。 这一步就是对每一张图片打 tag 标签,为了保险起见,可以对图片跟标签进行二次检查。将底膜放到 laura 训练的 sd models 目录下,并命名为 model safe tensors。 进入 train 目录,创建 laura 模型目录名称,这个名称前面应要跟数字表示图片的训练次数。 双击 a, 启动脚本 bat, 启动 laura 训练的 web 界面。点击新手,把刚才改过的底膜名字进行覆盖。路径选择刚才自己创建的 trim 目录下的目录名称 尺寸按照预处理时的尺寸进行设置, 自动保存轮数设置十六到二十期间的数值, 最大训练数选择十五到二十之间的数值。我们还需要将预处理后的图片和提示词复制到春影下带数字的目录中,然后点击直接开始训练。这个过程相当的漫长,根据你图片的 数量和训练轮数来决定训练的时长。经过几个小时的训练,终于结束了。将 output 目录训练好的模型放到 s d 的 stable diffusion 目录中, 最后一步,重启 sd 的 vab 目录,然后就可以选择你自己的 lower 快乐的生图了。怎么样,学会了吗?学会了就赶紧去试一试吧! 视频制作不易,喜欢的小伙伴就关注一下我吧!
89大鹏AIGC 01:14查看AI文稿AI文稿
大家好,这里是 old 官文野设计,我是设计师关晓野,前段时间在研究 ai 绘图,尝试制作一些设计类的 lol 模型,因为比较喜欢像轴色分析图一类的渲染图, 于是在网上收集了一些三 d 轴测模型渲染图片作为数据集调试了很多版,在经历各种奇奇怪怪的失败图后,终于炼制了一款还可以的 low 模型, 该模型主要用于生成室内轴侧模型渲染图,包括客厅、厨房、餐厅、卧室、卫生间、书房等。 一起看一下具体的效果吧!如果觉得还不错,还请一键三连支持下。评论区有下载链接,有疑问可以弹幕评论区发问。
 00:47查看AI文稿AI文稿
如何训练自己的模型?这里就是用的老马的图片训练的,怎么做呢?上教程访问这个狄冰云部署来训练傻瓜式的单机部署。 注意,这里要上传图片的说明,上传你要的图片, 查看你上传后的图片效果,训练你的数据模型, 加载你的数据模型就可以玩了哈。 想知道更多的 s b 小知识,加个关注喽!
48ArtiTech 01:03查看AI文稿AI文稿
seven 结 few 上可以训练自己的稳定扩散模型,这是一种令人兴奋的机器学习模型,它能够根据文本描述生成惊人逼真的图像。您可以采用不同的方法来训练自己的模型, 其中包括使用额外的数据对现有模型进行微调,或使用一些像 double 这样的技术。微调是一种广泛使用的机器学习技术, 他通过让语线训练好的模型在特定数据集上继续训练来提高其性能。例如,您可以使用更多的图像数据来微调您的稳定扩散模型,以使其更倾向于生成与您的数据及类似的图像, 同时仍然保持其多功能性。另一种令人兴奋的技术是 during booth, 它可以帮助您将新的风格或主题引入您的稳定扩散模型。使用 during booth, 您可以使用至少三到 五张自定义图像来向模型教授新的概念和风格。这是一个非常有趣的方式,可以帮助您创建出与众不同的图像。下期揭晓具体怎么做,加个关注了。
63ArtiTech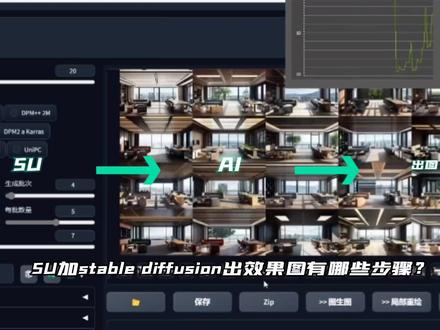 01:48查看AI文稿AI文稿
速加 stable diffusion 出效果图有哪些步骤?零一, su 导出控制图,这里我利用了 su 的样式制作跟穿奈的控制图。 零二, s t 中加载预测无形用的 realistic v 二零设置,采用方法加载 logo 模型 low 外用的是国风三点二零三上传控制图,语音分割, 深度线性检测。 零四,调整参数,先调整 ctrl night 参数,然后是全局参数。零五,生成图片, 也就是传说中的抽卡,也可以理解为渲染。我这里设置的生成批次是四,每批数量是五, 他一共会计算二十张图片生成 计算完毕来看一下效果, 每一张效果都不错,但是我们要去选取适合的, 根据生成空间的材质、物体质感去选择合适的,之后利用水技术生成更加接近的准确的图。最后就是高清修复出大图了,看到这的都是真爱,就给个三年吧!
1855阿歪梦工厂 16:35查看AI文稿AI文稿
嗨,大家好,今天给大家介绍一下 sd xl laura 的一个模型的训练,这是我训练的一个京剧脸谱的一个啊, laura 给大家看一下是这个京剧,然后把这关掉,然后模型选,选择的是 sdxl 一点零的这个基础模型, 然后提示词,呃,一个骑着摩托的人,然后有一个这样的京剧的提示词,后边加了一个劳软,然后我们点击生成看一下 其他的参数,都是默认参数,呃,只是把这个画幅的比例调成了幺零二四,然后采样步数调了三十步,然后我们看一下下,看一下, 很快生成了一个霸王骑摩托的图片,因为我的训练素材只是呃上半身的,所以他上半身会比较 贴切一些,下半身就有点有点怪啊。这个,嗯,倒不是太大问题,就是如果你素材选的好的话,量足的话,这个还是比较好的。我给大家看一下我其他生成的图, 这,这些都是这个人的脸谱,这这这提示词是喝咖啡的,就是这些啊。那现在来给大家介绍一下怎么训练。 s d x l the laura, 呃,是,首先我们我们进入这个 hacking face, 找到这个,呃,可以啊, ss 这个,这个东西你找一个自己的方便的文档,然后我到 e 盘吧,因为我 f 盘已经安装过了,我可以直接考考过去。呃,我这样考过来, 你可以直接从这儿靠的下边的下载这个压缩包就可以,当然也可以通过 get color 命令复制复制,然后复制这条地址,然后那样 下载,不过我觉得直接从这下载压缩包就挺好,然后我会把这些压压缩包文件直接上传一个网盘给大家使用,然后我们已经解压,解压完,然后打开这个文档,打开以后我们然后找到下 下边的这个这个 set set up b a t 这个文档,然后双击运行, 双击启动以后他就啊进入这个窗口运行一段时间以后呢,我们就在这里边进行选择,首先是输入一 安装这个模块,然后再选择,我看啊是选输入二安装必要的这些要求的插件,然后他就开始啊下载安装了 这个插件呢,它是没有进度条的,所以,呃,所以需要等待一会一段时间, 这里就安装完了,然后他让你选择计算机环境什么呢?这些直接回车,接下来选择,这是在这个电脑运行,然后直接点回车, 然后第二个问题,选择五分步训练,直接点回车,然后选,呃问题是否只用 cpu 输入文章 回车,然后问问这,这也是选弄, 然后这个也是 no, 然后这个 是 all 回车,然后这个选择那个是,呃 运算方法,按上下键就可以选择,选择这个,如果你显卡 ok 的话,正常的话选择 b f 幺六,用上下键选择,然后点回车, 现在我们的选项就完了,然后我们直接选六退出就可以,现在就退出退出了,嗯,可以直接关掉这, 然后找到这个这个文档。呃, g o i b b a t 文件运行,这个文件双击运行, 运行运,运行以后呢会有一个呃网址,我们就是在这个网址里边做相关的设置,输入这个网址之后呢就开始一些参数的设置,首先是进入,我们点击这个这边的这个 laura, 然后 train, 然后下边的这个原模型这一块选择 custom 这一个板块,意思是直接在那个模型基础上进行进行训练,然后文件格式是 seven tenth tensers, 这个可是这个大家应该很常见了。然后这儿呢是选择一个基基础模型,也就是,呃, sd xl best 一点零这个模型,这样你的电脑里边应该已经装了,这个 是在也你的电脑里边应该已经装了。这个模型通常是放在我们的 stable diffusion 外部 ui the models the stable diffusion 的这个文件夹下, 找到以后点选,然后打开被练到,这就 ok。 呃,然后关于这个模型呢,是在哈根 face 上,我会把这个模型的下载地址以及这个模型这个下载这个文件夹,这个文件直接上传一个网盘给大家用。 回到啊模型训练界面,这选勾选好以后呢,这勾选这个 s, d, x, l model 选这块,那这个界面就设置完了,然后 接下来来到 noratos, 来到这个节,嗯,来到这个界面,呃,在这进行设置,首先是这个提提示关键词,然后我输入一个 picking, 然后这儿呢是一个类别的关键词,我输入了一个 picking。 一, 这是我们的那个素材的原素材图的一个文文档文件夹。呃,因为我们训练 s, s, d, x, l 嘛,所以这块儿我给大家看一下啊, 这个这个文档里边是我找的原,呃,一个十一张图片的一个原素材,就是各种规格的都有,我们训练 s, d, x, l 呢,需要幺零二四的图,所以我们需要把这些图裁切成 这个文档里边的这种规正的图,这个怎么裁切呢?就是之前我们用过一个网站,这个这个网站网站打你打开以后呢点选这, 然后就可以选择你的这个原文件,然后这样全选 全选,然后这样打开它就会上传,全部上传,上传以后在右侧设置你需要的一个像素大小,咱们是幺零二四,设置好以后呢,你还能因为有些是竖图吗?你还能选 框,选框,选一下你的这个需要的部分啊,这样框选一下,框选好以后, 点击这个保存为压缩文档就可以,这是这我们回到训练界面, 呃,这块就是我们的已经裁接好的幺零二四的原素材图,然后这是一个正则,正则图片,我们这块没有直接删掉。这,然后这是一个设设置,就是训练文文档文件夹,然后我们点选这 这个文件夹的意思是我们的训练的 laura 的所有的这种中间模型呀,素材图呀,就是整个项目的文件都在这里边, 我你可以随便建一个文件夹,这是我建的文件夹 s d x l lara picking 这个文档,然后点击点选,点选以后我们这边就可以了,然后我们就 就可以点击这个按钮,点选以后可以看到, 可以看到我们的这个后台界面,就是,呃,这一条的意思是已经把啊我们的那个原图拷拷贝到啊我们的这个项目文件夹下边,我们可以看一下 这是我们的这个文档,然后这个这个文件夹下边已经有了这些图, 而且这个文文档呢都是系统自自动建的,然后这个他是有一定命名规则的啊,这个十呢是指我们选的十步,然后这是我们的那个,嗯,关键词,然后这后边也是,所以这 这块的文件夹名字不要动啊,这是这回到训练界面,然后再点选这个,呃,考配信息到文档,点选以后,我们可以看一下,回到这个文档,然后看这个 分栏,下下拉的就会把我们的这个文档的信息,文件夹的信息都全部拷拷贝到这边。 这是啊,这这一部分的内容相当于我们对整个项目进行了一个管理,那接下来就是对参数的设置,到第三个了, 到第三个画下下拉栏里边啊,这个栏里边这这块都不用动,然后这这是一个训练。 呃,步数大小,这是四十一就行,一到二,然后越小他的精度越高,当然也对你的系统要求也就越高。这是一个,嗯, 一个轮数轮数,我们这可以选择十轮。啊,那我们刚才选了十步,这又是十轮,那我们十一张图就是一千一百 一,一千一百步啊,这不需要选,这个是保保存的频次,也就是这是我选的一是每一轮都要保存一次,那十轮就是保存会保存十个。 呃,训练的 lord 模型,嗯,然后下边的这些,这,这是我们勾选的 这个,这个啊叫什么? 勾选这个 bf 十六,就是这个,是这种计算方法吧。啊,然后这选择二,这不用管,然后勾选这个栏和这个栏都需要勾选一下,然后这是这是一个学习率,和 这的这个参数有关系,我们是我们选择这个,我们选择这个的话,这的一个参数要改成零点零零零四, 下边还有一些,呃,这个学习率的参数,把他们都调成一样的数值,这三学习率有三个数值,然后我们接着继续往下调 啊,这是没关系的,这是有一个啊,额外的这种要求参数可以加,也可以不加,然后我这准给大家准备了一下啊, 油画器额外参数,我们把复制一下,复制然后粘贴到这个位置, 然后处理的像素大小,这很关键,我们要调成我们需要的幺零二四,幺零二四, 调整好这以后,然后还有哪这需要勾选,这是默认的, 然后这需要 调成零,这儿呢需要调成这个 content content, 我这有有一个表,可以参照这个表来调,别漏掉。 继续往下看,然后学习率这个需要勾选上,这个呢?哈弗 v, 然后下边的,呃,这个参数需要调成六十四,呃,这个也是直接影响我们训练出模型的一个大小,这上面就调完了,调完了,然后 把这个高级设置这点开,点开,这里边需要勾选一个,嗯,把这个 扭勾选,勾选,那就可以,那我们的这些参数就就可以了,然后点击,点击这里边开始训练, 然后我们来到后台看一下,可以看到我们刚才所有设置的那些参数,在这都会有一个访显示, 可以看到现在已经开始训练了,这是,呃,第第一个,我们总共十一个图片,然后他一个一个来, 那我这就不给大家继续看下去了。呃,大概需要一个小时啊,我是一个三零六 六零的显卡,然后十一张图片,十步啊,十个循环,总共一千一一百步吧,我三零六零的显卡是差不多一个小时,我之前训练的这个时间, 然后我们给的我给大家看一下,就是训练出来他是一个什么样的文档,哦,是上次我是训练出这样,他会有一个,这是原图的一个 文档,就是我们原素材的文档,这是十个文档,然后这些是一些中间文件啊,这个不需要我们管。然后训练出来呢,是在这个 model, 然后这十个十个文档,一二三四四五六七八九这九个文档是一个中间文档,因为我们设置了每一每 每一个循环就会生成一个啊模型这种文件,然后然后这个是最终最终的一个文档复制到 的外 u i models 下边的 laura 复制到这儿,这也是我上的这个训练的模型, 京剧这个模型,这就是我训练的模型,复制到这就可以使用了,就是我片头的,嗯,我片头用到的这个 lower 就可以生成这样的一些图。感谢大家观看,如果我的内容对你有帮助,欢迎订阅、点赞评论,谢谢大。
 07:28查看AI文稿AI文稿
我们看一下云端 fdsl 的训练啊,首先进入这个青椒云,然后你可以注册一个啊,这是有免费的试用, 然后呢你注册完了就登录,登录之后实际上就是用你电话登录啊,然后呢这个地方是你的优惠券,就是新手会有两块钱的优惠券,可以试一下。 然后呢这个地方是你的个人资料,订单的管理啊,消费的明细啊,都会在这显示啊,还有这些优惠券就是会显示在这啊,这是桌面管控,还有登录日志,就是你做了是什么样的,就是活动,这他有些记录啊,在右上角这块有个客户端下载, 那么这个时候呢,就是一个云端桌面,根据你自己的操作系统啊,选择一个,我是 windows 就下一个 windows 啊,然后打开安装就行了,下载完了以后安装点一下立即安装,那么这个是 实际上就相当于一个终端啊,直接和你这个云端那个虚拟服务器连接在一起啊,完了以后登录进来以后,这个地方是服务器选择啊,你可以根据你自己的地域选择啊,这是选了一个华南寺,然后呢这个地方点新增云桌面, 那么这个时候呢,会里边有些产品啊,有些标准产品啊,还有些定制产品啊,大家可以尝试一下啊,这是 aigc 尝鲜,然后这是这些入门级图形工作站啊,这些东西根据自己的需求来选择, 然后呢,你看他也有便宜的 aigc 的长线六 g 啊,你可以选择一个,然后点,然后点开机就行了。选好开机,然后呢,他这个地方需大概需要一到两分钟等待啊,然后等待完了以后,进来以后就是这个样子,这是云端,就是相当于远端的虚拟主机。然后呢 这个时候呢他这有一个 starbody fusion, 还有他这个说明啊,你可以看一下,然后呢下面的这个就是就是这个烤鸭的就是模型训练器啊, 那么这个呢?呃,他有个问题,是什么呢?他这个版本啊,默认的这个版本啊,云端这个版本不支持 sdxl 的这个训练,那么这个时候怎么弄啊?我们就可以上传自己的就是脚本 好了,你打开这个青椒云的这个云盘啊,把这个我们要上传的这个就是脚本文件啊,上传进来,他这个你要等一下啊,他这个等他上传完,上传完了他就这样,然后你再把你的底膜就是我们的那个基础模型,那个贝斯模型 就是我们的大模型啊, s d i x、 l b 四一点零的这个模型也上传进来,方法都是一样的啊,上传完了 以后我们就是需要这两个,一个是你的,呃,当然就是说你的这个脚本里边啊,也要同时把你的这个包,也就是你的那个训练素材啊, 哎,就给他上传上去啊,一起啊,我是把那个打包了一起上传了啊,然后呢打到这个进入桌面啊,回到这个我们那个云端桌面进来以后,然后呢这个桌面上有一个青椒云盘, 然后呢就是添加成功, ok, 然后你双击他就行了。然后呢这个这个呢就是我们上传的这个训练脚本,训练脚本还有我们的那个都可以把它放到我们的就是云端的这个 c 盘, 把它放到这个云端 c 盘,然后呢确定这个是防病毒的啊,然后确定确定完了以后啊,都把它放进去,还有包括你的那个训练机 都放,都把它加载进来。然后呢解压缩,我的这个训练集啊,是跟你这个脚是这个脚本的这个放在一起的,然后呢这个地方实际上有个说明,大家可以看一眼。 然后呢这个脚,这个,这个 easy 吹吹的这个脚本啊,先要 update, 点这个 update, 点 bat, 就他就是要先就是安装一些就是必备的依赖之类的东西啊,他当然这是一键运行的啊,然后呢这个东西等他安装完就行了 啊,请按任意键继续随便点一下就 ok 了,然后呢再运行 r u n 点 b, a, t, 双击它好,打开界面,先选 s, d, x l bass 啊,选择它。然后呢再选择我们的这个大模型,就是 基础模型,然后再把这个宽度改成幺零二四,高度也是幺零二四, 这两个选好。然后呢下一个呢就是优化器的这个参数选择啊,选择我们的优化器类型,把它改成这个神童优化器, p 打头的这个。 然后呢下面这些可以不用管啊,如果我们作为一个简单的训练的话,这个保存参数需要选,就是说我们保存到哪就训练完了,那模型啊,这个老老卡模型放在哪?然后你自己定义啊, 然后输出的名字是什么?这个时候你看我们就是叫芭比啊,这是我训练了一个芭比的一个 sdxl 的模型。好,然后呢这个呢就是数据集参数右上角的这个啊,然后呢把这个参数啊就是你的训练集选择,选择好了以后, 然后呢其他的这些东西啊,就是没有什么好选择的啊,点一下开始训练训练的步数,我就选择了一就就是就是训练一轮啊,就是一步, 然后呢应应该是十到二十,我为了让他快啊,对吧?这不你看这 step 就是百分之百了,这就是训练一,训练了一轮呢,然后呢这样的话我为了快啊,你看就得到一个结果,那么这样的话就是我们就可以把它下载到我们的本地盘, 然后呢首先还是把它拖到这个青椒云盘上,拖到青,他是通过这个青椒云啊青椒云盘,然后呢去上传,下载好,然后回到我们本地桌面,然后呢就打开这个青椒云盘,注意啊,这这个是我们本地的界面,然后呢就是把这个下载 点下来,点一下啊,勾选他下载下载这传输列表,然后呢等他传输完了以后,下载完了以后就在这啊打开这个,打开文件夹,那么这个是本地文件,就是我们放在我们的本地电脑 里边的这个盘里边了。好,我们回到云端,然后呢我们把这个云端服务器里边的这个青椒云盘啊,都给他清空了啊,就这些都不要了啊,我们就训练完了,训练完了以后啊,就把这些该删除的删除, 对吧?然后再回到我们的这个青椒云云桌面,然后呢回到我们的这个云桌面这个位置啊,他这个地方有一个关机,然后我们 要及时关机啊,要不然他后台运转的话,你没关啊,他继续还是要扣钱的,对吧?所以的话我们啊就是让他关机,关机成功,等关机成功就行了,然后你就可以把它关掉了, 关掉这个云桌面啊,就是中断了和远端的联系,就退出客户端就 ok 了,那么这个时候就回到你自己本地的电脑 好了,然后呢你打开 starbody fusion, 然后呢看一下你训练的模型怎么样啊?这个呢,就是我们刚才训练的那个 logo。 呃,然后呢给他关键字啊,正反关键字,这个宽度啊,七六八乘幺零二四,让他小一点啊, 是个竖构图。好,你看这是我们的训练结果啊,你看多多试两次啊,你要是说满意了的话啊,你就把它留下啊,要不满意的话就接着训练啊。就是啊,其实很简单。
 01:14查看AI文稿AI文稿
小白如何快速上手 sd? 兄弟们呐,最近啊,在研究这个 sd, 这个我试了好多种方法,什么本地部署啊,咱也没钱,搞不来机器云端部署呢,又麻烦,而且他还是按时收费的,这个也不太划算。但是呢,我今天发现一个网站哎,非常好,咱们一起来看看看,看看,就是这个网站啊,他是一个完全在线的一个 sd 的平台, 看,这是我现在目前在研究的一些 icon 的商城啊,他自己可以下载下载模型啊,就是什么都不用下载了,就可以自己自己用,你点击这个加入, 然后他就会加入到你的这个模型库里面,点一下刷新就有模型库,然后就可以免费用,而且他的生成次数,每天可以生成一百张图片啊,都是免费的。这个对于初学者疫情是完全够用的,那么工具搞定了,咱再搭配一本这样的教程啊,咱研究起来就是如鱼得水了。 这是一本啊, s d 的应用与技巧啊,一本全方位的教程书啊,非常适合小白。前面呢,他会讲一些 安装配置的一些讲解,然后我们可以直接跳过。后边呢,他会针对每一个参数啊,具体怎么使用啊,代表什么意义都会讲的非常详细。 后面还会有这些老手模型的训练,就是我们自己在训练一些模型的时候,一些流程和方法都讲的非常的透彻详细。其实网上现在的教程也非常的多啊,但是对于初学者来说呢,我建议是大家背一本这样的工具书,这样我们在学习的时候呢,随时随地的,方便我们去翻看知识点。
 03:16查看AI文稿AI文稿
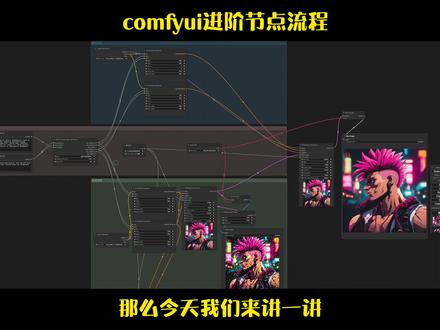
sd 叉 l 在空腹 ui 中更加进阶的节点流逻辑,第一,风格控制。第二,贝斯模型以及 refine 模型如何连接。第三,分区提示词控制。第四,多重采样分区提示词控制。节点流程这种东西一通百通,逻辑正确怎么连都可以,所以这一期视频我不打算讲得太细,只讲 搭建的逻辑和重点。看完视频找我拿笔记和节点流程文件,相信看过上一期视频的小伙伴应该一看就懂。首先就是风格控制,这个是上一期视频整出来的一个完整的节点流,区别只有一个,这个提示词变成了一个 sd 叉 l 的提示词。 说实话,这种连接乍看之下我都不知道风格节点往哪里插入,但是没有关系,遇到这种情况,我们先把风格节点先给亮出来,右键增加节点 utils, 选择 sd 叉 l 风格高级插入进来之后呢,你就会发现其实情况 放非常的明朗,对吧?说白了,风格节点就是一个追加的提示词,左边是输入提示词,通过风格节点补充风格提示词之后再输入到最后的提示词,倒 clip test in code 翻译成 ai 能听得懂的东西,但是找不到 positive 的连接点,那怎么办呢? 右键选择文本 g 作为输入,同样的操作,把文本 i 作为输入,如此就可以将提示词变成节点输入的格式, 把 g 和 i 分别连接起来,左边再划拉一条线处来连接到原始节点,就可以将提示词独立成文本输入框,如此风格节点就完成了。这个原始节点非常的重要,有很多的参数都可以通过这个原始的节点 转化为输入,那么我们现在就可以开始搭建基础加精炼模型的节点流。我们先来理一下逻辑,基础和精炼模型是分开两个步骤的,所以我们需要分开两个不同的节点,流程中间再 通过某个节点将两个流程连接起来。整个的工作流程是基础完成百分之八十的采样,之后再送到精炼模型完成剩下的百分之二十的采样。所以需要有两个采样器,那么这两个采样器就是串联两个流程的节点,从基础的采样器 later 连接到精量采样器的 laden image 就可以完成串联。这里面有两个流程相同的共用的参数,第一,提示词相同。第二,风格相同。第三,随机种子相同,第四 v a a 相同。 我们可以把这四个参数放在中间作为共同的参数,如此你修改一个参数就可以同时修改两个流程的参数, 当然包括采样方式 c f 区迭代步数,这些都可以作为共同的参数,这里就不演示了。最后我们再说一下一个非常重要的参数,采样步数。假设整个采样步数是二十五步,基础流程从第一步 采样到二十步停止精炼流程就从二十步采样到第二十五步完成整个流程。所以两个采样器的采样步数设置是这样的,基础流程的终止步数作为精炼模型的 开始步数。找样器中还有两个关于噪声的参数,顶部的这个 adenoys 是在采样的过程中是否添加随机噪声。在基础模型要打开精炼模型则不需要打开 以下的这个 return with let overnoid 我也不知道我读的准不准确,这个很难用日常语言来解释。简单来说,打开 return 的时候,深层的图还处于有照点的中间态,而关闭则会让图片 形成最终的图片。为了让精炼模型有发挥的空间,基础模型要打开 return, 为了让图片成型,精炼模型则要关闭。如此整个基础加精炼的模型就搭建完成了。
205惡棍Borges 01:25查看AI文稿AI文稿
来,我们继续上次生成的一堆模型对不对?我们来看看这些模型怎么检查并使用。我们把生成的这些模型全部复制,然后粘贴到 ic 的插件目录里面去。 a 三胜所有的插件都在这个文件夹, 找到这个 networks 结尾的文件夹,打开里面的 model 文件夹,打开牢牢文件夹,粘贴到这里就可以了。打开 stable defusion, 点开 additional networks, 刷新一下模型列表,你就会在这里看到刚刚放进来的模型,随便选择一个,然后启用。点开下面的脚本,选择 xyz 图表 x 九,选择附加模型,一点一下后面的小说图标,其他的模型就会出现。 外轴选择附加模型一权重,外轴只写零点六,零点七,零点八,零点九,注意要英文逗号,这里是为了测试不同权重的效果。把宫格图边框设为十,然后填上关键词,我就 简单写一个女孩,加上基础词,然后就可以生成了。 much, much, much later。 考完以后你就会得到这张图,会显示你的所有模型在不同权重下生成的效果。横坐标就是你的模型名称,重坐标是不同的权重,我们就可以直观的看到哪个才是我们需要的,比如这个一堆马赛克的,我们直接 pass 掉。 我们可以看到零点六和零点七权重的都不像了,零点八和零点九就开始有那位了,依旧会更好,就可以得出最后的模型。零点八以上权重效果最好,那其他的模型就可以删掉了,以后生成图像的时候记得权重高一点就行了。
4365摸到绝张先生 06:02查看AI文稿AI文稿
你的 stable difference 模型库里面的各种模型和 lower 或许很快就得全部删掉了,因为他们都是基于 st 一点五或者是二点零版本的底膜来开发的。现在 stable difference 已经开始全面进入了 st xl 的高分辨率时代。 最新的 stable division web ur 一点六版本的更新,直接把 sd xl refiner 放置在首页 control 呢。最新的一点一四版本也全面加入了 sd xl 的支持。在西站里,海量的基于 sd xl 训练的大模型和 roi 纷纷推出市场。 如果你也想产出更高精度、更多细节的画面,那么我非常推荐大家升级,过渡到最新的版本。嗨,大家好,我是李晨,欢迎来到 c 军迷。为什么现在 stable tiffson 开始全面普及到 s d x l 呢?首先, s d x l 是目前为止学习参数最多的 模型,参数总量超过一百亿次。这也意味着通过 s d x l 可以生成各种各样的画面,不再仅仅局限于人物,它是一款可以对标咪尊里的通用型大模型。 其实 sdxl 的分辨率精度是过往底膜的四倍,直接来到了一零二四乘一零二四级别,你可别小看这个分辨率,我们看到的超高精度的图片都是在基础底膜的基础上高清重绘出来的, 所以基础底图本身所具备的细节是高清重绘的关键。 sd xl 有着更高精度的底子,也意味着他重绘扩展出来的质感和细节也会成倍的增加。 s d x l 还多出了一个 refiner 采样重构器,相当于多做了一次加照和去照的过程,能够进一步的给画面增加细节。启用 refiner 后,可以看到人物脸 部轮廓、边缘、局部的细节都有明显的加强,而且渲染时间只增加了一点点而已。另外, scxl 对关键词的理解程度有了大幅度的提升, 换句话来说就是更听得懂人话。他不用像以前那样输入一大段一大段的高精度前缀词,你可以把重心放在主体的描述上。他的核心思想和没准你一样,就是希望你输入更少的关键词,并准确的呈现出你想要的画面。 例如输入艺术,女孩戴着耳机在火车上,红色类似生锈的座椅、垃圾和破碎的瓶子在地上用 sdxl 模型来生成一下画面除了破碎的瓶子没有表现出来, 基本能够准确地呈现百分之八十以上的提示词内容。换成 sd v 一点五模型,同样的提示词生成出来的画面却是这样的。 当然 sdxl 也不是没有缺点的,他目前与老版本的 lower 是不兼容的,必须和 sdxl 训练的 lower 来搭配使用。另外, sdxl 模型对显卡的要求更高了,必须配备八 gb 以上的显存显卡才会有较好的体验。 由于 sd xl 模型的学习参数和精度更高了,以至于现在 sd xl 的各种大模型容量也是六 gb 七 gb 起步,硬盘负担又进一步增加了。不过这些都改变不了 sd xl 成为主流的趋势。接下来就给大家讲一下如何升级 stable devision repui 一点六版本。 使用秋叶启动器的同学升级非常简单,点击版本管理,在最上方看到最新的一点六零版本,点击切换确认安装最新的这个版本号,点击右上角一键更新,这样就更新完 完毕了,同时还需要更新一下相关的插件,点击扩展标签,同样的一键更新, ok, 这时候可以启动 stabledifishui 了。刚更新完的第一次启动需要加载一系列的依赖,会稍微慢一点,耐心等待,不要退出 浏览器,跳转到 web ui 界面,在首页就看到 vina 的这个功能,拉到最下面,可以看到当前已经更新到最新的 v 点六零版本了, 其他安装包或者是手动安装的同学最好最好是先复制一份备份,保存好再更新。更新的方法也很简单,进入 stable diffusion rap ui 文件夹,在导航栏上面输入 cmd, 确保这个路径是你 stable dv 选 rap ui 的路径,然后输入 gipo, 很快就安装好了。这时候下拉,打开 rap ui, 点 b a t, 稍微等待一下依赖的加载, 这时候看到 stab 的顺 rapyy, 一点六版本就更新好了。 max 用户更新稍微麻烦一些,最好先把要更新的文件夹先备份一份,不要有中文的名称。右键进入终端,或者在文件夹路径,右键在终端中打开, 看到这个路径和要升级的 stable decision web ui 文件夹一致,就没有问题了。输入 gippo, 很快就更新好了,然后输入这段命令,更新新版本需要的新增的依赖。 更新完毕后,同样的方式,用终端打开这个文件夹,然后输入启动命令,看到这个熟悉的地址,在浏览器打开就可以看到 stay body 选 rap ui 一点六版本更新好了, 最后给大家推荐几款不错的 sdxl 模型,首先是这款 cantify xl, 它能够生成细节度相当不错的二次元卡通效果。然后是这款 dxl leg 特别版,它是一个通用性相当好的模型,基本所有平面二点五 d 的动漫风格都能够胜任,容量也很大,六点四个 gb。 最后推荐一款国风真实系模型,它是一个集服装、道具、化妆都经过特别化的国风模型,可以搭配汉服 sdxl 版的 lower 一起使用。另外最新版的 ctrl 一点一四版本更新了非常多的 sdxl 模型,可以看到一共是二十七个 gb, 这些模型我都会提供给大家,这样大家就不需要模仿网络下载了。同时 sdxl 官方模型和 vfan 模型还有刚刚给大家推荐的三款 sdxl 模型也会一起给到大家,大家在评论区自取就可以了, 也可以回复模型,我会一一私信给大家。好了,本期教程到这里就结束了,如果觉得教程还不错的话,请 不要吝啬你们的小爱心,麻烦点赞收藏一下了,感谢大家的三连,那我们下期再见,拜拜!
4756CG迷 22:18查看AI文稿AI文稿
哈喽大家好,欢迎再次来到欧阳的视频频道,相信大家在通过欧阳之前的一系列教程以后,应该可以顺利的铲除我们图像了,但是呢,往往这个 ai 他是很不听使唤的,通常我们需要进行无数次的连抽啊,才能找到一张相对于符合我们想法的图片。那么这一期呢,欧阳就跟大家分享如何驯服我们电脑中的 ai 绘图小助手, 听到没有,给我老实点啊,不老实削你,哈哈哈, ok, 话不多说,我们来到教程 这一期呢,我想主要跟大家说的就是这个 ctrl nine 的一个控制的网络,也就专门控制我们这个产出模型神经网络的 神经网络。嗯,那这个扩展插件呢,叫 ctrl net, 当我们安装了以后呢,在下方可以看到这样一个 ctrl net 下了菜单,如果没有的话呢,我们需要重新安装一下,我们找到拓展,点击可下载,并且加载拓展列表,同时在拓展列表里我们搜索 ctrlt 一个拓展,那么这里我已经按过了,所以在列表里我们是看不到这个选项的,我们可以直接找到 ctrl net 这个英文名词啊,那么它的全称是这个 sd vbui ctrl net 那下载完以后,我们重新启动 wib ui, 我们就可以在文生图也好图成图的这些界面里呢,看到我们下面 ctrl net 这样一个 下了菜单,那这里值得说的一点是,这个网络呢,它不仅仅是单一的一个控制网络,在 ctrl net 里,它分了很多种不一样的处理方式,也就是我们所谓的控制方式。那么这些控制方式呢,大家可以看到有很多,每一种控制方式呢,又对应了每一种模型, 所以当我们安装了这个扩展以后呢,这些模型并没有安装到我们的电脑里,我们需要单独到一个网页去下载这样的模型,可能你需要哪一个下载哪一个,但是呢我建议大家全部下载,那么这些模型的下载网址呢?我也会放到评论区置顶啊,这是他的原网址啊,每一种处理模 型呢,他的体积都要很大,都要到五点七级了。那这里呢,欧阳还有一份瘦身版的模型,体积基本上缩小了有将近十倍,那我也会把网盘链接放到置顶评论区,大家需要的话呢也可以去下载。那当我们下载好以后呢,同样还是放到我们 拓展文件夹下,并在拓展文件夹里我们找到。 ctr net 点进来以后,我们可以找到 mode 一样,在模型文件目录里面,我们 把模型放到这里面,同时我们充气 ui 或者是我们直接在这里刷新一下,那么就可以把我们文件目录下的模型全部刷新出来。 ok, 接下来我们就来探讨一下 这些模型到底有什么用?现在 ctrl net 分两种,第一种是官方的,我们可以看到 ctrl net 开头的这个模型是官方的公布的八大模型,我们在这里也可以看到一共是八大模型。那这一期呢,我要跟大家主要分享的是这八大模型的用途。之后呢,又有个项目推出了 t 二 i 的一个在 ctrl net 基础上呢 进行更多变种的一个模型,那么这种模型算法呢,我们可以在这里看到有一些是不对应的,这些简单的模型我们留到下一期再跟大家探讨,那么回来我们说这八大模型,大家刚开始看着可能都会很懵啊,这什么是什么? 这里我来简单的进行了一个分类,我们来到这个项目地址啊,那么从实现手段而言呢,我也把它分为了两大类,第一大类呢是简单处理或者是简单重绘,第二大类呢就是属于对接到那些专业的领域。 ok, 那么对于第一步呢,我们要掌握 ctrl net 其实我觉得先要掌握的是重绘的能力,什么是重绘呢?其实我觉得就和图生图有点像, 我们通过一个参考图,用一种可控的方式让他产生一种与参考图相符合的内容,那么这是一种二地图形的重绘。那么我们这一期呢,由 mcv 四的这么一个模型做演示,采样方法我们就默认,第一个采样步数呢,我们可以提高到二十五,宽高比呢, 到时候再根据我们的样图来进行一个制定。那下面当我们打开这个 ctrlnet 下拉菜单以后呢,我们先要给他一张参考图啊,然后要用 ctrlnet 的话呢,下面我们要点击启用啊,记得要点击启用再出图的时候他才会起作用。那么后面呢,是单独对我们的信息图进行一些处理,比如说 颜色上的处理,反转啊,这个类似于黑白图,也就是我们遮罩图或者深度图的黑白信息图进行一个颜色的处理。那么 第二个呢,从 r g b 到 b g r 是也是一个颜色的翻转,通常我们用于色卡卡尔又或者是 normal map 的一些处理,那么后面底线存啊,这个一定要勾,除非你是拥有四零九零的小土豪。这两个勾圈以后,我们就来看一下下面的模型,这里分为两步, 第一步是预处理,这两个其实就是个顺序问题,预处理这里我们是预先要对这个图像进行一个哪方面的处理,比如说我们用第一个 cany 啊,这是一个 cany age, 是一个提取图像编 边缘的一种算法,我们下拉到下面可以看到有预览预处理结果,点击一下以后,我们就会看到他把我们原有的图片预处理成了一个具有边缘的图片,那么这个开呢呢,就是通过色差来提取图像边缘的这么一种算法,那这个边缘我们看的有点太杂乱了,在下面呢我们可以设置他的一些预值啊,让他高或者是低, 再把它降低一点点,可以看到它这个图像出来以后,边缘就更密集,因为根据我们图像不同啊,我们处理手段也不同,在产生了预处理结果以后,这就是我们的资讯图,真正要用到我们模型上的图, 我们再用这个图片去影响模型,那么怎么影响呢?我们就需要选第二个模型类型,那这里我们用哪个呢? candy, 第一个对应的啊,一一对应的, candy 的预处理器对应我们 candy 的加工模型,这样的话我们来进行一个生成,他就会产出以这个图片来影响整个视图的一个模型。那么在这里简单的进行一些 提示词的添加,我们添加一个基本的质量骑手,下面呢一样我们添加一个负面,最后呢我们还需要对这个图片进行一个题词,那么简单的题词,我们可以通过图声图的这个窗口啊,把我们图片拖拽进来,我们让它反向的进行一个 tact 的提示,那么第一种反向推词呢是自然语言,第二种呢是我们 tact 语言 剪切一下,再用这个自然语言提一下,那可以看到他给了我们一句自然的描述语,当然后面这里有一点错误,也就对于这个图片来说,他提示的比 并不是很完整,那么 ok, 我们把刚才剪切的自然语言粘贴到这里,同时呢我们来调整一下图片分辨率,因为这里它是横屏的啊,所以说横屏的图片我们这个宽度要改到七六八,高度呢就是五幺二就可以 我们直接点生成。那么在第一次加载模型的时候呢,他是需要进行一个模型的一个加载,我们需要稍微等一段时间,他才会正常的来运算我们的图片。 ok, 当图片运算出来以后,我们可以 可以看到这是他根据我们的这个图片的信息生成的这么一个图片,他的这个面部细节呢,并不是很理想,对吗?为什么呢?其实因为我们这个地方所给他的信息图是有些扭曲的,那么这种情况呢,我们有一个小小的改善方法,就是下面我们可以看到这里有个 gets model, 就让他进行一个自我想象,进行一个自我发挥,也就说对于他模型来说啊,他进行一些判别。这里我们声称一下,再看一下这个张图呢,他的脸型和耳纹给到他的脸型就不太一样, 这个地方呢,他会有一些自我的猜测啊,遐想模式,那这个开关呢,我们可以根据自己需要来勾选和取消,那么下面这里还有一条就是权重啊,就是我们这个模型对他影响的权重,那这个时候呢,如果我们把权重再降低一点点,再来生成的话,可 能离我们这个资讯图偏差就更大一点了,那后面呢,是他对我们原图的采样范围,默认我们从零到一就 ok 啊。那接下来呢,我们来了解 一下其他方面的模型。在这里我跟大家也说了,我进行了一个分类啊,总成的二 d 分类呢,有这么几种,第一种呢 cany, 第二种呢 h e d。 那这个 h e d 是我常用的一个模式,我觉得比较好用,我们来声称一下预览结果,那可以看到他的边线呢,就要比刚才那个 candy 的边线更虚,相当于我们后期的蒙版边缘进行了个羽化, 羽化的地方呢,其实能处理很多比较杂乱的一个边缘,尤其适合我们这一张图片。那么也可以看到这个边缘他的强度啊,在下面呢,简单的强度,我们也可以调节,把这个五幺二降到一百, 他的强度可以看到就更强,相当于他进行了一个向外的拓展啊,蒙版拓展啊,我们给到他更高的话呢,他的边缘就更细,这可以进行一个效果的微调。第三种描边方式呢,是一个 skibo 涂鸦方式啊,他这种涂鸦是一个粗线条的涂鸦,可以看到他所给出来的这种,就有点像涂鸦手绘的一种感觉啊,我们可以通过比如说在 ps 呀,或者是在手绘板上画一些啊类似的东西。那这里我们也可以简单的举个例子,比如说我们在这里啊创建一个空白画布,这个词可以把我们给到五幺二默认值,比如我们要绘制一条小狗啊,这里我们就简单的给他画一个小狗的样子吧, 这里我们记忆不惊啊,随便画一下上面的提示词呢,给他来一个 cut dog。 然后这里呢生成之前我们要注意一下啊,这个图片预处理呢,我们就可以不处理了,因为他就是我们的资讯图啊,我们把这个呢选择成无,同时呢注意一下分辨率啊,尽量对上他的资讯图的分辨率。这时候我们点击生成, 因为忘了一点啊,我们下面这个地方的模型没有切换啊,我们要切换到涂鸦模式的这样一个模型,我们重新让他渲染一下,可以可以看到啊,他出这个小狗还是比我画的啊,不是好的一点半点啊,但是从构图上来说呢,稍微有点偏差啊,稍微有点偏差,这跟我们画水平有关啊,我们画画的水平有关。 第二种呢,它还有一个涂鸦模式,那么就下面这个 fake, 那这种呢,它是属于一种假涂鸦,就是我把我们的图像呢转换成涂鸦,和我们刚才所说的一样啊,那么这里呢,我们找一个比较简单线条的这么一个耳机的图片进行预处理,我们看一下他能给出来 什么样的一个图像,可以看到他就把我们这个图像转换成这种类似涂鸦效果的感觉了,是吧?那么线条可能稍微有些粗旷,我们把线条呢调低一点,这样可以看到他的线条会变细一点。那这里呢,我们给他一个单词,给到他一个耳机和电脑,然后继续呢,我们让他生成一下,哎,注意呢,相应的调整一下他的分辨率。 现在可以看到啊,我们这个里面多了一个小朋友啊,负面词,这里可能有一些关于人物的描述,我们把关于人物的描述删掉,在这个基础上我们再加一个我们上一期所加的一个 cg 风格,我们把这样一个 cg 的基础描述风格也添加进来,让他再进行一点点猜测, 再来生成一下。那现在可以看到他还是有人物的,有时候呢,这要说一点,就是 ctrl reg, 他在不听话的时候呢,可能是说他抽风。嗯,那这种情况下呢,我们可以重启一下我们的 ybui, 我们直接刷新就可以啊,当然我们也可以通过拓展那个页面,进行一个重新读取,加载魔性以后再进行一次生成。 现在我们就可以看到他产出的这个耳机图,就和我们原始的这个耳机的构图很类似了,对吧?只不过这边不是电脑,我们需要再修正一下,需要在题词上呢,可能再给他一些方面的题词校正,或者是我们把这个权重提高一点点。那么现在呢,我们再来一下畅想模式啊,让他进行一些猜想,我们再生成一遍, 现在可以看到啊,他的这个耳机的形状呢,就变成一只手了,有点浮想联翩了啊,因为这个地方我们可能给的细节还不够明确啊,我们把细节再给明确一点呢,其实这个产品呢,我们应该用 canny 来做,那他的细节就更明确一点下来。我们来 说第四类基于平面处理的一个描边方式,我们叫 mlsd, 那通过他项目网站我们看到的信息是他可以提供我们直线描边的这样一个构架,那么这种东西更适合做一些硬表面啊,机械机甲,又或者是建筑,他的表面都是直来直去的,那这里我们找一个建筑图,我们找个室内的吧 啊,因为这里我们有圆的,可能不太适合,我们找一个楼吧。啊,这样一个古罗马建筑,我们来生成一下阅览图,看一下他给出来的边缘线呢,都是直来直去的,我们再基于这个图来生成一下,同样我们到图生图,把这个图的题词我们来提取一下,有这样的题 次以后,我们复制过来,来看一下我们的这个宽高比啊,那么宽度呢?给到七六八,下面这个地方,我们也给到他七六八,我们来直接生成成图啊,但在生成成图的时候,一定要把这个处理模型给他换成对应的 mlsd 这样一个模型,我们来进行生成。那现在可以看到啊,生成出来 图片呢,和我们提供的这个图的构图是差不多的,但是内容呢,可能有些变,对吧?更有一些这种幻想色彩啊,有一些这个楼还飘在空中了,对不对?可以看到这个地方,我们是让他勾选了联想模式的啊,那么我们把这个联想模式去掉,我们再生成一遍 这个图,我们来看一下啊,他就比之前的也没好哪去啊,没有人物了,这是在这之外呢,可能还多了一些建筑物,但是整体呢,构图是没有问题的, 所以这是我们 mlsd 这样一个模型呢,通用的一个方法啊,产生一些硬表面。那么这四个呢,基本上就是我所谓的二例平面处理啊,一个轮廓图检测的这么一种方法。那么对于这四个呢,我们简单的总结一下,其实 kini 呢,它适合用于一些构图简单的一些圆滑物体, 我说这个我觉得就比较适合用 candy 来生成啊,这样一个简单的线条。那对于第二个 h, e, d 这样一个预处理方式呢,我觉得更适合一些不清晰的一些边缘,比如说 我们这个女士,我们来看一下他的这个头发,或者是一些边缘很凌乱啊,就适合我们用这种模糊边缘的方式给他处理一下,我们先把他生成一下吧,既然在这边说呢,就让他边生成啊,这个地方我们不要那么复杂了,就给他个弯钩就可以。 那么第三种涂鸦呢,我觉得现在还不成熟啊,能用到的地方也不多,和这个有一些像,但是呢,他能给出更好的边缘过渡 涂鸦呢,它的边缘是比较生硬的。那第四个 m, l, s, d 呢,就是我们刚才所用的一个建筑,一个硬表面。那说完这四种使用方式以后呢,它 更多的适合一种转描转数,对吧?比如说我们有个手稿,类似于这个样子的手稿,就适合用这样的方式,甚至我们可以把这个手稿直接当成我们的资讯图来铲除,不需要用用这个预处理的模型,我们可以用 kenny 的一个方式,或者是 h e d 的一个方式来直接把它生成出来,那这里可以看到我们这个资, 这是对的,但他的手是有问题的,我们需要后期进行一些调教。那么说完这四种以后呢,我们来说另外的四种,就是下面这四个,他是比较针对于专业领域的。第一个就是就是我们说的一个深度图,之前如果呃懂后期的一些朋友或者是看过我之前任意教程的呢, 我们也是通过一个深度图来产出一个,应该是一个做一个动态图片啊,做一个视察动图。那么这里呢,我们把刚才我们这个挪进来 我们室内的,因为他有个纵深关系,我们可以通过这个深度图直接铲除我们想要的一个纵深关系。现在我们来看哪个是远,哪个是近,那么更远的在哪里, 最近的在哪里,他会给予试图这样一个信息。那么通过这个图铲出的图片呢?他也有一个纵深的这么一个关系,现在呢纵深最远的窗帘那个地方我们看不见了,我们可以把他的纵深调一下,但现在我们选的这个预处理方式呢,是是最基础的这个 dips 方式,我们需要 选到下面这一个更多选项啊,这个 dips 下面我们可以看到他的一个采样范围,在这里呢,我们可以稍微来调整一下他的采样范围,那么第一个是距离,第二个呢是他的背景距离啊,也就是我们整个的前前后距离和他的背景距离拉伸有多远?这里呢我们只需要调整一下他的距离,往前调一调,那么他前面呢可能 就会更亮一点,后面呢也会提起来一点,那现在可以看到他前面是更亮了一点,对吧?后面的窗帘也被读取进来了,对吧?这个信息都有直接用它来生成一个图片, 这里我们就直接给个入目就行,我们来生成在这里可以看到他给我们生产出来一张基本上是一模一样结构的这么一个房间,对于深度图来说,他更适合处理这种有紧身大紧身的一个图, 说我们这个他也有个谨慎模特和人物,他的近景和远景远近关系有多少都适合用这样的方式,也就说白了就是一个广角, 他有人物信息,呃,有物件信息,甚至有场景环境信息,就适合我们这个 dp map。 但这种生成出来的图片呢,我们再稍微多了解一些,就关于一些其他专业领域的都会用到这样的图片。 比如说我们的视频,后期可以用这个图做一些视察动画,也可以把它当成遮罩来进行一个远近关系处理的一个特效的制作。又或者三 d 软件里面可以把这种贴图呢做成一个动态贴图,也也一样是属于一个视觉特效。那如果对后期有兴趣的小伙伴呢,我们再可以深入探讨一下他生成出来这个 deep maps 我们如何利用,在后期我们能做些什么?那么第二个呢,我们说到的就是 norma, 那这个呢,更多的是用于三 d 领域的 bpl 材质制作,比如说这里呢,我们同样把这个耳机给到他,让 它生成一个耳机的 norma, 可以看到这是一个法线贴图了,对吧?那么它更适合于近景物体的一个描述,一个描绘它会把这个物体的三 d 空间,三 d 位置凹 出质感体现出来。那如果对三 t 行业有接触过了解的小伙伴,先去知道 nonomap 主要是体现物体细节的,那我们来通过这个 nonomap 我们再生成一个细节的一个图片啊,我们把这个模型给到 no, 同时呢我们给到五幺二,那可以看到这里他渲染的还是有一个手, 可能还是因为我们的负面词添加了人物的一些相关东西,还原的话还要重启啊。这里我们就说一下这个 nomaf, 可以看到他给耳机的细节呢,会有很明确的一个凹凸的一个细节,包括他的耳机上面的这样一个头带。但是比较有问题的就是可以看到他的背景是完全什么信息都没有,所以他后面的信息他会 胡乱发挥,所以说在紧身处理上他就不如这个 deep map, 就是我们这个深度信息图做的好。同样呢我们也可以来测试一下。对于一个人物而言,这里我觉得人物的细节他体现的比较好,我们预处理看一下,把他预制往下拉一拉,可以看到他对人物的这个发丝啊,发带, 哎呀,头发对不对?这个细节要好于深度图,如果我们要换深度图的这个处理呢? dips 我们这块来处理一下。深度可以看到人物的细节基本上是消失的,他没有这个关于发带的一些细节,或者是服装那些细节都没有,所以深度更适合做场景,这个呢,我觉得更适合做特写的一些物体。 接下来我们再看,这是第几个了,我不知道 s e g 他的项目网站,来我们可以看看一下,他这个全称是 semantic segment teach 呢,翻译过来就是分割羽翼。如果做过这个标注行业的朋友应该知道啊,他是一个 id 图, 它会生成一个 id 图,那在专业的标注行业呢?这个 id 图的不同的颜色,它代表了不同的东西,标注的东西是很明确和很清晰的,比如说草坪,比如说树,天空、海洋,各种各样的这个标注它都不一样,所以说它的 id 产生的是很明确的,那这个地方就更适合做一些。呃,我们场景标注的 东西,比如说这个地方,我们给到他这么一个一张图啊,我们让他标注一下,我们找到一个 seg 啊,语音分割的这么一种方式,让他标注一下。那么这里可以看到啊,他对每一个物体呢都进行了一个明确的划分和标注,包括黄色的可以看到是植物,这个灰色的是道路,红色的是房屋,包括上面是天空和植物, 这是一个明确的标注。那么通过这样的标注生成图呢,它的结构也是比较好的,也就是说这一块呢,你只能给我画房屋,那么黄色这一块呢,你只能给我画草坪,那么这里我们再给他一个另外一个室内的一个图, 稍微比较凌乱的啊,我们再重新让他标注一下,可以看到他标注的是比较明确的。不同的物件在哪里啊,悬挂的什么东西都可以标注的很明确啊,那接下来呢,我们再用这个标注,我们再出一个图,同样我们分辨率要调一下啊,横屏的话我们给他宽度七六八,描述词给个入,然后我们直接 生成,在这里我们可以看到他所标注的内容啊,和我们产生的图像呢,有些地方他标注的并不是很明确,也不是很对啊,毕竟这个预处理模型他不是专业的一个标注的这么一个范畴,如果想要做标注预处理呢, 其实是专门有这个专业行业的啊,那么我们也有对应专业行业专门的一个标注信息图的一个处理方式,要比这个严谨的多,如果通过那种方式处理的话呢,他的图片可控性就很高。那么这种方式解决了个什么问题呢?比如说我们用 cane 的这样的方式,或者是各种各样的描边方式啊,预处理出来的一个 id 图呢, 他辨别不了这个地方是什么,比如说我们这个地方是一个柱子,但是呢他会把这个地方画成一个布条,又或者是画成一个很狭窄的一个书架或者是门之类的,他会自由的去发挥,不会按我们所想具体是什么物体来制定。但这个地方我们可以看到这个地方就是 一个柱子,我们所标注出来的这个红色的这么一些地方,他就是一个建筑物,那至于什么颜色代表什么物体呢?如果大家有兴趣,我会专门针对这个标注的这么一个功能,以及深入到一个一些相关领域呢,说一些资料来专门做这一期啊关于标注的内容。那说完这些,最后一个我们来看一下,就是大家所谓的 openpose 了, 解决我们项目里所说的这么一个 human post, 我们如何去锁定一个人体的姿势,那这个东西相信大家看过很多教程以后也知道它的用法其实比较简单。这里我们给到一个人物,我们让他用这个 open post 出一个图, 出一个预览图,我们来看一下他能不能给到我们一个正确的人体,可以看到是没有问题的,这样的话能控制画面当中人物的一个形体造型,但是呢,有时候过于夸张的一些造型,一些姿势呢,可能会有些问题啊,这里我们稍后再说。接下来呢,我们用这样张图呢,然后再出一张图,同样图生图,我们把这题 词给他提出来,提出来以后,我们放到纹身图的下面来,都没有问题,我们把下面这个模型呢,我们给到 openpose 对应的模型,然后我们点击生成。那么通过这张图我们可以看到啊,这个姿势呢,差不多一样的,对吧?胳膊也是在这,身体也是这么一个站姿,那么脸和上面这个伞有一些问题,包括他这个正反,那 这就是 openpose 的一些问题。同时呢,周围也和我们这个画面不一样,因为这个 openpose 呢,他只给到了一个股价信息,但是呢他没有给到环境信息,也没有给到构图信息, 有时候 openpose 出来的这个构图呢,可能和你想要的构图还不一样,比如说这里我们再来一个图片,我们来分析一下这位女士,她的一个坐姿,分析出来的还是差不多的, openpose 只是说下面这个胳膊稍微有一点不太对,我们稍微在下面调教一下他的这个参数,来重新生成一下,看看效果怎么样。哎,这样的话,下面这个胳膊稍微好一点,两个腿呢也 差不多。这个时候呢,我们再生成一个,大家就知道我说的这个构图是什么意思,那么我们现在来对比看一下,这两张图哪些地方是不太一样的呢?首先一个环境不一样,对吧?第二个呢,是角度不一样啊,这个地方他有点仰视,对吧?就是仰拍。原本的这个图片呢,我们过来看一下,他是一个直视的正拍的, 不过这个人有点抬头而已。但是我们这个图片呢,给出来的就是有些仰拍,他的摄像机机位有点低,造成了构图上的变化,所以这就是只识别骨架,其他信息都是他自己想的。 那我们如何要锁定人物的姿势,制定他的姿势,又要呃来给他一个合适的构图,或者是他的背景是我们想要的,那这样呢,就说到我们两个 ctrl net 一个结合方式, 我们可以在第一个给到他人物的姿势,第二个呢,给到他一个环境,比如说我们用深度图也好,或者是用描边图也好,都行,我们开启第二个 ctrl net 以后,把这个图片拖进来,点击 启用,我们给到他一个深度图,这里呢我们同样用一个深度处理,然后这个姿势我们就固定了,这里呢,我们宽度给他一个横屏,然后我们直接来生成。那现在我们就可以看到啊,在这个场景里呢,他有一个这样奇奇怪怪的人物啊,这样的话他是一种粗暴的进行了一个简单的两个东西的融合, 如果要想细条金条的话呢,我们其实这个人物的这个骨架呢,是要和我们这个深度图的位置进行一个对等的,把这个人物的骨架放在这个深度图某一个位置,这是我们后期要细节处理和调教的,当然对这个 openpose 呢,现在也衍生的出了很多不同的调教方法, 最简单的就是我们上的这个 openpose 的编辑器,我们可以在这里编辑一些人物的方式啊,那对于这种方式的使用呢,它的内容还是很多的,我们可以留到后面呢,再专门讲一期这个 openpose, 那么这就是这一期跟大家分享的关于 ctrline 的这个网络是如何运用 用的,关键是这个官方的这八大模型都有什么用处,那两种的结合呢?我们也可以再回头再聊一下我们如何开启更多的网络啊,如何结合不同的网络来正确的运用,在专业领域又能用到哪一些?主要是这三个专业的领域能拓展出来很多内容,如果觉得这一期对大家还有所帮助的话,那 千万不要忘了点击系列按键来支持万元线下,如果未来希望了解更多啊视觉视频相关的内容的话呢,也千万不要忘了点击波关注我们未来呢也一起学习,一起探讨,一起进步吧,好了,我们下期再见。
202OUY后期公园 02:43查看AI文稿AI文稿
大家好,我是灰灰老师,这期我们分享一下 control net v 一点一的 m l s d 模型。 m l s d 模型为直线检测工具,主要适用于室内和建筑设计。 如图,就是通过检测毛坯房的格局线条,从而生成室内效果图。接下来我们返回 y b u i 详细看一下,打开 control net 为一点一选择 m l s d 模型,点击启用,打开完美像素允许预览。 这里我们先拖进一张建筑图,观察一下处理结果,可以看出只检测到了建筑下方的直线部分,上方的异形顶没有。 接下来我们再换一张图看看。这张的建筑主体部分的线条是完整的,我们再 导入一张室内效果图看看,整体画面都处理为了结构直线条,我们下面看一下参数, m l s d 这里有两个重要参数,第一个是它的玉值,我们感受一下值大与小的区别, 当我将直调大后,画面直接黑了,不显示直线,我们再将直调小, 可以看到线条非常清晰。第二个参数统理,大家可以自行感受一下,值越小识别越精细。接下来我们给一组提示词,看看生成效果。先简单的一组描述现代轻奢风卧室 室内的迭代步数,建议三十以上, 我们生成看一下, 效果还是不错的,基本都是按照预处理后的线条结构生成的,与原图结构也基本保持一致,只是装饰风格样式变了。我们再换一张毛坯图,由毛坯生成效果图看看怎么样, 其他参数提示词都不变,点击生成 效果也是完全 ok 的。继续生成, 对于室内和建筑来说,可以批量出多种效果图方案,功能非常强大。这期内容分享到这里,我们下期见。
 00:59查看AI文稿AI文稿
stable diffusion 常用五大模型推荐第一个 deliberate deliberate 是一个全能的模型,你的提示词越详细,他的诠释就会越好,就像他的名字深思熟虑,是 c 战中下载次数最多的模型哦。 第二个 ghost max 高评分模型,线条密集且又不错的艺术感,效果,非常 nice。 如果你是二次元创作者,一定不能错过这个模型。 第三个暗恋二次元新手推荐这个模型生成的二次元人物效果非常好,极易上手,即使是简单的描述也能生成很好看的图片呢。 第四个 counterfep 高质量动漫风格模型,人物和场景画的都非常漂亮,划分也很干净舒服,是我最爱的模型之一。 第五个 my g max realistic 该模型专门用于生成现实模型,不论男女,出图效果都很好,宽容度高。用它搭配人物 laura 就可以生成照片级的作品了。宝子们,你们最喜欢的模型是哪个呢?评论区分享起来吧!
1552火星时代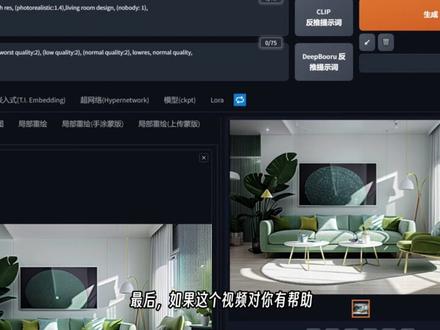 02:28查看AI文稿AI文稿
你肯定想象不到 sd 也可以电图了。 control net 的这项新能力简直让 stable diffusion 的实用性再上一个台阶,这个新能力就是一点一点。四、新版本发布,预处理器 ip adapter 这些更新将彻底改变 sd 的使用流程。 ipadapter 这个新的功能,简单来说,他可以识别参考图的艺术风格和内容,然后生成相似的作品,并且还可以搭配其他控制器使用。可以说, sd 已经学会临摹大师的绘画,并且运用到自己的作品上了。 接下来,我将通过两个小案例向你展示 ipadapter 如何使用。无论你是艺术家、设计师,还是只是对 ai 技术感兴趣,这个教程都将带你深入了解如何利用 ipadapter 将你的创造力发挥到极致。这条视频讲的非常详细,建议你先点赞收藏。 首先,我们打开 y b o i 界面,在 control net 选择 ip adapter, 选择一张参考图,我专门选了一张风格比较明显的女生。然后我们调整与处理器和图 图片尺寸。最后点击生成按钮,可以看到生成的人物不仅头发颜色、动作姿势类似,而且服装也有比较好的还原。接着,我们再添加一张新图片到 ctrl net 中,选择 kine 作为控制方式,并推荐把控制参数调低一些,大约零点七。最后点击生成按钮, 生成的人物图片姿势符合参考图片,而且画风还能保持统一。然后我们再换一张图片,选择 soft age 模式进行生成,结果同样令人满意。 接下来我们演示一下如何制作室内效果图。首先,我们选择一张室内效果图,并将其放入 control net 中。接着选择 ipadapter 进行适配,然后调整图片参数和更换大模型。最后直接点击生成按钮,可以看到生成的效果图风格非常接近原图,当然这个拿来直接使用还有一定的距离, 所以我再添加一个图作为构图参考,选择 dept 深度图模型,点击生成 风格也是完美的迁移到了我们想要的构图上。虽然现在看起来生成的图片有些模糊,是因为我使用的是 sd 一点五的模型,并且还没有输入任何的提示词。最后我们再添加一个常用的质量提示词骑手式,然后通过使用 tail 插件提高生成图片的分辨率, 最终达到一千零八十分辨率。这就是 control net 插件 v 一点一点四版本的最新更新 ip adapter 功能,我相信将为 ai 绘画带来新的可能性。如果这个视频对你有帮助,请不要忘记点赞收藏, 你的支持对我制作下一期教程非常重要。如果你有任何想学的内容,请随时在评论中告诉我们。感谢你的观看。我是设计师,学 ai 教你实操,圣于虚言。我们下期再见。
1733设计师学Ai 16:10查看AI文稿AI文稿
hello, 大家好,大家玩 stable defusion 应该有一段时间了吧,也下载了很多的大模型和 laura, 但是有的大模型和 laura 呢?它是有一定的触发词的,只有和触发词结合在一起使用,这个效果才会更好一些。 就比如说像这个汉服的 lara, 它是有相对应的触发词的,就是这旁边紫色的这个就是它的触发词,你只有和这种触发词结合在一起使用,才更好地去调用这个 lara, 它的效果才会更好一些。那么 回到这里,如果你的大模型和 lora 下载的比较少,那你这个还记得这个触发词,但是这个模型一旦多了之后,可能就不太方便我们记忆了,或者是你把这些触发词写在记事本上边啊等等之类的,但是不是那么好去调用。像我之前 前给大家去介绍了一个插件,就是 safeta ai 助手这个插件,它可以对这些模型进行管理,但是有的人跟我反馈它这个有一定的 bug, 很可能就是扫描不成功,而且只能扫描 c 站上边的一些模型,那从别的一些地方或者自己训练的一些模型就没办法去管理了。那么今天就给大家去介绍另外一款插件,就是这个 laura prompter to 这个插件,它可以很好的去管理我们的模型。那这个插件是怎么样的?我们一起来看一下,就比如说像这个汉服的这个 laura, 对吧? 然后你点击它,它会在这里去调用这个 lora, 但是它还有相对应的触发词,我们鼠标右击,然后我们点这个汉服,你可以看一下它的 触发词就放过来了,就是这个你可以看一下一模一样的这个触发词啊。还有一个你鼠标右击,你还可以加入试列图片的提示词,就是这些图片,你可以看一下这些图片都是 c 站上边扒拉下来的,那么就是这个 就是这些图片可以看一下的,那么你点这个图片,他就可以把这个图片的提示词,然后就是自动的就是转到这个提示词框内了,然后我们再把这个清除掉, 我们再看一下下边他还有试列读的提示词和他这个读的一些参数,他也可以去调用,但是我觉得他这个还是有一 定的问题,你可以看一下他这个地方都不对,你看大小很明显是不对的,对吧?然后还有等等一系列的,比如说这个我没有他相对应的底膜,我给大家去就是说介绍一下,我们先把这里清空,我们刷新一下嘛, 我们就以一个我有的,比如说像这个国风三,然后就是他这个图, 你可以看一下他的提示词是对的,然后但是他下边你可以看一下这个地方 大小是不对的,而且他的这些放大算法啊,这些都是不对的。比如说我们在这里生成,他是没办法去生成这张图的,是有问题的,可以看一下是有问题的,没办法去调用 它,是什么原因呢?比如说我们可以看一下哈,我们在 c 站上边去找国风三的模型, 就是这张图片,我们可以看一下生成这张图片它的参数,点右下角这个地方,然后 copy 它生成的参数,复制回到 stable diffusing 这个页面,我们先清空一下提示词, 把我们刚刚复制的东西粘贴到这里来,然后这里是它的正反向提示词,下边就是各种的参数,我们可以看一下, 这个是比较重要的,这个是噪声种子偏移,他是还原图片的,这是大小六四零乘以零二四。我们再往后看,这是他的采样方法,这是跳 过程是二,然后是高清修复采样的一个次数是六十四,放大两倍,这个是放大算法,这是他的一些参数,我们点这个地方,点这个箭头,他就可以帮我们自动的去配置好了,可以看一下, 但是它是没有这个差异,随机种子的这个地方是没有的,我们取消这个勾选,但是它多了一个覆盖设置,你可以看一下跳过层十二,然后这个是噪声种子偏移,因为我这两个都没有去设置,然后我们点这里生成,你可以看一下, 它就可以生成就是这张图片了,就是还原这张图片,就是这个,那么它这个插件这个地方是有问题的,这个参数是有问题的,我们看一下到底有什么问题。我们刷新一 同样,我们鼠标右击,然后点这个 点它,它的这个正反向提示词是对的,没有问题。然后我们再往下看, 它的放大算法是错的,它没有去识别是这个放大算法,然后它的高清修复采样次数也是没有识别出来,它是六十四的一个次数,大小也是不对的,是六四零乘以零二四。 然后我们再往下,他是没有这个差异,随机种子的,他这个地方是应该错了,应该是那个噪声种子偏移,所以我们这个不勾选那个噪声种子偏移呢?他是在这个地方我们点设置,然 后这里有一个采样器参数,下边这里就是噪声种子偏移,就是这个东西他是建议三幺三三七的,他不影响我们平时生成图片的。设置好了之后,我们点保存, 然后回到纹身图这个地方,它的跳过程是二,其他的参数我们也已经改掉了,改掉之后我们再点击生成,你可以看一下, 它就可以还原我们这张图片了,可以看一下,所以这个功能呢,它的这个参数,这个地方是有问题的,但是我们可以借鉴上边的这个,它的这些图片,它的这些提示词你是可以看的,而 这些提示词的话可以学习,我们可以结合这个提示词插件,就是这个地方,然后你可以把这些识别出来,把意思翻译出来,然后进行一些调整,你可以去学习生成一些比较类似的一些图片,对吧?那这个地方他是那个翻译有点慢,可以看一下, 就是这个插件,这个插件我觉得最大的一个用处不是在这个地方,而是在它可以去编辑你从别的地方下载的模型,或者是嗯,就是在 c 站上边下载,但是这边没有去识别的,或者是你自己训练的 一些模型,比如说像这个 lorra, 这是 c 账上边的一个 lorra 盲盒的这个 lorra, 然后你鼠标右击,它没办法去识别它的就是 提示词啊这些,这个是我之前就是测试了一下,就是没有去识别好他的一些触发词等等之类的,那我们可以点这个地方进行编辑,比如说像你自己训练的罗啊,或者别的一些地方下载的一些罗啊,你就可以在这进行编辑了, 这是他的名称,然后路径等等,这一等你还可以在这里设置一些就是权重,你调用他的时候,他就会使用这个权重。 然后还有这个建议的 lora 的一个分层控制,你也可以在这里进行编辑,然后这是他的名称和触发词,这是我之前测试的, 然后这是额外的描述专用的反向提示词,你都可以进行设置,设置好了之后点这里确认保存,就可以去调用这些了,这是一键的编辑。但是我不是特别建议大家用这个, 而是建议大家用这个高级编辑。就是这个地方,比如说像这里的名称,我可以去输入,我就输入一个盲盒这样的一个名称,然后触发词 c 账上边我们搜到 盲盒的这个模型,然后你可以看一下他的出发词,是这个,我们就复制一下, 然后回到这里,我们可以把触发词黏贴到这里来,然后这个是触发词的一个分类,你也可以进行填写的,然后这个是反向提示词,我们不管, 当然这里触发词设置好了,我们可以点这个加号进行添加,就是下边这是可以添加的,我们也可以点这个叉删除, 是也可以删除,同样我们点这个这个地方也是可以添加的,然后比如说我们在这里添加一个就是附项, 然后这个是它的反向提示词,比如说我就随便复制一个它的反向提示词 粘贴到这儿来,然后这里你反向提示词,你这后边儿要填写 y, 你还可以继续的编辑添加,都是 ok 的。然后这里也可以移除重复的提示,这儿是移除空白的提示等等。然后你编辑好了之后,特别是你自己训练的模型, 然后你是可以在这编辑的,而且你这里也可以就是说把你这上边的内容就是一行为一组,把它输入到这里,然后也点这个从文字框读取提示词,它也可以读取到这儿来, 明白了吗?然后如果你是军 boss 模型,然后去就是训练的,那你也可以点这个直接去抓取他的一个触发词,也是 ok 的, 然后这里你保存好了之后,对吧?然后回到这个纹身图,你可以看一下,就是这个盲盒的这个你鼠标右键,你可以看一下我们刚刚点的这个盲盒,我们先把这里清空掉,就这清空掉, 然后我们刚刚输出的这个盲盒,对吧?比如说我们点它,先点它去调用这个 lora, 然后 我们可以鼠标右击输入这个盲盒,你可以看一下他的触发词就已经调用好了,就是这个就是我们刚设置的,而且这里我们不是输入了一个负向,就是这个反向提示词吗?然后我们点他, 他这个反向提示词,这个地方就可以帮我们去录入进去了,就是我们刚刚进行设置的,而且这里是我们建议的模型设置,就是这个建议的这个权重,我们点他, 你可以看一下,就是我们刚设置的这个 laura 调用的一个权重是零点六,他直接是这样去调用的,所以你直接点他调用的是一的一个权重,但如果你是调用的那个建议权重就是我们刚设置的这个零点六,明白了吗?是可以进行编辑的,不管是在 c 上上边还是你自己训练的 模型,都是可以在这里进行编辑的。除了这个像 c 站上边,比如说像这个 就是这个模型,我们也可以就是进行编辑,现在是啥都没有,对吧?但是他是 c 站上边的一个模型,我们点这个编辑,然后来到这个页面之后,我们同样点到这个高级编辑里边, 然后我们可以直接从 safety ai 抓取配置文件,我们点它, 你就可以看到他是在 c 站上边抓取的这个提示词了,比如说我们在这里嘛,然后同样我们回到这个地方去输入这个模型搜一下,我们看一下他抓取的那个对不对?就是这个,就是这个 cute girl mix 四,然后它的 这个触发词就是这个复制一下吗?我们回到这个地方,你可以看一下,比如说这里我们粘贴一下,对吧?是一样的, 然后多的一些地方,你可以进行编辑的,就是这个地方,比如说我们也复制这个反向提示词,然后我们点这里反向反向 提示词,然后这个地方它的触发词,我们这里还可以改名字,我们就改成触发词都可以 反向提示词,我们不敢把刚刚那个粘贴到这来,然后你反向提 提示词,这后边就是要设为 y, 就是这一块,然后设置好了之后,你可以点这里保存, 然后保存好了之后,我们回到这个纹身图这里,然后我们就是这个模型,我们鼠标右击,然后你就可以看到这里是他的触发词,对吧?我们先调用一下这个 lora, 可以看一下是调用了,然后我们再把这个触发词点上,可以看一下就是这里, 然后呢我们把这里先删掉,这个是反向提示词框,然后这里有一个反向提示词,点他你可以看一下, 就是这样的,大家可以下来去看一下,然后你从 c 站上边抓取的这个呃文件之后, 它会有这些试列图,你可以看一下这是抓取的试列图等等,都是可以进行编辑的, 明白了吗?这个是这个插件非常的方便,大家下来可以去试用一下,然后你看一下他的一个就安装方法,跟我们平时的这个插件的安装方法是一样的,我们这个地址会分享给大家。来到这个页面之后,你点这里的鼠标绿色的这个 地方,然后点它复制一下这行命令,回到 stable defusion 这个页面,然后点这里的扩展,从网站安装,把刚刚那个命令粘贴到这里来,点这里安装, 安装好了之后,他这里会出现他安装的地址,然后你再点这个已安装应用并重启就可以了。如果这里因为网速等原因下载不下来,你可以点这个地方同样复制这个命令,然后我们 回到这个 weby 的一个目录,然后找到 extensions 这个文件夹,然后来到这里之后,我们鼠标右击,在终端中打开,可以打开这个界面,没有的话你就在这里输入 powershell 或者是 c, m, d 都可以,然后再按那个 enter 键,它也可以进入这个窗口,然后我们在这里输入 get clone, 把我们刚刚那个命令粘贴到这里来,然后在 enter 键进行运行,我这里就不运行了,然后你运行好了之后,它会自动下载这个插件, 这个是第二种方法。第三种方法呢?就是回到这个页面,然后你可以下载他的压缩包,就是这里有个当漏的,你可以点这个地方下载他 的压缩包。下载好了之后你要进行解压,解压好的那个文件你同样放到这个 extensions 这个文件夹下边来,然后放好了之后重新启动你的 vbui, 就可以使用这个插件了。然后这个就是今天的一个分享,大家下来可以自行的去试用一下这个插件。
254喜好儿网


