脚本之家的提取码是多少
共享提示网络发现已关闭网络,计算机和设备不可见,遇到这种情况怎么办呢? 桌面左下角的开始就是 window 按键,然后在设置界面输入控制面板,点击网络和 internet, 再点击网络和共享中心, 然后再点击左边的更改高级共享设置,这里面可以看见两三个选择来宾或公用专用所有网络,三个都打开它,勾选里面的启用网络,发现设置好了以后记得点击下面的保存更改。
粉丝2735获赞5.5万
相关视频
 01:06查看AI文稿AI文稿
大家好,我是老张,呃,前几个视频呢?呃,我发了一个呃手机二维码的一个提取的一个动作脚本啊,呃,只要打开我们的二维码,然后点击我们这里的手机提取手机截图的二维码呢,然后程序会自动给我们截取一个二维码。 但是呢,哎,有粉丝又发给我一个另外的一个二维码,因为我们做的这个脚本动作呢,我只做了这种黑色的二维码,所以呢一件是可以很好的去提取的啊。结果前两天呢,有粉丝又发给我一个绿色的二维码,然后我们有用这个动作去提取呢,就提取不到。 好,那问我能不能把这种绿码也能够给他提取出来啊?那么我又补了一个提取手机二维码绿码的一个动作啊,我们现在这个是绿色的码,然后我们点击这个提取绿码的 动作,现在也能去提取出这个二维码了,你们还有什么其他颜色的二维码吗?啊,也可以都发给我,给大家多一些测试吧,我们现在这个地区没有什么风险,所以还没有接触到这种啊提取绿码的情况。
 00:26查看AI文稿AI文稿
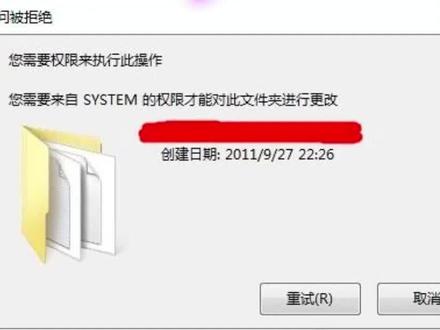
当你删除文件夹时,却出现了你需要来自 system 的权限才能删除的提示,遇到这种情况该怎么办呢?其实很简单,一个简单的设置就可以搞定。首先右键该文件夹 属性安全,高级点击更改,高级立即查找,在下方的框框找到本地账户,点击确定,再点击确定,然后将这两个勾选项勾选,点击应用四确定确定,这样就好了,你学会了吗?
3090脚本之家 09:52查看AI文稿AI文稿
hello, 大家好,欢迎来到跟这个零零后学员,我是阿进,那今天给大家分享一下如何用 opencloud 去爬取抖音的数据, 那上一期我们给大家分享过如何去安装 opencll, 那 安装以后呢,我就带大家一起去啊,去看一下如何去使用 opencll, 那 因为大家其实平时刷抖音比较多,那我们今天就给大家分享如何去用 opencll 去爬取抖音的数据, 那我们爬取的话需要什么样的工具和步骤呢?首先第一个是 opencll 啊,我们肯定要安装 opencll 嘛。 第二个其实是我们用到一个开源的工具叫 media cloud 去爬取这个数据,因为你直接用 opencloud 去让它去执行相关的操作的时候啊,其实会有些限制,比如说抖音会有一些反爬的机制,还有比如说这个登录信息的保存等,这些其实,呃 相对来说实验起来有点复杂,所以我们用 media cloud 更简单更直接一点。好,那我们直接开始我们今天的内容, 首先肯定还是安装我们这个 open climb 嘛,安装完了以后,呃其实就可以让它去执行任务了。我们,呃我们这里就不用重复执行了,给大家看一下我们 执行的历史,因为重复执行的话,哦已经有记忆了,它可能会有不一样的结构,给大家简单看一下就知道大家就知道什么意思了啊。首先我们,呃 创建完了以后,先给这个 open class 指定了他叫什么我们叫什么,对吧?然后说他会问我们需要做什么东西。然后我首先是给了他一个任务,就是 先不用不借助我们说的那个开源工具啊,我们给的这个任务是什么呢?首先第一个是让他自己去用浏览器打开抖音的官网,然后用工商赔偿去搜索视频,然后去筛选近半年内低本高赞的视频,最后呢再把相关的视频详细信息输出给我, 然后他就有反馈了,他说他搞不定,为什么呢?因为他又没有浏览器,抖音又没有公开的 a p i, 没办法去搜索。 然后呢我会告诉他,因为,呃有,其实我们默认没有装一些 skill, 然后我告诉他,让他装一个触摸浏览器的 skill, 然后他再去试啊,然后他会有一些思考的流程啊,他有几个相关的 skill 啊,然后去安装 好,然后它 skill 装好了之后它有两个限制啊,要本地去装一些东西,但是抖音可能会封,对吧?还有一些反爬的这个 skill, 但是这个的话也会需要一些 api 啊,这个可能对一些对一些新手来说会有硬的门槛, 所以我们就没必要后面再用这个东西再去折腾,我们就直接让它去 呃,让他去用那个工具,我们更新一下我们的这个题诗词啊,就是让他去这个链接,其实就是我们那个开源工具的呃, get up, 让他去这个链接,自己去查看这个工具是怎么用的, 然后呢再让他去安装,并用这个工具去爬取视频啊,然后第三步呢,就是让他去啊,筛选这个低端的视频啊。第四步就是把这前四个视频的协议已输入给我, 然后他就开始了,大家可以看到他会去有一个思考的过程,比如说网页会去失败,搜索也失败,他会去自己去尝试, 会尝试很多方法,对吧?可以看到如果他网页打不开,因为这个 ktv 有 时候网也网络不稳定,不容易打开,但是他会去尝试去下载,下载成功,然后他会有一些自己的步骤,比如说先检查并安装,下载成功啊,然后他会有一些自己去安装, 如果说如果是安装失败了,他就他就他自己会想别的办法,对吧?好,他要安装成功,然后这里会跑,会去跑,这个脚本太好了啊,跑成成功,被运迫取了数据,大家可以看到这里, 是吧?他已经把 this 啊,我按照我们的要求去输出了相关的信息,比如说低粉高赞这个链接, 他的这个作者标题啊,点赞、收藏、评论分享啊,发布时间,还有视频链接已经都输给我们了啊,同时会有标签的分析,然后对本高赞他的理解,还有文件保存位置, 是吧?这里都已经有了,他还会啊,他还会提示我们说要不要把这个文件替我们导出成这个 excel 啊,或者其他的其他的东西,他还可以帮我们去下载视频啊, 这样的话其实就已经完成了,当然这个过程中其实呃他会去,如果如果大家是首次使用,他会去跳出来,他自动会打开浏览器,然后会跳出来一个图片,让我们扫码登录抖音,因为,呃, 因为这个欧,呃,这个 media cloud, 它这个工具使用的话,其实是需要我们呃用扫码登录一次抖音,然后呃保存这个登录信息,我们只需要第一次的时候扫码登录,后面我们再用的话,其实就不用再去扫码, 这个也是为了呃绕过抖音的这个反法机制啊,如果大家去操作的时候记得有这个步骤就行了,只要扫码登录一次就可以。 好,这个就是我们使用啊 opencloud, 然后加这个 mediacloud 去完成抖音数据的版权, 这个是 opencloud, 那 如果说,呃大家呃安装 opencloud 有 问题,或者说想尝试国内其他平台的这个小龙虾想去做啊,怎么做呢?那其实也是可以的,比如说我们可以用 qcloud, 对 吧?这个是腾讯,腾讯的,腾讯的 qcloud, 呃,它其实做起来也是很方便的,这个我也是做过了,可以给大家呃看一下这个呃 呃, qq 的 一个流程,其实我是把相关的这个呃直接把它的题词复制过来啊,给大家看一下,好 看到没?这个是一样的, open 可乐能做,那 q 可乐其实也能做,但这里我们其实已经执行过了它,它会有些思考,然后怎么去做,这样这个这个也会。呃,存在说如果你没有保存登录信息,也是需要先首次登录,需要先扫扫码登录的, 然后这里它也会有这个呃结果,大家可以看到啊,这里它也会思考,其实我们已经执行过一次了,然后你如果再让它执行,它还是会执行的。 这个是 qq 了啊,这里我就我们就不去一一展示了,大家可以自己去尝试 qq 了。这个是腾讯的啊,腾讯出的小龙虾,然后腾讯云其实也出了一个叫 workbody, workbody 的 话,它其实是另一个版本的腾讯的这个小龙虾我们其实也可以用它去做。 好,这里就会思考,先去查找啊, excel 文档它也会一样,也会去做相关的操作。 好看,可以看到我们再切回到 q curl, 这是 q curl, 我 们切回来它,刚才我又让它执行了一次,它其实已经又完成了,可以看到它会告诉你 midi curl 的 工具用法,其实它的思考过程可能会跟 open curl 有 一点不一样,但是整体上都是差不多的, 然后他会去把结果直接输入给我们啊,就是关键发现,然后他把文件直接保存起来了,这是 qcloud。 然后呢,我们再去看 opencloud, 那 个对 workbodyworkbody 的 话,他其实也会在思考,也是在思考。 这个我们就呃不用具体去等了啊,因为这个它有时候执行起来其实时间挺长的,大家只要知道有这个 啊,有这个平台,然后也可以用就行了。那整体上我们今天主要给大家分享了三个平台,去爬取呃抖音的这个数据,但用的方法都是一样的,都是让他让平台去呃去让这个 agent 就是 我们用的哪怕 open cloud 还是 呃 qcloud 还是 workbody, 它其实都是 agent 嘛,哎,就是让这个 agent 去学习工具的用法,然后再用这个工具呃去爬虫,去爬取数据。 对,我们的这个题词词也都是一样的啊,当然结果呃基本上也是大差不差,但是每个平台,它的每个 agent, 它的思考的过程可能会不一样啊,大家有兴趣都可以自己去尝试一下。我们首先用了 opencloud, 然后呢有 qcloud, 最后呢我们还有 workbody 啊,因为他还在执行,我们就不等了,大家有兴趣可以自己去尝试,好吧? 好,那我们今天的这个内容就到这里。好,谢谢大家。如果大家有什么问题可以在评论区跟我们交流,谢谢大家。
9100后AI实验室 06:42查看AI文稿AI文稿
所有做自媒体的人都应该用 codex, 不 管是用来涨粉的视频,还是用来变现的课程,你都可以让 codex 帮你搞定。举个例子,我昨天在星球里说的,现在 codex 的 流量已经起来了,势头绝对不会比之前 coco 的 小。 那为了能吃到这一波的红利,你可以出一套 codex 的 视频课程,课程内容的来源就是 openai 的 官方 youtube, 把官方的教程改一改就能出脚本了。为什么用官方的内容? 因为足够权威,足够有料。其实对于 codex、 colocode 之类的工具,你都完全没有必要去看外边的教程,你就盯着官方出的内容就好。但是对于绝大多数人来说,网络不通,又不懂英文,再加上自己懒,所以这部分的需求就空在那了。 而这个就是咱们自媒体的机会。第一步,先让 codex 把资料全都提取出来。这一步没啥技巧,我就用大白话跟 codex 说到 openai 的 频道,把有关 codex 的 教学内容全都给我找出来。为了保证质量,我把模型开到最高,等了十几分钟, codex 全都搞定了。 而且你看他找的来源,不只是 youtube, 还包括官方的网站,并且把这些内容都做成了结构化的资料。 有了这个基础,接下来就可以让 codex 出脚本了。而这一步的关键是给他参考资料, codex 最初写的完全不行,于是我把我之前的脚本和文章全都给到他 那个文件夹里,有两百多期视频的脚本以及七十篇文章,足够他去提取我的文字风格。你看,有了丰富的上下文之后,再加上一些亲自的指导, codex 出的脚本就靠谱多了,稍微做一些改动就可以开拍, 我来录一段,你们感受一下。哈喽,各位好,欢迎来到我的第二套课程, codex 新手入门, 这是我第一次出 ai 工具类的教学。那么问题来了,为什么不出 cocoode, 而是专门挑 codex 来做?它究竟有什么特别的价值? 我之前在星球内说过,我觉得 openai 应该认真考虑一件事,把 codex 改名叫 work gpt 不是 开玩笑,我真心觉得这个名字会更加准确,因为现在的 codex 已经不只是一个写代码的工具了,它真正的定位是用来干活的。 你看 chat gpt 这个名字其实非常成功, chat 就是 聊天,所以大家天然知道它是一个你可以提问、讨论写东西的入口。但 codex 这个名字问题就很大,它一听就像程序员的工具, 对于普通人来说,一听就不想碰。如果它叫 work gpt, 很多事情一下就清楚了。 chat gpt 是 用来聊天的, work gpt 是 用来干活的,这才是 codex 真正的价值和渠格。 因为 codex 解决的是人怎么跟 ai 交流,而 codex 解决的是 ai 怎么替人推进工作。这两个东西不是同一个物种。 codex 这个物种学名叫 angelic ai, 你 给它目标,给它上下文,给它边界,给它工具,给它验收标准,然后它自己会去执行,中间遇到需要确认的问题再回来问你。 这就是 chatbot 和 ajaxai 最大的差异。所以我说它叫 codex, 反而限制了大家对它的理解,它不是 code gpt, 而是 work gpt。 那 为什么你现在应该用?除了刚才说的价值和定位之外,还有三个很现实的原因。第一,门槛低。 以前大家一说到 ai 编程工具,就想到 cli、 终端命令、环境、权限、路径,这些概念对于程序员来说还好,但对于普通人来说实在太吓人了。但 codex 现在有桌面版,这个变化很关键, 他把一个原本偏工程师的工具,变成了普通人也能打开的应用,你不需要学一堆的命令,你只需要知道我有一个任务,我要交给他,这就是低门槛的意义。第二,成熟度高。 说实话,很多 a 卷产品看起来很猛,但实际用起来很不靠谱,一会是权限出了问题,一会环境出了问题,一会坐着坐着他自己就跑偏了。 而 codex 的 优势是它已经成熟到你可以信任它的程度。比如 codex 把很多脏活累活都补上了, 包括任务隔离、权限确认、浏览器操作结果验证等等,这些东西看起来不性感,但它们实实在在决定了一款 a 卷产品能不能进生产环境。第三,安全边界更清楚。 这一点我觉得特别重要, a 卷越强越不能乱来,尤其是能操作电脑、浏览器、文件系统之后,安全就不是一个可选项了。我之前为什么对 open core 类型的产品会比较谨慎? 因为它们能力是很猛,但是边界不够稳,我绝对不会轻易把它放进我的核心工作流当中。 codex 在 这点上更像一个大厂的产品, 它不是只追求能不能点鼠标,它还会考虑权限确认、隔离、风险操作,这个就稳了很多。所以作为课程的第一集,我想先给大家一个总体的判断, codex 的 价值不是又一个 ai 编程工具,它的真正价值是 openai 做出了一个跟 check gpt 区隔明显,甚至可以平起平坐的工作型产品, 确保 gpt 解决对话, codex 解决工作。如果未来有一天他真的改名叫 work gpt, 我 一点都不会意外,因为这才是他真正的位置。 怎么样,作为课程的第一集,是不是完全 ok? 这整套东西的基础是官方出的教程,因为是官方出的,所以你不用担心专业上的问题,而且这些内容对于普通用户来说足够了。然后 codex 会根据参考文档进行风格化的处理, 这一步他做的挺好的。最后我们再亲自上手顺一遍,以及添加一些我们自己的东西,一套课程就出来了。 就像我在星球里说的,这种事情没有任何的门槛,而且如果不想做视频课程的话,还可以做成文字版放到闲鱼上去卖。如果你是自媒体,对技术不是那么懂的话,那么 codex 就是 你的最优解,少一点折腾,多一点产出,抓紧起飞吧。 ok! 以上就是本期内容,想了解 ai, 想成为超级个体,想找到志同道合的人,就来我们 newtype 社群,那咱们下期见。
1176黄益贺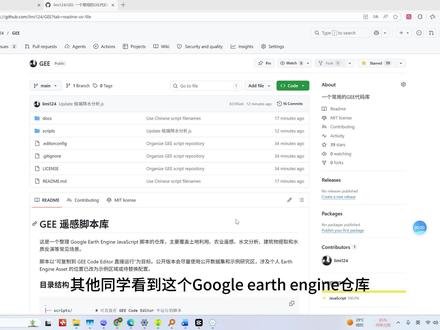 02:17查看AI文稿AI文稿
其他同学看到这个 google earth engine 仓库都急哭了, 哈喽大家好,我是 s 小 白,本期我们分享的是一个 g e e 的 开源代码仓库,这个仓库是比较久远,之前我自己整理的一个仓库,但是因为当时整理的很粗糙,所以今天给它归拢了一下,然后也欢迎大家过来贡献。 我先介绍一下这个仓库吧,大家做出贡献之前,首先要点开这个文档看一下,这里是一个贡献规范,然后我们来看一下目录源代码脚本,目前都是一些综合性的分析脚本,比如这个土地利用覆盖分类,这个是用的,这个是数据下载,应该是因为比较久远了。 然后这个是叶绿素的持续分析,这个是一个建筑物分割并且提取的脚本, 然后这个应该是一个极端降水分析的脚本,这个是耕地 n d v i 十续分析脚本, 这个是耕地高精度随机森林分类提取脚本,然后给大家看一下运行的结果吧,刚才抽空运行了一下,然后从第一个开始看, 这个是徐州市的耕地 n d v i 持续分析脚本,大家可以看一下,这不是结果,然后咱们看下一个,这里不用管,这里是计算超时了,格式化超时了,不用管的,然后这个是提取出来的那个建筑物,还可以提取出来建筑物高度这些, 然后这个是西南地区的极端降水持续分析,应该是,然后可以把它导出来 c s v 点数据,然后进行一个持续分析展示看一下, 然后这个是叶绿素的一个持续分析,结合随机森林,大家可以看一下,这个是 r 方很低,这个这个还比较粗糙的样本没选好,当时大家可以借鉴一下。 然后这个,哎,这个是下载哨兵数据的,然后后面我们会把这些基础的代码给放进去, 呃,当然了,也欢迎大家一起来做开源来做贡献。然后也方便咱们遥感地信的同学以后用这个 g e e 去做分析, 包括像下载 d e m 数据啊,像那个 mk 持续分析啊,像还有什么东西,像还有 r s e i 那 种综合代码,我们后面都会开源出来的,欢迎大家一起来做贡献,帮助很多同学一起学习这个记忆。 ok, 谢谢大家。
861is小白 00:16查看AI文稿AI文稿
今天教大家电脑默认下载位置如何修改,点击左下角 windows 图标,点击设置图标,点击系统,点击存储,点击更改新内容保存位置,选择要保存的位置,点击应用就完成了, nice!
25脚本之家 00:19查看AI文稿AI文稿
有用的小常识通过蚂蚁森林能量球显示克数,你就可以知道你男朋友在干什么。 180 克能量球是买两张电影票, 136 克是买了火车票, 80 克是坐了公交车, 52 克是坐了地铁, 5 克是买了东西, 16 克是点了外卖。嘿嘿,这个很有用。
208脚本之家 03:44查看AI文稿AI文稿
今日 ai 教程大爆款女装带货视频,本期视频让零基础的朋友们也能够轻松上手,整个流程分四步,分别是如何生成模特,如何提取服饰, 如何搭配场景和如何制作视频脚本。今天就给大家讲的清清楚楚,明明白白。首先我们要搞定模特, 在灵感里面搜索女生,里面会出现很多已经生成好的模特图,在里面找到 ai 感没有那么强的图片, 点击做同款。这里需要注意的是,我们在生成的时候看一看,不要选择图片三点零以下的模型去生成它已经下架了,三点零以下的模型生成不出来以前那种感觉的图片了,这一个是四点零的,没有问题,我们直接点击做同款, 然后上传生成,重复这样的操作去生成三组。得到这三组图片以后,分别选择一张正脸朝着镜头的图片, 点击智能超清,再把这三张图片添加到参考里面,输入这段提示词,就能融合三个人的脸部细节, 生成一个全新的人物形象模型。选择四点一,比例选择九比十六,清晰度选择四 k, 点击生成。生成好了以后,选择一个中意的,点击智能超清,我们就得到了这种细节,拉满没有 ai 位且不会设计 人物脸部侵权的原创模特提示词。打包好了,六六六自取模特解决了,我们来提取服饰,提前准备好我们选好的服饰,截图下来。同样的,我们还是用图片生存模式上传这张参考图,输入这段提示词,提取出图片中人物所穿的服饰。 实物平面图,纯白色背景生存在一张图片上,只需要不是模型,就选择五点零,同样的九比十六四 k, 再点击发送,生成好了以后,选择一个中意的,点击智能超清。 第三步,场景,我们把爆款的视频截图保存一张,找到我们这款反推提示词的智能体,添加参考图并输入,只需要背景提示词发送,就能得到我们这种背景的中文 ai 绘画提示词,粘贴我们这段提示词,模型选择五点零, 点击生成,这样我们一次就搞定了模特服饰和场景的。最后我们来解决视频的提示词,来到这里粘贴,点击右边的开始反推,这里也可以上传,视频也可以上传, 根据我们自己的需求来,视频已经拆解好了,并且我们获得了这种镜头拆解的分镜提示词,包括零到二秒,二到四秒,四到六秒,六到八秒,都做了些什么事情, 我们只需要复制下来这段提示词。我们再回到切换到视频生成模式,模型选择 c 胆十二点零, vip 全能参考,比例选择九比十六,清晰度可以根据自己的要求来修改,七百二十 p 或者幺零八零 p, 时常根据我们刚才获得的那段提示词来选择,我们刚才是八秒,我们选择八秒,然后粘贴提示词,依次上传场景 不是人物,在后面再添加入人物参考图三,不是参考图二,场景参考图一直接点击发送,成篇就已经制作完成了,我们来看一下效果。
4.2万零一讲AI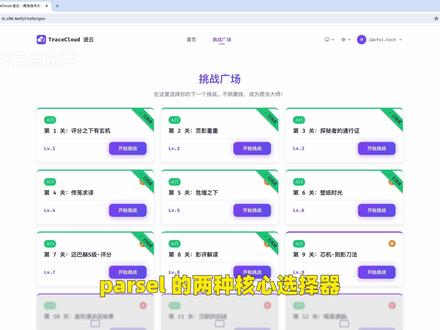 08:39查看AI文稿AI文稿
rcl 的 两种核心选择器, css 和叉 pass 我 们就讲完了,不管你用哪一种,目标都一样,就是把你想要的数据稳定准确的拿出来。除了这两种方式,用正则也可以做到,只是正则一般不作为首选,用来直接解析 html, 因为 html 本身是结构化数据,用 css 或叉 pass 去拉结构,更简单也更稳定。正则更适合拿到存文本后做阶梯提取手机号、邮箱订单号这种模式数据,以及处理脚本中的数据等等。 其实 parse 这个库就支持正则,主要就两个方法,文档里我都写好了 r e 和 r e first, r e 返回所有匹配结果, r e first 只拿第一个值。 还有就是如果正则里有捕获组,也就是括号。二是要返回的就是括号里的内容。正则的语法基础课讲过,这里就不再讲语法了,如果你不清楚的话,可以回看拍摄基础片。 ok, 现在我们打开第九关,这一关是特意为正则练习设计的。可以看到这个页面上主要有两块内容,上面是渠道行情快照,下面全都是评测数据。当然数据还是在元代码里,所以第一步我们先把元代码拿到, 导入 requests url headers, 接着写一个基础请求函数 get html。 这个函数只做一件事, 就是接收 url, 获取 demo 源代码。这节课我们主要练习正则,就不做多余的处理了,直接返回源代码,再写一个 may 函数,调用 get html 传 url, 它会返回网站的 html, 把它打印一下。 ok, 现在我们导入 selector, 创建 selector 对 象,这个 text 就是 它的第一个参数,这样传可以直接传也行。然后我们先拿到每一个评测卡片来,搜一下这个标题,可以看到每一条评测就是一个 article card, 页面上有十个卡片没问题,来把它拿到, 刚好十条。这里要注意一个问题,我们的靶场 url 不是 固定的,每天都会变化,你练习的时候从主站进入靶场就会生成新的 url。 所以 这里我们判断一下,如果 cards 没有数据,就打印一个。未找到平车卡片,请检查选择器或 url, 然后 return。 为了练习过程中打印内容更清楚,我们只拿第一个卡片来练习。然后我准备了一些练习场景。先来看场景,一,标题提取可以单独写一个函数来做,就叫 s e title。 传第一个卡片来,把它写一下,传 card 进来,标题的内名是 article title, 选中它, 获取它的文本。这里我们只提取书名号里面的内容。正则就很方便,直接用文本节点点一个 r e, 是 不是感觉 parse 很 方便?任何节点,任何 selector 对 象都可以直接用 css 叉 pass。 正则, 我们要提取书名号里的内容,就直接写书名号点加问正则表达是 ps 基础篇讲过的,这里就不解释了。直接把结果返回出去来跑一下 标题就拿到了。 r e 默认会返回一个列表,因为它会把所有匹配都收集起来,但我们这个卡片里标题就一个,所以更适合用 r e first, 直接拿第一个结果就不用再切片了。 如果不想要书名号,就可以像这样加一个捕获组, r c l 会直接把括号里的内容返回出来。当然你可以偷懒不取 text 也能跑, 甚至直接对整个卡片节点做正则匹配也能跑通。这是因为我们这个页面比较简单,如果页面复杂一点,就会有很多物匹配,所以最好还是定位到具体的节点再来用正则匹配范围越小,正则越简单,也越不容易翻车,我这里还是把它写全。再来看场景。二,数字提取 函数就叫 s r number。 这次我们要提取首发价、海外参考价、到手价以及阅读次数、评论次数、点赞次数以及评分。首发价的类名是 press c n。 先把它拿到 获取文本节点,这里面文字和数字混在一起的,而且数字里面还有逗号,我们要用正则把数字提取出来,点 r, e, first, 数字和逗号出现一次或多次。 接着是小数点,数字出现一次或多次,整个小数部分出现零次或一次。这样写其实有点问题,我们先来跑一下,返回一个字典出去 有两个问题。首先是语法警告,他说这个杠 d 是 无效的转移,因为反斜杠在 python 字幕串里有转移的作用,所以我们要在前面加一个 r, 防止转移。其次是这里的价格只拿到了小数点后的部分,因为正则里面的括号表示补货主,而 parcel 默认返回补货主内容,要把它改成非补货主 才能拿到完整价格。但它现在是字母串,而且还有逗号,那我们再写一个工具函数,叫图 number, 给我一个 text, 我 给你转成 float。 当然要去掉逗号,再转捕获一下 window arrow, 还有 html, 因为有可能 text 是 浪或者其他没有 replace 方法的对象, 就打印一下,转换失败返回浪,等你拿到价格之后,就用它转成 float, 然后是海外参考价,逻辑是一样的, 以及到手价, 这三个正则一样的,就没必要写三遍了,来单独写成一个变量 pattern。 再来看阅读评论和点赞,它们也可能有多好,只不过没有小数。但我们这个正则,小数部分本来就是可选的,出现零次或一次,所以没有小数也能匹配,直接赋用就行。当然如果你想严谨一点, 可以单独写一个,我就直接用了。逻辑都是一样的,直接复制这个叫 beuse, 还有 comments next, ok。 最后是评分,这叫 scorebeat, 它没有逗号,但这里有杠 d, 是 可以匹配的,我也直接附用了, 来跑一下就全都拿到了。再来看长颈山作者与联系方式提取函数,就叫 s 三 archer, 要从这个 archer info 里拿到它里面的文本,人本在紫元素 span 里面,所以要用后台选择器空格来读取文本,当然你选择第一个 span 也行。接着用正则来提取作者名字, 我们要的是它,那就把它括起来,典型问联系方式,不需要空格结尾就行了。把结果复制给 name, 再来一个 phone, 需要联系方式这一段。 最后把 name 和 phone 打包成字典返回。 接着来看场景四链接路径里的 id 提取,也就是这三个 a 元素对应的资源 id, 比如这里的幺零零零幺 ip 幺二八这一段。 e g r e v 幺零零零幺。对正则熟悉的话都很简单,我们快速写一下函数,就叫 s 四 ids, 可以 直接 return 字典。先来来 article id, 选中 article link, add a ref 属性,接着用正则来提取 id, 给它括起来,用杠 d 加匹配参数就不要了,如果有参数,这里就是问结束,没有参数的话就直接拖那儿数字结束改成非补货处。再来一个 product id, 这里就不是数字了,有字母和减号,那我们用杠 w 匹配字母数字,再来一个减号, 然后是 rebuke id, 也是字母数字和减号,正则不用改, 来跑一下三个 id 就 都拿到了。还有个警告,这里少了一个 r。
36小飞有点东西 00:24查看AI文稿AI文稿
你知道怎么检查微信好友有没有把你删除吗?使用这个工具就可以批量检查。打开软件,它有一个无障碍权限,需要赋予,点一下,这里会自动跳转到无障碍服务, 点一下已安装的服务,找道理跳跳真实好友这一项,点开以后把这个开关戳一下,再点一下确定即可,现在可以点开始检测了。
20脚本之家


