gpt-4彩票高级数据分析功能原理
今天的话跟大家在论文,这个论文的话是阿里达摩院公开的,他他们研究了一下,就是类似的 gpt 四,就是 lm 的这种大模型,能否帮助人们做一些高级的数据分析,他主要是做这样一件事的。我们就今天这个话题跟大家一起来聊一聊。 呃,先说一下结论,达摩院他们的研究结果来看,就是用 g p d 四,或者用 l l m 的这种大模型,帮助人们做一些高级的数据分析,这个是可行的。 他的准确度,目前用 g p 四测下来,他的准确度基本上能够达到高级的数据分析师的这个能力,准准确度是差不多的,大概在百分之八十左右,人类最高的话呢,也是大概在百分之八十左右,他是这样的。但是呢,就是他的那个成本, 用 g p d 四的做高级数据分析的成本,他可能不到这个高级分析师的百分之一。所以这个就挺震撼的。这篇论文还是蛮震撼的,我也把 这个论文也拿出来,大家可以我们来解读一下这篇论文的名称的话呢,它是它主要是阿里的研究院和大学,新加坡的南阳技术大学共同研发的这样的一个项目。我们来看一下他们是怎么做的。是的,他用 gpd 是怎么样做那个高级数据分析的,他也在这个论文里面的一个框架, 他这个框架的话呢,有两部分组成的一部分呢,是必选的输入,因为你要做高级数据分析,他主要是在数据库里面做一些数据分析,要有问题,那么这个数据库他一般有一个叫表结构,叫 c 个码,这个就是你这个数据库结构的一个,这个表的一个结构,还有一些裸数据,他呢就就是把问题和 c 个码这个东西通过 gpd 四 这个模型产生拍成的代码啊,产生拍成的这种代码,当然拍成代码里面也有这个 c 库的这样的一个语句后,再结合这种后产生数据的表格和数据的图表啊,他是这一部分,当然他也 讲的另外一部分,我觉得也是讲的非常好。是他也会用一些外部的一些知识库啊,他把外部的这个知识库跟这个数据结合后,他这些数据可以在线的一些通过一些外部。第四里面后,通过他的这个数据 分析的得到的这个数据的结果后进行分析,他等于是这样,那么他就会把数据图表和外部的这个知识库进来一起来分析后,能 达到这个高级分析师分析这些问题的这样的一个准确度好。呃,这个是他整体的一个框架,那我们看目前他整个一个项目,我看他在 gitch up 上面也也已经也公开了这样一个项目,但这个项目里面目前代码是空的, 那我估计他不久之后呢,他这个代码会发布出来啊,这部分代码我觉得还是非常有价值的。之前因为我给大家演示过怎么 lm 的大模型怎么跟外部的这个知识库结合去推理一些东西,那么现在呢,他又增加了怎么跟数据库里面的这个 结构化的数据啊,再加上外部的这个知识库结合起来,怎么去解决一些复杂的一些数据分析的问题。所以他的这第四就是 lm 的这种大模型啊,他这个应用就是越来越广泛了啊,他可以替代很多人的这样的一些工作啊。我们看一下他的这个实验的结果啊,这个当中的论文,我们就不去讲他这个,这个是他的算法啊,他这个算法他是怎么来做出来的?他呢主要是先产生 c 口, 通过这个问题产生 c 口和拍摄的代码,然后执行这些代码之后,然后产生数据和图表后再根据 online 的这个 information, 就是外部的数据库,结合后,再跟图表和数据结合后,去分析 相关的一些问题。他也给了一个例子啊,我们可以看一下。他也给了个例子,我们看看他的那个实验结果啊,实验结果,他的那个准确度啊,图表的准确度达到百分之七十八,数据分析的准确度达到百分之九十,次度他都是平均的啊,他随机抽了一百个问题,他等于是这样。当然他也呢,他把人是一 一般的,普通的这种分析员和高级的分析员都做了对比。高级分析员的准确呢,大概是在百分之八十。呃,那么 gdp 四也差不多能达到百分之八十。 junior 的就是初级的分析上,他的准确度在百分之七十二,那么 gdp 四的准确度达到百分之七十八啊,他会更高一些。他等于是这样。 所以它它这个就 gps 目前结合阿里开源的这样的一个方法论的一个框架,它已经能够超过普通的这种数据分析师的这种能力, 基本上接近和达到这个高级数据分析师的这种能力,他是这样的一个结论,那他最好,他给了一个图,是他每一次的这个问题,他大概要花多少钱啊?他当然是用的是 美国的数据分析师的这个平均工资啊,这个用的是美金。他看一下初级的这种,呃,分析师啊,他每问一个问题,大概是要六点三八美金,那么高级分析师的话呢,是十点二二美金,但是如果用 gdp 四的话呢,他只有零点零五美金, 所以的话,一个是相差十一倍,一个是相差七倍。所以他的这个最后的这个结论,他的性啊,就是他他的那个分析的准确度,跟高级分析师和初级分析师都比较接近的,他的费用只有他原来的可能不到百分之一。他等于是这样。所以他就讲了这样的一个论文。这个论文发布出来,我看到 在其他的老外的一些吹的上,也基本上是炸雷了,他等于是基本上是炸。有很多人。这个是他的一个例子,他这个讲了一个 question, 他分析完之后给一个图表,他再有一些分析的结论,他就这这个就很厉害,基本上跟数我们人类的那个数据分析师已经没有任何差异。好,所以如果大家有兴趣,大家这篇 文章也可以,论文也可以详细的去,还是有很多歧视的它这个东西,所以的话呢,那个 g p d 四,它像一个大脑一样,围绕着这个 g p d 四,或者 l l m 的这个大模型,它的这个应用会越来越广泛,在围绕着这个周围,别人会, 企业只会围绕他这个东西,会做很多的这方面的应用,各种各样的插件,所以的话他的能力会越来越强。好吧好。我就这篇文章我就跟大家就聊到。
粉丝4.6万获赞35.6万
相关视频
 02:19查看AI文稿AI文稿
gpt 四在分析体彩、福彩网页数据中的应用,更精准的彩票号码预测在数字时代的今天,技术的飞速发展为各行各业带来了新的可能性。其中,人工智能 ai 的进步为彩票领域带来了一些令人惊叹的变革。最新一代的 ai 模型 如 gpt 四已经开始在分析体彩、福彩网页数据方面展现出惊人的能力,帮助彩票爱好者更精准的预测号码。一、 gpt 四简介 gpt 四是基于自然语言处理的人工智能模型,具备更高级的语义理解和上下文分析能力。他能够理解更复杂的问题, 产生更准确、连贯的回答,甚至可以进行推理和创造性的文字创作。二、分析体彩、福彩网页数据彩票号码的抽取是基于特定的算法和概率, 然而过去的开奖结果往往被认为是未来结果的一种参考。 gpt 四可以被用来分析体彩、福彩网页上的历史开奖数据,从中寻找模式和规律。它能够识别数字的频率、数字之间的关系以及其他相关信息, 从而提供更准确的预测。三、更精准的预测号码通过对历史数据的深入分析, gpt 四可以识别出可能的趋势和模式,帮助彩票爱好者更好的预测号码。 然而,需要注意的是,彩票本质上是随机的,过去的数据并不能百分之百的预测未来的结果。 gpt 四提供的预测只是一种参考,而不是绝对的预测。四、想要尝试吗? 如果你是一名彩票爱好者,你可以考虑利用 g、 p、 t。 的四大能力来分析历史开奖数据,你可以找到相关的体彩、福彩网 网页,将数据输入 gpt 四,然后观察他是否能够找到一些有趣的模式或趋势。但请务必记住,彩票始终是一种娱乐活动,不要过于依赖预测结果而忽视了随机性物。总结, gpt 四的出现为彩票领域带来了新的可能性。 通过分析体彩、福彩网页数据,他能够帮助彩票爱好者更精准的预测号码。然而,预测结果仍然需要以谨慎的态度对待。彩票的本质是随机的,过去的数据并不能完全决定未来的结果。 在尝试使用 gpt 四进行预测时,保持理性思考,将彩票视为一种娱乐,而不是投资。
 05:31查看AI文稿AI文稿
兄弟们,用最强 ai tfgbt 四点零帮咱们预测双色球,我买了一百座号码,咱们看看能不能中大奖啊。 网上不是出了一个 chet gpt 吗?那个东西呢?不是说号称是现在目前最强大的 ai 机器人吗?它总共是有两个版本,一个是 gpt 三点五,还有 gpt 四,然后三点五的话呢,是二零二一年的数据, gbt 四的话呢,就是现在最新的数据啊,所以今天这个视频呢,我是这样想的啊,之前我们用这个彩票机去分析那个彩票的号码,其实大家都知道这个肯定是智商税啊,因为他是根本就不联网的, 说是说是实时分析,但是实际上一点用都没有啊,所以今天要视频呢,咱们就用上这个目前最强大的人工 ai chet gpt 四,我们来分析一波这个双色球的号码啊,让他给我们分析出几组号码,我们看一下买完之后呢,会不会中大奖啊?这个网站呢,我已经打开了啊,总共你看啊,这里上面有两个选项,一个是三 点五,还有一个是 gbt 四啊, gbt 四是要给钱的,总共是一百多块钱吧,为了搞到这个东西啊,我是已经提前买好了啊,总共花了我一百多块钱,而且只是一个月的啊,能中大奖的话,这一百多块钱那也无所谓了,对吧?那同样我们打开这个双色球的分析啊,选到最近一百期,这就是往期从二零二二年十 一月份开始,一直到前几天开的啊,然后咱们直接就复制下来啊,直接输上去啊,输上去以后就跟他说一下啊,让他帮我分析 一下,一定要给他说规则啊,就是前面六位是一到三十三,然后最后一位是一到十六啊,因为前面六位的话呢,是红球嘛,一到三十三,然后最后一位是蓝球一到十六号。然后给他说一下啊,分析一下。 他现在已经说出来了啊,就是想让我们知道规律啊,我们就直接给他回一个分析一百组号码出 线频率啊,让他分析一下怎么给我打了一个代码是什么意思啊?那直接让他跟我们推荐十组好吧,直接告诉我结果 ok 啊,你看他现在直接就分析出来了啊,十二号,二十四号,二十六号,三十三号,六号。哎,他怎么分析的全是二八十二二十四,这就相当于是十组,但是只是说篮球改变了啊, 给他复制下来吧。我感觉他分析的全部都是二八十二号啊,那今天这个号码一定得买啊,兄弟们。就买前面这个,后面那个篮球不买的话,如果中六加零的话,那也是大奖,对吧?没事啊,就直接再复制一下,让他再给我们分析一下,然后我跟他说了啊,就是 让他帮忙把范围扩大一点,跟我生成十组啊,这里已经生成出来了呃,就是这十组啊,那直接给他复制下来,然后就再生成十组吧。这现在已经有二十组了啊,多来几组啊,这样会多一些概率。现在又生成十组了啊,总共是四十组号码,我感觉有点少啊,兄弟们。 所以我又立马找这个 ai 啊,让他帮忙又打了六十组出来啊,同样是根据中奖规律生成的六十组号码啊,这里我已经打上去了啊。好,我已经打印出来了啊, 咱们直接走着,上次我们去的那个地方就是那个卖彩票的老板娘啊,他已经关门了,因为他去日本了,女儿怀孕了在日本,所以我们只能另外再找一个别的地方,就是有点可惜啊,就再也见不到那个老板娘了。好,又找到一家啊,咱们就在这里买啊, 打票子这几个是要打高倍数的啊,打五倍,打五倍打五倍,还有七还有八,哎呦九,你全部按去丢打嘛。他这个篮球还分析到二十七号去了,然后我就给他改成十六号了啊,我感觉这五十块钱肯定是亏了。兄弟们 好, 我们一路上走过来的时候呢,就已经开始想着把钱怎么分了是吧,你拿三层我拿七层啊,就这样好吧,一人三层,剩下的四层就拿来交税,交完税以后呢就送粉丝可以吧,你中了钱粉丝肯定看不到这就是。哈哈哈,不可能,我一定会让你们看到,你放心中了,我 没有不发这些视频,我天打雷劈,我以我的人格启示,我要监,我会监督他。嗯好,我多分你一点。哈哈哈哈好,多分你一点。不行,我就是这么能出卖自己的理由。 好,可以可以可以,说到做到啊。来来来,对讲时间到啊兄弟们。昨天的号码是三号,十五号,十八号,四号二十二号十九号,篮球是九号啊,气了。别,别急别急, 没有五百万五千块是可以的,我们买了两个五倍的 ai 打出来的没有一个九号的啊,全是二号八号你知道吧,十五号,二十四号三十三号, 一个都没有,一个都没中,还还分析还监督,哎呀,我们还打了五倍啊,兄弟们,五十块钱一号码,十块钱一个号码都没有就没奖啊,中了一个篮球是五块啊,我们这里有七张五七三十五,但是五块 牛逼,花了二百八还牛逼,你个鬼,其他的我就不看了啊,直接明天去兑,万一可能会有个惊喜,对吧?来第二天啊,兑奖啊,兄弟们。那句话说的好啊,男人过了二十岁就不要再穿的像个小孩子一样, 十块喂,三十五就总共三十五啊, 一张都没算错啊,就中了七个篮球三十五块啊,还监督不?我这是偷偷来这兑奖,我的个鬼,以后千万别信这玩意啊。这个还不如我们直接买那黑科技,买两百还能中一百,这玩意二百八中三十五,哈哈哈,别信啊兄弟们。
1.3万馋大鑫 00:38查看AI文稿AI文稿
朋友们用 gbd 四来做数据分析到底有多高效?我们来看一下。我们先把 excel 表格传给 changp, 不要告诉他分析需求,接下来就是 chagp 见证奇迹的时刻开展。整体看下来呢, gbd 四在敏捷数据分析这一块还是非常强的,从我把数据发给他,到他完成数据的分析,到 输出分析报告,整个过程也只用了十分钟。这个如果换成我们人来做的话,可能需要至少一上午的时间,甚至一整天的时间。 ai 时代已经到来,我们不要成为那个追车的人,我们要成为那个会开车的人。关注我,咱们一起学会开车。
159橙子聊AI 02:18查看AI文稿AI文稿
这篇内容如此详细的揭秘了 jubile for 的内幕和数据,这还真是令人叹为观止。相比国内很多解读 jubi four 的内容啊,我觉得这篇可靠性思路更高一点。之前有这个天才黑客 josh horse 在采访中谈到了 jubi force 由八个这个 jubile 三点五的专家模型组成的 系统,那每个专家模型的参数大概是两千两百亿左右,但是这个消息并未被欧本亚官方验证,但是呢,部分的业界人士啊,认为是合理的。那今天分享的内容了,来自于这个 deep trading 的创始人发布了条推特, 他整理的这个在 semi analysis 的这个一篇付费的订阅内容,所谓的揭秘去不去否?请注意啊,这些内容看上去合理,但也并未获得官方的确认,仅供大家参考。那我来选择一些我认为有趣的地方来进行一下解读。 第一呢,是 jubile four 的这个参数量,大约是 jubile three 的这个十倍,也就是一点八万亿个参数啊。第二呢,是 jubile four 确实是使用了这个 m o e 模型,也就是由十六个专家模型组成,每个专家呢,大约有一千一百多 一个这个参数,其中呢两个被路由到每一个向前的这个传递。前面这两点呢,和天才少年谈的基本类似。第三呢,是大家关心的成本问题。 gbt for 在两万五千块 aa 一百这个 gpu 上使用了大概二点一五乘以十的二十五次方的这个浮点运算啊,大约持续了九十到一百天。一块 a 一百的 gpu 的成本啊,大约是每小时大概一美金左右, 算下来的话,你可以理解为这种级别的训练一次性大约要消耗掉六千多万美金。所以很多国内的创业公司说自己要搞大模型,要去超越这个 gbt four, 我觉得应该要掂量一下自己的钱包。四呢是 ppt four 的这个效果那么好,为什么不在这个 m o e 模型上面多增加一些专家,使得他变得更加强大呢?里面也做了一些解释 啊。推理过程中的处理 m o e 啊,非常困难,因为并非模型的每一个部分都在 token 的生产中被利用,这意味着部分情况下其他的这个部分处于闲置状态,会严重影响到资源的利用率。 open i 保守的选择十六位专家模型的原 大致也因为此,在许多任务中,更多的专项模型啊很难被泛化或者被收敛,造成了资源的浪费。里面大量提及到内容,涉及到数据级并行策略、视觉多模态,对,这是解码,推理结构等等等等。那感兴趣的朋友呢,可以自己去搜索去了解一下 目前的地步缺点的。这个创始人的这个推条啊,因为版权问题,已经删除了这条内容,大家可以去这里面看这个原版的信息,我这篇内容的话是需要订阅付费的,国内我也看到有些媒体已经把这个原文扒了下来,这我就不做推荐,大家自行搜索了吧。 次详细的信息给出来,我认为可能会给大量的国内的一些做大模型的大厂带去一些参考的价值,希望国内的大模型加加油。好了,今天就分享到这里,我们下期再见,拜。
477让包神先走 00:25查看AI文稿AI文稿
下 gpd 开放 code interpret 模式之后,我们普通人做数据分析简单到什么程度呢?以我在某视频平台上的数据为例,在这里导入 code interpret 之后,只需要简单的和他说,帮我按时间做一个直线图出来,然后就正常好了,什么都不用管,你甚至可以直接问他这个数据包能够做哪些分析,适合做哪些图标展示。 那么为了帮助大家快速掌握新技能,我这边整理了一份用 code interpret 做数据分析和量化预测的 prom 合集,需要的进粉丝群。
2508AI卡森粒 05:40查看AI文稿AI文稿
号外号外, gpt 史上最强大的一个数据分析的插件叫做 code interpreter, 终于上线了,那这个呢,可以说是定量原则的福音,它可以帮我们计算各种各样的统计数据,帮我们出报表,跑回归, 然后呢也可以帮我们出特别强大的,包括网络分析的图谱啊等等,这些东西他都可以做以下的,我们一起来进入实操吧。怎么样能够启用 code interpreter 这个模式, 那他呢要在左下角点到我们这个账户这里,然后有个 settings, 就是设置在设置里边呢啊,有一个 better features 在这儿呢,我们能够看到 code interpreter 这个插件,或者这个模式关掉就没有了,打开之后呢啊就启动了,启动之后呢,我们可以点到新开一个窗口,然后点到 gp 四,在这儿呢,我们就可以 可以直接选择 code interpreter, 一旦选择之后呢,我们看到最大的区别是这地方有个小加号,我们点这个小加号呢,就可以上传你需要进行分析的统计数据的文档啊,这个时候呢,假设我们随便选一个,例如我们选这个 二零一五网民调查最终公刊版,大家建议最好把它改成点 csa 文件,这个时候咱们选择打开,我上传了一个中国民大学的一个教授做的二零一五年网民态度调查,里边大概有三千多个,这个干 就丢给他,他就会做一个整个的就是一个数据的概栏,网上做了几个事,一个呢是做一个交叉分析啊,因为 q 五和 q 三就这两个东西呢,都是一个类别变量,那我就让他看这两个变量之间是否有关系,我想看一下人们这个 党员还有非党员这样一个身份,对于转金食品态度上面没有差异。这个地方要去备注一下,要行使用中文进行结果的分析和解读,那因为有的时候他会给你说出英文, 我的中英文不是特别好,就直接告诉他,这个时候呢他就会开始说,哎,这个应该进行卡方检验,他自己能够判断这两个分类变量之间用什么样的检验方式,说怎么创新交叉表啊。最后呢给他一个结果, 但是这个图也很不错,就是他这个,他在这个中文的这种字体的形式上面有些问题。好,接下来呢,开始给砍半截案的结果,然后说批值大零点零五,就意味着我们不能拒绝原假设,也说这两个变量之间的没没不存在什么关系。好,我们第二个让他做一个描述的统计, 针对样本,因为从 q 十六这七个问题呢,其实是一个两表的七个问题,那我们就是要看一下整个的这个样本当 中呢,这些被调查者,他们对于不同的渠道的,尤其是媒体的信任程度,你看这边有央视啊,新华社呀,新浪啊、微信啊,小道消息啊,海外媒体等等。 那这时我也备注一下,我说可以让他把非常可靠和基本可靠给他看作是一个高信任度,那情形就不同,媒体信任度高低的分析,这个时候呢,他就会把这样一个表给打出来 啊。这个我用别的同学更新的软件比对了一下,他的数字没有问题,版本比都没有问题,但是结果就是他有些问题,你看结果的地方呢?他说新浪等新闻网站一半一半,一半选项比例最高。 w m 三、三十九点一七, 微信一半啊。他说在尤其是在这个地方高信任度方面,海外境外媒体是四十八点四五,新浪是三十七点五零,微博呢这个是三十八,新华人民日报呢是四十点零,得到的比例比较高。反而在这 这个分析当中呢,中央电视台呢是四十二点一三,明显中央电视台呢要高于这三个啊。所以我就说你的分析监管线有些问题,中央电视台的比例应该高于保护网络吧, 你一旦要质疑他,他就会重新进行计算。他说,对不起,我之前的解释有误,当我们考虑到这两个选项,如果别人是高信任度,是不同渠道的高信任度比例,他给你做了一个降区的排列,我们可以看到这个时候呢,海外境外媒体包括央视以及新华社官方媒体,这几个呢是最高的啊。所以呢, 最后他感谢我指出这个错误,好,再来给我们做一个因子的分析,我们知道这是一个量表,我们可以让他来做因子,让他提取光因子。好,就跟他说,请针对这个变量做因子分析,提取光因子,并给出你合适的图和表。我就把整个的题项以及下边的选项呢给他,要告诉他很详细。 他说这个时候呢,而且你要我要先告诉他,要先进行这个巴特勒球形检验,因为这个是我们做因子分析的一个前提条件,他就先做这个球形检验, 就说皮值小,零点零五,我们可以继续原件设,但其实他的结果不太全,因为我们知道应该还有一个结果,你要看他具体的那个值有多大的问题,因为我们说值越大啊,他其实更加适合来做这个球形体验,他反正通过了这样做, 这个时候呢,他就开始来做因子分析,但他说呢,我要这个通过这个,这就是碎石图吗?他叫剪映图来确定因子的问题,说选择三个因子,这个时候提取三个因子, 使用这英子旋转的方式,当然他说他没有这个库,他用了这个另外一个主成分分析法,这也是英子分析常见一种方法,保留三个成分,于是于是就到了这一步,他就说每一个组成的部分呢,代表一个芹菜的因素为 度。但事实上呢,我们可以看到他的分析还是有些问题啊,因为我用 ct 专门跑了一下,其实这两个就是第一个因子当中的这个特征,特征值应该是高于一的,所以他跑的还是有些问题。所以大家呢,目前也不能完全信任 code interpreter, 他只能作为我们的一个基本的辅助,我们可以用 其他的统计分析软件来帮他进行校准。好,当然我们做了因子之后呢,我们也可以把,例如我们可以填填这两个因子,对吧? 这两个因子呢,一个其实是对于官方媒体的信任度,一个是对于非官方媒体信任度,我们可以把这两个东西再纳入到后续的回归分析当中去。好,这个大家可以自行来探索。我是一天哥,关注我,更多学术干货带给你。
472一平博士讲论文 04:14查看AI文稿AI文稿
open ai 又更新了啊,第一个更新的话呢,它是放开了这个 a p i 接口啊,就是任何人都可以啊,你只要是啊付费用户都可以申请 a p i, 所谓的 a p i 的话呢,就是可以把这个 charge p t 四呢,就是啊,植入到你的个人程序里头,比如说你这个像 呃,微信里边可以植入成这个叉 cpt 四啊,系统,这是第一个第一个更新啊,第二更新的话呢,非常厉害啊,第二更新呢是在这, 呃,它是这个,这个叫它一共三种这个模式啊,叉 h b d 四啊, 那么你付费了以后的话呢,你可以选择插件啊,这个插件啊,这 default 就是默认的这种情况,他还有第二种情况就是 code interpreter 啊,这个东西,那么这个 code interpreter 是怎么样子来的 呢?在 setting 里边啊,这过来以后呢,这个 bate 板啊,这样打开就可以了啊,这有很多的这种插件啊,第一个插件,第二打开这个 colint preder 呢,翻译过来呢 啊,是代码解释器模式啊,他这个模式呢,实际上就是多模态,有点多模态的这种,也就是说你可以进行数据分析啊,图像啊处理以及这个编代码啊,原代码都可以,没问题。我来看一看啊,他到底是怎么弄的 啊?我都已经测试完了啊,这都是我测试的情况啊,比如说这个第一个,我让他来分析一个论文啊,就是论文的话呢,我就是用华为的这篇论文啊,就是用三 d 模型, 然后进行这个这个天气预报的情况啊,这个这个论文呢,很长啊,这个一共大概二十多页,看起来比较累啊,那么呢,这样的话,我就 直接上传到这个系统里头,上传到拆 gp 四的系统里头,他这有个加号,然后你可以上传你的想要上传的文件啊,那我们就把这个 pdf 文件呢,整个这个论文的 pdf 文件呢,就上传了,上传了以后呢,他就可以开始 进行分析啊,这是费士西的程序啊,他是一段一段来分析的,一一个一个问题来分析啊,他得运行一段时间啊,就是后来呢得出来结论啊,你看这个后面结论就出来了, 然后呢你就可以根据说这个简简单的介绍啊,就这这篇论文大概是什么样的一个情况, 所以呢,他又还我还让他翻译成中文啊,啊,这是很不错的一个结果啊,就可以看帮着你看论文啊,帮着你分析这些东西啊。目前为止呢,让他我还是让他来改这个图片啊, 也可以上传 p 这个这个图片啊, gpg 的图片,但是他没有改成功啊,他,是啊,分析分析图片没有分析成功啊,改图片是可以的啊,我们看一下后面的啊,后面的话呢,我又让他分析了一个 这个世界五百强的一个啊,这种表啊,就是 excel 表啊,就是这这种表格啊,就很多很多信息的这种表格。那么这种是 excel 表的话呢,这种数据分析是很累的一件事啊,所以我让他做成可视化的这种图表啊,他也可以做出来,没问题。 然后这个呢是特斯拉的股票的情况啊,股票的话他分析的蛮好的呃,给他特斯拉所有的历史数据,然后他就可以分析出来,然后最厉害的另外一点呢,就是他可以另存啊,就是你比如说你分析完做做报表,你要放到自己的文件里头,你可以诱存啊,变成一个 文件这个这个图片的情况,然后把它存存存下来啊,还有还有分析的话呢,比如说你看这个图片,我想把它处理成这个黑白颜色啊,这是我上载了一张彩色图片,然后让他处理黑白的,他可以然后缩小放大呀,包括这种 各种的这种图片处理的,都可以让他来做啊,都都没问题的,所以他现在就变成一种多模态的一种形式啊,多模态形式,比如这是比特币的比特币的数据啊,我让他裂开若干个这种图表来表示这个比特币的情况, 然后分析大于十种啊,他就列出来了,你看这个各种价格的分析啊,这个量化交易就总体来说呢,还是非常不错的啊,包括编程这部分没有测试啊,他有编程的话也可以啊, 就是说来分析这个你上传的这个代码对不对?怎么来修改什么之类的啊?都可以,所以有空的话大家可以试一试啊,这个叉勾屁更新还是蛮厉害的啊。
305舟自横 00:27查看AI文稿AI文稿
拆的 gpd 最强大的插件大码解释器昨日终于公开上线了,它可以为你进行数据分析,并生成这样这样甚至这样的三 d 交互数据图,它还可以根据数据为你生成这样的一段视频,甚至自动编程生成一个网站。 你只需要打开设置,开启代码解释器,就相当于拥有了一个免费的程序员为你打工,大家也去试试吧!
2860Luna的AIGC频道 02:21查看AI文稿AI文稿
如果说我突然赚了波快钱,我应该怎么样去守住这笔横财?嗯?有没有什么好的方法或者建议给到我? 如果有一天你突然有钱了,说实话,请一定要牢记这九件事情, 一定要牢记。第一个,不要告诉任何人,包括你的父母。我这么跟你说吧,根据大数据统计,天生烦恼的人赚钱的概率比不烦恼的多得多。第二个,先把欠朋友的银行的 网贷都坏到,这个就不用我说了吧。第三个,这些钱已经到你卡里了,不要转出来,先放半年,可以用一小部分,但是大头的先留起来,先去把吃喝玩乐体验一遍,但千万别碰自己认知以外 的大头子。这个你一定要记住。第四个,千万不要,千万不要马上买房子,或者去高档的小区租房子,很多人在这里都会踩坑,你相信我。第五个, 先不要着急辞掉你的工作,不然你的父母着急,而且看你好像没事一样,他们会担心你受了什么刺激,是这个道理吧?第六个,先不要买车和奢侈品, 可以花钱,学点理财的基础认知。第七个,尽量少和朋友、亲戚、同学合伙做生意,这个你相信我,这是不管你有钱没钱都要注意的点。第八个,如果你有孩子, 一定要想尽一切办法,不让孩子知道你很有钱,因为童言无忌,你能理解吗? 保持现状,当一切没发生过,你只需要牢记这九点,坚持二个月,相信我,你的心态和生活绝对会发生翻天覆地的改变,你觉得呢? 呃,那如果说我现在已经花了百分之七十了,已经花了七成了,我现在有点后悔了。呃,怎么办?有没有什么应急的方法能够给到我? 好的,这个说实话,你成功的花光了你的所有运气。那你把剩下的三成都花了吧,只有这样才能让你痛彻心扉,等你下次发横财,才能让你如梦初醒,手足钱财。
3340勋红雷 00:33查看AI文稿AI文稿
看,我用 gpt 是完美预测了比特币的价格走势,前两天 gpt 斯发布了代码解释器的功能,作为当今世界上最先进的 ai 工程,那我必须给他出最难的题,让他预测比特币的价格走势,来看看他是怎么做到的。第一步,我先为了他一份数据,从二零一五年一月份到二零二三年七月份整个比特币的历史交易数据。 第二步,我让他从这些数据里面抽取最有价值的十条关键信息给我,用图表来呈现。第三步,基于现有数据做分期与统计,预测未来一周比特币的价格走势。过了两天看大盘数据跟预测图走势一模一样。对此,小伙伴们你怎么看?
3926钱叔A.I.视界 01:15查看AI文稿AI文稿
家人们谁懂啊! gpt 已经进化到可以直接上传全格式文件,刚刚是 txt 格式,现在试试 ppt 文件,不仅能读取,还能总结分析 ppt 内容,处理 pdf 文档也是轻轻松松。 bdf 转图片一键生成,再也不用开 w s 会原谅, 还会分析文章,生成词语, 分析表格数据更是不在话下,还能生成数据图标,以后再也不用自己做数据分析了。这还不止,还能剪视频、生成 二维码等多功能。点赞关注,下期给大家演示剪视频这么全能是因为我装了 code interpreter 插件。安装很简单, 登录插 gpt, 再点击左下角的 set, 点击贝塔,打开 code interpreter, 刷新你的 gpt, 选择四 a 就可以用了。这个插件真的很牛,快去试试吧!
626ChatAI人工智能 03:06查看AI文稿AI文稿
i want to show you how to use this prom to its full potential vita custom instructions with code interpreter and with chat gpd plugins in new chat and go to gpd4 and we are going to click code interpreter open ai just renamed cold interpreter to advanced data analysis if you are new to charge pt plus to enable advanced data analysis now and plugins you need to go to settings and beta under beta features toggle plugins and also toggle advanced data analysis and this is really where fun starts code interpreter allows you to work with files do start and once again professor greets us and for the goal i recently tested 432a writing tools and inside enormous database you can download it for free and i'm going to download this scsv file and you can do this with any type of data said any type of file that you like once you got your file you click upload and it also reads zip files i'm going to approach this in the most simple way so you can see what is the huge value of this i upload a zip file it's asking me should they go ahead and enzip it and i will say yes it is really like working with an assistant where instead of thinking what you should do you say yes or no or provide feedback it seems like it's red correctly it has 432 entries and 12 columns even though i do know how i would like to analyze this data i will ask it can you help me to think about waste analyze with data it lists me all the ways that i could be analyzing this data and even giving me examples for which columns what type of analysis would be the best just for fun i'm going to do data visilization it's now calling data visilization expert okay, so i wanted to visualize prices monthly, and i got this chart, but we can make it 3d and interactive so i asked to create downloadable link so i can interact with 3d visualization and this is what i got, but we can also ask to interact with different categories and also make it 3d so it created scatter plot diagram even though it might look a little bit messy, but you can see some trends appearing like general writing how price varies this kind of consistency increasing as compared to category like ads it can go from cheap to much more expensive, but it could be even more useful so i asked to create downloadable interactive 3d sketter plot, but make it that i can click and it tells me that name of a tool an actual real price and it is just that so now when i'm flying around for example with ads we can see that this pencil and its hundred nineteen as compared to let's say add copy, which is twenty nine dollars。
73产品进化论 01:59查看AI文稿AI文稿
众所周知, open ai 并不 open, 特别是在 g p t 四发布后,整个 open ai 团队对 g p t 四的几乎所有信息都守口如瓶。而就在今天上午,媒体 semi analysis、 the dillon patel 和 gerald wang 发表了一篇题为 g p t 四 architecture infrastructure training dataset costs vision mode 文章曝光了 g p t 四从模型、架构、模型训练到成本的所有细节。 g p t 四又被开源了。文章中详细介绍了 g p t 四的架构训练和推理的基础设施参数量、训练数据及 token 数、成本、混合专家模型 mixture of experts 某等非常具体的参数和信息。文章指出, g p t 四在一百二十层中总共包含了一点八万亿参数,而 g p t 三只有约一千七百五十亿个参数,也就是说, g p t 四的规模是 g p t 三的十倍 以上。 openney 通过使用混合专家 mixture of experts mo 模型来控制成本。这一批 t 四拥有十六个专家模型,每个 mlp 专家大约有一千一百一十亿个参数, 其中有两个专家模型被用于前项传播。 open ai 用于 g p t 四的算法其实非常简单,模型中还有约五百五十亿个参数被用作注意力机制的共享。每次的前项传播推理生成一个 token 中, g p t 四只需要使用大约两千八百亿参数和五六零 t f l o p s。 相比之下,纯密集模型每次前项传播需要大约一点八万亿个参数和约三千七百 club 的计算量。 openney 用十三万亿的 token 训出了 gpt 四。 openney 云计算的成本是差不多一美元每一百小时的话,那么在这样的条件下,仅这次训练的成本大约是六千三百万美元。 关于 gpt 四的模型架构训练、基础设施推理、基础设施参数数量、训练数据及组成、令排数量层数量、并行策略、多模态视觉编码器、不同工程权衡背后的思考过程实施的独特技术,以及他们如何减轻与庞大模型推理相关的一些最大瓶颈。
108ChatBot创新科技 01:58查看AI文稿AI文稿
太炸裂了,兄弟们,阿里达摩院最新的报告, gpt 四替代年薪六十万的数据分析师,只要几千块人民币啊!注意啊, gpt 四替代初级分析师的成本只有百分之零点七,你没看错,是百分之零点七,不是百分之七十一样,什么概念啊,我们可以看一下 啊,新加坡的行情啊。这里以高级分析师为例啊,他的年薪是六十三万,用 gbd 四可能只需要两千块人民币就搞定了,这绝对不是忽悠啊。这是阿里达摩院与新加坡南阳理工发表了一个权威的报告, 就问各位慌不慌。这里面 g b t 四的表现,他基本上能和一个六年工作经验的人类相当,也就是说, g b t 四出来就是一个六年工作经验的数据分析师,虽然说在复杂性和正确性上不如人类,但是他在整个的这个速度上面是非常非常快的,这也很好理解啊, g b t 四 背后的算力非常的强大,无论完成任何任务都比人类要快的多。这个表格你看展示了一下, gp 四完成一项任务的成本,可以看到是远远低于 人类的这个平均水平,无论是高级工具工程师还是初级工程师,那 gbt 四都能干一些什么呢?看过我之前视频的兄弟们啊,都应该知道啊, gbt 四的很多插件啊,都可以完成非常复杂的数据分析的能力啊。比如说,这里面列举着几项生成 circle 和 pison 的代码, 执行代码去生成一些数据和图表,这是 c b t 四最强大的功能,以及它可以从外部的这种数据源直接拉取数据,然后去分析 这第一个,你看他生成一个四扣的代码,然后去画一个图表。数据分析这一块之前我们的视频也演示过了,他基本上就是给他一段这数据,他可以去非常 丰富的去给你画一些图表出来,以及给出对应的这个分析的一个结果。兄弟们,看完这篇报告我久久不能平静, g b t 四进化的速度真的是太快了,我觉得 g b t 四不但会替代掉数据分析师,慢慢的会替代掉所有的职业。
1826AI深蓝 02:23查看AI文稿AI文稿
呃,这个视频我们来演示一下这个 gpd 四。呃。昨天推出的一个网页端的图片识别,呃。在这里。呃。这个图片识别的话在手机端的话在之前就推出了,但是这个网页端的话好像就是昨天才推出的一个这个图片的一个识别。 呃。图片识别的话,他并不是在这个增加数据这一个,呃。增加数据这一个他虽然可以上传图片然后进行识别,但是他是通过编写代码去识别一个图像的,识别的并不是很准确。呃。昨天增加的一个图片识别的话,我们要选择这个默认,默认的话,哈,这里有一个图片, 我们可以去打开一张图片来看一下。呃,比如我们去找一张图片,呃,比如这个吧,呃。我们去识别这里面有多少人,他头上戴的什么啊?这 类的也可以啊。我们来看一下,我们把这个图片拖到这里来,然后问他图片有多少人 的,是什么,我们进行发送。呃。他就识别出。呃。图片中有两个人头上戴的是这个皇冠, 但是他是没办法去识别这个人物是谁的,不管是谁都是没办法去识别他的头像的,他这个涉及到隐私的问题,所以他这个是被他拦截掉的。而我们再来看一下啊,随便点一个吧。而这个图像这下面有点花,但是我们问他这里是哪里吧? 啊?他这里没办法去识别,我们再去找一个图片啊,比如我们去识别这 这是什么车? 这辆是什么车。 呃。他这里就识别出来了水量宝马的差异啊,当然他这里是有写的,这个是差异,具体的大家可以去试用一下啊,这个就是他的图片的一个识别的功能, gbd 四,手机端的话他就装上的眼睛跟耳朵,但是我们在这里网页端的话,他只装上了个眼睛, 并没有装上耳朵啊,看一下过两天啊有没有进行相应的更新,有更新的话应该会装上他的耳朵,以后跟手机端应该是差不多的啊,我们可以去期待一下。嗯,这个内容就讲到这里。
8余汉波 04:04查看AI文稿AI文稿
你好,我是王一泉,这里是王一泉要文评论。三月十五号凌晨, opena 正式发布了,大家期待已久的 gpt four 很快就在中外科技圈刷屏了。 这款新的 ai 大模型确实拿出了一些新东西,不但理解能力、可靠性、输入处理长度上都显著提高,还有一个重大进化,拥有了多模态的能力,简单说就是不仅能看懂文字,也能看懂图片了。 在欧派的爱的技术分享和视频演示当中,展示了 gpd four 在各种标准下的性能提升。比如实事求是回答问题的可能性提高了百分之四十。律师模拟考试成绩从拆 gpd 的后百分之十直接冲进了前百分之十,超过了大多数人。 看图表完成数据分析,找到搞笑图片中的笑点也不在话下。不少媒体可能受发布会演示的影响,注意力都集中在了这些直观的指标上,不停地渲染 gpd four 的各种能力多强。在我看来呢,这些都是 ai 技术调优项。 正常的性能提升真正值得关注的是实现图片和文字同时处理的多模态能力。这个能力的底层,预示着的其实是一切数据偷坑化的新变革。为什么这么说呢?首先,如果你了解 ai 技术的进步趋势,就会明白,今天这些性能提升是必然的事情。 虽然 open ai 以竞争和安全为由,没有公布 gpd four 的任何技术细节,只发布了一份手机评测一样的技术报告,叫 gpd four technical report。 但从模型性能提升的情况看,理解能力和可靠性这几个关键指标的提高,主要是来自于 ai 模型、算法架构和数据级的改进,简单说就是 ai 的工程调优,具体的技术趋势我们早已经介绍过了。 二月十四号的要文评论里,我跟大家谈过 ai 大模型的伸缩法则,当时就提到了 open ai 和谷歌的 demand 关于 ai 参数和数据关系的研究。简单说, ai 大模型中参数规模也不是越大越好,必须和数据匹配才行。之后第二天谈 b 硬上线拆 gbt 的时候,我继续和大家聊到,目前训练 ai 大模型的数据用到了一点,四万亿的 tok 数据瓶颈摆在眼前,谷歌和 openai 都在做算法架构上的优化。了解了这些,你就会明白为什么发布会前盛传的 gbt four 参数超过一百万亿的说法不靠谱也就能理解,性能提升是很正常的事情。 接着我们就来聊聊为什么多茅台技术底层是一切数据头坑化的变革。这里先要区分一下数据头坑化的概念其实很早就出现过,最初是作为互联网上数据加密的一种思路,后来还被外部三领域接见过去,演化成外部三存储数据的方法。 不过我们今天要说的 token 是 ai 大模型的数据单位,一切数据 token 化指的是 ai 大模型加持下,文字、图片、声音等等所有数据都被统一处理的新变革。二零二二年六月,我在科一的学生的大数据专题和大家聊过。互联网产业兴盛之后,人类社会中百分之八十以上的数据都是 图片、音频、视频等等非结构化的数据,这些数据不像文字和字符一样能被计算机处理,如何挖掘这些数据背后的价值,成为大数据变革中的一大方向。当时我预测 ai 会是这轮变革中重要的颠覆力量,如今 open ai 用实际行动证明了这个趋势正在到来。 ai 大模型呢,使用多种类型的数据训练其实已经是非常常见的事情了。 open ai 自己的 ai 绘画软件 doe 就是基于 gbd 三用图片数据训练出来的。他们之前还做过分享,一张图片最长会被转化为一千零二十四个 tok。 打个不准确的比方,相当于所有图片都会被拉成一个长条, ai 是通过这些长条上的数据掌握经验的。 谷歌去年五月在这方面做的更为极致,他们将图片、文字及其坐标等等数据全部 token 化。 ai 经过训练后,分类掌握各种经验,然后根据实际情况匹配对应 token 中的经验,一下子就用了完成六百多种任务的能力。 gpd four 这次 实现的多模态进化则是再进了一步。以前图片数据训练出来的 ai, 也就是用于生成图片或者识别某些具体的物品。这次体现出对图片信息更强的理解能力,提供了图片数据处理的新方案,这背后潜在的价值难以估量。 由此我们也会看到, ai 的数据需求同样还会继续爆发。在文字数据之后,各种图片数据的标注需求将是新的热点。 我可以这样说,未来所有的数据都会偷坑化,衡量数据质量的标准将不再是清晰、完整这些为人服务的指标,而是能拿来训练 ai 的数据才是好数据。可以说数据偷坑化就相当于石油精炼成汽油的过程,会使得人工智能这个发动机得到广泛运用,最终无所不在。 未来各个领域的人工智能水平,甚至能用偷坑化的数据量大小来做评估。完成完评论我们明天见。
337王煜全 02:56查看AI文稿AI文稿
又有新的突破了啊,就在今天, g p t。 四可以解释 g p t。 二了, open ai 呢,今天公布了他们最新的研究,用 ai 来解释 ai。 各位老板好,我是蔡永吉, 大家要知道啊, lms 大型的语言模型背后是如何运作的?这件事情呢,即使是最专业的数据科学家也是很难解释清楚的。那我们所使用的 ai 模型呢,就好像是一个黑盒, 我们不知道黑盒内部是如何运作的,但是我们却能从盒子中呢拿到我们想要的结果。那科学家们呢,一直在试图寻找 lolms 的可解释性, 那现在来看,我们想到的办法就是让 ai 来解释 ai, 那这里稍微加一点专业的东西啊,听不懂也没有关系,那稍微离 理解一下就好,那后面的东西呢,才是关键。那这篇这篇论文叫做 language models can explain nuance in language models, 直译过来呢,就是语言模型才能解释语言模型中的神经元。 那 open a 呢?利用 g p t 四来模拟 g p t 二神经元的工作过程,来寻找神经元的工作原理。那 g p t 二听到一句话呢,它一系列的神经元 啊,他有多个层次的理解,那比如说今晚打老虎,第一层呢,理解到了夜晚和老虎,那第二层呢?理解到了打老虎,那第三层呢?可能理解到了老虎,他是某种暗语, 那但是第四层呢,可能就是 a, b, c, d 了,人类看就看不懂了,那这个时候呢, ai 才能理解 ai, 那这期间呢, pt 四观察 gpt 二,试着重现 gpt 二神经元工作的过程,那 gpt 二呢,现在来看是相当落后的模型了,而 gpt 四呢,在现在也就是二零二三年的五月份,是最先进的模型,那用高级的模型去推理 低级模型的工作原理就是他的方法。那大家也看到了,这个世界呢,真的是以星期为单位在发生着巨大的变化, ai 超越的呢,不只是程序员,作家,还有科学家。那我记得我们小时候就学过 体型庞大的恐龙,曾经称霸了整个地球,但是他们的大脑呢,却非常的小,跟人类相比不值一提。人们骄傲的说呢,人类的大脑是所有生物中最大的,那现在呢,人类引以为傲的大脑呢,正在被 ai 所 超越。而且 ai 最先超越的呢,就是有创造力的职业,比如说作家,设计师,还有高脑力劳动的行业,比如说程序员,甚至是科学家。那我们究竟要如何利用 ai? 我们要发展我们自己的哪些方面作为核心,核心竞争力呢? 那我们如何在这一天一个样的世界中生存呢?这是一件非常值得深思的事情。
21蔡永吉 × AI 02:59查看AI文稿AI文稿
很多做 n r p 的人都说 n r p 已死啊,我给大家讲一个实战例子啊,是怎么回事情?因为 g t g p d 四出现了嘛? 现在做医学数据分析,大数据分析的这个方向啊,嗯,其中有一个东西呢,以前是要这么干的,比如说你拿到一个新的呃医学数据库,好吧?然后呢,你就可以用,你要做一些算法去呃,首先做 entity recognization, 然后要做 relationship extraction, 好吧, 这两件事情呢,现在用 g gpd four 的 api 直接可以搞定,搞定啊,也就说现在的做医学,你就算不是做 医学文本处理的这些人,你可能比如说你是做医学呃,这个图像处理的,那么你现在想要跨界,对吧?你就不用去搞那些拼那些东西, 直接用 gpt 四 api, 然后对着这个医学图像的那些。啊,不对,讲错了,是医学数据库,首先做 energy rigonization, 然后做 relationship extraction, 好,搞出来之后呢?然后你写一个 嗯, paper 的一个草稿啊,只要有 draft 就行啊。然后呢,你看你把这个 draft 直接扔给这个这个 gpd 四的 api, 然后他就帮你去完善这篇论文, 你发现什么了吗?你根本就不会 nlp 那些的,你不用去考虑那些东西,不用考虑,不用考虑那些算法怎么去做 entity regulation, 怎么去,怎么去 扣那些那个,呃,这个关标,那个那个那个什么关键词,对吧?然后怎么去做这个 relationship 的 expression, 你都不用去管,你直接交给 gpt 四,只要有一个新的数据库出现, 比如说你现在拿到一个新的呃病历的数据库,对吧?然后, ok, 你就可以对这个数据库进行分析了,分析完之后,然后你写出一个论文的草稿,然后这个草稿呢,你也可以又丢给这个, 甚至你先写草稿的时候,你都可以用的一些 prompt, 这个前面生成的一些 prompt 你写好,然后丢给他,帮你去完成这个草稿。然后有了这个草稿之后呢,你再丢给 gps 的那个 api 就能够完善这篇论文。 你发现没有,这个 gp 四从头到尾在辅助你去做这个 nlp 的一个任务,在医学里面的数据分析的一个任务。那现在可能是在文本上面还不太行啊。 呃,主要原因是什么呢?主要原因是因为 gps, 他可以从一些公开的,比如说医学书籍啊,然后比如说公开的一些医学论文里面去学习,从文本上面去学习这东西。 但是图像呢?可能因为这些地方的图像,呃,公开的数据里面还并不成好,包括有些图,有些图像是三维的。那这个公开的,呃医学图像信息呢?数据库呢?是不太多的,所以这个可能在图像上面呢?呃,目前还不行,但我相信。 呃,也不是我相信,我只能猜测啊,可能将来图像也会被攻破,反正目前 a r p 是这个,在医学领域,你就算不会,你也可以干这个事情,就这么简单。
294Mardin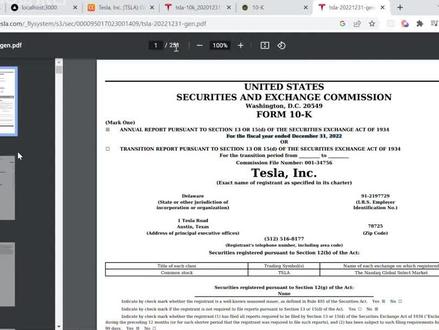 00:37查看AI文稿AI文稿
有网友基于 ppt 四搭建了一个名为沃伦巴菲特的金融分析师平台,支持通过提问的方式进行专业的金融分析。以特斯拉为例, 通过上传二零二零至二零二二年长达一千页的十 k 年度报告 pdf 文档,并询问他 tesla 收入同比增长率是多少, 系统就会自动基于文档进行计算和分析,并详细列出计算步骤和结果,甚至在最后还会列出各个数据源,方便数据追踪和溯源。
23AIGC资讯台
