各显卡模型推理速度对比
很多人觉得 ai 最重要的是算法,但如果你真的了解 ai 行业,你会发现, ai 现在最稀缺的资源其实不仅仅是算法, 是算力啊,甚至是一张显卡。对,没错,就是那个能卖到十万以上人民币那种的。现在的 ai 显卡并不是什么电脑配件了,是发动机,是印刷许可证,是数字时代的油田。咱们客户买的绝对不是卡, 一定是算力,为什么?因为这是速度,是比别人快一步的。可能今天我就用最人话的方式,把四款核心装备的底牌先给大家看看。 四零九零五零九零三十二 g, 我 管他叫入门战神,二五六显存适合谁?个人博主, ai 创作者,想跑大模型但预算有限的玩家,你问稳定性能不能打?我说绝对够用,但是你要二十四小时关机,那你就来找我吧,我给你配业的方案。 l 四零 s 四十八 g, 我 管它叫生产队长。三八四显存,这是英伟达官方出的正规军,不是改装车,适合谁?中小企业生产环境多,用户并发,你问为什么比五零九零贵那么多,因为它能让你睡觉踏实,这话不是我说的,都是客户反馈过来的。 h 两百,我管它叫性能怪兽,这一点,一, tb 的 显存适合谁?大模型训练部门,风控科研机构, nv link, 全互联八卡当一台用,速度可是五零九零的三倍啊,你要真玩这个级别,一定要来找我,我帮你算机房承重和散热。 b 两百 b 三百,我管它叫国家队专属一点五到二点三, tb 的 显存适合谁?部门项目操算中心,万亿参数炼丹丹, 这玩意我听说过几批,流程复杂,不是有钱你就想买,想了解私信我细聊。问题来了,同样一个跑七百亿参数的模型,这五零九零和 s 两百速度差多少倍?评论区可以留言猜一猜。下集我教大家怎么用三个问题,让自己变成一个不踩坑的采购专家。
粉丝274获赞3265
相关视频
 00:55查看AI文稿AI文稿
这是一零八 p 的 游戏画面?没错,不是一零八 p, 是 一零八 p, 而这是使用五零 c 显卡开启 dlss 四点五 l 模型后,将一零八 p 画面强行计算到四 k 的 画面, 你能看出明显的瑕疵吗?而这是贴吧网友将二十四 p 的 游戏画面超分到四 k 的 效果,原画面连是什么物体都看不出来, ai 却猜出了形态,连表情花纹都还原了。甚至啊,网上还有将十六乘九分辨率超分到四 k 的 对比。 当人类用肉眼都无法辨认这是什么游戏的时候, ai 呀,确认了出来,这是巫师三。虽然咱们日常呀使用不会这么极端,但这也完全展示出了 d o s s。 的 强大。未来的游戏画面可能真的有一半都将会是 ai 计算出来的。 传统光学性能的重要程度在逐渐被淡化,算力的大小啊,才是衡量高端显卡的标准。而英伟达也是用实力回应了当年质疑 d o s s 是 骗局的那批玩家。
6.2万小宇-搞机砖家 04:57查看AI文稿AI文稿
这条视频让你的八 g 笔记本显卡的本地大模型推理速度提高百分之四百五十。小伙伴们都知道我推荐的本地大模型推理框架是 l m studio, 如果你还不知道什么是 l m studio, 可以 翻翻我的往期视频。 l m studio 最近更新到了零点四版本,这是一个大版本,更新了很多内容,比如支持多病发和 cloud 的 api。 其中混合专家模型的层卸载也得到了更新,现在单独的选项消失了, 取而代之的是这个滑块。通过滑块的调节,我们可以决定把混合专家模型的层卸载到内存里,只保留激活的层在显卡的显存里, 这叫做卸载 mo, 一 层到 cpu。 这是一个针对混合专家模型的特殊优化,它的原理非常简单粗暴。 以千万三三十 b a 三 b 模行为例,三十 b 指的是这个模型的总参数量,就好比我们现在有三十个在不同领域的专家, 而 a 三 b 指的是在模型推理中只会激活三 b 的 参数量。这就好比从这三十个专家里挑出最适合执行特定任务的三个专家来执行任务, 这样我们最后在完成任务的时候,就只需要支付这三个专家的开销。相对于混合专家模型的叫做筹密模型,比如千问三三十二 b 就是 一个筹密模型,他也有三十个专家, 但是在执行任务的时候,是这三十个专家一起上。这些专家里有很多专家可能并不适合执行你给出的任务,既滥竽充数,浑水摸鱼,且并不能对任务的执行有多大的贡献, 但是我们还需要支付三十个专家的开销,回到大模型上面说的开销就是我们的显存了, 显然三个专家比三十个专家占的显存更小,理论上推理速度也就是更快了。 众所周知,显存的待宽和速度要比内存快不少,所以我们可以利用混合专家模型构架的特点,把激活的专家层放在显卡的显存里,而把贡献不大的专家卸载到内存里,从而充分的优化和利用显存而达到提速的目的。 下面就跟着我带你操作,超简单,有手就会。首先确保你的 lm studio 升级到了最新版本, 然后确保你的 ron time 也升级到了最新版本。 我们直接用千问最新发布的千问三 coder next 模型为例,这是一个八十 b 参数量的模型,在安斯拉斯动态四比特量化后的大小是五十点五一 g, 而我的显卡呢,则是一张八 g 的 rtx 两千 a d a, 显然八 g 是 装不下五十 g 的, 好在我的内存有九十六 g, 而千万三 cold nex 是 一个混合专家模型,且激活量仅为三 b, 所以 我们可以只保留激活专家在显存里,而把没用的专家放进内存里来提高推理速度。 首先我们来演示一下正常情况下的推理速度,我们把上下文拉到三万两千,打开 flash attention, 剩下保持默认,点击 load model 等模型加载。 此时我们可以看看任务管理器,我们可以看到显卡的使用率极低,几乎不参与推理。 此时我们可以看到推理速度是四点四九 tokens 每秒,速度可以说是非常慢了,几乎是不可用的状态。现在我们利用混合专家构架,把没用的专家层卸载到内存里,让激活的专家层都保留在速度更快的显存里。 我们回到加载模型的界面,我们只需要无脑把 gpu offload 拉满,点击 load model 就 可以了,就是这么简单。 同样的问题我们再推理一下,此时我们可以看到显卡的占用基本跑满,而且显存的使用则比刚才还要低,这是因为三 d 的 激活餐数量大概只需要一点八 g 的 显存就可以塞下, 此时的推理速度是十三点九七 tokens 每秒几乎是之前速度的三点五倍,推理提速百分之三百五十。这同样适用于任何其他的混合专家模型,比如 g、 l、 m 四点七, flash 不 卸载到内存的情况下是三点二 tokens, 每秒,卸载到内存之后则达到了十四点四七 tokens 每秒, 提速更是达到了百分之四百五十,一下子就把这些模型从不可用的三四个 tokens 每秒的速度拉到了十四 tokens 左右的可用状态了。
2045AI踩坑指南 00:48查看AI文稿AI文稿
hbm 三 e 显存有多猛?为什么说它是大模型推理的救星?简单说, hbm 三 e 不是 一块普通显存,而是一幢数据摩天大楼。它把内存从平房改成高楼,用几千个微型电梯直上直下传输数据,彻底告别传统显存的地面交通的拥堵。 模型推理,尤其是 ai 和你对话时,想实时开卷考试要求极快的反应, hbm 三亿现存贷款直接飙到一 t b 以上。这意味着像老马三这样的七百亿参数大模型,所有参数一秒能被完整读取超过三十次。推理时再也不用怕被未数据的速度 拖后腿。我们推理的瓶颈往往不是计算芯片不够快,而是参数和缓存调用不够快。这就是大家说 h b m 三一显存是大模型推理的救星的原因。你听懂了吗?有兴趣关注私信!
24咨钛服务器硬件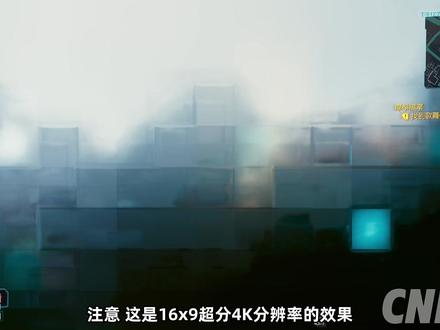 08:57查看AI文稿AI文稿
注意,这是十六乘九超分四 k 分 辨率的效果,只是切换模型,就足以让画质从块块分明马赛克变成闪烁油画,再提升到稳定模糊,能大致分辨出形状的程度。看了这个过程,我确实体会到了科技的发展, 是啊,换来了何为论?见 dlss 四点五发布也有一段时间了,经过了长时间的测试,今天我们就来好好聊聊神奇的超分辨率,用实测看看超分辨率到底有多大提升。 包含十六种分辨率加原声画质和两种 c n 模型加三种,全是粉末模型,画质对比测试量不小,画质对比耗时费力,制作不易,还请三点鼓励一下吧。首先,什么是超分辨率?举个例子,这张熟悉的背影截图是压缩至百分之一的四 k 图片, 相信大家一看这个图,眼前立马浮现出清晰图像,甚至还能动起来,这就是我们原厂自带的超分辨率。超分辨率原理是通过局部信息分析内容,预测意图,根据已知信息进行推理演化,由点到线,由线到面,逐步补全整个画面。 早期 cnn 卷积神经网络的运算逻辑相对单一,更像是在照本宣科按顺序识别内容,实际上并不理解图像信息。因此 cnn 模型超百倍率常被诟病,开启后图像质量远不如原生画质, 而 d o s s 四推出的却是 formal 模型,改进了这一点,更能精准感知场景。上下文类似可解释性,说白了就是不仅知道是什么,更明白为什么 这种基于深度推理、深层的画面效果提升显著。第二, s 四点五的二代全风光模型在初代基础上提升了五倍算力,光线效果更加符合物理规律,残影闪烁现象也大幅减少。超分辨率可以通过降低实际渲染分辨率,减轻显卡运算压力,以达到提升帧数的目的,再 由 ai 算法填充剩余像素,补缺画面画质帧数两手抓。接下来进入实测测试平台,如图所示,游戏为赛博朋克二零七七四 k 高画质 未开光追,因为开启后画面显示有问题,只有黑白斑点。除原生画质外,参与对比的还有 cnn 首款 a 模型和最后一款 f 模型、初代 transformer k 模型和二代 transformer lm 模型。游戏中九 p 超低分辨率渲染又是如何实现的呢? 通过 d o s s 酷奇酷尔可以更改 d o s s 各模式的具体渲染比例。以九 p 为例示范超级性能模式,比例设置为零点零零四,游戏目标分辨率设置为三八四零乘二幺六零,再打开超级性能模式,此时渲染分辨率即为十六乘九,也就是九 p, 其余分辨率以此类推,都是通过修改比例得来的。 c n 框架下的 a 模型九 p 到十八 p 呈果冻块画质,完全不知道画面中的是什么。 幺零八 p 到五四零 p 呈油画风,逐渐清晰,到七二零 p 画面基本和幺零八零 p 原声相同。另一方面, a 模型与幺零八 p 到二幺六 p 的 组合有较为严重的闪烁, 三二四 p 到四三二 p 好 了许多,五四零 p 画面基本稳定,整体有一种用力过猛的感觉。看楼梯和广告牌边框可以明显看出来锐化程度较高,边缘磁感较重,光影效果偏暗,整体观感不太自然。 九百 p 往后,画面中的字愈发清晰,再往后即便分辨率提升,整体画质也变化不大。 f 模型一直到二幺六 p 都是 m、 c 像素几何风, 三二四 p 明显比 a 模型清晰,整体观感和 a 模型差不多。来到 ds 四初代,全是蜂窝模型 k, 九 p 到十八 p 就 已经实现了果冻风像油画风的画质转变。二幺六 p 更是明显比前代模型清晰了很多,五四零 p 基本就和幺零八零 p 原声差不多了,甚至招牌上的字都更清晰些。但同样在招牌和楼梯间存在边缘磁感重的问题, 而后提升分辨率,整体观感变化也不大。重头系第二 s、 四点五的二代 transform 模型 l 和 m, 这里二者整体画面观感差别不大,只是九 p 的 l 模型已经能看出个大概, 十八 p 的 l 模型画面更加清晰透亮。最夸张的来了,幺零八 p 的 l 和 m 模型都摆脱油画水平,整体构图清晰,都比幺零八 p 的 k 模型要清楚多了,甚至超过了二幺六 p 的 k 模型水平, 更不用说二幺六 p 的 af 模型了。但跟三二四 p 的 k 模型相比还是有差距的。 l 整体画面观感比 m 还要更通透清晰点。 三十四 p 的 lm 模型就和幺零八零 p 原声几乎看不出区别了。同时,比七二零 p 的 a、 f 模型五四零 p 的 k 模型画质更好、更细腻,边缘锐化毛躁更少, 明暗区分更加明显,整体画面效果更为逼真。由此可见,第二代全 sportmore 的 lm 模型能够以更低的像素需求渲染出更逼真、更出色的画面效果,那么在画质差不多的情况下,模型的代际跟替是否能够起到在同目标画质下提升帧数的效果呢? 由于 cpu 瓶颈,以幺零八零 p 为目标的渲染场景中,各个模型的帧数基本都一样,这次只能观察 gpu 的 占用率了。以幺零八零 p 为目标的渲染场景下, af 模型在七二零 p 下渲染时几乎与幺零八零 p 画质相同,显卡占用率维持在百分之八十一到百分之九十六左右。 模型在五四零 p 下渲染时几乎与幺零八零 p 画质相同,占用百分之八十一到百分之九十六左右。 l m 模型在三二四 p 下渲染时几乎与幺零八零 p 画质相同,占用率维持在百分之七十四到百分之九十左右, 可以占用略低百分之七左右。由此可见,低分辨率下,二代 transform 模型性价比最高,不仅画质表现更好,硬件占用还更低。如果想要观察帧数差距,那么显卡就必须吃满,这时需要二 k 原生画质幺零八零 p 加 c n 模型或者七二零 p 加 transform 模型才能堪堪把显卡吃满。 从七二零 p 开始,一直到一千八百 p, 每提升幺八零 p 原生画质平均帧损失约百分之七点八, c n 模型平均帧损失约百分之九点七。 一代 transform 模型平均帧损失约百分之九点九。二代 transform 中的 l 模型平均帧损失约百分之十三点九, k 模型损失约百分之十三点六。由此可见,原生画质随分辨率提升的帧数损失最小,而二代 transform 模型计算量更大,帧数损失较大。 k 与 a f 模型帧数损耗几乎持平,画面会更好些。按 n v 官网说法, l 模型搭配超级性的模式,超分辨率效果最好。我们都知道 d l、 s s 一 般有四个模式,质量、均衡性能和超级性能, 虽然比例分别为百分之六十七、百分之五十八、百分之五十和百分之三十三。你把游戏画面设置为四 k 分 辨率,并且开启超级性能模式时,基础分辨率就是二幺六零 p 像素点的百分之三十三,差不多就是七二零 p。 l 模型加超级性能与原声四 k 对 比,确实效果不错,整体看来几乎没有差别。 帧数近乎翻倍,平均帧高约百分之九十六点八,基本是在用原声二 k 的 帧数唱完四 k。 这样的提升还是很可观的,妥妥的黑科技。但要强行盯帧的话,拉大看烟雾效果得幺六二零 p 才能达到近视清晰水平, 此时画质压力较大,平均帧比四 k 原声还要低约百分之七点四。官方建议搭配超级性的模式,不仅因为画质达到了完全可用的状态,也因为 l 模型对显卡性能要求更高,帧数损耗较大。对比 m 模型,超级性的模式平均帧低约百分之五点一。对 对比 k 模型超级性能,模式平均值低约百分之二点六。对比 k 模型质量模式平均值高约百分之四十三点四。除光影效果外,差别也不大, k 模型画面更加柔和点,对比 m 模型性能,模式平均值高约百分之二十三点三。 总结一下, l 模型在七二零 p 画质下渲染,画质即可与原生四 k 相近,此时平均帧比原生四 k 高约百分之九十六点八。 m 模型在九百 p 画质下渲染画质即可与原生四 k 相近,此时平均帧比原生四 k 高约百分之九十一点五 k 模型在九百 p 画质下渲染,画质也可与原生四 k 相近,此时平均帧比原生四 k 高约百分之九十四点七。 c n 模型中的 a f 模型需要在幺零八零 p 开始渲染画质才能与原生四 k 相近,此时平均值高约百分之九十一点五。基础模型在不同渲染分辨率下与原生四 k 画质相近时,帧数表现相差不大。 索尼的 ds 四点五的 l m 模型抗锯齿效果更加平滑,运动图像清晰度更高,闪烁残影现象也大幅减少,更推荐大家选用四 k 画质百分之一百直接拉满开旋。 l m 模型画面相比原生四 k 我 其实没怎么看出区别,此时平均帧分别低于百分之四十一点五、百分之三十五点一, 相较原生四 k 帧锐减,在三 a 帧流畅线徘徊,就不如直接使用原生画质了。最后我们再看一下,四 k 加 l m 模型和八 k 原生画质碰一下肯定是打不过的,这时候就属于底大一级压死人了,更何况不止一级, 八 k 相比四 k 像素不是两倍的关系,而是四倍。一眼可见,八 k 清晰度高,画面立体感更强,光影效果更加深重。李正, 总体来看,二代 transform 模型属实给我们带来了不少惊喜,也许正如老黄在 c s 二零二六媒体采访中提到的, g p u 纯算力受物理限制灾难发展,依靠少量像素极致精美渲染,由 ai 补全剩余画面,未来是神经网络渲染, 未来更新的模型会让画质向何方发展呢?让我们拭目以待。好了,以上就是本期视频的全部内容了,感谢大家的耐心观看,我们下期视频再见, peace out!
3568和微论件 01:34191科技糖
 08:11查看AI文稿AI文稿
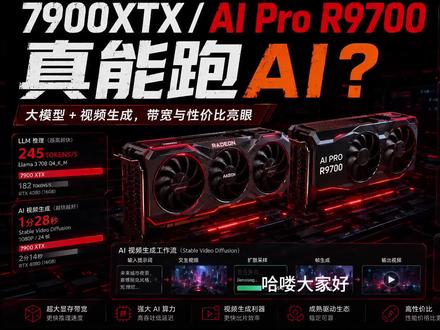
哈喽,大家好,欢迎来到这一期的深度解析。如果你平时一直在折腾本地 ai, 或者正发愁不知道该选什么硬件,那你今天可算是来对地方了。 好,咱们直接切入正题。今天我们要彻彻底底的把 amd 显卡在本地 ai 工作流里的底盘给掀开,看看它的真正实力、性价比,以及到底哪些卡适合什么样的场景。说真的,是时候打破那些老旧的观念,看看红场是怎么在 ai 时代悄悄逆袭的了。 今天咱们的内容非常硬核,但也绝对精彩。咱们会先聊聊 amd ai 生态的崛起,接着看七九零零 x tx 和二九九七零这两张神仙卡的硬核对比,再聊聊他们各自的最佳使用场景。 然后咱们会去分析九零七零 x t 和 max free 三九五的战术玩法,揭秘超级实用的分层计算。最后帮大家评估一下现在投奔 amd 到底值不值。 好的,咱们马上进入第一部分, amd ai 的 崛起,看看它是怎么打破刻板印象的。咱们得承认,以前一说用 a 卡跑严肃的 ai 生产,很多人的第一反应就是,哎呦,太折腾了,全是 bug 对 吧? 普通人根本不敢碰,但朋友们,那真的是过去式了,现在的真实情况是,生态已经发生了翻天覆地的变化。就拿最新的 rocm 七点二和 piq 六点三来说,在 linux 环境下,这套组合的性能直接拉满了,既成熟又强悍。 而且现在论坛里有大量的大神和极其活跃的社区,你现在上车绝对不是孤军奋战。这也就引出了现在极客圈里非常火的一句话,没错,就是那句激动人心的 amd, yes! 为什么大家这么激动? 因为对于那些真心想玩转本地 ai 的 人来说,花一点点时间去配置环境,回报率简直太高了。你想想,比起去买那些架构老旧,说不定哪天就核心虚焊的高端方案, amd 现在的性价比简直香爆了, 哪怕遇到点小报错,问问 ai 助手,再去论坛发个帖,轻轻松松就解决了。咱们趁热打铁,直接进入第二部分,看看七九零零 s t x 和 am pro r two 九七九七零零这两位重量级选手的拼锋对决, 这可以说是消费级王者和专业工作站老大哥的直接碰一碰了。这两款卡的定位完全不一样,一边呢是咱们很熟悉的七九零零 x g x, 差不多六千块人民币,给到了二十四 g b 的 显存,绝对是 ai 爱好者的心头好。另一边是专为小团队和企业设计的 ai pro r 九千七百,大概一万一千块,给了海量的三十二 g b 显存。 简单来说,七九零零 x t x 主打一个简单粗暴的原始速度,而 r 九千七百玩的就是超大容量和绝对的稳定,大家一定要记住这个数字,每秒九百六十 g b, 这可是七千九百 x t x 的 显存贷款呐!在消费级钱卡里,这简直是个不讲道理的性能怪物, 有这么恐怖的贷款夹尺?他在跑窥闻三点六二十七 b 这种仇民模型的时候,不用任何魔改,默认状态下就能跑到每秒三十个头啃这几站立,就问你怕不怕。 稍微总结一下,七九零零 s t x 为什么能成为极客们的梦中情卡,首先,巨大的贷款让他在跑 a o l t x 二点三生成四百八十 p 原声视频的时候,速度比那些专业计算卡还要猛。 其次,如果你买的是比如蓝宝石白金版这种做工扎实的飞工版卡,满载温度连七十度都不到,安静的像是不存在一样。最后,六千块左右的无低身价,直接让他在这个价位段锁定了六边形战士的称号。那么问题来了,既然这卡这么好,我们什么时候该看别的卡呢? 进入第三部分,咱们来聊聊旗舰卡到底该怎么选才最合适?很多人搁那问问,既然七千九六 x t 这么快,那多花几千块买 r 九千几百到底图个啥?答案就四个字,不间断生产。 r 九千几百这类涡轮计算卡,天生就是为了高分辨率的连续工作流和复杂多任务设计 的,它极度可靠,工号还压在三百瓦以下,最绝的是它一万一左右的价格,非常坚挺,无论国内外都能炒的一万四那么离谱。 咱们用实战数据来说话,看看超大显存到底为什么不可替代?打个比方,你要在 linux 下用 ltx 二点三生成一段七百二十 p 十七秒长的高清视频。 注意了,这个过程中的显存占用平时就在二十七个 gb 左右徘徊,峰值甚至能冲到二十九个 gb, 这时候七九零零 xt 的 二十四个 gb 直接就爆显存爆工了。 而 r 九七零零呢?凭借三十二个 gb 的 海量空间,它能面不改色地接下这个任务,让你极其从容地去跑连续脚本和复杂的运镜拼接,这就非常有意思了,其实这两款卡的定位互补的堪称完美,七九零零 x t x 就 像是一个四八零 p 速度狂魔,跑得飞快但又显存天花板。 而 r 九七零零更像是一台七二零 p 工作室级涡轮机,虽然贷款只有六百四十 gbs, 稍微慢了那么一点点,但人家的度量是真的大,能吞下极其庞大的流水线人物。所以买哪张完全看你是要追求极致的单次速度,还是高分辨率下的干活不抱显存, ok? 看完了两张旗舰卡的神仙打架,咱们进入第四部分,来看看两位非常有意思的战术专家。九零七十 t x t 和 max 三九五先聊聊九零七零 xt, 老玩家都知道,以前十六 gb 显存的 a 卡拿来跑 ai 真的 是能让人掉眼泪, 但这块卡绝对是个大异类,它不仅价格不到五千块,竟然还给了二百五十六倍宽和六百四十 gbs 的 高带宽。更夸张的是,它的 bf 十六算力强得离谱,甚至比老大哥七九零零 xt 还要猛出一点点。 虽然说只有十六 g 显存,跑特别复杂的 comfy ui 有 点捉襟见肘,但它强悍的算力让它成了一张极具可玩性的战术卡。 接着给大家隆重介绍我们今天极其特别的一位选手, ai max 三九五。注意哦,这可不是大家以为的那种插在主板上的显卡,这玩意儿是一个完整的 x 八六独立生态小盒子,而且最让人惊喜的是,它的 windows 环境超区友好,几乎就是即插即用, amd 甚至专门给它搞了一套特别好用的软件生态。 那这个想盒子的必杀技是什么呢?那就是它的统一大内存!你别看它跑普通模型可能慢吞吞的每秒不到十个 token, 但有了庞大统一内存的加持,它居然能硬生生地跑起十二八 b m o e 这种巨无霸级别的混合专家模型。 这就意味着在做原生多模态任务,尤其是那种需要极深知识库的超高精准图片识别时,它能做到普通显卡因为显存不够而根本做梦都做不到的事,这就是它无可取代的价值所在。 摇完小猴子,咱们进入第五部分,我要教大家一招,看看怎么把刚才那张九零七零 xt 的 战术驾驶真正榨干,那就是分层计算。 你想啊,如果单买一张九零七零 xt 跑 ai 显存肯定不够用,但如果咱们换个思路把它当副卡呢?这就是分层 ai 工作流的魅力所在了。你可以让性能怪兽九零七零 xt 当主力,死磕那些特别吃显存的 ai 视频生成, 同时让算力爆表的九零七零 xt 在 旁边打配合,专门负责流水线里的音频生成声图或者是画面的即时审核。 看到没有?这就是一加一大于二的魔法,把这两张卡组合在一起,你瞬间就拥有了总计四十 gb 的 恐怖显存值。 你可以弄一块非常便宜的老 x 九九这种洋垃圾主板,把它们串起来,直接打造一个超大型的分流处理流水线,而你花掉的钱,连隔壁某些天价旗舰计算卡的零头都不到。这就是现在高阶玩家玩分层计算直接压榨性比的终极奥义。 好嘞,干货讲完了,咱们进入第六部分,也就是最后的总结,搞这么一套 amd 方案,到底是不是一笔好投资?帮大家快速复盘一下红场现在的核心竞争力, 首先毋庸置疑,它比同级别的企业级硬件便宜太多了,极大地拉低了玩转本地 ai 的 门槛。第二, rocm 七点二的软件生态真的已经非常成熟,性能爆表, 再加上现在开源 ai 工具疯狂迭代,生态的护城河正在被快速填平。最后,就像我们刚才说的,利用低成本的旧平台搭建双卡跑大模型,这套方案已经被无数人验证过了,不仅绝对可行,而且体验直接翻倍。 就像资料里非常霸气的那句总结一样,买一张 a 卡站未来,这波肯定不会亏。说实话,这早就不是我们在玩梗了,这是基于实打实的性能跑分及其硬核的社区支持,以及每天都在飞速进化的软件生态得出的最客观的结论。 amd 在 本地 ai 这盘大起上,这一次是真的站稳脚跟了。 那么最后,我想把这个问题抛给大家,当你在有限的预算下也能享受到每秒九百六十 gb 的 极致贷款,甚至能灵活玩转四十 gb 超大显存的分层计算组合时, 你是不是已经准备好打破原有的硬件舒适区,开启一场全新的本地 ai 装机之旅了呢?希望今天的深度解析能给你带来点不一样的启发,感谢大家的陪伴,我们下次解析再见!
1243AI深度实验室 00:59查看AI文稿AI文稿
兄弟们,做魔性 a p i 搞多了,我推理,千万别堆四零九零了。这台四卡 a 一 百才是真正的印钞机,一台顶八张四零九零不止。它的四张卡可以通过 nv 令可全速焊在一块,形成一个三百二十 gb 显存的巨型机。 p u 卡间带宽六百 g b 每秒是 p c i e 的 十倍,完全没有数据,堵车多人五并行,最怕一个 o m 全崩。 a 一 百的 m i g 技术是真正的硬件切割,一张八十 g 显存可以秒切七个独立小 g p u。 跑前问七零 b 的 主服务,边上再挂上语音识别和绘图,资源故 障,全部物理隔离,延迟稳成一条直线。我们再来看下实测,用吞吐二 t 老马把老马三七零 b 灌进去,打开持续 p 处理,同样跑并发。这台四卡 a 一 百的吞吐量是八卡三零九零涡轮机群的两倍多, 它可以同时处理的绘画数量直接翻倍,而那种气人的 p 九九延迟,直接砍掉百分之六十,电费更低,机位更少,客户更安静, ok, 我 们总结一下,这台机器生命周期强,可扩展性强,现在抗病发,将来上万亿参数也能调油再战, ok, 如果你有兴趣,点关注。
 06:12查看AI文稿AI文稿
你敲下回车,人家那边两千个字已经拍你脸上了,这事你敢信?就在二零二六年二月,农历大年初六年还没过完,一家加拿大只有二十四个人的小公司叫 talas, 突然扔出一枚深水炸弹, 他们搞出一款芯片,推理速度直接干到了每秒一万七千个 token。 什么概念?现在市面上最火的英伟达 b, 两百每秒也就三百五十个 token, 也就说这枚小芯片的速度是英伟达最新款 gpu 的 将近五十倍。成本呢,直接砍到二十分之一, 工号降到十分之一。最狠的是,这帮人为了追求这个速度,干了一件反常识的事,他们把 ai 大 模型直接用物理的方式焊死在了芯片里。你没听错,是焊死。 就像把一首歌直接刻在黑胶唱片上,这张唱片这辈子就只能放这一首歌。这到底是一次改朝换代的宣战,还是一场注定沦为电子垃圾的豪赌?英伟达的芯片神话,是不是要被这二十四个人撕开一道口子了?今天就用一条视频把这个事给你讲清楚。 咱们先聊聊英伟达这些年是怎么封神的。其实过去三十年,不管是 cpu 还是 gpu, 硅谷那帮巨头就一个信仰,造一个通用的计算平台。什么叫通用?就是我这个芯片得是个万能舞台,你不管是跳芭蕾还是唱摇滚, 不管什么软件什么模型上来都能演。英伟达最牛的地方就是它造了 gpu, 这个舞台还搭了个叫库达的生态架子, 任何模型甭管是 chat、 gpt 还是 lma, 上来就能跑。所以过去十年,大家心甘情愿掏空钱包买英伟达的卡,图的就是这个万能,这个省心。但是这个万能舞台有个要命的硬伤,叫内存墙。我给你打个比方, 你是个大厨,你的灶台是计算单元,你的食材仓库是显存,每次炒菜,你都得从仓库把食材搬到灶台上。 以前炒个小炒搬一趟就行,但现在模型大到几千亿,参数等于你要办一桌满汉全席,得来回搬几百趟食材,这搬来搬去的功夫和力气,早就超过炒菜本身了。整个行业包括英伟达,为了保住这个万能舞台,只能拼命把仓库盖大, 把搬运工练壮,但永远解决不了来回折腾的这个过程本身。这时候那二十四个加拿大人站出来了,说,你们累不累啊?既然这个舞台天天只演罗密欧与朱丽叶,咱还天天搬布景干嘛?直接用水泥把布景气死在台上不就完了吗? pass 的 思路就是这么简单粗暴。他们做的芯片叫 hce, 出厂的时候就把 mate 的 lama 三点一八 b 这个模型,每一个参数每一个权重直接对应到了芯片上特定的晶体管。你问他问题,压根不需要去内存里加载数据,电流一通过,答案啪的一下就出来了, 这就是速度暴增五十倍的秘密。那问题来了,把魔性焊死,到底是神操作还是骚操作?网上已经吵翻了天,正方说这是未来,你看他那个速度, 那不是回复,是直接未卜先知把答案砸你脸上。有人甚至说,这种速度根本就不是给人准备的,是给以后无数个 ai 智能体互相聊天用的。那个世界不需要等待,这就是把灵活性换成了极致速度。 就像你听歌是愿意听现场交响乐团,还是愿意听灌好的黑胶唱片,黑胶唱片音质完美,而且想听就听,不需要等乐团就位。但反方的话更难听,他们说你这是引阵止渴,是制造高级电子垃圾。 为啥?大模型现在十八个月就迭代一次,今年是拉玛三,明年拉玛四出来,你这块号称速度第一的芯片瞬间就变成一块废铁, 为了追求那点速度,把升级的路全堵死了,这不是自己把自己玩死了?这种分裂本身就说明行业共识已经被打破了,以前大家都信通用,现在有人开始走专用这条道了,而且走的这么极端, 那这场路线大决裂之后, ai 世界会变成什么样?咱们普通人能得到啥?或者会失去啥?我个人觉得未来的 ai 硬件会走向一个两级分化的世界。一边是云端,那些通用神灵就是少数,像英伟达这样的巨头,供养着几千亿参数的通用大模型, 他们负责思考,负责创造,负责给你写诗画画。他们像发电厂的高压电,庞大昂贵但无所不能。 另一边就是像它拉斯这种被死死刻进龟片里的电子牛马,他们会以百亿计的数量钻进你的手机,你的汽车,你家的扫地机器人,工厂的流水线上。他们不懂什么是诗和远方,他们生下来就只会干一件事,比如语音唤醒或者人脸识别。 但干这件事他们是光速,而且成本低到可以忽略不计。网上有个评论特别扎心,他说其实大部分人类一辈子也就说一种语言,做着一份固定的职业,这和大脑里刻死了一个模型有什么区别?想想还真是,我们在绝大多数场景下,根本不需要一个全知全能的神。 你家里的扫地机,它只需要认路避障,你管它是 gpt 六还是 cloud 五呢?这时候,一个永远不需要换代的钉子一样的专用芯片就是最好的答案。所以你看扎克伯格,如果看到这个芯片,他眼睛得发光。他手里有拉玛模型, 如果他能用这种技术把拉玛固化到每一台设备里,他就能彻底摆脱对英伟达的依赖,实现硬件及模型的终极梦想。这对麦塔是天大的好事,但对那些靠卖通用算力的云厂商来说,就是噩梦。 这场决战让我想起了当年的 intel 和 a r m。 pc 时代, intel 的 x 八十六芯片一统天下,啥电脑都用它, 这是通用。到了移动时代, a r m 走了一条完全不同的路,它允许每个手机厂商定制自己的芯片, 功耗低,专门为手机服务,这是专用。结果呢?两者共存至今,今天的 ai 芯片可能就站在这样一个历史岔路口。所以回到咱们开头的问题, 一个二十四人的小团队掏出一万七千 tokens 每秒的芯片,这不是一次简单的技术突破,这是用一种全新的物种对旧世界发出的挑战书。它不是要取代英伟达,它是要告诉你,未来的世界不需要一个神,而是需要无数个各司其职的牛马。 你觉得人类的科技树应该往哪个方向点?是继续追求那个全知全能的通用神,还是拥抱这些光速干活的电子牛马?欢迎在评论区谈谈你的观点。
829智库林丨杉哥 02:20查看AI文稿AI文稿
我手里有两片显卡,一片是三零六零的十二 g, 一 片是五零六零的八 g, 这两片显卡谁更好?如果是玩游戏,或者是说我们做一般应用,那么确实是五零六零更深一筹, 因为它的核心,它用的显卡是 ddr 七的,再加上它的核心显卡,它确实比三零六零要快。但是如果我们是做本地大模型,这个答案还真不一定, 因为本地大模型对显存是很看重的。有一个简单的判断标准,显存决定了你能流畅运行大模型规格的上限。 这句话是大模型运行的基本逻辑,就是对于大模型来说,你稍微慢一点,只要不是太慢没问题,但是显存不能不够,显存不够,它里面数据腾不过来,是要崩溃的。 要想运行更大的模型,那不但它的芯片要好,现存也要快。 呃,比如说你跑一个一百四十亿以参数的也就是四 b 吗?他的模型你三零六零的十二 g, 他 基本上是刚刚好够用。呃,运行 q 四版本的模型,但是五零六零他的八 g 现存 就非常吃力,甚至有可能崩溃。至于说我们大部分人应该在家用电脑上跑的应该是七 b, 也就是七十亿参数的主流模型, 这个模型三零六零他可以就是十二 g 的 三零六零显卡,他可以流畅的运行精度更高的八位或者六位版本,但是五零六零、五零六零八 g, 他 只能运行占用显存更小的四位量化版本, 所以说这个时候差距就看出来了。然后还有就是我们在进与大模型进行对话或者处理长文本的时候,你更大的选程, 他能让你的个整个反应速度反而更流畅,就是说你三零六零。因为选程大,在默写长文本或者是说上下文多轮对话的时候,他的反应速度有可能反而比八 g 的 五零六零更快。 所以我们显卡的好坏不仅是要看芯片,还要看它的使用场景,不同的场景我们要配不同的显卡。
131兄弟电脑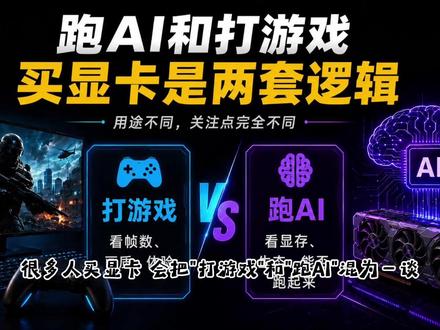 02:22查看AI文稿AI文稿
很多人买显卡会把打游戏和跑 ai 混为一谈,但这两个场景判断一张卡好不好,逻辑不一样。先说打游戏,打游戏买显卡主要看几个指标,游戏帧数、分辨率、画质、光线追踪、 d l s s 工号和散热。你玩三 a 大 作,关心的是一零八零 p 二 k 四 k 下能跑多少帧,画面稳不稳,温度高不高。 跑 ai 第一优先级,不是真数。跑 ai 要先看显存容量,库达支持模型能不能装进显存软件,能不能跑起来。根据 nvidia 官方对库达 toky 的 说明,它是一个用于开发 gpu 加速应用的开发环境,包含 gpu 加速库变器、开发工具和运行时。目前主流的深度学习框架,例如 pht sensor flow, 长期都对库达提供了原声支持。 所以你买显卡跑 ai, 第一个问题不该是这张卡游戏强不强,而应该是这张卡显存够不够,软件支不支持, 环境好不好装。举个例子,根据 nvidia 官方规格, rtx 三零九零二十四只 b g d d r 六 x 显存,一万零四百九十六个库达核心,二零二零年九月发布。 rtx, 四零九零二十四 g b g d d r 六 x 显存一万六千三百八十四个库达核心,二零二二年十月发布。游戏性能上四千零九十比三千零九十强一代。但在能不能装下某个模型这件事上,两张卡的显存都是二十四 g b 这个数字才是 ai 用户先看的指标。显存不够,模型直接加载不进去,显存够了才谈得上速度和效率。这就是为什么有些上一代的卡游戏玩家不再关注,但还有 ai 用户在二手市场盯着,不是因为它游戏强,而是因为它显存够大。再说多卡 打游戏方面, nvidia 在 rtx 四零系列上已经不再支持 sli 多卡,互联主流游戏对多卡的支持也基本停止。但 在 ai 领域,躲卡仍然是常见做法,比如把更大的模型分片到多张卡上,或者并行跑多个任务。不过有一点要讲清楚,躲卡不是把显存简单相加,所有软件都能直接用, 能不能用、怎么用,要看模型本身是否支持分片框架,如 pie torch、 deep speed v l l m 是 否支持躲卡驱动主板、 p c i e 通道、电源、功率、散热条件。所以新手买 ai 显卡不能只看几张卡, 还要看整机和软件环境能不能配合。关于 amd m d 显卡不是不能跑, ai m d 有 自己的 roc 盘平台,部分框架如 pie torch 也提供了 rock me 版本。但客观事实是, nvidia 的 酷大生态发布于二零零七年,时间更长,酷更完整。 nvidia 还提供 c u d n n 深度神经网络、酷 tensor r t 推理优化、 tensor tell l m 大 模型推理等专门面向 ai 的 库。目前大多数开源 ai 项目默认适配的是酷的,所以 nvidia 对 于新手确实更省心。
137AI深度实验室 01:10查看AI文稿AI文稿
最近 ai 很 火,但很多人买了服务器之后,并不知道他跑大模型的性能怎么样。像我们给客户交单,一般都会附上一个检测报告,但如果说你没有找我们买,那可不可以去做这个测试呢?也是可以的,我们还单独开发了一个测试的软件,这里我们来做一个演示,用的是液冷的 h 一 百的机器, 我们安装两个模型,第一个是千问的一百二十二 b 杠 a 十 b, 另一个是 deepseek 的 七十 b, 我 们很方便快捷的能测到它的速度。比如说现在切换的是千问一百二十二 b 的 模型,问他一个问题,那这个时候我们很快的就能看到他的一个 token 的 生成速度了, 以及它的走字延迟。走字延迟是我们判断它回复的效率的,也就是说你发送一个问题之后,它隔了四十四毫秒才回复你。那我们现在切换到 dbc 七十 p, 同样的也是问它一个问题,好,现在速度也很快的就出来了。 所以说这个软件可以很方便的管理多个不同大模型。比如说我在一台电脑上放了八个大模型,你就不需要一个个去弄,全部集成到这个软件里,想切换什么就切换什么。而且速度啊,手自言辞啊,耗时啊,以及其他的参数我们都有写进去的,大家如果对这个感兴趣,可以聊一聊。
35算力飓风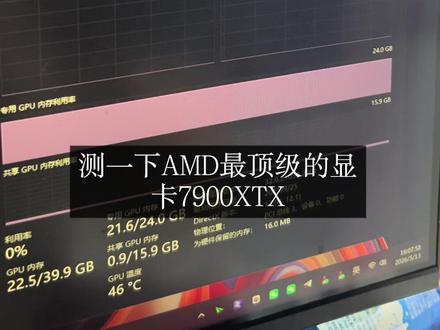 00:52查看AI文稿AI文稿
测一下 amd 最顶级的显卡七九零零 x d 叉跑大模式,这个推移的速度的话它是刚才,刚才已经测好了,它是五十七 talk 每秒。然后我又问三零九零二十 g 它的速度是多少, 它显示是也是在四十到六十之间,所以说用这个 amd 显卡它是跟三零九零五差的。 现在这个英伟达显卡被人为拔高了。三零九零现在基本上很多都是宽卡,但是 m d 这种七九零零它是二十年之后的,很少有宽卡 长上上下文可以拉到满。如果你内存足够高的话,内存比较少,只有三十二 g, 一 般内存四十八 g 以上会比较好一点。
45Sun_^ 01:31查看AI文稿AI文稿
deepsea v 四与 gpt 五点五两搭势接顶及模型正面硬钢几乎同时发布,我们该选哪个?今天用硬核数据给你一个明确的答案。先看价格, deepsea v 四只要零点零零零一美元每千 token, gpt 五点五幺零点零零三美元,百分之一的价格,百分之九十的能力, deepsea 做到了,这就是性价比之王。处理一百万字文档, deepsea 只要一毛三, gpt 要十三块,差距一百倍。 企业级应用一年能省下几十万,构招三个程序员,这就是真金白银的差距。 deep sec v 四支持 e m 上下文, g p t。 五点五只有一百二十八 k, 读一本书 vs 读一张,差距八倍。但编程能力, g p t。 五点五是 sota terminal bench, 百分之八十二点七, deep sec 还在追赶,承认差距,建立客观性。更重要的是, g p t。 五点五是 agencai, 能自主规划使用工具,检查工作,不只是聊天,而是你的 ai 代理国内项目, deepsafe 数据在境内合规无忧, gpt 数据出镜有风险, deepsafe 也是配华为,含五 g 芯片,不怕卡脖子,自主可控,这就是底气。 deepsafe 开源可定制, gpt 五点五闭原声太强, 个人开发者、创业者预算有限,选 deep seek v 四,省钱就是赚钱。企业级应用追求极致性能,选 gpt 五点五 agent 能力降本增效,政府、国企项目必须选 deep seek v 四,合规是底线,聪明的做法是简单任务用 deep seek 省钱,复杂任务用 gpt 保性能。一句话总结, deep seek v 四是性价比之王, g p t。 五点五是性能之王。国产 ai 正在从追赶者变成并跑者,差距越来越小,价格越来越香,这就是国产 ai 的 底气。你选哪个?评论区告诉我!点赞关注,下期更深关注廖聊 ai 家,带你了解全球最新的 ai 资讯和实操案例!
101廖聊AI+ 01:03查看AI文稿AI文稿
本期测试的硬件是英特尔 k a 七七零模拟测试环境,显存十六 g b 带宽五百六十 g b s 核心数四零九六,内存三十二 g b 能跑的最大模型是宽三三二 b, 显存直接拉满震。用十六点九 g b 上下文一百二十八 k 生成速度十三套个每秒。能跑最长上下文的模型是 number two 三 nano 三零 b 显存用十五点九 g b 上下文一千零二十四 k, 速度二十五 talk 每秒。最合适的大模型是 jama 三一二 b, 显存占用六点六 gb 上下文一百二十八 k, 生成速度五十九 talk 每秒。推荐模型, jama 三一二 b 推荐理由, 速度五十九 talk 每秒,在二十到六十 talk 每秒区间内拥有一二 b 参数,同时保持六点六 gb 的 合理显存占用 有一百二十八 k 的 拥置上下文长度,兼顾性能与效率,是入门级 ai 部署的最佳选择。想要详细的测评数据,评论区留言给我。
18AI科创指南


