wps如何生成正态分布数据
今天花大概五分钟的时间做上手手势的一个正态分布的一个曲线,这是原始数据啊,这是正态曲线,这是各个数据期间数据分布的一个频率啊。 呃,我们先将这个数据删除,我们大概花五分钟时间给大家介绍一下,这些数据都删掉了, 这有两两百组随机数据啊,这随机数据是通过 正态分布函数这个生成的,这两百是两百组数据一生成一列,七十是我们这个数据是按七十的平均值 s 至 s 的 标准生成的一个概率分布函数。我们现在开始, 首先我们要求要要得到这个正态曲线,要先得到这几个数据生成平均值的生成。生成正态曲线的几个参数,一个是最大值,最大值我们乘个最大值函数平平均最小值,最小值函数平均值标准差,主主主数的话, 嗯,我们是根据这个数据的总量,两百大概给它分成二十五组,每组平均下来大概有八组数据,组计的话是最大值,减去最小值再除以指数得到一个组计。得到组计以后,我们下来就要设定横坐标的一个 这个坐标轴,坐标轴开始是以最小值为起点,所以第一个值应该是等于最小值啊,最小值啊。呃,第二组的话应该是最小值的, 加上主记,主记是四啊,这个这个地方要决定用 f 四决定,这样再往下依次填充, 依次填充,填充到填充到,呃,接近要大于最大值啊, 就这样我们这个期间就分好了,就是很久这个期间。期间分好了以后,下一步我们就要开始 先画脂肪图,脂肪图的话是在书记里面,书记里面这里有个数据分析,数据分析可能没有加载的,要从选项里面进行加载,我这已经大概给大家说一下怎么加载,嗯, 加载向这里转到,转到这里有个分析工具库,点,这个我们已经点了。嗯,我们先来把脂肪图给做出来,脂肪图在数据这个地方,数据 脂肪图,脂肪图我们上次已经做过他,他把上次的纸默认保留下来了,我俩给大家说重新来一遍吧。嗯,这是第一个输入区域是原始数据,第二个接收区域,接收区域就是我们的分离,这个期间, 期间第三个数,第三个数出七页是我们这个脂肪图需要让它输出在哪个地方,我们选一个,选一个单元格吧,选到第二个,第二个输出这个地方,我们同时要把这个脂肪图给输出,输出数据的同时输出脂肪图。确定, 嗯,这里多了个,把这个删掉,多了个单元格,这里不错了,我们重新选选一下输出这个地方吧。嗯,确定。 今天这样我们的脂肪图就生成了脂肪图,我们呢给它拿大一点,拿大一点,把标签加上,这个相当于就是在这个期间发生一个频率,这是脂肪图的意思,脂肪图我们才要来算到钙磷密度,钙磷密度的话用钙磷密度函数等于, 嗯, normal 就是 正在分布的意思, normal distance, 第一个是选中数据区间时,嗯,第二个参数是平均值,平均值这个地方我们要写对引用。 c 四,这个是标准差相对引用, 嗯,我们是按概率密度函数的减负,这确定这样,嗯,这个区发生的概率就是 万分之二,这样,这样整个更密密度就出来了,出来后我们选中这个数据区间,再选中更密密度,再插入, 插入,在图标推荐图标这个地方勾选这个脂肪图,这样确定啊,这样我们这个脂肪图就画出来了啊,大概就是这几个步骤啊,嗯,我们把这个坐标组大概微调一下,再调最高值,调低一点 a 一 好,那 这样,这样脂肪图就出来了啊,改一下标题真的帮助啊,今天洗脸 这样真的显眼,就画出来了,剩下的细节大家自行美化啊啊,本期视频分享到此结束啊,谢谢!

粉丝1621获赞5641
相关视频
 05:50查看AI文稿AI文稿
大家好哈,这一节我们给大家分享一下 excel 里边去如何去制作纸方图,以及给它拟核,正在分布曲线。 好,我们有一列模拟数据啊,是一个童话市场的数据,现在我们在数据菜单啊,主菜单右侧找到数据分析,如果你现在这个菜单上没有数据分析呢?你要到文件 选项这边啊,找到左边的加载项啊,点一下加载项之后呢,在右侧最底下啊,管理 excel 加载项,点击这个转到再出来的框里边,你把分析工具勾上就可以了啊,分析工具库也要勾选,点确定就可以了。 好,我们现在呢,还是找到数据分析啊,点开之后,我们找到直方图,这里边就有直方图啊,点确定,这是最省事的办法啊,办法如果手工作会比较麻烦啊。 好,我们现在直接把数据选中,我选中 f 一, shift 下箭头啊,就把所有的数据都选中了,因为我们选了 f 一 啊,选了标题,所以这个地方呢,我们要勾一下这个地方,要去把标志 勾上啊,如果你不勾标志呢,因为 f 一 是一个文本啊,它是列标题,它会报错啊,勾上标志之后呢,那么 excel 就 会知道 f 一 是一个标题啊,它就不会报错。 好,我们在底下把图标输出勾上就可以了,当然这个工具还可以生成帕累托图啊,但是呢,它的效果并不是很好,这个是后话以后再说啊。好,我们点确定啊,这个时候我们就会得到一张啊, excel 自动为我们生成的直方图, 我们可以把它拉大一点,左侧就是它的接收的区间划分啊,这个区间就是柱子的间隔区间啊,还有每一个区间里边的数据的频次啊,都在这里面, 我们其实可以把这个数据给他,尤其是最后一个,其他啊,就是二零七以上的那个数据,这个数据呢,你要对自己的数据有了解啊,我们会知道它最大值的就是二零九啊,我这个数据最大值就是二零九,我直接把这个 其他改成二零九就可以了啊,我们来把它的小时点位给它做一个缩进啊,好, 把小时点位给它缩进来。 text 说这现在就会更加的正常一点啊,这样小时点位太多了,就乱挤在一起啊,现在我们稍微修饰一下它点任何一根柱子, 打右键,设置出一系列格式,在右侧把它的菜单调出来。调出来之后呢,我们把间隙宽度拉到零,我们点一下这个颜料桶啊,在就填充与线条这个地方啊,找到这个边框啊,边框里面选实线,实线里面给他选一个白色啊,这样呢,我们就能够看清楚每一根柱子的轮廓啊, 在填充里边啊,选纯色填充,我们选一个比较啊,正规或者是商户一点的颜色啊,比如说深灰色啊,或者说是浅灰色啊,稍微浅一点啊,这样我们这个纸方图啊,大概的这个样子就出来了。 出来之后呢,我们现在在做什么曲线,我们需要在这个地方,就在它右侧啊,这边这一列紧挨着频率这一列,我们来做一个数据啊,等于稍等一下啊,我们还需要去到 前边的数据里边啊,去做几个值啊,前面数据的几个值,我们首先要做一个均值,这个地方呢,是等于我们回到前边的这个数据, 我们看一下,是从 f 二看,这是下降点, f 四啊,是这样的一个值啊,一百八十点零四九啊,还要做一个标准差,标准差呢,等于 s t, d, e, v 啊, 我们算三泡 e v 点 s 啊,我还是上一页,我们再回到这个数据区域, 再次选中我们这个原始的数据啊,从 f 二开始, ctrl shift 下箭头回撤,这样我们得到它的标准差啊,这两个键有了之后呢,我们在这个地方啊, 等于 norms, 用这个函数啊,用这个函数 normest 啊,它的第一个数值呢,我们取我们接收区间的第一个数啊, a 二啊,第二个数呢,取这个均值 f 二, f 四,把它锁定, 第三个数来取这列差啊,我们取这个 f 三,再把它锁定。最后呢,它是让我们决定是要累积概率的分布还是概率密度的分布, 累积分布的话,从百分之零到百分之百啊,那个不是我们想要的啊,所以我们要选 false, 叫概率密度啊,所以选零就等于 false, 这样我们来回车计算第一个值,填充到底,就把整个的概率密度啊,把它算,计算出来,就针对我们整个的,从最小值到最大值之间啊,把它整个概率密度分布计算出来,计算出来之后呢,我们选中复制,点一下这个图标啊,点一下脂肪图,图标打右键 是粘贴啊,粘贴进来之后你发现已经有变化了,有变化之后呢,系列二已经进来了,但是我们看不到,因为太小了,我们在柱子上打右键啊,更改系列图标类型到这个界面来,把系列二勾到次坐标轴,把系列二勾到次坐标轴,把它的复杂图形图呢改成折线图, 看到这个形状已经出来了啊,点确定?这样其实我们就已经看到了我们的正态的分布的曲线啊,双击一下这条线, 在他的这个线条就是颜料桶这个地方啊,线条与这个边框的设计,这个地方底下有一个平滑线啊,我们勾一下这个平滑线,它就会变得比较平滑,这样更好看一些。剩下的什么颜色呀,这个粗细呀,自己去调就可以了,都在这个菜单上 啊,这样呢,我们就有了植帮图以及他的正态分布的尼克曲线就做完了。好,接下来给大家分享到这。
636数据分析精选 22:37
 05:35查看AI文稿AI文稿
今天我们给大家介绍一下用 excel 来制作这样一个正在分布的 get value 曲线,用到的公式是 normal distribution 这个公式,嗯,它有四个参数,我们一边用一边介绍这个正在分布曲线,它其实是一个散点图, 我们模拟生成一个标准状态,分布下 x 轴的值,从负六到正六的这个值。为了让数据点稍微多一点,我们每隔零点二设一个点,第二个点是五点八,这样拉下来,每隔零点二生成一个点,生成从正六到负六的 x 轴对应的值。 我们要求的是每个 x 轴值对应的曲线上的 y 轴的值。 正态分布的中心曲线,它其实是叫 gradient 曲线来的,这个函数叫 normal distribution, 它有四个参数,第一个参数就是你要求哪个 x 轴对应的 y 轴的值,呃,第二三个参数对应一个正态分布,正态分布用一个括号来表示,括号里两个数字,哎,代表这是一个什么样的分布,呃, 第一个参数代表均值,第二个参数代表标准差,那零一就代表均值为零,标准差为一的这样一个啊。正态分布, 我们求这个正态分布的 x 周围为负六的时候,它的值。第四个参数叫概率密度,这个以赛公式,它对应的数线上两个函数, 当它为 false 的 时候,它才对应概率密度这个函数,哎,也就是中性曲线上唯独的值,哎,这样的话,我们就求到了负六这个值的概率密度啊。双击,我们把公式拉下来,就求到了每个点啊,对应的 站在分布上的外周上的值。我们用这样的一个 x 值和外值做一个图,我们要用到的是这个散点图, 这上面的每个点就对应着我们表里每一行的数据,比如说负六, 这个点就代表 x 等于负六的时候, y 轴等于多少零这个位置就比较容易看出来,它接近零点四,它是零点三九八九, 所以这个三点图对应了我们刚才生成的数据。但像我们是想要一个平滑的曲线,我们改一下数,做图标的例行,改成一个带平滑曲线的三点图,这个图呢,就是我们最终想要的那个平滑的曲线。我们改一下外轴的数字格式, 保留一个小数点,再改一下 x 轴的位置,负六正六啊,间距是一,那把六个点都显示出来。再改一下图片的 布局,简约一点的一个布局,再加上一个标题,图标的标题,这就是我们要的正态分布,正态分布的概率密度曲线。我们知道在正态分布当中,标准差变小意味着图形变尖、变陡, 我们再做一下标准差变小的啊,这样一个图,在第一个参数前加一个 dollar 啊,这样我复制公式的时候引用的位置就不变了, 我们把这个位置改成零点八,求均值为零,标准差为零点八的该灵敏度,这样我们就得出来了啊,这个所有的 x 轴的值 啊,我要把新的数据添加到这个图上,选中这个图,然后调整做图用的数据的范围, 把新的这列数据包含进来,这样我的图上就增加了一条均值为零,标准差为零点八的曲线啊,颜色是橘色,可以看出来橘色的曲线变得更尖了, 那标准差变大的时候呢,就是相反,它又变得更扁了。我们也演示一下,求 x 轴每个点对应的均值为零,标准差为一点二的概率密度啊,这样我就求到了新的一组数据, 同样是选中这个图,调整作图用的数据范围,把新的这一列数据也添加进来啊,在图上已经出现了 啊,增加了一条均值为零,标准差为一点二的曲线,是灰色的。这条曲线啊,可以看得出来,他是变得更扁了。在正在分当中,均值变大变小,意味着图形左右偏移。我们也演示一下, 再增加一列数据,这一次是均值由由零变成一点五啊,标准差还是保持一双击公式拉下来我们就得到了啊,均值为一点五,标准差为一的每个点的啊概率密度值。 同样,我们再继续选中这个图,调整做图用的数据范围,把新增的这一列的 数据做进来啊,可以看得出来,我们已经把均值为一点五,标准差为一的这个曲线做进来了 啊,想又便宜了一点五个 c 个码。如果这时候你有规格线的话,你就会发现右侧的不良明显增加了,这个就是我们要做的这个正态分布图。
76督导君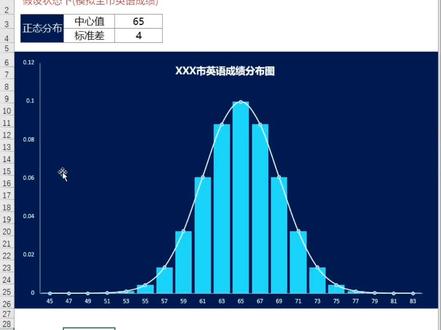 02:52查看AI文稿AI文稿
哈喽,大家好,今天给大家分享的是用 excel 绘制正态分布图,例如我们模拟一个诠释的英语成绩分布情况,那就可以利用 这个正态分布图,它其实是一个组合图,柱形图以及折线图组合而成的,那我们只需要知道两个数据就可以模拟了,第一个是中心值,我这里设定的是六十五,标准差呢是四。 那首先我们理解了这个数据之后呢,我们开始来模拟,首先呢,我们可以定义,比如说几组数据,我这里的话呢,随意的设置了二十组数据,接着呢在组句当中呢,我们可以从四十五开始,或者是其他数据都可以, 并且它的一个间隔呢是二。那接着在概率这里的话呢,我们需要用到的是这个,喏,这个函数啊, 那这个函数的 x 这个值呢,就是第一个组句,接着呢第二个参数是中心值,其实就是一个,嗯,中数,或者是说平数啊,那第三个数呢,就是一个标准差, 那最后一个数据就是说我们要算的是概率密度函数,所以呢选择的是 four 四,补充又括号就可以了。接着呢,双击下拉填充, 那我们选中这两组数据,点击插入 三点图,找到第二个三点图,然后呢,现在呢,只有一组数据啊,得到的不是我们想要的,所以我们需要再次添加一组数据,直接点击图表设计当中的选择数据, 在编辑当中呢,我们添加,然后系列名称,依然选择概率 x 轴,我们选择的是组句对应的一个数据,那外轴对应的是概率所计算出来的值 确定,那又由于两组数据呢,它的类型是一致的,所以已经重合了,需要更改图表类型,找到组合图,然后选择第一个选择确定就可以了。那接下来的话呢,只需 需要对数据以及图表呢进行二次美化,那美化部分的话呢,会 略过啊,大家呢可以自行根据自己的一个风格来进行美化。那今天的分享呢,就到这里了。
1720AI职业技能【培训+考证】 05:00
 03:28查看AI文稿AI文稿
如何绘制正态分布曲线?哈喽,大家好,我们今天讲一下如何绘制这种正态分布曲线图。我们的数据区域是某公司的阅读绩效考核分数,我们需要根据这个数据区域 统计出每一个区间内的人数,然后绘制出这个人数的分布图,最后绘制出这个人数的正在分布曲线。 我们将分上下两集来讲解这个案例。上一集我们主要讲如何按照指定的区间统计出每一个区间有多少个人数。 这里说一下这个区间的含义,这个区间是指大于等于八十,小于等于八十四这样一个范围,其他同理,比如这个是指大于等于九十, 小等于九十四。我们看一下原始数据,首先我们在拿到数据之后,先观察一下原始数据,我们发现这个数据他的左上角有一个绿色的帽子, 这个我们之前讲过,这种绿色的帽子其实说明这个文字它不是常规的文字,它是一种以文本形式存储的数字,像这种文字它是不能立为统计的,所以第一步我们需要将它变成常规文字。我们将所有的数字选中, 然后点击这个叹号,选择转化为数字, 然后我们现在已经提前呃分辨好了这个区间,我们需要列出每一个区间的临界点, 我们这里只需要列出右侧连接点,六十四、九十九、七十四、七十九、八十四、八十九、九十四,这样就可以了。我们一共有 八个区间,只需要有七个零点零就可以了。这时候我们将这个单元格区域全部选中,记住一定要全部选中,然后输入等号,然后输入我们的 freeprint 函数 f, r, e, 输入三个字母,然后 entable 选择第一个参数从 b 二,我们选择一个单元格,然后 a 加, ctrl shift 加,按下箭头, 输入一个逗号,这时候第二个参数,我们选择这个区域, 然后再输入诱惑号,当输好之后,不要着急按回车,我们按住 ctrl shift 加回车,看到没有?当我们按下 ctrl shift 加回车之后,每一个区间对应的人数 就统计出来了,我们可以验证一下,比如说大于等于七十五,小等于七十九,这个范围我们可以筛选一下, 然后数字筛选,介于大于等于七十五,小于等于七十九,确定可以看到在六十八条记录中找到八个,我们取消筛选, 确实是八个。好了,你学会了吗? nice。
1105码字小马达 11:40查看AI文稿AI文稿
质量人经常需要对一些数据进行分析,有时不一定需要实际测量的数据,只需要一些符合条件要求的数据进行模拟分析,这些数据不仅要符合尺寸要求,可能还要服从正态分布,甚至是特定的标准差或 c、 b、 k, 如果只能自己手动一个一个编,那就太费事了。这期视频就分享如何快速的生成一些符合特定条件的数据组,不多话进主题,其实要生成符合特定条件分布的数据并不难, x 或一些专业的统计分析软件都能做到。 这期视频分成有钱的跟没钱的做法进行说明。先说有钱的做法, mini tab、 jmp pro、 spss 等专业软件都有提供生成随机数的功能,就以 mini tab 来说,假设要生成一组随机正态数据,只要到功能区中的计算 功能找到随机数据,并选择正太,然后在对话窗口中输入相关的条件设置即可。 先来生成一组有三百个数据且平均值五点零,标准差一点零的随机正态数组,来看一下这组数据的正态检验,其实这有点多此一举,身为专业软件,生成的数据如果无法通过检验,岂不可笑? 另外,看到基础的序数统计均值五点零五,标准差零点九七,并不会完全与设置条件相同,只能做到尽量靠近, 顺便看一下过程能力的指标。 cbk 是零点六五,如果没有特殊用途, cbk 的值并不重要。但若要特定 cbk 值的数据组进行模拟分析时,那要如何处理? 假设现在有个五正负二的尺寸规格,所以规格上下线就是七跟三,希望生成的样本分布中心跟规格中心重合,也就是样本平均值是五,那标准差该设置多少才能生成一组 c、 b k 符合要求的数据? 这是大家已经很熟悉的 c b k 公式,公式里面共五个未知数,规格上线 u s l 规格下线 l s l 样本均值 x double bar 标准差估计值 sigma 以及过程能力 c b k。 值刚刚的假设规格上下线 让本君值都已知, c、 b k 则是看要求给定,因此只剩下标准差是未知数。这样只要简单的把公式进行推导,就可以知道标准差的公式。先讨论双边公差的部分,为了方便 推导公式,再假设样本均值无偏移,就是样本均值 x double bar 等于规格中心,这样的话,规格上线减样本均值就等于样本均值减规格下线令它等于 s l。 所以 c b k 的公式就变成,但是要除以三倍的标准差。接着等号两边都乘以三。再来是把等号右边的分母与分子的三倍上下相消,就变成三倍的 c b、 k。 等于,但是要除以标准差,然后等号两边都乘以标准差, 就可以把等号右边分母的标准差消掉,变成三倍 c b k。 乘以标准差等于 s l。 接着把三倍 c、 b k 移到等号右边,就可以得出结果,标准差等于 s l, 除以三倍 c b k。 所以在样本分布中心无偏移的条件下,标准差等于 s l, 除以三倍 c b k。 最后看到,若样本均值不等于规格中心时,把 s l 换回来,就是 s l 等于规格上线减样本均值,或等于样本均值减规格下线,因为计算 c、 b、 k 只有用到这两个其中一个较小的值,所以就可以写成最后这样。 假设需要一组 c、 b、 k 一点三三的随机正态分布数据,就按这个推导出来的公式来计算需要的标准差,只要使用 many 函数套用公式即可。 计算的结果,标准差零点五零一二,改变一下,样本均值为五点二零,其他条件不变之下,标准差需要变成零点四五一一三。接着用这个结果到 mini type 生成一组随机正态数据, 再用这组数据进行过程能力分析,可以看到,平均值标准差 cbk 虽然没有与要求的目标值完全相等,但也非常接近,因为软件只是根据设置条件进行估算,基本上很难得到完全相等的结果。如果要得到非常接近目标条件的数据组, 可能需要经过多次生成数据找到最接近组。接着看让人头痛的单边公差问题,把原先的规格要求改成单边有上限的规格。这里看到,当规格下线被改成五之后,标准差变得很小。那是因为目前计算标准差的公式 是从计算双边公拆 cbk 推导过来,在规格上限与样本均值差及规格下限与样本均值差这两者之间取交小值。把规格下限改成 乘五之后,就会让原本的计算 cbu 变成 cbl, 但有上限的单边公差只能计算 cbu, 所以可以把规格下线的值改成与规格上线相同,等于让公式只能计算 cbu, 但这样计算的结果会出现复数, 所以需要在计算标准差的单元格中,在原本的函数前面再加上 abs 函数,就是让单元格显示计算结果的绝对值。但这样的结果跟前面双边公差是一样的。 因为尽管可以推导出标准差,但无法限制随机生成的样本分布范围,所以生成的数据中会有一些超规格线的值。 因此想要在 c、 b、 k 或标准差不变的条件下生成在规格线内的随机正态数据,只能想办法把整个样本分布往融差中心移动, 这样只能不得已采取折中的方式,就是在相同的规格容差条件下,把单边公差改成双边公差。这里就是把规格要求改成六,正负一点零,规格上限维持原来的七, 规格下线变成五,然后把样本平均值尽量往新的规格中心靠近,或直接等于规格中心。也可以一样用计算的结果到 mini tab 生成一组随机正态数据, 再用这组数据进行过程能力分析,可以看到平均值标准差 cbk 也非常接近设定的目标值。然后样本分布并没有超过六正负一的范围,也勉强等于是原先单边公差的范围。 因此遇到要生成单边公叉的随机正态数据,就只能选择这种折中方式处理。如果各位 有更好的方法,欢迎在评论区留言建议。以上分享的是有钱的做法,但万一遇到老板打算换车买房子,不愿意花钱买这些专业软件,那就只能选择没钱的做法,便宜的笑或 wps 同样也可以做到这些功能。 先在 excel 工作表中先把设定条件改回原来的双边规格。先介绍第一个函数, r a and d red 函数可以在单元格中随机生成一个介于零到一之间的数值。 如果把这个函数稍加变化,在 run 函数后面乘以某个数值,就会变成在单元格中随机生成一个零到这个数值之间的数值。例如,在 run 函数后面乘以 七,那就会在单元格内随机生成一个零到七之间的数值。如果再进一步做些变化,让 ren 函数加上某个特定数值,例如三加上 ren 函数乘以四,这样就等于三加一个零到四之间的随机数。 结果就是会产生一个介于三到七之间的数值。但 ran 函数生成的是平均分布的随机数,如果生成的数据量够多,就可以容易的看出来数据是呈现均匀分布形态。 如果要生成的是随机且呈现正态分布的数据,就需要使用 normal 函数。使用 normal 函数需要提供三个参数,第一个参数是正态分布的概率,第二个参数是平均数,第三个参数是标准差。平均数是决定 生成的正态分布数据的样本分布中心。标准差是决定生成的正态分布数据的区间宽度,概率则是决定生成的数值在正态分布区间的位置。例如,概率越靠近零或越靠近一生成的数值越接近正态分布两端的位置, 概率零点五就会生成落在正态分布中间的数值,基本上就等于设定的样本均值。 样本均值与标准差在工作表中已经有,可以直接填选代率,这里先填入零点一。按前面的说法,代率越接近零或一生成的数值越靠近分布的两端零点,一是往零的方向靠近, 所以会往分布的下线靠近,以这里的案例,应该是会往三的方向靠近。由于刚刚输入的概率是一个固定值,所以复制工是到其他单元格 格产生的数值也是固定的。如果要生成很多数据,这样做就的逐个单元格更改概率值实在是太麻烦了。回到 normal 函数的对话窗口,可以看到下方的说明,概率参数是介于零到一之间的数值。 前面介绍的 ryan 函数刚好可以随机生成零到一之间数值,那就把 ryan 函数填入概率这里, 这样就可以利用复制粘贴的方式,快速的生成很多随机正态的数据。 因为概率是由 rain 函数决定,所以生成的数据位置也是随机产生,并不会依序排列。如果想要直接生成依序排列的随机正态数据,就必须对函数 的内容进一步修改。首先设置一个需要的样本数量,再回到 normal 函数的对话窗口中。这次利用 row 函数来设置概率, row 可以返回单元格的所在行数,随着单元格越往下, row 函数返回的数越大,因此概率也会越大, 这样 normal 函数就会随着单元格往下生成生序排列的随机正态数据。复制之后似乎有点问题, 确认一下函数的内容,原来是样本数量的单元格。第五没有写成绝对引用,这样复制公式时,其他单元格里面的公式就不会是引用第五。要改成绝对引用,只要在公式内的第五前面加上前符号, 或者在公式中鼠标点到第五的文字,再按下键盘上的 f 四,就会自动加上前符号。接着再从新复 布置公式到其他单元格,这次就没问题了。可以看到生成的随机数据是由小到大依序排列,且呈现左右几乎完全对称的正态分布。 最后是单边公差的随机正态分布。跟前面谈到使用 mini tab 生成随机正态数据的处理方式相同,直接改成双边公差的规格,然后把样本平均值尽量往新的规格中心值靠近。 以上就是使用笑生成随机正态分布数据的方法,学会了这个没钱的做法,就可以帮公司省下一笔买专业软件的费用,也可以帮老板更快的把五菱宏光换成大奔。 最后要声明的是,请正确且正当的使用这些数据。
363Aron 02:49查看AI文稿AI文稿
两分钟教会一个统计学思想。今天我们讲中心极限定律。先做一个掷骰子的实验, 掷一个骰子一到六,每个数字出现的概率都一样,是均匀分布。但是如果掷三十个骰子,然后算它们的平均值,重复很多很多次,你会发现这些平均值的分布变成了正态分布,这就是中心极限定律的魔力。 中心极限定律的核心思想是什么?无论原始分布是什么形状,只要你从中反复抽样计算样本均值,这些均值的分布就会趋向正态分布,前提是样本量要足够大,通常要求 n 大 于等于三十, 不管原始数据长什么样,结果都一样。均匀分布。指数分布,两项分布形状各不相同,但只要反复取样本均值,下面这一排全都变成了正态分布。这就是中心极限定律最神奇的地方, 样本量越大,效果越明显。 n 等于一的时候,还是原来的指数分布,歪歪扭扭。 n 等于五,已经开始有中型的样子了。 n 等于三十,已经非常接近正态分布了,从乱七八糟到完美中型,只需要增大样本量。 为什么中心极限定律这么重要?第一,致信区间。估计总体均值的时候,可以用正态分布来计算区间。第二,假设检验 p 值的计算离不开正态分布的假设。第三,大样本推断。 不管总体是什么分布,样本够大,就能用正态方法,它是整个统计推断的理论基石。 生活中到处都在用中心极限定律,工厂质检抽检一百个产品,取平均就能推断整批产品的质量。 民意调查随机抽一千个人样本本均值,推断全国的态度,金融风控,大量交易取平均来估计风险。关键是你根本不需要知道总体分布长什么样。 使用中心极限定律要注意几点,第一,样本要够大,一般要求 n 大 于等于三十, 如果原始分布偏太严重,可能需要更多。第二,要独立抽样,每次抽样之间不能有关联。第三,原始分布的方差要有限,不能是无穷大。 记住一句话,样本够大,军值就是正态。不管原始数据长什么样,取够多的样本均值,结果一定去向正态分布,这就是统计学最强大的定律之一。
 01:51
 00:37查看AI文稿AI文稿
绝不能让导师发现的 ai 数据分析神器就是这个恰当 s r s。 我 们只需要在这里上传数据,然后和他对话,让他帮我们进行正态性检验,他就直接根据我们的要求进行了正态性检验,生成了相应的三线表, 这个三线表里面包含了我们需要的偏度、风度以及 p 值,全部在一张表格里,而且这张表格是标准的三线表格式,是可以直接复制粘贴到我们的 word 或者 excel 当中,进行二次编辑使用,后面还有相应的结果文字解答也是可以借鉴使用的。
227chat SPSS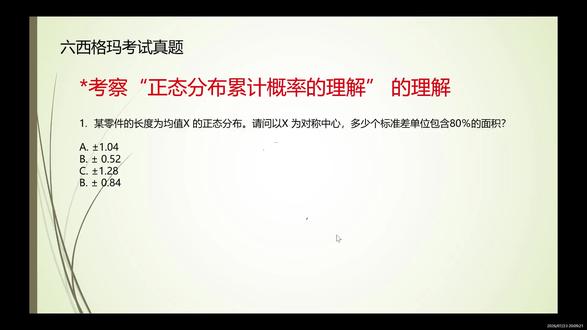 02:12查看AI文稿AI文稿
大家好,今天给大家讲解这道题,是关于正态分布的累计概率的一个理解。我们看一下某零件长度的均值是正态分布,请问以 x 为对称中心,多少个标准差以内 包含它百分之八十面积,所以说呢,呃,我们从正态分布概率图我们可以看到呢, 以以 x, 比如标准差的分布,以零稳者为中心,然后一倍标准差的情况下,概率是百分之六十八点二七。比如说一倍标准差一个四个码,两倍的标准差的情况下呢,我们通常是百分之九十五点四五, 九十五点四五啊,这是六十八点二七。一倍标准差两倍标准差是九百分之九十五点四五三,三倍标准差呢是百分之九十点七三。所以说呢,这一题呢,我们 包含它百分之八十,比如说它的概率是百分之八十的情况下呢,我们可以看一下,它肯定是大于一吗?我们对应的 z 值肯定是大于一的, 但是呢,我们一般大于一小于二嘛,我们通过一倍两倍的区别,我们可以看出它的概率百分之八十介于一到二之间,所以说这一题呢,就是一点二八。当然呢,我们可以通过查正态概率的一个分布表,我们可以比如说我们 p, z 属于一个 x, 比如说到 y 之间,然后等于零点八,我们可以去查表啊,约约等于呢,基本上就是 此时的 z 值呢,就是一点二八,也对应着我们的 x 值,我对于标准正态分布而言,我们的 x 值就是一点二八。所以说这一题呢,选择 c 这一题呢,考察大家对我们常用的正态正态分布累积概率的 理解,我们要记住我们一倍,比如说,呃,一倍标准差情况下我们是概率多少?两倍以及三倍情况下我们就可以通过这个呢去去判断。我们实际比如说我们给一个百分之七十五或者百分之六十情况下,我们大概是什么范围?我们对应的 z 值是多少?
 07:21查看AI文稿AI文稿
今天我们来讲解一下统计与概率学中的正态分布,正态分布是统计与概率中三种分布中比较难理解的一种,这三种分布是二项分布、超级核分布以及正态分布。 那么今天我们就来讲解一下正态分布。首先来了解一下他的这个曲线,正态分布的曲线大概是这个样子,那么这条曲线是怎么来的呢?首先我们可以画出一个柱形图,这个比如说他就是 一次高二某次数学考试中学生的分数关系,那么 零分的同学是比较少的,一百五十分的同学也是比较少的,那么平均分呢?在九十分,也就是很多人都在九十分这个大概这个区间内,所以画出柱形图大概就是这个样子, 我们把终点连成了这个线,划出来大概就是这样的一条曲线。那么不光是数学考试中人们的分数关系, 包括女生的平均身高是一米六五,然后一米三的人越往一米三靠近他就越少,越往一米八靠近他也越少, 然后包括体重,嗯,还有其他的一些成绩啊,嗯之类的东西,很多都是符合这个正态分布的。那么最终我们来到这个图像上,首先因为这个公式我们大概要了解一下 公式大概是这个样子的,那么其中呢有两个比较常见的值,一个是 mu, 一个是 sigma, 那 么我们现在就来了解一下这个 mu 和 sigma 它到底是什么?首先这个 mu 呢,在这个图像中就是它对称轴所对应的值, 比如说这个图像中对称轴所对应的值就是九十,那么这个缪呢?就是九十,那么 sigma 是 什么呢?比如说 sigma 越大,那这个图像呢?它就越平缓, 但是不管这个图像是怎么变化的,它大概围成它与这个坐标轴围成的面积大概都是相同的,然后呢这个 sigma 越大,它这个图像大概变成了这个趋势,然后 sigma 越小, 它图像就会变得越陡峭一些,所以 sigma 对 应的是图像它这个变化趋势。 那么在看某每一个图像的时候,我们都需要先看这个图像的,嗯,横坐标和纵坐标,对吧? 那么这个 x 横坐标对应的就是我们所需要考虑的这个自变量,嗯,也就是说,嗯,比如说这个是分数,那么女生的身高,那么就是身高,体重就是体重,那么 动作不要歪是什么呢?动作不要歪是频率。嗯,好的,那么我们现在去了解一下这个面积所对应的这个数值是什么?比如说我们再画出一个曲线, 比如依旧是嗯,这样的一个正态分布的曲线,那么还是我们数学成绩大概在九十分是平均分,然后最高点, 比如说我们画出这个是一百三,然后 在九十到一百三之间的这个人数,他的概率大概是零点四,那么从九十到一百三是四十分。 如果我们往前推的话,从九十再往前推四十分是五十分,那么五十到九十这个区间内, 他的得分的概率也是零点四。这就是我们正态分布中一个非常重要的一个性质,就是当 两边是相同的分数区间的时候,就是比如说呃是九十到一百三,或者是说他的这个身高是一百一米六五至呃一米三五, 然后那他们前面的那些是相同分数区间,或者相同区间内的这个人数大概也是相同的,也就是说频率啊,不是这个概率也是相同的,那么我们最后可以写出来这个 p 是 就等于零点四,然后同理 也是零点四,那么由于整个面积是一,所以我们可以知道这个大于零点,大于一百三的这个人数, 然后它所对应的这个概率就是零点一, 然后小于五十的这个概率也是零点一,所以大概这个得出的这个频率呢?嗯,还有大概这个概率呢,就是我们所写出的这些,那么 我们刚才说到这个零点三啊,还是零点一啊,也好,它都是概率,对吗? 但是其实呢,也可以说,如果题目中提到,比如说九十到一百三十六个区间内,它所对应的这个面积是零点三,那么它的概率就是零点三,它的面积是零点四,它的概率就是零点四。 那么最后我们再提到一个,嗯,比较常见的状态分布中所题目中所提到的式子,那么就是 x 这个波浪线,然后 n 这个波浪线 n, 也就是说明这个 x 它是符合状态分布的, 然后这个命就是我们所提到的这个对称轴,然后 sigma 的 平方就是我们刚才说到的这个正负。好了,那么我们今天的讲解完毕,明天我们要来写练习一道正确丰富的题目。


