citespace如何调整图谱

粉丝515获赞2166
相关视频
 03:28查看AI文稿AI文稿
有好多小伙伴在问我,如何让这些节点变成圆形,那么我们其实可以在这边调整,嗯,这边有个 no, 然后在这边 shape, shape 第二个里面选择, ok, 那他他就会变成圆形,那么我们其实可以让他这个变得更小一点,他这些这些节点变得更小一点, 嗯,可以进行一个大小的调节就可以了。嗯,那么我们再讲述一下这个,呃,这有一个时间图,时间线图直接点一下就好了,那他自己就会生成这样一个时间线图,那么我们可以在这个时间线图上做进一步的调整,这个可以调整大小。 然后这边呢其实可以调他的这个呢,可以调他距离,就是 这个标签距离,这个嗯线的一个距离,大家可以看现在是五十,我让他变得更近一点,大家可以看到他就会变得更近。那么嗯,这个呢,就是调他一个上下这个宽,就是上面这个线跟下面的这个线的距离,可以让他变得更宽一点,都可以,这是可以大家自己可以自行调整。 嗯,具体的细节的调整大家可以看网上里有很多很多的教程,大家可以在嗯进行详细的一个学习。 呃,我这个版本呢,因为他有点问题,所以在调的时候他有容易有些这些字体容易消失,所以我这里就不做进一步详细的演示呢。那么再接下来我们再看一下他这个,呃,有次图大概 可以点这个点好了之后呢,大家可以看,我们点一下 fries 他系统,他就自动生成,他是有二十三个,二十三个字条,那我们直接点点微用, 如果说我们想要更多,但是二十三个已经足够,一般二十五个已经比较多了,那如果你想要更多的话,你可以在这边数值进行设置,如果设置到零点六,然后你再点 refriends, 他是有八十个,但这个太多太多了,我根本用不可能列给这么多,我比如说点还是一点零好了,然后二十三个 我们的微友,微友就可以了。那么我们这边,比如说我们只需要前二十个,那我们就把就改一下数字就好了。 那这个图他是个什么意思呢?就是说他关键词啊,关键词他位于突变强度位于前二十,他的一个分布情况,大家可以看到他这个是按照时间线排列的,你看,嗯,就是说,嗯,这几年的时候, 他其实他是这些词,他的图片就是说,嗯,他的引用也是最多的,那么到后面,嗯,到中间这是这几个词,然后再到后面呢,就是这些词,就尤其是到最近这几年,可能是像体外呀,还有这个 q 们啊,肿瘤微生态啊, 嗯,微环境啊等等,这个可能是最近一两年研究的热点。然后我们到时候可以直接把它一个一种方式是直接进行一个 剪辑截图就可以,直接截图保存就可以。还有一种方式呢,就是说我们自己可以进行一个复制,把它全部复制下来,复制下来之后,然后放在 xl 里边,然后你自己再进行一个相关的呃编辑,或者直接把它再拷贝到这个呃味的里面都可以的。 好了,今天的分享就到这里,嗯,如果大家对我的讲课还比较感兴趣的话,嗯,请大家多多点赞、投币和收藏。嗯,你们的鼓励也是我继续讲下去的最大的动力。好的,谢谢大家。
291杨杨医生谈科普 04:43查看AI文稿AI文稿
今天给大家分享三倍使用教程,分三个部分给大家介绍,一、软件下载与安装。二、 web of science 结果的导入与分析。三、参数调整。我们先 打开软件下载页面,大家注意记得这个网址,然后点 download, 这有个计数器,稍等,等计数器到零的时候 会弹出一个保存框,这里可以选择保存位置。我这个地方建的有 d 盘,里面建的有 satispace, 点确定,然后点下载就可以了,这就是 软件的下载。软件下载完成后,我们双击安装包,点 next, 安装目录,保持默认,点 next, 点 install, 点费力,这样软件安装就完成。 satispace 项目分析需要用到三个文件夹,我们 先建三个文件夹,我在地盘先建一个目录,我取为 temp, 在 temp 下面建三个子目录, project input data 好目录建好了,目录建好了,我们来运行一下 satispace, 我们双击安装完的 satispace 的快捷方式,然后就开始了 satispace 的运行。 sally space 比较大,所以运行他需要一定的时间。运行完过后,我们点 english, 就是将菜单转为中文状态,我们点 origree, 然后我们这个地方新建一个项目,比如说我们设为 temple 项目,目录,我们指向我们刚开始新建的 底盘 temp project 目录, data 目录,我们指向我们开始新建的 data 目录,其他保持波热, 我们点 c, 然后我们要分析数据,必须将 vars 的数据首先进行转换,所以我们这个地方要点数据的输入,输出,输入目录,我们点我们刚开始建的第一盘 temp 铺庭目录,输出目录就是我们要分析的数据的目录,我们指向我们刚开始建的 d 盘太阳德塔目录。由于我们现在是没有数据的,所以我们首先需要到 worc 中去将检索结果保存在已经铺庭目录,我们将窗口最小化, 我们打开 vivo sens 主页面,这个前提必须是我们的学校已经定了这个数据库,所以才能打开这个页面。然后我们首先选数据库,我们只选 vivo sens 核心合集就是第二项。然 后我们选数据库,只选前两个,就是 sci 和 ssci 四段类型,我们选前四段。然后我们的检测词是一会微信里揣我信息,检索点四二七, 我们得到了一千零八十九个搜索结果。然后我们对年代进行一下限定,我们一般分析近十年的数,我们就选二零二四到二零一四十年的数据,我们点了一份限定结果类型,这个地方可以看到得到了五百七十九个结果。 我们讲结果导出点 export 点 t x t playing t x t file 就是纯文本格式。然后这个地方的记录数我们选一到三百,因为我们下载的 satispace 是基本版,他最大支持的数据数是三百,我们点 export 导 出导出的结果,我们就保存到我们键的底盘的 tamp input 目录点下载, 这样下载成功,我们再回到 satisface 运行界面,对数据进行输入输出转换,这边默认是 vars, 我们不动输入目录就是我们刚开始保存的 vars 导出的数据目录音谱输出目录就是我们等会要分析数据的目录,就是 d temp 推塔,我们将减速结果进行处理,点去重整理参数,保持默认不变点 star 选,我们呢?刚开始的减速结果就是导出来的减速结果,从这可以看到处理了三百条记录,没有重复数据点 cloud, 然后时间段 二零一四年到二零二四年是正确的,然后我们试着分析一下,选关键词,分析一下看点开,然后这里可以看到所分析的记录有三网 空间有三百三十六,但是我们的免费版只能分析三百,所以我们必须缩小范围,我们把年代缩到二零一六年点开始, 然后可以看到这二百三十九条记录,我们点可视化好,等他运行一会,然后我们点暂停,这样就得到了一个图,对吧?然后我们可以调参数, 我们说的第三部分参数我们调 sorry so 的,我们将它填一调小,就能显示出更多的关键词,我们可以将图形放大好,这就是塞利斯贝斯的基本操作,如果要用好,大家还需要不断的摸索。
790资源共享者 05:48查看AI文稿AI文稿
啊,同学们好,那今天我来给大家分享一下用此时区的突破制作的一些方法。首先呢我们还是去找到我们这个,找到我们刚刚做的一个文件,然后我们可以去找到我们的控制面板,去找到我们的来 out 这个选项, 找到我们的可视画,打开这个选项,我们看到时间线之后呢,一个是是去图,按下这个是去图,他就能显示出我们的具体信息,这个刚开始的时候还是需要我们调节的,然后我们需要逐渐去调节这张图, 把它调小一点,显示的全面一点。调完这张图之后呢,就是我会发现它整体颜色不太明显,对吧?我们还是找到我们的控制面板,通过这个 线条的这个连接线颜色,把它整体颜色给调深一点啊,这样大家就能够看清了,我是把连接线颜色调到最高了。然后呢我们还是通过上下左右 把这张图给整体的给调节出来,这张图不像时间线,就他上面的对应连线,我们可以没必要管他,因为他因为因为这张图呢, 他下方呢是有他的显示年限的,所以我们只看一个就 ok 了。那我们还是整体把这张图给调节处调节好。 这张图呢整体上是比较难调的,就他可调节起来比较麻烦, 慢慢的一点点放大, 是把它给慢慢的调大一点, 大家调这张图要足够的耐心,就类似于这样的,调节完之后呢,它关键词没有显示出来,我们还是找到我们的控制面板,找到我们的标签,我们需要把我们的控制面板呢,这个纸调的越小纸越多吗?然后我们把我们的这个字体给显示出来, 这张图呢,实际上大家在做的时候呢,出现问题会很多,因为他会存在 很多重叠,他会密集的在一个区域显示出来,我们需要进行对的人人工的拖转。我觉得字体颜色有点小,字体有点小,把字体的字体调大一点, 嗯,还是太大了。 好,现在就 ok 了。调完他之后呢,还是他的字,字体的颜色呢,还是有点需要调节的,我们还是去找到我们的 label label, article label, 然后去找到黑色,去把它调成我们需要的颜色。实际上我们在做的时候呢,你们会经常出现一种情况,就是我在做的时候不同图呢,它的一个阿力 labor 和 tim labor 颜色会变化,而有时候呢,你们可能会找不到具体的位置,没关系,你们这个阿 tgo labol 和 tim labor 记住一个就 ok 了,你们就是来回尝试这个呢,他就在 tim labor 里找到 tim labor 呢,我们还是去找他的这个背景颜色 brown 的,去找到他这个 team label, 然后把这颜色给调透明 啊,透明呢他就显示出来了,显示出来之后呢,这张图呢,我们是调节,就是在设置方面是完成了,剩下的就是脱图了,我们就慢慢的选中他,选中这个词的中心位置,慢慢给他 拖出来,出来,然后按一下他就大家一定要记得一定要选这个土的终点,就是原点,拖的时候呢是就是问题会比较多,就是你拖不重,有可能就选不重,就是你,大家可以慢慢的有耐心的慢慢尝试一下, 去,慢慢选中他,就选中一个,在按到空白为止,他就会慢慢选中他了, 是慢慢的选中他。大家在脱的时候呢,也不能随便脱,因为大家要看到啊,这张图呢,他看到他是有二零一八年, 二零一,二零一七年,二零一六年,包括二零二零年,他是每一年呢是有对应的,他的这个就像我鼠标一只 s 轴这样的一个歪轴,这整体的一下来,他是对应的年限的,大家呢就是 他对年份呢也不能乱拖,因为这样就不科学了,所以大家要还要尽量耐着性子,就是按照这在他的这一条直线上慢慢的拖拽,整体上是就是他保之后呢,这如果等你拖拽的拖拽到你觉得满意的位置,这个时候呢,就这张图就是你就可以, 呃,相当于做好了,大家保存方式呢,也是菲尔这边一个 sizespng, 这是原图的保存方式,我个人认为他原图的保存方式呢是不够清楚,而我一般呢都是用微信自带的一个 shifta, 就是给它保存出来,因为微信呢我感觉会更清楚。 然后呢,这就是这个图的一个整体的一个做法啊,大家剩下在做的时候呢,还有什么问题呢,可以在评论区或者私信我交流。
82质性分析 04:04查看AI文稿AI文稿
朋友们好,今天我来给大家分享一下关键词时间线图谱的制作。关键词时间线图谱呢是在关键词剧烈的基础上做生成的,所以我们在做关键词时间线之前呢,要把我们的关键词剧类给完成完成,那我们首先还是先做我们的关键词剧类 还是紫色葡萄,再按一下我们的 k, 从关键词剧烈之后呢,就是怎样再不进行关键词剧烈的条件生成之后呢?我们找到我们的控制面板, 关键词时间线的做法呢,在这个烂 out 这里我们点这个烂 out 这边有个可视化,我们去找到我们的这个 time 烂时间线,去按一下它,然后这就是会显示出我们关键词时间线这张图呢, 总体来说是需要调节的,然后我们首先把大小给他调节一下, 就是你要把整体的所有的信息给他显示出来,还是进需要进行一下左右的拖拽的,大家看我鼠标位置,我就把他在右边的一些信息给他显示出来, 但是不能大家要注意一下啊,他这我们时间是是这个关键词时间线呢,他是一个立体的坐标,他这边呢有对应的年限,还有对应的对应的年限,关键词对应的年限, 然后还有呢就是我们的一个具体的就是关键词对应的年限,还有我们的这这个 关键词呢,对应的有句类,它显示出来就是这个句类的包含的关键词,它的研究进展就这样的一张图,然后我们把所有的内容显示出来之后呢,然后呢我们这张图呢,它黑白比较丑,是吧?我们需要进行一下关键词的图谱的调节, 我们首先呢看我鼠标位置这边有个彩色的底色,我们把它底色呢去调成我们想要的白色吧。 有时候你们会经常出现一种情况,就是我直接按白色,他没反应,你可以再按一下其他颜色,再按白色就反有有反应了, 然后摁完白色之后呢?然后我们还是继续调节图,我们发现这个字体的颜色啊,整体啊是这个其他什么颜色都有,不太合理,我们还是把它给调出 成我们想要的黑色,我们还是去这个 label 这一条找到这个 label, 找到我们想要的 article label, 然后去找到我们的黑色。 黑色之后呢?黑色之后呢,大家会觉得它字体有点小,我们还是去找到这个开了麦普 labo 这边的 labour 这里,然后我们把它这分三四,把它字体调大一点 啊,调到我们想要的大小。调完之后呢,哎,这个整体就好看美观很多了。然后如果说你要对剧烈的颜色,包括他的框架调呢?包括他的模,就是背在阴影部分调呢,也是同样的调整位置。我们呢去找到我们的这个这边的 雷宝卡乐有个剧类雷宝,然后我们去把它调成我们想要的颜色,调成我们想要颜色之后呢,我们把 他们的标签给调到,也是去找到这个标签背景这边的一个剧类的一个东西,剧类的东西我们找到这个 ssssl, 把这个透明度调到最高, 然后这张图呢就生成了,然后这张图呢,呃,他总体上是需要我们调节的,通过这张图呢,我们是能够看出来就是我们做成的剧烈,这个假如这个价值,这个剧烈 他是包含了什么关键词?他的关键词从不在不同年份的研究进展分别是什么?然后我们能看出一个具体的比较立体的三位的三位坐标的信息,这就是我们关键词时间线啊。今天的分享就到这里了。
347质性分析 03:53查看AI文稿AI文稿
还有就是这个标签不连续的问题,比如说我们这关键词呢,我们给他做个剧类,我们点这个像像葡萄一样的这个点一下选择 k 就是 kos 关键词,以关键词进行分类 好了,那他会出来这样一个,嗯,他自己默认那个,这样我们再点一个 lr, 这个是对他剧烈的一个定义,就是算法。那出来之后呢,如果你觉得影响视觉的话,可以把里边的节点让他变得更小一点。 ok, 然后这是我们一个剧烈,大家可以看到他主要零零一二三四五六,其实他都有,但是在有些情况下,我们可能这个节点他没有显示,但是在有些情况的时候,可能他的节点并不是 非常连续的,他可能是零三六七等等像这样的情况,那这是什么原因呢?主要是因为这边点这个飞舞塔,飞舞塔是过滤的意思,那么他这个节点 他这个剧烈呢,他会把一些出现的比较离散的啊,这种剧烈呢,他会让他进行隐藏消失,那我们点一下,点一下就是把这个过滤取消掉,那我们再重新剧烈一次的话,他就会显示齐全。 我这个因为我这个距离他是刚刚好的,他都显示的比较连续的,所以不存在这个问题。尤其是大家在用大量的这个数据进行分析的时候,可能就会存在这样的问题。就 大家有的说点这个 k 之后剧烈全部消失,我一般推荐大家尽量还是点,因为版本不一样,所以有的版本可能,比如说太早的版本可能会有这样的问题,但是 我一般推荐就是点这个,就是相机这个三,这个三种颜色,这个点他啊,那他他自己会自动生成这样一个剧类,而且也是我们,嗯比较直观能看的, 包括这边剧烈标签无法显示完整,其实也是在啊,这边也也可以在这边进行调节,就是让他剧烈标签显示完整,也是在这边进行调节。然后颜色的调节呢,大家都在这一块进行调节,你可以选择让他变颜色改变都可以的。 okay, 这就我们换了一种新的颜色, 那我们再点一下这个时间线图,因为现在他这个新版的他只有这两种, 就是两种模式,像大家之前讲的这个,嗯, kimevnyw 这个已经被被取消掉了,现现在只有这两种模式。 ok, 这个图线呢,我们可以让他稍微的图形尽量稍微缩小一点, 然后这里呢其实就可以对他节点进行一个调节,你可以让他显示更多或者更少,然后这字体大小都可以进行设置。然后这边呢 这边呢可以显示他这个的宽度,离散的宽度,大家在自己在进行,前面几期的视频我也有讲过,大家可以再进行调节,因为他这个反应起来还是比较迟钝的,如果你点的太快的话,他跟不上你的节奏的。 好了,那今天的分享就到这里,谢谢大家。
199杨杨医生谈科普 02:34查看AI文稿AI文稿
同学们,今天来给大家分享一下关键词突现这张图的做法。通过关键词突发性探测呢,我们可以发现某一领域 的研究,从微观到宏观,从单一到多元化的演变趋势,可以回顾或预测哪些关键词分支技术在什么时候成就了热点啊,甚至可以预测呀哪些关键技术在未来的一些研究的爆发性趋势。 然后我们回到软件里去探究一下如何去做关键词凸显这张图我们可以找到我们的控制面板,这边呢有一个巴特斯,我们按到这个巴特斯这边呢,我们可以看到啊,他有两个系数,这边呢就是他的干妈系, 这边呢是在干嘛系数,这边呢就是他的一个突线时间,干嘛系数呢的值呢是零到一,他这个值呢越小他出现的数量越多,这边呢是他的一个突线年限,他一边的都是一到一年或者两年,我们默认是两年。 然后大家可以看到他这个凸线呢,发现是零个,我们需要把它给调节出来,我把它调成零点二,按一下 refrus, 现在出现十九个, 然后我按一下 review, 然后再按一下确定这个呢就调就做出来了。我们关键词凸显这张图,我们直接微信 shifta 给他保存一下就 ok 了。通过这个关键词这张图呢,我们可以看出来就是我们的一些研究热点,就是在 假如比较这个词,他从二零一六年到二零二零八年,他的他的研究热度就比较高。然后呢我们可以看出来不同年间的他的研究热点, 然后甚至可以预测之后的一些研究热点。当然我们在做的时候会出现一种情况,那就是比较这个词不是我想要的,这个时候我该如何做呢?我是去 同样的做法,我是去这个关键词贡献这张图里,把这个我不要的这个关键词这张图呢,假如是比较去找到他,把他给删除掉,然后重新运行就 ok 了。 然后找到我们可以去找到我们的比较这个词,然后重新运行一下就 ok 了啊,这就是我们关键词凸现的做法。然后大家有什么问题也可以评论区私聊我。
170质性分析 06:00查看AI文稿AI文稿
今天给大家分享 site space 使用教程,主要分为四个部分,一、 site space 下载与安装。二、 jinki 减速结果的导入分析。三、 table mad 减速结果的导入分析。四、 site space 常用参数调整。 citisbase 的下载我们首先要打开 sitisbase 的下载主页, satisbase 还有三个版本,我们这里下载基本版,我们点击 satisbase base 口打开,在页面过后,大家不要直接点下载当漏的,因为这样的话 会把所有的十五个文件全下下来,比较大。实际上我们只需要下载安装包,我们 windows 操作系统的话,下载 satisface masi 这个文件就可以。点下载过后会弹出保存页面,我们选取一个保存目录,点保存 点下载,这就开始了。下载完成后,我们双击 sat space 安装包就可以开始安装了。弹出安装引导指南,点 next, 这里有个 sat space 安装路径,我们保持默认点 next, 然后点 install, 安装完成后点费力, 我们双击桌面上 satisbase 快捷图标,就开始了 satisbase 的运行,在运行时弹出这个框,我们需要将窗口最大化,然后在下面有三个按钮,我们点击英格里,它变为中文,表示运行菜单 就成中文状态了,我们点击或个瑞同意的意思,这样 set space 就运行起来了。用 set space 进行分析,需要新建一个文件夹,我们这里先做一些准备工作,新建文件夹,我命名为 temp, 临时 里面再新建三个目录, project data input, 我们回到 satispace 的运行界面,我们新建一个项目拍头,我们取为 temp。 加盟目录指向我们开始新建的 project 目录。数据目录指向我们刚开始建的 data 目录,选 cn 开或者外框语言,选中文,点 c, 我们进入 cn 开主页面,我们点高级检验所,选取片名,输入信息检验所,我们指定 时间范围。我们分析二零一三次二零二三年的文章点解锁显示我们选,每页显示五十条。由于 cts space 基本版是支持三百篇文献的分析,我们这里最多选三百篇,我们选三。 三百篇过后,点导出 ref workers, 点导出保存路径,点我们刚开始线的目录 input 存下载开的文章目录就保存在 input 目录下了。我们再回到 satispace 界面,点数据输入输出,因为我们是 c n 开的数据,我们再点 c n 开输入数据,就是我们刚开始保存 c n 开 文献步入的文件夹引步突出数据就是他转换为 satispace 能够分析的目录,我们这里选择刚开始新建贝塔姆默认是中文,点转换,这里记录显示 处理完成三百,然后我们这里新建项目艾特区为 tam, 那么目录让我们新建的文件夹数据目录只需要我们刚开始翻过来的, 这里数据该分开英文,时间跨度是二零一三到二零二三点,类型关键词明天要取消掉,我们点开始点可视化, 得到了需要的图形,一只显示了两个关键词,我们可以调节参数,后面也会讲,接下来我们看没得耐数据导出分析,同样我们在一排建一个目录 tmp 二,在 tmp 二下再加三个目录对他 input, 然后我们回到他不卖的那里信息检索这里得到了一千一百六十六个结果,我们这里点 ct two, 点 ctrl, 这个里面可以选结果,因为我们只超过三百条这一页, 它显示的是两百条,符合要求。我们点所有接本页的设计,点 creatify, 然后这里一样的是要选保存目录,我们点刚开始新建的 tempo 二 input 目录,点保存下载。 同样我们进入塞里斯贝斯主页面,项目点新建艾特,我们取名为丹普尔 项目目录指向我们刚开始新建的 emperor project 数据目录,指向 emperor dirt 数据来源选 problem nine 语言保持英语 点 c 五,同时我们要将刚开始从 pop madline 导出的数据首先进行转换,这里点 pop madline 输入目录,点我们保存 madline 的目录位置,音谱体输出目录,同样我们选 一 m p r, 带它点 imad averse 格式转换,这里可以看到转换了两百条。转换成功后,其他参数跟刚开始我们分析 c, n k 结果一样,点开始点可视化, 这样一样的得到了分析结果。 say space 常用的参数调整,主要是控制完这个标签,这个 three show, 如果我们看 看显示的关键词太多了,我们就把这个数字放大,这样关键词就会变少,我们缩小就增多。然后关于字体大小,就是关于那个文字大小矛盾 很多的 size 是指节点大小,然后我们还可以调节点的显示模式,我们点十二口,另外在中间我们可以移动位置,不影响结果,我们可以调整,根据我们自己需要调整图形。 好,这就是 set space 基本使用,其他详细的功能需要继续摸索用,熟练了就好了。
1192资源共享者 00:53查看AI文稿AI文稿
三分钟教你用会 sex space 视频,最后有操作指南哦!哈喽,大家好,今天呢,我们来聊一聊文献综数利器 sex space 的使用方法。 sex base 是一个非常强大的文献综述工具,它可以帮助我们发现学术研究领域的热点、趋势和关键作者。首先,我们需要准备好论文的影文数据库,可以是 website, scopris 等等。然后将影文数据导入到 sex base 中。接下来我们可以选择不同的分析方法,如共词分析、影文网络分析等等。 共词分析可以帮助我们发现关键词之间的关联和演化,从而了解研究的热点和学术趋势。而引文网络分析可以帮助我们发现关键作者和他们之间的引用关系,了解学术圈的权威人物。最后, set space 还可以生成各种图表和可视化的效果,帮助我们更好地理解和展示研究成果。 所以,如果你正在进行门线综述,或者是想要了解某个领域的研究热点和趋势,那在 space 绝对是一个非常有用的工具。
463尔雅老师 07:35查看AI文稿AI文稿
好,各位小伙伴,大家好,今天跟大家录一期视频。嗯,主要是解决一下之前有朋友在评论区对我的一些呃相关提问,我一道跟大家做一个回复。在这里我也想介绍一下六点一点四版本,就是最新版本他的一些新的功能 啊。第一个问题就是好多朋友在运行的时候就点这个,购的时候啊,经常会提示一个报错,就是说啊,我运行的这个条段已经超过了这个软件自身的一个呃容量啊。就比如说我们里边总共 有三千篇文献,但是我们在点的时候,他其实他是运行不出来的,他这个是在一千篇左右,那这个时候呢,我们只需要在这个时间机片这边做一个调整,调整成二或者三啊,那这样再重新运行的话,这个问题就可以很快得到解决。呃,那么我们就先以参考文献 作为一个粒子签,继续进入主界面看一下。 好的,我们先让他这个运行一下,运行好了之后呢,我们,嗯再做进一步的一个讲解。 嗯,好多朋友在问,我就是说如何把这个主界面的这个呃相关的就是文字导出来,就这个里边的这些数据信息导出来。其实这个很简单, 我们直接可以就是先直接 ctrl, ctrl 加 a 全选,然后再 ctrl 加 c 复制,这样就可以了,然后我们自己在新建一个文档,嗯,就把它放进我们这个新建的文档里就可以了。 ok, 大家可以看到。呃,我们最好是建成一个 excel, 千万不要见味的,因为这种版式就不好调整的。 ok, 那大家可以看到。嗯,我们这个数据就可以把它存档在这里了。 好了,这就是我们刚刚嗯,从这个塞利斯杯子里面倒出来的这个数据。其实所有的其他数据都可以通过这种方法,按 ctrl 加 a, 然后再 ctrl 加嗯 c, 然后再就是这样直接把它复制复制弄出来,我们先让这个数据暂停一下。 好的,那现在他就暂停了。呃,还有一些朋友在问,我就是说这个节点怎么调啊?比如说他是方块和圆形,他是怎么调节的?其实节点调节他是在 这个位置,在这个位置他有一个雷 boss 啊,对对,在这个位置,然后他这边塞口,塞口就是圆圆圈型的, 哎,大家可以看到。然后新的版本呢?他跟旧的版本有个有就是存在不同的,就是说旧的版本我们是需要拉这个进度条的,但新的版本他只要你这个 上滑,上滑的话就是就是你这,因为在我的苹果电脑上就是我只要往下拉的话,往下滑的话他就会整个图形就会缩小,我如果往上滑的话他就会增大。 然后还有一个呢,就是说,呃,在左右移动的时候,他是只需要你点住,点住他,点点按住,然后直接拖拽就可以了,整个可以实习实现整个图形的拖拽,你可以把它拖到你想喜欢的这个地方去。 好了,那这个呢?这个面控制面板呢?大家可以自行进行调节。其实这个我在前几期视频已经做过详细的一些介绍, 还有有的人说这个形成的图形太过于密集的,怎么把它把它分散开?呃,其实呢比较 就是说比较机械的方法吗?那就是我们自己一个去拖拽了,但是拖拽的话如果是大量的这个点的话,其实拖拽起来其实是非常非常困难的。那么我们在下面这个雷奥的这个位置呢,有这些,有这个 x 判的, 然后我们可以点他就可以分散开,如果点这个嗯 streaking 他就可以缩进。好了,他这是 嗯的一个啊,就是可以把它进行一个松散的一个调节,然后大家可以计算他的一个剧类。呃,另外一个就是说,嗯,我们在这边就是一个突变词的一个 图片,图片词问题我们先点一下其他,现在可以,如果是一点零的话,他可以生成六十四个图片词,但是一般来讲我们也用不到那么多,我们可以选择前二十五或者前二十,大家根据自己的需要就行。 然后可大家可以看到他基本上这张图就出来了啊,出来了之后他是按照时间分布的啊,你看时间就是红色的,他就是研究热点,就是或者是在引用最高的,或者是最近最热门的文献。那么我们这个图呢,其实就是很 很方便,就直接可以截图截下来就可以了,可以原汁原味的把它保存下来, 然后这些剧类其实大家可以自己多摸索摸索,总归是很容易上手的。 好了,大家可以看到这是我生成的一个呃剧烈图,然后他自己给这个进行了一个剧烈的一个划分,应该是十四个,从零开始算的话应该是十五个,他是一直到十四,那就是零,再加上一个零 也是十五个,其实这样也也挺漂亮的,他分的还是蛮蛮开的,然后对于剧烈的调节呢,大家可以点这个克拉斯特 啊,基本上都在这里调节,然后如果是详细的一些,对些颜色啊,或者是其他的呃,字体大小啊,人的方面大家一定要记得可以在这点 the ones settings 在这里调,这里都可以调节的,大家只要就认识 这个英文单词,那么你基本上就没问题,或者你如果实在是不清楚的话,就挨个点一点,基本都能点出来。还有一个就是说,嗯,把我们这个剧类如何导出来,大家可以点这个嗯,克拉斯特哎, isplora 直接点一下,然后你就点,直接点下一步,下一就直接直接就往下往前点就会 就可以了。然后大家可以看到这是他给我们嗯,这个系统他自己默认生存的一个剧烈, 有些人他可能看,哎,他这个十七十八十九怎么没有,嗯,其实这个软件他自己会把一些嗯,他认为不是 非常重要或者离散的比较离开比较开的这种啊,他会进行一个就是说直接嗯,省略掉其他这个编号倒也无所谓。如果大家有自己想把它修改的这个,嗯,就是说这个强迫症的话, 嗯,也可以在这个优字儿这边自己再重新再设定。其实这个也可以导出来的啊,就是也是卡同样的方法, ctrl 加 a, 然后再 ctrl 加 c, 然后在你的新建的这个 acl 里边就把它粘贴一下就好了, 那么自己粘贴一下,嗯,那到到时候大家也可以根据自己的选择看看这些,包括生成的这个嗯,他的一个剧烈词总结的是不是符合实际情况,大家可以根据自己的呃判断, 这可以自定义的,自定义的话就是需要点点这个位置,这边有一个优字, 大家可以用自定义的标签,但是这个要自己先,嗯生成这样一个文档之后放在你的啊 pro 站给他里边,然后最后再重新点一下他,他就会按照你自己预想的这个标签类型进行一个分布。好了今天的分享就到这里,谢谢大家。
665杨杨医生谈科普 08:14查看AI文稿AI文稿
哈喽,大家好,这节课我给大家讲一下怎么去理解三的 spa 四的实区图 啊。这篇作文是我自己写的,然后放在了微信公众号学术点滴上,学术点滴里还有很多关于 sens, max 啊, ucniteyex, ico, 还有该费拍即可这些知识图谱,或者说可视化文献计量的软件,大家如果想获得这些软件或者学习相关的教程,可以去关注一下学术点滴微信公众号 啊。这节课我就给大家讲一下怎么去理解这个图。这个图是经常用到的,也是塞的 spa 四的一个独特之处,因为塞的 spa 四,他的这个图将关键词与 时间联系起来了,这就不仅仅的是看关键词了,因为其他的可是话软件他主要做的就是关键词,对吧?关键词的贡献之类。而赛的 spax, 他加入了时间,有没有看到加入了时间, 所以咱们就可以去理解一下。怎么去理解这个图,我看了很多网上的论文啊,里面说的都不清晰,甚至有些是错误的。 那咱们这这节课就讲一下他的本质,这是我已经写好的一个文档,已经发布,发布出去了,所以录制视频就是放在啊壁站上,然后可以让更多的人看到。三的 sps 有一个亮点是将时间因素 加入了知识图谱的绘制中,先划分时间段,你看下面的时间段,对吧?从一九九八到二零一七,然后将合并起来,一起将,其实就是合关键词合并起来一起分析,这就是他的史趣图,又叫主题路径图,其实就是一个主题的演化过程, 因为一篇文章的主题可以用它的关键词来表示啊,主要讲解一下,如果有不对的,还请指出来。 这个图中的每一个圆圈,他代表的是一个关键词,该关键词在分析数据集中首次出现的年份。比如说数据管理,就是在咱们下载的这个数据集中,一九九八年出现。当然如果咱们分析近十年,或者近五年、 近二十年,而这个领域自从研究一共有好几十年,有五十年、六十年了,那 咱们这个数据管理只是在这一个一九九八年咱们下载的数据中第一次出现。在一九九八年咱们没下载的数据,比如说一九九七年,他也也有可能出现了,但是这时候咱们就无法 无法分析了,因为咱们没有下载一九九七年的数据,懂了吧?也就是说数据管理可能在以前的年份出现了,但是咱们针对咱们下载的数据,他第一次出现的年份是一九九八年。科学数据管理是二零零八年出现的, 当然也有可能他是一九九七年,一九九六年也出现过,但是针对咱们下载的数据还是二零零八年出现的,就是这个意思,也就是这句话的意思, 关键词一旦出,一旦出现,将固定在首次出现的年份,尽管之后论文中仍会出现该关键词,图中将不再显示,只会在刚出现的年份显示,懂了什么意思吧? 比如说数据管理在一九九八年出现了,一九九九年、二零零六年、二零零七年都出现了,但是咱们只把它固定在一九九八年,如果后边还出现了,那么咱们会将后边出现的频次累加到一九九八年,所以一九九八年数据管理这个圆圈很大, 懂了吧?是这个意思,是不是有种豁然开朗的意思, 对吧?就是这个意思。一九九八年他的文献量是很少的,但是他的关键,他的收据管理,这关键词频次怎么这么大? 只能说明后边的出现的频次累加到一九九八年了,就是这个意思。那这种方法合不合理呢? 比如说如果一个关键词一九九八年出现一次,之后几年没有出现,而而在二零一二年出现了八十次,那么软件会把该关键词归结到一九九八年,显然是不合理的,对吧?因为一九九八年出现一次,二零一二年 出现,二零一二年如果出现了八十次,那应该说在二零一二年,这个数据管理是研究的重点,但是咱们把它归结到一九九八年了,这就不太合理了,对吧?当然这也只是一小部分的情况, 现实生活中出现的几率不是很大,不是很大,对吧?不可能一九九八年出现一次,然后又到了二零一二年又出现了 八十次,这个差距有点大。当然也是有可能的。有说一个领域,他刚开始研究研究了,呃,一点点就是研究了皮毛,然后进行不下去了,然后过了一段时间,过了十年,二十年,然后这个领域又火起来了, 就是这种意思,懂了吗?比如说人工智能领域,他中间有有很长时间的,这个就是低谷期,然后现在又火起来了,对吧? 这就是关于这个圆圈大小的解释,圆圈大小的解释,懂吗?圆圈大小的解释,然后 这个线条怎么解释呢?线条怎么解释呢?这个之间的连线,你看他有圆圈,有连线,对吧?这个图中不就有圆圈,有连线, 加上一个时间轴,对吧?线条怎么解释呢?线条也好解释,线条代表着关键词之间的联系,也正是这种联系式的主题路径图能够加入时间因素。 如一九九八年的数据管理和二零零八年的科研数据管理同时出现在二零零八年的某一篇文件中,那么数据管理和科研数据管理之间便存在一条联系,这条联线从一九九八年到了二零零八,就是数数据管理、科研数据管理,他们直接有一条连线连到了, 说明在二零零八年,有一篇文章同时出现了这两个关键词,然后他们就会联系起来。当然不止一篇文章,可能有很多篇,十篇、二十篇、五十篇, 所以他们之间的联系,懂了吧?就这个意思啊。连线表示 两个关键词出现在同一篇或多篇文当中,那么这种方法有没有缺陷呢?因为刚刚咱们说了,这个圆圈的大小有没有缺陷?有,连线有没有缺陷?也有。 比如说,如果同两关键词同一念均第一次出现,他们这两个关键词就在同一篇文章中,那么他们之间应该是有连线的。但是现实情况呢?现实情况是没有联系的,当然 任何方法都有缺陷,能做的就是尽量优化,对吧?嗯,现在 已经把这个图完全给大家讲讲解解析了,是不是?现在你再去看这个图,是不是很清晰明白他是什么意思了,对吧?这个图也是我用三十四分做的,是不是比很多论文里面方便, 要的都很美观,对吧?然后,嗯,这就是,呃,制片论文,大家可以去关注这个公众号,微信公众号,学识点滴。 可以,这里面有很多东西,很多东西,比如说有一个我自己编的一个软件万能侠,现在是六点零版本了,可以免费下载论文,还有搜索各种你想要的资源,以及各种 工作学习的效率工具。你不需要下载别的工具了,直接下载这一个软件,然后它里面有很多插件,你直接点击用就行了。 还有各种各种小工具,大家可以去关注一下。好,这节课咱们就到这,咱们以后再去分享别的一些好的东西,再见。
134学术点滴 05:37查看AI文稿AI文稿
好了啊,我们现在要跟大家做的是关键词剧类啊,那么现在是关键词出来之后呢?现在剧类点击这个剧类, 这就是我们所看到的关键词聚类,这个类别就已经聚好了。那么聚好之后呢,我们需要去嗯,探的一个核心的词,看他在当前的这个时间节点当中。呃,他的 这是关于词啊,然后看一下啊,十五, ok, 这个是十五个词啊, 这个没有什么世界价值啊,那么这个是他的一个关键词。呃,一二三四,我们需要看的是 现在其实我所遇到的问题是在于说这些关键词的背后,他所对应的这一个一个类的词在什么地方找,这是我现在所遇到的问题啊,我们现在先把这个,把这个图先保存一下啊,这个是, 呃,这个是这个第六个图据,关键词关键词这个剧类啊,剧类,关键词剧类,这是第六张图,然后图六。 好,我们先看一下这个图啊。哦,这是图六,我们先看一下。 好,这是关键词的图六,这个图六的话就是我们现在所看到的这一个关键词区内, 现在这个关键词剧内,呃,我想要的是这个关键词剧类的这个下面的这些文字,我要想办法去找一找啊。 ok, 保存,因为在这个文字的查找过程当中呢,他在剧烈的话 是可以用不同的算法,因为清华的博士的话,因为用了他的算法,今天这个地方的话,我看有还有第四个算法,他把这个算法去做了,那个就是图形,我觉得做的很好,那么在这过程中我们可以把这个,呃,调,这个是调图的他的这个样式啊, 这是图形的样式,那么先把这个图调的比较好的话,真的是比较比较好使啊。然后他的这个深浅度啊, 这个文字的话也是可以调的, 国家认同。然后现在,嗯, 他这个他这个句的一个类的这个类别里面呢,是刚才我们所看的那个关键词, 然后现在这个关键词,呃,有一些他有些阴影部分去啊,他这个不不亮了, 这个是他 那个外面的一个亮度啊。 现在那个,呃所做的呢?我们看一下这个啊,就是他是这个是不同的算法,然后不同的算法,我们点一下不同的算法,一个、两个、三个。 嗯,创建一个 tfboysid, 再次尝试 好像没有这个第四个算法这个算法的,有谁知道他这个算法的这个就是 呃关键词背后的这些这一组的这一个,他这个文字在什么地方?这是我现在所遇到的问题啊。 好,我们做完这个,刚才这个是做的是剧类啊,剧类分析了,就到这个地方。下面我们就跟大家做一下那个,这是实线图、实区图和我们的这个,呃, ladies as cap 啊,我们先到这个地方啊。
66围巾哥萧尘 06:40查看AI文稿AI文稿
好了啊,现在我们开始做第四张图片啊,第四张图片,呃, 第四张图片的话,我们现在跑的是关键词,然后我们把这个就去掉了, 现在主要是关键词的那个视频, 现在是关键词,那么在做关键词,我们在做关键词的时候,其实他就有比较多了。那么在这个过程我们首先还需要去做的一件事情是关键词的他的中心性啊,这是我们的词品啊, 我们在做这个中心性的时候,需要在这个地方,呃,这就是中心性, 刨一下之后,然后他那个会有一点小卡顿,我们等一下旁边的话,那个他的那个中性性就会出来。 ok, 中性已经出来了,大家看到吗?刚才从零的话已经开始出来了,那么我们可以点击他的中性性。 ok, 这个中心性啊,这是按中心性排序的,然后这个是按他的持平排序的。 呃,我们先把他那个点击暂停,我再跟大家那个重点的那个强调一下,我们现在的这个,我们的这个数据的耽误的来源的话,是来源于周周爱学习博主。 哎,那个有 ccs 的一些问题的话题也可以问一下苏州博主,他其实也做的很好啊。那么现在我们做的时候呢?第一个我们需要把这个方框呢,把它变成圆圈, 这是我们当前的瓷瓶,这个瓷瓶的话,现在的瓷瓶,呃,最多元是一百二十四,然后文化,文化,呃,文化的话是十五,这个是十五啊, 其实应该是前面的几个要做呈现的,现在我们来去完成一下呈现啊,第一个是把他的圈圈放大一点, 哦,对,他这个在做的时候是点上面的,这个是圈圈放大,然后呢这个是关键词放大的,大家可以看到我们在这个下面呢,他是有这个阴影的,我们先把这个阴影去掉 透明度 啊。我们现在那个,呃,现在是十二的视频,十一,现在我们把那个最大的这个关键去掉,他的那个就是二十七啊, 二十七来去完成他的一个。呃,分析,我们看一下二十七的开根号, 嗯,开根号的话我们做三七三七二十一, 嗯,我们把它做二十八的话是二十八、二十八、四七二十八二,又根号七啊,二又根号七, 二,有根号七的话就有二乘以根号七,根号七的值,嗯。根号七的值是 多少?嗯,根号根号二,根号七,根号七的话,我们现在用根号九三二三得六六乘以零点七四九四。 我们在做的时候他的是呃三和四的视频,如果我在当前集团是四的视频啊,我们现在用这个四的视频来去完成呈现,这是三的视频啊,然后这是四的视频,我们现在减小他的这个关键字。 呃,这一个背景的话,需要重新的把他那个,把他那个就是透明掉啊。我记也是在做这一个啊,嗯,这个是他的大小,然后这个是圆圈啊,这个是圆圈的话,这个是 是嗯,他的词,但是他怎么没有透明调啊?这个是,哎,这是透明度啊。 然后我们现在在做的还有一个是第一个是他的连线,然后增加他的这个线区, 这样兴趣之后的话我们还需要去做的一件事情,下一个这条图就是要第一个是改变这个文字的他的颜色,第二个是要改变,改变他的这个就是强度啊。呃,我觉得这个我还需要练习一下,还没有完全的这个完全到位,然后他的那个背景的话也需要去掉这个地方,也需要练习一下。 这我们给大家那个做的第一个,这个叫做持平贡献,我们现在做的是四的持平的贡献,然后贡献完毕之后呢,我们先把这个图做出来, 这是第四张图啊,叫图四 cnki 的这个关键词贡献图。 关键词贡献图,这是第四张图,然后在做这个关键词的贡献之后呢,他还需要去做的是,呃,他的那个关键词的剧类啊,我们现在把这个图再看一下。 好,这个关键词贡献图 接下来我们所需要去做的就是几个几个剧类,他的那个几个剧类的话,他包括的是包括的是几个不同的算法,这就是我们所看到的关键词的他的一个贡献啊。 那么在这个关键词贡献的这个背后,他就他会有句类,这个句类的话包括的是这个是标题的句类啊,然后这个关键词的句类和他的那个下面的这个文章的这个句类啊, 这个是他的这个摘药啊,摘药的一个距离。那么在做剧内之后呢?还有这两个,这两个我还没有研究啊。 然后在做的时候,我看有清华的博士的话,他去在做剧内的时候用了不同的这个,呃,用的这三个不同的算法去完成的那个置评的一个数字。现在还有第四个算法的这个数字啊,我觉得这个就是我们要去做的叫剧类分析。还有一个是突变, 我们现在把这个贡献做完之后,我们开始做区内。啊,好,这是我们所做的贡献分析啊。
37围巾哥萧尘 03:47查看AI文稿AI文稿
ok 啊,那个刚才我们跟大家做了实线图,其实高级版本的话,嗯,在这个过程其实最不一样的呢,就是在于呃,多了一个,多了两个算法,然后多了两张图啊, 那么这两个图的话,一个是呃实区图,一个是那个,呃景观图啊,我们现在先点的是实那个实区图,这是我们现在所看到的实区图啊,那么我们在这个过程当中的话,是可以去调整他的这一个线路的大小的, 嗯,我们先把那个关键词去减少一点, 然后呢把这个圆圈把它缩小一点, 呃,颜色应该可以调整吧? ok 啊,文字可以放大, 这个是他是把把这个就是词的话,把它用 这个词的话,把它用这个就是用文字的形式把它呈现在这一组一组的路线上面啊,这是我们所看到的这张图,然后这张图在做的时候,他其实还可以去做方向上的这个条, 这个旋转啊。 ok, 呃,在做的时候呢,蚊子要稍微大一点点,然后这个线路呢?需要 这个线路呢?有一,我们看一下能不能换一下,把这张图把它调的好看一点, 然后我们需要还有一个是他的这个点,所以在这个调这个图的话,这个地方的话,我感觉我现在还是欠缺一点啊。 好,我们现在先把这张图先输出来啊,嗯,先把他那个颜色调调一下, ok, 把这个 油心调小一点, 这就是第八张图啊。哦,上面这个是七啊, 第八张图,图发关键词的实区图、 分点图、实虚图,我们把这个实虚图我们再再瞧一瞧, 嗯,这个要这个是第七张图。 ok, 我们看一下这个四驱啊。 好的, ok, 这就是我们学员在所看到的这个时区图啊。 好,呃,十七图就到这个地方,然后还有一张图呢?就是我们的这个风景观图啊。
26围巾哥萧尘 03:34查看AI文稿AI文稿
大家好,这里是不爱学习,最沉迷学习的小声音就是我。前段时间小陈一直在忙着编论文的事情,利用了 sbs 去分析了将近三千条的数据,最近呢,小陈还要忙着十到十八岁的 中小学生的一个深度反弹,如果大家身边有这方面的资源的话,也希望大家能够多多推荐给小陈。然后今天呢,小陈主要是呃兑现之前的诺言,就是在分析完关键词的一个出现,制作之后,将要给大家分享的是剧烈分析,我们开始吧, 一般来说剧烈分析怎么做呢?首先我们可以把这个图调大一点,这样大家看的更直观一些, 我们点击这个绿色的按钮,然后点击确定,我们看到这个图他整个截 点的形式是变化的,我要接着我们再点击这个 k 和选项,点击 k 和选项之后,我们可以发现这个图他有这样的区域性的划分,这个就是剧类 最关键的一点,也就是我们最后一步需要选择一个聚类算法,一般来说他有 lsi 算法和 lr 算法以及密算法,一般优先选择的是 llr 算法。现在看到这个图其实是有点乱的, 因为关键词的剧烈类别他们是重叠在一起的,那这个时候我们就需要把关键词隐藏掉,那么我们应该怎么隐藏掉呢?我们可以点击这个字体的设置,我们把这个设置为零,然后我们所有关键词他就不显示, 现在显示只是聚的类别,目前来说他已经聚成了以下几类,前面这个井号和这个数字搭配表示的就是呃这个类别的序号 可以旷为分为乡村文化振兴以及乡村文化建设、文化建设等等。那么这个时候我们可能会想到这个类别可能会有一点重复,是有点多,我们可以做一些删减,这边可以点击这个 display, 然后点击最累这里 现在我们可以选择的是,嗯,过滤掉一些比较小的类别, 我们点击这个按钮,一些这样的类别就会被隐藏掉了。怎么输出这个剧类表格呢? 我们点击这个剧烈表这里, 然后选择这里的第四个按钮,然后就把它导成出这样一个 html 格式,这边需要选择自己需要的类类别, 然后把它保存一下,也是一个 html 文件导出后的结果就长这样。这个要怎么看呢? 前面这一类表示的是这个类别,一般来说类别的第一个词就是呃,这个句类中最具有辨识度的词就是最为重要的词,那么这边可以把它理解为是一个关键词,因为我们之前呃使用的是 lr 算法,所以只 看 lr 算法这一列,然后可以看到就是这次的剧烈表,大家可以根据自己的需要来阐述,多点赞,多关注,小陈一定会努力更新的。
275小陈研究所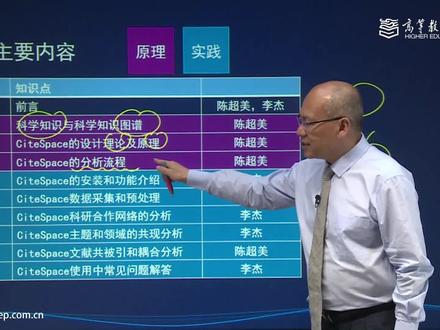 07:40查看AI文稿AI文稿
三个模块里给你解释了,但是呢具体操作起来啊,有很多具体的细节啊,这时候我会结合,我很理解,结合我们从呃中外各种各样的机会,我们给大家啊,在中国的,比如说科学网上,在国外的 各种各样办的这些啊,就瞅瞅有什么地方。这时候我们问到的呃读者用户问到的问题,我们来给大家解释解释。比如说在这一步在数据收集的时候需要注意什么?在呃数据最后分析的时候需要注意什么? 比如说好多好多参数,如何选择这些参数?呃参数你选择参数的影响是什么?对你后边的影响是什么?都要做些介绍啊,所以这个 下面这几个部分呢,侧装于安装啊,功能介绍,数据的采集啊和预处理,这时候呢,再往下就会给出大家一些具体的实力。 这个塞斯贝斯啊,有许多种分析的方法啊,其中有几种,比如说科学合作网络, 科研合作网络就是研究啊,几个不同的哎,比如说研究一个论文,这个论文有几个作者,这几个作者 作者发表同一篇文章,他们就是成了合作者,所以说这个合作者是局部的信息构成了一个网络分析,这种网络就可以回答一些 许多高层次的问题,据说这个合作是谁和谁合作呀?或者是这个合作是在每一个领域合作,合作和那个地理位置有什么关系啊?这些方面,呃相对后边来说比较直观,就是说科学合作的网络是比较直观的网络, 这些网络的合作,网络的分析啊,作为第一个例子,第第一部分实力啊,同时呢你可以看到是怎么样啊?通过这个流程具体化,具体到合作网络分析的时候啊,来体现这些功能和原理 啊。下边呢,下边还有这个科学主题和科学领域的贡献分析。贡献?是啊,比如说一个论文 里头啊,同时有出现两个关键词,两个关键词一个是 k 一啊,一个是 k 二,这两个关键词, 如果你发现一个论文里列出这么几个关键词,这样的话就叫贡献。贡献呢啊,也是一个常用的办法,就是怎么样找找出他的局部的联系。你看这个前面合作是局部的联系,是共同作者。 下边的贡献是合作关系啊,就相当于合作关系,但是呢,贡献就是共同出现在一个地方,这样他是局部的联系。 第三,下边一个是最核心的啊,塞斯贝斯最核心的功能,最核心实际上就是说塞斯贝斯的设计啊,完 全是为了实现这一个主要功能,其他的功能都是辅助实现的。呃,顺便比较容易实现。这个文献供背引分析啊, 根据前面的理论,前面几个理论说文献供背分析反映的是一个学科一个领域里头的 一种犯事。前面一会会讲到这个为什么叫做犯事,他是一种犯事呢?就说这个犯事在经常在变化,也就是酷恩的理论,我们回头会具体讲一讲这个啊,这些理论 不光是哲学上有酷恩的理论,还有社会学类有其他的竞争的理论,有这些理论会具体的讲,但是这个塞斯被子的设计说既然有这些,呃,犯事,犯事之间会有 转换,这也就是说科学革命,科学最后的进进步啊,都是通过犯事之间的转换来进行的。 但是怎么样了解这个犯事呢?犯事是关键点,是有一种是通过这个文献供背人网络的特征来了解这些关键点,所以说从这些基础层次上直观的可见的 啊,信息,我们可以返回来来看到哲学上才能出现的这种犯事的结构啊,犯事的转换等等等等。所以从这方面来看,塞斯被子啊 啊的一个突出的一个特点就是怎么样用啊这些实际上你可以每个人都可以操作的这些工具来达到解决这些问题,达到这些非常抽象的一个层次上才能看到的问题。这最后不仅仅是关于一篇文章,一个论文,而且是 关于整个学科,所以这个视野啊,就是非常啊跨越了几个层次,从啊从高层次的,低层次的啊,互相之间 经过几次几次的这种跨越。所以说有时候用户用三四的时候觉得这个东西比较不好琢磨这个分析到底是从哪入手,如何解答这些得到的结论。 所以整个来说,呃,我们这个一方面有针对性,针对好多用户提出的各种各样的问题来解答他们的具体的需要。另一方面呢,也给大家提供一个系统的学习这个的机会。 这个你可以看到这不光是一个领域,不光是一个,比如说不光是一个什么树木计量学,也不光是一个,呃 啊,计算机也不光是知识挖掘的,但是他牵涉,而且他牵涉了许多各个方面的领域,他综合的是一个解决一个问题,为啊为动力的就是解决这个问题。是什么呢?就这个学科, 某一个学科,我对这个学科感兴趣,我怎么样通过这些现有的知识,现有的工具来更快的更有效的达到我的目的? 那当然就说现在的方法是,呃比较费时费力,而且呢具有局限性,这个方法呢 提供了一个新的可以辅助,不光可以辅助,而且可以开阔我们的视野的一个办法 啊。最后还有这些,呃,塞斯贝使用中常见的问题,常见的问题,你可以从别人的经验里学到很多东西,别人说如, 如果说这个流程里我们知道哪个节点,哪个关键点容易出问题,容易出现什么问题,我们可以呢一返回来,呃,改进塞斯被子的设计,这个界面上让你不容易在 走到那条岔路上去。所以呢啊,通过这个系统的这几个步骤,我们希望啊大家可以更有效的 运用这些工具,同时运用工具,最后结果就是啊,你省省掉了很多很多,原来可以你必须花费很多很多时间 来掌握这些知识,掌握这些信息,现在通过运用这些有用的工具,更合理的运用这些工具啊,你能省很多时间,也可以用这些很多宝贵的时间来发现更新的问题。好,这就是这个 啊要点我们需要,里面还包括很多很多的知识点,但是呢,整体来说就是给大家提供这么一个系统学习的机会。

