实验后数据也必须符合正态分布吗
三、样本量足够大,是不是就可以不做正态性检验了?有些读者说,不用这么麻烦,只要样本量足够大,就可以默认数据满足正态性了。这种认知当然是不对的。 这种观点的起源,是因为对中兴极限定理的误解。事实上,中兴极限定理的说的是不管是总体数据的分布是什么样的,可能是正态,也可能是偏态。 如果从总体中多次抽样,对于每个抽样样本计算统计量,如均值中位数,当每次抽样例数足够大时,样本的均值或中位数近似服从正态分布。并不是说样本量足够大,这个样本就服从正态分布。
粉丝10.1万获赞2.7万
相关视频
 01:13查看AI文稿AI文稿
当我还是一个科研小白的时候,就因为分析数据忽略了这一点,结果被导师臭骂一顿,那就是数据一定要符合正态分布之后才能进行相机检验之类的分析 正态分布的意思简单来说就是数据的重复性。好,那今天就用 sbox 来教大家三个检验正态分布的方法,干货,记得收藏! sboss 中我这有两组数据,一组是对照组,另一组是实验组,我想分析他们在处理后的体重是否存在显著性差异,那我首先就要检验他们是否符合正态分布。 第一个方法,点击图形,再点旧对话框,点最下面的直方图,然后将体重导入变量中,打上这个正态曲线的勾,点击确定,结果就出来了, 只要图形是像我这样符合中型的,就说明数据符合正态分布。第二,点击分析,选择描述统计,选择最下面的 qq 图,同样是将其 重导入变量中,右侧选择正态。然后我们发现,如果数据点能够分布在一条直线上,表示数据符合正态分布。第三,同样是在分析中的描述统计中,点击 pp 图,和 qq 图一样的操作, 如果数据点是一条直线,就代表着你的数据符合正态分布,你学会了吗?这里是正在读博的大学长,关注我,带你开心读研!
4348大禹学长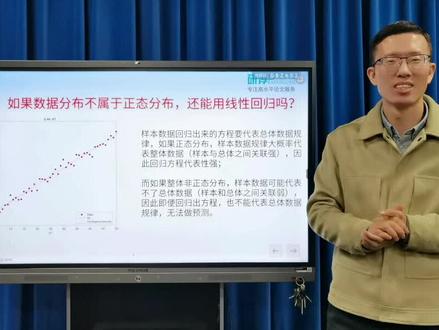 04:49查看AI文稿AI文稿
大家好,我是吴博士,今天我想回答一个科研问题,如果说你的数据不属于正态分布数据,那么我们还能用线性回归去做这个你的回归分析吗? 我们来看左边这个图啊,这是一个啊示意图,示意的是 x y 两个啊,变量之间的线性黄气, 这个可以看到它是一个正相关的一个关系,对吧?随着 x 的增加,我还只在增大,而且呢是一个呃一远线性的回归的这种关系啊。 那么啊,我们再看这个问题啊,如果说你这个数据啊啊,他的这个总体数据不属于正在分布,那你用这样的这个样本数据做的这个啊 回归方程啊,能不能去代表整体呢啊?能不能代表总体呢?好,那我们先啊,在回答这个问题之前啊,先想一下,我们为什么要做这个啊,线性回归的这种啊风险。 我们知道,我们做这个先进回归分析,是希望通过样本数据找出一个啊先进回归的方程,而最能代表这个样本数据,同时呢 又能代表总体数据,那这样的话呢,我们不仅了解总体数据的这个内在规律,而且能做预测,对吧?这是我们的这个本源的这个目的, 那你试想啊,如果说你的这个数据啊,是符合这个正态分布的啊,那么你的这个样本数据呢,大概率是能代表整体的这 这个数据规律,对吧?因为总体数据规律呢,就是一个正态分布嘛,你的样本数据大部分都集中在啊这个总体数据的这个趋势里面啊。 好,那这样的话呢,也就意味着你的样本与总体之间光临性很强,那你样本数据得到了这个啊,回归方程啊,就能代表总体的这个啊方程规律,那这样的话做预测分析啊,就很自然的事了。 但是如果说啊,你的这个整体啊,他不是一个正态分布啊,或者是其他这个某一种分布很复杂, 那么你的这个样本数据呢,就可能代表不了整体数据啊,尽管你的样本数据呢,可以做出一个漂亮的一个先进玫瑰方程啊,这么一个啊,直线啊,那总体在哪里啊?长得怎么样,你不 不知道,所以从样本数据的这个线性回归方程去推让总体,哎,这个就很牵强啊,就像我们这个,呃,这个样本数据呢,呃,我们做一个比喻啊, 你的这个样本数据呢,就可能像总体这个冰箱啊的这个一角一样啊,那你由冰箱一角去推量整个冰箱,那显然是很牵强不合理,对吧?所以我的观点就是,如果说你的这个总体数据他不是一个正态分布 啊,那即便你的样本数据呢啊,可以非常好的你和回归出一个方程,那也不能代表总体情况啊。但是呢,你通过这个样本数据的这个规律的这种寻找,你对样本数据呢有一个更好的理解啊,这个风险那是可以的。 那么第二个问题呢,是啊,如果啊,你这个项目数据的确啊想做这个回归分析,那总体呢,又不符合正在分布,怎么办? 所以我第一个建议呢,就是你数据呢啊,转换成正态分布的这种形式啊,通过一定的这个数据转换啊,比如说去对数啊,啊,去去某一个方程变换形式,对吧,转换成正态分布呢,再去做现金回归, 这时候需要注意的是什么呢?就是你做完这个幸运回归之后,是转换完之后的那个变量啊,所以你要进行啊,相应的这个替换回来,对吧? 好,另外如果说啊,你不能通过这个数据变化变成这个正在分布的数据啊,那怎么办呢啊,我的建议呢,还是你只能解释一下 样本数据呢?哎,有前面类似那样的这个啊,线性回归的这个方程规律啊,但是呢,我们必须要指明啊, 由于我们样本数据量过少,或者说啊总体不符合正在分布呢,我们不能在统计学意义上呢去推断总体的这个分布规律怎么样啊?也就是不能由样本呢去做啊,预测分析啊,总体的这个情况。 好,今天我的这个科研问题的回答就到此结束,大家如果还有其他问题,欢迎给我留言,我会尽量回答。
142吴博士论文及基金指导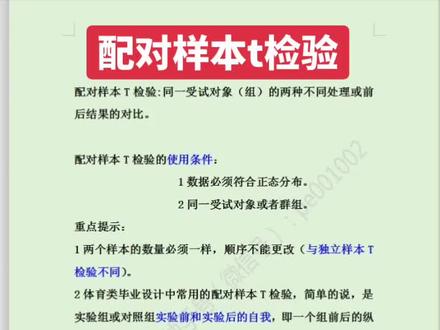 00:42查看AI文稿AI文稿
配对样本体检验配对样本体检验指同音受视对象的两种不同处理或者前后结果的对比。 配对样本体检验的使用条件,一、数据必须符合正态分布。二、同意受视对象或者群组。重点提示一、两个样本的数量必须一样,顺序不能更改。体育类毕业设计中常用的配对样本体检验,简单的说是实验组或者对照组。实验前后的自我比较, 即一个组前后的纵向比较如下,立一个组别实验前后的比较。在满足其他条件的前提下,可以采用配对样本替检验。
126蓝科体育(小陈老师)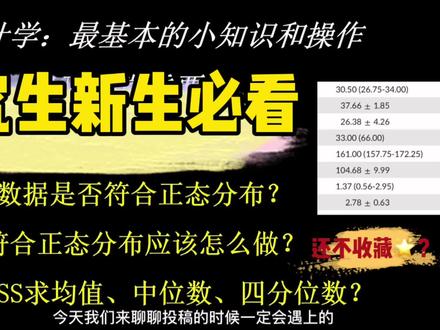 11:36查看AI文稿AI文稿
今天我们来聊聊投稿的时候你一定会遇上的,也会用得上的统计学最基本的小知识和操作, 可能很多研究生已经会用了,但是对于部分新生来说可能还不知道,如果不注意的话,投稿的时候有可能就会被拒搞,所以这些东西是非常重要的。 首先来看看这个表格,有这些变量,然后分成了两组,每组有五十个人,那么这是批职, 可以看到有些数据是这种形式表示,有的变量是 加减号的表示,他们有什么区别呢?看这里。那么两组数据进行比较之后,如果符合正 性分布,我们就用两样本体检验来进行,检验他们之间是否有统计学差异。 表示的形式就是用均值加减标准差,也就是这样的形式,说明这些都是符合正态性分布的。如果不符合正态性分布,就得用非参数检验, 用中位数括号,第一四分位数到第三四分位数来表示, 也就是像这样的说明这个变量年龄他是不符合正态分布的。 这是我从刘老师医学统计的公众号里面截图下来的,因为我觉得这几个都是需要注意的。首先 有没有必要做正态性检验呢?有的人说数据在我电脑里,其他人都不知道啊,但是有些高手一眼就能看出 你有没有做对,有没有做了正态性检验,所以我建议还是追求严谨客观的一个态度,最好还是检验一下。 第二个就是有的人可能会认为样本量足够大的时候,就可以默认数据是符合正态分布了,但是刘老师的观点是这种说法是不对的, 那么具体的原因大家自己可以看一下。第三个就是进行两组或多组间的比较时, 需要分组检验正态性,而不是合并进行。像刚才这样,这里有两组,我们不能把 有年龄的数据,把这组跟这组的放在一起去检验正态分布,这样是不对的,而是先检验年龄在这一组的数据是否符合正态分布,然后再检验年龄在另一组的数据是否符合正态分布。 只有两组都符合正态分布时,我们才能认为他符合正态分布,而只要其中有一组不符合正态性,那么就判定该变量不符合正态分布。 不符合正态分布就得用非常速检验,就得用这种形式来表示,只要有其中一组不符合都得这么办。 那么接下 下来就稍微演示一下。这是我一篇文章里面的举例。第一个表格,比如看中间这里年龄 不符合正态分布吧,运州符合正态分布。那么怎么求出这些数值呢? 我已经提前把数据导入了 spss 里面。首先我们进行正态性检验,按 analyze, 按第二个,然后按第三个 is floor, 把年龄和运洲,哦,我重新弄一遍, 把年龄和运周,也就是你需要检验的指标拉到第一个框里, 把主别放到第二个框里,要按 plot 勾选这个图形,然后最重点的一定要勾选这一个,因为这个就是检验正态形分布的,按 contineu 按 ok 往下拉,我们我们来看这个结果,这个结果就是正态性检验的一个结果。 一般认为当数据量小于二等于五十的时候,我们看这一边,如果当数据大于五十时,倾向于这一边为准。 如果当数据量很大,比如大于五千的时候,他软件只会显示这一边的结果。那么 我们现在来看这一边。年龄和孕周两个变量分成了 p 一组和 ctrl 组。首先来看年龄,在 p 一组的 p 值是零点三八二,大于零点零五的, 我们在正太性检验里面批值大于零点零五,就认为他是符合正太性分布的。 年龄在 ctrl 组里面他是零点零四七,他是小于零点零五的,他是不符合正态分布。刚说过了,只要有一组不符合正态分布,那么就认为年龄他是不符合正态分布的,我们就得用非参数检验 往下看。运州,他在两个组里面的批值都是大于零点零五的,说明运州在两个组里面 他都是符合正态性分布的。所以我们就可以用体检链来对比孕周这两组间的差异。 这是我文章里面的结果,你看刚才说了,年龄在其中一组不符合正态分布,所以我们就要用飞山术检验来对比,然后他要用中位数 和四分位数来表示。孕周他是符合正态分布的,所以我用了均值加减标准差来表示。 那么怎么求呢? 我我们先来看一下符合正态分布的运周,直接用体检验, 按 compamines, 按独立样本体检验。把熨州拉到这个框里,我们重新来做一遍。 这里把主别拉进来之后,要进行主别的定义,输入一跟二,因为我这里是一跟二,如果你这里是别的,比如零和一,那你这里就要输入零和一按, ok, 首先来看左边的方叉骑行检验,这里批值是小于零点零五的,所以就认为他的方叉是不齐的,不齐的就得看下面这一行,你看有两行,一行二行, 但他不齐,他小于零点零五是不齐,我们就得看第二行,第二行体检验的批子是零点零零零,也就是小于零点零零一的,你看这里, 那么这里就是运州在两组的均值命和标准差,比如他在 p 一组的均值是三十七点六六, 标准差是一点八五,因为我只保留小数点后两位。三十七点六六加一点八五,加减一点八五, 你看三十七点六六,加减一点八五,就是这么求出来的。体检验就直接可以看到 t 值和均值标准差, 那么年龄不符合正态分布,要用非参数检验来对比,怎么求呢? 非常速检验按这里, 不要,因为我是两组的对比,按这个 把年龄拉进来,把主别放到这里进行定义,然后默认勾选的这个很 ok。 看最后这里他的皮质是零点九一五,你看他的皮质是零点九一五, 但是我们怎么求他的中位数和四分位数呢?这个可能会有人有更好的办法,但是我的办法是这样的,比较麻烦。 你看在这个表格里面,年龄是把两组的年龄放在一起的,那么我们要对两组分别求出他的中位数和四分位数,所以我们要先把其中一组的数据删掉, 选中之后按键盘上的顶立, 这样就只剩下第一组的年龄的数据了。我们来到这里选择这一个, 我们把年龄输入这个框,要按这里,默认情况下是没有勾选的,那么我们勾选一下,这个是四分位数的意思,这个是中位数的意思,我们 ok, 这里就能求出来 第一组数据里面的中位数和四分位数的,你看有五十个值, 中位数是三十点五零,第一四分位数是二十六点七五,第三四分位数是三十四点零零, 和我文章里是一致的,三十点五零是中位数, 第一次分分是二十六点七五,二十六点七五,就是这样求出 过来的。然后我们撤回,撤回之后刚刚删掉数据就回来了,我们再把第一组的年龄的数据删掉, 这样就保留第二组的年龄的数据。我们再重复一遍刚才的操作, 这些都已经不用再重新选了。 ok, 他的中位数是三十点零零, 三十点零零,二十八到三十四,二十八到三十四,好的小伙伴们学会了吗?
1455飞猪Doctor 00:57参数检验一般都需要数据满足正态性的特征,正态性检验的方法有很多种,常见的有3类——统计检验法、图示法、描述法#数据分析 #spss #spssau #毕业论文 #论文发表 #正态性检验 #科研 #论文查看AI文稿AI文稿
正态性检验,看这个就明白了。一、统计检验法,该方法对数据要求很高,很难满足。 spa。 骚,操作如下,选择正态性检验 结果解读,样本量大于五十,因而使用 k s 检验,数据呈现出显著性,拒绝原假设,数据不满足正态性特征。二、描述法,如果风度绝对值小于一, 并且偏度绝对值小于三,则说明数据虽然不是绝对正态,但基本可接受为正态分布。三、图示法,可以通过直方图查看数据分布,若直方图呈现中间高两头低的中型分布,可以认为数据满足正态分布。骚操作如下,选择直方图, 还可以使用 p p 图或 q q 图,如果近似呈现一条带角直线,说明数据也近似满足正态性。
155SPSSAU 00:51查看AI文稿AI文稿
正态分布与正态性检验正态分布是一种概率分布,类似于平滑的道优型曲线。 很多统计学中的检验都要求数据符合正态分布。正态分布检验的方法有, d 检验,风度偏度检验、卡方检验、 ks 检验、 sw 检验。重点一, ks 正态性检验应采用大样板 小于五十样本量的检验,一般采用 sw 正态性检验。 ks 正态性检验的原甲设是数据符合正态分布,因此其检验结果 p 值大于零点零五,说明数据符合正态分布。 错误分析,多数体育类毕业设计中用到了各类体检验,但前提都没有做数据的正态性检验。
 00:42查看AI文稿AI文稿
数据不满足正态分布,可以使用非参数制和检验参数检验。对应的非参数检验方法见下表。 致核检验可以分为如下几种, spell 操作演示,如使用单样本 will coxsen 检验,分析星耀得分与三之间是否有显著差异。选择分析方法,将星耀得分拖拽到右侧分析框中,对比数字,输入三 sport, 输出结果如下,从上表可以看出,新药评分未表现出显著性,即新药平分的中位数接近于数字三点零,没有统计意义上的差异性。你学会了吗?
253SPSSAU 03:18查看AI文稿AI文稿
hello, 大家好,我是 doctor 里,今天呢我们来学习正态分布的检验,我们要了解的是连续型变量呢,都是需要检验正态分布的, 因为分布状况不同,我们选择的分析方法也不同。如果说我们调研到的连续性变量的数据呢,他是服从正态分布的,那我们就可以利用 t 检验,方差检验,方差分析呢来进行对我们所电影到的数据呢进行比较差异的分析。 如果说我们该数据呢不符合正态分布,那我们就要选择其他的分析方法,所以说呢,在进行正态检验是很有必要的,有利于我们选择准确的合适的分析方法。如果说这个数 数据分布呢,它只要不是太偏态就行。检验正态分布呢,通常我们利用直方图,正态 qq 图以及正态 pp 图, 那我们来接下来开始学习如何利用 spas 呢来进行这个正台分布的检验呢?首先我们选择第一种方式,图形直方图好,点击图形,点击就有对话框,然后选择最下方的直方图 好,这是我们涉及到的这个连续性变量销售额,我们将销售额呢导入到变量当中,勾选显示正态曲线好,我们直接看结果,点击确定好,这是我们这个销售额的一个 个分布情况,我们来看他这个曲线类似于一个道中的一个形式,哎,类似于一个正态分布,稍微往右偏了一点,所以我们也可以认认为他符合正态分布的,就可以进行体检验,防沙分析等等。 我们看第二种正态 qq 图好,点击分析 描述统计只有一个 qq 图,点击好,我们将销售额呢倒入到编制当中,别的可以默认不动,点击确定。我们来看一下这个 qq 图的一个检验结果 把,我们这个所有的点呢,哎,接近于这个这一条直线,所以说它也是符合 这个正态分布的,通过这个正态 qq 图的结果来看,好第三种呢,正态 pp 图,也是点击分析描述统计这个 pp 图将销售额呢导入到编辑当中,点击确定。 我们来看这个正太的 p p 组,它的所有点呢几乎落在或者接近于这条直线上,所以它也是符合。 通过这个正态 pp 图呢,也是判断呢,该数据是符合正态分布的,所以说呢,判断了数据的分布情况呢,我们就可以选择合适的分析方法。好,今天呢就是我们这个正态检验的一个讲解。好,今天课程就到这里。
386小小羊爱分析 01:17查看AI文稿AI文稿
为什么我们算正态分布的时候,总是把它转换成标准正态分布来算呢?一句话就能解释明白,因为天下所有的正态分布,不管它的均值方差怎么变化,这个概率密度啊,高矮胖瘦怎么发生变化? 正在分布在他均值这个位置,往左右数走一个是一个嘛?对应的概率都是固定的啊,大概百分之六十八。 走两个 c 个码,对应的概率都是固定的,大概百分之九十五。走三个 c 个码,对应的概率大概是百分之九十九点七。那于是非标准的正态分布,你往右往左走一个 c 个码,就对应标准正态分布,往左往右走一个单位一就好了。 同理,走两个 cg 嘛,就对应标准正态分布,左侧右侧走两个单位。那这样就把不标准的正态 分部对应到标准正态分布上来算了。我们就可以只制作一个标准正态分布的查表的表格就行了。那为什么正态分布要查表呢?因为它的积分是非初等函数,积分积不了, 他这个正态分布的表格是通过更高级的数值计算的知识或者是级数的知识来计算出来的。所以我们只会查表,把所有的正态分布都对应到标准正态分布上去。
1566小元老师高数线代概率 00:45查看AI文稿AI文稿
关于数据正态分布的判断标准,首先打开数据包,现在我们看到的就是调查问卷的数据,有一二三四五六七有七类数据,现在我们要检测这数据是否符合正态分布。首先点击分析 描述统治频率,全部选中,拉进去,点击统治拼度,风度继续确定,然后会弹出一个表,关于数据正态分布的判断标准是他的拼度要小于二,他的风度要小于八, 所以我们看这个表格当中这个是偏度,这个是风度,这偏度里面全部都要小于二,风度里面全部都要小于八。好了,再见。
160享受生活 17:01查看AI文稿AI文稿
哈喽,各位朋友大家好,我是侯茂林,好久不见啊,那么今天的话呢,我们想跟大家分享一下关于这个非正态能力分析当中的一种方法 啊,那么这个视频的话呢,它是为了去说明这个文章啊,所以说大家在看视频之前把这个文章呢先 阅读一下,那么对于这个文章的话呢,其实我们在我们的公众号呃前面的一些这个呃文章内容当中的话呢,也有相应的介绍,如果大家感兴趣的朋友,大家可以去扫码关注这个微信公众号啊,大家可以去看一看这个文章。 好,那么文章我就不顾的介绍了啊,那么我们来看一看怎么去实现文章当中所说的方法。呃,怎么利用密码软件呢,去对这个非侦探数据啊,做过程的分析,那么呃在文章当中也有详细的说明,我们做能力分析 一些流程,我这边的话呢,由于时间关系,我就直接打开软件来给大家做一些相关的操作。好,这边的话呢,我们就直接打开软件。好,我们来看一下这么一组数据啊,我们想对这里的 y 来做过程的分析啊,这个数据的话呢,一共是有一百个数据啊,他是叫单词的设计的数据, 这个数据的话呢,他没有规格下线,只有规格上线,上线是八啊,那么针对这个数据,我们想做过程的来分析,基于我们在文章当中提到的一些方法的话呢,我们的这个步骤啊,我们就按照这个流程图啊,按这个流程图的话呢,来进行相应的分析。 首先第一步啊,当然我们在做分析之前啊,他的前提条件啊,要满足这个在文章当中反复强调了,我在视频当中就不过的去提了。好,第一步呢,我们先做质量检验啊,统计 基本统计啊,做质量音检验啊,统计基本统计质量音检验,或者你利用统计基本统计图形化为种啊,这个方法很多啊,我们就呃来用这种方法吧,统计基本统计质量音检验,我们把这里的 y 输入进来,点击确定 好,我们来看一看当前我们的这个 y, 这个数据啊,啊,它的智能音节的批值呢是小于零点零零五, 那么它比零点零零五还小,那么它一定比零点零五小,所以说我们这里的 wide 数据的话呢,它是非正态的, 那么对于非正态我们怎么做过程来分析呢?我们按照这个文章当中的流程图的说法,我们先干嘛呢?我们可以先来做一个个体分布的标识,先不要急着做我们的转换,或者去做一些非正态的。这个,呃,你 和我们先看一看啊,看一看这个你转换行不行?然后非正态方法来,你和他可不可以,对吧?怎么试呢?我们点击统计,选择质量工具 个体分布标识啊,我们从这个路径他可以帮我们去找到哪些分布是可以很好的,你和这个数据变化可不可行?我们在这里的话呢,都可以得到相应的答案,统计质量工具个体分布标识, 好,我们把这里的 y 输入进来啊,这里的指数大小呢?得一可以看到在体分布标识当中呢,这是一个非常强大的功能,那么在 mit 软件的这个功能当中,大家可以看到啊,这里的分布的话呢,其实 它是包含正态分布在内,一共是有十四种分布,另外呢还有十,呃,还有两种变换啊,波斯科斯变换和纠正变换。 说这里的话呢,其实他一共有十六种选择啊,那么到底哪一种比较好?是变化比较好还是用其他分布你好比较好?这个呢,我不确定啊,所以说我这边的话呢,是用所有的分布好变换啊,十六种都来一遍,好点进去。 好,那么下面的话呢,我们来看一看这个结果啊,这个呃,他会给一些图,也会有一些这个检验的批值。那么由于时间关系啊,我们这边的话呢,就直接来看一下这个你和 you 的检验,这个图我就直接跳过了。 那么在这个你和 youtube 剪映当中,我们主要看什么呢?我们主要看的是这里的你和 youtube 剪映的批值,看这一点。 那么在这一节当中的话呢,首先我们大家可以看到正态性他通过不了,但是这里的啊, boss 的变换,他的题写着零点八一一出生变化呢,零点八,零八啊,这两种变换的方法呢,你可以去做尝试。但是我们在这节课当中的话呢,并 不是给大家去讲变化啊,变化的话呢,是我们上一篇文章已经给大家说了,做了一些说明,那么我们这节课的话呢,主要给大家讲的是用其他分布来拟合这个数据,然后呢去算分位数的方法,做过程的分析。 那么我们来看一看,除了正在分布以及这两种变化以外,还有哪种分布能够比较好的,你和这个数据呢,我们去找一些 p 值比较大或者 a d 值比较小的分布啊, a d 值比较小的分布好,我们主要看 p 值啊,那么这里呢,你可以发现 啊,指数分布应该是一个不错的选择,大家可以看到在指数分布当中,我画一下啊,大家可以看到在指数分布当中的话呢,他的这个礼盒优度减的批值啊,达到了零点九一九啊,这个批值是比较高的。所这边的话呢,我们可以用指数分布呢来对这个数据做礼盒,然后进行 非正态的能力分析。好,那么下面我们来看一看分布,找到以后,我们看一看 mit 满键怎么做的好,怎么做呢?我们找到分布以后呢,我们点击统计,选择质量工,质量工具,统计质量工具能力分析,这里呢我们选择的是非正态啊,选择非正态。 好,我们把这里的 y 输入进来,然后呢我们这边要去选择合适的分布,至于为什么要选择合适的分布,我在文中已经做了详细的说明了。那么这边我们的分布 哪个是比较礼盒的比较好呢?这边呢我们可以看到指数分布,它礼盒的是非常好的批值,零点九一九啊,所以说这边呢我们可以选择指数分布来礼盒这个数据。好,然后呢我们这里的这个上线是等于八下线呢,没有,没有的话呢我就不填了。好,那么直接点击确定, 直接点确定好,我们来看一看,通过这里的通过 meta 软件呢,我们选择指示分布来领和这个数据,然后得到相应的过程能力,因为这边的话呢是非正态,所以说 c b c b k 得不到,因为只有单面公叉,所以说 p p p p l 得不到, 只有上限,所以说只有得到 p p u 和 p p k 啊,这边呢就是 p p k 就等于 p p u, 这边呢就等于零点零点三三啊,零点三三,那么我们下面要进来看一看啊,就是这里的零点三三,到底怎么算出来的,怎么算出来呢?我们来看一下, 那么其实对于呃这个非侦探能力分析啊,我们在文中当中也说明了一下啊,他其实是有两种算法啊,哪里就可以看到呢?我们可以点击文件菜单,我这个呢是 metibo 二一版本啊,如果你是其他的一些比较老的版本呢,你的操作可能稍微有点差 差异,我们点击文件,然后点击选项,然后呢点击这里的控制图和质量工具,在这边的话呢我们可以看到点击一下这个能力分析,那这边的话呢大家可以看到啊,我们对于非正态,我们怎么去计算过程能力呢?其实这里呢有两种方法, 默认的方法呢,其实是 z 值法,只不过我我这里的话呢是把它改了一下,改成了 iso 的方法 啊,我这边的话呢把这个默认方法由 z 值法改成了 i s o 的方法,在 metal 二一版本当中默认的是 z 值法,但是我们今天主要讲的是这个 i s o 的方法,所以说我这边呢 做一些调整,这个让大家要注意一下。好,那么我们来看一看这个什么叫 is iso 的方法啊?那什么叫 iso 方法呢?我这边呢用手动啊,手动计算呢,来给大家做一个简单的演示,简单的演示, 那么所谓 is 方法呢?我们在文中也有详细的介绍,所谓他其实就是帮我们去首先第一步找到合适的分布,然后第二步呢去求相应的分位数,然后把这个分位数求出来以后呢我们带入到对应的公式就可以算出来 ppk, 那么这个分位数怎么求呢?我们在文章当中啊有相对说明,首先我们要去找到分布,那么通过我们刚刚的个体分布标识,我们可以看到指数分布是一个不错的选择, 那么分布是指示分布,那么指示分布它的参数是多少呢?这边呢我们其实啊在个体分布标识啊,你把这个速度结果呢往下拉 啊,往下拉,往下拉,下面的话呢,在你和优度检验的下面呢,这边还有一个分布参数的极大四难估计,说这边的话呢是可以帮我们去估计分布的参数的, 那么我们刚刚找到的是尺度分布,那么尺度分布的话呢,我们来看一看,我们这边的话呢是只有一个参数的尺度分布啊,它的参数呢是尺度参数,是尺度参数为三点零四二六八的这么一个尺度分布。那么有了分布以后呢,我们下面的话呢就去求分位数,求三个分位数,一个呢是 零点五啊分位数,第二个呢是零点九九八六五分位数,第三个呢是零点零零一三五分位数。那么至于为什么要求这三个分位数啊?大家详细的内容呢,可以去看一看,我们会把这个文章发到我们的微信公众号,大家可以去看一看我们的这个微信公众号里面有相关的说明啊,相关的说明。 好,那么下面我们就一起来看一看,怎么去算啊?怎么去算这个三个分位数啊,一个是零点五分位数,一个呢是零点九九八六分位数,一个呢是零点零零一三五分位数。好,那 现在我们来看一看怎么算啊?怎么算呢?我们可以用图形选择概率分布图啊,通过这个概率分布图呢,我们可以非常简单直观的就可以帮我们算出来这三个分位数。好, 我们来看一下怎么算呢?我们首先啊点击图形选择概率分布图,然后这边的话呢,我们为了方便一点啊,我们可以选择查看概率啊,查看概率好,点击确定 啊,所以我们在查看概率当中,我们首先要指定分布,这里分布的话呢,我们刚刚说过用的是十分布,这样的话呢,我们用的是只有一个参数的啊,只有此路参数的这个,呃, 此处分布此处参数呢是多少呢?现在我们在个体分布标识当中已经给出来是三点啊,三点零四二六八 这里的这个尺度参数啊,他是哪里得到的?他是这个指数分布,他对应的这个尺度参数啊,我们把这里呢填进来就可以了,这个玉值的话呢,我们是没有的啊,我们是只有一个参数的尺度分布好, 然后呢我们点击阴影区域,我们把分布找到,它的参数找到,然后呢我们点击阴影区域,我们去求一下分位数,我们首先来求一个顶点五分位数,怎么去求分位数呢? 所谓零点五分位数,其实就是中位数,什么叫中位数呢啊,这个呢,有一些朋友应该了解过啊,那叫中位数啊,就是把数据从小到大排列 啊,然后处于中间位置的数呢,就叫中位数,说白了一点就是这个数啊,有这个数据当中有百分之五十的数据比较小,百分之五十的数据比较大,对不对?那么怎么去求呢?很简单啊,我们选择左尾,然后左尾 的话呢,他的这个阴影的面积啊,这左边这一块的面积多少呢?就是我们百分之五十啊,就是零点五啊,零点五,那就是我们所谓的位数了啊,这就是这里的零点五分位数。好,点击确定,我们来看一看等于多少啊? 好,我们可以看一下他得多少呢?他等于啊,这边呢,简单说明一下,这边为了让他看的清楚,我把这个零把他删掉啊, 可以看到我们算出来的这个零点五分位数得多少呢?这里算的零点五分位数啊,等于二点一点九啊,算出来等于二点一点九啊,啊,这个比较比较简单吧,什么叫 零点五分位数?对应的是二点一零九啊,也就是说在这组数据当中,比二点一零九小的有百分之五十,大的有百分之五十啊,这种叫中位数啊,中位数。好,我们再看一看, 零点九,零点零点九九八六五分位数和零点零点一三五分位数,这两个分位数我们该怎么去求呢?也是一样的啊,我们点击编辑上对话框,然后呢,我们仍然分布还是一样,参数还是一样,我们选择阴影区域 啊,这边的话呢,我们选的双尾,为什么选双尾呢?就是我们在文章当中说明我们所谓的非静态,其实我们要去估计他的过程之深,就是要去第一个通过刚刚的中位数去估计他的中心位置,第二个呢是我们要去构建一个顶点百分之九十九点七三的这么一个区间, 那么中间的区间的范围是零点九点七三,那么落在两边的他的这个范围相加是多少呢?就是百分之零点二,其实零点零 零零二七对不对?落在两边的零点零零二七,那么落在中间的多少呢?中间内就是一减去零点零零二七,就是零点九九八六,对不对?好,点击确定 好,这的话呢,我们就可以把这里的零点九九八六分位数啊,零点零零一三五分位数求出来,这个呢也是一样,我把这个零把它删掉啊,这个 为了看它方便一点。好,那么这样的话呢,我们可以求出来零点零零一三五分位数等于多少呢?等于零点零零四幺幺, 那么零点九九八六五分位数等于多少呢?等于二十点一零。好,我们把这三个分位数求出来以后呢,我们就可以来计算得到这里的。呃,这里多少呢?这里的啊,我们就可以得到 这里的零点三三啊,这里零点三三怎么来的呢?我们来看一下。好,我们来看一下。 好,通过刚刚的分析啊,我们求出来了这三个分位数,首先零点零零一三五分位数等于零点零零四幺幺零点九九八六五分位数呢?等于二十点一, 中位数就是零点五分位数呢等于二点一零九,我们刚已知啊,已知规格上线等于八规格下线没有啊,没有好, 收到这条信息以后呢,我们带入公式,首先我们来看一下 p p p p 得多少呢? p p 啊,等于归个上线减去归个下线,比上,如果是正态的话呢,比上的是六倍四个码啊,为什么比上六倍四个码呢?因为六倍四个码它是包含了百分之九九啊,零点九九七三,那么现在我们 是非正态,没有六倍 c 个码,百分之九点七三,那么怎么去代表这里的六倍 c 个码呢?我们就用这里的零点九九八六分位数减去零点零零以上分数。这样的话呢,我们也可以构建一个零点九九七三的这么一个区间范围,但是因为这里的规格下线没有啊,所以说这边的 pp 呢,我们就算不出来, 然后 p p u 呢? p p u 就是规格上线,原来如果是正态的话呢,它的 p p u 是规格上线,减去均值,但是这边的话呢,我们没有均值,我们用的是中位数啊,减去八,减去二点一零九,然后啊,然后是除以, 如果是正态的话呢,除以是三倍 c 个码,但是如果这边呢是非正态的话呢,我们这边的话呢,是用这个零点九九八六分位数减去我的中位数啊,这样的话呢,我们也可以构建一个所谓的三 c 个码这么一个范围,而这边的话呢, 我们可以算出来啊,这边的 p p u 等于零点三二七四四啊,约等于零点三三。那么同理呢,我们的 p p l 啊, p p l 因为规格下线没有,所以说这个 p p l 呢算不出来, 然后 p p k 呢是这两个当中取一个最小的值,所以说 p p k 呢就等于 p p u 就等于零点三二,七十四就约等于零点三三。 那么大家可以看到这个点点三三其实就是我们在用密码键默认的 iso 的方法当中算出来的 p pk 等于点点三三。说这个算法的话呢,其实就它其实后台的逻辑, 首先找到合适的分布,然后基于这个分布去算对应的分位数,然后分位数求出来以后呢,我们带入到这个公式啊,这里话呢,我们就可以把这里的 ppk 啊,可以把它求出来啊,那么怎 个的一个计算的话呢?当然我们有迷彩软件的帮助以后呢,这个其实就非常简单了,所以说后续大家在算的过程当中的话呢,并不需要再去计算这些分位数,然后去计算所谓的这些公式啊,我们只需要用软件呢,直接把数据啊,通过 理分布标识找到合适的分布,然后呢直接选择分布呢,我们就可以非常简单啊,通过简单单机呢,我们就可以完成相关的计算,所以计算呢,我们这个软件说这节课只是给大家说明一下这个算法,但是公式 并不是重要,那么其实我更加情愿大家去把精力花在哪里呢?花在前端,据说这个数据我们现在用的是非这些非正态的方法,通过指数分布来你和他,那么这个数据为什么非正态?我希望大家把更多的精力点花在 这里,去找一些原因,看能不能找到啊,如果能够找到这个分期变得更加简单,对不对?好,那么呃,视频呢?就到此结束,那么更多内容话呢?大家可以去关注我们的这个微信公众号,这边呢有两个微信公众号, 当然这边我也有我们的联系方式啊,大家可以去关注一下。那么本期课程到此结束,谢谢大家,我是小何。
 03:10查看AI文稿AI文稿
一百二十五个,数据测完之后的话呢,随着时间的图形,我们把每一个点往这个外上画个箭头。这个图我问一个问题,这个图当中挨得最近的两个线之间的距离是什么?这个估计 啊,这个图当中挨得最近的两个值之间的距离是什么?是爱情啊,哈哈哈哈啊,平均值组间组距, 有人,对了啊,分辨率,分辨率,分辨率,嗯,也就是说所有挨得最近的两个之间的距离是分辨率,再过头来把这个值按照某一个区间范围,横坐标是一个区间范围,重坐标有多少个,这个叫做频率。做一张图,这个叫值房图。对的,但实 据我关心的不只是这一百二十五个,我只关心所有的。对,那所有的会怎么样子的?我们做一个实验。好的,下面我们来做一个实验。这个是什么玩意?这里的话呢? 我的小球,小球落的过程当中中间有个挡板,有很多层,那挡板对这个小球往左往右 落的可能性是一样的。现在的问题是,如果说我有很多很多的这样的小球,那么他会是什么样的一个形态?我们把它反过来。好, ok, 好,大家看到了什么样的一个分布状态?哈哈哈哈,再来一次啊。嗯, 这里有一根线,这个下面有一根线,这根线代表的是 这个数值的中间多,旁边少。对,所以说分布模型是用来描述不是个样本,是样本背后虚构的一个总体,总体中数值的分布情况。请问这条 也叫什么形状的曲线?大家可以像个什么?说一说,像一个什么?和尚庙里面有 圣诞也要用。对,各位同学们小伙伴们,如果大家知道,在公屏上打一个出来,有人说抛物线,哈哈哈,布拉图中对,中中中型曲线,对的,有人说概率密度线,这个 很好啊,这个高度外不是概率,他是概率密度,他这位同学说的叫概率密度,很专业很专业很专业,这个很专业。山顶东门取弦,哈哈哈哈哈, ok ok ok, 挺好的。这个是目前大概在这里有多少个 正负多少正负。很好,这里面就有另外一个统计量,正负三十一个码 大约在啊,在所有的点基本上都在正负三星吗?这个方面,童老师你不是六星吗?啊?你给人做多一倍,哈哈哈,正负三星整个就是六星,加入粉丝群,随时随地,想学就学。
764质量大鲜 09:46查看AI文稿AI文稿
奖励为大家讲解了如何处理数据表,如何清洗数据的相关内容,在这一奖励为大家分享数据的标准化。 所谓的数据的标准化就是指在分析之前对数据进行代码化的一个过程,然后利用标准化后的数据进行分析。 通常的情况下,标准的数据包括同区化和呃无量钢处理而使用的方法有两种,一种是最大值和最小值法, 第二种则是标准正态法。今天在这个视频里为大家讲解标准正态法来对数据进行标准化。 首先我们一起来看一下这个数据,这个数据就是在上一讲中进行, 是处理过的数据,那么如果把原数据变成标准化的数据的话,应该怎么处理? 首先天气有两种情况,雨天和晴天。道路有三种情况,城市道路、 乡村道路和自行车专用。城市道路代码一,乡村道路代码二,自行车专用代码三。 然后还有几个看似连续一起连续型的数据。首先我们先把这些数据的这些指标值给找出来, 座椅高度的最小值,这时你从数据表中可以直接看出来,最小值是一,最大值是六, 均值和标准差这里因为它不是一个实际意义上的连续性数据,所以这里的均值和标准差都不用去计算温 度,他的最小值你可以通过最小值的公式 min 来计算得出。 推车可以看到温度的最小值是六十点八六,然后它的最大值可以用 max 公式获得。 好可以看到温度的最大值是七十八点三二,他的均值可以采用 均值的公式获得。最后标准叉可以采用标准叉的公式, 大家记得在选用标准差公式的时候,一般选择的是样本标准差, 因为在很多数据计算的时候,你是不知道总体的数据的情况是什么,当我们不知道总体数据,然后你是抽样数据进行计算的时候,多数采用样本的标准差,样本的标准差是标准差点 s 这个公式 还是温度,然后确定,那这样就计算出了温度的最小值,最大值均值和标准差,这样算成的数据一倍我们后面使用, 那这时呢,你就得到了一个标准化之前的一个参照表, 那么在后面的这些就比较容易进行标准化了。比如在天气这里,雨天是一,晴天是二,那你只需在这里使用 x luca 不公示,或者是 v luca 不公示, 选择哪一个雨天原始数据表里的雨天,然后在哪里寻找呢?在这两个单元格中去寻找 啊,这两个单元格按 f 四给固定,然后最后返回的值是代码值,也按 f 四固定,然后回车,那这 这时就把天气这一列从雨天和晴天变成了带马化的一和二。 那座椅高度由于是这种数据,不需要做任何的更改,那直接等于座椅高度就可以。 在温度这里采用的标准化的方法是用竖直剪掉均直除标准差的方法,那他的公式就是竖直剪掉 它的温度的均值,在这里温度的均值按 f 四固定,然后除上标 准插,然后按 f 四固定确认,那这时就把温度的每一个数值都变成了标准化的数据。同样后面的处理方式是一样的, 在处理这个的时候也可以是等于突发时间,然后减掉他的均值,然后锁定,不要忘记这里应该有一个括号, 除上标准差确定,那这里呢,会有一个看起来不太好看的一个数据, 为什么不太好看呢?因为这个点这个时候他出现的是复制,而时间如果是复制的话是不存在的,那你需要把这一列数据的格式 更改为常规,那这时你就能看到出标准化处理后的数据了,您能看到温度和出发时间,他们两个的数据都是从某一个副职到一个正职,那这样的话, 哎,他都属于一个标准正态分布的数据,这样处理之后,你再去分析的时候,他都能基于同样的一个水平上做数据分析了。而胎压这里来看一下胎 压的处理方式,跟刚才是一样的,直接等于胎压的原始数据,减掉胎压的均值, 然后除上胎压的标准,差点确定 路径的说一句,路径有三种,城市道路、乡村道路和自行车专用。那这时还是用刚才的 x luca 进行选择,筛选的是原始数据表中的单元格,然后在参照表里寻找, 最后返回的是代码值。 好,这时我们把路径做了标准化,后面是风速,风速的处理方式与温度和出发时间是一样的, 直接用风速的原始直减掉风速的均值,然后除上风速的标准,差 点确定,那这样就得到了风速的标准化的序列值,那最后把骑行时间引用过来就 可以了。我通过这个数据这样的一个处理,你就可以得到一个标准化后的数据表, 如果你是用一个塞入表进行分析的话,这个地方一定要留意,因为一个塞入表是没有办法分析含文本型的数据的话,你必须做这种个人化,如果你用其他的 软件进行分析的话,这样的标准化之后能给你带来很大的便利,减少很多的麻烦。好,今天的讲解就到这里。
119六堂课 06:56
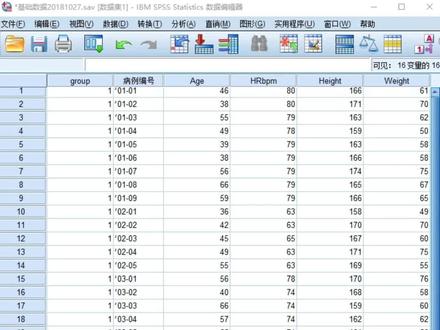 00:42查看AI文稿AI文稿
今天我们来演示一下如何在 spss 中进行正态性检验。首先点击分析描述统计探索,将年龄选入到应变量列表中,点击绘制, 选中带简易的正态图,点击继续点击确定。我们来看结果。 通过正态性检验就可知, spss 采用了 ks 法和 sw 法两种方法进行正态性检验。 请我们可以看出这两种方法的 p 值都是大于零点一的,因此我们可以认为年龄这组数据是服从正态分布的。
1343追梦吧,少年 04:22查看AI文稿AI文稿
哈喽,大家好,今天我们来分享一下非参数检验中两个相关样本的分析。那非参数检验它主要是适用于样本数据不服从正态分布的情况。两个相关样本呢?这个主要是用来检验组内差异性的, 比如说前侧和后侧的成绩是否存在显著差异,这种就是对同一批人他的前侧和后侧的得分进行的分析。 那假如说我们现在要看一下,呃,某一个班的同学,他的前侧得分和后侧得分是否存在显著差异, 然后我们来演示一下操作的过程,把这个数据复制一下,复制的时候带上这个变量名称,然后打开一个新的 spss 文件,在这里点击右键,然后选择与变量名一起粘贴, 这样我们就把前侧和后侧的得分复制到这里了。然后我们还是要先对他进行正态性检验, 如果正态性检验说明他是服从正态分布了,那我们就正常的使用配对样本 t 检验。如果他这个数据检测出来是不服从正态分布的,那这个时候我们就要使用非参数检验中的两个相关样本, 好先做一下正态性检验,点击分析描述统计探索, 然后把前侧和后侧的得分放到音变量列表啊,再点击图,勾选含检验的证 正态图,点击继续,再点击确定。在这个结果里面我们找到正态性检验这个表。 呃,这里主要是看夏皮洛威尔克他对应的显著性,如果这个显著性是小于零点零五, 那也就说明这个数据不服从正态分布,如果他是大于零点零五,也就是服从正态分布这里,不服从正态分布的话,我们就需要使用非参数检验,点击这个分析非参数检验就对话框, 然后两个相关样本, 把前侧和后侧的得分放到右边这里配对这里,然后这个检验类型就用默认的 vr 科科森符号之 检验,然后点击确定。我们主要需要看这个检验统计的表,这里面渐进显著性批值是小于零点零五,也就是说明前侧和后侧的成绩得分是存在显著差异的。 然后像这种非参数检验的话,我们也是不用均值加减标准差来表示他的描述性统计需要,而是需要计算一下他的四分位数, 然后我们来分别计算一下前侧和后侧的四分位数,点击分析描述总计频率, 然后把前侧和后侧的得分放到变量这里,点击统计,然后勾选四分位数,点击继续, 这里可以取消显示频率表,点击确定这个就是前侧和后侧的四分位数, 然后我们把这个检验统计的表,还有这个描述统计的表复制一下这两个,然后粘贴到 excel 里面,把这几个需要用的数据给他弄到这个整理成这样子的格式, 那最终前侧得分的中位数就是九十一点五,下次分位数是九十,上次分位数九十二,然后后侧的也是九十三、九十二和九十四, 这里 p 值是小于零点零五,说明前侧和后侧的得分存在显著差异,后侧的四分位数可以看到每一个都是 大于前侧的得分的。好,以上就是非参数检验中两个相关样本的操作步骤和结果的解读。
502spss小师姐
