pycharm怎么进行图像识别
粉丝176获赞1762
相关视频
 06:31查看AI文稿AI文稿
大家打开我们的排岔膜, 我们要新建项目, 在这里选择我们新建项目的位置, 在 n env 中建立我们的人脸识别项目。 在这个 open cv 文件中先建立三个文件夹备用, 接下来我们直接打开我们的 v env 文件夹。 好,在我们 ok cv 文件里新建一个文件,新建一个拍,新建一个拍摄文件。 首先呢我们要做人人脸识别系统呢,首先我们要有人脸的信息,所以我们第一个文件要录入人脸信息, 接下来我们要在录入信息里边 来写我们的陆陆续续的代码, 打开我们的此电脑,找到我们的拍身环境, 在我们的拍摄环境中,我们要去布置两个文件,复制到我们的项目里面, 布置这两个文件, 布置到我们的 open cv 的 li b 文件中。 好,接下来我们要引入我们的 cv 二图像处理库, 接下来我们定义一个变量来存储录入信息的人的名字, 在这里大家要注意咱们这个名字呢只能使用英文或者中文的拼音。 接下来呢我们要加了我们的人脸检测分类器, 接下来我们就要调用我们的摄像头, 好,这里刚才我们小写了,这里要大写。然后呢我们又运行一下我们的代码, 在这里呢输入我们的英文名字,大家是不是看到了自己的摄像头是不是闪了一下呀,这样就代表了我们已经成功调用摄像头了。
 04:23查看AI文稿AI文稿
oh, my god, 我们这次呢来演示一下拍森批量识别图片文字,并且呢把它写到 excel 表格里面去,那这个批量呢,它可能是以万章为单位的啊, 那我们的整体思路就是用 pase 去调用百度智能云的接口,然后呢我们处理百度智能云返回来的数据,并且呢把它写入到呃,同级文件夹下面啊,保存为 excel 的表格。我们先来看一下啊,百度智能云 啊,那我们这里可以看到啊,我们本月的话呢,是已经调用了两万五千次的这么一个次数啊, 因为做项目的时候数据具有隐私性,我这里不能展展示啊,那我就用一些公开的数据来做个测试吧。 好,那我这个泰斯特文件夹里面有这么六张图片,然后呢第二个文件夹下面也有六张图片啊,内容呢都是从上一个文件夹 cop 过来的。 好,我们现在呢来打开我们的拍摄啊,东西已经写好了,我们来跑一跑 啊,我电脑有一点点卡,我们来看看他需要多久的时间啊?他用了 七秒多一点点的时间啊,七秒,因为我把它写成多进程了,咱们再跑上万张数据的时候就要考虑到性能了,他如果是单进程的话呢,用两个小时,那如果做成 多进程,开四个进程,可能就只需要半个小时就能跑完了。好,我们现在来看一下效果吧, 好,点开。哎,发现没有,我们这个文件夹下面多了两个文件,一个是文本,一个是 excel 表格,其实两个内容是一样的,我们点开看一下啊, 他其实内容是一样的啊,就是一个文件名,然后中间以井号分隔,后面的是内容, 我们这边也是一样的,打开来看一下啊,电脑确实有点卡, 那这个是文件名,然后这边是正文的内容啊,咱们呢一共是六张对不对?我看一下数据有没有少呀?啊?减去表头就是六条数据啊。 然后呢,我还想再展示一下,我们把刚刚那个位于不同文件夹下面,看这里有一个表格,对不对?然后呢, 这里还有一个表格,我现在需要把他们两个汇总一下,把它写在这个同级文件夹下。好看,开始吧,跑一跑,这边 马上就要出来了啊,好,开始了,已经完成了,我们来看一下效果。哎,看这里多出来了一个合并文件啊,点开来, 现在呢,按理来说咱们这边要有十二条数据对不对?每个是六条,所以呢,他这里是十二条数据啊,那这么简单就把我们这件事情给完成了啊, 那这个代码你写好了之后,你以后持续有这类的需求,你只需要点击运行就可以了,这就是 你同样的一份时间付出去了,你的编辑成本就是你后期需要投入的时间,是已经是固定不变的了啊,但是你后期的收益就是他为你节省到的时间, 其实是接近于正无穷的啊。我们这次的效果展示就到这里了,小伙伴们再见。
279仰起45℃脸微笑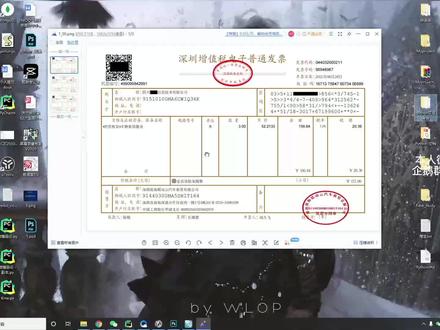 05:53
 02:24查看AI文稿AI文稿
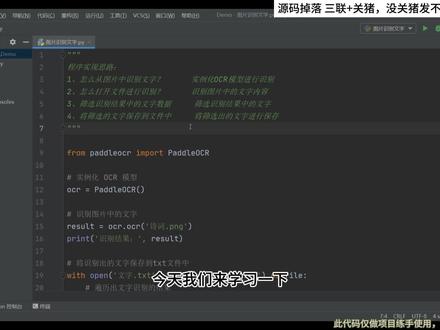
我们来学习一下怎么样拍损程序来识别图像中的文字,这里的话呢,我准备了两张图片,呃,里面这是一个散文,荷塘月色,然后这个话呢,可以看到有很多很多的字,我们想要通过代码把这里图片里的所有字呢给它识别出来。 另外呢还准备了一篇诗词啊,水调歌头。那接下来呢,我们通过程序的方式来简单的运行,看一下结果。运行好,首先的话呢,我们来识别,第一个是识别诗词,就是我们刚刚所看到的这个 水调歌头的诗词,那么可以看到目前正在识别,哎,然后呢提示,我好像已经识别成功了,对吧?那接下来后呢,请注意看,在左边这里出现了一个文字点 txd 记事本,然后就可以看到在这就是我们刚刚所识别出来的文字内容 啊,明月几时有,把酒问青天,现在我们将诗词这个图片换掉,换成什么呢?换成散文,换成散文,也就是说我要让他去识别这个散 文当中的文字内容,这个文字就比较多啊,那么我们来试一下同样的啊,这个是诗词,我们先关掉关掉,然后重新运行一下这个程序。 好,正在运行,那么这里的话呢是一个图像处理,所以他的相对来说时间会久一些,如果你的图像当中文字越多,那么所花费的时间也会越长,如果文字越少的话呢,所花费的时间他也会越短。我们可以看到我们这个散文里面有好多个字啊, 他是有非常非常多字的,所以话呢相对来说速度会慢一点,那这里我们需要稍微等待一小会,好,然后可以看到现在基本上就出来了啊,他已经识别完成了。接下来我们再来看一下我们 识别的文字,用也是在这里边,我是用的 a 的方式追加,那么打开看一下,然后可以看到这是前面那一篇识别的诗词,然后下面这款呢,就是我们刚刚识别的荷塘月色的散文内容啊。最后是但热闹是他们的,我什么也没有确认一下是不是这个呢?但热闹是他们, 我是妹妹, ok, 没错,那这样的话呢,我们就十倍完成了。看一下整体的代码结构吧,代码部分其实主要分为四个部分,第一个部分就是,哎,我们要通过什么方式去实现?这里话呢?使用是 这个 print o r c 啊, o c r 这个库来进行实现了,那么这里先实画一个模型,然后呢读取这个图片文件进行识别,识别完之后,这里是识别的一个结果, 然后再将识别结果他的一个数据呢,进行拆分,进行便利啊,得到我们想要的那一段文字信息,而其他的信息的话呢,我们就不要了,作为筛选剔除掉,所以第三步就是筛选我想要的文字数据,然后第四一步呢,就是将文字数据保存到一个文件当中 啊,那这就是我们程序的一个功能,直线,好的,如果需要元宝同学呢,可以一键三连加评论区留言或者后台私信领取我们这个元。
 01:35查看AI文稿AI文稿
当那是一朵给,孤独,是一朵给。
69快乐的代码蛋 05:35查看AI文稿AI文稿
大家好,呃,我是九天,今天给大家介绍一下如何使用 python 进行 ocr 图像识别。 呃,今天我给大家介绍的这款第三 python 第三分裤叫做 easy ocr, 然后它的特点就是简单,呃,后面你会看到它只需要短短的三四行代码就可以达到一个 ocr 识别的效果。 还有就是免费,嗯,这一点也是相比于其他一些付费的 ocr, 嗯,他的,嗯,优势,嗯,但是的话,相比付费的 ocr, 他可能就是在识别的精确度上可能是有限的 啊。还有一点的优势就是他支持,嗯,多种语言,比如说我们的图下面可能会有中文啊,英文啊同时存在,然后他都是可以进行 一个识别的,嗯,下来,嗯,我就给大家来展示一下,嗯,就是怎样用这个 eocr 进行图像识别,嗯,在我们用行我们代码之前,我们需要做做一些准备工作,那就是安装一些相关的第三方库,这样才能让我们代码能够跑起来。 嗯,这里有两个第三分库,一个是 tort vira, 还有一个是 e z o c r, 嗯,在安装这两个第三分库之后,我们仍然有一点需要注意的,就是,呃,这两个第三分库,它的底层逻辑是有用于到 napa 这个库的, 所以如果你的电脑之前没有下载过 napa 库,就需要对这个库也要进行下载,嗯,而且的话,就是他对 napa 库的版本是有一定要求的,需要我们, 呃,就是大于等于零一点一六点五,小于一点二,三点零。所以如果要是你的版本虽然下载过,但是并不在这个区间之间,那需要把它卸载掉,进行一个重新的下载才可以啊。 嗯,在做完准备工作之后,我们就可以开始嗯,我们的实战了。嗯,第一个实战就是我们提取下。嗯,这张发票名字叫做 invoce 一,就是它的发票号信息, 这个代码我已经全部写好了,把它复制过来, 没有形象。 呃,这里,因为我的电脑是没有呃符合要求的这个 g p u 的,所以说这里设了个 force, 如果你的电 电脑就是它的性能很好的话,你这里如果用这个 gpu 跑的话,它其实速效率会更高一点,更快一点。我这里的话就只能用呃正常的 cpu 去跑,就没法用这个更快捷的这个 gpu 去跑。 哎,我们看到就是发票号被成功踢出来。零一五九九四八五,看一下。零一五九九四八五 a, 呃,是十分准确的。 接下来我们把我们的案例进阶一下。呃,我们想要提取一个文件架,就是这个 这盘下面有一个 gzhocr, 这个文件架下面的所有的发票图片中的发票号。嗯,我把程序也全部已经写好了。 嗯,在这个之用心之前,我们先看一下我们的素材,嗯,我们这个文件夹下放两张图片,因为素材很难获取。现实中可能我们这里有成百上千个发票,直接放在这里,程序就可以自动进行所有的识别。 呃,第一个发票 invoice 一,然后它的呃发票号在这里。第二张发票是 invoice 二,它的发票号也是这个 这个数字零零七三七零一,然后完完整代码在这里,我们把它复制过来,也来跑一下, 点击滤芯。 你是 用 cpu 跑,所以他可能相对慢一点, 那它这里也会提示用这个 d p u 会更快。我现在正在用 c p u。 第一个发票他已经提取出来,而且我们注意到这个发票号跟我们刚才看过的是一致的,所以说他的提取是准确无误的。 嗯,第二张发票也顺利提取了出来,这次我们的程序就全部运行结束了,而且两个发票号都是识别的,十分准确的。嗯, 这就是我们今天介绍的关于 pass ocr 识别的内容。呃,如果大家对其他的一些嗯,用 pass 实现,比如说办公自动化啊,或者数据分析等一些内容感兴趣的话,呃,不只是 pass, 还包括 vb 等一些其他的编程语言的实现方式。 嗯,大家都可以。嗯,评论或者是对我私信,然后我会从中挑选给大家。嗯公分享我的代码逻辑,还有进行演示的,谢谢大家。
 07:48查看AI文稿AI文稿
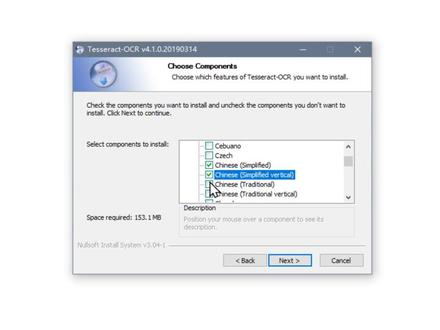
大家好,今天我们使用拍摄来实现一个 ocr, 这光学自负识别, 我们使用的是 tsurt ocr 这个开源的项目,这是他给他按不成一个主页,大家可以看一下详细的说明。那我们以 windows 为例,如果你使用的话,我们首先得安装一个 exe 的程序, 那目前我们安装的是这个安装包,售后我会提供给大家下载。双击启动安装向导,那这里目前他在解压缩 在向导界面上,我们单击下一步 max, 然后同意协议,然后针对所有的用户安装到本机计算机安装的时候有一个选项,就是关于语言的数据,我们要找到所有一千例子开头的一方, 方便我们识别中文简体或者中文繁体的字符。好,然后我们点下一步,他安装的位置,默认是 c 盘不够 pro 跟上 fm 录像,因为我们安装的是六十四位版本。好在这一步 就是告诉我们安装语言包的时候呢,他会告诉我们需要我们联网啊,在线请求下载,那这个时候我们点确定 好,这个时候呢,就安装过程中他有联网下载扩展的一些语言包,方便我们识别非英文友爱的一些其他的字符。 那这里边我们主要是方便他识别中文,所以安装了以千亿字开头的几个简体和繁体的几个包。安装完 windows 的 ex 之后呢,接下来要到 拍摄我们的虚拟隔离环境,我们之前创建了一个虚拟隔离环境,然后接下来如果想实现我们的店铺代码的话,我们要安装基于拍摄版本的一个库,那配平时都安装拍 ts。 好,这个时候呢,我们下载了拍摄版本的一个扩展库,那稍后呢?因为我们要读取图片,我们要安装 plpl plus, 基于拍摄三等针对拍摄二里边的 prl 库的一个兼容版本。 在我们编写代码之前呢,我们首先到 c 盘的目录下看一下刚才我们安装的那个对象装到什么地方了。刚才我们安装的 ese 程序是在 c 盘的扑克上面 beaus, 然后 tsuritocm 录像,那这里边稍后我们使用拍摄编写代码的时候,还会调用一个 ese 程序, 就是我们目前看到的特斯瑞 x 点 ex e, 那可是这些文件,也就是说我们识别提取的工作主要是由他来完成的。然后我们复制两张图片过来,非常简单的,零一是一个包含有英文字符的图片。 好,零二呢是包含一个中文字符的图片,那个图片都比较小啊,没关系。然后接下来我们来写一个简单的 dm, 首先我们要导入一个库,就是我们刚才安装的拍 tsux。 好,到了之后呢,我们把它取个别名,比如说这个 pt 吧。然后接下来从 pl 就是 ps 了,包下边导入一枚就方便我们待会打开那张图片。 第一件事情,我们要找到刚才安装 ex e 的那个可执性文件,因为它是我们核心提取识别的工具,把它路径给得到。然后呢,我们 找到刚才那个路径,找到刚才完整的文件,名称叫 tsurig 点 ex e, 那稍后要把它交给我们拍线库的一个组件去使用。那我们说刚才导入过来的拍 tsurx 就 pt 的对象,他下边的拍 tsur 下边有一个属性叫 tsurk cmd, 就是用来识别的那个命令是谁,那你就把刚才的 pass 给他,就是找到确切的一个自己所在的位置, 然后使用 emax 下边的 oppo 方法打开,我们要识别的图片交给 emg 这个实力。 然后文字呢就非常简单呢,我们直接找 pt, 他下面有一个方法叫以 mate 图 steen 把图片上的文字提取到字符串,把图片传给他。那接下来我们 pro 打印一下。 好,我们看一下刚才我们这张图片呢,那比较规整,那文字呢,也比较清晰,用拍摄运行一下,戴帽点拍,这个时候很快他就识别到上面所有完整的文本,并且打印出来,你在这样就实现了你的图片上文本提取 这个过程。好,这是我们讲的英文,那接下来我们看一下中文,那这里边有张零二点这笔记有一个,接下来播放有自动播放这几个字。 那接下来要识别的话,我们直接跟刚才的方法一样,只是把文件名有零一改成零二,但这次我们发现呢,他并没有正确的识别到上面的中文字符, 那中文字符刚才我们就安装的有扩展的语言包,那这个人怎么办呢?那我们在刚才一没的特思追的方法后边除了指定图片之外的,加上音浪就是兰博基尼,语言为 c h i 杠, c 就是简体中文。在这里又泡了一个错,那告诉我们说刚才你安装的沐浴露下边是不是有 tst a 他这个沐浴露他下边有 c h i 杠性,那有一些训练的一些数据, 那看一下这个里面其实也有,那可能是刚才在下载安装的过程中呢,他并没有下载完整,那这里我们重新把它安装一下。 重新安装的过程呢?这里边并没有录上,那重新安装之后,我们重新再运行一下,点拨点拍好,这次他正确的识别了,只要接下来播放,那后边有自动播放,那发现呢?他有一些乱码,就是说他并没有完整的,百分之百正确的识别, 这些呢,是有一定的误差,所以这个的话心里要做好准备,特别是你的图片不够清晰,或者有一些近似于文字的图案图形的时候。好,那这里实现 呢,我们命令行的版本,他代码的总共几行,那我们看到总体的代码量的并不多,那主要是实力画脸的对象,然后调养方法识别就可以了。 那为了方便日常工作中使用呢,这里包括开发了一个窗体版本,就基于 t k 开发的 gvi 的版本,好代码呢?也不多,总共五十几行代码。那我们看一下,那我使用的这个 t k 开发的窗体版本,那使用的效果 说拍摄帮我运行一下 ocr 点派创体版本,打开之后呢,我做了这么几个基本的组件,首先一个选择按钮,打开,选择一张图片文件, 然后路径显示出来之后,点一下提取文本,他就会将刚才我们选择那张图片上的文字提取到下边的文本框里边。好,那我们换一张,比如说刚才的零二点借笔记,那我们点一下提取文本, 那这里边是中文,那也提具成功。接下来我又准备了一张零三点揭秘记的图片,包括的文字多一些,那时候是一首古诗的,我们接下来使用创题版本的来识别一下,那这个图片比较规整,字符呢比较清晰,然后选择刚才的零三点揭秘记, 然后点一下打开,目前只是记录了他图片的路径,还没有真正的交给我们代码去执行,点一下提取文本,这个时候呢就把刚才零三年记不记的图律图片实力打开,然后正确识别里边的所有的文字。 最后完整的代码和刚才你的 exc 安装包呢,提供给大家下载安装,关注我们的微信公众号,注意是微信公众号,并不是私信回复 ocr 下载原码和 exc 安装包。 最后说明一下,他毕竟是一个开元的项目,如果说你认为他的精度那并不能够满足你的项目需求,你可以考虑使用国内或者国外开发的一些第三方的付费的欧 cr 识别的 app, 所以说不要对开元的项目有过多的一些奢求。
511快学电脑 02:04查看AI文稿AI文稿
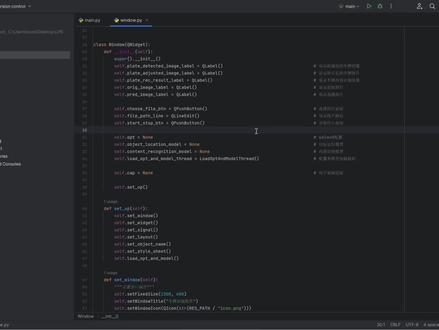
今天给大家带来一款工业智能化程序 ai 工厂刚批批号识别软件,该功能能够对自动化生产的过程中刚批进行批号识别,录入 max 系统,实现无人工厂的一部分。 软件基于 python 和 ocr network 进行模型的训练和验证实现,并使用 pyqt 五进行 gui 界面的制作。 软件运行后能自定义的对单张图片、单个视频以及摄像头多种情况下进行自动识别,并将批号识别结果进行展示,方便后续录入。 max 系统进行结果存储、筛选和异常提醒,跟踪刚批的生产运输全过程。
12程序猿胡66 01:01查看AI文稿AI文稿
我们用英文去看欧冠的方法 是读取方式二表示指读, 最后我们用收函数来显示图片。
20Coinmach 00:14


