comfyui橘猫教程
警告,本视频耗时四个月制作,制作时长五百分钟,陪你系统学习 comfyui 制作视频!这应该是目前最详细的 ai 视频教程了,哪怕你是零基础也能轻松 给你学会。这并不是标题党视频,而是实打实的 ai 干货教程。为了方便大家学习,教程内涉及到的相关资料和学习案例 我都给大家整理好了,老规矩,验个牌试试!本套课程共分为两个部分,一到六节为基础部分,其中包含了 comfyui 的 配置要求以及如何安装与部署、 界面导览与原理介绍、文声图以及提示词的语法,之后还会聊聊 ai g c 的 相关网站以及模型下载,最后还有突升图以及高清修复的过程。那么从第七节课到第十三节课属于进阶部分,先后会讲解 control 内及其诸多预处理器的使用方法 以及使用场景,之后还会教大家 ipad 及其强大功能的应用。随后我们还会学习最基础的 ai 视频生成原理,而在最后,我们将结合前面所学的全部知识, 一起来做一个 ai 视频换脸、转会。这些这些这些都是 ai 生成的。自二零二三年以来, ai 绘图软件 step diffusion 的 发展势不可挡,各种各样的衍生模型插件百花齐放,现如今生成像这样的 ai 视频完全不在话下。那么 我们就一起跟随着时代的脚步,一起探寻 step diffusion 的 comfui 到底该如何使用吧。大家所熟知的 webui 和 comfui 其实都是属于 step diffusion, 而 webui 主要是基于数据库开发的浏览器界面, comui 则是使用图形、节点、流程图设计和用于稳定扩散的用户界面。这边我们将 comui 和 webui 的 优缺点列出来,方便大家做个对比。首先我们来看 webui 这块,它的优点是简单易学,并且操作较为基础与简易, 而它的缺点是不异于长期管理。那么这是什么意思呢?当你在深度学习完 webui, 那 么将节省两到三倍甚至更多的时间。其 次,在插件过多时, web ui 会显得非常的臃肿以及操作费时。那么接下来我们看一下 comfui。 这边我们可以看到 comfui 对 配置的要求较低,这同时也意味着降低了 ai 绘画的门槛,方便更多的小伙伴加入进来。 那么它的优点其实是节点更易于管理,有较强的自主性。我们可以根据个人需求来组装属于自己的工作流, 并且在未来, kufui 将逐渐与 webui 在 应用层面拉开距离。比如前段时间的 s d 三或者国产最新的柯林大模型, 都是第一时间在 kufui 里可搭建工作流并使用的。而对于 webui, 这些最新的模型与插件往往得过一阵子才能时装,甚至直接不时装。所以使用 kufui 也意味着你能够更早地使用到最新的模型与插件。 而康复 ui 的 缺点是初期不好上手,但我相信在你学完了本套课程后,一定能够完全掌握康复 ui 的 基础操作。除此之外,过去我们知道有许多软件,比如 blender、 达芬奇、 ue 等等都是使用节点式工作流, 因为他们有极强的自主性与可模块化,许多头部公司的顶级团队使用的都是节点式软件,那么康复以外,除了上述优点之外,我们在使用时还可以非常方便的套用他人分享的工作流,即刻便可实现相同的效果,节省了非常多的节点部署思路的思考时间 及从单个节点构建成工作流的部署时间。哈喽,各位小伙伴大家好,欢迎来到康复 ui 系列教程的第二节课。那么在本节课中,我们将介绍康复 ui 的 配置要求以及安装与部署的过程。那么首先是电脑配置以及系统环境的介绍。首先是显卡方面, 最低要求是拥有四 g 级以上显存的英伟达显卡,如果显存不足,可能会影响到绘图过程的流畅度。接下来是 cpu, 关于 cpu 要求不高,英特尔十代 i 三以上就可以使用,但推荐使用性能更强的,如英特尔十三代 i 五幺三六零零 kf, 以获得更好的性能。接下来是内存,内存至少需要十六 gb, 推荐三十二 gb 以上,以确保可以加载和运行较大的模型。最后是硬盘,关于硬盘呢,至少需要两百 g 的 空余空间,推荐使用大容量的固态硬盘,因为 ai 绘图过程中会下载和生成大量的模型以及图像数据。那么接下来我们详细介绍一下 cf u i 的 下载以及部署方式。 我们先安装资源包里面附带的启动器运行依赖,接着打开解压之后的 comfort ui 文件夹,在文件夹内找到 a 会式启动器,随后点击一键启动即可。首次启动时可能会安装一些必要的环境依赖, 稍等片刻后,我们便来到了 comfort ui 的 主界面。接下来介绍第二种安装方法,官网资源包的安装。当然关于官网的资源包我们也可以在评论区内获取。我们解压完资源包后,在文件夹内找到这个项目, 双击运行。等待片刻后,我们便可以来到最原汁原味的 cf ui 界面了。这个版本的 cf ui 是 没有装任何非官网的插件的。此外, cf ui 完全离线工作,对 gpu 的 要求相对较低,但是也有 cpu 模式,不过在 cpu 模式下 绘图速度较为缓慢。如果小伙伴们之前有使用过 webui 或其他类型的 stupefuge ai 绘图应用,那么可以通过修改 comfui 的 配置文件来实现在不同的 ai 绘图应用间共享大模型以及 loa 等等,以此减少对硬盘内存的占用。那么接下来我将向大家演示一下 如何将我们的 comfui 大 模型以及 loa 的 加载路径修改成 webui 的。 如果小伙伴们没有玩过 webui, 那 么这一段可以直接跳过。好的,那么我们打开 comfui, 接着我们找到这个文件, extra model pass y a m l 点 example。 接着我们用记事本打开。好的,那么打开之后我们找到这一项 base pass。 我 们要做的是把 base pass 后面的这一串改成我们 web ui 文件夹的路径。比方说我们打开了 web ui 的 文件夹后,我们可以单机上面的这个栏目,随后 ctrl c 复制。接着我们回到刚才的记事本内,将我们刚刚复制的路径粘贴到此处,随后我们保存并关闭记事本。接下来的一步很重要, 我们需要将 example 以及这个点给删除,也就是将我们的文件名后缀改成点 y a m l, 随后点击确定即可。那么接下来我们打开 comui 来确认一下。 好的,我们这边看一下 checkpoint 加载器里面的大模型,点开后我们可以看到多了非常多啊,那么这就证明我们成功把模型路径合并到了 ruby ui 内。好的,那么以上就是关于本期的全部内容了, 欢迎来到 cf ui 系列教程的第三节,那么在本节课中我们将一起了解 cf ui 的 主界面以及各种参数到底代表了什么。最后我们将学习 stable fusion 生成图片的根本原理。好的,我们打开了几位大佬的会事启动器后,点击一键启动, 经过一段时间的等待后,我们便来到了 cf ui 的 主界面。那么我们在面对 cf ui 这个完全陌生的软件时,我们要做的就是初步了解每一个模块的大体含义,那么接下来我带着大家过一遍。首先是操作方式,我们可以通过鼠标的滚轮来控制画面的缩放, 按住鼠标左键,我们可以拖动我们的仕图。点击鼠标右键,我们可以看到有非常多的栏目,这边我们可以试着点击新建节点,随后我们可以看到有非常多的节点可以供我们选择。好的,那么之后我们再来说一下快捷键,生成图片的快捷键是 ctrl 加 enter 框选节点的快捷键是按住 ctrl 加鼠标的左键。移动框选目标的快捷键是按住 shift 加鼠标的左键。 这边我们在框选完后,如果不按住 shift 直接进行拖动的话,我们可以看到此时只有单一节点进行了移动,剩下的快捷键我都放在这了,小伙伴们可以暂停观看。 好的,那么接下来我带着大家一起来解读一下这个默认工作流。首先在这边我们可以看到有个叫 check point 加载器的东西,这个节点的主要作用是加载扩散模型, 也就是我们常说的大模型。此外,该节点还提供适当的 v、 i、 e 以及 clip 模型,具体它们是什么,我们带回讲。我们顺着去控制加载器的节点连线,可以看到这里有两个 clip 文本编码器,在这里我们可以看到它们的输入都是 clip, 而它们的输出都是条件。那么究竟什么是 clip 模型呢? clip 全称为 contrasted language image pre training, 是 由 open ai 公司在二零二一年发布的一款多模态与训练神经网络模型。 clip 模型的作用是理解我们输入文字的意思,比如我们输入 one go, 生成的是一个女孩,而不是太阳, 这就是 clip 的 作用。接着我们顺着 clip 文本编码器的条件输出看过来,连接到了 clip 传感器,这边我们可以看到 clip 传感器一共有两个关于条件的输入,一个是正面条件, 另一个是负面条件。那么这代表着连接着正面条件的文本编码器内的提示词为正面条件提示词,也就是我们常说的正向提示词。同理,下面的则为负面条件提示词,也就是我们常说的负面提示词。好的,我们把目光重新回到 case 函数内, 我们可以看到除了正面条件以及负面条件外,还有两个输入,分别是模型以及 latent, 那 么模型则是连接着刚才的 checkpoint 加载器,也就是我们的大模型。那么这个 latent 究竟是什么意思呢? later 通常是指前空间,可以理解为 stability fusion 内部流程中的图像格式。如果将图像作为输入,则需要通过 v a e 编码将其转化为 later。 数据 在最后输出时,也需要通过 v a e 解码将其转化为像素空间,也就是我们最终看到的图像。这边我们可以看到 k 太阳系的 later 连接着一个叫做 comlater 的 节点,这个节点内共有三个参数, 分别是宽度、高度以及 p 四大小。宽度和高度决定了我们最终生成图像的尺寸,而 p 四大小则代表着每生成一次将出多少张图。比如说我们将 p 四大小改为三,高度改成七百六十八, 随后我们按 ctrl 加 enter 进行生成。好的这边我们可以看到一次性生成了三张图像,也就是我们 p 四树目的图像。接下来我们继续看 k 传感器的其他参数。 首先是随机种,随机种的值我们一般称为种子值,每张图都有专属于它的种子值,我们也可以理解为种子值,就是图片的 id 号码。接下来是运行后操作,点开后我们可以看到拥有四个选项,分别是固定、增加、减少以及随机。如果选择固定,则在你生成完后,种子值会保持不变, 方便你进行其他的调整与操作。那么接下来就是裁量部署,裁量部署越多,计算机的运算时间越长,在大多数的情况下,我们的裁量部署保持二十到三十步即可。接下来是 c f 锯值,该值的意思是提示词引导系数。 c f 锯值越高,则代表着生成图像与提示词之间的联系越紧密。 c f 锯值越低,则代表着提示词对生成结果的影响越小。不过过高或过低的 c f 锯值都会给图片带来不好的影响, 所以我们一般保持适中的 c f 居直即可。接下来是采暖器和调度器,我们可以理解它们为图像的生成方式。如果我们将其他参数比作是食材, 那么它们则是烹饪方式。不同的烹饪方法当然会带来不一样的结果。比如我们点开采暖器后,可以看到有非常多的选项,这里我们目前最好的一般是选择这个 d 片加加二 a m 或者 d 片加加二 a m s d e, 这两个都是挺不错的。接下来点开调度器,我们也是可以看到有非常多的选项,这里我们一般选择的是 carrots。 最后我们可以看到还有个降噪参数,由于该参数是跟图生图有关的,我们以后再说。接下来我们看一下右边有个叫做 v i e 解码的东西,那么我们可以看到这边有两个输入,分别是 latent 以及 v i e。 至于 latent, 刚才我们已经解释过了,也就是前空间图像。那么 v i e 究竟是什么呢? v i e 全称变分字编码器, variation of auto encoder 的 缩写。它是一种深度学习模型,主要用于无监督学习任务,特别是在生成模型领域。 eve 结合了神经网络和概率图模型的特点,而它在康复以外的作用是将我们的前空间图像编码成像素空间图像,或是将像素空间图像编码成前空间图像。除此之外,我们还可以双击屏幕上的空白处,最后就可以搜索节点,比如说搜索加载图像, 或者我们也可以双击搜索预览图像,这边再多说一嘴, ve 解码之后的图像节点,我们也可以直接连接到预览图像上, 比如说我们现在把这个保存图像节点给删去,如果这么操作的话,那么我们生成的图像不会被保存,接着我们再生成一次。 这边还要注意的一点是,在我们搜索节点的时候,我们也可以输入英文,比如说加载图像的话,那么就是 load image, 那 么我们可以看到这两个节点是完全相同的。接着我们再来说一下,比如说当我们输入英文的时候,同 样的也是 load image, 但是这个时候我们加了一个空格,好,我们可以看到这里面并没有出现加载图像的节点,那么这也意味着在我们搜索节点的时候,我们要注意区分节点的名称是否有空格好,比如说我们需要搜索加载图像节点,那么我们删去 load image 之间的空格之后,我们可以看到,哎, 是不是加载头像节点就出现了?好的,那么以上就是关于默认工作流的全部解释,接下来我们来看下界面还有其他哪些模块。首先我们点击左上角,这里有个文件夹, 点开后我们可以看到我们的工作流都保存在这,这边可以点击新建,那么我们就新建了一个新的工作流,当然我们也可以点击这个 import, 也就是输入我们的工作流,或者说是输入我们的文件夹。 最后我们点击 models, 我 们可以在这里找到并且下载相关的模型。接着我们来看一下右边的栏目,首先是该栏目的左上角,我们按住后可以进行拖动, 然后是这个齿轮标志,点开后我们便来到了康复以外的设置界面,在这里我们可以设置语言,点开后我们可以看到有中文,繁体中文,英语以及日语,韩语等等。我们往上翻可以看到有其他的功能,比如图像面板顺序,图像面板的位置等等等等。 我们往下看,这有个文本补全,这个 enable 我 们一定要勾选上,这代表着它的起用。文本补全的意思就是在我们输入提示词的时候,会有这些英文短语的提示, 我们往下看有个添加提示词对联,这个是生成的意思。接下来我们可以看到有个保存的选项,点击该按钮,我们便可以保存当前的工作流以及加载,那么就是加载工作流,同样的意思。接着是重刷新,比如说我们下载一个新的大模型之后,那么我们点击重刷新便可使用。接下来还有个重点就是管理器, 这是 com 浏览器里面最重要的节点,点开后我们可以看到非常多的功能,比如说这边有数据库以及频道方式,预览方法,表情等等等等。这边预览方法我们一般选择的是这个 eight two i g b, 然后表情这一栏我们一般选择的是名称, 也就是标签名称选择了之后,我们可以看到节点的右上方一般会出现一个小狐狸按钮,而小狐狸按钮则代表的是它是官方节点。比如说我们加载一个新节点, 那么我们可以看到该节点是属于 animate develop 节点组的。接着我们回到管理器这六个 custom node manager, 点开后,我们可以看到有非常多的节点,在这里我们可以查找以及安装我们想要的任意一个节点。在今后的学习过程中,我们会频繁使用到这一个模块。 接着我们能看到 model manager, 在 这里我们可以安装我们想要的任意一个模型,注意模型不是节点,它们是分开来的。至于该模块,我们今后也会频繁地用到好的。在介绍完康复以外的主界面以及各种参数后,我们来了解一下 stpt fusion 的 内在运行原理,就可以方便我们理解并掌握进一步的学习内容。 在我们输入完体数词之后,文本编码器的 click 模型会将体数词转化为特征向量,然后再由 e a e 编码器将这些特征向量 传输到前空间内,这些特征向量在前空间内不断的降噪,最后再由 v a e 解码器将这些经过降噪之后的特征向量解码成由一个个像素所组成的图片。好的,那么以上就是本期的全部内容了, 哈喽大家好,欢迎来到康粉 u i 系列教程的第四节课,那么本节课我们将一起学习纹身图的相关知识 以及提示词的语法。在第三节课的结尾,我们一起学习了 step diffusion 康复 ui 的 基础工作原理,那么现在我将结合默认的纹身图工作流来讲解其中的工作流程。首先第一步,在我们输入完正负相提示词后,文本编码器内的 key 模型会将我们的提示词转化为特征向量输送到 k 彩样器内。 那么这边有个疑问,就是文本编码器的 key 模型从哪来呢?我们顺着这个节点往下看,可以看到它来自于 copy 加载器, 而这个加载器主要是加载各种各样的大模型,也就是说文本编码器内的克利普模型是属于各个大模型的内置克利普模型,而不同的大模型之间克利普模型也可能会有所差异。那么接着我们可以看到这个朋友加载器的输出有个 ve, 那 么也就是说它提供了 ve 模型,我们看看连到哪 哦,连到了 ve 解码这里,而 ve 解码的作用就是将 k 传感器内经过了降噪之后的前空间图像解码成像素空间的图像,也就是我们肉眼可以看到的图像。这边我们可以做个实验,先将种子轴固定,最后断开 ve 的 连接, 然后我们生成,我们可以看到这边是直接报错了,而这个报错的意思是缺少了 ve 的 输入,那么接下来我们重新将 ve 模型给连上,随后开始生成。这边再提一嘴,生成的快捷键是 ctrl 加 enter, 非常的实用,请牢记。 如果说你想调节生成图片的尺寸,那么我们可以在空内存这里,比如说我们将高度调成七百六十八,注意这个数值一定是八的倍数,宽度也一样。至于 p 次的话,则是控制单次生成的图片数量。比如说我们设置成二。好的,我们按 ctrl 加 enter 开始生成。 图片生成后,我们是不是可以看到它的比例已经成功变成了竖屏的比例,并且它一次生成了两张图像?好,接下来我们一起学习提述词的相关语法。首先我们来聊聊书写规范, 不论是正向提示词或者是副向提示词,我们在书写的时候一定是英文以及英文的标点符号,不然系统可能会识别错误。比如我们输入 one girl garden, 还有 yellow dress 黄色的裙子,这边再提一嘴,生成的快捷键是 ctrl 加 enter。 好 的,我们得到了一个穿着黄色裙子在花园中漫步女孩的图片。那如果说我们用中文来输入,结果会是什么样呢?一个女孩花园以及黄色的裙子, 我们这边可以看到,不能说是毫无关联吧啊,他们至少图片中都有女孩,但是黄色的裙子以及画圆很明显没有在图片中出现。接下来我们来讲一讲题,数字的权重。 在这之前,首先我们要理解什么是权重。对于权重概念模糊的小伙伴,我们可以理解权重就是比重 分量,那么一个提示词的权重越高,它的分量就越高,它的比重就越高,它在整体中的地位就越高。比如现在一个提示词的权重是一点二,而另一个提示词的权重是零点九,那么当然是一点二的提示词会占更大的比重。 那么接下来我们做个演示,比方说我们输入 one girl garden, one girl 的 权重是一点二,而 garden 的 权重是零点八,那么画面会更侧重于 one girl 的 展现,那如果说我们 one girl 的 比重是零点八,而 garden 的 比重是一点二,那么画面会更注重于描述花园是怎么怎么样的。 好的,接下来我们来讲一讲我们该怎么去控制提数词的权重。首先是中括号,中括号代表着零点九倍的权重,也就是说给提示词加上中括号后,提示词的比重会变小,会降低它的重要性。 那接下来是小括号,小括号代表着一点一倍的权重,比如我们给一个提示词加上小括号后,那么该提示词在画面中的比重 就会增高。最后是大括号,大括号代表着一点零五倍的权重,算是一种微调。当我们给某个体式词填这两个中括号时,那么就相当于为这个体式词加上了零点九乘以零点九倍的权重。零点九乘以零点九是零点八一, 那么就相当于给这个体式词加上了零点八一倍的权重。那么同样的,当我们给个体数词加上两个小括号时,那么就等于一点一乘以一倍的权重,那也就是 点二一,相当于我们给这个体式词加上了一点二一倍的权重,大括号也同理。那么有的同学可能会问,关于这个权重的变化有没有什么快捷键呢?哎,这个还真有。比如我们将光标移动到某一体式词上时,打个比方说, garden 按住 ctrl 加上键,那么就是给它加权重,我们可以看到它的权重在不断的增加, 那么 ctrl 加下键,那么就是减少它的权重,是不是很方便呢?不过我们要补充的一点是,关于权重,我们要多低都行,但是不可过高,因为过高的话图片就会过你和换句话说,图片就会变形, 会失真。接下来我们来讲短句和长句。我相信不少小伙伴都有这么一个疑问,为什么我姐提示词的时候一定是一个一个词这样去拼写,而不是用一句话去描述我们想要生成的内容呢?那么这边我可以很明确的回答你,其实两种都行,但是就目前而言, 用一个一个的词组去生成,效果会更加的准确,更能表达出我们提示词吐含的意思。另外一点,使用一个一个的词的时候,也方便我们进行权重的调整。比如刚才我们有提到,将光标放在某一体字词上, 然后摁住 ctrl 加上或下就可以调整该体字词的权重。那么如果说是一句话的话,你想调整某一体字词,那么可能就得手动去输括号,进行相关的权重调整。当然现在全世界的 a i g、 c 从业者也在不断地去 研究该怎么样让自然语言,也就是我们的长句能达到媲美短句的效果。接下来我们来讲一讲 提示词的整体长度。这边要注意,比如我们在输入正向提示词的时候,并不是说越多就越好,多可能会让你的表现更加糟糕,那么我们最好把提示词控制在什么数量之内会效果最佳呢?经过众多 a、 i、 g、 c 玩家的经验以及研究表明,提示词控制在七十五个之内 是效果最精准的,超过了七十五个提示词的话,可能会对提示词的识别不精准,整体的表现会降低,正向提示词如此反向提示词也是一样的,记住最好不要超过七十五个。 接下来我们来讲一讲骑手势,那么什么是骑手势呢?在 stebiefune 各个大模型训练的过程中,会加入许多的 如四 k, 八 k 或者 masterpiece 各种各样高质量的图形去训练。那么当我们在输入提示词的时候,比方说输入四 k masterpiece, 那 么就可以使我们生成的图像更加的精美。反向提示词的话,那么就相反,比如我们输入模糊就是文,不想要模糊嘛,那么相当于也是会让图片 更加的清晰。或者说我们在反向提示词内输入文字 text, 那 么在画面中就会减少文字的出现。这边我们可以来看一下这几组的对比,差异还是很明显的, 接下来我们来讲讲提示词的顺序。或许有小伙伴会有疑问,一个提示词在整体的前部或者是在整体的后部会有什么影响吗?答案是会有影响,在一组提示词中,越靠前的提示词权重会有所增加。那么在我们书写提示词的时候,我们尽量按如下格式进行书写, 首先是书写那些可以提升画质的,或者说可以改变画风的一些词汇,比如 masterpiece, high quality, high detail, 类似这些词汇。第二步是描述我们画面的主体,比如我们可以说 one girl, blue dress, 一个女孩,蓝色的裙子。 那么第三步就是描写环境,场景,灯光或者说构图,比如我们可以说啊 garden 背景嘛, garden 或者说是 white background, 白色的背景,或者说是 soft light, 柔和的灯光类似于这些。那么最后我们可以在正向题词词的结尾添上我们想要加的 laura。 关于 laura 和各种模型的下载,我上期视频也有介绍,感兴趣的小伙伴可以回去观看。接下来我们来讲一讲题序词污染。那首先我们要知道 什么是体式词污染。我们可以看一下这一组图片,未经处理时,在多个体式词同时书写的情况下,各个体式词的意思可能会相互渗透。那么为了避免这种情况,我们可以用 brick 来隔开体式词, 尤其是防止颜色污染。之后我们来聊聊体式词融合。比如我们写 one girl, cat, 这个我们可以看到生成了一张冒在女孩身上的图片。好的,现在我们在 one girl 和 cat 之间添加上 end。 注意这里的 end 必须是大写,全部大写。这边我们可以看到生成了一张猫娘的图片,这个 end 的 作用就是将两个提示词融合在一起。同样的,下划线也有和 end 类似的作用,也是将两个提示词结合在一块。 除此之外,格一组提示词用中括号括起来,中间再用竖线隔开,也有类似与融合的效果。那么这个的原理是,第一步画前面的关键词,第二步画后面的关键词,第三步又在画前面的关键词,以此类推。最后我们来讲一下控制生成的时间段,比方说现在的迭代步数是二十步, 在这过程中,我想让前百分之三十生成森林,后面百分之七十生成一个女孩。那么我们可以试着这么书写大括号, forest 在 街上冒号, one girl 在 街上冒号零点三,最后以大括号结尾,那么这一长串 代表着是在百分之三十的时候结束画 forest, 开始画 one girl。 那 么如果说文把零点三改成零点七,那么意思就是前百分之七十画 forest, 后面百分之三十画 one girl。 好 的,那么以上就是本期的所有内容了。
粉丝5166获赞1.2万
相关视频
 07:10查看AI文稿AI文稿
这个是一个 comfy ui 的 工作流,非常普通的一版,那么现在我们点一下运行,稍等片刻, 那么经历了一分钟的时间啊,我们得到了这么一张图片啊,就是一张成功的生图了, 那么我也是断断续续学了几个月吗?现在我想把自己学到的一些东西跟大家分享一下,就是如果是没没有接触过的这个的话,大家可以看一看,应该是能够做到一个基础的上手啊,就算是一个比较新手向的一个教学吧。这个关于康复 ui 生图的, 那么首先这个第一步呢,就是配置要求,就是我的电脑的话是四零六零啊,这主要配置是看显卡, 然后显存是一个八 gb 的 一个显存,然后就是我这个电脑配置啊,运行起来如果我生成特别大的图片的话, 比如说二零四八乘二零四八的话,也会出现那种报显存的方式,就生成不出来啊。所以说我建议大家电脑配置主要是显卡啊,你至少是个八 gb 的 显存啊,至少是反符合这个要求的, 反正四零六零升成的话是比较勉强的,但是能用,如果你这个显存有只有四 gb 的 话,我觉得你就不太建议去尝试了,只是配置方面的要求。 然后再谈的就是为什么说我建议大家可以学一学这个部署,本地的这个工作流就是这 comfy ui 呢?就大家肯定会说现在这个市面上什么极梦生成呢?是不是然后 chat gpt 生成这个生图都挺好的呀,对不对? 为什么非要用这个本地的这个康复 ui 呢?是不是这个原因啊,其实就是很简单,就是你用一些极梦也好,这些 gpt 也好,你生成图片的时候是不是他会告诉你涉及敏感内容啊,对不对? 涉及,他有时候会告诉你涉及敏感内容不能生成,对不对?敏感内容是吧? 但是你自己本机生图的话就没有这个说法了,对不对?你想怎么生成就怎么生成,对不对?你生成各种各样你想要的效果,你想要内容,只要你提示给到位了,你可以生成各种各样的东西,自由度更高,对不对?这就是为什么我建议大家可以学学这个本机生图,这就是我要,这就是一个前沿吧,像是 一个是配置要求,一个是八 gb 的 啊,显存八 gb 的 显卡,主要是看这个显卡,然后另一个就是尽量是 哦对,好像尽量的话是用这个 n 卡,我记得就是用这个 n 卡,就是我对电脑不是很懂,但是尽量是用 n 卡,然后如果你不是这个 n 卡的话,好像就好像它这个生成就比较麻烦啊。是这样的, 那么首先关于第一步怎么下载安装呢?这个大家肯定看到有不少人会在发地方发,发完之后就会说后台给我发消息,或者说什么关个注,点个赞是不是?然后再说,然后我后台发给你,这种呢有很大概率他们是来卖课的。 那我这边呢,就直接告诉大家这个下载的这个链接啊,是这样的,这么一个链接,大家可以自己看一下, 截个图什么都 ok 啊,这个是秋叶大佬整合的一个安装啊,一个整合包啊,大家直接去这个链接下载就可以了,然后大家看啊,然后这么多乱七八糟的,你就先把最底下这个,这个一月十九号最新这个你点一下下载就可以了 啊,然后你就正常下就完事了,等你下完之后呢,你下载到哪个位置,你应该自己知道。 然后下载完之后呢,你就去比如说下载到这块,你就会得到这么一个文件夹,然后呢你把它解压出来,解压到什么位置随你解压出来,就这样子给解压出来, 但是呢,因为我这边已经下过了,所以说我就不再解压一次了啊,就是大家,然后怎么解压啊?我我我觉得大家应该都会吧,但是我还是提一嘴,就我怕有的人不太清楚,就你随便找个解压软件就行,比如说啊, 咱们可以用那个,比如说 win r a r 这个来解压缩,打开之后对上面这个就可以,这是正版,咱们直接点击下载,下载之后呢它就会给你下一个安装包,然后你把它运行,运行之后呢它就会下载到你的电脑上面,咱们演示一下也无妨 哎,他就会让你解压缩,然后你点试之后他就会给你下载,你就直接点快速安装就 ok 了。把它都下完之后呢,你就可以点开这个东西, 你下载完之后应该是这么个东西,就点开它,然后,然后呢你就去找你直接下载那个整压解压缩包的那个位置就可以了,然后你点击它打开,或者还有一个更干脆的方法,在这个位置你把它拖过去, 拖过去打开好,然后呢你再把这个东西放到你想要给它放的位置,哎,就可以了,这就是一个非常简单解压缩方法。 好,那么现在安装解压都完成了之后呢,咱们就点开之前下载的那个东西,然后呢打开之后呢会出现这么一个会式启动器,咱们双击他,然后他会说要等一会更新什么的,就让他更, 然后下一件事是什么呀?在左边这个版本管理这块,你呢一开始版本一般情况下不会是最新的,你呢你就点个一键更新。哎, 一建议大家先更新一下啊,因为你刚下载出来的话,可能版本不一定是最新的,你先点个一键更新啊,就是最新版本的话会有就兼容性什么应该会更好一些,反正我建议大家先点个一键更新, 就如果你用出来突然间发现什么时候突然间有问题了,卡壳了,你就把它全部一键更新一下,可能就会解决这个问题。 哦,好,更新完了,然后呢咱们都更新完之后,咱们就直接切换到最新的版本就可以了。哎,我现在这个怎么这样子? 这不用管,反正咱们就更,咱们切换到最新版本之后呢,就是在版本这边你切换点那个勾切换,他就会切到最新版本,然后点这个一键启动啊,稍等一会,启动的话需要一段时间,你需要稍微等一会,他会在这个运行一大堆的东西,你需要稍等片刻。 哦,好,然后它就会蹦出来一个这样子一个界面,当然你们这个一开始一定是什么都没有的,你们的应该是什么都没有的,比如说像是看看啊 啊,你们应该是一开始是这个样子就什么都没有的一个工作流,那么这个第一课的这个下达与安装就到此为止了,咱们回头再继续更新啊。
194雨泽 03:32查看AI文稿AI文稿
大家好,我是陈旭,今天给大家分享一期 comui 的 基础知识,包括快速启动、界面设置,工作流模板模型文件、常规插件等。那么首先我们来讲一下 comui 的 启动,如果我们的 comui 是 通过拉取官方源代码进行安装的,那么我们启动的时候是需要来到我们的 comui 根目录, 然后在根目录右键在终端中打开,通过激活我们的虚拟环境,然后实现启动。但是这种启动方式非常麻烦, 它需要多次输入命令才能够侦查启动。例如我们首先要输入这行命令,然后激活它的虚拟环境,但这个时候很多电脑是没有办法直接激活,比如说我这台电脑,我现在回车看一下, 是因为环境策略受限,没有办法激活,我们还需要输入一行代码,也就是这行代码,然后绕过我们的环境策略受限的一个状态回车,然后我们再输入这行命令,继续激活我们的虚拟环境。点回车看一看, 当它前面变成绿色的 v 一 n v, 就 表示它的虚拟环境已经激活,现在我们输入我们的启动命令,它就可以启动了。 好,它已经开始启动,但是这种启动方式确实比较麻烦,例如我的电脑要输入四次命令,然后才能正常启动,我现在教大家如何设置我们的一键启动按钮。继续来到我们的咖啡园,给目录,在这里右键我们新建一个文本文档,在这里输入 star, 然后注意我们这个后缀啊,一定要设置 b a t, 然后回车, 这个时候它会有一个提示,我们只需要点视就可以,那么现在我们开始编辑一下它,然后对它右键在记事本中编辑,我们已经打开它可以编辑了,那么现在我们只需要输入这样一些命令,如果大家看不清可以放大一些,这些我们都不用管, 唯一我们要关注的是它就是我们的 comui 的 根目录,如何快速找到我们的 comui 根目录呢?只需要在我们根目录这里点击空白处,这个时候我们的根目录地址就可以复制了,比如 ctrl c, 然后回到这里进行替换,然后我们点击保存关闭。好,这个时候我们可以点击它进行快速启动,尝试一下, 好,它已经开始运行,当我们看到这里说明已经启动完成,这种方式是非常方便的,我们只需要点击一下,我们还可以把它右键显示更多发送到桌面快捷方式,然后我们会看到我们桌面有这样的一个按钮,那么每次只要我们想运行我们的 comui, 我 们只需要在这个地方点击一下,我们 comui 就 启动了。 好,看到这里说明我们的 comui 已经是启动状态,那么我们再回到我们的根目录。实际上我们日常使用我们的 comui 经常会用到的某些文件夹。第一个也就是我们的 custom node, 这是我们的一个插件库,比如说我们安装的所有插件都在这里。 第二个核心是我们的 models, 就是 我们的模型库,点进来以后我们会看到这里有 checkpoint clip diffusion models, loras unit, 加载器,包括 vae。 当我们去下载我们的模型文件的时候,我们一定要看提示,要放在我们对应的文件夹里面。还有一个我们经常用到的文件夹,就是我们的 output, 这里是我们生成的所有的视频啊,图片啊,它的一个存放地址。最后一个要讲的就是我们的工作流它到底在哪里? 我们找到这个 user 双击,然后点这里,然后再点我们的 workflow, 这里是我们平时所用的所有工作流,它都会存放在这里。 ok, 我 们的文件夹就算讲完了,因为 comfuse 的 基础内容角度,我们需要分几期才能给大家讲完。今天主要讲了在启动 comfuse 的 时候,如何绕过繁琐的代码行,设置一个快速的启动按钮和我们 comfuse 根目录主要文件夹的处理。请大家点赞、收藏加关注,感谢观看,我们下期见!
653晨序AI工坊 01:45查看AI文稿AI文稿
到底是用惠氏启动器还是用原版康 p u i? 如果说你只想跑两张图自己消遣一下,那你用惠氏启动器是绝对没有问题的。可能有人听启动器这三个字感觉不是特别专业,其实它是国内大佬秋叶为那个康 p u i 专门做了一个整合包,你只需要双击图标,它就会帮你搞定环境、插件、 模型管理,甚至有时候报错都能给你修一修,基本上能解决你百分之九十的环境还有报错问题。但是如果说你想充分学习这个 copy u i, 或者说是拿它当做一个工作,那你就去安装原版的 copy u i, 因为原版 copy u i 是 原大版安装的,你需要自己下载插件,自己下载加速器啊, pixon 啊 g i t。 反正各种各种的东西, 它会帮助你非常有效地了解这个 comui 这个工具,后续再出现了一些爆仓,你可能自己就会修了。像这边这一串警告,如果说我用之前的会式景动器,我绝对不知道它是干嘛的,但是现在我能了解个大概,因为这个 piason 还有这个 c u d a 都是自己装的, 这个意思大概可能是它们版本不兼容,最主要的还是它能帮助你从底层逻辑上更加了解 comui 这个工具,知道它是怎么运行的。这个对你后续学习 comui 是 有很大帮助的,但是 就因为这一点,所以说这个安装门槛非常之高,我自己前段时间安装的时候,大概是熬了两天二十个小时,一点不夸张,各种报错,按来按去就是版本问题,拍摄的版本问题,还有那个 g i t 版本问题 很难,而且我做抖音现在大多数的安装视频都是最早的,也是今年三月份的,今年三月份他的安装视频里很多节点,还有一些插件和环境。他当时用的那个版本到 到现在不过短短几个月,已经是落后了,已经是用不了。我当时按照他那个视频安装的就各种报错,然后我下载的节点也会报错。如果说你不想系统化的学习 comui, 或者没有把它当做工作的需求,那你就去直接误导会试就 ok 了。有想安装原版 comui 的 可以视频里扣个一,我看有多少人。我可以大概试着出一期元旦码 comui 的 安装视频。
1078叫我小利群 09:14查看AI文稿AI文稿
hello, 大家好,今天给大家讲解一款如何从体式词故事产生一套风景图,它每个风景图都是独立的,这里可以看出来,它相对而言的话能保证人物的一致性和场景的一致性,每个图片它相对也是独立,就是你想怎么去使用它都可以。 主要用的是两套节点,第一套配合节点是拉玛模型,第二套是千万系列的模型。像拉玛模型的话,它是属于一个大语言模型,就是你可以给它进行对话,让它给你进行拆解,有点像是肉包系列的,但是它用的是千万的模型,并不是 gdp 或者是 dvd 这样子的。 主要的节点就是拉玛 c p p, 它需要连接的一个是模型的输入和参数的设定,这里参数比较重要的是 max talk, 它这边的话,因为我这边输出十六张空间,当然也可以输出更多或者是输出少一点。如果你要输出像 我这边写的是十六张的风景图,我的文字语言可能会相对的会比较长,所以你的头坑的话,输出数量他也相对要长一些才行。如果你的文字你在里面的描写相对剪短一点的话,你这里头坑也可以给他剪短。我接下来我这边还在跑,跑一下怎么去预览,这个我这边先暂停,给大家先 带着一起做一遍。 首先我们先输入一个拉马的 app, c p p, 上面一个写的是主要的用户提示词,比如你是什么用户,你想要做什么,你想要给他做什么设定里面都可以写中文,不用写英文也没关系。下面的话是一个具体的场景,我就直接复制粘贴了,接下来呢这些就不用改,保留就行。我们把模型传入, 还有参数也要传过来,这里的参数像刚才一样,我写的题是有像做的是十六个封印,那么我就想让它相对长一点,就是三零七二, 像大圆模型,我们就用切入三点六四六, 我们把它选上,我们先选上,选上完之后我们再试一下是不是真的对我们的控制进行分段分界。我这边跑一下, 像这个 token, 它太长了,所以我们可能会运行慢一点。我这边还没有写这边的话是选用的东西,我这边选的,因为都是切位的,所以我这边也就选切位的东西,切位三点五系列的, 如果你选上其他的模型的话,聊天类型,那你把模型放进去也可以。我这边选的是千万的,还有君临,还有 g、 l、 m 的, 现在呢都跑出来了,可以看一下每个分镜,它这里写的都是很很细节的, 二十八岁,褐色的眼镜, p 棕色、深棕色以及尖齿发,然后它这个每个描述都是稍微还是很细节化的。这里有十六张风景的图片的一些具体内容,现在我们把这些风景图,风景的文本转成图片, 现在就用上了千万模型系列的,我们现在搭下千万模型,千万的话,像之前一样,我们需要一个模型的输入,用内存加载器,还有可拎可加载器, 文本输入,还有然后我们还要需要一个可以裁量器, 现在这模型跟 k 采集器是最重要的两个,我们现在开始搭建一下,像 u n t 的 话,我们用的是文本类型的,就是二五一二,它是它是主要控制整个千万系列的,通过图像,通过文本生成图像的一个模型, 然后还有可厉害,我们就用千万的千万三杠四,再这样用第一个吧,然后我们选上千万,接下来我们要输入一个文本, 需要文本加载一个正向提示和负向提示词,负向提示词的话我就复制一下 正常提示,就是需要把这里面的东西转进来。我现在先不处理,不能直接连,直接连的话他会当做一整这整个信息,当做一张图像,我先把其他的连好,然后像模型的话,我们选用了千万千万的二五一二,二五一二的话就是将图片,将文本, 然后根据文本去生成图片的一个主要工作流程,然后我们再加上一个 lala, 他 这个比较大,所以可能会比较慢。我们用一个加速器, 然后用的也是二五一二系列,这样子的话我们可以加快这个模型的速度,把它连接上,然后再把正向和负向连接上,这时候我们看到还需要一个空勒着,空勒着的话就是一个前空间,需要把我们 的一些深层的图层进行一个压缩,然后再进行一个解压,然后生成一个同样我们适合的大小的空间, 我就给它长宽,就是设置一下三四四和七六八差不多,设置完之后我们就给他再添加一个 彩样算法,因为原本的话我们加完加速器之后,他原本的这个模型他彩样,嗯,不加其实也没有关系,但是我原先是加了一个,他可以让整个模型的彩样就是统一化, 像我上个视频提到过它的这个彩样算法,像有些模型它是不太建议去使用的,就像那个 flag 模型,但像千万模型去使用它的话,它对整个彩样的一个画面感会相对会好一点,如果你想去掉的话,它的影响也不是特别的大,也没有关系,给他就设置成一零。 这个彩样呢,就是跟之前有提到过像,如果说我这边设置了二十步,就是二十步太高了,我设置四步,然后 cf 只设置为一, 这四步的话,原先的产量可能不加他,他也许是从一点零,然后到零点八,再到零点六,再到零点四这样子,但是如果我加上了这个产量,我们就会去控制他我这个步数,我这个步数越高,就代表 我里面我里面的,呃,像那个区间,就刚才的零点一点零啊,零点八、零点六,他可能会越越大,可能就变成一点零,然后到零点七五到零点五五,就这样子一直往下,如果他这个偏移的越小,如果我写的是一点零到零点九到零点八这样子, 它越大呢?它更加着重于整个画面的构图构造跟整体。然后它如果数值越小呢?它更偏向于整张图的细节,比如头发呀,手指头啊,还有一些画面的那种细节的描写,我把它加上去,这个影响不是特别的大。然后接下来的话就是 解码,然后再预览图像。 这边呢,我们要把这一段和这一段连接起来,但是如果相直接连,他会把整段话当做一张图片。所以我们还需要一个 easy 的 prompt, 需要这个模块,我们把这里面的给它放进来,它这里可以分段,这个最大只有几行,我这边有十六行,所以我这里写十六就行。如果你原本只想给它分割四行,那你这里给他写个四也没有关系。然后再把这个字母串连接给我们的正常提示词,这整个就做完了,主要的是这个内容, 然后直接运行就可以了。哦, me 还没有。
249白白 02:04查看AI文稿AI文稿
还在被在线 ai 绘图限速画质压缩,今天教你本地完整部署康复 u i 保姆级分布操作存小白也能一次成功。大家好,我是子雾,然后我们给大家介绍一款本地可以升图升视频的一个工具,康复 u i, 它可以生成一些我们想要的图片还有视频,纯本地。然后我们来说一下怎么样开始 本地部署。首先我们包,也就是这个康复 u i 的 整合包,解压之后会出现这三个文件,这三个文件分别是启动器以及 秋叶大佬的康复 u i 的 整合包本身我们双击启动器配置好环境,怎么配置?要先点击添加环境,这个时候选择整合包之中对应的 这个 v 三的整合包,选择文件夹,这样环境就添加好了。添加好环境之后,我们在环境依赖里面运行环境键,然后直接选择这个,点击安装这个最新版的。 至于插件管理就这些东西,整合包里面内置的有就不用大家重复下载了,这些是插件,也就是 comui 工作流里面对应的这个节点,还有模型配套都在,但是相应的整合包比较大,三百多 g。 我们切换内核版本,然后选择最新版的内核,切换到这个版本之后,我们点击开始运行,我们开始运行之后就会输出我们的这个复制,这个网址就可以打开, 就可以进到我们这个里面,对应工作流程都已经弄好了,大家可以运行一下试试效果。
94子悟Aigc陪学 19:31查看AI文稿AI文稿
今天我们来搭建这个一键换装工作流,这个工作流只需要一张照片,加上一个参考图,再加上一段视频,就能生成你想要的使命。这个工作流需要用到什么节点模型?怎么下载?下载好的模型存放什么位置? 一个视频教会你,这里是这个工作流所需要用到的节点,我们按照节点的名字去搜索下载就好了。第一个节点是 k j 的 节点,第二个节点是通用节点,第三个节点视频节点,第四个节点是基础包节点。现在我们说一下节点怎么下载,记住第一个节点的名字, 然后打开管理器,你就是这个 manage, 点击它之后选择第一项,第一项是自定义管理节点,点击这一个点进去之后,它会加载,加载完成之后,在最后框这里输入节点的名字, 输好第一个节点名字,如安装了它会显示这样,那如果你是没有安装的话,你会显示这样的图标,你点击安装,它会显示版本,你选择有数字版,然后点击选择,安装完之后这里会显示重启,重启之后就安装成功,这个界面就是重启完成的界面, 先安装第二个插件,一样的在左上角这个兑换框这里输入节点的名字,输入完成之后,你就可以安装 这第四个节点,它有两个节点选择,我们只安装 id 是 六十四的这一个安装完成插件之后,我们需要更新自己的 com 版本,把版本更新到开发版,我们需要一个启动器去更新,选择您的启动器或者下载一个启动器, 点击起用器之后,他肯定有个版本管理,点击版本管理之后有个开发版,我们点击开发版,然后使用国内的镜像点击一个最新的版本,点击完成之后可以选择更新的版本,更新完成之后他会显示更新成功,把它关闭就好了。 更新完成之后就点击重启,如果你是使用启动器的话,你在启动器那里点击重启就好了。如果不知道怎么启动的话,可以直接关闭后台,然后重新打开就好了。你也可以点击命令键,点击这个重启按钮,点击确定 就能重启成功,那么我们就完成了插件的安装和软件的更新。现在我们开始搭建这个一键换装工作流,什么节点用到什么样的模型,我会教大家怎么下载,然后把模型放在什么位置。 现在我们需要用空白的工作流,点击左上角的加号,创建一个新的工作流。在空白的地方我们可以使用滑轮拉近和拉远,双击空白的地方, 这里输入 unit u n e t, 选择这个加载器。如果你在界面这里双击你搜索不到 unit 加载器这个节点, 就点击右下角的这个设置,然后往下滑动,找到区域设置这里这个有语言 把它设置为中文,详细的可以看置顶视频。我们第一个用的模型是 plus 二的克莱因九 b f p 八量化版的模型,这个模型的强项是运行速度快,画完显示它比平常的模型快百分之三十,并且深层的画质也好。我们选择的这个是 f p 八量化版, 它能在八 g 显存的电脑上运行。现在我们去下载这个模型,我们需要一个空白的页面,在页面这里输入这一段文字,点击回车,我们选择这一个, 然后选择模型库,等页面加载完成之后,在右框这里输入模型名字,往下滑动,找到这一个, 进来之后点击模型文件,在模型文件这里往下滑动,找到这一个,看右边这有个下载,点击下载,然后打开 comu 文件夹,点击 comu, 往下滑动, 找到这个模型文件夹,点击进去之后往下滑动, 找到这个模型文件夹,然后在这里存放模型,我们再回到 comuui, 在 界面这里按 r 去刷新,等它更新完成之后,自然在这里选择你的模型, 然后我们在 unit 的 下方,在这里双击空白处输入可立普,选择加载可立普 这里我们要用一个千万三的模型 f p 八量化版的,在类型这里我们要选择 plus 二的,在官方文件中, plus 二是对应的千万三这个模型作为专用的编码器。千万三这个模型它是新一代的大语言模型,它能理解中文,所以说我们要输入体式词的时候,可以输入中文体式词。 接下来我们下载这个千万三的大语言模型,在这个对话框输入千万三八 b f p 八,我们选择这一个,点击进去之后,选择模型文件夹 往下滑动,因为它是跟 plus 模型配套训练的,所以说这里有个 plus 的 v i e, 我 们把这个 v i e 跟这个可利普一起下载,下载完了之后,我们打开文件夹, 找到模型文件夹,在模型文件夹这里找到这个肯尼普文件夹前面三八 b f b 八量化版那个模型放在这个文件夹返回而往下滑动, 找到这个 v a e 文件夹,在文件夹这里存放 f l s 二的 v a e, 再回到康复 u i, 按它去刷新,让我们在空白的地方双击,再输入 v a e, 选择这个加载 ve, 在 这里就能加载 plus 二的 ve, 然后把这三个模型框选起来,点击这个三个点,选择框,选节点,这里输入模型,然后这三个模型就下载完成。 那么看到克里普这里这有黄色的点,点击这一个点,拖出来,选择这一个克里普编码器, 编码器需要一个正面条件和负面条件,所以说我们选择两个,因为搭建的这个是一键换装工作流,所以说我们需要两张照片, 我们在空白地方双击这里选择加载图像,这里上传一张人像, ctrl 加 c, 加 v, 复制一份, 这里上传参考图,然后图像需要一个编码器,我们点击图像这里选择这个编码器,下面这个图像也是一样的,选择这个编码,他们这有个 v a e, 我 们把 v a e 连接上, 然后在 v a e 编码这里双击空白的地方,我们这里输入一个参考,选择这个参考类型,我们这个需要四份,所以说粘贴复制四份, 然后把 ve 编码内存连接上一个编码,连接两个,一个是正面条件,一个是负面条件,这个也是一样的, 然后把正面条件的相连,负面条件相连,这是正面条件,把这个正面条件相连,负面条件负面条件相连,然后把正面条件的 k 符相连, 后面相连,然后在这个空白地方,我们需要个 k 裁剪器,然后选择个 k 裁剪器,把正面条件连接和负面条件连接, 还需要个模型,我们把 plus 二的模型连接上,这个需要一个内存图像,我们双击空白处,这里输入空,选择这个空内存图像,图像连接上,然后 k 裁剪器这里还需要一个解码,把这个叉槽拖出来,选择这个解码, 然后它需要一个 v a e 连接,把这个 v a e 连接上,然后在睫毛这里我们点击这个图像, 这里选择这个预览图像,然后在 k 渲染器这里有个步数,我们选择一空滤镜图像这里有个高度和宽度,这里就输入图像的高度和宽度,然后我们在提示词这里输入一段提示词,输入这一段提示词,然后在预览图像这里点击这一个。 设置好图片,我们看一下运行成功没有问题,让图一的人物穿上图二的服装,生成图三的照片。恭喜自己搭建完成了这个工作流的一半,牛 逼,牛逼,这是两段工作流,所以说搭建完成这个工作流,我们需要清理他的显存,我们在任意解码和图像预览这里双击空白处,在角落框这里输入清理, 选择这个清理显存占用,然后把这个图像的线连接到这个输出口,在这个输出口的线连接到图像,然后我们在运行这个工作流的时候,它会自动清理显存占用量,然后我们要加载一个重要的节点,双击空白,地方这里输入页面, g s i n i g e r e s i z e。 选择这一个工具,这个节点有什么作用?就让你生成的视频它的比例协调,右边的这个是没加这个节点,左边的是加了这个节点,这个节点的作用就是让你的照片根据视频的比例去调整,然后它所生成出来的视频就会协调, 左边的这个是照片节点,右边的这个是生成视频的参数,我们把照片节点的参数调整成视频节点,参数一致,二手生成出来的视频比例大小都刚好合适。现在我们来调整这个节点的参数,在第三个选择,像这里点 击下之后我们选择第四个,然后在第一次选择,像这里我们点击选择最后一个, 调整好它的参数之后,我们点击清理内存这个节点,把这个线连接上之后,我们需要导入一个工作流,如果不知道工作流存放到什么位置,打开你的康复 ui 文件夹,点击文件夹往下滑动,找到这个文件, 点击进去就找到这个文件,然后就找到这一个文件,这里面的存放工作流,然后回到 com 界面,点击旁边的这个工作流, 然后这有个刷新按钮,点击刷新这里就会显示工作流,然后我们点击刚刚导入的这个工作流,点进去之后他会有包错,这些红色的框框不用担心,我们现在解决这些问题,点击右边的这个开关属性这一个工作总览,我们点击错误这一栏, 在这个地方显示的都是报错,现在我们解决第一项报错,他这里显示的是缺失模型,那么我们只需要下载模型就好了,这是模型的名字, 这个模型是 sim 三是图像和视频分割模型,就是他能检测图中的东西,并且把它分割出来, 这是这个模型的安装要求,二点七或者是三点一二或者更高的版本,这是科大的要求,十二点六或者更高的版本,你才能使用这个插件,这个也是主要插件,它的分割图像,然后点击这个复制按钮, 都在之前下载模型的网页端,在这里输入这个模型名字,回车键,如果这里不显示这个模型,我们把这些后缀名给删掉, 在回车键,然后这里就显示这个模型。点进这个模型,又点进这个模型文件,往下滑动,这里就能找到对应名字的模型,我们点击下载, 下载完成模型,点击康复语音文件夹,往下滑动,找到这个模型文件,又点击这个文件夹, 然后这里存放在这个模型,然后我们回到 com 界面,按 r 刷新,刷新之后就能在这个节点加载这个模型,加载完成模型之后,它还是显示报错,有红色的框框,我们就按键盘上的 f 五去刷新这个界面, 刷新完界面之后,他就不显示红色的框框,我们这个模型就加载成功。我们先去下载第二个模型,这个模型是视觉模型,他的分析图片,这个是模型的名字, 我们点击这个复制在这个框,这里输入这个模型的名字,点击回车,他可能找不到这个模型,我们把自己后缀名删除掉, 这里就显示这些模型,我们找到这一个作者的名字是 kb 九七幺幺的,点击它,再点击模型文件,这里就能下载这个模型。 下载好模型之后,我们点击 com 文件夹,往下滑动,找到模型文件,往下滑动,找到这个,我们把模型存放在这里,存好这个模型之后,回到 comui, 一 样的操作啊,去刷新, 按完之后这就能加载模型,然后我们刷新一下页面,刷新完成。现在我们还缺少四个模型,需要下载。接下来我们下载第三个模型,这个模型是一个 lala 模型,它是一个加速模型, 他的名字这里有个四八零 p, 他 在这个分辨率下,加速后的画质保持的最好,这是他支持的生态系统,包括 lts 二点三千万的模型,混元的模型。现在我们下载这个模型,复制他的名字, 那就要框这里输入名字,如果搜索不到,我们把后面的后缀名删除掉,这里有个链接,我们点击进去,点击模型文件,往下滑动,这有个 lala, 点击进去这有一个模型,这个模型后缀名是六十四的,这个其实也可以使用, 我们再点击模型库,在这里输入模型名字,然后把后面的后缀名全部删除掉,只留前面这一个,点击回车。在这里我们找到第一个模型,点击它,再点击模型文件,往下滑动,找到这个 lala, 然后这里有个后缀名,是二五六的,如果显成高的可以下载这一个。现在我们存放这个洛拉文件,点击 com 文件夹,往下滑动,找到模型文件,再往下滑动,找到洛拉文件夹,这一个 都把模型存放在这里,存放好之后进入 comui, 按二去刷新,然后在这里就能加载这个洛拉。 我们已经下载安装完成了三个模型,还有最后三个模型,厉害,现在下载第四个模型,我们复制他的名字,在这个框子里输入名字,把后缀名给删除掉,这里这有这个模型的亮化板,这个模型能使用, 点击模型文件,这里就能下载这个模型。如果你想使用 iphone 十六的,然后在搜索栏这里输入万二点一康复 u i, 点击回车,这里有一个文件夹,这个意思是万二点一专门为康复 u i 模型打包的一个文件夹,我们点击进去, 再点击模型文件,找到这个文件夹,再往下滑动,找到这个变音器,这里就有两个模型,可以选择性下载,下载完之后我们点击 com v i n, 往下滑动,找到这个模型文件夹,然后再找肯德福文件夹,把下载好的文件存放进去, 转换完成,我们进入 com 爱按二刷新,然后这里就能选择这个可立谱文件。现在我们最后还剩下两个模型下载,现在我们开始下载第五个模型,这个模型是个 ve 模型,我们复制这个模型的名字,在这个搜索栏粘贴名字,把后面的后缀名删除掉, 这里这个是些模型的卡片,我们点击第一个,再点击模型文件, 这里就能下载这个模型,你可以更改它的名字,更改成 y 二点一 v a e 下载好后,我们投放 v a e 模型,点击文件夹往下滑动,找到模型文件夹, 再往下滑动,找到这个 v a e 模型文件夹,点进去转发模型,回到页面,按按去刷新 这个地方就能加载这个 ve 模型。现在我们只剩下最后一个模型,需要下载 这个模型是个主模型,这个模型主要功能是让你的视频参考图片,并且进行角色替换,这个模型合成了六万多个运动数据,所以说这个新模型是很强大的,这个模型在七零四 p 下效果是最佳的。 现在我们来下载这个新模型,复制它的名字,在对话框这里粘贴名字,然后把后缀名给删除掉, 前面的这个也删除掉。回车这里就有这个新模型的名字。我们选择第一个,点击模型文件,再点击这一个,这里就能下载这些模型。第一个模型是满血模型,第二个模型和第三个模型量化版。 如果你是五零系显卡,可以选择 f p 八这一个,这个会快一点点,如果你显存不够大,我返回这个界面,在这里有个 g g u f 版,这有个模型文件,这里就点下载 g g u f 版的文件。下载好文件之后,我们点击 com u i 往下滑动,找到这个模型,再往下滑动,找到这个模型文件,把模型存放进去, 转换完成。我们回到页面,按按刷新,这里就能加载这个模型文件。现在我们的所有模型都下载完成,下载成功,牛逼牛逼。现在我们把这个工作流全部复制 框,选 control 加 c, 回到我们搭建好的工作流这里, control 加 shift 加 v 粘贴,我把这个模型拖下来, 按住 shift, 点击这个蓝色的标,把它连接到这个图像上,把这个加载图像删除掉,这样就完成了一键换装工作流的搭建。 nice, 现在我们说一下这个工作流怎么使用,在这里是添加视频的地方,我们选择一个视频,选好视频之后,这里是强制帧, 这只帧数上限就是你这个视频要跑多少秒,如果你想跑十秒的视频,就用二十四乘十,那么等于二百四十四,那如果你想跑十六帧十秒的视频,就这里输入十六,那么十六乘十,那就是一百六十六,就在这里去调整这个视频的时长, 在这个地方这是调整输出视频的时长,这里的帧数显示六十五,我们参考的视频是二十四帧,那么六十五除以二十四,就等于三秒钟左右的视频。 在这里运行的话,就能生成三秒钟左右的视频。我看到这边这有个第一段框,选数之后,按 ctrl 加 b 就 能把它打开, 打开之后可以看到这是八十一,用八十一针除以二十四三秒多的视频,那么两段结合起来,这一段跟第一段结合起来,就能生成五秒钟左右的视频。如果想生成更长视频,就把后面的打开图像节点怎么使用? 如果输入视频是五幺二乘八九六的,再把五幺二粘贴过去,八九六粘贴过去, 这样你生成的视频比例就会协调。如果你在运行的时候,在节点这里报错,就把这个注意力模式 关闭掉。在加载视频的节点旁边,这里就是调整输出视频的分辨率,你这里输出多少,要在这个图像节点这里调整多少,他们是对应的。这个工作流搭建完成,运行成功,哈哈哈。
846熊猫怪兽AI日记 19:57查看AI文稿AI文稿
大家好,这里是秋叶,在二零二六年上半年,各种衍生模型和插件层出不穷,现如今生成这样的 ai 视频完全不在话下,很多教程也满足不了大家的使用需求, 所以我联合几位老师制作了一套新的 comui 教程。教程会从软件安装到文声图图声视频,再到电商产品应用, ai 视频生成, 从入门到实战应用,一步步带大家掌握并使用 confui。 无论你是完全不懂 confui 领域的小白,还是说已经熟悉这个领域的老手,相信在看完这个系列教程后都能有所收获。 教程中用到的新版 confui 整合包以及整理好的工作流模板和模型,老规矩还没试试地验个牌, 接下来我们正式开始上课。哈喽,小伙伴们大家好,欢迎来到本期 comfui 系列教学这一节,我们将一起熟悉 comfui 的 操作界面,了解各个区域的作用和常用功能,为我们后续搭建和使用工作流打好基础。 接下来我会按照从上到下、从左到右的顺序,带大家依次认识和了解 comfui 的 顶部菜单、左右两侧功能区以及画布上的常用工具。 其实这一节的重点内容就三件事,工作留在哪里、打开和保存、任务怎样运行和中断,遇到问题以后去哪里查看日记, 只要掌握这三点,就足够跟上后面的操作了。另外,再分享一个学习 ai 很 实用的小技巧,遇事不决先问 ai, 碰到看不懂的功能或者工作流运行报错时,可以把界面截图、报错信息和 copy ui 网址一起发给 ai, 再简单说明自己刚刚做了什么,想实现什么,提供的信息越完整, ai 就 越容易帮你定位问题,快速缩小排查范围,少走很多弯路。 如果你平时也在使用 work 八 d codex 这类 ai coding agent, 还可以让他们直接检查运行环境、配置文件和报错信息,协助你进一步排查和解决问题。 ok, 好 的,接下来我们就从左上角开始正式认识 comfyi 的 操作界面。最上方的 idol 表示 comfyi 当前处于空闲状态,还没有工作流正在执行。当我们点击运行开始生成以后,这里会显示当前任务的运行状态。 下面的 video minimax h 三就是当前工作流的名称。之所以选择这个案例作为演示,是因为在我们制作这期内容的时候,海螺的 minimax h 三模型在 ai 视频领域热度非常高,很多小伙伴也比较关注它的具体使用方法, 所以这期内容就直接用它作为案例,带大家完整了解一个视频生成工作流的搭建和运行过程。 同时,我也把关于 minimax h 三的使用说明整理成了文档。为了方便小伙伴们学习和研究,感兴趣的小伙伴可以在评论区自行领取 comfyui 支持,同时打开多个工作流,每一个工作流都会像浏览器标签一样单独显示,在顶部标签旁边的加号可以新建一个空白工作流。如果以后想从零开始搭建自己的节点流程,直接点击这里即可。再往下,我们会看到图形这个选项, 这里代表当前使用的是节点图编辑模式,也是 com p y 最核心的工作方式,在这个模式下,我们可以直接在画布中查看节点之间的连接关系,调整参数,并搭建完整的工作流。 点击图形右侧的小箭头,可以展开当前工作流的更多操作选项。其中比较常用的几个功能大家先了解一下。 重命名可以修改当前工作流的名称,方便我们管理多个不同的工作流。复制则可以快速复制当前工作流,生成一个新的副本。如果你想保留原来的版本,同时尝试新的调整复制功能会非常方便。 添加到书签可以收藏当前工作流,方便以后快速查找。下面的保存和另存为就是我们平时管理工作流最常用的功能。 保存会直接记录当前的修改,并覆盖原来的工作流文件,另存为则会保留原来的文件,同时创建一个新的工作流副本到自己的工作流库。导出,可以把当前工作流文件保存出来,方便备份或者分享给其他人。 导出 api 则主要面向开发者使用,可以将当前工作流转换成 api 调用格式,方便后续通过程序或者 a i a 诊进行调用。 最下面的清除工作流和删除工作流,大家需要注意区分,清除工作流只是清空当前画布上的节点内容,并不会删除已经保存的工作流文件,而删除工作流则会直接移除当前工作流,所以使用时一定要谨慎。这里也建议大家养成一个习惯, 修改工作流之前先保存,想尝试新的效果时,可以先复制一份,再在副本上进行调整,这样即使修改失败,也可以随时回到之前的版本。 旁边的进入应用模式是 comui 最近推出的新功能,目前还处于测试阶段。进入应用模式以后,会隐藏复杂的节点界面,只保留用户需要操作的参数,更适合把已经制作好的工作流包装成一个简单易用的小工具。 不过对于刚开始学习 comfyui 的 小伙伴来说,这个功能暂时先不用关注,我们这期课程主要是学习节点之间的数据流转以及如何搭建和理解工作流,所以保持默认的图形模式就可以了。点击左上角的 comfyui 图标,就会展开主菜单 最上面的新建和工作流标签旁边的加号作用相同,都会打开一张新的空白画布。 下面的文件菜单主要负责工作流的打开和保存,打开用来载入已有的工作流,保存会记录当前的修改,另存为则会保留原来的文件,再生成一份新的副本。 这里建议大家尽量养成一个习惯,每完成一个阶段就按一次 ctrl 加 s 保存,特别是修改了节点模型或者重要参数以后,不要等到全部做完再保存,这样即使浏览器意外关闭或者 comfy 临时出现问题,也不用从头重新连接节点。 ctrl 加 o 用来打开工作流, ctrl 加 s 用来保存工作流,这两个快捷键以后会经常用到。文件菜单里的导出可以把工作流文件保存出来,方便备份或者分享给其他人。 导出 api 主要通过程序调用, comi 的 开发者刚开始学习时,我们先用好打开保存和另存为就可以了, 等以后需要做自动化调用时再回来了解 api 工作流。接下来我们看一下编辑菜单, 这里主要放置一些日常操作中比较常用的功能,比如撤销、重做、复制和粘贴等。如果我们在调整工作流的时候不小心移动错了节点,或者删除了一条连线,可以直接使用 ctrl 加 g 进行撤销。 如果想恢复刚刚撤销的操作,则可以按 control 加 y。 在 选中节点以后, control 加 c 和 control 加 v 可以 快速复制和粘贴节点。 control 加 a 则可以一次性选中当前画布中的全部节点。 这些快捷键在后续大件复杂工作流时会经常用到,建议大家慢慢熟悉。清除工作流这个功能需要注意一下,它会清空当前画布中的所有节点内容,但不会删除已经保存到电脑里的工作流文件。不过如果当前修改还没有保存,清除以后这些内容就会丢失, 所以在使用之前一定要确认当前工作流已经保存。在编辑菜单下面还有一个刷新节点定义。 在使用 cfui 的 过程中,如果你刚刚新增了模型文件或者安装了新的节点,但是在节点列表或者模型选择框里暂时没有看到,可以点击这里刷新,让 cfui 重新读取当前环境中的节点和模型信息,也可以直接按快捷键二来完成刷新。 再往下是卸载模型和卸载模型和执行缓存,这两个功能主要用于释放显存和清理运行缓存,并不会删除电脑中已经下载好的模型文件。如果你的显存占用比较高,或者刚刚连续切换了多个大型模型,可以通过这两个功能释放资源。 不过需要注意的是,清理之后,下一次运行工作流时,模型需要重新加载,所以第一次执行可能会比平时多等待一段时间。接下来我们看仕途菜单, 仕途菜单主要负责调整 comfyui 的 显示方式,不会修改工作流参数,也不会影响最终生成效果。比如底部面板可以控制底部区域的显示和隐藏, 专注模式可以隐藏部分菜单,让画布拥有更大的操作空间。不过这些功能在我们平时使用 confui 过程中很少会用到,或者说我们接下来会有更好的操作方式。 这里的 kj node 有 的小伙伴会有,有的小伙伴可能不会显示出来,关键是小伙伴们的整合包是否已经把 kj 的 节点整合进的整合包里面。我们课程演示的整合包已经是整合进去了的 kj node, 它是开源社区大佬 kj i 做的一套关于 comfuse 自定义节点合集, 不是某个单一功能节点,而是一堆实用小工具的集合,主要解决工作流理的各种麻烦和效率问题,妥妥开源社区的建设者,值得我们尊敬。 主题功能只会改变 confui 的 界面外观,不会影响节点参数和最终出图效果。本次视频内容使用的是默认深色主题,建议大家学习过程中保持一致,这样跟随课程操作时更容易找到对应的位置。等熟悉 confui 以后,再根据自己的习惯调整界面主题就可以了。 菜单中的 nose 二点零是 comui 新版的节点显示系统,它主要优化了节点的显示效果和交互体验。不过由于部分第三方自定义节点还没有完全适配,所以在一些情况下可能会出现兼容问题。 为了保证课程中的界面和大家实际操作保持一致,入门阶段建议先使用当前默认节点界面,以后想体验 nose 二点零可以随时开启,如果遇到兼容问题,再切换回来即可。 下面的浏览模板,它会打开 comfyui 的 工作流模板中心,这里提供了很多已经制作好的视力工作流,包括官方提供的模型案例, 以及一些第三方节点提供的模板。点击某个模板以后,对应的工作流会直接加载进来。同时, comfyui 也会检查当前电脑是否安装了模板所需要的模型,如果缺少相关文件,通常会给出对应提示。 不过模板虽然方便,但不建议大家打开以后直接点击运行。更好的学习方式是先顺着节点之间的连线,观察整个流程模型从哪里加载,提示词传递到了哪个节点,图像经过哪些步骤处理,最后又从哪里输出。 当你真正理解这条数据流之后,别人的工作流才不只是一个可以运行的文件,而会逐渐变成你能够修改和创造的新工具。接下来我们进入设置,打开设置以后,左侧会看到 copy、 外观、遮罩、编辑器等分类。 如果安装了第三方扩展,也可能会增加对应的设置选项。在 copy 分 类中,可以调整开发者模式、错误提示、工作流保存方式以及执行预览等功能。 对于刚开始学习的小伙伴来说,大部分设置保持默认即可,其中开发者模式主要面向 api 调用和插件开发,目前阶段暂时用不到 错误提示,建议保持开启。当节点执行失败时, comui 会直接提示具体出错的位置,比我们盯着一张没有反应的画布慢慢排查要方便很多。这里还有一个管理扩展功能需要单独说明, 它主要管理的是自定义节点,在 confui 前端中的菜单面板和快捷功能,自定义的选择开启或者关闭某一个节点。主菜单最下面的帮助提供了官方文档、社区问题反馈以及版本信息等入口, 当遇到普通操作问题时,可以优先查看官方文档。了解完顶部菜单以后,我们把主菜单收起来。再来看左侧的竖向的工具栏, 这里主要集中放置了 comfyui 日常使用中比较常见的几个面板,包括生成资产节点、模型、工作流和模板等功能。 其中素材面板主要用于查看已经生成的图片、视频以及其他输出内容。节点面板可以搜索 comfyui 自带节点和安装的第三方节点,找到以后可以直接拖入画布中使用。 模型面板则会显示当前 comui 已经识别到的本地模型。工作流面板可以帮助我们快速查找和切换已经保存的工作流模板面板则会打开之前介绍过的工作流模板中心。不同版本的 comui 左侧工具栏中的图标顺序可能会有所变化, 如果暂时不知道某个图标对应什么功能,可以把鼠标停留在图标上,稍等片刻,界面会自动显示对应名称。 在左下角还有几个非常常用的入口,问号图标对应的是帮助功能,类似命令行窗口的图标可以打开日制面板,键盘图标可以查看快捷键,齿轮图标则会进入设置页面。这里需要大家重点记住日制面板 以后,在使用 ctrl u i 的 过程中,无论是模型加载失败、节点缺失、显存不足,还是工作流执行异常,第一时间都应该打开日记查看原因。每次运行工作流时,模型加载过程、节点执行时间以及运行过程中产生的错误信息都会记录在这里。 例如我们碰到什么报错问题的时候,我们可以把这里面的内容点击一下这边右上角的复制按钮,把报错信息复制出来。然后来到我们最近很火的 workbody, 跟他说帮我解决一下这个报错问题, 接着再把报错信息粘贴进去,最后点击发送。 workbody 会根据日期内容分析错误原因,并给出对应的解决方案。比如缺少哪个节点,哪个模型路径配置错误,或者应该修改哪些参数, 他会一项一项的帮你把报错问题弄好,这样无论你遇到什么问题,基本百分之九十五左右问题都可以成功解决。对于刚开始学习 compi 的 小伙伴来说,学会利用 ai 辅助排查问题,会大幅降低学习过程中的试错成本。 以前可能需要搜索半天的问题,现在通过完整的报错信息,往往几分钟就能找到排查方向并解决问题。刚开始学习 confui 的 时候,不需要一次性记住所有快捷键,先掌握几个最常用的操作就可以了。比如 ctrl 加 s 用来保存当前工作流, ctrl 加自己用来撤销刚刚的操作, ctrl 加 enter 可以 快速执行工作流。二、可以刷新节点定义。另外还有一个非常实用的小技巧,在画布空白区域,双击鼠标会弹出节点搜索框,我们只需要输入节点名称,就可以快速找到并添加对应节点。 这个操作在后续搭建和修改工作流的过程中会经常使用,大家可以提前熟悉一下。接下来我们看右上角的运行区域, 运行按钮左侧的数字代表一次提交到任务队列中的执行次数,默认情况下这个数字是一,也就是说点击运行以后,当前工作流会执行一次。如果把数字修改成五, 那么同一个工作流就会连续加入五次任务队列,适合需要批量生成相同流程的情况。中间蓝色的运行按钮就是启动当前工作流的入口,点击以后, comfyui 会根据节点之间的连接关系和数据依赖顺序依次执行计算,最后生成对应结果。 那么运行按钮旁边的小箭头还可以展开更多执行相关的选项。不过对于刚开始学习的小伙伴来说,在是保持默认设置,直接点击运行即可。 右侧红色的叉号则用于停止当前正在执行的任务,比如发现提示词填写错误、参数设置不合理,或者生成时间过长,不想继续等待,都可以点击这里中断任务。除此之外,也可以使用 ctrl 加 alt 加 enter 快 捷键快速停止执行。 最后我们来看一下画布右下角的工具区域,这里主要负责画布的浏览和管理。箭头按钮用于选择和移动节点,旁边的小箭头可以切换不同的画布操作方式。 定位按钮可以帮助我们快速找到当前选中的节点,也可以重新调整整个工作流的观察范围。旁边显示的百分比数字,比如这里的百分之三十九代表当前画布的缩放比例。通过滚动鼠标滚轮就可以自由调整画布大小。 地图图标可以打开小地图帮助我们快速查看整个工作流的整体结构。连线图标则可以控制节点之间连接线的显示状态。 随着后续学习深入,我们搭建的工作流会越来越复杂,节点数量也会越来越多,很容易在大画布中找不到刚刚修改的位置。这些工具就是帮助我们快速定位节点和管理画布的重要功能。最后再补充一下顶部出现的一些扩展功能, 像 manager、 show image feed、 key monitor 以及菜单中的 kj notes, 都不是 confu i 默认自带的功能,而是在安装第三方扩展之后增加的。 其中 manager 是 目前使用频率比较高的扩展之一,主要用于安装、更新和管理自定义节点。 当我们导入别人分享的工作流时,如果提示缺少某些节点,也可以通过 manager 查找对应的插件并进行安装。安装完成以后,通常需要重新启动 configui 并刷新浏览器页面,让新的节点生效。 show image feed 主要用于展示扩展提供的图片结果。面板 k monitor 和 kj nodes 的 具体功能则会根据安装的插件版本有所不同,不过刚开始学习 configui 的 时候,大家暂时不用深入研究这些扩展, 它们并不会影响我们理解最基础的工作流逻辑,等后面实际使用到相关功能时再回来了解即可。到这里, comui 的 主要界面和常用功能区域就基本介绍完成了。 其实大家现在真正需要记住的内容并不多,左上角主要负责工作流的打开、保存和管理,右上角负责工作流的运行、暂停和任务管理。左侧面板可以快速找到节点、模型、素材以及已经保存的工作流, 遇到运行问题时优先查看左下角日制,如果节点超出了当前画布范围,就使用右下角的定位和缩放工具快速找回。另外,现在 comfy 官方已经内置了越来越多经过验证的视力工作流, 这些工作流基本都是社区用户长期使用和反馈后筛选出来的。对于刚开始学习的小伙伴来说,其实不需要一开始就从零搭建复杂流程。 很多时候我们只需要打开对应的官方工作流,根据提示下载所需要的模型,完成简单配置,就可以直接运行并生成效果。 等熟悉了整个工作流的运行逻辑以后,再逐步去修改节点、调整参数,甚至搭建属于自己的工作流。所以学习 comfy 的 过程不要一开始就被大量节点和复杂界面吓到。 我们首先建立起这张 comui 界面地图,知道每个区域负责什么功能,后面的课程学习和工作流搭建都会轻松很多, 至于其他暂时没有用到的按钮,也不需要现在全部记下来。后续课程中遇到具体功能时,我们会结合实际案例再逐个展开讲解。
306秋叶AIGC 03:16查看AI文稿AI文稿
今天一条视频教会大家解决康复 u i 百分之九十九的报错,那么有些同学要问老师,老师,那请问那百分之一怎么百分之一?不要问我,因为我还没有遇到。今天这条视频,只要是你认真听,康复 u i, 你 可以不用再报任何的课,包括我的课也不用报,我这算不算自雷了? 对不起各位同行,不要干。我今天为了给大家做这个案例,用的是剪辑宝,然后这里边有很多的差价都没有,很多的一些东西都没有。我们每当拿到一条工作流的时候,就像我现在这个情况一样啊,屏幕上有很多的小红框啊,包括这种小绰号, 就说明一个什么问题呢?其实无外乎就那么一样问题,第一,你的模型的位置是吧?模型有没有下载好,模型有没有放对位置?第二呢,你的节点有没有安装好 啊?然后你的节点如果安装好的话,他会不会和别的插件产生一些环境上的冲突,无非就这点问题,对不对?但是如果让我们以前我们来解决的话,超级麻烦。在二零二四年我在玩这个东西,可能一个报错困我两天嗷嗷熬夜掉头发都解决不了,因为现在有了非常方便的工具,我们很轻松就能搞定这些报错问题, 也不用自己动手,很简单,就是打开我们的智能体,如果有魔法,如果说你,你可能可以用一下 codex 什么之类的,我们今天以假设没有的情况下,百分之九十的人都没有这些东西,对吧? codex 这个东西我们 pass 掉,我们直接用国内的 workbody, 当然我没有拿他的钱,我也没拿他的广告,他们广告商也没来找我。广告商 我劝你不要不识抬举,非常的简单,直接打开他们的智能体,这个时候你可以新建一个任务啊,因为其实我也没有深度研究这些智能体啊,我只是拿它来解决我当下的一些小问题。这里新建任务之后呢,这里直接可以写 这里,我说的是他没有自动加载的原因是什么呢?因为这些模型其实我本人是有的,在我那个主要的康复 ui 上是有的,但这个副康复 ui 他 没有加载对路径,所以我直接让自动加载路径就好了啊。如果说你们连这个模型都没有呢?你要告诉他啊,没有这个模型,让他自己帮你下载好放对位置。 因为 comui 是 个非常开源的一个东西,所以说它很多的东西不是那么的规范式,你比如说我这两条 comui, 比如说我这两条 comui, 我 这个 comui 和我的主 comui, 它俩可以用一个模型的地址。 有的时候你们玩康维尔也是一样啊,完全要用开源的思维去考虑他的一些用法啊,比如说这里啊,我把这个完全写的是大白话啊,我现在打开了我的康维尔便携版,对吧?我上传一条工作流,然后我的模型没有自动加载路径,还有一些插件没有安装,你帮我全部修复,让我可以使用这条工作流。好,你把这大白话说完之后,直接点击发送 我们这里的权限,可以给他打开一个完全访问权限,因为要不然他一直问我们很麻烦啊,直接给他打开就好,现在我们要做的就是躺在沙发上刷抖音,等待他完成。 朋友们,就这么简单。他现在已经将我的模型以及我所所有所缺失的节点 全部已经给我搞定了,我现在只需要将我们的图片上传就可以制作视频了。这里有一个需要注意的点,一定要记住你,每当你上传一条工作流的时候,先用你的键盘的快捷键 ctrl 加 s 保存一下这条工作流,他来修复的时候就会更方便。 ok 了,修复好的工作流直接产出视频了, 哈哈哈,你陪我一晚,之前的恩怨便一笔勾销,哼哼,臭道士,看你道貌岸然的,净想些龌龊之事,哼!下期就给你们做这一条开元免费的多图参考工作流使用教程,勾上你这个大骗子!
1383高尚 00:52查看AI文稿AI文稿
什么?康复优儿还在用秋叶整合包?康复优儿千万不要用秋叶整合包啊!嗯,很多人问我为什么秋叶整合包那么好,你为什么不去用?一开始我也是用过秋叶整合包的, 直到后面我发现啊,秋叶整合包真的适合是那些纯小白啊,并不适合长期商用。为什么呢?因为插件太多,版本也太多了,节点冲突很容易报错,尤其在做涂身视频的时候啊,各种依赖,直接崩。 所以呢,我干脆直接自己重新整合了一个,把一些没用的插件全删了,只保留真正高频稳定能双用的节点。 主要我已经把环境配置好,一键启动就可以,启动更快,占用更低,工作流更干净。重点是独生视频和室内工作流我已经全部配置好了,现在打开一键直接出电影级动画,根本不需要再折腾环境。加入我一起学习 com 爱吧。
488啊新设计+AI实战 03:30查看AI文稿AI文稿
本期我们讲解 comfyui 官方纯净版本地部署。首先我们要知道什么是 comfyui 以及各种版本安装包有什么不同, 我们目前可以使用各种 ai 模型来生成文字、音频、图片、视频等,但不管什么模型,都需要一个能和使用者产生交互的前端操作页面,而这就是 comfyui。 那 么 comfyui 有 各种版本, 官方纯净版、官方桌面版,各种博主整合的整合包版本,又或者是启动器版本,我们该如何选择呢? 这里我直接推荐大家选择官方纯净版。首先我们说一下官方桌面版,它始终基于稳定版本构建新功能更新会滞后一段时间,只适合新手使用。 再来说各种博主的整合包,里面会预装各种各样的资源,整合包一般都会非常大,但并不是为我们的工作学习而量身打造的。再来说启动器版本, 虽然使用简单,但是会加入启动器中间层,会加大资源占用,所以这里我们推荐大家使用官方纯净版,稳定性最高,自由度高,可以自由管理模型以及插件。下面我们讲解本地部署。 首先我们下载给大家准备好的文件,我们先来讲安装方法,我们依次安装 git、 visual studio setup 和启动器依赖。第一步,我们先点击 git, 依次点击下一步即可。 第二步,我们安装 visual studio setup, 我 们点击安装包, 到达主程序以后,并在 vio 里面安装桌面版 c 加加,这里我们只安装桌面版 c 加加即可。 第三步,我们安装启动器运行依赖依旧,点击下一步即可。 做好这些我们就已完成了所有准备工作,我们点击 comui 文件夹,此时我们发现最下方有三款启动器,我们该如何选择? 首先, run cpu, 使用 cpu 来运行,我们不推荐 run nvidia 使用英伟达独立显卡 gpu 来运行,这是最常规最推荐的启动方式。 最后一项是快速累加模式,生成速度更快,显存占用低,代价是精度低,所以这里我们选择第二项。 点击 run n video, 我 们就会进入 confuioi 网页端,此时我们就完成了 confuioi 本地部署,剩下的就交给大家自由发挥了。本期讲解就到这里,感谢您的观看。
1118佳恒AIGC✨ 07:49查看AI文稿AI文稿
事情开始不对劲了,你根本没意识到,市面上那些一个月收你几百块的 ai 生成工具,它们背后的核心技术竟然统统源自一个你完全能免费下载的开源项目 comfyui, 正是那个被大量野 公司拿去套壳的技术根源。他们干的事说白了就是添了个登录页面,加了个排队机制,再翻好几倍价钱卖给你,今天我就直接领你上手。这个技术源头,把编好的故事脚本扔进去,大模型就会自动股权细节产出。这种带人生的高质量的 ai 视频,二零六零显卡就能带, 不用排队,不限次数,无积分消耗。这些工具包教程我都有整理,感兴趣的三个六,低调研究,它就是康复 e y 官方版的默认界面,我们可以看到这边呢,准备了非常多的工作流,我们可以把它们理解为 主板,那总共大概有几十甚至上百种,基本覆盖了市面上主流的案例以及大模型,同时还有 ai 视频甚至 ai 音乐相关工作流。 ok, 那 么我们先回到默认的工作区域,这块和我们以往使用的康复语言基本没区别。如果说对于运行加载栏位置过下的话,我们可以拖动该栏目,随后来到最上边,松开鼠标, 那么他将被我们固定在左上角这个熟悉的位置。而如果小伙伴们是第一次接触康复 ui, 那 也没有关系,接下来我将带领大家一步一步去了解如何使用康复 ui 这一款当今市面上最为权威、最有深度且兼容性最强的 ai 绘画应用。首先一起来了解一下工作区都有哪些部分? 那么我们可以在左上角这里点开工作流,随后我们可以点击一下新建,那么我们可以看到这里啊变成了两个,大家可以理解为咱们刚才新建的是项目。 回到刚才的工作流,我们还可以点击浏览模板,在这里又回到了之前向大家展示的默认模板界面。如果说大家是初学者,那么我们还是从最基础的开始学起,点击图像生成就是这个紫色的小 瓶子,那么在我们第一次加载该工作流的时候,可能会出现这个报错,大家遇到了千万别慌,并且也没必要慌,他的意思是在我们运行的时候啊,缺少了以下模型,我们只需要点击这个蓝色的下载按钮即可, 或者压根不用管。为什么这么说,我们先点击拷差,随后啊来到去控制加载器,在这里我们将选择接下来会用到的大模型。刚才的报错意思就是指这一个模块缺少了模型, 如果说我们有其他模型放置在这个节点中,那么刚才的报错同样也能够解决。这边听不懂,没关系,我们慢慢来。刚才我是不是提到了个概念叫做节点,那么这一个我们可以称为节点,这一个也是这一个,这一个,这一个他们都 都是节点,而节点与节点之间可以看到是通过线进行连接,哎,有黄的线,蓝的线,粉的线,还有红的线,当然还有其他的各式各样,那么这些节点呢,就是通过刚才所谓的线连接成了一 整个,我们称为工作流。至于如何让这工作流跑起来,我们仅需点击这个蓝色的运行按钮即可, 一起来试试。现在我们可以发现出现了这个报错,而这个报错也是非常多新手小白会遇到的,他的意思其实和刚刚所见的报错完全一致,大家记清楚如何解决之后,可以举一反三,自行解决接下来可能会遇到的类似问题。那么我们可以看到,首先在工作流中有一个节点爆红了, 哎,这个节点他是不是现在被红色的框框给框起来?这个标志代表着工作流在这个位置遇到了阻碍,进行不下去了。那 我们重新看一下刚才报错的英文都代表了什么?点击运行可以看到,首先呢,这边交代了 jumper loader simple, 意思是在这个 jumper 简易加载器中出现了报错, 那这个简易加载器也就是刚才我们所说的该节点嘛?好,继续往后看, value not in this, 意思是在属性中缺少了某些值,那么这个值是什么呢?这个值啊,就是这个什么 v 一 杠五,吧啦吧啦吧啦哎,它是一个大模型的名字, 该如何解决?方法很简单,一就是像刚才我所说的,点击之前出现的蓝色按钮。第二,我们可以主动的把大模型给放置在这个文件夹内,至于大模型如何获取,小伙伴们可以评论私信,稍后我发你。又或者我们可以在 libabai 这种 ai 网站上自行下载,比如这边我刚刚把一个大模型放到这个路径后, 刷新一下该界面,这边的话我们可以选择不再显示此消息,因为它是一款默认模型,效果其实很差劲。接着关闭,然后来到去控制加载器,点击一下,哎,我们就可以看到刚才放进来的模型,这边我们就可以选择,那好,现在解决了大模型的问题,再次点击运行,来看一下此时啊,咱们的工作流能不能跑起来。 ok, 那么这张图像就是我们用康府 yi 生成的第一张图像,别看它非常的简陋,甚至是混乱,但它只是个开始,后续我们会一步一步的精进,逐渐学习更为强大,更有效率,更有深度的模型以及工作流,还有商业案例。而同时刚才我们所加载的这整套工作流,它有个名字叫做纹身图,也就是文字生成图片。好, 纹身图,纹身图,这个文字从哪来?咱们来看到这里有两个文本编码器,咱们先简略的带大家理解一下,下一期我再进一步的详细讲讲纹身图具体参数以及背后的逻辑。来 看到这边上边的文本编码器,它的条件,这根线连到了哪?是不是连到了正面条件,那么我们就称这个文本框为正面提示词文本框,也就是我们想要什么就在这边输入什么,比如说此时我们生成一个女孩, one girl, 点击运行,哎, 可以看到这种图像立马变成了一个女生的形象。那好,上边的文本编码器我们理解了,咱们来看下下边的,下边的顺着条件输出,往后看,连到了一个叫做负面条件的输入中, 那么这一个文本编码器我们就称为负向提示词文本框,我们将在这边输入负面条件,又或者被称为反面条件, 这个负面条件的意思和正面条件相反,我们不需要什么,就在这边输入什么。咱们来举个例子,比如说啊,现在我在正面提示词输入一座花园 one garden, 点击运行,可以看到图中有许多的花朵,有蓝的、粉的、紫的,哎, 我们可以再跑一次是吧?花园中怎么能少得了花朵呢?但是如果说我们就不想要花朵行不行?可以,我们在负面提示词这边输入 flower, 也就是花朵,点击运行,此时我们就可以看到,哎,最终生成了图像,有关花朵的比重好像大大减少了, 信的话可以多跑几张,明显变少了吧,这张也是。那么小伙伴们是不是已经理解了正负面提示词的具体意思?不理解没关系,我们下节课再讲。那好, 如果说啊,我们想保存咱们刚才编辑的工作流,怎么操作?回到刚才左上角的工作流,随后点击保存,给他按个名字,比如说 文声图确认。接下来我们就可以在这个文件夹样式的按钮内看到刚才或者说之前所保存的所有工作流。那么我们该如何使用它整个工作流呢?比如 说某天啊,我在网上看到一个大佬开发的,比如说模特换装、人物写真,高清修复,老照片还原,像这些工作流我们该如何直接套用?同样的很简单,我们仅需把工作流的文件拖过来,在这个工作区域内松开鼠标,哎, 那别人的工作流就会呈现在咱们的电脑上。至于这边出现的报错,意思是所有的这一系列节点呢?咱们电脑没有需要安装,那如何安装?当然就是点击这个安装所有趋势节点 操作,大家跟着我来一种方法,可以点击这个 open manager, 接着就可以来到这个界面,然后我们就可以在这个缺失选项卡内 安装本套工作流中我们不具备的节点。又或者我们可以直接哎先回到这个工作区域,然后在上方看到没有有一个 manager 按钮,点击一下,接着再点击这个按钮安装缺失节点,同样的也是可以和刚才所见的模块一样来补充咱们的节点库 呀,这一个和刚才所见的其实功能是完全一致的,只是展示的界面不同而已。 ok, 那 比如说啊,我们先回到刚才的纹身图工作流,这套工作流的保存方法咱是知道了,那他如何导出呢?如何在其他电脑上也能使用呢?来我们 这边也是点击工作流,随后点击导出,注意不是下面的导出 a p i, 是 这一个导出,点击一下再点击确认,最终我们就可以得到一个像这样的 随手文件。好的,咱们再来讲最后一点,当我们想加载节点的时候,只需要双击界面,随后再输入节点的名字即可,比如说加载图像直接点击,那么这个节点就会出现在咱 们的工作区域中。至于如何删除,我们可以直接点击这个红色的垃圾桶按钮,我们也可以点击键盘上的 delete 键两种方法。那么有的小伙伴可能会说, up 主,为什么我的界面是英文的?好认真听。我们可以在左下角的设置 这个小齿轮按钮内找到区域设置,这里有个语言选项啊,展开来里面我们可以看到有英文、中文、日本语、韩语、法语等等等等,那选择我们想要的即可。
244AIGC黄埔中校 02:25查看AI文稿AI文稿
我靠, ai 圈砸缸了! cfu 终极版的出现直接终结比赛,它能不限次数产出图片和视频,无需积分也无需排队,最关键 的是完全免费,操作简单到我想骂街!以前你们装个 cfu 配环境配到崩溃,红筐爆错爆的想砸电脑,今天 直接帮你搞定,一键解压就能用,全中文界面,不用你懂英文,一键铲除商业级大片。最夸张的是做 ai 视频直接一键搞定,没有狗屁深层次数限制,深层的内容完全无审核。为了让你少踩坑,这次整合包直接内置了三百八十八套精选的傻瓜式工作流, 直接给你开启了批量复制模式。想尝尝这个整合包啥的味道,直接吱个声。我们先安装资源包里面附带的启动器运行依赖,接着打开解压之后的 comui 文件夹,在文件夹内找到 a 会式启动器,随后点击一键启动即可。首次启动时可能会安装一些必要的环境依赖, 稍等平和后,我们便来到了 comui 的 主界面。接下来介绍第二种安装方法,官网资源包的安装。我们解压完资源包后,在文件夹内找到这个项目, 双击运行,等待片刻后,我们便可以来到最原汁原味的 comfui 界面了。这个版本的 comfui 是 没有装任何非官网的插件的。此外, comfui 完全离线工作,对 gpu 的 要求相对较低,但是也有 cpu 模式,不过在 cpu 模式下 绘图速度较为缓慢。如果小伙伴们之前有使用过 vpuui 或其他类型的 stuf fusion ai 绘图应用,那么可以通过修改 comfui 的 配置文件来实现在不同的 ai 绘图应用间共享大模型以及 loa 等等,以此减少对硬盘内存的占用。那么接下来我将向大家演示一下 如何将我们的 comui 大 模型以及 laura 的 加载路径修改成 webui 的。 如果小伙伴们没有玩过 webui, 那 么这一段可以直接跳过。好的,那么我们打开 comui, 接着我们找到这个文件 extra model path yaml 点 example, 接着我们用记事本打开。好的,那么打开之后我们找到这一项 base path, 我们要做的是把 base pad 后面的这一串改成我们 web ui 文件夹的路径。比方说我们打开了 web ui 的 文件夹后,我们可以单机上面的这个栏目,随后 ctrl c 复制。接着我们回到刚才的记事本内,将我们刚刚复制的路径粘贴到此处,随后我们保存并关闭记事本。接下来的一步很重要,我们需要将 example 以及这个点给删除, 就是将我们的文件名后缀改成点 y a m l, 随后点击确定即可。那么接下来我们打开 comui 来确认一下。好的,我们这边看一下 check point 加载器里面的大模型,点开后我们可以看到多了,非常多啊,那么这就证明我们成功把模型路径合并到了 v i n。
1959AIGC黄埔中校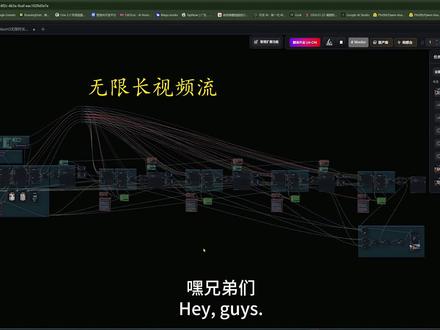 06:35查看AI文稿AI文稿
嘿,兄弟们,今天教你们一个理论上可以说是一线时长的工作流,手把手教你们搭建一下,我们先看一下个案例,这个我是拿零点四的像素做的啊,所以不要在乎他的视频的质感哦,是你吧?我昨晚没上山,可车牌是这个, 他跑不动的发动机早该换了。那你为什么还留着他?因为上一个跑他的人没回来。你说的那个人是谁?三年前山口那一战跑赢所有人的那个,然后呢?然后他冲下了护栏, 最后他这个结尾不是结的很好啊,但不用管他,我们主要看的是什么,这是一个完整的五十秒的,五十秒的视频,并且一丁点的接缝都不会看得到啊,一百万的像素呢啊,它的质感可能就会好一些。你比如说像这样昨晚那条山路上跑第一的那台车是你吧?我昨晚没上山, 可车牌是这台,现在我来手把手带大家搭建这条工作流,跟着我搭完这条工作流之后,起码以后你再拿到一些别人的无限时长工作流的时候,你就不蒙了,你就知道哪里是负责哪里的,什么是管什么的,就是一个理论性的一个东西。首先我们打开官方的工作流之后关掉,把前面那没用的东西关掉,我们先需要一套什么加速插件, 我这有一套加速的,你们自己如果有自己的一些加速方式,先弄一套加速放这是吧,咱们先把速度提一下,再搭一个加速的 l 模型啊,我先用的是 type 六百。好,他的线怎么连?从这先给他连上,给他连上。哎,给下面连上 l, 给这连上。 ok, 那 这就是他的加速部分,这边就这点事搞完了,我们要想做无限时长工作流呢,主要是需要三个节点,第一个过去 图像范围, k g 的 啊,这个是 k g 大 佬的一个节点,获取图像范围,从这里输入负一,负一是获取上一段视频的最后一帧,就是负一, 我们还需要一个什么呢? t d t d 的 叫鬼,叫什么鬼?德福 mini max h 三,这个节点的作用就是将你上一段视频的尾帧融进你下一段视频的开头。我们还需要一个什么节点?叫 t o n e toner toner mini max h 三 toner compass 啊,我音乐不好,这个就是一个饱盛它的色调的,主要就用这三个节点就能做无限时长的节点了。这三个节点怎么用?我们来先看第一个,会有同样范围,那我们会有同样范围,我们就要从这连上,连完它之后我们不着急,这俩先不要管,我们先从这边我们需要这套一个两个, 比如说,比如这里是五秒、十秒、十五秒,那这边我们也是一样,再来一套,比如这边是五秒,我们这边再想来个五秒,再来个五秒,就做一个十五秒的,这边复制出来,来,把这个节点拉过来,将这条线直接和这个节点连上,连完之后,接下来就是 接下来就是连线游戏了,连接点,连接点放在上面,要不然省省的搞乱了丽吧。连接点, v e 的 连接点,音频 v e 连接点,日常的连,高的连接点,长时长有个表达式,把它打开。连接点, ok, 图片的连接点,这图片还要多做一个,因为经常都是两个人物,还有场景管理,这个也连接点, 这个也连接点,先把这个图片连上, ok, 好, 这些我们先右键,让他们靠左对齐,我们先连上面这些, 这些线全部连好。首先默认连,这个默认正向连,这个正向 v e 连好, v e 连好,下面的 v e 也要连好。 leap, 连上面这个模型连下面的模型就是一带绕,绕的连上面的基础引导,不带绕的加速的直接在基础掉到气质,那这些线就算连完了,这个正面要连到这个正面上,这边是检查一下上面的线,这边还有这俩 v e, 千万别忘,这俩 v e 最容易忘。好,那我们再连下面这皮一样,先把模型连对 v e v e 好, 下面这些我们都连完了。开始下边的,首先扩长,图一隐秘指零,图二隐秘指一,图三隐秘指二, ok, 连下一波,我要连下一波,连完之后我们过去图像复制, ctrl 加 v 粘贴,要从这里出来一份, 把它连上,这次我们要用到这个色调的,这个就是这里要连这色调,这个我们要第一波,要在这里,为了让你上一个视频,下一个视频的颜色要注意隔离,这个也需要把这一份放在这,这边线差点忘,先把它该连的线连好,有点过绕了,有点绕,调完颜色再放这调完颜色的也是放在放剪视频的,这,这样就对了,复制粘贴一下, ok, 我把这边的这个连接器还要再过来一下,再连一下,连他的正面 v 一 连他的 v 一, 他这个正面连到下边这个基础引导。 ok, 连好了, 我们接下来要做什么了?我们接下来需要两个节点,将我们要生成的三段视频拼成一段视频,一个叫图像组合,一个叫图像组合,批次多重,一个叫音频拼接,一个叫音频接,这个需要两个音频接的节点, 我们这里有三段视频,对不对?我们这里加一下,变成三段,更新输入可以变成三段音频。这里一会我们现在开始在连线第一段生成的视频,在这里把它连过来,可以再放连接线,不好连的地方放连线一个, 这边两个,这边三个,再说音频一样放连接线音频的第一段的音频是吧?第二段的音频,第二段再也来一个保存视频,已复制 视频,音频视频进入保存视频。好了,基本上这条工作流就发完了,如果你想继续往下连接,还是按这个方式一下无限的串联就好了,就按照这个方式无限的串联就好。接下来我们再用昨天教你们那种制作的那种人物卡,我们这是成套的连续剧的这种人物资产卡,比如说我做了一个啊 啊,这个你再加上给我答谢,上传一个场景,用智能体来写这种连续性的提示词,比如我刚才录了一段,但是我刚才忘记点了,录制那边出了点问题没录上,所以说我就不再去教一下大家怎么写提示提示词,就是告诉他什么我这是做了一条 有首尾针连续性的这种提示词,多餐的让他按照这种格式来写,还是给大家看一下,我就用这段话,这个里边我已经部署了我的官方提示词 skill, 现在我用这段话,现在我要做五段连续的剧情,连上一段的尾针都能连续接,能接上下一段,所以你就按照这种能连续的画面的剧情写,每一段都要求五秒是吧? 我后面又修修改改的,反正最后反正我觉着出来效果还不错,接下来我就让他们按照这个给我写的。 ok, 复制一段,先选粘贴。第二段。啊,对了,这个叉子把这个忘了,提示词一个两个,还是把提示词框给忘了,撸串往这一连。 ok, 我再把那两段去选粘贴,这基本上就算是弄完了,现在我们图片题词都有了,可以跑一下试一下。我们先跑一下试一下。对,你看这里忘了步数应该改八步。忘了这边写成二十步了,关一下重重跑八步就够了,再跑。 ok 啊,六百多秒已经生成了。生成了,我们看一下,我们看一下。他现在应该是十五秒,对吧?这是这写十五秒啊, 我们看下有没有接缝啊。五秒。那场车祸你也在车上?你查了三年就查出这个,这是从车里捡出来的,上面刻着你的名字,是我把他报出来的, 晚了一步,那天坐在副驾的人本来是我,所以我才替你上了那辆车,你要恨我就恨到底,别停这次啊,他有那个切了一刀之类的啊,我们可以看看我之前的啊,因为我不想再搞贴瓷了,反正就是这种,绝对可以做到无限时长啊,非常方便啊。看这吧, 你看啊,这里啊,虽然有接缝看,但是一点也看不出来吧。好,这里也没有啊,哎,也没有,到时候自己懒得搭,在评论区直接打工作流,到时候我会发出来给你们玩一下。 ok, 下课。
1496高尚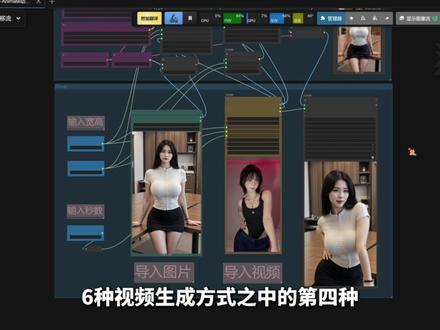 07:49查看AI文稿AI文稿
ai 创作圈的性价比天花板,康菲 u i 九点五新版本重磅上线,这次更新聚焦高清创作需求,将视频与图像生成质量推向新高度, 更坚持永久免费开源的核心优势,让普通创作者无需花费一分钱就能轻松产出媲美专业团队的高清作品,彻底打破优质创作必付费的固有认知。生成的图像细节丰富立体色彩还原精准, 动态视频流畅丝滑,无锯齿模糊。无论是商业级海报设计、短视频创作,还是创意特效制作,都能呈现出影院级的高清质感,完全不输付费工具的输出效果。那么该如何使用呢?首先将我们的 v 九点五整合包下载到电脑上, 下载好之后,用鼠标右键点击这个压缩包,在弹出的菜单里选择解压软件进行解压。这里有一个非常重要的点,请一定要将文件解压到一个没有中文的目录下,也就是你的硬盘路径里不能出现中文字母,以免后续运行出现报错, 静静等待解压完成就好。解压完成后,咱们就可以准备打开了,在解压出的主目录里找到并双击那个粉色头像的会式启动器图标, 双击打开后,电脑会首先为你弹出一个图形化的秋叶启动器控制台。在这个界面里,我强烈建议大家先点开左侧的高级设置看一眼,确保系统已经准确识别,并且选中英伟达独立显卡。 确认无误后,点击右下角的一键启动按钮,点击之后,后台会弹出一个黑色的代码窗口,开始狂飙数据。 这期间,系统正在为你自动唤醒底层环境,并加载内置的五十多个精选插件。大家只需要耐心等待几秒到几十秒,他就会自动唤醒你的电脑默认浏览器,直接把你带入康复 ui 节点操作区。 当浏览器成功弹出带有网格和各种连线的深色界面时,恭喜大家,你已经正式推开了 ai 创作的大门。咱们这个 v 九点五整合包最大的魅力就在于把复杂留给底层,把简单教给你, 你完全不需要从零开始去学习怎么连线,直接在界面里点击加载预设好的最基础纹身图。工作流,咱们来简单跑个测试看看效果。 你只需要找到一个在上方的文本框,输入你想描绘的画面,比如简单敲上一句一个女孩毛衣白色背景,然后在下方文本框里填上如模糊、低质量、畸形之类的排雷词汇。 接着点击界面上的运行按钮,这时候你会看到屏幕上的节点开始依次亮起绿色的光效。得益于咱们非九点五底层强大的环境优化,仅仅几秒钟的功夫,一张光影细腻、质感拉满的美女照片就会在最终的图像节点里生成出来, 整个过程丝滑流畅,完全不需要你懂任何深奥的代码原理。当然,这种基础的纹身图仅仅是个热身, 咱们这个 v 九点五整合包真正的核心资产是里面为大家精心预制的两百多个大师级精品工作流。这 些工作流的特点可以用四个字来概括,那就是开箱即用。以前大家在网上找工作流,最怕的就是导入进去后满屏飘红,告诉你缺这个节点,少那个插件,折腾半天都跑不通。而在咱们的整合包里,几十个核心插件早就为你配置的明明白白。 不管你是想做高清的图声图,局部重绘,还是想玩点高级的 ai 换脸,数字人对口型,甚至是去挑战目前最前沿的视频生成模型,这里面都有现成的模板供你直接调用,那么你赶紧去自己动手试试吧。 欢迎来到我们的 comfy 视频生成系列课程。哈喽,大家好,那么这一节课呢,我们来学习我们六种视频生成方式之中的第四种,也就是动作迁移工作流。那么我们只需要上传一张图片, 然后再上传一个视频就可以了。那么首先我们来看一下我们刚才导入, ok, 然后再来看一下我们生成的结果, 整体的一个动作,包括人物的一致性都保持的还是很不错的, 同时呢,他会将我们原来的视频当中的音频自动与我们的视频进行一个结合,然后直接一键生成。那么像这一种我们图片可以模仿视频当中的人物动作,然后进行一个视频输出的工作流,是如何实现的呢? 我们来看一下怎么使用。那么首先呢,我们依旧要明白,第一步就是确认我们的模型使用, 这对于我们生成任何视频或者图片都直观的重要。像这里面我们依旧选择 g g u f 的 模型, 以及添加一个对应的加速 laura。 由于这里面我们使用的是一个动作迁移,所以我们还需要加一个 animate 的 加速流来进一步对这个工作流进行一个加速,我们加载好我们的这些模型之后呢 就可以直接输入到我们的彩样器当中,这个时候就要注意到我们彩样器还依旧缺少了正负相条件,那么正负相条件其实指的就是我们视频当中的人物运动部分, 这个时候我们需要加载我们的一个视频进来,那么这个视频呢会拆分成很多张的图像, 然后传入到我们的姿态与处理器这里面,然后通过这个处理器呢分别对我们的一个姿势以及面部来进行一个识别,最后将生成的这些图像呢输入到我们的动画短视频当中, 我们需要提供面部视频和姿态视频,那么这些都是通过我们的育处理器来得到的结果,同时这里面我们还需要输入我们的一个参考图像,也就是最后我们视频生成中的主体人物图像, 通过我们的视觉编码器呢进行一个编码,然后一同输入到我们的一个转视频节点当中, 然后这样子就提供了他的一个副像条件。同时由于我们的参考图像可能尺寸比较大, 所以这里面呢我们直接对整体的一个图像呢设置一下深层的视频宽高,那么像这里面这张图像呢是一个竖向的比例,所以我们最后设成一个宽四八零,然后长度为八三二的一个图像尺寸, 然后在这个地方我们进行一个设置,最后呢我们的彩样器上面的条件我们就都连接好, 然后再直接输入到我们的解码器当中,进行一个生成即可,最后呢就能得到这样的结果,这里面我们想要这个视频呢,更流畅一点,也可以添加一个补帧节点,又或者想让视频变得更清楚一点,可以添加一个高清放大节点。 那么这两个节点呢,在我上一节课讲设为真生成的时候都已经提过了,那么整体的工作流所使用到的文件我都已经为大家准备好, 比如说我们的插件,包括我们的 g g f, 我 们的视频转模型,包括我们的视频 c t r l, 再比如说我们的所需要的模型以及工作流。那么大家在拿到这样的文件链接之后呢, 就放到对应的文件夹目录即可,那么这个视频就到这里了,感谢大家的观看,如果对你有帮助的话,不妨点赞加关注,支持一下,我们下个视频再见。
1501AI教程-Comfyui 07:25查看AI文稿AI文稿
如果你的电脑能跑康福 u i, 只要你能跑一秒的视频,那么你就能跑一千秒的视频,甚至能跑一万秒的视频,康福 u i 真正做到了无限时长,最重要的还做到了无限制生成整盒包,三步就搞定,一拿二解三,打开 粉丝宝子吱个声,让我看到你输入一张图片和提示词,就能在本地运行这样丝滑流畅的视频了。 啊啊啊啊啊啊啊 hello 小 伙伴们大家好啊,今天给大家带来一份 mini max h 三的一个长视频生存的工作流,我们 mini max h 三呢,它是有一个啊生存时间上限的,一般来说十五秒就封顶了啊, 这场的话是生成出来的那个质量是不好的,而且容易崩溃,那么这份工作流呢,就帮助大家突破这个时间的上限啊,你可以去生成三十秒,四十秒啊,这是更长的一个视频,这份工作流呢,是基于之前的一个双时钟彩样的工作流去进行更改的啊, 那我们看看多了哪些内容啊?首先呢,我把这个加速节点啊,原本是用的这个加速节点,现在给他替换成了这个这两个加速节点。然后呢,我也为低选存的用户呢,加了两个节点啊,这是给低选存用户专门啊加的。 那么经过我的测试呢啊,我在跑啊,零点七的像素啊,零点七就是七十万像素的时候,跑十秒是跑不动的啊,那我在开启这个节点之后啊,我这里是相当于分块处理, 分两块处理啊,是可以跑到一个八十万像素十秒钟的啊,所以说这个节点是有用的,那么对于低显存的用户来说,这份工作流也是可以跑的啊,八 g、 十二 g 的 用户都可以来试一试啊,那么这两个节点怎么去用呢啊?简单来说就是分块处理嘛, 这里的话大家可以填二填四或者填八啊,都可以,你分的快速越多呢,对于显存的这个啊,要求就越低,当然你分的快速多了的话,那么他分快处理的时间就多 啊,就相当于是用你的显存去换时间了啊,那我自己的话就分两块就可以了啊,相对来说可以跑快一点。那么接下来就是这个节点啊,这个节点的话可以清理掉你的 clip, clip 模型的一个占用问题。好吧,然后就是我们的这个最核心的一个长视频生成的一个模块了, motion context。 这个 motion context 它的工作逻辑是这样子的啊, 假如我们先生成了一段视频,简单来说就是 motion context 啊,它会把上一段视频截为大约一秒左右的模型内部状态,直接带到下一段视频的开头啊,差不多就这样子啊, 那么这个红框的话,就相当于是第二个视频啊,我们的下一段视频生成啊,不是重新生成的,他是接着上一段继续往下演的,也就是说他继承的不是最后一帧画面,而是包括这一小段里面的一个运动方向,镜头速度、 人物动作环境、声音和节奏等等的一系列的数据啊,会被第二阶段的视频进行一个继承,那么这就是一个 motion context 的 一个工作原理啊。好,那我们来看一下这个啊,工作流他怎么去使用啊? 那我们这里的话,这个视频是一个啊,图片参考生成的一个案例,那么我们接下来我们就用这个 f l 开头的模型就可以了,好吧, 嗯,其他的就不需要动,那我们现在是相当于生成第一段视频啊,生成第一段视频的情况呢,我们要在这个 save late 这里啊,给它换成一啊,方便自己去记忆。那我们现在是在生成第一段视频啊,那第一段视频的话是不需要进行一个视频延长的啊,那我们就先给他断掉 啊,好,这样子话就相当于给他关掉了,然后我们再去填写一个提示词,复制粘贴进来, 那么这段提示词的大致内容就是我想去生成一个兰博基尼在一个高速奔跑的一个状态啊,好,我们这个参数改完之后啊,我们就点击运行就可以了, 那么这个节点呢,可以看到我们采样过程的一个大致样貌啊,在这里呢,你可以判断出来我们的视频啊, 他的一个大致情况有没有崩坏啊,如果他没有崩坏的话,就可以让他继续生成,如果崩坏了啊,那我们就直接取消,我们去进行一个参数调整就可以了。好,到这里让我们的第一段视频也是生成出来了啊,然后我们要在第一段视频的 一个音频数据基础之上去生成第二段视频啊,那么这里呢,我们就要打开这个 motion contacts 模块,然后我们要将刚刚生成的第一段视频啊给他上传进来。 然后呢我们的这个啊, motion contact save later 这个节点是要改的,这个节点的作用是什么呢?我们可以看到是 save later, 就 相当于是储存一个前空句数据的一个意思嘛, 对不对?那我们第一次进行生成的时候,它将我们这个啊编号为一的一个啊前空句数据给它保存了, 那我们在进行视频延长的时候,我们首先就要对他前面保存的一个前空先数据进行加载嘛,所以说我们这里填的是一。好,那我们接下来的话是要进行第二次的一个视频生成,那么这里的话也要对应改成一个二, ok, 好, 我们再进行一个提示词的输入就可以了。 好,我们再点击一下运行。那么另外一边的话啊,是这个啊首尾针的一个长视频生成的流程啊,那么首尾针的话我是单独拿出来的,我们可以来看一下这个首尾针它是怎么使用的,那么首尾针的使用方法呢,也是很简单啊, 那如果你只是想要首帧升图的话,那么你只需要啊,把一个把尾帧啊这边给他关掉啊, ctrl 加 b 关掉就可以进行一个首帧的升图,那么首尾帧的话就是两边都打开就可以了。 那么这里的话还有个非常快捷的一个分辨率啊,还有尺寸的使用节点,大家想要什么尺寸的就在这里选择就可以了啊,然后这里的话可以输入他的一个尺寸表, 那么这底下呢就是一个视频你想要生成的秒数,然后这里的话就输入提示词就可以了,那么提示词的话啊,我给大家准备有这个官方的一个 skill 啊,那么大家只需要随便找一个啊,智能体 豆包啊, dsp 都可以啊,将啊我提供给大家的这个啊官方的一个 skill 文档提交给智能体,然后你再把自己的剧情啊告诉给这个智能体,那智能体呢,就会按照这个官方的一个啊 skill 来给你生成提示词了啊,然后我们再点击复制 返回到我们的工作流里面,给它粘贴进来就可以了,然后就点击运行。好,那我们这边也是生成出来了,我们可以看一下效, 可以看到这两段视频它的衔接是非常完美的。好吧,包括它的音频,它的画面也没有发生任何结构上面的变化啊。
227AI小叶 10:35查看AI文稿AI文稿
哈喽,大家好,我是子悟,今天我们一起来学习康复 ui, 我 们双击启动,一般启动后我习惯先看插件,也就是插件作者有没有更新,然后依赖分析一下,看有没有冲突, 然后环境依赖我们冲突检测一下,没有检测到任何冲突,内核版本是最新版,没啥问题,我们就启动 好,启动成功,可以看到是一个空白的。目前我们今天学习第一个这个搭建 zm 机纹身图工作流,也是最基础的一个工作流。我们先双击画布,然后 unet 加载器,选择这个 unet 加载器,它是 绘图的核心引擎,它决定怎么画,我这里是准备好的笔记。好,接下来我们选择模型,选择这个 zm 机模型, 我们复制粘贴,因为我们纹身图这个 z omega, 它是属于高低造彩样,所以说需要两个,这个是高噪,这个是低噪,高噪这个模型也也可以叫做底膜的模型,上面这个是基于底膜微调的肥厚大佬微调的这个 omega 微二二零模型, 它们的作用是什么?这个作用就相当于让 ai 把这张图画一个大概。第二张图是在会绘画大概的基础上面,然后进行高精度的绘画,也就是填补细节,然后互相配合,然后最后会画出一张比较好的这张画面。 好,介绍完了这两个,我们来看一下第三个 clip, 这 clip 相当于翻译官 ai, 他 需要知道我们让他们画什么,也比如说你想让 ai 画一条狗, ai 得能听懂,然后才能去画,对不对?这个相当于翻译官,他能够把我们输入的想让他画什么,变成 ai 能懂的向量, 我们选择千问三,这个千问三四 b, 这个模型相对中文提示词也比较友好类型,我们选择这个, 为什么?因为是配套的,可以看一下我的笔记。 click 好, 就这个有,那个加气器上面也有。好,接下来我们介绍第四个。呃, ve, 这个 ve 就 相当于让 ai 把已经画好的结果,然后变成我们能看懂的图片,相当于他也是一个翻译官,只是一个是人类翻译官,一个是 ai 翻译官, 人类翻译官就相当于我们把我们想让他画什么,然后变成 ai 能懂的, ai 就 能听懂了,然后这个是 ai 已经处理好之后,再通过这个 ve, 然后变成我们能看到的图像啊,作用就是这么几个,高噪低噪翻译官。机器翻译官,它是相当于把 绘画后的前空间里面的 latens, 然后变成图片,原理是这样的。然后接下来我们开始 连接节点,比如说这个模型,我们可以直接连 k 彩样器,但是官方推荐可以用那个彩样犯法,这样效果更好,官方推荐是五。然后我们再连接彩样器, 我之前具体试过有彩样算法,效果会好一点,它相当于一个锦上添花,能让原来画的比较好的,然后有这个彩样算法之后,它能够画的更好一点,没有的话它也能出来,效果也还行,只是稍微 歪了一点点。嗯,具体细微差别后面可以详详细讲一下。我们加上这个彩样算法,这个彩样算法就相当于让 ai 绘画的步骤。嗯, 可以这么理解他,他相当于画师,这个画大概这个画仔细,这个是我们告诉他怎么画,这个是画好之后给我们看,然后这个就相当于让画师知道会画的步骤,然后开彩样器,就相当于干活的一个地开彩样器,我一般更喜欢高级彩样器, 可以看到它里面,它这里面有很多条件,有正面条件、负面条件,它这个就跟我们连接的是一样的,可以看到我们通过输入,比如说一条狗, 然后连起来,相当于作为参数输入进去,让这让这个模型就接收到我们输入的参数,他就知道了。因为之前说过这个 app 是 一个翻译官,所以说它分为正负面提示词, 好连接上我们的工作空间。这个 linux 图像就相当于什么?相当于一个绘画,你想让 ai 画一张图,你是不是首先得给他一张图啊?给他一张空白的图, 对吧?所以说我们给他一张图,然后这张图我们自己可以决定他的宽高,我们宽比如说一零八零, 高是一九二零,就相当于一 k 的 竖屏图吧,批量大小是一,可以换成二三四,这样的话他一次他可以生成多张图片。好,我们具体的这个原理大家都讲的比较清楚了,这个是高噪, 到这一步的时候, ai 它只能够化成一个半成品,所以说我们需要 d 造,通过 latens 传直贴传感器, d 造这个模型要连接我们之前的模型,然后正面条件连一下,负面条件连一下 latens, 因为前面有,所以说就不需要了, 然后接着进行下一步,下一步就是 ve 解码,因为这个时候已经处理好了,但是它处理好之后我们并不能看到,所以说它需要解码, 然后变成我们能看懂的图像,然后预览一下图像。好,这个时候我们基础工作流搭建完毕,我们可以 继续看一下核心参数。添加噪波需要添加,需要返回, 为什么?因为这是高噪,低噪不需要具体的。为什么不需要?我下面也有,我可以给大家看一下我之前写的全部的笔记,纹身图的笔记也有高噪传感器。好,我们接下来生成控制是先固定一下种子吧,我们我们的这个随机种就给他 先填一个固定的,这样的话能看到后续对比效果。步数十二 c f g 值,我们选三,这个低噪选一。 为什么是三?三的话 ai 的 自由度更高,就绘画的自由度一的话是更更准确。部署是他采用部署,然后开始部署和结束部署,我们选三,这个是配套的,是官方推荐的值, 然后接下来我们看彩样器,彩样器我们选选一个这个,这个是最快的,第二个是选择这个彩样器和调度器,他们之间也是有区别的,这这些每一个都有,大家可以感兴趣的可以每一个都了解一下。 好,我们先看一下。好,可以看到这个高照彩样器,它是一个画面模糊的哦,因为我们的这个 ve 它需要,它需要也是配套的,所以说再重新运哦,彩样算法,这个就是我们生成狗了, 可以看到我如果再运行一次,结果不变,因为我们的随机种是固定的,如果我们前面添加一个一,这个时候再运行,它的结果就会变动, 它会变成一条其他的狗。然后这里我准备好了提示词,提示词很大程度上能决定生图的质量,还有负面提示词,它分为正面提示词和负面提示词,正面提示词就是你想让它生成的,负面提示词就是你不想让它在途中生成的一些东西,这是一条狗。 我们 ctrl 加 s, 保存一下文生图工作流,接下来我们看一下区别, 也就是我点击生成这个写的比较好的提示词,然后生图出来的质量。随机种我们已经演示过了,随机种如果一样,提示词如果也是一样的话,那生图的也是一样的。所谓的抽卡就是 你提示词稍微修改一下,或者你的随机种修改一下,当你生成的图片不满意的情况下,可以修改这两个,然后进行好,我们打开图像,这就是生图的效果。我们可以看一下和参照算法开始加 b, 然后给它注视掉,然后再再生成一下,看一下它的区别。 ctrl 加 b 是 忽略,也就是直接绕过,没有这个采用算法和有这个采用算法生成图像的区别好,可以看到它们之间还是有细微区别的, 我们可以仔细看一下这个高调彩样是一个,可以看到明显是一个半成品, 这两个一样,这就是彩样算法不同,我更倾向于打开彩样算法,彩样算法是一个锦上添花,因为,呃,如果有时候你可能会发现,比如说他这个法杖歪了,然后或者多一根法杖, 然后彩样算法你如果要是给他忽略的情况下,他可能就会有一点瑕疵啊,他打开之后会有更多理性,一般来说这就是一个完整的纹身图工作流,然后如果发现这个不行的话,我们可以通过 修改随机种,然后来多次抽卡。如如果要是发现我们的随机种抽了很多次都不行,那么这个时候就需要修改我们的提示词,然后哪里不对,然后就可以修改哪里,实在不行还可以加负面提示词,这样就能生成我们满意的图片了。然后最后我们说一下批量大小,也就是一次处理,批量处理四次 啊,这个是第二个提示词,可以给大家看一下效果,这个就是新提示词出来的,我们放大一下这个批量大小,就相当于让 ai 有 四个四张图,让他画四次, 但是相应的显卡也会占用更多压力,如果显卡不足,然后让他生成的比较多,那么还会降低质量,这个生图的质量, 所以说一般来说我会选择批量大小是一 好,我们快生成完了,可以看一下生成四张图这个质量,因为我换了一个提示词,看到效果还是不错的, 这张图大家知道就好,模型是破线的。好,这就是纹身图。
767子悟Aigc陪学


