runninghub任务管理在哪里
我宣布,全网低价的 cds 二点零被我薅到了!众所周知啊,天下苦 cds 二点零九蚁,它强是真的强,动作连贯,质感逼真,玩转各种大片运镜,已经是 a i g c 行业的标配生产力了。但贵它也是真的贵啊,一秒一块钱的起步价,抽卡抽的肉疼不说, 关键是还要排队还卡真人!而今天,我要给你们爆一个大料性价比夯到底的 cds 二点零已经被 running hub 拿下了,他们最近刚上线的一个限时会员七二零 p, 每秒只要三毛钱! cds 二点零的谱真的有解了吗? 咱们现在啊,直接开测来 running hub 跑一段十秒的七二零 p 素材,你看啊,这十秒的素材只花了三块,要是一整不短就坐下来, 至少能省大几千上万块。再看看这效果,不是什么降智版或阉割版,是实打实的满血 cds 二点零,不增加抽卡次数,还支持真人不排队,正常抽卡也不肉疼, 该怎么用就怎么用。更绝的是这个超低价,它是全平台通用的,不管你是用 r h t v 搞无线画布,还是用 r h story 做专业 ai 影视流水线,哪怕是玩康体 u i 工作流,或者是用快捷创作,只要你在 running hub 里 所有产品线全都接入了 cds 二点零,全都能享受这个白菜价。无论是小白找灵感爆款、工作流一键附用,还是专业创作者需求到成片一站式闭环,这波大促就是来给大家发福利的。但是注意了,这个价格啊,是限时捡漏 活动,只到六月三十号,现在不存,过了这个村可就没这个店了。零点三元一秒的满血 cds 二点零,这波羊毛必须薅秃它。链接我放在评论区了,赶快去抢吧。
粉丝110.8万获赞1006.4万
相关视频
 00:54159神经智研
 00:50查看AI文稿AI文稿
包括这个系统这两天也在研究,叫 dreaming hub, 就 这个它现在也出来了一个无线画布的模式,有点像 libtv, 但是它有 agent 的 模式,这个右边的 agent 模式也有,所以它也会让我们的设计下线提高很多,它会变得很聪明,所以,而且它的这款软件有一个好处是 它真的很便宜。就我昨天了解了一下它,它就仅生图这块,利用相同的模型,用它生张图是 laut 的 五分之一, laut 一 张图用 image 来生成的话五十积分,我这个还是最高级的会员,一个月两万七,然后五十积分,这样一算,结合到一张图要一块两毛八, 但是无限画布这里边如果你要生张图,他只需要两毛钱,而且这个是明码标价的,你在里边充十块钱,充一百块钱可以玩好久,一千块钱一个月可以做很多东西了。
766大萌AI进化论 03:02查看AI文稿AI文稿
今天给大家分享一个可以免费本地部署商业化的 ai 平台,能够让你通过简单的拖拉拽,快速搭建一个属于你自己的 running ha 平台,期间还会分享一些 ai 商业化落地的思考干货,相信看完一定让你对 ai 应用商业化有一个更加深刻的综合感受。首先我们需要有一个自己的工作流, 如果你不会搭工作流,最简单的方法就是在 runnyhop 或者离谱平台找到自己想要的工作流效果。例如这个频谱变三 d 展示的电商工作流,在电商运营中可能会经常用到,我们就把这个功能搭建在平台上,打开平台的后台管理,在应用管理中找到新增应用, 使用教程中也会分享通过 n、 八 n 等多种形式的功能搭建路径。接下来我们需要上传这个三 d 工作流的 app 文件,上传之后可以看到平台自动会提取这个地方,要注意是书英文名称,设置一下这个工作流需要运行的最长时间, 防止任务没有完成时后台停止访问保存节点,刚才平台已经自动设置了。继续点击到下一页的应用信息配置界面, 这页信息比较丰富,能够适用我们各种商业化的一些需求,我为了展示就只进行简单的设置,后续有想要商业化的小伙伴可以评论留言,我会免费分享一些商业化成功的应用案例。这一页的设置同样还是名称,开始这个地方是中文,然后上传一下这个功能的封面, 我们就还用 runninghub 平台的这个功能封面,当然后期咱们自己可以设计,然后上传,接下来再选择一下服务器,就是说这个工作流你是需要它在哪里的 gpu 上跑,我这里之前已经设置过了,直接选择就可以了,当前无论是仙宫云还是其他的 gpu 平台都是可以无缝衔接的。 这里是这个功能的算力值消耗,就是说你想要用户点一下这个功能收费是多少,我们先设置为幺九九,然后是这个地方的组织商业化的一大特点就是对群体的区分, 就是对群体的区分,从而满足不同的需求。我们可以通过组织去设定这个功能可以给谁用,不让谁用,支持企业年会员这些这里我们选择只给设计部使用,应用标签方面管理,我同样写设计部,其他的暂时可以不去设置。 最后是功能的搭建界面, ai 上新功能,你就得变群的去更新你的代码,这时候需要去站在一个更高的维度进行综合性的思考。所以我觉得这个平台的亮点之一就是组建化的参数设置,我们可以看到左侧的菜单栏多种组建, 去满足我们的参数配置需求。这个随后大家可以自己下载安装后进行查看。我们先简单的配置完这个功能, 最后点击保存回到应用管理,点开这个地方的小眼睛,前端用户就能看到这个功能, 现在回到首页刷新,然后就能看到我们刚才上架的功能,测试一下功能好了,现在结果出来了,整个上架只用了两三分钟的时间,我们可以通过这个平台快速搭建自己的商业化平台,视频平台等,企业内部也可以搭建自己的 ai 应用生产中控平台,方便大家的快速商业化以及企业 ai 赋能。
68企业AI应用落地 03:12查看AI文稿AI文稿
这节课讲一下这个在 running app 上怎么去做图像批量处理啊?嗯,它有一个默认的工作流, 它有一个默认的啊,在这里啊 啊,它有一个默认的工作流啊,啊,然后,呃这里上传图片啊,上传图片之后,然后它就会批量处理图片了啊,就会批量处理图片,然后我在这里,呃,用那个 啊,这个批量去水印的这个工作流给大家展示一下怎么操作啊?嗯,我们先把图片上传上去啊,然后这些图片的话可以把它打包一下啊,打包成 gip 格式, 打包好之后把它上传上来, 嗯,看一下这里水印在中间,这里 啊,看到这个 success, 哈,这就是上传成功的意思,然后点运行就可以了。 然后这里是呃一些设置哈,因为,呃为了不不大显着啊,我们这里呃这个图片都是呃一百啊,包括你自己的图片也尽量不要超过一百赞啊,那它就会啊 啊一张张的读取图片去处理哈,这个是 f 循环, f 循环是每次读取一张图片去处理啊,处理完之后,然后它会保存成一个,呃,这是一个 g i p 格式吧,然后就是图片打包在一起的, 那我们看一下它怎么接吧哈。呃,图片从这里出来哈,从这里出来,从这里出来之后,我们接到这个位置去哈,接这个图像编码这里哈, 它就会处理图片,然后我们做完之后啊怎么处理啊?就是啊,这个图像解码哈,图像解码之后出来,呃,接到这个啊, back to anything 这里去哈,也就是这个值一这个位置,你接值一也可以哈,接值一也可以, 可以看一下啊,已经处理完了,处理完之后啊,我们在这里看到这些图片,看一下是没有水印的啊,然后我这里有个压缩包,就是方便啊, 方便大家啊,不会一张张的去下载啊,我们看一下 解一下哈。解压好之后我们看一下,在这里啊,这里就是我们出料的图片哈,可以看一下它是没有水印的哈。 啊,然后这里。
62Li鱼 05:01查看AI文稿AI文稿
今天给大家录制一个故事版详细完整的教程。 首先插件上我更新了三个 草图故事版呢,你们在这个圆圈按一下就会刷新到你们本地上面三个,之前课程就有不展开了,这次详细说说草图故事版的使用方法效果可以点开缩略图看,为了照顾新手,我会讲的细一点呢。 现在插件上就有那个 emoji 可以 直接出故事版的。以这个火柴人故事版为例, 直接选择插入,然后看看它格式,你们只需要修改任务,这里任务描述换成你们自己的故事。宫格,这里根据故事的复杂程度可以是六九或十二宫格都可以的。下面补充这里写对宫格数量或者把 补充删了都是可以的。然后选 html 十六比九就可以直接出图了, 出来的效果跟案例是一致的。第二个故事版也是改任务和改补充的那个镜头数,同样可以把补充删除掉啊。 第三个同理也是修改任务和镜头数也出一个吧, 好,出好故事版以后其实也就是去徒生视频了,最近我都在那个 i t v 上面做视频,现在我感觉反而抽卡率最低的就是 r h t v 了。 具体出视频,先把故事图复制,再画布 ctrl v 粘贴过来就可以了。然后拉出一条线,选择视频, 用一个三次图的人物锁定,然后也拉到视频节点,再用插件上这个提示词来填充,然后在上面补一下简单剧情就可以了,其实不补也是可以的,最终提示词就是这样子的。好,这三个视频都完全没抽卡的,看看效果, 先看第一个, 这种简单的都是毫无悬念没问题的,如果都有问题,基本上就不是满血版的 dc 了。看到第二个提示时,非常简单啊,用的就只有这个了,然后固定了一下风格,出的效果还可以, 然后我首见是是去了风格抽了一次卡,其实效果是更好的,但色彩不太对,所以还是锁定一下风格比较好。 第三个视频也同样只是增加了风格锁定,所有情节都来自于故事版,连人物都没有,锁定,出来的效果也非常不错。 好,最后总结一下,总 总结就是用故事版做十五秒效果都不错的,用来起号是足够的,如果是要做连续多个十五秒拼接的,就比较适合用上面三个那个故事版了。如果是十五秒单镜头的, 直接用草图故事版效果锁定会非常的不错。重复一下使用的方法,第一,直接改故事版的模板上面的任务和设定宫格数量,然后在 html 那 里出图。第二,出图后直接用故事版 加上故事版视频提示时,然后如果需要再增加图片,锁定一下人物和场景,加上风格词, 出的视频还原度一般都不错的。如果你们还有不懂的就单独找我吧,我尽力了。提示时插件上自己用也可以拿走,都免费。好,谢谢。
370飞驰影漫社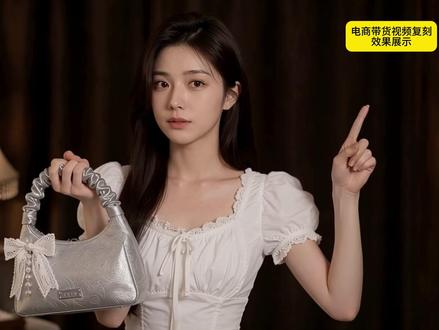 06:27查看AI文稿AI文稿
姐妹们今天挖到宝了,快进来看这个包,这光泽,这质感,绝了!背上它,你就是那个清冷又心动的存在,这谁顶得住啊,我真的建议我的好闺蜜人手一个。首先第一步,我们需要对爆款视频进行反推,打开我们的爆款视频,反推工作流, 点击我们的视频上传节点,点击这个按钮,加载我们需要反推的视频。然后点击工作流右上角的运行按钮, 我们就会得到我们的反对提示词,将这个提示词保存下来。第二步,我们需要对模特和产品进行反推,打开喜图工作流,通过图片上传节点上传从视频里截取的模特图片,我们可以在底边加上一些文字说明,比如说我要求去掉文字,去掉这个包包, 只保留模特。这边是我们生成图片和模特对比,如果你有自己的模特图片的话,也可以用自己的模特图片。 接着我们还要对产品进行反推,这里边同样是从视频中截取的报告图片,我们通过这个工作流上传需要洗图的图片。之后呢,我们点击工作流右上角的运行按钮, 我们就可以得到我们洗图出来的图片,左边是我们洗图出来图片,右边是我们原始图片。当然,如果说你有自己的产品的话,也可以用自己的产品图片。第三步,我们需要生成我们自己的故事版,有了模特图片、产品图片以及我们刚才反推出来的视频提示词, 我们打开我们的故事版工作流,通过图片加载节点,分别上传模特还有产品图片。在提示词这里边,我们首先要写上 图,一是女子参考图片,图二是包带的参考图片,然后下面写上我们刚才反推出来的提示词,也就是我们第一步的时候通过视频反推出来的提示词。接着再回到我们的故事版工作流,在故事时长里面写上十三秒, 保持和原视频一致,分清数量,我们写到四个就可以了。这个时候点击工作流右上角的运行按钮,就可以得到我们的工作图片以及我们对应的提示词。我们把这个工作图保存下来,我们的提示词在这个地方 k f 一, k f 二, k f 三, k f 四,这个是我们的提示词,我们要把它复制下来。这里说明一下,我们这个工作流呢有一个放大节点,如果说你需要的话,可以把它打开来, 打开之后呢,我们会得到一个高清的宫格图,但是呢,工作流的生成时间也会相应的增加,同时呢,我们这宫格图支持多图,如果说你需要更多的参考图片的话,可以把它们打开来。 我们再仔细的看一下我们生成的这个分镜提示词,从 k f 一 开始,每一个分镜提示词下面有一句台词,我们要把它复制下来,进行声音克隆。第四步我们要进行语音克隆, 打开我们的千问 t t s 语音克隆工作流,在我们的工作流左侧上传我们的参考音频,我这里边用了原视频的参考音频,我们先听一下。 姐妹们今天挖到宝了,快进来看这个包,这光泽,这质感,绝了,背上它,你就是那个清冷又心动的存在,这谁顶得住啊,我真的建议我的好闺蜜人手一个。 如果说你有其他的参考音频的话,你也可以上传其他的参考音频。上传好参考音频之后呢,我们在这里边上传我们的文案台词。这里边我没有更改,直接用了七十四生成的台词,如果说你有其他需求的话,可以手动进行更改。我们看一下我们生成的声音。 姐妹们今天挖到宝了,快进来看这个包,这光泽,这质感,绝了,背上它,你就是那个清冷又心动的存在。这谁顶得住啊,我真的建议我的好闺蜜人手一个。啊!声的声音和原声音还是蛮像的, 宫格图文案主题以及声音都已经准备好了,下面我们进行最后一步。来到 rts 二点三全自动宫格导演台,我们通过左上角的图片加载界面,点击这个按钮,上传我们刚才生成的宫格图故事大纲。这里边就是我们刚才通过故事版生成的提示词, 也就是 k f 一 到 k f 四那里边,你把它复制下来粘贴到里边就可以了。故事的时长呢,和原视频保持一致十三秒,这里边设置我们生成视频的分辨率。我们这个地方上传了宫格图主题,设置好时长之后呢, 他会用 g p t 五模型针对这四个宫格图生成 r t x 导演台对应的分镜提示词。像这个地方,第一段就是他的第一个分镜提示词,第二段是他的第二个分镜提示词,第三段是他的第三个分镜提示词, 这是第四段分镜提示词。这里面还额外的生成了全句提示词,以及他每个分镜的时长。上传好宫格图, 填好故事主题。设置好时长之后呢,我们还要到导演台进行相应的设置。首先我们上传我们的音频,通过这个按钮加载我们刚才克隆出来的音频,这个音频加载出来之后呢,我们点击它看到这个时长是十三点八三秒, 我们要在这个总时长这里边设置和它一样长度的时长。然后因为我们上传的是四宫格,所以说这个地方我们要写成二乘二的四宫格,这个工作流呢,它会自动将我们的宫格进行分割,同时它会将生成的分镜提示词自动填进来这里边每一个分镜的时长, 我们可以参照左边提示词里边的时长来进行设置,因为我们这里边是有外置声音的,我们可以听一下这个声音,根据这个声音来设置他的每一个时长, 比如说这句话结束了,在这个地方我们听一下他的声音每个声音在什么地方结束,然后呢来进行调节,调节好之后 我们还有最后一步。调节好之后呢,我们一定要记得把这里边的自定义声音打开,如果说他没有打开的话,我们刚才上传的这个声音他是不起作用的。在我们的工作流的最右边,我们的声音最好要接入到我们的原音频里面去,如果说我们接入的是系统音频的话,他声的声音他会有个裂化, 我们最好要把声音接到我们的原音频里边去。这些设置好之后呢,我们点击工作流右上角的运行按钮,就可以得到我们的视频了,工作流呢?我会放到评论区里面,需要的字取都看到这里了,给个一线三连不过分吧。
33青橙Lab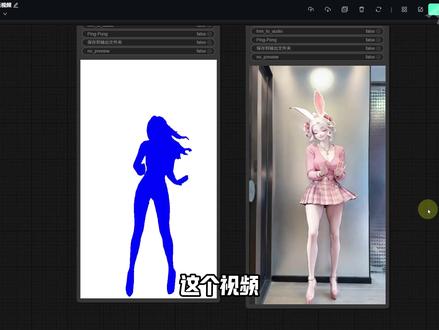 05:32查看AI文稿AI文稿
这个视频我们来看到 scarecrow 模型在视觉当中一些非常实用且有趣的更新。第一个也是首当其冲的多餐的实现,在一次的生成过程当中,我们店入一角色的多视角图像已允许我们生成的视频完成高难度的动作,如转身, 如跳跃。第二个更新官方,这个地方有一个 d p o 模型的更新,简而概之,这个模型能够让我们生成的结果更加的好,无论是从哪个方面来说都会有一点点的提升。第三个更新是量化模型的更新, 量化模型能够非常显著的降低我们在视频生成过程当中对于我们性能的要求,推荐对于低速选层的用户可以去使用 sky two 的 流程了。 sky two 模型本来是基于万人体系而产生的模型,所以很多的东西都是完全的通用的。接着我们来看到工作流,我这一测试和使用的是全球最大的在线 comforter 系列。 running hard 是 ai 专家和爱好者们最常用的在线工作台,最好的技术都正在同步更新并可以在线运行。这个视频我们将看到单人、双人、三人以及多餐的相关流程和一些经验借鉴。这里有一些流程来自于上一期节目, 我依然在进行复用,原因非常简单,我们今天的重大更新 one animate plus 节点,它是与原来 k g 的 流程相匹配的,所以这个地方我依然会提及更偏向于原生流程的流程。第一个流程,单人生物动作引导的视频生成,非编辑流程 快速启动上来说,我们需要去下载视频,设置一下我们生成的视频的时间长度,帧率锁定为二十四至高的话,我不建议超过三十, 是一个带有循环的流程,并且是一个自动算循环的流程,所以我们只需要再去增加一个我们的参考图像,就可以点击运行以获取我们的结果了。模型这个地方我会尽量的去填充我们的量化模型作为可选项。 第二个流程就是我们的单人人物替换的流程,快速启动上来说与第一个流程完全一致,真正的文章我已经在编工作的时候替大家做掉。第三个流程,双人动作引导 快速,从他来说依旧与第一个流程保持完全协同。第四个流程,双手参考编辑。第五个流程,三人动作引导。第六个流程,多图的参考。在我们原视频引导之初,这个人物是背对着镜头在往里面去走的, 所以我们结果也是与我们的原视频完全一致,是一个背面面对观众的开头,进去之后 转身跳,这个也是可以说是非常的成功了。快速启动上来说,我们要去加载一个视频,设置一下这个视频加载的上限,设置一下这个视频的帧率,设置一下我们参考图像一般为我们的正面、侧面背面式图加上一张背景图像那么 宽高,这个地方统一说一下,要不就是五幺二乘以八九六,要不就是七零四乘以二八零,简单去配置一下格式,点击运行将会获得结果,那么这就是我今天要去分享流程的快速启动 均是带有循环的,就算没有循环我们也可以使用这个上传文件点的话去完成长视频的生成,不需要太去担心性能的消耗问题。导航至 runninhabar 也是 n 视频,相对应的 ai 工作流 和可以一键启动的 ai 应用均以同步部署制,线上可以在线运行和测试。接着我们来看到细节处啊,那么首先是我们量化模型的更新依旧来自于设置当中, unik 模型可以进行量化的,那么我们的文本编码器也可以进行量化。 使用 g g u f 节点 noir 模型这个地方直接串联 d p u 之前我有编入一些 noir 增益模型以作为可选项,那么现在的话,其实我个人觉得只要保留一个菩萨模型就足够了。多参这个地方能够实现来自于社区当中的创作者乌卡卡老师开源的插件 one enemybeat plus, 核心节点就是这样的一个节点, 主要的差异在于 prefix frames 和 prefix mask 的 输入。多图参考的稳定性主要就和这两个东西呢在一起工作,这两个就是输入的,相较于我们原来多出来的图像, 和它们相应的 mask 背景图像不需要进 prefix reference image 和 reference image。 mask 与我们之前的用法是一样的,我们可以使用 kg 的 图像批次组合一起组合起来送进去。单双生物一体的动作引导 和参考编辑都已经做过了,而且我在上一个视频当中就已经发出去了,它都是循环的版本。进到三人之后的话,我这一次也打样举了一个例子,同样的 异于启动,但是这个地方我依然想表达一个观点, scar 二模型如果我们要进行参考编辑这样的任务,第一它是有减损, 第二它不一定完全有 animate 模型好,这是实话。所以有的时候如果说我们想保留背景,我们这个时候呢,不一定要把我们的替换模式开出来,直接保持关闭的状态。而使用我们的参考图像来进行背景的参考,怎么去做其实非常简单,就是我这里使用的是 runhattan 的 快捷创作功能, 直接用我们的 g p d 以 midi two 去做就行了。比如简单的来说,保持姿势不变,帮助我们渲染一个结果,或者说保持背景和姿势不变,帮我们渲染一个结果,这样很快就能让我们获得一个良好的参考头像。那么这就是三人的流程。 所以我这个地方主观的判断是不建议大家对两人以上进行参考编辑这样的操作的。多图这个地方理论上也可以做成带有编辑的流程,稍后我也会上传到 runnyhabar 上面。最近 runnyhabar 也在做六幺八的限时活动, cds 二点零的七二零 p 最低可以做到零点三元每秒钟,真的是非常便宜了,只是 通知大家一定要有需要的再去买一下。这么去评价一下 renee harvey 这个平台,受大量的博主监管的,平台稳定性是有保证的,有的平台的稳定性是极差,维权是非常困难的。
18AI-KSK 10:40查看AI文稿AI文稿
如何在 ai 中精确的控制人物的姿态,人物之间的关系以及视角。我们在用升图软件升图的时候,虽然可以用提示词来描述人物的站位和具体姿态, 但是用这种方法呢,抽卡的概率比较大,很难一次生成我们想要的结果。今天给大家分享一种能够精确控制人物站位和人物站位, 而且呢它的生成成本非常低,下面我们来看一下它的一个操作方法。首先呢我们需要使用三 d s max 软件,这个软件我会免费提供给大家,这个软件呢叫三 d s max, 我 们刚打开的时候呢,它的界面是这样子的, 我们点击右上角的创建面板,点击最右边的齿轮按钮,然后这边有个叫白铺的按钮,我们点击它在视图中进行拖拽,我们会拖拽出一个骨骼出来,这时我们可以选择里面的区块类型,我们选择男性或者是女性, 让它更好看一点。这里边的其他参数我们不需要更改,我们创建完毕之后呢,点击鼠标右键就结束了我们的当前的创建。下面我们讲下他的一些基本操作方法。 首先呢我们要在英文的输入法状态下,我们按下 q 键,是选择按钮,现在就是选择状态,按住 w 键它会变成移动状态。好,我们可以把鼠标放在轴向上对它进行移动, 如果放在两个轴向中间的话,它就可以在两个轴线上进行移动,按住 e 键可以对它进行一个旋转, 我们按 ctrl z 把它撤销, r 键对它进行缩放。同样我们选择单轴就是单轴缩放,如果两轴的话就是两轴进行缩放,现在我们把它改成选择状态, 我们再看下矢图的一些操作,按下鼠标的中键,可以对画面进行平移,按住 alt 键加向鼠标中键可以改变画面的视角。 其实这个软件它不光有一个式图,我们可以按住 alt 加 w 键,可以切换到四式图,我们可以看到这边是顶式图、前式图、左式图和透视图,我们可以分别对单个式图进行操作。 如果说我们想对它移动位置的话,比如说我们在顶视图,我们选择 w 键,然后把它移到世界坐标中心,他其他视图会跟着进行改变。下面我们在顶视图选择移动状态,按着 shift 键沿着一个轴向对它进行移动, 然后呢松开鼠标,它会提示你,你可以复制出来一个,然后我们按着旋转键按 e 键并旋转, 这个时候我们发现呢,他旋转的时候呢很别扭,如果说你发现他旋转之后的身体拧成了麻花,这是因为这个八一铺的他的特殊结构造成的。我们按一下键盘上的 h 键, 选择这个 ipad, 忘记它,重新选择它,这个时候再进行旋转,它就可以正常了。我们在旋转的时候呢,按一下键盘上的 a 键,进行角度锁定好了,它就可以五度五度进行旋转,我们旋转个一百八十度, 那么这个时候呢,他就是两个人对面进行站立了。好,下面在顶视图进行操作,我们按着 auto w 键将顶视图放大进行显示,我们将这个人物往左移一下,然后呢按着 shift 键 进行移动一个位置,然后这个时候我们选择十,然后点确定他就会出来是十个人物,我们把它框选,再按着 shift 键把它往下移动, 我们选择也十个吧,好确定,这个时候他就出来一排人物,相当于呢这个人站在这一排人物前面进行训话,我们把它位置调一下,框选他, 然后呢把它往左边移一点啊,可以选择这个 x y 中间移动了。等到之后我们 alt w 键选择四十图, 然后呢在我们这个透视图上点击一下,右击点击一下,按住 alt w 键,我们将那个透视图进行放大显示。好的,我们按住 alt 加 z 键, 可以进行一个矢图的一个作坊,按住 alt 加中间可以调整我们的视野,如果说我觉得 这样看起来热,可能会可能觉得这个人太小了,太矮,怎么办呢?我们还是回到我们的顶视图啊,我们选择这个右边的创建面板,选择这个球形,这个几何体,我们选择这个长方体, 在这人物底边拉一个矩形,拉完之后呢,鼠标松开,然后呢再往上再移动鼠标,我们看右边这个位置可以看到啊,他可以有个高度出来啊,这高度差不多了,好了, 到了左视度可以看到,那如果说这边看不清楚,我们到透视度看一下子这个立方体是把人物盖住的,我们要移动这个这个人物,还是按住我们的 h 键,选择它是白 put, 零零一双击它, 然后呢把它往上移啊,移到上面就差不多了, 但是我们觉得这个这个人物和这些阵列呢啊有些太近了,我们可以把它框选 往后移一下,那我们调整一下我们的视角,如果说你觉得视角不好调,我们按住 ctrl 键加 c 键啊,这个时候我们发现多了个摄像机出来,这边我们把它移开来,多了个摄像机出来, 那其他视角都可以看到,其他视角都看到,我们通通过其他视角也能看清楚。这边有个摄像机出来啊,这个是我们移动摄像机啊,我们看这边移动摄像机它这个视角它就跟着变了, 我们还可以右击选择这个摄像机的目标点,那么也可以对它进行移动,或者在其他地图我们看看。哎,那这个视角有点偏下了,我们把摄像机往下移一点 好了,我们把视角就调成这样子,那么这个时候呢,我们可以对它进行截图,或者说我们按住 shift 加 q 键, 他会将我们当前试图进行渲染出来。为了便于我们后期的一个操作呢,我们可以选择我们这个熟悉他这个人物,我们把它换个颜色,选择它之后呢,在我们这个地方 点选这个色块,我们给他一个红色吧,给他个红色啊,那么他就是红色了。好,我们再进行 shift 加 q, 那么这张这张图我们就渲染出来了啊,它还是一个带 ipad 通道的图,那么这张图渲染出来之后呢,我们选择这个文件保存我们的图片, 我们把它保存一下子起个名字,我们还可以继续再改变摄像机的角度,比如我们选择这样一个过肩视角,同样呢按 shift 加 q 键进行渲染。 好,我们把这个图片进行保存,我们保存成 png 格式, png 格式呢,它会带那个二发通道,我们可以通过这种方式任意的调整我们的人物占位,接着我们借助 com u r 来生成我们需要的视角。下面我们打开 gpt 页面, g 二工作流, 通过图片一节点,点击这个上传按钮,上传我们刚才渲染出来的人物站位的一个图片,再上传一个男字图片, 再上传一个学生的参考图片,其实词要这样写,人物站位。参考图片一,红色的人物呢是老师,老师站在讲台上,学生站在讲台下面,老师和学生对面站立,老师在讲话, 老师的形象呢?参考图片二,学生服装参考图片三,学生中有男生有女生,地点在学校操场。写实风格电影光照。 这个是我们生成的图片,这个是我们的生成图片,比较符合我们的预期,也非常符合我们的站位图。 当然我们用同样的方法,我们可以还可以上传我们刚才的第二个图片,这个时候因为我们已经生成了我们的场景图片了,所以说只要把我们的第二个场景加载上来,然后呢提示词要这么写,参考图片一,的镜头修改。图片二, 我们这个学生的参考图就不需要了,把它禁用掉,这个时候再点击生成,那么他就将我们的图片角度改变过来了。 不仅如此,我们的骨骼其实是可以调节的,我们可以调节成各种我们想要的姿势,这里面有一个我调节好的姿势,我们可以把它渲染出来,这是我们渲染好的图片,将它保存,然后给 gbt, 让它参照图片中人物的站位和人物的姿势,生成我们的想要的图片,这样我们就得到了一个人物站位和人物姿势一比一还原的照片。 下面呢,我们继续调整人物的姿势,还可以通过改变视角,渲染出不同的角度,然后让它生成不同角度的图片。在保持人物一致性和场景一致性的前提下,就可以生成不同角度的图片了,比如我们把视角变换到这里, 或者这里,这里都可以,我们通过变换视角就可以生成不同角度的图片了。 我们来到 gpt 编辑二,工作流,上传我们刚才调节好的人物姿势图,上传四个人物的参考图以及环境参考图片。 提示词这么写,人物的站姿和站位参考图片一,图中的红色人物参考图片五,黄色人物呢?参考图片四,蓝色人物参考图片三, 灰色人物参考图片二,场景参考图片六,我们看一下最终生成的效果,人物的姿势和站位基本上一比一的还原了我们的参考图片。好了,这是今天视频的所有内容,工作流我会放到评论区里面,需要的自取。都看到这里了,给个一箭三连不够分吧。
53青橙Lab 06:07查看AI文稿AI文稿
小伙伴们大家好啊,今天跟大家说一下这个 sky 二动作迁移以及这个角色替换的这个工作流啊, 这个模型呢,发布了有好多天了,然后如果大家要使用它的话,首先把自己的 copy 更新到最新版,更新到最新版之后呢,大家点开侧边栏的模板这里,然后在视频这里就可以看到他最新版的工作流了,搜 s c a i 啊,有了这个之后呢,就可以正常使用了,当然他这里啊,大家给他进行解包一下就可以啊,我其实一直不太喜欢官方的这个解,就说这个封包的操作啊,不不利于我们观看这个整个工作流的演示啊。解开之后呢,就可以看到 就说他这一整套流程了,包括这个模型下载地址,只不过因为出了很多天了,很多大佬也对他进行了优化, 我这里呢就说简单用了一下,呃, workface 大 佬做的啊,他这个呢是在官方基础上结合了爱屋大佬的工作流,然后做了一个循环这一块,就说能让我们跑更长的时长。我把这个参数给整理了一下,做了更加适合小白使用的啊。 首先本期对应的两个工作流呢,我这边也同步上传到了 ryan 哈普这里,大家在 ryan 哈普这里点开就可以直接使用了,如果是新用户呢,这边用我地址注册,还能送大家一千积分啊。 你像现在玩康菲约或者说玩无线画布, ryan 哈普都是就说现在顶流的一个平台了,咱这里就不过多介绍了。首先回到这工作流使用啊, 工作流呢主要是分两个,第一个呢是角色替换,角色替换呢,顾名思义就是我们把视频里的角色换成我们指定的角色, 这个 skill 呢,他不光能支持单人,也能支持双人,这也是他的一个优势啊。我们说一下怎么使用啊?你比如说这个,我想把视频里这两个跳舞的人物换成我图片中的这两个人,大家看一下最终效果 是吧?换的基本就没有什么大问题啊,包括这个人物特征,还有这个遗嘱啊, 还有这些动作以及表情啊,复刻的都很完美。具体使用的也很简单啊,大家就从这里输入,就说你想要视频多长, 它会自动按照帧率这里计算。注意啊,这个工作里头因为加了一个循环,所以说大家不要跑的时间太短,基本就说得十五秒,十秒到十二十秒左右,也不能太长啊,因为这个机座呢,它本身是基于万二点一的,太长的话也会就说越跑越烈化, 基本是三十秒以内,没什么大问题啊。十秒到三十秒这一块,然后这里锁定帧率是十六帧,大家尽量不要改啊,如果改的话,你后面这些所有运算都得跟着变一下,因为他这里是根据这十六帧到最后,然后再加一个插针补针这一块, 加一个插针补针这一块,最后生成个三十二帧的,所以说最后生成就流畅了,虽然说这里上传的时候感觉有点卡顿,这是为了我们 跑的是更加流畅一些啊,最终输出效果是不影响的。然后因为是不管是动作迁移还是角色替换,所以说其实我们的视频对我们的提示词对他的影响已经微乎其微了,所以说这里提示词大家随便写啊,他影响不大。 另一个这个参数呢,就是我们视频的最长边,不管是图片还是视频,都会按照这个九六零来给你做切分,然后剩下的比例自己变。有一点需要注意的,大家不要就说,比如说我上传的视频是个横版的,然后我上传的参考人物是一个竖版的, 因为这样他会按照图片的比例最长边,比如说九六零吧,按照九六零给你裁了,然后这样的话视频就相当于两边没有了。所以说啊,这个 呃,大家尽量上传就说比例接近的两个参考参考内容,要不然的话很多会出鬼图,或者说人脸根本就参照不到了,或者说下半身直接裁掉他就他就会越来越随机给你猜测了。 这里啊,就是我们想扣几个人,大家就选几就行啊,你比如说这两个人的,我们就选个二,如果说单人图,大家就大家就从这里选个一就可以了,上下使用就很简单了,大家就直接运,直接点运行就可以了。这个现在康学员说实话 用的也是越来越简单了,不需要去考虑太多,因为大部分流程官方其实都有啊,特别像是视频这一块, 有很多东西是没法去解释原因的,你比如说我这块怎么接,那块怎么接的,直接按照官方流程走就可以了,我们只需要了解一个大概的原理,然后直接替换就行。 因为说实话现在变化这么大,有可能一个周之后这个工作流程就完全跑不通了,又要又要按照新的官方工作流程去搞,所以说啊,大家就先整明白了官方的流程怎么跑,然后再去根据自己需求改动就可以了。 而动作迁移的使用和刚才这个就完全一样啊,他和刚才那个唯一的区别就是背景不一样, 你像我们呃,人物替换是把这个图片替换到视频里,用的是视频的背景。而这个动作迁移呢,是把视频的里的人物动作给迁移到图片上,用的是图片的背景,区别也就是在这里啊,而他们用法和刚才一模一样。这里就不注意数了, 大家自己试玩一下吧。对应的模型和节点以及工作流呢,我这边都同步放到网盘里了。这边其实也没什么太难的一个节点啊,唯一不同的就是 k g 新作的这一个测试节点, 就这个,就这个测试节点不太好找,大家可以直接解压网盘里这一这一个节点也不需要安装依赖啊,直接就可以使用了。好嘞,谢谢大家,再见。
38炮老师的小课堂 08:13查看AI文稿AI文稿
大家好,我是老徐,最近出来的新模型和新工具也是非常多,但是很多我在测试过之后感觉效果很一般,所以就没有制作教程。 但是最近刚出的 sky 二 two 这个效果还是让我比较惊喜的,相较于它的上一个版本提升是非常明显的,最直观的就是在这个人物一致性方面保持的非常的好。 以前我们用 one 编辑或者是 vse 进行视频人物替换的时候,基本上可以说替换出来的人物跟参考图片的人物是没有什么关系的。 这个模型这样出的人物相似度就非常的高,因为这个模型使用起来也更加简单,他是不需要骨骼图或者是生动图来控制人物的动作,他只需要一个蒙版,这个蒙版是必须要用三百三十一来生成,这个蒙版并不是直接用来控制视频的生成,他是进行一个参考, 所以在蒙版以外的地区有可能也会发生改变。以前我们用这个蒙版控制的话,那生成的新人物基本上就是这个轮廓,但是我们现在只是参考蒙版的话, 人物的外观轮廓其实差异比较大,也可以进行很好的替换,这个我觉得也是它非常实用的一个地方。 这个模型在刚发布以后, comui 在 第二天就对它进行了支持。这个工作流是我在 k 级的工作流之上进行了一个优化, 主要是加了一个长视频的循环,这样就可以支持长视频,理论上是可以不限时长的,但是这个也需要显存的支持,一般情况下一次跑个四五十秒也是没什么问题的。这个工作流我已经发布到了 runescape 上面, 在桌面上是可以直接使用的,接下来就跟大家讲一下这个工作流的具体使用方法。使用是比较简单的,有两个功能,一个是视频人物的替换,一个是动作轻移。 在参数设置这里可以选择模式,默认是开启了替换模式,如果关闭掉就是进行动作轻移,这里就是替换模式,这里是一次性替换了两个人物,这也是非常实用的,如果把它关闭掉,就是进行动作轻移,看一下动作轻移的 动作新颖,就是直接用参考图片来生成视频,使用的是这个参考视频的人物动作,这个地方是可以开启和关闭长视频循环的, 在默认情况下,长视频循环区都会工作,那如果视频是五秒或者五秒以下的,这个就比较浪费时间, 因为它再循环也是没有意义的,所以这个地方可以把它选择关闭,这样就是节约时间,不关闭的话就不管时长多少,它就会一直升沉,一直升沉。因为在视频上传的这个地方,我默认是设置了一个帧数的上限, 一百六十一针,十六针一秒也就是十秒,这里也可以把它改大点,二百四十一就是十五秒,三百二十一就是二十秒,也可以不设置,改成零,就是没有限制, 我建议大家还是设置一下,不然的话是个非常耗时间,特别是比较长的视频。然后这个地方是对视频提示词的控制, 可以简单的描述一下,其实我这个地方是描述错了,这个是上一次生成的时候写了一个女孩在跳舞,她视频里面其实是两个女孩,在这里也没有出错,所以这个地方简单的写一写就可以。然后这个地方也需要注意一下这个控制区,这里其实是一个蒙版区域, 这里的题词是用来选择蒙版的运行,来看一下这里就是选择了人物,这里的题词可以写的更加具体,比方说我只想选一个人物, 右边的女人。再来看一下这里还是选中的两个人,那我们就把这个地方给调整一下,这里的意思就是最大的检测对象, 这里是二,那我们把它改成一,就强制它只能选择一个, 然后这里是进格次数,这里的二代表的就是每两针检查一次,数字越大就是越结越显层,但是就没有那么准确, 如果是一的话,就是每一针都检查,这是最准确的,但是对选择的要求也是最高的。我们看一下现在就选择了一个,再来试一下左边的女人, 这里就选出了左边的女人,但是视频的蒙版还是右边的,这个题词就要重新来改写,这里我就不再测试了, 反正就是这里的蒙版是根据羽翼去生成的,这就是这个工作流的使用方法。另外尺寸这里需要注意一下默认的尺寸,四八零和八三二,如果是横屏的话就把它换过来, 这个效果是最好的,但是我感觉这个清晰度有点低,所以我把它改成了五幺二和八九六,也可以把它改成七二零或者幺二八零,清晰度就高很多,但是在替换人物的时候会出现很多问题,如果是动作轻盈就没什么问题, 因为这个模型是基于 one 二点一来训练的, one 二点一的训练级绝大部分都是四八零乘以八三二,所以使用这个尺寸的话效果是最好的。 如果是在本地使用的话,首先是要把 comui 更新到最新的版本,大家可以看一下这里的版本信息, 直接在管理器里面更新。 comui 更新到最新版本,这个地方要选择这个夜间版,稳定版的话,目前还没有正式的支持,要最新的夜间版,然后更新一下就可以。 但这个更新通常是需要魔法的,如果大家用的是我的整合包的话,在这个升级文件里面,我是自己创建了一个免魔法的升级命令, 直接双击以后就会进行自动升级,这个是不需要魔法的。接下来需要到海报费彩上把这个 sky two 的 模型下载到本地, 这里有三种模型,建议大家直接使用 f p 八的模型, f p 十六的模型,这个体积有点大,对显存的要求也特别高,我自己试用了一下,这个差异不是特别明显。 下载的模型也是放到 com 幺 的 modus davidson modus 这个文件夹里面,这个模型是基于 one 二点一来开发的,它这里也有体现 one 二点一,这是它使用的克利浦和 v i e 都是 one 二点一的。然后这里还有个视觉模型, 这里的是一个加速的 nor, 也是万二点一的加速 nor。 这个小视频的内容就是这些工作流的地址我也放在了视频的简介区,如果大家觉得有帮助的话,也可以关注一下老徐,给老徐点个赞,谢谢大家。
39老徐Ai研习社 00:43查看AI文稿AI文稿
感觉错意啊兄弟们! runninhab 的 cds 满血七二零 p 最少只要三毛每秒,而且我已经去给你们实测过了,给了他一张九宫格参考图来生成视频,不用排队,差不多一分钟就能生成好,速度飞快,而且不用偷塔,一次就能值出满血的效果,真的满血完全不将至!我守护甜蜜 甜蜜暴击!不过这个活动六月三十号就结束了,真的没早点发现他 招 running hap 还是一个很全能的 ai 创作平台,有集成各种 ai 模型的无线画布,还能用别人打包好的 comfyui 工作流,甚至专门做短剧的 r h story 这些工具都能用上这个三毛钱的 c d s 二,我只能帮你们到这了,冲吧兄弟们!
1667赛博小凡 07:21查看AI文稿AI文稿
哈喽,大家好,今天给大家做一个这种自己做的一个网页的一个介绍,漫君梦工厂。然后我们首先先进入工作台, 点击之后它就会出现这样一个界面,然后你需要在设置里面去把自己的一个 dixickey 和一个 runninghub 的 一个 k 输入进来,因为我这里主要用的就是 dixic 和 runninghub, 然后像 gpt 它的一个第三方,这个的话如果你自己会弄的话,可以在后台里面后端自己设置。 然后我们今天就主要讲一下简单那个工作流。嗯,第一步的话,首先进来之后会有这样一个界面嘛,你就可以点击开始创作, 然后先去生成剧本,然后这里我也是设置了四个按钮吗?如果你有自己的剧本的话,就可以输入剧本去创作,我们今天就先从零开始去演示一遍, 然后它的它是一个以对话的形式来进行的,这里面它已经说好了,然后我们只需要就是看你喜欢哪一个嘛,然后比如说我们来做一个替身的游戏, 主要的话就是通过这种选项来跟他得到一个剧本,然后有时候可能会没有这种选项,没有选项的时候你就可以去把他给的两个方向输入进去,比如给个方向二, 然后继续, 然后这边它这个对话速度还是比较快的,我们就可以我稍微快进一下, 然后这里面就到了我们那个剧本生成的了。如果你对这个剧本觉得太简单的话,你是可以在后边就是前边让他再去做一个这种嗯,扩展的生成,因为我们这边做一个演示就不再重复的进行了, 然后也可以在这里面进行编辑,如果直接觉得可以的话,就直接点个生成分镜,然后就到了第三个界面,分镜提示自生成, 它可以把整个剧本提示成五个分镜,然后根据根据每个分镜再来生成图片, 然后我们这里也是快进一下好的,然后我们这里也是生成了生成了五段的一个提示词,然后刚才的话我生成它出现了一个报错, 那如果你生成它出现报错的话,你就可以再点个重新生成它,可能就是在提取的过程中有可能会出现一些错误,但是重试的话就可以生成成功。 然后这里生成了之后,我们就可以去利用这些提示词,他这里给的也是比较的详细的给了场景、人物、台词,还有一个每个四宫格的景别, 然后包括从这以上都是用调用的是 deepsea 的 一个大语言模型,然后我们去生成图片, 这个图片的话包括后面的视频生成都是调用的一个 running hub 的 一个工作流,所以如果你需要使用的话,可能还需要在 running hub 上开一个会员,然后它每次最多就生成一个图片进行一个任务, 也就是说你生成这个的话,你就需要等待,然后等到它生成完之后再生成下一个, 然后我们这里也是快进一下, ok, 我 们这里图片也生成出来了,然后我们放大看一下 还是可以的,但是他这个人物的区别好像不太行,但是没关系,我们是做一个简单的测试嘛, 然后到下一步这里的话,你就可以把它全部再都生成一遍,然后我这里继续往下走了,这里它会根据提示词,但是这个提示词跟这个不太匹配,它就需要优化一下, 优化成这个可以被识别生成视频的一个体质测,然后优化完成后,点击生成视频片段,他这里就开始跑了,然后我们也快进一下。 ok, 这里视频也是生成了,我们来再来看一下 晚堂晚安 控制还是不错的。然后这里的话它是有一个自动匹配时长的,比如说它在前面的剧本嘛,它就是说生成一个多少多少秒的,比如说这里它生成个十二秒的,它最终生成的视频就是可以根据匹配它文本 所规定的时长,然后生成对应的时长,然后下面的每个视频都是一个一个生出来的, 然后最终生完之后就可以在这里视频合成界面,把视频最后拖过来,这里是可以进行排序的,然后合成最终视频就结束了。下面这个七八九是作为一个嗯微调的一个界面, 比如说有时候你不喜欢他生成的视频,你可以在这里用文本描述生成一个视频,比如说我们来测试一下,嗯,小猫 跳舞生成个五秒的,然后我们也继续快进一下。 ok, 这里视频生成了,我们继续看一下, 当然提示词没有很准确,所以呢生成的视频就非常的简单,然后还是做个演示,下面的话就是一个 gpt 二点零这个 身图,我这里呢分为了一个官方和一个第三方的一个接口,然后都是可以使用的。 然后下面的话就是一个很基础的,像 ctrl u i 里面的动作迁移、 人物换脸,还有一个视频变高清都加进来是可以跑的。这里呢就不做演示了,因为主要的话就是做一个慢距工作流的演示,然后告诉大家怎么使用, 然后主要的话就是这些。
62633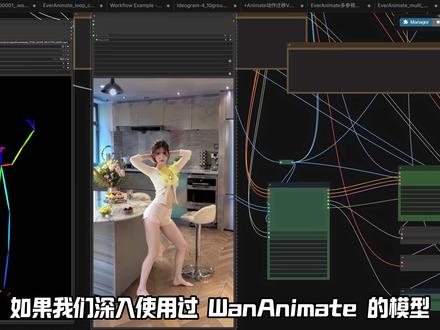 06:17查看AI文稿AI文稿
如果我们深入使用国外的模型,其实一定会遇到一个问题,一旦视频拉到二十秒以上呢,你就会开始飘衣服,开始变,背景呢,也开始闪人,就不一定还是那个人了。今天这个技术是专门冲着这个痛点来的, ever animate 这样的一个技术相关的团队,之前还开源过 sv i 这样的长视频生成技术,这一次的更新是有东西的,那么我这个视频的话,其实已经跳了一分钟左右了。 人脸这个地方如果说模糊的话,可能是因为它所占的比例比较的小,至少我们看到大体以及背景这个地方是没有什么变化的。我使用过之后还是推荐大家去试一下,因为这是 yem 的 模型,所以它除了可以做垂直参考之外,还可以进行参考编辑这样的任务。当然这不是官方所推荐的形式了, 普通长视频呢,是把一段段的画面硬接起来, r ever animate 是 先在浅空间里面把上一段的身份和运动状态呢做好,再生成下一段,所以它不是单纯的拼视频,而是在 later 里做长视频记忆 是这样的一个状态,而且这种说法也不是一个假把式, stage 一 是给 one animate 的 模型补上长视频续写记忆, stage 二是用来去修复跨段漂移, stage 三则和高清相关。我主要对官流进行了参数的调节,模型配置的优化,循环的构建,可以说能够把 y n m 的 模型的性能呢给发挥的淋漓尽致。接着我们来看到工作流,我这测试和使用的是全球最大的在线康复员一名 runninghab 是 ai 爱好者和专家,最常用的在线工作台, 最新最好的基础都正在同步更新,并可以在线运行视频对应的打磨好的流程也已经同步上传。接着我们来看到工作流,既然说快速启动,那这是一个 one animate 模型,它所支持也是我们最为常用的能力有两种,一个呢是全球参考,还有一个是参考编辑, 在最右下方呢,有一个布尔值,可以通过布尔值来对于我们的流程进行调节,如果设置为 false, 则将会是一个全球参考的流程。 设置一下我们视频生成的宽高,那么我这里设置为一二八零乘七二零七二零 p 的 结果帧率设置为二十五,那么 one enemy 模型设置为三十帧也是相当合理的。帧数 读写着上线和跳过前面多少帧呢?可以选择性的进行设置。这里我使用了一个简单的数学表达式,使用了我们的帧数来算出我们需要循环的次数,所以不再需要手动的去填写我们循环的次数。一般情况下来说,初次生成为八十一帧的结果,后面的循环每循环一次的话,会新增七十六个帧, 因为我们有五个帧叠在一块儿。如果我们做的是全帧参考,我们需要加载一张应用于全帧的图像,然后点击运行将会获得结果。如果我们做的是参考编辑,我们除了加载图像之外的话,还要注意我们遮罩区域的深沉,如果自动裁不准的情况之下的话,我们接下来一张图像, 既然这张图像直接就从我们的 load v 九当中去取出来简单涂抹一下,我们想用遮罩追踪的人物让 c m t 去切, 这样的话准确率会高很多。提示词我直接使用了 w 一 四做的简单反推,那么在后方的话,有一个骨骼视频检测预处理的选择节点,可以用缩影做零一二的选举。那么 v i t pos 是 我们官方原来支持的, 它的速度也最为的快, s t pos 的 话更为精准,更为强劲,也更能应用于复杂场景。那么切换为 index two, 我 们实际上用的是一个全剧参考,加上 人物对齐,参考人物与驱动人物身材的比例对齐,因为中间呢,我们会再重音设一下,那么这就是快速启动。在官方的眼中, ever animate 它不是一个完全的支持参考编辑的流程导航至 runny harbor, 也是 n 视频,相对应的 ai 工作流 和可以一键启动的 ai 应用,均以同步部署式,线上可以在线运行和测试。看到模型处,那么第一个呢,是我们 k g 最后的 v 二版本的 animate 模型,接着是我们 y animate 模型后期五个参数的增益模型,这是我们常用的增益模型,基本上是一个固定的配置范式。 everanyme 的 模型是有需要我们家的模型的,那么就加载的这么三个 size 一 二三的 laura 模型, click belowder, 它加载文本编码器,用来理解正向提示词和负向提示词。 va 一 使用的是 one 二一的 va 一。 laura 后面有几个性能优化节点,那么第一个呢,是我们的显存倍率, 用于调整模型显存使用的策略,这个数值越高越保守,越低呢越接近。接着是我们的设置 attention 节点 touch 补丁,用于修正 touch 运行的设置。神选层是否要分快神显存,如果我们报显存了,我们就往上调一调吧, 后面我们就直接看到循环的部分。那么第一个呢是模型的总线送入所有的 everanimate 分 支, 正向提示词总线副向提示词总线 v a e 总线参考图脸部视频姿态视频背景视频遮罩宽高这是我们第一段的生成,不再循环之列,会生成八十一个帧, 这一段负责生成第一个创可,也就是长视频的起始状态。在参考编辑这个地方吃尽了我们所有的条件,全区参考,我们就少吃两条件,一个背景视频,还有一个遮罩 手段生成之后会说出三个非常重要的东西,那么第一个呢是生成用的 latent, 第二个呢是 trim latent, 也就是后面要裁掉多少锚点帧和重复帧。 第三个是 video frame offset, 也就是下一段应该从驱动视频的哪个时间位置继续抖动作。接下来经过局部手段裁锚点 latent, 再经过局部手段裁重复图帧, 把我们手段当中为了铰砝和沉结而产生的重复的部分的裁掉,然后的话会进入我们真正的循环。 在后面我们的循环呢就开始了,这里头头是手段之后的续段数,不用担心,我已经做了自动的表达式。 然后我们看到局部续段。局部续段这个地方呢, menu 一 是上一段裁剪后的最后有效帧,它会进入到零七记以上一段继续的 continue motion v 六二是上一段输出的 video frame offset, 它会进入到对应的 offset 节点。 v 六三是目前已经累计好的整段视频帧, 这里最关键的是零七 g, 它粘在我们的后方,需要组合拼凑,后面就是这么三象值的循环,在里面周而复始地去一批一批四地去循环了,最最后我们就会得到结果。
50AI-KSK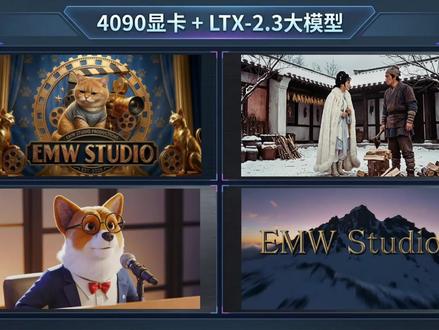 08:52查看AI文稿AI文稿
你现在看到的这些视频全都是四零九零显卡运行 ltx 二点三大模型生成的。 你可曾在雪山上救过一只狐狸?你是那只白狐,我是那只酱板鸭的妹妹。 女士们,先生们,今天做客的嘉宾是当红榨子鸡、小龙虾。 现在我们来看一下 lts 二点三到底升级了哪些地方。第一,依旧开源,配合四零九零显卡就可以尽情的在自己的电脑上运行它。 第二,大幅度的提高了九比十六竖版视频的生成质量,因为我们的手机屏幕是九比十六竖版,所以对移动端的视频更加友好。 第三,画面更清晰,台词配音更准确,配乐和音效更好听。第四,更懂你写的提示词,无论你写的提示词多么的复杂,它都懂你。第五,视频文本渲染更准确。比如你想生成一个 logo 的 视频,它就能准确地把 logo 的 字母写到视频里。 comfui 第一时间就对 lts 二点三进行了支持。现在呢,我就带大家去搭建一下 lts 二点三的 comfui 工作流。在 runnyhub, 我 搭建了四个与 ltx 二点三相关的工作流,我们一个一个的来,先看第一个, 点击运行工作流,你就可以跟着我学起来了。整个工作流你看起来很复杂,但其实需要你配置的参数很少。 首先你要看这个节点,是个开关,开启表示纹身视频,关闭表示涂声视频很明显现在是开启状态,也就是纹身视频 现在来到工作流的左上角,其中 log in mid 节点我们不用管,因为现在选择的是纹身视频模式,我们只要看提示词就可以了。我在这里写的是标志性的电影制片厂的厂头,以航拍镜头扫过雄伟的雪山峰顶,刺破棉絮般的云层,开始 时值黄昏,天空渲染着身子与金色渐变等等等等。这里有一个站位符叫做 replace name, 我 用 test replace 节点负责把这个站位符找到,然后在下面输入你的电影工作室的名字,比如我写的是 emw studio test replace 节点就会把这个站位符替换成你输入的工作室名字了。 下面就是一些常规参数的设置了, length 表示视频总帧数,现在我们设置的视频帧率是二十四帧每秒,然后根据这个公式,总帧数等于二十四乘以秒数加一。因此我想生成八秒的视频,带入公式就能得到幺九三。 一般支持生成十秒以内的视频啊。当然,如果你的显存足够的大,你也可以尝试十五秒时长。 vs 和 hit 表示生成视频的宽和高, 其他参数不用动,包括模型加载,你就用默认的配置就可以了。点击运行,等待两分钟,你就能得到一段运镜效果还不错的 logo 展示视频了。 第二个 ltx 二点三,生成电影公司厂标视频工作流,其中文声视频开关,这里选择的是关闭状态,也就是说这是一个图声视频工作流。那么此时在 lud 编辑节点上传视频的手帧画面,作为视频的开头, 我设计了一款我们工作室的厂标,我直接上传到了这里,然后输入提示词,中景构图,开场画面精准呈现。这张金色厂标, 橘色短毛毛,穿着灰色针织衫,端坐中央,神情威严镇定啊等等等等,写的很详细,其他的参数跟刚才介绍的一模一样,我就没有改,直接点击生成,等待一会你就能得到一段特效相当不错的电影公司厂标视频了。 到这里你有没有发现我写的提示词都很复杂,因为 ltx 二点三这个模型对提示词的要求很严格,你写的提示词需要包含以下几点,生成出来的视频的效果才会好。第一,需要确定镜头的构图, 最好是使用电影术语进行描述你想要的风格。第二,描述视频氛围,比如视频光线、色彩风格以及你要表达的情感。 第三描述动作,将主角的动作按照时间顺序写出来,尽量的自然流畅。第四,确定运镜,说清楚镜头何时切换,包括镜头移动后的主角状态。 第五描述配音,请使用清晰的文案,描述出视频的环境,音、音乐、音频以及主角对话。对于主角对话,请将台词放在引号内,并注明你希望主角要使用的中文还是英文以及其他语言,还有口音等等等等。 讲了这么多,我相信大家已经蒙了,没关系,接下来我就来讲如何在康复 ui 中使用千万三点五来帮你写 ltx 二点三的提示词。现在来看第三个工作流, ltx 二点三配合千万三点五生成宠物播客视频。 整个工作流我只做了一处改变,就是把原来负责写提示词的节点直接删掉了,取而代之的是添加了一个千万三点五大模型节点。 首先我把 ltx 二点三大模型的提示词拷写规则给到了它,然后呢,我只需要把我想生成的剧情用大白话跟它讲一下就可以了,你看,我就是这么写的, 我想生成一个八秒时长的呃,具有皮克斯动画风格的宠物播客视频主持人是一个柯基犬,嘉宾是一个小龙虾。主持人先面对镜头介绍本期来的嘉宾 ladies and gentlemen, 今天做客的嘉宾是当哄炸子鸡小龙虾 现在确实很火啊小龙虾。然后镜头转到可爱的 q 版红色小龙虾,小龙虾面对镜头腼腆的微笑,示意你给我生成出中文提示词,只要最终的提示词结果到这里,大白话就说完了。 然后你看一下经过千万三点五处理之后给你写的标准提示词版本,尤其你来看一下他写的这个运镜镜头脚本,那叫一个专业,是不是写的特别的好,根本就不用再愁怎么去写好 ltx 二点三的提示词了, 其他的都不要动。你来看一下视频效果是不是特别的 q, 特别的可爱。 然后我们来看一下第四个工作流,使用 ltx 二点三配合千万三点五生成武打电影视频。在这里我把纹身视频的开关关掉了,然后在 log 隐秘之节点上传了一张武侠电影的配图。 紧接着我跟千万三点五说,将输入的图片作为起始帧,生成一个八秒的武侠电影片段。 男主和女主的口音是经典的武侠片里的中文配音,那种感觉。女主问,你可曾在雪山上救过一只狐狸?男主回复你是那只狐狸。 此时女主掏出一只特别大的酱板鸭指向男主,然后生气的回复道,我是那只酱板鸭的妹妹。 之后千万三点五就会把你的大白话写成一个很详细且符合 ltx 二点三大模型规则的提示词。再次感叹一下,写的是真好这个提示词,然后你再等个两分钟,就会得到一段对话效果特别棒的武打电影片段了。 最后我们总结一下啊,第一, ltx 二点三这个大模型开源,它可以部署在本地运行,配合四零九零显卡就能跑。第二,生成的视频效果和配音都很不错。 第三,使用千万三点五可以帮你写出很棒的提示词,且符合 ltx 二点三的规则。 最后,有个地方需要注意一下啊,他对中文的文字渲染能力还是不足的,需要继续提升。如果本期视频对你有所帮助,请点赞收藏,支持一下,这里是电磁波 studio, 我 们下期视频见!
2328电磁波Studio 06:08查看AI文稿AI文稿
sniff sniff sniff 好 久不见, 功能强大的动作迁移模型 s c a i l 二点零版本来了,它不光能够对运镜进行迁移,哪怕你的视频中有分镜以及非常复杂的动作,它都能够非常精确地进行复制。 那么二点零版本的话,它有几个特点,首先呢,在老版本里边会用到 dwpos, 它会占用很大一份显存。而新版本里边,它是使用端到端的一个技术,也就是直接从我们的原视频来直接读取我们的肢体动作,这样就能够极大的减少显存占用。 二点零版本不光能够进行动作迁移,还能够对视频中的人物进行替换,他在对视频中的人物进行替换的时候呢,不光能够对我们原视频中单个人物进行替换, 还能够对多人物进行替换,哪怕是你的视频中有多个人物,他还可以进行一个指定人物的进行替换。另外呢,他还能够对人物的面部表情进行一个精确的还原,也就是说,如果你是有一个口播视频的话, 他在对人物进行替换之后呢,也能够精确的还原人物以前的口型。下面我们来看一下工作流的一个操作。首先呢,我们看一下单人动作迁移,首先我们看一下动作迁移和视频人物替换的一个区别,这是动作迁移,他有一个 姿态视频这个遮罩,还有一个参考图片的遮罩了,这两个节点是断开的,而我们的角色替换的话,这两个节点他是连上的。 同时呢,如果说你是做角色替换的话,他这里边会将人物抠出来,生成一个黑底的一个图片,而我们的动作迁移就没有,这个是我们的动作迁移和我们的角色替换工作流的区别。 下面我们先来看一下动作迁移工作流的一个使用方法。首先呢在我们工作流的左上方,这里面有一个视频的尺寸设置,视频的尺寸要确保能够被三十二整除,如果说你是竖屏的话,建议是五四四乘以九六零,如果横屏的话就是九六零乘以五四四。 这个加载视频节点上传我们的参考视频,这里面我上传了一个女人跳舞的视频。 下面的参考图片节点,这里面我上传了一张高达的图片。我们接着再来看这个地方是我们的提示词,设置一定要写准确了。我想生成一个机器人跳舞的视频,这个地方是多人设置,也就是说你的参考视频里面有几个人,你想有几个人进行一个替换或者动作迁移, 那么我们这边只有一个人,我设置一就可以了,那么检测对象,我这视频里面我想切换一个人,那么就把它换成 person, 写成人也可以,写成一个女人也可以。这边的时长是十六秒, 我们设置好时长就可以了,然后点击运行就可以得到我们的视频了。啊,这是我们生成的高达跳舞的视频,嗯,可以说呢动作呢非常协调,毫无违和感。不光如此,他还对我们原视频中的我们原视频出现的两个人物 也进行了一个重绘,他将我们原视频中的两个人物呢也生成了和高达相似的风格。 如果说我们想做一个多人的动作迁移,我们可以拿一个多人跳舞的视频来进行演示,这边我上传了一个五人跳舞的视频, 下面呢我们对应的要上传五个人物,我这边呢上传了五个动物工作流,他也支持非人类的动作迁移,这里面提示词我们要注意一下,提示词我们要写成五个动物在跳舞,然后呢 因为这边我是有五个人,所以说这个多人设置的地方呢,我要把它设置成五。检测对象,同样是人或者是我们写成女人都可以。时长,这个时长呢是十六秒,我们就设成十六秒,然后点击运行,我们看下生成结果啊,这是我们生成的结果,比他的第一版好多了,我记得第一版的时候呢,他会把这些小动物进行拉长 来匹配,我们参考视频中人物的身高,二点零版本呢,他依然保持了这些小动物的原始身高,看起来呢更加可爱一点。下面我们来看一下人物替换工作流,他是怎么操作的。首先呢,我们还是通过这个地方来设置我们视频的尺寸,分别是视频的宽和视频的高, 通过视频加载节点上传我们的参考视频,通过这个节点我们上传我们的参考图片,我们要生成一个女人跳舞的视频,要在提示词这边写入正确的提示词,我们的视频中呢只参考一个人物,所以说这个地方我们设置一就可以了。 那么检测对象我们视频中呢是一个女人可以在这地方写一个,一个女人或者是人都可以。视频的时长他就是我们这边的帧读取上限,如果是零的话, 那么他就是这个视频完整的一个时长,你也可以在这个地方输入一个数值来控制我们视频的生成时长。另外说一点,我们这个工作流呢,他是一个循环工作流,默认他是有第一阶段采用八十一帧, 第二阶段七十三帧以及我们循环序来构成的,默认情况下的话,他差不多够我们三十秒的时长生成,如果说你觉得时长不够的话,可以在这个地方增加他的一个循环次数,好看一下我们的生成效果。左边是我们生成的视频,右边呢是我们原始视频, 可以说呢,我们生成的视频对我们原视频中的人物进行了完美的替换。今天的视频就到这里了,给一箭三连不过分吧?
37青橙Lab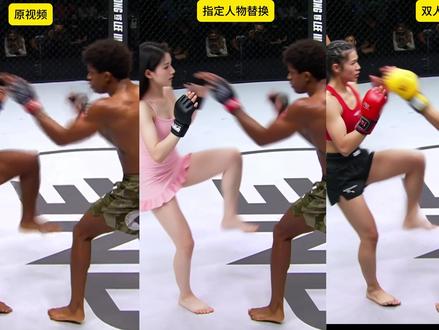 04:40查看AI文稿AI文稿
刚才我们看到的视频是用我们最新的 s c a i i 二工作流制作的,一个呢是对指定人物进行替换, 还有一个呢是对视频中的所有角色进行替换,今天呢我们来看一下它的一个具体的使用方法。好打开我们的 s c a i i 二二工作流, 这个工作流不仅可以制作动作迁移,而且它还能够实现对视频中的角色替换。那么首先我们看一下角色替换和动作迁移的区别,那么在这个节点的话, 如果说你想做动作迁移的话,这里的姿势视频遮罩还有一个参考图片遮罩,他是断开的,如果说你要做角色替换的话,这两个节点要把它连上去。同时呢在我们的控制区,如果说你想做角色替换的话,这里边他还会生成一个人物的黑底图片, 因为他是用人物的黑底图片进行训练的,如果说你是做内动作牵引的话,是没有这个图片的。好,我们看一下这个工作流的一个使用方法。我们先来看双人的角色替换, 首先在这个尺寸里边要设置好我们的宽和高,这里边的宽和高一定要能够被三少整除,否则呢视频会出问题。 如果说你是做竖版的话,尺寸就可以设置成五四四乘以九六零,如果是做横版的话,就是九六零乘以五四四。 在这个视频加载节点上传我们的参考视频。在图片加载节点上传我们的参考图片,我们的参考图片最好是和我们的参考视频手帧保持相同的姿势。在提示词这里边要做好一个准确的描述, 这里边我可以写两个人在打拳,也可以写两个女人在打拳,因为我们最终生成的视频是两个女人在打拳啊,这个提示词一定不要写错了,这里边的多人设置 是指的你要对视频中的几个人进行一个改变,我这里边要替换两个人,所以说这里边我要写成二,如果说你要替换一个人,那么可以写成一,选择对象是什么呢? 我们视频中我们要替换什么元素?我们要替换人,那么就可以写成 person, 也可以写成男人都可以。如果说视频中有男人有女人,可以笼统的写一个 person, 也可以写指定的一个人。视频的时长,这里边的时长控制你想要生成视频的长度,单位是秒, 如果说你不知道整个视频的完整时长,你可以把这里边设成零,他将会将整段视频完整的输出,这个工作流是一个循环,工作流,他可以声称大概三十秒左右的一个视频,所以说三十秒以内的视频呢,我们可以直接的完整的输出, 如果超过三十秒怎么办呢?我们来到工作流右边的循环区域,在工作流右边的循环区,这里边有个循环次数, 如果你的视频时长超过三十秒,可以增大这里边的循环次数,大概八分钟左右视频的生成了,我们把它和原视频对比一下,我们看到他替换的还是蛮好的,他对视频中的人物进行了一个精准的替换, 包括这个慢动作,他也做到了一个精准的还原。下面我们看一下指定人物是怎么替换的?首先同样的在这个地方设置视频的尺寸, 上传我们的原视频,在这个地方我们上传一张参考图片,提示词,我们要改一下,一个粉色衣服的女人和一个男人在打拳,多人设置,我们要设成一,我们只检测一个人,那么检测什么呢? 整个一个男人,至少我们也可以设成零。这里要说一下,我们在做视频替换的时候,比如这个视频,我们要将视频中左侧的男人经替换,那么在第一针的时候呢,这个男人要出现,如果在第一针的时候呢,我们要替换的这个男人没有出现,那么他有可能就会出问题。这里边的提示词, 还有这里面的检测对象都对我们的结果有印象,这个图片是对我们要替换的图片进行一个抠图,我们可以在它上面进行右击执行选中的节点,那么它将只运行和它有关的一个节点, 我们可以检查一下它有没有正确的识别,如果说没有正确识别的话,我们就要修改前面的提示词,直到它正确出现, 那么在运行的话就能够节省我们的时间啊。这个是我们的原视频和我们替换后的视频对比,这两个视频不同步,我们可以把这两个节点选中,右击同步一下视频啊,现在同步了,好,我们看到视频中的这个光头蛋人 被成功的进行替换了,这是今天视频的所有内容工作流,我会放到评论区里边,需要的自取。都看到这里了,要个一键三连不过分吧?
92青橙Lab 01:58查看AI文稿AI文稿
还在心疼抽卡烧积分? runnyhop 这次把满血 cds 二点零七二零 p 做到低至零点三元一秒,这波真的可以冲一下。做 ai 视频最心疼的不是一次生成失败,而是镜头明明只差一点,还要再跑一把, 每一次重跑都在消耗积分和预算。 runnyhop 这次会员活动低至二点七百二十 p, 低至零点三元每秒,这个价格的确很划算。 简单算一笔账,生成一段十秒的七百二十 p 视频,正常可能要十几块,但在 runnyhub, 按这档活动价算就是三块钱,差不多是四倍的价格差。以前做一部片的预算, 在 runnyhub 直接能做四部,这省下的可都是利润。当然,我们不能只看单价,还是要看实际出片测试一下。进入视频生成入口,上传图片,或者输入提示词,选择 cds 二点零七二零 p, 点击生成。 实测下来,它调用的确实是满血 cds 二点零无视降置版入口,人物运动镜头稳定性和画面细节都在线,不用反复增加抽卡次数。同时它还支持不排队和真人素材。对高频创作者来说, 这才是低价能不能真正用起来的关键。而且这次三毛钱的 c 档四二点零在 running hub 多个核心入口都能用。广告片商业内容可以进 r h t v 无线画布,用智能体拆需求拆分镜 ai 短剧慢剧费劲, r h story 直接拆解十万字长剧本,并把剧本 资产分镜,故事版和视频生成串起来,角色和场景会更好控。新手可以用快捷创作和 ai 应用生态套模板,已经在用 copy ui 的 人也可以直接用云端工作流调用和附用。另外你做出来的优质内容发布到 running hub, 只要有人使用,你还会有收益,这算下来成本就更低了。这波活动直到六月三十日,真的是限时简陋,如果你本来就要用 cds 二点零做 ai 视频,建议赶紧去囤。
1.2万宅不住的AI


