既梦ai怎么加负面提示词
你是不是也踩过 ai 视频的这些致命坑?提示词写的越认真,细节堆的越满,生成的画面越容易融化变形,人物穿帮,反而随手写两句能出片?做视频全靠抽卡碰运气,耗光了积分,生成的素材要么逻辑混乱,要么画面崩坏,根本没法用。 翻遍全网抄了一堆十万赞的爆款提示词,结果套到自己的视频里,照样全程翻车。到底高质量的 ai 视频提示词该怎么写? 今天这篇内容毫无保留把能搞定所有专业及 ai 视频的科学生成方法全交给你,零基础也能照着做,彻底告别抽卡式生成,次次都能高质量的出片。首先,我们要先搞懂核心底层逻辑。 想做出不翻车的 ai 视频,核心就是给 ai 简单明确精准的指令锚点,而不是甩给他一大段小作文,让他先做阅读理解,猜你要干什么。 ai 的 生成逻辑是完全跟着你给的锚点走的, 你给的锚点越精准,边界越清晰,它越不容易跑偏。反之,你写的越散,越模糊,它越容易自由发挥,最后直接翻车。如果你实在不知道怎么把想法拆解成精准指令,也可以先把画面需求告诉豆包和 tipsy, 让它帮你转换成结构化的提示词,再拿去生成。说到这,做过乙方做过剪辑设计的朋友肯定深有体会。 如果甲方给你的需求是画面主体放大百分之二,十字体统一用十六号加粗红色、微软雅黑,你一眼就懂,一次就能改到位。但如果甲方只说画面感觉不协调,字体不好看不醒目,你只能一遍遍是错,改实版都未必能对上他的胃口。给 ai 写提示词也是一样的道理,别给模糊的感觉,给精准的指令,别给完整的长篇故事,给拆分好的核心锚点,那一条能稳定出片的提示词到底要覆盖哪些核心维度? 无非就是四大核心模块,基础定调参数、分镜、持续与运镜、光影色调、音频设计。接下来,我们就用张先逃离匈牙的片段,手把手拆解每一步的写法逻辑和避坑要点,帮你彻底吃透。 第一步,先写死基础定调参数,给 ai 画好不可越界的红线,这一步是从根源规避翻车的核心。先把视频的底层标准定死,彻底不给 ai 自由发挥的空间。核心逻辑,这些参数是专业电影的工业标准。先把画质、 帧率、画幅时长这些硬指标锁死,直接就能避免 ai 生成时最常见的时长乱跳、画面机变帧率异常、唇形对不上等翻车问题。同时一步给视频定好质感基调。第二步,按持续拆分分镜,写清每个时间段的核心画面与运镜,这是避免画面混乱、人物动作穿帮的关键。绝大多数人翻车都是把一堆动作全堆在一段里, ai 根本不知道哪个时间该做什么,最后直接画面融化。正确的写法是按秒拆分镜头,每个时间段只给一个核心动作,一个核心焦点,精准告诉 ai 哪一秒该拍什么镜头,该怎么动。核心逻辑, ai 视频是持续性内容,按时长拆分后,每一段的动作警戒焦点都清清楚楚, ai 只会在对应时间执行对应指令,不会出现动作混乱、焦点跑偏、画面穿帮的问题,同时精准把控了整个镜头的蓄势节奏和情绪递进。第三步,定死光影与色调,给视频定好情绪基调。光影是画面的灵魂,直接决定了视频的氛围感和情绪走向。这一步,别只写好看的光, 要给 ai 精准的光影参数和方向。核心逻辑,精准的光源、方向、色温和聚焦区域,能让 ai 直接生成你想要的光影效果, 不会出现过爆死黑光影混乱的问题,同时用光影贴合剧情情绪,让画面更有感染力。第四步,普通音频设计,精准匹配画面情 绪。如果你的视频需要 ai 同步生成音频,这一步一定要写清楚。如果后期你要自己用剪辑软件配音配乐,这一步可以直接省略,把所有生成权重都放在画面上。核心逻辑,让 ai 去根据视频的需求精准匹配画面情绪,同时通过声音提升视频的质感和共情。最后,很多朋友肯定会问,基础孵化到设定的设定应该怎么写呢? 如果我要做剧情二创系列短片,没有现成的参考图,怎么保证每一条生成的人物场景孵化到全程统一,不崩人设不穿帮?点赞关注,下期我们继续拆解全类型 ai 视频提示词的写法,从单镜头成片到多镜连贯剧情片,手把手教你避坑,零基础也能做出专业级 ai 短片!

粉丝2.6万获赞11.3万
相关视频
 00:41查看AI文稿AI文稿
最近 cds 二点零真的刷爆全网,想做视频的人实在太多了,动不动就要长时间的排队等候。 很多人辛辛苦苦做了好几个小时,结果生出来的效果和自己预期的完全不一样,既浪费时间又影响心情。其实想做出高质量的视频,核心根本不是排队,而是提示词写的够不够精准。今天我把私藏的万能出片公式分享给大家,掌握这套写法,不用反复试错, 不做废片不白等,每一条都能直接出大片,新手也能一次成功。
222小小AI 00:46查看AI文稿AI文稿
叫什么?我没叫。不要跟我玩这个烂梗啊。你能吃苦吗?一半吧。一半是什么意思?我能吃,但不能吃苦。 如何在五分钟内用 ai 做出这种搞笑视频?详细方法,三十秒分享给你。先到极梦图片生成里,用这段提示词,四点五模型生成图片, 选择好看的超清放大,再到视频生成,将刚才的图片用作参考图丢给他。这个提示词,标红的部分不要动,标黄的部分你可以自由修改 模型,选择三点五 pro, 只有这个模型能够做出人声、对白和音效音乐,然后生成,稍等一会就做好了,再提升分辨率。搞定。好的,学会了吗?那还愣着干什么,快去试试吧。
861白石AI实战笔记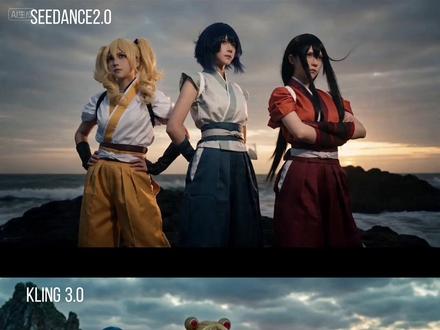 01:15查看AI文稿AI文稿
首先我们先看 seasons 二点零模型啊, 我去,这个视频是直接用提示词生成的,没有添加任何图片参考,音乐也是自动给我卡点生成的,转场丝滑自然,不得不说真的太牛逼了。但是二点零也有一个很大的硬伤,主包原本是想做美少女战士变身的效果,但是它既不支持真人照片,也不支持提示词中有 ip 词语出现, 虽然各方面的效果都非常惊艳,但是不支持指定人物和真人效果也是很让人难受的一件事了。接下来我们来看看可灵三点零模型生成的效果。 嗯,怎么说呢,家人们还是得先夸一下可灵支持真人主体绑定的功能,但是可灵是没有全能参考功能的, 这个视频我用提示词和人物三式图抽了很多次卡,根本识别不出来,最后还是先生了变身前后的两张图单独生成视频最后剪辑到一起的。不过可灵支持真人这一点就把二点零甩很远了,也有可能是主包还没有掌握使用可灵的方法。 家人们在平时使用中,你们觉得哪个模型效果更好呢?欢迎评论区一起分享讨论,我们下期见,拜拜!
1690Rec·造梦 03:40查看AI文稿AI文稿
今天给大家带来极梦 c 弹四二点零系列教学第二期一致性控制,咱们废话不多说,直接上干货教学。第一类,人物一致性控制 我们先来看第一段提示词,男人下班后疲惫的走在走廊,脚步逐渐放缓,最后停在家门口。紧接着脸部特写,男人深呼吸,调整情绪,收起疲惫与负面状态,重新变得轻松自然。 随后镜头特写翻找钥匙,插入门锁,进门之后,小女儿与宠物狗欢快地奔来迎接拥抱。室 内分为温馨治愈,全程搭配自然对话。原本这么长的视频片段,很难保证人物前后长相统一,而 cds 二点零只需上传人物参考图,直接按图片引用,就能完美解决人物一致性问题。我们来看生成效果, 可以看到男主角前后长相高度统一,没有明显崩坏,特写镜头的呈现效果也十分出色。第二类,动作一致性控制 这是一段质感极佳的舞蹈视频,我们想要附用其中的运镜转场逻辑,让镜头与人物动作精准匹配,只需要将参考视频上传至即梦,通过艾特视频指令,把原视频中的女生替换为戏曲花旦,保留原版运镜与动作节奏即可。来看生成效果, 可以看到视频的运镜转场动作韵律完全保持一致,兼具极致的舞台美感与强烈的视觉冲击力。 第三类,多图片细节一致性控制这是同一款包包的测试图,主视图与材质细节图。想要实现商业化的精致产品展示,我们可以这样转载提示词,对图片二的包包进行商业化摄影展示。 包包侧面参考图片一,表面材质与细节质感参考图片三,完整展示包包所有设计细节,搭配恢弘大气的背景音,我们一起看一下生成效果。 可以看到完整的包包商业展示片一键成型,细节还原精准到位,背景音乐也完美适配,有商品展示需求的朋友一定要试试这个功能。 第四类,运镜一致性当我们拥有手针主视角上方、左侧、右侧四张场景参考图,同时想借鉴指定运镜视频生成恐怖短片时,可以这样创作提示词, 将图片一作为画面手帧采用第一人称视角。参考视频一的运镜效果,上方场景参考图片二左侧场景参考图片三右侧场景参考图片四,即可快速生成高质量恐怖短片。 可以看到视频的转场,运镜生成的都不错, 图片场景替代的也可以有一点点小恐怖片的感觉。以上就是我为大家总结的四类一致性控制实用玩法,心动不如行动,赶紧去极梦体验试试吧!
896AI 办公室 00:33查看AI文稿AI文稿
想知道别人的图都是怎么生成的吗?千万不要再去花钱买提示词了!今天我就教大家如何用豆包免费的反退提示词,只需要一条指令就可以。准备好抄作业,请帮我分析一下这张图片,并生成一个能够指导 ai 作图工具,重新创作类似作品的纹身图。提示词 需要从主体的内容、场景设定、风格参考、色彩、色调、构图、视角、细节补充这些角度,用文字描述图片。拿到这条指令,你就可以去试试,回来记得点赞、关注加收藏,持续分享 ai 的 落地实用干货!
440Ai播哥·分享与思考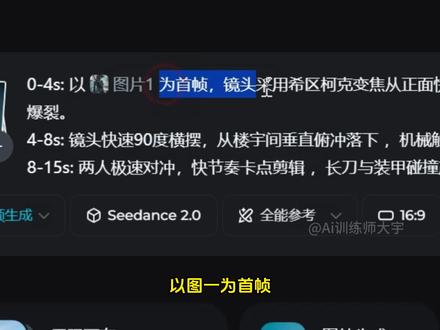 04:51查看AI文稿AI文稿
首先这不是一条广告,而是我用 cds 二点零测试的一套打斗画面。怎么说呢,嗯,我真的被吓坏了。 过去要做这么一套效果,先不说能不能实现吧,从角色设定到分镜设计,再用 ai 辅助构思动作提示词,再手动反复修改, 运气好一点的,抽个三十次就能拿到一个五秒的可用镜头,而现在一口气全都给解决了。今天这条视频,我们就一起来看一看他都更新了哪些既好玩又好用的神奇功能。 首先还是要拜访一下吉梦老师。选择视频生成,我预先设计了两名角色形象,把它们分别上传上来。选这个模型,全能参考模式比例,选择十六比九十五秒的视频, 我把题词分成了三段,第一段零到四秒打艾特,选择对应角色图,以图一为手针,用西区苛刻变焦从正面推进镜头,交代第一个人的状态, 四到八秒交代图二角色出场动作和环境。最后八到十五秒详细描写两个人的打架细节,用了什么招式,再指定一个运镜效果走你。 我们看模型,会通过分析画面质感、风格来判断他属于什么类型。这条视频很明显他理解成了是游戏画面,整个的打斗感特别像某种赛博朋克动作类游戏的效果,挥刀的动作有点慢,但是该有的特效都给到了,有点意思。 同样的原理,我们换成这种仙侠风格的图片后,效果就完全不一样了,明显感觉人物的动作更流畅,特效也更丝滑了。就单凭这个影视级音效这一点,就不知道节省了多少时间,真是越刷越上头, 咱们换个机甲的试试。我准备了三张图,分别是机甲、越野车和杀虫。同样是拆分成三段,零到八秒描述越野车和沙漠的背景,让他完成在空中变形成机甲,最后发射激光炮消灭杀虫这么个剧情。 这越野车岁数也是有点大了,变个身零件丢了一半。你别说,这机甲变身的味还真挺对,我以前试过很多模型都做不到这个效果。 仔细看,他开炮之前会有一个蓄力充能的过程,从头到尾一镜到底,没有任何多余的环节,就是最后杀虫没打爆,换成这个结尾就完美了。 这次的一大亮点是视频参考,所以我准备了一条骑自行车的视频作为素材,注意时长不要超过十五秒,否则就上传不上去。玩法很简单,还是选全能参考。注意首尾针虽然也支持这款模型,但是想要上传视频参考,你就只能用这个。 我分别上传了一张人物形象图和这条参考视频,我们将视频中的运镜和人物动作,把故事背景放在古代街头看效果, 这真是太丝滑了。注意看,我并没有指定分镜,他会根据视频参考自主设计,并且给出的地理环境和围观的这些路人的状态也太到位了吧。十五秒切了十二个镜头 放在过去,升分镜图就够合一乎了。并且我同样把主角换成熊猫,把背景设定在动物园里,用同样的一条参考视频,给出的却是完全不同的感觉。真的从来没想过 a i 还能这么玩。 我准备了一条只有两秒钟的视频,开头我让 ai 给我续写,后面的剧情延长到十五秒,然后按照我给他的剧情继续表演,看看他的演技。 哦买噶,线索是什么? c dance 二点零发布了以后傻子都会做视频了,这演技确实够浮夸的。注意,我只是提供了一个思路,至于怎么运镜和如何表演,基本全是靠 ai 自己脑补的,我甚至自己都不知道是什么效果,这实在太可怕了。 最后咱们来模仿一个动作,我分别找了五个男团演员来替换原视频中的五个跳舞的男生,题词很简单,效果更炸裂。 关于玩法真的是太多了,在这篇文档里列举的很详细,我大概一个多小时才给他看完。感兴趣的同学记得在评论区里大声喊出那三个字,咱们回见!
9.2万Ai训练师大宇 00:36查看AI文稿AI文稿
不是我以为这么简单的问题,应该全世界都知道,你还在看网上那些动不动用首尾针故事版来做视频衔接,这 些方法既浪费时间又浪费积分。我就不明白了,为什么不直接在视频提示词里面,直接让视频模型做好衔接呢?今天给大家带来一个专业分镜导演 skill, 只需要先把 skill 丢给豆包跟他学习,然后把剧本丢给他,输入这段指令。每个提示词结尾都要设计一个符合当时画面效果的转场,比如打击转场, 具体根据画面而定,它就会给你生成一个专业级 cds 二点零分镜脚本,并且会再在每段提示词结尾根据实际的画面生成一段对应的转场提示词。这个 skill 已经准备好了,需要的六六六大家可以拿回去自己研究。
 15:18查看AI文稿AI文稿
不是,我以为这么简单的问题,应该全世界都知道,你还在看网上那些动不动用首尾针注示板来做视频衔接,这些方法既浪费时间又浪费积分。我就不明白了,为什么不直接在视频提示词里面直接让视频模型做好衔接呢?今天给大家带来一个专业分镜导演 show, 只需要先把 show 丢给豆包让他学习,然后把剧本丢给他,输入这段指令。每个提示词结尾都要设计一个符合当时画面效果的转场, 比如打击转场,具体根据画面而定,他就会给你生成一个专业级 sequence 二点零分镜脚本,并且会再在每段提示词结尾根据实际的画面生成一段对应的转场提示词。这个 skill 已经准备好了,需要的六六六大家可以拿回去自己研究。 好,那我们下面再看那个生视频的这个。嗯,提示指南我们还是先看一下那个,我们的就是再具体看一下我们这个模型吧,其实我们这些模型已经是二点五了,比这个模型还会更强,但是我们可以去稍微再去回顾看一下,看一下里面的这些能力。 稍等,网上网络有点卡, ok 出来了。呃,三个模型,这个二点零主干粉呢,它能能力更强,然后 fast 呢?就意思是它速度更快,成本更低,但效果会差一些。那 mini 呢?可能就 速度更快啊,那尺寸更小,就它参数量小嘛?刚才我们不是讲过模型参数对不对?这参数越高呢?这肯定是一个是它更好算的资源,所以呢,它成本肯定更高,然后然后那个, 然后然后那个它成本高,所以收费肯定更贵了,哎,这样一个意思, 我们我们看一下吧,看一下这个图,这个图是这张,这个图我们之前见过的,我看他是怎么做出来的啊?这个是 全程使用图,视频一的第一视角构图,就这个视频呢,就这个,这里面有个视频啊,就这个视频,我只看他的构图啊,只参考构图。然后呢手针是这个图片一, 然后图片二,图片二的就是就写了各种各种提示词嘛,比如说你第一秒怎么做,第二秒第四秒怎么去做,呃,第四到六秒是干嘛?然后每个每个步骤你可以描述的比较清楚啊,最后就出了这样一个广告片,你看一下, 来一口鲜爽,刚才没声音,我们再放,再放一遍,先切现摇, 来一口鲜爽, ok, 我 们看现在呢,就是模型呢,对这个营销的产业其实冲击还是蛮大的。 然后我再给大家看看点别的吧,比如说这个对物理规律的了解啊,我们看这个场景还是非常复杂的,这个模型能理解到这个水滴怎么降落,水花怎么去,往什么方向去扩散 啊?这里设下一个专业词汇,要切镜,切镜的意思呢?就是我从镜头一切到镜头二,这里面切了好几次场景,一切到场景二嘛,你看切切切,再切,再切,再切,一切切, 然后每一个呢,其实都是一个分镜,就分镜头就分镜,就这概念, ok, 呃,我们我们找一些那个啊,这个产品的,这也是营销的,我们找一些那个慢剧的吧。呃,比如说大家看过看没看过这个丧尸清道夫啊?这个最近非常火,而且这个片子呢,已经火到油管上面了,就是很多老外也非常关注这个片子,这个呢,其实也是用 sit down 来做出来的。 sector clear, ok, 不 看了啊,还有很多啊,像央视春晚,大家应该关注过贺花神,玉峰哥,这里面很多的画面都是由 sit down 才生成的。 呃,北京电影节的 ai g c 宣传片,还有这些各种各样的漫剧,再看一个就不看了, 大家思考一下,如果说这些事情不是通过 ai 生成,通过传统方式去做的话,需要多高成分,大家可以去想象一下。 ok, 好,这已经看过了,我们我们继继续啊。稍等。 呃,我们下面去讲一下那个提示怎么写吧,同样这也分成通用技巧,然后以及呢 具体一些秘籍。通用技巧其实也是一样的,跟声图类似,只不过因为视频嘛,视频其实就是 图片加帧率组成的吗?就是它,其实就是图片,嗯,它秒钟有好几个图片在变化,所以我们看看起来是个视频流,其实视频跟图片是有很大关联关系的。然后这个公式呢,就是主体,也是一个主体, 到底是谁,怎么去运动,怎么样一个环境啊?这个环境是非必须,但是最好是有啊。然后后面呢, 这个这个生视频呢,其实多了几个,就是我运镜,切镜,这个是最好是加上啊,运镜后面会讲到底什么是运镜?运镜有推镜头、拉镜头、摇镜头、移镜头好几种方式, 然后还有美学描述,还有声音,我们都可以去写提示词,让他去帮我们去把这个视频做的更符合我们语气。 呃,这里面有些那个有几个点啊?大概是三四个,三个左右的一个点,比如第一个点是建议,是,第一个是描述必要的信息。呃,比如这一个是一个面容沧桑,身穿中世纪海盗服饰的男子 站在大海边的黑色礁石上,然后男子表情是怎么怎么样?呃,向天空有力的举起双手, 还是要写提示词,这里面有。大家说一下那个这个提示词指南呢?它实际上这个这个画面呢,是基于我们上一代的模型七档的一点五来做的,所以这个效果并没有二点零好。哈,现在如果去你用同样的提示词去做的话,二点零有更好的, 但是其实原理呢,学习知识肢体就是一样的,就我们这里面学的知识也适合于二点零,二点零会效果会更好,这也是大概有这样一个效果 啊,然后,然后这个事就就不太好。这个所有的不管文本模型、升图升视频都是一样的,写了个主角向天空举手, 展现对自由的渴望,这描述非常模糊,所以说这个模型就得就得靠抽卡率了。抽卡率指的是看概率啊,看他看那个看概率事件了,对吧?有的可能符合我们要求,有的可能就不符合,就这意思。 呃,给出画面对应的直观信息,滥用修辞,提供语域域信息也不太好,所以这个词也不是越多越好,这还是要尽可能的描述清楚。 呃,这个呢是善用程度副词,比如这里面呢,这个 it 位置呢?是图片生成视频哎, i 是 image, 然后 v 是 video 呢,就图片生成视频。 呃,这里面就是一个好的案例,就是玩偶先是缓慢旋转, 随后他停止转动,面对镜头展现自己的可爱啊,这是一个好的案例,坏的案例。怎么说呢?玩偶旋转两圈,然后他的他偏头展现自己的可爱,我们看这效果是不一样的, 这这两圈他,他是那么转的啊,咱们看这个 哇,明显是不一样的,对不对?好,这就是第一个,第一个小的一些 小的经验点,就是描述必要的信息一定要描述清楚了。然后第二个点呢,是信息要描述清楚了啊。这个你看,你看左边,这就是一个非常好的一个例子。右边这不看了,就是 赛车比赛拍摄现场画面中从左到右的次顺序是什么啊?赛车手,导演和摄影师,然后左边赛车服呢? 赛车服形象的人是赛车手,中间是青中国青年形象的人是导演,右边黑人手上抱着摄像机形象的人是摄影师啊。先告诉模型谁是谁,然后呢?再告诉他谁看上谁,说什么话, 镜头怎么运动,你看近镜头是缓慢推进的,就是镜头从远处不断往它往那个近处去推进啊,我们看这个效果, got it perfecto, 有 了,有了,这条过, ok, 你 看这个不好,就是这样子, we got ok。 呃,第三个是做精准的切镜描述,呃,切镜,呃,就是刚才也也展示过了啊。呃,我们在电影里面看过很多切镜,就是他画面不断的去切嘛,因为我不可能一部电影,我只是在一个角度去拍, 他可能多个视角需要不断去变换,这样能调勾起人的情绪啊。所以这个是切镜的意思啊,这是一个不好的描述,就是切镜时间点描述的非常模糊, 这里面写的是镜头从三层通过中景开始,然后中间男子开口说到什么什么,对吧?就就说的非常模糊。看左边正确的例子啊,就是 镜头是从三个人中间开始,从这开始切,然后中间这个黑人呢?开始说啊,说说一句英文啊, we need to clear this up。 然后接着切第二个镜头,然后第二个镜头是从左侧女子近景从这开始 再拍,然后第三镜头呢是从白人男子近景呼一口气,然后我们再看一下这个这个效果, we need to clear this up, i've already made my choice, the problem is your choice affects all of us, oh, we're。 看一下啊,这就是这就是一个非常好描述的一个时机,第一个镜头呢是拍这个人,对不对空间,第二个呢是 拍这个女,这个女生,对不对?然后第三个是拍这个男的,一般电影都是这么,有很多场景都是这么拍的, ok, 所以 这块呢还是要想清楚,然后这些知识大家一定很好奇啊,就这个知识就是不是很复杂, 那个复杂是正常的啊,这个这我刚开始学的时候其实也是一样的。然后我们在那个 b 站上有好多这样的视频,大家感兴趣可以看一下,就导演思维是怎么去做的,包括每个场景的镜头应该怎么去切,有很多最佳实践,大家可以去看。就我我这边是从那个模型视角来看,就是这个怎么样能发挥模型最好的效果, ok, 呃,然后,然后那个大家如果现在那个就对对这个,对,整个这个这道体系呢, 我来讲呢,其实也没关系啊,因为后面我们会讲那个有些工具能帮我们去把这些切镜啊,都已经帮我们更换好,然后我们可以去基于 ai 的 这个切镜再去修改,这也是一个好的思路。 呃,这里面还有还有一个点是那个切镜之间要明确的景别和内容区分啊,就是景别是什么意思呢? 咱们拍照的时候是不是有一些远景从远处拍有中 景还有特写啊?这是不同维度的,你比如说这后边就是个中景,对吧?半身,然后啊,这是个近景啊,这是个近景, 然后那个后面还可能有有有,比如说手部特写,头部特写越来越近,所以这个呢,我们还是要把警戒,警戒和内容也需要去说的更清晰一些。 ok 啊,上上面呢就是一个基本的一个那个生视频模型的一个技巧啊,大概是大概是这样子,然后我觉得,我觉得今天因为时间关系,我并不能把那个这里面比较详细的 怎么去切镜呢?然后那个,呃,景别是什么样子呀?然后镜头啊,这个我并不能 给大家完全去讲述清楚啊,因为时间关系,我们后面可以留个作业,大家可以去去看一看啊。这个镜头也有好几种类型啊,你比如说穿梭机, 比如手持的摄像头,比如华为的镜头,对不对?每个镜头其实不一样,长焦、短焦、近焦什么的都不一样,所以我们,我们是,尤其我们这如果有同学对摄影感兴趣的话,对这块应该也非常了解,做玩具也非常适合,就是我们可以把自己的摄影知识放到我们的画面里面去,让这个画面变得更更美。 就为什么好莱坞大导演的片子跟小淘房出品是不一样的呢?因为别人的这方面知识非常丰富啊。 ok, 上面就是一些提示升视频模型的提示词。
81甜糯小念 11:45查看AI文稿AI文稿
分享一组热血沸腾的 ai 运镜提示词,中距离攻击,嗨,远程攻击、 超远程攻击、 近身搏斗、 兵器缠斗,所有的这些内容都已经打包整理好,试试吧。 ok 了,同学们,给大家录一下,今天三月十九号给大家更新一下二点零的高阶人物创作,呃,这个里面包含了一些技术跟手法,大家一定要仔细看仔细 听。呃,像反推人物形象细节,反推服饰,反推发型,反推加人物结合,他会用到很多操作手法,然后我我给大家改一下授课的形式哈,因为,呃,现在目前呢,我去一个一个给你们生成。首先来讲速度达不到,然后并且练路会非常非常的长, 然后大家不是对于我直播间这种作品会比较好奇吗?这个人物模型是怎么出的吗?我可以给你们看一下,对吧?就像其中这个啊,大概是个什么样,标准真人是什么样,以及原始图片 是什么样,怎么一步一步的把最终的这个人物模型变成这样的形象,并且说在视频里面呈现出来整体的效果是比较高级的啊,我们先看一下,感受一下啊, 礼成就大概是个这样的,然后再看第二个细节一些,哎,这好像是一个视频,这个 既如此便好,今夜我素在书房,你早些歇息, 大概就是为了这样的感触。小姐,婚事是陛下旨意,你我各司其职,守好本分,互不打扰便是最好。 呃,这样的风格, ok, 然后我们了解到这样风格了以后,那么这个这个图片,它的基础模型是怎么生出来的呢?我们会用到刚才我所讲到的,呃,反推人物形象加细节,反推加服饰,反推 范型,反推加人物结合,然后我们这张角色的最终定稿图片是哪里产出的?是豆包,所以我一直在课程里跟大家讲豆包,豆包,我们自己实际实操也会用豆包,然后偶尔的时候可能会用到一些像这种国产香蕉啊,国产香蕉,但这需要额外花钱,基本的最后出图都是豆包的,你看我这个里面其实都会有一些豆包的 ai 在 里面 啊,香蕉不给大家过多介绍,因为我们香蕉都是用香蕉,九宫格会多一点,然后像人物角色模型啊,我这样来给大家讲,让你便于你们更好去理解我把豆包的整个角色的对话 啊,我把跟豆包整个说了什么样的东西,以及聊了什么样的东西,有哪些是注意事项,怎么样去做细节反推场景反推人物反推服饰反推道具反推,然后这个东西给大家分析一下,然后包括我整个生成的过程当中我的一些 啊,思路啊,以及一些啊,整体的这个叫什么呢?叫叫叫叫想法啊,都会给大家分分析出来,所以呢,我们直接看生成记录就好了啊,这个呢,课程大家可以反复的去观看观看,你像我们整个基本的这个人物生成模型,基本差不多就是这个版本 啊,基本就是这样的,我怎么做你怎么做嘛?啊,所有的文字来源都来源于这里,豆包。首先第一个这句话哪里出来的? 用我们的指令角色例会描描描的那个啊,是一模一样的,这个东西我没有说换一个什么样的工具去给大家弄没有?呃,我们去找到人物角色形象提示词,我看是不是这个啊? 啊对,就是这个词啊,就是这个角色人物形象描述词在这里整理出来,小说的原文呐,角色呀,特色,然后我可以给你们看啊,看完了之后我们来看一下整体的制作。呃,我看看是哪个啊? 青云山与吉梦婚服的照片。嗯?哪个呢?我看看啊,找找忘了呢。啊,这呢穿着分析啊,穿着分析。你看 这个里面放的是小说,然后这块里头放了一个那个指令,然后把这块又给他一个指令没生成出来嘛?根据文件二帮我提炼小说当中人物,他就会把人物提炼出来,因为我是拆分开的,我没有放在一块,我直接给他输入了一个单独的人物出现,所以这个时候会出现沈清词、 苏清婉两个角色出现,然后包括配角陛下、苏文渊。呃,夫人,这东西我们不就不详细赘述了,没有意义了啊。然后紧接着呢,我们复制的这段文案就是这个东西,就是一模一样的操作流程,他是不变的啊。 然后再次回到我们的整个人物设定,我们稍微往上来一点点就就太慢了。 ok, 整个人户设定到了,从 这里开始。这呢看到了吗?文案是一模一样的,没有变化,背景白色单人单图都是一样的。那 ok, 生成了这一版之后小说那么生成这一版人物模型,它只是叫一个基础模型 啊,只是一个基础模型,因为基础模型我们需要在不断的上面更改,因为人物角色模型呢,它是需要不断的去抠抠抠,为什么?因为你对于主角的要求会比较高,我们每个人心中都会有一个对应喜欢的样子嘛,所以他能否达到你喜欢的?有的人举个例子吧,你像男的可能一般喜欢网红脸啦, 或者说呃,国泰民安小鹅蛋脸啦,或者说小小小小鸭蛋脸啦,或者说国字脸啦等等一系列萝卜青菜,各有所爱,所以为什么很多人会觉得角色很慢?原因就在于这,你想把这个人物塑造成你心目当中完美的样子, 那么你就需要不断的去调整,生成四张图片以后在这个里面去挑,如果没有合适的再生成再挑,那么基本我一遍出来了,根据这个生成单人照背景白色对不对? 这个我就不再不给大家详细赘述了,看到了吗?豆包 ai 生成都是一样的,因为它是做着的,所以我要求的是什么叫人物站立全身图,那我这个时候再生成一个全身的图片,全身的图片生成了以后,看好了我的提示词跟指令词,这个也不叫提示词, 这个里面会涉及到一个什么问题呢?会涉及到一个所谓的配饰,那这些配饰等会我会给你们讲这些东西是哪里来的?就是你看啊,保留肌底结构,那什么东西叫做肌底结构呢?这一串的配饰啊,这一整个这串配饰就是说首先第一个肌底结构,包括硬朗 这些是不是就是我们的一些风格啊?是不是我们的一些风格,包括以及一些嗯,我们的这个整体想要的场景,那这个图片哪里来呢?是不是这样的?嗯, 对了,就是我跟你们讲,跟大家理解的是一样的,就是你需要我们一会可能会讲到啊,在这里我先简单给你描述,我们可以去其他地方,豆包,我随便去找一张图片吧。啊?我看看能不能找得到啊? 啊?有,桌面上有,然后我创建一个新的豆包,创建一个新的对话,我把这个文件,呃,上传一个图片吧,然后我这里我记得有一个这样的人物角色,嗯,这是我前两天生成的,哎,我那个人物哪去了?人物呢?我那漂亮美女哪去了 啊?我缩小一下我就找到了。 ok, 这张图片近,那么这个就是你,你可以去找你喜欢的风格,包括你可以根据你的小说去找。这段的文字来源于哪里?来源于我去解析的这个叫反推人物,其实我在前面的课程已经讲了,帮我解析图中人物三种 特色,即开始、细节、繁善。 ok, 就 这么简单一点吧。不用不用搞那么多了,你愿意简单就简单,你愿意详细就详细,这个没关系。然后我就举个例子啊,这张图片, 那么其实他会给我出啊,大概是什么样的盔甲,什么样的鳞片,以及什么样的护腿,包括腰封内衬啊。其实在反推的课程里给大家明确的讲,包括头型、配刀、足部、脚部哎,风格统一等等一系列的, 这段文字来源于这里,我直接复制。那这段的图片我在后面也会有,我在后面也会有,这儿呢,这段的图片就是这个,是吧,对不对?同学们,我们这段的图片就是这张图片,那你可以去哪去找你看,哈哈。 然后是什么呢?看着吗?肌底结构这些东西?风格,定位,然后这些东西你直接去复制,把主人物 主脸型不换哦,然后按照这些东西给你安上,能理解了吧?但是你看这个时候出现了一个问题, 我们怎么调整的?我会按照这位女子,她给我生成了,你给我整成这样了,我的上脸又没了啊,我的上脸又没了。那你看,虽然给的是全身,但是可能是上脸,没关系。来,我又换了一个指令,帮我把图二的 发型发饰换到了啊,图二的发型更换到图二,这个时候我指令稍微有点错误啊,然后他又弄了一遍,我会将图二的发型,将图会替换到图一上面。其实正确指令是什么?请将图二的配饰,或者你要求的细节,或者你要求的服装,因为 他这个环节属于什么呢?我只需要他的脑袋,我只需要他的配饰。说实话,他的衣服我不需要,能理解吗?我这就,我这叫什么? 我这叫服饰反推,细节反推。那你想要一个好的人物,你不就是得这样扣吗? ok, 他 给你扣下来了,放在这个位置了, 放在这个位置。这张图片我们就算定了,定了之后他又给你生成全身,因为他不是全身,然后此时此刻又开始变看,帮我生成图片,他也不听话,你以为我这里的听话呀?我的豆包也不听,不听话,就是不断的调整指令,不断的调整指令呗,然后发誓 图二的发式更换到图二里面。这个时候脑瓜子可能有点糊住了,又打错了。然后打错了之后呢?正常来讲的逻辑是,请帮我把图二的发式 换到图一里面去, ok, 它又生成了,生成了这样了之后,哎,整个的发式换过来我比较满意,那么我基于这张图片,或者基于哪一张图片我比较满意?将于基于这张图片,然后改成全身站立。那这种怎么叫基于呢? 怎么基于下载图片啊?下载图片,然后你再基于这张图片,你给这个图片发送上去,给参考图,参考图了之后把这句话复制给他,其实就这么简单,这个我给大家操作一遍,不然好像你们又不会了。来下载一张这样的图片,然后在这里点击参考图,然后我们上传这张图片, 上传这张图片了之后,把这句话复制下来,跟着我一步来操作,也就是说我怎么做你们怎么做,点回车就可以了,这个时候人物就站起来了,站起来了以后呢?其实我们的肌底模型,人物肌底模型已经制作完成。那看鲫鱼啊,鲫鱼,打错字,鲫鱼。上面的这个能看出来,我是手敲的 啊。上面的图片头发发色乌黑有光泽,额间配有流苏吊坠,耳朵上搭配有皇冠的一个这些东西,这些类似的话术你让我写,我也不会写,哪里产出的,还是这个解析里面去产出的。就是我们到这个里面去找到假设, 我认为它这个毛绒披肩比较好,那我能不能看这个里面识别出毛绒披肩?有啊,肩甲布有金属护甲,边缘处有白色毛绒,哎,有什么狐毛,哎,兔毛无所谓,你把这句话找到,你把你。
411太空赛车Ai(在窝煮页)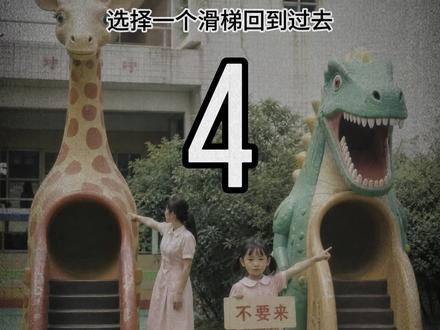 01:29查看AI文稿AI文稿
选择一个滑梯回到过去, 你不顾指引,选择右侧的滑梯。一切起初是那么美好,你回到了高中时代,但是高考已经迫近,而你已经忘记了一切。 你跟随指引,选择左侧滑梯,这是你记忆中老旧小区的楼道, 你回到空无一人的家,桌上散落着酒瓶,他们都还没有回来,你想起了自己的童年,好像无数日子都是这样度过的。 类似的二选一怀旧短片,是不是效果不错?跟我学,找到老朋友设定基础参数,视频模式,智能参考竖屏比例,十五秒老照片关健真,按照这个模板视频,按照这个模板, 你还可以改变场景或者加长时间,比如这个幼儿园场景, 最后把几段视频拼接起来,再加上倒计时和旁白就可以了。是不是非常简单,快来试试吧!
1522UE小小攸 00:36查看AI文稿AI文稿
不是我以为这么简单的问题,应该全世界都知道,你还在看网上那些动不动用首尾针故事版来做视频衔接,这 些方法既浪费时间又浪费积分。我就不明白了,为什么不直接在视频提示词里面,直接让视频模型做好衔接呢?今天给大家带来一个专业分镜导演 skill, 只需要先把 skill 丢给豆包跟他学习,然后把剧本丢给他,输入这段指令。每个提示词结尾都要设计一个符合当时画面效果的转场,比如打击转场, 具体根据画面而定,它就会给你生成一个专业级 cds 二点零分镜脚本,并且会再在每段提示词结尾根据实际的画面生成一段对应的转场提示词。这个 skill 已经准备好了,需要的六六六大家可以拿回去自己研究。
 01:52查看AI文稿AI文稿
很多人呢想做这种哎呀的短视频啊,然后呢,他又不知道这个视频的提示和啊,你像这种都是高点赞的短视频呢,哎呀做的我们打开这个视频的反推工具啊,上传你想拍的这个视频啊, 就这个视频啊,我们先看一下视频的内容,今天室外温度负五百度,到底是谁算出来的?不要, 我要不要打开五百度的?好,以这个视频为例啊,咱们完成。好,我们在这里加一句话啊,请把视频拆解,分析他的画面风格,动作描述,还有人物的台词啊,好,这个时候我们可以看到这个视频已经被拆解出来了啊, 比如说有这个场景动作描述是吧?比如说一个穿白衬衫的女老师是吧?小男孩背着书包的小男孩走进教室,这些东西都是可以更改的啊,还有说遥控器负五百度人物的台词等等。 好,咱们直接把它复制,然后打开我们的豆包啊,这里有个 cds 二点零, 把刚刚复制的提示词粘贴在这里啊,直接提交,等待几分钟看结果。好,视频已经做好了,我们来看一下生成的效果怎么样?热空调, 今天室外温度负五百度,到底是谁算出来的? 我要不要打开五百度的热空调,效果还可以啊,我们再看一下他的提示词啊,这个提示词就是我刚刚直接从那个反推那个工具里面直接复制粘贴过来的啊。
8火火AI 00:37查看AI文稿AI文稿
兄弟们,我真服了吉梦,这老六我招谁惹谁了,今天我一共就试了五六七八,好吧,也就十多次,每次都是这个,不符合规则,请稍后重试。我改 剩一半我再改,只剩一行字一张图,哎,还不行,我真想发语音问他到底哪不合规,你给我划个重点行不行?没招了,关掉重开,然后你猜怎么着?过了就过了, 你感性。但是兄弟们还有更觉得升程时长加速版七小时,不开加速六小时,你说这一小时的差距是给我留面子吗?我就想问问你们有遇到这种情况吗?
109无痕 00:14查看AI文稿AI文稿
包不好用,说明你的提示词太水了!记住这五十个润色指令,覆盖你所有的使用场景,让你秒变 ai 高手!不是工具的问题,都是你不会用,记得点赞收藏!
179朱朱说 00:42查看AI文稿AI文稿
不是我以为这么简单的东西应该所有人都知道。你不会还在跟着网上那些用九宫格场景俯视图来保持场景一致性的方法吧?最关键的点,人家根本没说零基础学着做只会浪费积分。今天分享一个很多漫剧团队都在用的 skill, 既能帮你省下大把抽卡钱,又能轻松拿捏场景和人物控制。在生成时,他会先用图片来让你看到场景与人物的占位关系,你确认后,在提示此阶段就将场景一致性给锁死, 并且会将人物占位整体环境与布局光怎么打,甚至整体色调与道具细节都给你定好,直接输出影视级的整体效果,再结合场景俯视图、九宫格图,这才是保持场景一致性的正确打开方式。使用方法也很简单,直接丢给豆包就能用。感兴趣的三个六,低调研究。
249AIGC阿凯


