本地部署大概能生成多少token
企业本地部署 deepsea 需要花多少钱?先说答案,如果只算服务器的成本的话,最低价格不到四万块钱,相对应的配置大家也可以参考一下。 当前门槛最低的 deepsea 本地部署方案,支持三十二 b 的 模型,并发量可以支持二十个左右,透更速度也有十左右,如果想要性能更高的话,只能提高预算了。比如一台四卡的四零九零服务器,可以部署七零 b 的 模型,价格大概是十几万左右。 如果想部署满血版的六七 e b 的 deepsea, 那 最低建议还是要上一台八卡的四十一克的 h 二零服务器,市场价格大概在一百三十到一百四十万左右。以上,这说的都是服务器的成本,但是本地部署的话,需要专业的团队维护, 比如硬件的调试、模型的优化、软件的更新升级、故障处理等等,运维工作人力和时间的成本可能会超预期。所以如果企业没有相对应的技术资源,建议还是选择轻量化的方案,比如选择云端的租赁机器,或者直接购买 deepsea 一 体机,省心省力还省钱。
粉丝886获赞2.5万
相关视频
 02:12查看AI文稿AI文稿
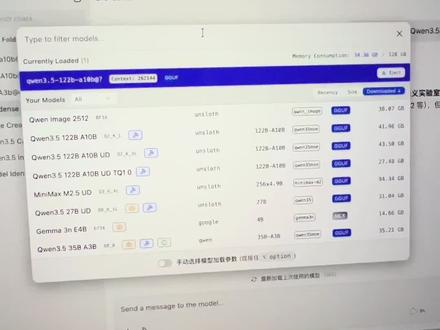
兄弟们,昨天直播的时候测试了千万三点五的几个版本的模型,今天给大家汇报一下啊,这是我下载的这几个模型,然后后面是它的大小, 首先是这个二十七 b 的, 它是一个稠密模型,它的速度在我的在机器上一百二十八 g, 这个统一内存的机器上,它的头肯是九点六, 比较慢,他思考时间也比较长。然后第二个是这个三十五币的激活三三十亿参数,然后是 q 八的 量化版本, m o e 就是 专家混合模型,然后他的思考过程也比较长,然后但是他的这个回复速度比较快,达到了四十一托克每秒。 还有一个是一百二十二币,是一百亿激活参数。然后是两位的量化版本, 这个的速度的话是二十四托根左右,但是他思考时间特别长,将近有一分钟或者两分钟,这个是一百二十二 b 参数,然后激活呃,一百亿,他这个思考时间也比较长,他这个速度的话是二十四托根每秒, 他们的这个上眼纹长度的话都是二百五十六 k 的。 还有一个要说一下,就是他的思考确实是全英文的,从这个模型的功能上看,带这种锤子的都是支持工具调用的,带这个眼睛呢表示支持图像, 带这个的话他支持啥?他支持推理,但是都会有这个 think 思考的过程,总体上来说他们的性能智商我觉得还可以, 就是主要是这个量化的位数影响了他的智商。还有一个很重要的一点就是模型的这个参数设置啊,他是他是有这个推荐的, 在这边都是有这个参数推荐你看上下文的长度,如果你要用思考模式,他是给的参数,如果你要是编码的任务的话,他给了另外一种参数, 所以有些人觉得他笨的话,可能是这个参数没有设置好。兄弟们,你们在自己电脑上测过吗?评论区说一下, ok。
450沪上码仔AI 06:54查看AI文稿AI文稿
三千元到十万元大模型家用 pc 硬件方案全解析?上一期社长介绍了纹身视频模型的硬件方案,里边讲了企业或专业工作室的纹身视频模型硬件应该配到什么程度。有不少朋友在评论区留言说,希望社长能够出一期大模型的家用消费级硬件专题, 那么这一期就满足大家专门讲一讲大模型家用消费级的硬件方案。最近 oppo colo 很 火,那什么样的配置能够畅玩 oppo colo 呢?在这一期也有答案。既然是家用消费级方案,也就是个人 pc 方案, 那么 e 五神轿、特斯拉、 v 一 百为代表的老旧服务器显卡就不在今天这一期的讨论范围内了。 ar max、 三九五、 mac mini 的 整机方案由于纹身视频能力弱,也暂时排除在本期之外, 因为毕竟作为家用消费级主机,必然是要兼顾多种需求的,跑跑大模型和智能体,生成一下 ai 视频,做做生产力工作,没事还能打打游戏,甚至新出的三 a 游戏也能尝尝咸淡,这就是本期硬件选型的基本要求。 所以我会尽量选择个人 pc 的 消费级硬件来给大家搭配方案,最低花费三千元,最高花费十万,大家可以根据自己的预算和实际需求,综合考虑自己的硬件配置。 在开始之前呢,先给大家预告一下,在三月十五号,我们会开一期 ar 大 模型私有化部署的小白培训,具体的培训内容在这一期结尾会有展开说明,有兴趣的朋友一定要看到最后。 我们知道,现在的大模型在日常应用上已经分成了上下文推理模型、纹身图或纹身视频模型,这两类不同的模型对于硬件的要求是不一样的,对硬件适应性最广的是上下文推理模型, 它对扩大的要求最低,只要显存达到一定规模,哪怕是好几年前的老旧显卡也仍然可以胜任,这就给了我们家用消费级配置很大的选配空间。 这里要注意的就是如何判断某一推理模型能不能部署,主要是看显卡的显存能不能大于模型的参数,比如三十 b 硬特八的模型对应的就是三百亿参数。按硬特八量化规则,加载到显卡里所需要的显存大约是三十七点五 g, 加上要预留 k v 缓存激活值缓冲区, 因此要运行这个大模型,我们一般是按照模型量化后显存占用的一点二倍计算。那三十币 ink 八模型就需要至少四十五 g 显存的显卡,但众所周知,内存是可以分担显卡的上下文推理模型的加载任务的,比如上面讲到的三十币 ink 八的大模型, 需要四十五 g 的 显存来流畅运行,如果显卡只有十二 g, 剩下的三十三 g 可以 加载到内存中去运行。 当然,因为内存的贷宽远远小于显存的贷宽,如果大部分都让内存来跑的话, tokins 的 速度会大打折扣,所以显存尽量还是要大一些。但对于个人来说,对于效率的要求并没有企业这么高,我相信大多数人是可以接受的,毕竟在性能和成本方面总要找到一个平衡。 纹身视频模型的门槛就要高的多了,他没办法像上下文推理模型那样,显存不够内存来凑,模型必须要全部加载到显卡里。所以如果朋友们想尝试纹身视频模型的话,就要至少满足两条硬杠杠,一是显卡要有 touchcore 支持,二是显卡显存要至少达到十二 g。 为什么呢?我们以 y 二点二为例, y 二点二 t r v 五 b 轻量版模型是一款小型可部署的开源纹身视频模型, 十二 g 以下的显存加载不了这个模型,十二 g 正好能加载,而且能够跑起来。因此呢,显存越大,扩大核心越多,显存待宽越高,视频生成的清晰度、速度、时长就相对更有优势。 于是,基于上面社长针对这两个模型的分析,我们就得出了个人 pc 如果想要同时玩转这两种模型的话,显存要大于等于十二 g。 为保证能够运行纹身视频模型,支持 touchco 的 可选型号为英伟达 rtx 架构的二零系、三零系、四零系、五零系显卡。这样我们就可以定义以下五档家用消费级 pc 的 预算方案了。 第一档,三千元。这一档的核心定位是新手尝鲜,可以进行基础大模型体验加轻度办公加普通网游。具体的配置如下,这套配置的大模型能力是这样的。 第二档,一万元,这一档的核心定位是家用主流,支持中型大模型流畅运行加高效生产地加中高画质三 a。 具体的配置如下, 这里社长推荐了四款显卡,从这一档开始, open club 就 可以畅玩了。下面就贴出这四款显卡结合 open club 加千万最新模型的畅玩区间,供朋友们参考。在这个表格里可以看到,三零九零二十四 g 显卡的性价比相对较高,畅玩范围相对更广。 这四款显卡都能支持纹身视频模型, rtx 五零六零 ti 十六 g 可以 输出七二零 p 二十到三十秒视频片段。 rtx 三零九零二十四 g 可以 输出一零八零 p 六十秒视频片段, rtx 二零八零 ti 二十二 g 和 rtx 三零八零二十 g 可以 输出七二零 p 到一零八零 p 四十到五十秒的视频片段。 第三档,两万元。这一档的核心定位是高阶家用加轻度专业,支持中大型大模型流畅运行,加多模型同时运行,加四 k 游戏加四 k 剪辑、 3 d 渲染。核心配置如下, 这套配置拥有较高的实用性,几乎可以胜任绝大多数主流需求。他的大模型能力是这样的, 第三档说完,接下来的第四档和第五档就进入高端玩家档了,如果只是纯打游戏的话,完全用不到这么高的配置。社长建议大家压抑住所谓一步到位的冲动,先在中低配置上玩熟了,确实有需要了,再上高端配置也不迟。 第四档,五万元。这一档的核心定位是旗舰家用加准专业,支持大型大模型流畅运行,加模型微调加四 k 游戏加专业级生产力。核心配置如下,这套配置的大模型能力是这样的, 第五档,十万元,这一档的核心定位是顶级家用加专业级。社长在这一档破个例直接给他上了英伟达 pro 六千九十六 g 工作站显卡,让他可以支持全类型大模型加大型模型完整训练加四 k 或八 k, 游戏加专业创作,核心配置如下, 这套配置的大模型能力是这样的好,说到这里,五档家用消费级大模型硬件配置推荐就结束了。 最后说说小白模型部署培训的事。最近有不少粉丝朋友跟社长说想要部署大模型,但又不知道怎么开始学起,所以我们打算在三月十五号开一期培训来手把手教小白,零基础上手, 核心内容包含四个板块,一是大模型基础原理与适用场景。二是不同大模型的硬件精准选型。三是本地知识库问答、自动化办公等实用智能体搭建。四是欧门可乐安装配置与私有化部署,有需要的朋友可以联系我哈!
9295单车酒吧搞机社 00:37查看AI文稿AI文稿
我是馒头,今天来和大家交流一下 ai 落地的话题。我用 ai 打造了一个量化交易系统, open c l a w, 能实现的功能特别多,这只是其中的一个。这个量化交易系统所有的界面、功能布局都能进行修改, 而且这些界面并不是我预先规划设计的。那我是怎么做的?很简单,我让 ai 自己到网上学习相关知识,从学习成果来看, ai 学到了很多内容。值得一提的是,我这个量化交易系统可以打包成客户端,这样就能分享给别人下载使用了。由此可见,未来一些简单的软件或许都可以借助 ai, 感兴趣的可以一起交流更多 ai 落地。
61馒头先森 02:32查看AI文稿AI文稿
兄弟们,你们以为安装了 open cloud, 从此就解放了双手,让 ai 替你打工是不是?那你们有没有发现每天烧掉了五百万的头,肯一个月账单就充到了五千块钱,这个呀,可不是你们的 ai 智能助手啊,这可是行走的续钞机, 烧钱的速度比我们赚钱的速度还要快十倍。那么大家今天有没有想过使用本地的大模型,要用本地大模型的话,基本上不花钱的,就消耗一点掏坑,消耗一点电费,他呢具有跟远程大模型同样的能力,同样的技能费用呢,但是天差地别。那么今天呢,我们的话 就讲一讲如何在本地来部署这个大模型,没错,就是要给大家介绍到欧拉玛这个一个本地部署,部署在本地的话,即使是网断了也可以用,它的成本的话很低,数据的话永远在本地。好,那我们开始部署吧, 我们打开浏览器,在浏览器的地图栏里面输入欧拉玛点 com, 然后呢我们就会就会进入到这个欧拉玛的这个主页,这里面的话向下拉,选择这个当闹的欧拉玛。然后呢我们进入下载页面,下载页面的话有三种, 呃,支持三个操作系统的一个欧拉玛的情况,我们选择 windows, windows 下载的方式有两种,第一种的话就是通过这个 power 里面的话,通过执行这个指令 i r m 去拉取这个下载这个欧拉玛。 第二种的话就通过这个 download for windows 下载这个 windows 版本的一个 alama, 我 们最简单的话就是直接下载这个 download for windows, 下载到本地之后呢,直接双击这个 alama setup, 点 exe 就 进行一个安装,安装过程的话是很简单的,像我们普通的这个安装 windows 程序一样的,点一次过之后的话就等待 alama 程序安装结束就可以了。 然后在电脑的右下角可以看到有一个羊驼的这么一个图标,这个就是拉莫在 nice。
3IT老农 02:36查看AI文稿AI文稿
最近爆火的龙虾,也就是 open crawl, 也叫 mobile, 它其实有两种部署方式,一种是部署在本地,它对于你的硬件其实有蛮高的要求,然后你的电脑是不能关机的。那另外一种它是部署在云端,相对来说比较灵活, 它消耗的是 talking, 有 用有收费。网速科技它是有在平台上有提供这样的服务。那希望大家听完投资热线以后可以踊跃讨论一下,你们愿意选择哪一种部署方式,又或者说哪一种部署方式更适合现在的你们? 呃,就是我有看到网速科技,你们有在边缘云主机上面上线了 mobile, 就是 现在那个 opencloud 的 镜像,对,你应该是在我们的微信公众号上看到的,是吧? 哎,对,然后我就想问一下,就是那我想问一下,就是你们把它上在云端,那他正常使用的时候要消耗这个算力的话,那我知道你们公司好像之前是不做这种算力租赁的, 那我就想问一下,你们那种算力的话,它消耗的话也是要找你们买 token 吗?这个太细节了,这个可能我也不太清楚, 但是就是我们微信公众号上我,我个人理解啊,他的意思是说就是我们可以在我们的自身的这样一个呃业务范围内提供这样一个环境和平台,然后如果用户有 有需要去使用这个 open pro 的 话,它可以在我们创造的这样一个环境中去使用这样一个东西啊,我们只是提供一个环境和平台这样一个概念,那其实跟我的理解是一样的,就是你们其实只是在云端上面让客户可以去选择去用, 那至于使用这个需要消耗的算力。但但我的有一疑问就是使用这个如果需要使用到 talk, 比如需要到算力,那你们公司又不做这个的话,那他这个也要找其他的厂商去去购买吗? 啊?这个太专业了,我可能还得去问一下那个技术那边啊,因为我们这边只是大概的就是宏观的一些东西嘛。 呃,对,主要是对信息批录这一块的,那可能偏技术方面的话可能还要再去了解一下,但是说实话作为我们这种散户来说,我们肯定是希望了解的更更深一点,你们是只要公司有这种信息,你们就正常对外批录吗?对吧? 呃,因为您看到这个微信公众号的这样一个对外的这样一个口径,然后他更多的是对于一个产品啊,包括一些最新的一些行业动态的一些分享。那么您打的这个电话呢?其实我们是针对于公司的公告的, 所以就是说一般我们是解答这个对于公司这个对外批录的这些公告上有什么一些疑问。对,好呀好呀,谢谢你哈。
100大A密探小飞飞


