opencode上下文满了怎么办
真是瞎搞啊,今天又验证了一个事情,就是省 token 是 怎么省的?如果说大家用 hermes agent 或者是 openclaw 去做自动化任务的话,那这个就不说了。如果说你是用它去写代码的话,我的建议是还是要用,不管是什么 code, 不 管是 cloud code 还是 kimi code 还是 cortex 啊,一定要用上这种专业的写代码的这种工具,它真的是很省。为什么呢?你看啊,这里 如果是我在用 promise 完成,我现在正在做这个任务的话,这早都撑满了。早都满了,你看它是每五小时刷新一次,你看这只剩三十三分钟了,我只用,只用了百分之十三,但是你看一下我做了多少任务了,看往上翻 能看到吗? 上下纹都已经撑满三次了,我都已经手动压缩上下纹三次了,恐怖吧。所以如果写代码的情况下,不要用那些龙虾呀,爱马仕呀这些东西了。
粉丝1899获赞7476
相关视频
 06:26查看AI文稿AI文稿
哎,你是不是花大价钱买了个超牛的一百二十八 k 上下纹大模型,结果呢,还是天天报错?我跟你说,先别急着骂 ai, 你 的 ai 没坏,问题八成是粗在你的配置上。今天咱们就来把这个问题给彻底解决了。 喏,就是这个报错,眼熟不眼破的 lance exceed。 哎,是不是每次看到他都特烦?刚有点思路,啪,又来了,放心,这种抓狂的感觉我懂。 或者有时候更让人崩溃的是, ai 好 像突然就失忆了,压根儿不记得你几分钟前跟他聊了啥,这上下文一断,前面花了功夫的全白费了。其实啊,这都是上下文超线的典型表现。好了,那咱们就来挖挖根源。 这个问题的核心其实在于,我们绝大多数人都误解了到底什么是输入。 来,咱们先打破一个思维定式啊,你以为你发给模型的输入就只是你刚刚打的那一行字吗?那就大错了,特错了。实际上, opencode 在 你看不见的后台悄悄打包了一个超级大的信息包裹,然后一股脑的发给了模型。 咱们来看看这个大包锅里都装了些啥?首先有那个告诉 i i 他 是谁,该干嘛的系统提示。 然后重点来了,是你们俩之前所有的对话历史,为了让他能接上话茬吗?接着还有所有工具执行后的结果,比如说,你让他读了个文件,那文件的内容也在这里头。最后才是你刚刚输入的那条最新信息, 你看,这四样东西加在一起,才是真正的输入,也正是他们不知不觉就把你模型的上下文给撑爆了。 那么知道的问题在哪儿?怎么解决呢?其实方法特别简单,就一步,在你的配置文件里正确的配置。 limit 这个东西 跟你说啊,要是没这个配置,你可就亏大了。因为 opencode 为了保证程序不出错,会给一个特别保守的默认值,可能就四 k 或者八 k。 就 意味着就算你用的是能支持上百万上下文的 gemini 一 点五 pro, 实际上你也就用上了那么一点点儿。 这不就等于你花了大价钱买了辆跑车,结果一直在市区里开,时速没剩过三十吗?好,我们来看这个表格,这里面的信息非常关键, limit 对 象里头有三个参数, context 就是 你这个模型的总容量,是天花板, output 是 模型一次最多能吐出多少字。 最重要的是,这个 input 也就是我们能喂给它的最大量。你注意看啊,官方说它是推荐配置不是必须,但听我的,这个值你必须得设。为啥?因为 open code 那 些特别牛的自动优化功能,就是靠这个 input 值来判断什么时候该启动了。 那这些数字去哪找呢?很简单,就去你用的那个模型的官网,一般在定价或者模型介绍这种页面上,都会把这些参数给你写得明明白白的,单位一般都是 tocan。 来看个实际的例子,比如说现在很火的 deepseek v 三,官方说了它有一百二十八 k 的 上下文,最大输出八 k, 那 你的配置就应该照着这个写, contacts 就 填一百二十八万千, output 填八一九二。那 input 呢?咱们留点儿余地,给模型输出留点儿空间,填个十二万就很合适了。 再来看一个更猛的 gemini 一 点儿,五 pro 那 可是一百万的超大上下文呢。配置方法一模一样, context 填上一零四八五七六, output 一 般也是八一九二,那 input 咱们就设个一百万, 你看,就这么简单几行,你模型的全部潜力瞬间就被你解锁了。当你把 limit 配置好之后,恭喜你,你相当于按下了 open code 一个隐藏功能的启动按钮,接下来它就会动用它的黑科技来帮你把每一个 token 的 价值都压榨到极致。 这就是 open code 真正厉害的地方了,当他发现上下文快又满了的时候,他不会傻乎乎的直接给你报错,而是会像一个聪明的贴身管家一样,主动开始帮你整理腾地方。 它的第一件武器叫压缩,这个功能简直太绝了,它会悄悄地启动另一个 ai, 把你们俩很多之前的聊天记录重新读一遍,然后提炼成一个几句话的摘药。这样一来,几千个头肯的长篇大论就变成了几百个头肯的会议纪要, 既保留了记忆,又省出了大把空间。第二件武器叫修剪,这个主要是用来对付那些工具返回的超长结果的。 比如你之前让他读了一个很大的代码文件,那一大堆内容可能就一直占着你的上下文。这个修剪功能就会自动把这些比较旧又触又长的输出给咔嚓剪掉,只留下最近最有用的,保证上下文里都是精华。 最后还有一道安全防线叫截断,这个是干嘛的呢?就是防止你一次性喂给他一个超大的东西,比如一个史密盖全塞进去,那肯定直接就崩了, 它会自动给你截取前面一部分,然后告诉魔情。哎,这文件太大了,我先给你看个开头,你要想看后面的,随时说是不是特别智能。 好了,说了这么多,咱们来快速总结一下,怎么样才能从一个天天看着报错抓狂的用户,变成一个能让 ai 火力全开的高手。 其实关键就三点,第一,你得知道你发送的输入是个大包裹,里面不光有你的话。 第二,解决办法超级简单,就是在 config 单调 json 文件里把 module 那 几项给它配对了。第三,这么做的少数是双重的,你不仅能用满你花钱买来的长上下文,还能白捡一套 opencode 自带的智能优化黑科技。 所以最后留给你的问题就是,你的 model limit 配置到底对了吗?别再忍了,现在就动手去检查一下你的配置文件吧,相信我,这一个小小的改动,会让你的体验好上十倍!
26忘记 18:12查看AI文稿AI文稿
open code 是 近期热度最高的 ai 编程工具,它的最大优势是有开箱即用的免费模型,通过简单配置,还能免费接入 gemine 三 pro、 cloud、 四点五、 opus 等顶级编程模型。 open code 可以 看作是一个开原版的 cloud code, 几乎具备了 cloud code 的 一切功能,而且对中国用户友好,不 会遇到 cloud code 里面限速、封号等一系列麻烦的事情。在 open code 里面有几个可以免费使用的主流模型,非常适合小白上手, ai 编程可以随便造随便玩,还可以用它练习 agent, skills, mcp, sub agent 等高级特性。本期视频是一个 open code 的 完整教程, 主要介绍 open code 的 四种形态,对比其他 ai 编程工具的亮点,还有我们要重点介绍欧买 open code 的 这个超强插件,还有等等的一系列高级用法。 open code 的 有四种形态,分别是命令行、桌面、客户端插件,最后是云端运行环境。我们先来看命令行,这里我准备用第二种方式,也就是 note j s 的 方式来安装。 我们先来到 note g s 的 首页,在这里根据自己的操作系统下载对应的安装包,把 note g s 安装一下。接下来我们复制 n p m 的 安装命令,我们打开一个终端窗口,把安装命令粘贴进来回车,这样就安装完成。输入命令, open code 就 可以直接启动了,进入这个页面打个招呼, 这样就完全配置成功了,非常简单。接下来我们来看客户端版的安装,在这个页面点击下载客户端,然后一路点击下一步完成安装。打开以后选择一个文件夹作为项目文件夹就可以直接开始使用了。 open code 的 客户端并不是一个完整的 ide, 它只有基础的对话框功能,而 而且目前处于贝塔测试版,我试用下来 bug 还是比较多的。所以本期视频我们主要还是以命令行版本为例进行操作。接下来我们来看插件版的安装。使用插件版的 open code 的 前提是需要先把命令行版的安装好,这里我以 vs code 为例,我们打开 vs code, 在 左侧的 extensions 搜索 open code, 然后我们找到这个 open code 插件,点击安装。安装好了以后,我们按快捷键 ctrl shift 加 p, 打开命令面板,敲这个命令, open open code 回车,这样就以插件的形式打开了 open code, 它可以自动关联左侧窗口打开的代码文件。然后我们还可以选中一些代码,点击快捷键, ctrl alt 加 k, 把这些代码直接快捷地粘贴到 open code 的 聊天窗口里面, 这就是插件的全部功能了。最后一个云端运行环境,我们放到视频的最后面再看 open code 最棒的是内置了一些免费的模型,我们敲命令来到软件进来以后,输入命令斜杠 models, 后面带 free 标记的都是一些可以免费使用的模型,特别是 g l m 四点七,还有下面的 mini max 二点一, 编程能力都非常的不错,零配置开箱即用,输入需求就可以直接编程了,很适合新手用它们来练习 ai 编程。接下来我要推荐一个插件叫 open code 的 anti gravity os。 anti gravity 是 谷歌推出的一个 ai 编程的 ide, 它里面十分慷慨地提供了 jimi、 nike 三 pro 还有 cloud opus 四点五这两个顶级的 ai 编程模型,我们可以借助这个插件把这两个顶级模型免费地接入 open code 里面使用,在它的 get up 首页有安装方式, 最简单的就是把这一句提示词复制下来,然后我们来到 open code 粘贴进来开始,这样 ai 就 能自动帮我们完成安装,这里耐心等待一会,这样插件就安装完成了。接下来我们复制这个命令,然后我们打开一个新的命令行窗口,执行这个登录命令。 这里的模型供应商选择谷歌,选这个 anti gravity 的 登录方式 project id, 这里直接回车,这里登录一下自己的谷歌账户, 点击登录,然后把生成的这个 u r l 粘贴进命令行回车,选择 n 回车,这样就配置完成了。我们重启一下 open code 的 斜杠 models, 在 模型选择里面我们就可以选到 jimmy nine 三 pro 还有 cloud opus。 四点五这样打个招呼成功给到了输出就配置完成了。接下来我们把另外一个好用的编程模型 gbt code 也接入到 open code 的 里面。就在前几天, open a i 跟 open code 的 官宣进行了合作, 我们可以直接在 open code 里面使用 chad gpt codex 的 编程套餐。首先我们需要在 chad gpt 的 官网获取一个至少是 plus 以上级别的套餐,在这期视频里面详细的介绍了订阅方法。我们来到 open code 输入这个命令斜杠 connect 回车,这里选到 open ai, 选择 gbt pro, 在 浏览器里打开这个链接,选择继续,这样就登录完成了。然后我们回到 open code 输入命令斜杠 models, 这样就可以选到 chat gbt 的 几个模型了,除了上面这几种接入 ai 的 方式,输入斜杠 connect 命令,可以查找到七十五种 ai 的 接入方式, 几乎囊括了所有的模型供应商。比如我们可以找到 open root, 这里需要我们填写一个 open root 的 api key, 我 们来到 open root 的 官网,点击 get api key 创建一个, 把这个可以复制一下,填写到 open code 的 里面,回车一个 open root 就 能接入市面上几乎所有类型的大模型,而且国内用户也可以很方便的获取额度,可以说我们只要接入了 open root, 就 可以使用几乎一切的大模型。 我找了一个之前常用的经典测试案例来测试一下这里 open code 的 表现有几个亮点。首先在开始之前,他会反向询问我一些问题,比如说只是要代码样例,还是一个完整可以运行的程序,有哪些功能是必须实现的,调用哪个 jimmy 模型,然后环境变量是怎么保存的, 在动手之前他会把所有的需求细节询问清楚,这点非常的不错。然后他列出了一个详细的开发计划,并且分步骤完成,每完成一步都会标记出完成。 第二个亮点就是命令行版的代码比对界面,我觉得是所有命令行类的编程工具里面做的最好的,整个编程过程没有出现错误,也没有出现过需要代码返工的场景,一次性就完成了这个需求的开发。这里我使用的编程模型是 gpt 五点二 codex, 我是通过登录我的 chat gbt plus 订阅的账号把 codex 模型接入进来的,我觉得它在 open code 里面的表现跟使用原生的 codex c l i 的 表现几乎是一致的。 open code 在 底层对各种编程模型都进行了很多工程上的优化,还是很不错的。 喷扣的里面重点突出了一个叫做 session 的 概念。我们每次跟 ai 开启的一个新的对话,就是一个全新的 session, session 可以 后台运行,而且可以多个 session 并行运行,比如这是我们刚才生成的你画我猜的游戏网站,这里我想增加两个功能, 首先我想让画笔可以调整颜色。第二个功能我想增加一个计时器,如果作画超过二十秒,游戏就失败了。我们先输入第一个需求,增加一个计时器,在第一次落笔的时候进行计时,如果超过二十秒,游戏就失败了。开始 在这个任务的执行过程中,我们可以输入 new 命令,创建一个新的 section, 然后开始我们的第二个需求,第二个需求是画笔可以调节颜色。我们输入命令斜杠 sections, 就可以看到我们触发的 session 前面一个打转的符号,表示它正在后台运行。这样我们就创建了两个 session, 让两个需求并行开发,还可以在两个 session 之间互相切换,查看它们的执行状态。好,这样就完成了, 我们可以调整画笔颜色,然后我们开始作画的时候,右上角也出现了一个倒计时,我们成功利用了 session 功能,并行地完成了两个需求的开发。输入斜杠 share 命令, 可以把这个 session 的 对话记录分享成一个网页,网页的地址已经复制进了粘贴版,我们把地址粘贴进浏览器, 就可以看到这个 session 里面跟 ai 的 对话记录,包括它是怎么进行文件修改的?有了这个历史记录以后,我们就可以很方便的把我们的编程过程跟其他的用户进行分享。输入命令 on share 就 可以取消分享, 之前的链接也就变得不可用了。输入命令斜杠 export 就 可以把对话记录导出成一个文件。刚才我又进行了两次对话,先让它把画笔默认改成红色,然后把这个提示删除。 open code 还有一个亮点功能,就是它的时间线,或者说是检查点。我们输入命令斜杠 time line 回车可以看到这个 session 里面的跟 ai 的 对话记录,我们可以选择任意一次的对话记录,选择这个 reward 功能, 把代码跟聊天内容一起回退到这次对话之前的状态,我们可以回到这个时间点再重新进行修改。 在上期视频里面,我们介绍了 agent skills 的 基础概念以及其目录结构,我们可以把 skill 理解成带目录的说明书。每个文件夹都对应一个 skill, 也就是一个技能包。 把一个 cloud code 中的 skill 迁移到 open code 里面非常的简单,我们只需要把目录里面的点 cloud 替换成点 open code 就 可以了。 在上期视频里面,我们一共创建了三个 skills 文件夹,把这三个 skills 迁移到 opencode 里面也非常的简单。我们来到 opencode 的 项目文件夹,新建一个叫做点 opencode 的 文件夹, 进来以后再新建一个 skills 文件夹,然后就可以把这三个技能直接复制进来,这样我们的项目就拥有了那三个技能。我们右键在终端打开,输入 opencode, 启动起来。我问他你有哪些 skills? 这里给出了完整回答,当我们有需要的时候,它就会调用这些 skills 进行工作。接下来我们来看 m c p。 的 配置方法。 open code 里面有两种 m c p, 我 们在文档里面可以找到一个是 local 的 方式, 也就是通过本地命令来执行。还有一个 remote 的 方式,也就是远程调用。我们先以这个 set cn 为例来把它配置一下。我们先来到 open code 的 配置文件夹,用户你的用户名 点 configure, 然后 open code 找到这个配置文件。 open code 点 jason, 来到文档站,这里把 m c p 的 这一段复制一下,粘贴过来。我先把这些多余的逗号去掉,这里填写上 m c p 的 名字,这里我就叫做 set c n 类型的话是本地,然 然后 command 这里填写命令 n p x, 后面是 shift c n, 把这一段复制过来。最后这里还有一个 m c p, 我 们打个逗号,添加上 enable, 表示启动下面没有环境变量,这样一个本地的 m c p 就 配置完成了。接下来我们再看一个远程调用的案例, 我们就以这个 context 七 m c p server 为例。我们回到 opencode 的 文档站,在下面找到这个远程调用的案例,把这一段复制一下,打个逗号,粘贴到配置文件里面来。这里类型是 remote 远程调用 url, 我 们把 context 七的 url 复制一下,粘贴过来。 在 hide 里面我们填上 context 七的这一串粘贴过来,这里它需要一个 apikey, 我 们可以来到 context 七的官网创建 apikey, 把这个可以复制一下,填写到配置文件里面, 把这个 m c p 的 名字改成 contact。 四七,我们重启一下 open code, 输入命令斜线 m c p, 就 可以看到我们刚才配置的两个 m c p, 这就是本地,还有远程调用两种 m c p 的 配置方式。 oh my open code 是 open code 上一个最火的编程插件,它本质上就是一系列的工具加 m c p 加编程 agent 的 组合捆绑包。比如在工具方面,它集成了 l s p 高级版,可以通过编程语言的语法和语义,帮助 ai 快 速理解和定位代码。 a s t 工具可以通过代码的语法术进行关联搜索。 open 工具借助多模态大模型的视觉能力,帮助理解图片还有 pdf 等信息,还有像 delegate task, background task 这些 agent 任务分配和后台调度工具。插件还内置了三个 mcp server web search 用于网络搜索, context 用于获取最新的文档。 group app 用来在 github 仓库快速搜索代码。 插件还内置了七大编程智能体,分别是希奇福斯,它是主智能体,用来规划和调度任务,先知用来做架构设计、代码评审等等。图书管理员用来查阅文献,探索者用来进行网络搜索。还有前端工程师、 文档编辑者,还有多模态等等。插件给每个智能体都分配了一个最适合他工作的大模型,比如前端工程师使用前端能力最强的 jimmy 三 pro 模型,主 agent 使用的是 cloud opus 四点五,据说这是作者花了两万四千美元的 token, 找到最适合的 ai 编程团队。 好,我们把这个插件安装一下,在它的 github 首页,这里有一段提示词,就是 install 开头的这一段,我们把它整个复制下来,我们回到 open code, 把这段提示词粘贴过来。开始安装的时候,插件会询问我几个问题, 他先问我有没有可洛的订阅,这个我是没有的,我有 gbt plus 订阅,用 gbt 去替代可洛的模型,然后问我有没有拆的 gbt 订阅,这里我选择 yes jimmy 订阅,有, 最后选择确认。过了一会,插件成功完成了安装。安装完成以后,我们来到 c 盘用户你的用户名点 config, 然后 open code 的 这个文件夹,在这里面有一个欧买 open code 的 配置文件,这里定义的是欧买 open code 的 七大智能体所用的模型,我们可以根据自己的需要来进行调节。 这里我把希希福斯的模型换成 g b t 五点二,剩下几个的模型都是作者的推荐配置了。然后我们重启一下 open code 的, 我们进来以后看到它显示的默认智能体就是希希福斯。 这个插件主要有几种用法,首先我们可以敲 at, 然后挑选一个智能体给我们干活。还有一个用法就是输入这个魔法词 u l w, 也就是 ultra work。 输入这个魔法词以后,不买 open code 就 会尽可能地调用它的一切潜能,把任务分配给几个智能体,并且并行运行, 由这个主智能体西西福斯进行居中调度。这里他询问我要什么样的网页,我们大体填一下需求,然后开始 我们看到他把任务拆分成了一个 to do list, 然后同时开启了三个后台任务并行执行,然后他对这些后台任务进行疯狂的调度。我们耐心的等待一会,等了几分钟, auto work 模式运行完毕,我们来启动起来看一下效果。一个宠物商店的应用看起来还真是不错, 界面看起来就很清新,它在没有图片素材的情况下,还尽量地用 emoji 给我们配了一些图,整个网站的交互还有动画逻辑看起来都是不错的。如果你有 gbt、 cloud 等几个顶尖模型的订阅,不妨来试一试。这个插件可以综合地调度各个领域最强的模型,完成一个很不错的编程任务。 购买 open 扣的还有一个重要玩法就是我们输入这个命令斜杠 raf 路虎就是拉尔夫循环,这个模式可以强制 ai 长时间的循环,对一个非常难的任务进行持续工作。 比如我可以要求它使用 springboard 四的最新标准重构整个项目,然后直到所有的测试用力都通过,它可以循环连续运行好几个小时,直到最终的任务完成。 刚才我们介绍了命令行、桌面板还有插件等运行环境。接下来我们看云端运行环境,这里我以 github 举例, 它的主要功能是当我们在 github 上面输入斜杠 open code, open code 就 可以在 github 云端进行工作,比如可以为我们解释问题,自动修复问题,并且创建 pr 等等。这里有一个安装方式,我们来试一下。首先第一步,先把项目上传到 github 上面, 这里还是刚才那个宠物商店的应用,点击这里的 south control public 是 branch, 这里我选择 public, 把这个项目变成一个 gitap 上面的公开仓库,点击右下角的 open on gitap, 这样我们的代码就成功上传过来了。接下来我们来到代码文件夹,把这个安装命令复制一下,粘贴过来执行。点击 install, 选择一个模型替工商,这里只能用 api 选择一个模型。然后还有两步需要操作,首先要把项目里这个文件提交到 gitap 上面,它已经准备好了这个配置文件, 我们先把它提交上去,接下来它需要把这两个环境变量填到项目里面,我们来到项目的 sightings, 然后下面的 secret and variables 这里找到 actions, 在 这里的 repository secrets, 我 们把第一个 key 的 名字复制一下,粘贴过来,对应的密钥可以在谷歌的 as studio 创建一个,这样填写过来保存。 接下来第二个 key 复制过来,还是填写相同的密钥,这样填写好了两个密钥。比如某个用户可能会在一处里提一个 bug, 说顶部导航栏 find ipad 跟 adopt null 功能重复, 应该去掉这个 find ipad 就是 这两个功能重复。在这个项目里面就可以直接斜杠 open code, 调出 open code 的 功能, 让 opencode 把这个 bug 修复一下,我们提交这个评论。然后我们来到项目的 actions 里面,可以看到这里有一个 action 就 正在执行了,这个就是 opencode 的 工作流,它现在正在 gitlab 的 云端运行,帮我们来修复这个问题。任务运行完成,我们来到 pullrequest 这里 就可以看到一个代码合并请求。在 file changes 这里可以看到它对代码成功进行了修改,我们只需要点击这个默认设置按钮,就把 open code 这次修改合并到了我们的代码仓库,这样这个一束就成功完成,并且关闭了。 接下来我们再介绍 open code 的 几个其他的重要功能,这些功能其实在之前的 cloud code 还有 codex 的 视频里面已经进行过介绍了,这里我们再快速的过一下。 首先第一个命令斜杠 inate, 这个命令可以让 ai 通读整个项目文件夹,然后把它学到的关于整个项目的知识生成一个 agents 点 m d 文件,这个文件就作为整个项目的系统提示词,可以帮助 ai 快 速地了解项目下一个重要命令。斜杠 compact 用来压缩之前对话的上下文,把之前的对话提炼成一个简洁的摘药来释放模型的上下文窗口。除了这些内置的斜线命令以外,我们也可以创建自己的命令。我们来到 opencode 的 配置文件夹,在这里面可以新建一个 com 的 文件夹,在 这里面就可以以 markdown 文件的形式来定义自定义命令。比如这里我创建一个自定义命令,叫做运行测试,我把官网上这一段样例复制过来粘贴进来,我们可以指定它是 build 或者 play 模式下面的命令,在下面的描述里面写清楚这个命令是做什么用的。 配置完自定义命令,我们可以在 open code 里面斜线,然后是命令的名字,这样就可以运行我们的自定义命令。下一个功能可以定制智能体, opencode 里面预设了 plan 跟 build 两种智能体,我们也可以创建新的。我们来到 opencode 的 配置文件夹,在这里面可以新建一个 agent 文件夹,比如这里我想新建一个 code review 的 智能体,让我新建一个 markdown 文件,在这个智能体的文件里面填上描述类型,它是一个主智能体还是 sub agent? sub agent 的 意思就是它可以由主智能体调度在后台执行,然后填上一个模型,后面是它的描述,就是这个智能体主要做什么事情。 定义好了以后,如果以后 ai 可能需要 review 代码的时候,它就会自动调用起这个 sub agent, 并且在后台运行,帮我们自动完成工作。 我们除了可以把一个智能体定义为 sub agent, 也可以定义为 primary, 也就是主智能体。定义成主智能体以后,我们可以按 tab 键直接显示地切换到这个智能体进行工作,而 sub agent 只能在后台由 ai 自动调度执行。好,这就是本期视频的全部内容了,感谢大家点赞支持,我们下期再见!
5.1万技术爬爬虾 03:15查看AI文稿AI文稿
给大家介绍一个欧邦扣的一个插件,欧邦扣的里面有很多的各种各样功能的插件,今天我们给大家介绍一个省钱的插件,动态的上下文裁剪的一个插件。因为我们在 使用这些写代码的软件过程当中,他的上下文其实是非常多的,你可以看到他有用户有回答,当然他有大量的是调用工具,所以他这个上下文都会很多。那么这个插件的功能是什么呢?他可以把 像非常多的这种 token, 它可以帮你节省下来做一个压缩,那这样一方面你压缩完了之后,你可以让你更省钱,让你的大模型在解决一些问题的速度和效率会更高,它是等于是这样。这个插件我们今天就给大家介绍一下, 看看怎么来装。这个插件叫 dynamic context 这样一个裁剪的一个插件,这个插件安装起来是非常简单的,我们给大家讲它只要是在 open code 的 这个配置文件里面,你自动的加上这样一段代码, 自自自动加上这个插件的这段代码,你启动这个欧奔扣的之后,他自动的就会根据你的上下文的实际情况,他自动的会做一些裁剪。像我这个里面原来大概有十九点三个托肯,他可以一下子帮我做压缩,压缩到二点七个托肯, 那这样我就可以在用这些工具的时候效率就会比较高,同时也比较省钱。那它的原理是什么?它的压缩的原理是什么? 它压缩它有三种方式,这第一种方式就是帮你把上下文生成一个摘要,这极端的压缩方式,把你的大模型调工具的这些内容全部删掉,这是一种压缩方式。第二种压缩方式,它把保留一部分的上下文的内容,它把你的 message 基本上都会保留下来,那但是它在工具的调用过程当中,它只是会保存一部分,它等于是只保存比如说最后的几个,那这样它也起到这个上下文这个字托肯压缩的这样一个能力。还有一种就比这个压缩更叫裁剪,裁剪应该用的最多的一种方式,就是 把错误的这个大模型调用的这样一些内容,它称之为叫 noise, noise 的 这个工具的内容从上下文里面把它给删除掉,删除掉之后,那么它也是一样做到这个上下文 talk 的 这样一个精简,那么可以帮我们节省这种算力,同时减少哦这个 talk 的 消耗。因为大模型用的 talk 也会比较少,同时它的目标需求也比较明确,相反它的效率包括它的准确率反而会提升,那么这个插件就是这样的一个东西,那么我们简单给大家看一看它这个插件到底是怎么来用,怎么来安装,我们给大家看一下 它本质它就是个配置文件,这个它在 config 下面你只要加这样一段话就可以,那么它就可以帮我们去实现这样的一个上下文的这样的一个 context 裁剪压缩的这样一个能力 还是非常简单,也不需要下载任何软件,它自动的会连上网去下载这样的一个软件,加载在你的这个上下文里面,它可以去处理,它也是有些指令的,它有一个叫这个,它有各种各样的指令, 那当然你也可以去看一下他的目前的这样一个情况,告诉你他裁剪的这个情况,他也可以去给你看,这是他的指令,我用的是一个自动的一种方式,这个就是前面讲的他手动他可以有裁剪、有压缩、有蒸馏,这多种方式他其实都是可以的。 好,那么如果大家有兴趣也可以去尝试一下这样的一个插件,他主要是在 open code, open code 的 这样的一个工具里面去使用的,去帮你减少上下文的托管。好,那这样的一个工具我们今天就给大家就介绍到这。
154小工蚁 03:40查看AI文稿AI文稿
好,大家好,我是小刘。呃,今天我们一起来聊一下在 codex 中上下文管理的一些技巧,那这里呢,我会讲我平时在使用 codex 当中,我是怎样进行上下文管理的。那我们先说一下背景, 什么上下文管理呢?就是我们知道我们在一次对话的过程当中,它的绘画窗口是有限的,可以看到这里是共二百五十八 k, 那 已经使用了三十二 k, 当这个上下文满的时候呢,扣代码,它会自动的压缩这个背景,这样呢我们的这个整个上下文会失真。什么是压缩背景呢?比如说猫和老鼠四个字,那就是我们绘画的主要内容,他会把它压缩一下变成猫老鼠,你看是不是压缩了,对不对? 但这样就会产生一个通病,就是产生 ai 幻觉,那也就是我们的功能开发会越用越不好用,你会发现你跟他说一个点,他就是不明白,然后呢会导致我们很崩溃。 那我们来看一下这个网友是怎么解决的,然后我再讲我自己的方案,他的方案就非常的简洁易懂,就我们都知道每一次对话呢,它会产生一个绘画的 id, 那 我们这次绘画它是存储到我们本地内存当中或者数据当中,这时候我们可以选择复制这绘画 id, 那 这个绘画 id 呢?本身上是一堆的这种字母,就我们扣带子可以根据这个字母找到我们当前上下我们所有对话, 他拿到绘画呢,可能是压缩库的,可能是不准确的,所以呢他就遇到了这个情况,他就把他哎复制到一个新的窗口当中,比如说新对话,这时候你看跟他说对吧?请你帮我进行这个功能继续开发是不是?那这个时候是不是就拿到了我们的青山崖纹?这个也可以,只是说开发的时候,那他需要去浪费更多的图层,因为他需要加载数据库,加一个内存,对吧? 好,首先我先说一下我的方案,就是这里呢,我会回顾一个上下文的文档,进行定期的总结。举个例子,比如说像这个绘画呢,他都满了,那我就跟他说,请你帮我根据当前这一次的绘画呢进行总结出一个 markdown 文件,这个 markdown 文件呢是包含了这一次的一些所有的关键信息,那你可以看我思路这样的,请你帮助我, 请你总结当前项目的关键决策已经完成的部分和代办事项,便于我下次听话加的一定要加这句话,如果说你不加这句话,他给你的可能就是一个总结性的文档,如果说你加这句话的话,他会按照 call 代词能够处理的绘画格式给你一个哎,一个合理的 bug 档,所以就相当于固定的一个格式给他。那如果说,哎,我这时候跟他说这句话对不对? 尽量用五点五模型,用最好的模型实现的效果可能是最好的。然后你比如说用五点五超高你发送一下,那这时候呢,他就会根据你当前的这个项目进行总结一个 bug 大 文件,那收下一次开启的时候呢,你就可以把这个 bug 大 文件哎给他 就是丢进去,然后这个时候呢,他就可以直接的进行上一次上下文的复用,而且呢失真不会失的很严重,那最起码会比直接使用 codex 压缩的方式会好一点,那这是我的第一种方法。第二个呢,就是使用这 codex 内置的压缩功能呢,这个我刚刚说过了,对吧?我们 正常来说 codex 也会进行自动压缩,但是它会进行四帧,但是进阶技巧就是我们可以直接让 codex 呢,每次都生成这个 prompt, 就是 给它设定一个这个啊, ajax, ajax, markdown, 这种,对吧?让它自动生成,而不是让我们手动去指定它。 那这里呢,再分享一下我自己的这个 codex 技巧,因为有小伙伴他会问我说,你视频当中平时使用 codex, 那 我先说我怎么使用呢?首先我不会把一个项目 丢到一个上下绘画里面,一个上下文绘画里面我会把它拆成多个小的功能,在每一个小的功能对应一个绘画,这样呢,我这个绘画可以赞成很大,并且呢它总结出一个 markdown 文件,再把这个 markdown 文件丢给一个新的绘画,这样呢,我们就基于这个功能在进行优化,不会去影响整个的大局。啊,能懂我意思吧? 那第三种就是我们可以使用外部的持久化工具,那这个外部持久化工具有很多,比如像我们之前说的 context 上来说,就是把原先我们的 markdown 给它缔造了外部的这种 社区部里面去,你可以这么去理解,然后通过一些更好的方式去把它读取到这个 collect。 那 每一个开源项目都有自己的方式,大家可以自行研究,因为篇幅有限,所以我这里呢就讲这几种,好吧。 然后呢?呃,这种方式呢?其实我还是建议大家使用 bit 进行管理起来,因为当我们用 bit 进行管理起来之后,我们整个上下文呢,能够更加有链路的去回溯,就是每一个版本都有对应的回溯, 我们能够很清晰的看到,对吧?这是我们整个流程,你可以看到通过这样的方式,那就是像上下文的这个管理,好吧,这呢是。呃,好了,那以上就是本期视频的全部了呢,我是小刘,我们下期再见。
1090程序员晓刘 05:53查看AI文稿AI文稿
我觉得现在最适合用这个 oppo 靠的模型呢,实际上可能是阿里新推的这个服务啊,这个东西叫这个扣丁不烂是吧?呃,为什么呢? 就之前吧,就是续费了好几个这种模型,然后呢?你续的不多,但它其实用量还挺大的,你看昨天晚上我就大概一个小时,我就把 kimi 的 那个十五元的 top 的 额度也就一个小时我就用光了。 我算了算,调用其实也不多,但是因为你在欧风靠的调用和你日常对话的调用是不一样的。今天我想打算试试这个阿里云百炼,简单说一下这个东西怎么回事啊?他其实就是把几个常见的这个模型给打包了,打包了以后有一个专属的调用地址和专属的 api, 来看一下它的指南。它是这样的,整合了这些顶级模型,然后还兼容主流的编程工具,就比如说我们 用的那些 id 类类的工具哈。如果你要是正常调用,他有的时候会限制速度或者限制这限制,那如果你一定想使好的模型,要么你去买会员,要么去升级,是不是他通过固定的费用?其实我算了算,应该是还是挺便宜的,虽然不至于到这个可调用的一折,但还是挺便宜。 然后它现在有几个基础的模型啊?这个千万三点五过年的时候推出的,很牛。据说啊, kimi 呢,也是刚推出不久,然后 mini max 当时那阵刚推出的时候也火了一阵。 glm 那 个五现在可以对标,他说可以对标那个叫什么来着,那个很牛的那个。 然后它有更多的就是千万三的 max 模型,这也是版本挺新的,二六年一月二十三号的,然后加上这些小模型啊,这无所谓,就是我们理论上如果你的调用次数差不多,那么你根据你的任务来选择不同的有特色的模型就可以了, 尤其是千万的这个和 kimi 的 这个都支持。图片理解费用上啊,首月七块九,其实你看的挺便宜,对不对?然后这个高级套餐呢,是三十九块九,就真的是特别便宜,但是价格上你看啊,首月七块九,次月呢是二十,也就是说他的正价是四十块钱,第一个月呢是便宜,然后第二个月呢是五折,第三个月就是正价。 呃,我猜两个月以后可能在这种东西上可能会有更多的爆发。呃,其实现在我我印象里火山就有这种类似的这种打包的这种服务,但是呢,一呢他的价格不便宜,二是他好像我查了查,他没有明确的说他支持那个 oppo 扣,这个呢是明确的说了他支持这个 oppo 扣,然后即使是最贵的这种 两百每月,那也真的是不算贵,因为你如果真的深度用了,你把两百的额度都用光的时候,那我认为你值得在这个上面花更多的钱。然后那个那天我还看到论坛上就有一个人说我除了租房子吃饭和日常开销,我把所有的钱都用来买陶坑上,哈哈哈,其实这是很有意思一件事啊,我觉得真的挺贵的。 我,我查了查我的用量限制,我觉得我用的不算多,但是其实也不算少,我其实在很多工作上都是在在那个詹妮的那个网页上去完成的,因为很多时候你要做调查呀,做一些文本的生成啊,那些东西他那个 pro 的 版本就完全能搞定了,因为我有个 pro 的 版本,但是如果按照他这个标准, 每五小时一千两百次请求,我现在是达不到的,但不知道我买了这个套餐以后会不会达到哈,我回头再测一测。那我认为新手呢,你就花七块九加上二十块钱,先用两个月, 对吧?然后当你发现不够的时候,你去升级那个就可以了,你就直接干到二百一个月呢。其实也没啥,二百块钱一个月也就是个电话费吧。我现在已经买完了, 买完了以后呢?他现在剩余天数二十八天,我不知道他为什么是二十八天,明明买的是一个月对不对?这个是不是他的 bug 按照当月天数计算的?那你们要不要搞到下个月再买二十八天?你看他是按照这个算的,上个月的二十六号到下个月二十七号对不对? 这个就不对了,这个非常过分啊,明明是一个月,所以我打算提前使光呢,呵呵。然后我们获取了这个东西啊,它有专属的 api key, 然后呢,怎么配置啊?这里面说明,我们来找说明配置, 看 open 框中配置这些东西,实际上不要被它这种东西吓到,如果你的 open 框现在正好用的状态, 你就把这段命令考下来。怎么写啊?我这就写了,我现在咱说说怎么配置哈,就首先呢,第一步就是修改配置文件,哪个配置文件呢?就是这个东西啊,但是呢,我们在 open 里可以直接跟他说,这是我上面已经配置完了,我重新演示一遍怎么配置,就跟他说修改配置文件啊, 然后呢?把这句 copy 过来啊,这这段啊,把这段 copy 过来,然后你可以把你的 apk 呢替换到这,我懒得打码,我也就不替换,放到这。然后呢?就这样呢,这个命令就搞定了,你回车, 回车以后就是我刚才的配置,那我已经配置完了,他现在就告诉我有这些可以用的了,然后同时它底下呢,还有一段,你可以直接考过来, 然后站到这,然后回时它就会自动把你这些东西都改好。看到没变更的载药就是什么呢?它其实就是告诉你默认模型变成这个,主模型 变成这个,然后移除了原先的什么什么,这些,就移除了原先其他的所有模型,然后把其他都移除了,我还有钱在里面。其中我认为比较好的几个,特别好的四个主流四个模型就是 kimi 的 二点五,对吧? g m m 五, 然后迷你 max 的 二点五,这个也不错,迷你 max 二点五。我发现他好像在写程序上更有优势。也是这样的,我的感受上啊,因为他的代码他理解的更快更好。然后这个是个多模态模型。嗯, kimi 应该是多模态吧,我记着这两个是多模态模型,如果你需要用到图片处理,尤其是处理本机的图片的时候,这两个模型非常好。 到了这步你的七块九已经发挥作用啊。至于接下来怎么用,那其实还是靠大家去想象。我之前因为这个模型的用量问题,我现在想都给他背地里的任务, 我现在都给他加回去,加回去以后我看看他这个调用的数量到底能撑多久啊?我每天会监控他的用量,我把他这个用量记进去吧, 非常好。我觉得整体来说这下就算完事了,至少我这个月应该不会特别为掏坑的续费吧?因为每次他如果出问题的话,你很难发现,除非你里面充特别多的钱。
1891赵兄休得胡言 00:58查看AI文稿AI文稿
你有没有觉得啊, open code 在 复杂工程里特别慢,还容易返工?原因很简单啊,它本质上是单的 agent 顺序执行的。 最近啊,我试了一个升级版叫欧麦 open code, 他 做了一件关键的事情,就是他把单的 agent 变成了多 agent 的 并行安装,非常简单,直接复制一句话,然后进 open code, 他 会问你有没有 clode, code, 叉等等的模型,你如实回答就好了,没有的话就告诉他全部用当前的模型, 我用的就是 kimi。 二点五装好之后,你就会发现左下角从 build 变成了希奇福斯,这是规划和调度执行的 agent。 接下来在你的任务前面加一句, u l w, 正式进入多智能体模式,它会自动拆解任务 多个 a 阵的并行执行,边做边叫验,减少反攻,对复杂的改动化文件的联动,重构场景速度和稳定性的差距会非常明显。一句话总结啊,单县城的程序员和多县城工程团队的区别。
189建斌聊AI 08:37查看AI文稿AI文稿
大家好, deepsea 发布之后,在国内外都带来了很大的反响,特别是 deepsea v 四 fresh 这个版本,又便宜又好用,那本期视频就跟大家一起来探讨一下,怎么把 deepsea 对 接到我们常用的 ai 编程工具啊, 常用的这种 ai 智能体龙虾啊,个人助手来出一个这样的保姆级教程。那首先呢,你要打开 deepsea 的 官网,然后点击这个 api 开放平台,然后去这边去进行充值, 充值完成之后,在 api keys 里面去创建一个这样的 api key, 那 输入名称,那创建完成之后,那么你就可以去接下来的操作了。那首先第一个工具就是 cloud, 出了这个 cowalk, 那 这个工具是非常火的,也是一款非常强大的一个 a 景的桌面软件工具啊,那么它可以去操控你的电脑,可以处理办公文件呀,可以处理很多很多事情。那以前呢是你必须是 cloud 会员,也就是你去注册这张会员,购买这张套餐才能去使用这款软件,但现在呢,它已经放开限制了,非会员不需要购买 cloud 的 任何套餐,也是可以去使用的。那么在安装完这款软件之后呢,你不需要去登录啊,直接去 点击这个软件上面这个 help, 那 么你在你的 windows 版本也可以找到这个,只要找到这个 help 这个按钮,然后找到这个, 那点进去之后开启这个开发者模式,开启完之后呢去重启,那重启完之后,你在这里就会多了一个 develop 这个菜单,那么点击这个,点击配置第三方的,点击之后,你就来到这里了,然后选择 getaway, 然后呢就是这个地址啊,这个地址就是 deepsea 的 这个适配这个 islopez 的 这个接口地址啊,然后把你这里的 api keys, 然后复制啊,新建一个复制到这里去,然后再往下走, 在这边 model 历史里面去添加两个 deepsea 的 这个模型啊,直接添加就行了,然后输入你这个名字,记住名字不能错, 一个叫 deepsea 杠 v 四杠 flash, 一个叫做 deepsea v 四杠 pro, 那 么排在第一个呢,可以认为是 cowalk 会默认使用的模型,这边有一个是否打开依照上下文的这样的一个配置啊,你一定要选上,就是选上和不选上差别是非常大的,所以这个一定要选上, 选上之后呢,点击确定,然后再重新退出来,那么你就可以在这边回到我们的这个界面里面去,那么你就能看到这里 database 啊,有普通的,有一兆的,有 pro, 那 么也有 flash, 那 么它这边就会去调用,那可那客户可能干什么呢? 它其实是一个非常标准的一个桌面软件的这种 a 景的工具啊,它能去访问你的电脑, 然后能够去搜索这样的信息,能够编程,能够处理文件,处理 word 文档,处理 excel excel 文件,那整个界面操作是非常的方便和丝滑的,所以说现在它放开了,不需要去购买会员就能用, 非常推荐去下载去使用。那第二个呢,就是我们常用的这个 ai 编程工具 curl code, 那 这边非常推荐使用这个 cc switch 来配置啊,这样的话我们有个这样图形化的配置,那就非常方便了,那打开我们的 cc switch, 然后的话你要如果你没有,你是第一次啊去创建这样的 deep seek 的 这个节点的话,那么你就在这里新增,然后选择这个 deep seek, 然后呢这边输入你这个 呃这个 api key, 然后这边它是有一个完整的一个呃这个 isopic 这个接口的,所以不用管。最最重要的是什么呢?我们来可以看一下,因为我们的 dbc 是 支持一兆上下文的,所以你在这里配置的时候一定要加上这样的中国号,里面有一个 em, 就 一兆, 然后这样去配置,不然的话它会默认是两百多 k 这样的上下文。然后这个 hack 模型的话,你就选择 flash, 因为它要求的是速度快。 然后这边配好之后,你就可以打开我们的 qq, 那 么你输入这个 context 了,那么你就能看到这样的一照上下文就配置成功了, 那这个是非常爽的,你能感觉到你的上下文是增加了非常多。接下来就是 open code, open code 也是一个非常知名的开源的 ai 编程工具啊,那目前呢用的人也是非常非常多,而且它支持非常非常多这样的模型啊,可以去自由去搭配。那么你安装好 open code 之后,然后使用 open code 来启动, 启动完之后呢,你只要输入一个命令,就是 collect 这个选择 deep seek, 搜索 deep seek, 那 选择那输入这样的 t, 比如我随便输一个 t, 那 么它就会让你去选择是这个 v 四的 fresh 还是 v 四的 pro, 那 么你就选择一个这样的一样的一个模型就行好了。如果你是专门用来编程的,还是处理比较复杂的任务,那么你就可以用 v 四 pro, 如果你是 用来,比如说去查询网络,网上的一些信息啊,去做一些文档的一些整合啊,这些东西比较简单的,那你可以完全可以用 windows flash, 那 这个价格是非常便宜的,那这边的话,它是没办法去选择这样的上下文长度的,应该它会使用默认的这个上下文的长度。 那接下来就是类似于 client 这种,就安装在 vs code 里面,作为插件形式存在的这种 ai 编程这种小工具,那么也有非常多啊,比如说 klein, 比如说 lu code, kilo code, 那 么都是非常知名的,当它们的配置呢,都是大同小异,所以呢,我取了 klein 这款目前最流行的这个 ai 编程工具,来做一个这样的配置的讲解。那么安装好之后,那么你可以看到在这边,然后点击设置, 然后这边的话有一个注意点,就是我们选择的是 open ai 适配,就是我们的接口是适配 open ai 这样的一个格式的,那么 deepsea 呢,提供了两种地址啊,一种叫做 open ai, 就 适配 open ai 是 这个地址,那适配这个 osmico 是 这个地址,所以说大家一定要区分开来, 那么我们选择的是 open i, 所以 我们输的是适配 open i 的 这个地址,然后输入你这个啊 api key, 然后在这里的时候特别注意啊,因为它默认是没有这个 deepsea v 四模型,那么你直接输入进去就行了,它是可以自定义配置的,那么你就可以 deepsea v 四 啊,比如说 pro 啊,弄完就行了,弄完之后呢,你一定要记得在这边去配置这样的一个上下文的窗口的长度啊,那这边你输入这个数字,那就代表的是一照这样的上下文,那么你如果不输的话,它默认不是一照, 那么你输完之后,你就可以看到在这边的话有一个这样的上下文的这样长度啊,这边一照,那么你用了多少,那么就会有一个这样的比例,所以这就代表了就说啊,我们是配置这样的一照的上下文,接下来就是两个这样的个人助手啊,一个是 open curl, 那 opencll 的 配置的话也是非常的简单啊,这边的话只要你黏贴这样的命令,然后如果你安装好了这个 opencll, 你 直接可以输入这个,那它会进入一个这样的一个配置的界面,然后你这边的话,他问你要不要继续,那你就选择 yes, 然后这边选择这个 quickstart, 那 这边有提供这样的 quickstart 的 这个路口,选择这个, 哎,那么你就它就会让你输入一个 key, 那 么你这边就输入一个 key 就 行了,它会加载一个默认的这个模型啊,你就可以去 啊,配置这边的话,因为我已经配置过了,那我会选择这个,就是让我它来再配一次。这边的话,你就可以选择输入你这样的一个模型啊,它默认会推荐是 dsp 和 v 四 flash, 如果你要用别的话,那你自己手动改一下 v 四 pro, 那 保存一下就行了, 那这样就就起效果了。那最后一个呢,就是最近比较火的个人注社哈密斯,那么这个的配置也是非常简单的,只要输入哈密斯 model, 那 就可以,只要输入这个命令,它就会开启这样的模型配置,那这边的话我们可以看到有 deepsea 这样的一个这样的选择,你只要选择之后, 然后这边的话要求你输入这个地址,那这个地址其实就是我们刚刚说的这个 openai 的 适配地址,那你点确定, 那这边的话会让你选择是哪个模型,那么你可以选择这个,选择完之后, ok, 那 你的默认的模型就发生了变更。如果你要配置 黑米斯里面其他的一些,比如说压缩的一个模型的话,你直接在黑米斯对话框里面让它去变更哪一个功能的模型就可以了,因为这个 v 四 flash 其实特别适合干这种 又便宜又脏又累的活的这种模型啊,可以让他去配置这样子。那么以上就是呃,把 dbic 配置到我们经常用的 ai 编程工具和常用的制型体的一个这样的教程了,那其实配置的过程是非常简单的, ok, 那 本视频就到这,希望这个视频对你有所帮助。
1090随风 00:37查看AI文稿AI文稿
抢不到扣丁 plus 用来编程的啊,可以看看这个叫 open code, open code 它里面有的购套餐,专门是用来编程用的。原来我一直不推荐它是因为它模型不够全啊,最近我发现它新加了 glm 五点一,并且啊,还有千万三点六, 首月只要五刀,剩下每个月估计就是人民币八十块钱,目前来看比较划算啊。并且最重要的是,现在基本上所有的大厂的模型都在卡,白天高峰期都会卡顿。 这个呢,就是专门用来编程的,不可能用来养小龙虾啊,所以卡肯定是不存在的。如果你实在找不到地方或者抢不到 coding plan, 我 觉得可以试试这个方案啊。 open code。
535互联网老实人 01:07查看AI文稿AI文稿
分享一个 kol 的 小技巧,在你这个 kol 的 code 里面,使用第三方模型的时候,比如说 deepink 四 v 四 pro, 它明明是有一千个 k 的 上下文,但实际上这里它只会写成两百,为什么?因为 你的这些第三方模型的 kol 它不认识,它并不知道你的上下文是多大,所以它默认都是给两百,直接切成两百,这样的话你问一个问题就能耗掉接近五十,你这个一个对话 基本上四五个问题,他就要被墙压住了,那肯定是很不爽的,那怎么办?有个小技巧,其实就是你要选择模型的时候, 你要跟他讲你的上下文长度是多少,那怎么讲呢?他是这么约定的,你后面跟个中括号就这样子, 如果你是要改成三百 k, 你 就改成这样子,如果你要一千个 k, 你 就直接写成一个 m 就 行,这样子他就会被识别的一千个 k 就是 一个 m 的 上下文, 这样的话,你记在这个里面,可以完整的问他几十次问题,五十次问题,他才会触发上下往下缩,这样的话你的这个使用的会很舒服。对,就这么一个小技巧,一分钟教给大家。
432教你宇宙级AI编程 00:46查看AI文稿AI文稿
windows 或者 open 格式,平时用 browse 这个 skill 去抓网页,是不是有个特别麻烦的问题?很多网站是需要登录的,比如小某书啊叉呀,或者是一些后台系统等等。 每次跑任务,它都会重新开一个新的浏览器环境,登录菜没了, cookie 没了,又得重新扫码,真正浪费时间呢。不是抓数据,而是反复登录。其实解决方法非常简单,只要是一句话,你只要在对话里啊。不是抓数据,而是反复登录,其实解决方法非常简单,只要是一句话,你只要杠杠 browse real 模式, 它会调用你本机真实的浏览器,之前登录过的账号,绘画信息,权限信息都会直接附用,不用登录了,体验是不是完全不一样?很多人觉得访问浏览器的 skill 太笨,其实不是它笨,是模式用错了。
5981建斌聊AI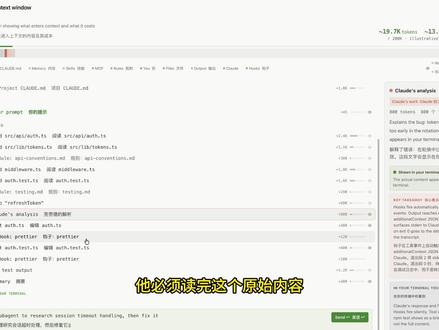 04:13查看AI文稿AI文稿
经常用 cloud code 或者 codex 这类 coding agent 的 朋友,应该都会挺关心 token 消耗和上下文管理这两件事情,但我发现哪怕用了一段时间的人,对于让 agent 做什么事情会消耗 token 这件事认知偏差还是挺大的。所以今天这条视频就给大家讲清楚两个事情,第一个是 token 和上下文 context 到底是什么意思。 第二个也是最重要的,让 agent 做什么事情是会消耗 token 的, 而哪些其实根本就不消耗,也不占用上下文。刚好 cloud code 的 官方其实做了这样一个特别直观的交互式的界面,把你从打开 cloud code 跟它进行多轮对话的整个过程中,它的 上下文是如何累积的,然后每条指令它消耗多少 token 全都非常清晰地画了出来。下面我们就顺着这个界面把这件事情讲明 来。首先就是在我们输入第一条消息之前, agent 它的上下文里面其实就已经被装进去一堆东西了,这里就包括系统的提示词,这个是 histogram 官方写的用来约束 cloud code 行为的一些固定指令。然后是 memory 文件,是之前你看 cloud code 的 绘画里面 agent 自动记下来的一些 笔记和记忆。然后第三个就是环境信息,包括当前的目录、操作系统 get 状态这些,还有 m c p, 还有就是我们非常熟悉的 skill, 还有 cloud 点 m d 这些 map down 文件, 这些都是固定成本,只要你打开一个 cloud 的 绘画,哪怕你一个字都还没有说,这些出土化的上下文就已经加载好了。那从我们发送第一条消息开始,托管是怎么一步步消耗的?这件事情我们站在 agent 的 工作流程的角度来看,就会特别的清楚,你 输入一个任务, agent 会首先理解你的指令,你的提示词本身就成了上下文的一部分,然后他会,然后他会触发绿的命令去读上下文的一些文件,读完他可能会做一些思考,思考完之后可能又会调用一些工具去读一些新的文件,或者跑一些命令去拿输出, 然后再基于得到的结果继续去做思考,这样进行反复多轮,最终他判断任务完成的差不多了,需要你的介入了,就会给你输出一条摘药返回给 给你。把这个流程总结一下,其实 agent 在 你输入完之后干活的其实就这四件事情,第一个就是去读你项目里面的一些文件,第二个去跑一些命令 或者执行一些工具来拿到一些对应的输出,第三个是进行一些思考和推理,第四步就是把摘要总结输出给你,这四件事情产生的所有的内容都会消耗 token, 然后进入到 agent 的 上下文里面。 那么讲到这里有两个事情是我觉得新手比较容易去误解或者搞混的点,这里需要重点去讲一下。首先第一个点就是跑命令本身是不消耗 token 的, 举个例子,你让 agent 把一条两个小时的音频转成文字,或者让他跑爬虫去抓取各个社交媒体上的数据,只要你有现成的脚本或者写好的 skill 让他去执行。这个执行过程中用的是你电脑的算力, agent 本身并没有去参与,所以这个过程哪怕很复杂,跑了一两个小时才跑出一个结果,也不消耗任何的 token。 只有当这个脚本命令执行完之后, agent 真正开始要去读这份结果文件,比如说你让他翻译这份文字稿,或者是基于爬虫的数据去提取观点等等,他必须读完这个原始内容才能开始干活,这个时候才会真正地去消耗 toker。 单纯的脚本执行过程中,无论跑了多久,他都是零 toker 消耗的。 toker 消耗只发生在 a 件的, 去读你的执行日制或者结果,这是我觉得新手最容易搞错的地方。那第二个点就是说,我们去在任务过程中去挤起用子代理的一个情况下,也就是 sub agent 子代理他执行的过程中,我们可以看到他本身是会消耗各种 token 的, 但他消耗的 token 是 累积在子代理自己独立的上下文里面的,不会污染到我们这个主体制。等子代理只是读到这样一份招标文件是消耗 token 的, 所 所以此代理是一种隔离消耗的方式,你让他干一堆需要读大量内容的活,但是主代理的上下文并不会因此受到污染。总结来看,我觉得官方的这个交互式页面真的非常的直观,浅显易懂。如果你对于 cloud code 的 上下文机制还不是特 特别清楚,我非常强烈建议大家去这个页面玩一下,你能够非常清晰的看到 agent 的 上下文是怎么加载的,然后 token 是 在哪些环节去消耗的。有了这个直观感受之后,以后你跟 agent 的 对话,让他干活的时候,就能比较准确的判断哪些事情真的会在消耗你的 token, 而哪些事情看起来可能很复杂,但因为只是脚本 或者命令在跑,其实根本不会消耗多少 token。 ok, 这期视频就讲到这里,如果大家觉得有帮助的话,帮我点个赞,我们下期再见!
41新也诚🦞 01:34:38查看AI文稿AI文稿
cloud code 架构解读,这个其实会稍微有一点点的这个小小的这个难度啊,但是我们会尽量的在今天晚上这个讲解过程当中呢,把这个难度降一下来进行一个讲解的介绍啊。因为 cloud code 它作为目前可以说全球最顶尖的 agent 架构,它底层的原理其实非常非常复杂,内部的这个架构呢,也非常非常复杂, 对吧?源码出来之后总共又是五十一万行啊,这样的一个很大的这个项目,虽然里面其实会有一些这个技术债在里边啊,但是其实不是很多 啊,整个源码的这个结构还是非常的这个紧凑,然后效率也是非常高的啊,所以我们才有说围绕他这个内容来进行解读的这个必要。我们今天晚上在课间里边有一个百度网盘,网盘里面就包括包含完整的 cloud code 这个项目的这个源码啊,然后呢我是给大家准备了两个 啊,一个叫 beautiful 杠 folk 的 一个原码,还有个 collection, 这两个原码像这个 beautiful folk 啊,直接打包运行,就可以直接去在本地运行一个 cloud code 啊这样的一整套原码。然后这个 collection 呢,实际上是一些更加零散的啊,一些这个原码,下面有非常非常完整的这个原码参考说明哈。大家这个领取原码之后呢,可以自己去看一下啊,这个呢是 它的这个完整这个原码,但是呢它因为它这个原码有五十一万行啊,所以呢,如果你想呃自己从头去进行这个开发啊,或者是自己来进行打包的话啊,也可以试着来进行一些这个运行啊,当然我们说如果你只是去用 clock code 的 话,那么拿它的原码或许没太大用啊,但如果你是想 去参考 clock code 的 这样的架构,然后来进行二次开发啊,那这个原码可能就很有用了。对于 clock code 来说,它总共是五十一万多行的这个代码,其实它的这个项目体量呃是非常大的一个这个项目哈, 那么在五十一万多代码里边,我相信可能很多同学就会比较感兴趣啊,那他什么这个代码会比较多呢?对不对啊?那个是不是调用模型代码会比较多呢?啊?构建一个 a 政策让他能够顺利调用工具代码比较多呢?还是用于去构建上下文的啊?这个代码比较多呢?还是要内置工具的 使用代码会比较多呢?还是他的这个内部的 skype 代码会比较多呢?那么同学其实会有这方面的这样的这个想法,但实际上啊,我们如果去看 clock 它完整的这个代码体系的话,那么你会发现它里边啊,只有不到百分之五的这个代码 是用于去给你构建一个完整的这样的一个 agent 啊,就是啊,大模型啊,这个调用某些工具啊,然后呢给它写成是一个 look, 对 不对?对不对啊?这个 agent 运行时嘛,一个这个循环,它会不断地调用这工具来完成对应的这样的一个这个工作,它里边啊,总共是只有不到百分之五代码是去写这些东西的, 剩下所有的这个代码,其实基本上全部都是 harness engineering 啊,就是我们呃上一场公开课讨论的这个内容啊,所谓这 harness engineering 要指的是它这里面基本上很多很多代码都是为了 如何让一个 agent 更加稳定,长期稳定啊,这个并且能够非常好的理解用户意图来进行一个这个运行好的,但这个其实对于现在我们在进行 agent 开发的很多同学啊,甚至是对于比如说啊,像 long chain agent school 啊,这些 agent 的 开发框架来说,都有非常好的这个借鉴意义啊,因为其实啊, 现就是呃大模型技术发展到现在,你会发现让一个模型会调用工具啊,会多用调部工,呃,会多部调用工具对不对?会一边思考一边调用工具等等等等啊,这个事情其实已经不是什么特别难的这个事情了啊, 包括现在大魔仙本身上下纹也很长啊,然后呢,工具识别能力也很强啊,在这样的情况下呢,你要去定义一个 agent 的 loop 啊,一个运行的这个循环啊,其实非常简单,你让它调用各式各样的工具,其实它也都也能够也都能够来进行很好的调用,但是呢,难就难在 很多复杂的工作,你怎么让 agent 去做呢啊?很多需要长时间啊,来进行运行的这个事务怎么样让 agent 去完成呢?很多需要非常非常长的上下文,长期持续专注去解决某些问题啊,怎么去交给 agent 来进行运行呢?这个其实才是现在我们在去使用 agent 的 一个非常大的一个难题。 那所以哈,我们前段时间公开课讲的 harness engineering 啊,这个驾驭工程啊,就指的是,哎,我们现在呢是要需要给当前的 agent 更好的一些 约束对不对啊?约束好了之后,他才能够长期稳定的去完成某一些这个工作,这其实是一个架构的这个理念。而在 cloud code 他 这次泄露的这个原码里边,我们就能够非常好的看出啊,他的这个驾驭工程是怎么做的啊?所以啊,我们 这次的 cloud code 这个原码的个泄露啊,也有很多技术人觉得说啊,这就是一个非常好的一次这个驾驭工程的落地实践的这样的样板啊,值得好好学习。 我们都知道在 a 证的运行的过程当中,其实需要他如果需要长期运行的话,会有很多很多很多问题的啊,比如说什么上下文越来越大, a 证的越迟钝,然后关掉就失忆啊,然后这个重开的 之之前的这个所有的这个记忆全全部都没有了啊,然后呢,比如说他的安全性的这个问题,对不对?然后比如说他的在伴随着运行的过程当中啊,他的这个实际的运行成本是限性增长啊,并且呢他其实会有个海量的啊,这个知识方面的这个商增啊,非常迅速的这个知识方面商增的这样的过程啊, 那么这些结都是会去影响一个 agent 的 长期稳定来进行运行的这样的一些这个不利的影响因素啊,那么其实从 code 完整的架构里面我们就能看得出来,哎,他呢是怎么去考虑解决的啊?解决这个问题,那么其中呢,既有一些 我们现在通用的啊,知道的一些这个解法的代码层面上的实现啊,同时呢他也会有一些啊,这个我们可能之前不太了解啊,甚至都没有听到过的 一些这个方法啊,来进行这个实现,等等等等啊,那么我们接下来在接下来的课程里面都会来进行一个这个介绍,那么这部分工作之所以会非常有价值的一个原因啊,其实也是因为大冒险本身啊,他的这个模型或者这个算法 导致的他本身运行的这个不确定性。那么我们在使用大模型的时候啊,其实经常啊,大家会觉得说啊,我们运行一个同一个任务,运行多次,他的结果不一样,我们在使用大模型的时候,很多时候都是在类似于像绝经的这样的过程,哎,他这次运行效果好了, 说不定啊,我们就有很大的这个用处,那这次运行效果不好,我们可能很可能很多时候甚至希望他多运行几遍,那至于这样的场景,我们当然是希望大冒险每次运行都能够长期稳定的,对不对啊?运行的这个很好啊,所以这才是所谓的这个驾驭工程的这样的一个啊,他的核心的这个出发点啊,跟现在这套技术最有价值的这个地方啊, 当然如果类比,比如说现在很多的一些这个啊,视频啊, ai 生成的这个视频的这个领域,它现在不仅仅是说啊,在在在什么这个提示方面会有些优化啊,甚至还出现了类似于这个抽卡这样的个流程啊,就同一个 场景啊,同一段故事啊,他可能会生成很多遍啊,然后你去找那些生成效果最好的那样的一些这个内容啊。当然我们想,如果你可以通过驾驭工程啊,假设类似这样的场景能够让当前这个 a 阵子长期稳定的去生产对应的这个结果的话,那么其实这个过程中间你要省去的成本或者提高效率就非常的可观了。 所以这就是我们接下来啊,需要去看现在的 cloud code, 它的这整个架构,或者我们通过今天晚上这样的一个学习啊,最后能够收获到的啊,最可贵的这样的这个知识和内容。哈哈,好,那么接下来我们就来看看啊,现在的这 cloud code 的 整个的这个架构啊,长什么样啊?以及呢,我们怎么样去啊,它,它是怎么样 很好的去引导当前这个 agent 长期稳定高效的就产出基金的这个内容的,对不对啊? ok, 好, 那么首先哈,我们会先,我们会先从一个 很简单的一个这个代码,呃,一个这个 demo 入手啊,跟大家来进行一个讲解的介绍啊,这也是考虑到我咱们今天晚上可能有一些呃,之前零基础的这个同学啊来听课, 那证明我们学上是借助了一个项目啊,叫 learn cloud code 啊,这个项目啊,这个项目其实是一个大家如果想要去深入学习 cloud code 的 每一个技术细节的话,一个非常不错的一个,呃,之前是一个逆向 去拆解 clock code 的 一个这个项目啊,然后现在呢, clock code 的 原码卸灭了之后呢,这个项目也火了啊,因为他很多之前对 clock code 的 一些这个猜想是对的啊,呃,大概猜对了三四层吧,啊哈哈,剩下的都都 不太对啊。然后呢,在这个项目里边其实有很多的一些围绕 cloud code 的 一些基本的底层功能的一些 demo 级的这样的实现啊,所以呢,我们接下来呢,在进行运行的时候呢,也会采用啊这个项目里边的一些这个代码给大家来进行演示啊,就是出于一个教学或者零基础理解这样的场景下,哎,我们看看 agent 是 怎么运行的,它会有什么样的问题,以及如何来进行解决 好,那么首先哈,我们需要知道当代 agent 在 进行运行的时候,其实它的这个呃整体的这个运行逻辑或者核心股价其实非常非常简单啊,就是一个呃能调用工具的这个大模型啊,加上这个 c m d 命令行工具啊,基本上就构成了我们现在看能看到的所有的 agent 最核心的这个股价。 那么所谓的这个 cmd 命令行这工具哈,它呢,实际上啊,就是一个这个 tour, 对 不对啊?这就是一个工具啊,然后呢,这个工具呢,它可以操作你当前的环境这个命令行,然后你只需要给它输入命令,然后它就可以自动来进行执行,你可以这么来进行理解就可以了。那这个工具之所以会成为当代 a 阵的最为核心的这工具, 大家想一想嘛,啊,你用这个 openclo 是 不是你动不动让它什么生成个文件啊,这个整理个桌面啊,啊,做这个事,做那个事啊,阅读下自己的这个记忆啊,修改自己的记忆啊,它背后怎么来进行的,基本上都是靠 这个命令行来进行实现啊,命令行就是操作你当前这个电脑最为核心的这样的工具啊,那么呃这个呢,是第一个,那么命令行工具在上面这个项目里边啊,回大家可以自己 在我们的课程的课间里面能找到哈这样的这个项目,然后里面有这个代码啊,让大家看一下啊,命令行工具,一个典型的命令行工具定义长什么样?然后同时呢啊,关于这个核心的 agent 在 运行的过程当中,它的核心功能其实都是通过一个叫做 agent loop 的 这样的工具来啊这样的一个形式来实现的啊,稍等 大家课间放大一点。然后呢,所谓啊这个 agent loop 呢,它呢实际上就指的是我们在进行调用的时候啊,啊,在大模型的工具的这个时候啊,基本上它就是属于一个啊 循环的这样的状态啊,那么这个循环它循环的是啊,我这次在进行工具调用啊,在这个看它能不能成功啊,如果成功了的话,我们就退出这个循环啊,给用户一个答案啊,如果成功了的话,我们就退出这个循环啊,给用户一个这个循环啊, 当然我们一会去看 cloud code, 它其实也是哈,那这个它里面这个源码其实也是一个这个 loop 啊,也是一个循环这样的概念。那么现在为什么啊?这个 agent 运行的这个核心本质上就是个 loop 啊,也非常重要的原因是因为现在的大模型性能都非常强 啊,如果是早几年的这个大模型啊,比如说二四年的那个大模型啊,那个时候呢,大模型这个不说调用工具稳定不稳定吧,如果你是把它放到一个 loop 里面来进行这个循环的话,那它就完蛋了哈,因为它根本不知道自己什么时候该停下来, 但是呢,对于现在当代大冒险来说,他其实都会有个非常清楚的这样的一个认识啊,一个呢是对用户的意图更加深刻的这个把控啊,那么除此之外呢,他也有一套自己啊非常清晰的去判断,关于说,哎,我现在运行到这个什么程度,或许需要停下来啊, 这样的一个这个状态啊,所以呢,基本上核心的这个 a 阵,它都是在一个 log 里面来进行运行啊,就是不断不断不断的尝试这样用各式各样的工具啊,去完成当前用户的提出这样的问题啊,完成了之后呢,就跳出这个循环啊,或者失败了很多次之后,觉得自己没必要再试了,也可以跳出这个这样的个循环啊,否则就一直在循环里面来进行。 那么有了这个 log 啊,然后呢又有了这个命令行工具之后啊,那么接下来啊,我们说你的这个 agent 啊,就属于一个基本成型的这样的一个这个状态啊,因为它可以持续不断地调用命令行,去完成各式各样这个操作啊,当然这个其实也是 cloud code 啊,里边核心源码的这个部分啊,这里面大家如果感兴趣的话,可以在这个 呃, beautiful s r c 的 那个文件里边能够去找到它完整这个源码啊,然后呢,这部分的它的内部的 agent 运行的这个源码核心代码呢,是在这 q r 点 t s 里边啊,大家可以去看一下, 发现啊,它其实也是一个也是一个 loop, 对 吧啊,它其实就是在不断的调用当前的 cloud cloud 这样的模型,在进行一个这个循环啊,差不多是这样的一个这个情况, 所以啊,你会发现,呃,整个的啊,我们当代的 ag 的 核心呢,就是要需要构建好这样的个 loop 啊,当然我们这一期讲的会比较简单哈,真正在构建 loop 的 时候,你可能好歹得用些这个工具啊,得用些这个框架啊,然后呢辅助你更好的去完成这样的这个 loop 啊, 这里大家可以自己去试一试啊,我们上面给大家给出的这个原码啊,就是上面呃,我们这个教学视力的这个代码啊, 就 learn cloud code 啊,这里面这个代码,大家可以自己去尝试着去用用,看一看啊,感受一下啊,他现在整个的这个核心的这个路谱呢,大概长什么样啊?你现在呢,让他呃这个执行简单的任务,他就是一步啊,这样工具结束了啊,如果让他执行复杂任务,他可能会 多部啊来调用这工具啊,但总之呢,有了这个命令,行啊,有了能够啊,有了这个能够调用工具的这个大模型啊,再加上一个路谱啊,基本上我们的 agent 的 核心呢,就这么构成了啊,是这样的这个情况, 当然哈,我们去构建这样的 agent 的 这个核心啊,大家肯定会想啊,那呃,他肯定会有些不太够的地方,对不对啊?你好歹给他多整一点这个工具啊,给他搞一点这个复杂的上下文啊,等等等等, 那我们说所有的啊,其他的这个 agent 的 这个架构,基本上都是以这个为核心去进行那些功能的这个拓展,我们这也就不展开了来说了,但是大家需要知道的是一个基于 look 啊和啊基于这个命令行为核心工具的这样的 agent 的 体系,它其实会面临很多问题的啊,我们接下来主要是看它会有什么样这个问题,以及呢 cloud code 到底是如何来进行解决的? 那么他会有哪一些问题呢啊?首先第一个就是上下文会不断的增加,对不对啊?这其实是非常明显的一个这个问题啊,也是我们在实际对话过程当中迅速就会遇到的这样的这个问题啊,上下文会越来越长, 越来越长,并且呢伴随着像现在啊,我们很多比较复杂的这工具在进行调用的时候啊,他这个上下文呢,实际上是会呈现这个指数级的这个上涨这样的情况, 上下文一长啊,其实就会带来很多的非常致命的一些这个问题哈,就比如说一个呢,是模型的啊,他会有个上下文的这样的窗口啊,超过这窗口他就没法来进行运运行了,必须要去裁剪一下之前这样的记忆啊。那么第二个呢,是 伴随上下文越长啊,其实模型的注意力呢也会被稀释掉啊,这就是所谓的现在我们在去使用,比如说 color code 呀,或者是大家去用很多的一些大模型,你会发现前半段啊,运行的还很好啊,愿意去生成一些很长的这个结果。到后半段 啊,尤其是这个模型快到自己的上下文窗口的时候,他就开始疯狂的输出啊,对不对啊?也不管这个输出对不对啊,或者质量好不好啊,甚至是这个给你乱输出一通啊,总之就是会迅速在短时间内把这任务给结束掉啊,这就是所谓的当代大模型的上下文焦虑,哈哈,会存在这样的这个问题。 那么第二个就是对于每一个 a 阵在这运行的过程当中啊,他其实会存在关掉就失忆啊,重开全部知道啊,这样的这个情况啊,但是这个情况 大家都能理解,对不对啊?因为上下文没了嘛啊?但是呢,我们说在当代的 agent 的 这样运行体系里面,为什么这点会变得非常重要啊?其实是因为我们现在的很多 agent 在 运行的时候,它往往不是一个 agent, 它是很多个 agent 啊,这个时候呢,它我们在实际执行任务的时候,就需要非常合理的给不同的 agent 啊,给他来进行非常精密的上下文,这样的匹配才能够迅速的带入到自己的这个角色里面来啊,来完成运行啊。所以呢,对于现在的 agent 运行过程当中来说啊,我们说合理的给他匹配上下文也是非常重要的一个方面。 第三个就是安全方面这样的问题,对不对啊?那安全方面问题呢?呃,之前我们在讲 cloud code 啊,讲 open cloud, 其实有讲到过啊,就是由于你现在啊 这个 a 智能很厉害啊,对不对?他自个又很聪明哈,然后呢,他又有智慧啊,又可以操作命令行者工具啊,对你各种环境的一通操作哈,那么这个时候呢,呃,他这个安全问题就会变得非常重要啊,因为他一不小心把你什么关键文件给删了哈,对不对?那这个事情就很尴尬了啊,所以呢,对于现在的这个 a 智能运行来说,安全其实是一个很大的 一个这个需要考虑的一个方面。那么 agent 的 安全哈,跟传统的软件安全还不太一样啊,传统的软件安全,它其实是可以通过一系列这个测试给它测试下来的哈,就去看啊,关于啊,你在各个场景下你的所有功能是怎么样来进行运行的,一个一个来进行安全测试,测试完了之后就可以上线。 但是对于大模型来说啊,它呢是一个有智慧的工具啊,那么呃,你引导它去工作啊,那么也可能会它呢也可能会被别的一些信息给忽悠瘸了啊,这个时候呢,你就得这个想办法,对不对啊?这个用魔法,对方用魔法对抗魔法啊,才能够解决大模型的安全性的这样的问题。 我们现在说 open cloud 啊,这个很多的安全性问题,非常的这个显著,有很多隐患需要来进行修复。但实际上呢, cloud code 啊,它作为目前非常通用的这个智能体, 他的安全的这个级别是非常高的,他也是之前经历了很长一段时间安全啊,踩坑啊,甚至被竞争对手殃流啊,这样的这个情况之后啊,现在他才这个逐渐逐渐逐渐提升了啊,他的安全性,这样的这个啊,提升他的安全性的一些这个措施,那么现在啊卡扣的的安全的很多措施我们会看啊,其实还是非常精彩的。 那不管怎么样,我们说对于安全性这个问题,哎,它其实也是属于,对吧?啊,整个 agent 在 进行运行的过程当中啊,这个我们是要时刻关注的啊,就比如说这里面我们现在给大家的这个视力代码里边啊,这个不是呃,这个不是 clock code 的 这个原码哈,这是我们给大家视力代码里,比如说 一些就包含了一些非常基础的安全性啊,这样的一个解决这个问题,比如说啊不让他去使用什么 r m 杠 r f 这样的这个命令啊,还有这个什么 s u d u 啊,这个全部权限这个命令啊,还有这个杀档啊,关闭某些东西这个命令等等等等啊,会有这样的这个提示啊,等等等等。 当然啊,还有一个非常重要的一个这个问题啊,就是他其实 a 阵的运行的过程当中啊,尤其是一些长效长期这样的问题,会带来巨量的知识的,这个 商真啊哈,那么你运行的越多啊,关联的文档就越多啊,他你现在需要处理的这个局面就越就更加的这个复杂啊,他其实是会出现一个非常巨量的、非常快速的这个商真这样的状态, 这个商真这个状态哈,其实会很大程度上啊影响你未来 a 智能是否能长期稳定运行的一个这个点啊,这个其实并不是在于说我现在啊,这个每次带货量我就越多了,然后我付的钱就越多,并不是这样,而是他整个的运行的稳定性 就会遭到巨大的啊,这个呃影响啊,那么就比如说啊,我们这个 agent 的 look 对 不对?在运行的过程当中呢,你会发现啊,这个运行的运行的,运行的每一轮 talk 就 越来越多啊,当然浅层次的呢,是你的费用越来越多啊,但是这个深层次的呢,是伴随着你当前 agent 的 这个商增啊,你其实你的稳定性会受到很大的影响。好, 那这问题怎么解决呢啊?我们接下来其实哈整,如果你去纵观整个 cloud code 啊,它的这些原码,基本上它就是围绕着这 四个问题啊来进行的这个展开啊。我们其实今天晚上的公开课并不会啊,直接去贴一个啊,比如说 clock code 完整的啊,这个什么几十个这个,呃,几十个不同的核心的这个主类啊,还有上百个啊,这个子类它的功能对比的这个表啊,这个其实意义不大啊,我们更多的希望大家能够通 过我们接下来这个解读啊,能够看得出来这个 clock code 是 怎么样啊,去实现这个 harness engineering 的 啊,以及呢我们现在这个 clock code 到底是啊作用于它的核心架构,对我们开发人员来说,它到底是能够解决哪些问题? 那么接下来啊,这个原码这个层面,其实就,呃基本上啊整个扣的这个原码层面都是围绕的我们刚才所说的这四个方面啊来展开的啊。当然大家如果想去看他完整这个原码的话,那么其实呃上面有原码,上面完整这个原码大家可以自己去拿,自己荡下来之后去可以去看一下啊,那么总之呢,现在他总共呢是 五十一万多行的这个代码里代码文件啊,然后总共呢是一千九百多个这个,呃五十一万行的代码啊,主要是 t s 的 这个代码,然后呢差不多是一千九百多个这个代码的这个文件,那么它总共的各式各样的分类呢?差不多是这样的这个情况啊,与它 模型 api 交互的核心代码,差不多是八千行啊,然后呢?这 curry engine 啊,推理引擎啊,差不多是这个 四万六千行啊,然后呢?工具系统啊,还有四十多个工具这个模块啊,差不多三万行代码啊,然后呢?什么这个终端 ui 渲染啊,差不多是两万五千行,剩下的这所有的哈,尤其是这个什么工程基础设施啊,总共有三十六万行代码,剩下这些所有的基本上都是为了啊,让当前这个 agent 给它约束,好 让它更好的去呃,这围绕长期这个问题来进行解决啊,所以呢,你会发现对不对啊?差不多这个百分之九十八啊,都是这个 harness engineering 啊里面相关的这个内容啊,这个呢,就是它完整的项目的这个代码,大家可以自己当下来去看一下,然后下面呢也有关于它的这个代码的 一个基本的这个分布物啊。好,那不管怎么样,我们接下来就来看看到底是怎么去解决这样的一些这个问题的啊,就是怎么去借助这个 harness engineering 这个架构呢,去解决它现在的这个啊,现在 a 证的长期稳定运行的这样的一些这个问题的 啊。当然其实讨论到这 harness engineering 这个的话,其实我们之前是呃有单独讲到过哈,这个 harness engineering 的 这个内容 哎,稍等,我们这个图它裂了啊,我们其实之前有一期公开课专门是讲到过啊,它内部的这个整个的这个 harness engineering 的 这样的一个这个呃基础理论,那么 对于 android big 来说啊,他会觉得整个的啊,这个按整个去构建它的这样高性能这个智能体,我们基本上是需要做好以下这么四个方面的这个工作啊。这个是它的第一版的这个想法。第一个呢是 context engineering 啊,就它上下文工程啊。第二个呢是 啊,我们如何协调内部的 agent 工作流和他的这个决策流程啊?第三个呢是提供高质量的工具接口跟工具描述啊。第四个呢是做好他的安全行为边界这样的个约束啊,差不多是他最开始啊是有这样的一套这个理论体系,这个是他自己的这个博课里面,这个呃博课里面来进行的这个介绍哈啊,当然这个理论其实说起来会比较 呃枯燥,我们接下来直接去看它到底是怎么做的,对不对?我们直接去看它这四个方面啊,到底是如何去解决的啊?那么它整个的 harness engineering 基本上就是集中在这四个方面的工程的实践。一个呢是所谓这个约束工作台啊,专门去进行上下文管理啊。第二个呢是它的这个记忆方面的这个管理啊,它呢是分成了三层来进行记忆管理, 这个记忆管理不仅仅记忆存储哈,还涉及到非常复杂的这个记忆处理的相关的这个内容。然后同时呢还有很多众生防众生的这个防御啊,和它如何来进行成本啊?这是 talking 消耗方面的这个成本的这个约束,我们先来看一下啊,是如何来进行实现的, 当然我们说对于整个的卡扣的来说啊,它的这个整体的这个架构啊,这个我们简单提一句啊,这个我们这个大家感兴趣可以自己去看一下,它的整个架架构其实分为五层的,分别是入口层啊,是是运行层、引擎层、工具能力层、技术设施层啊,差不多是分为这么五层的 啊,这个内容啊,但是入口就指的是它的所有的可以调用的啊,给它来进行信息传递的这样的这个接口,有一点像 opencloud 的 这个 getaway 啊,这样的一个这个系统啊,因为其实对于现在的 cloudcode 来说啊,它呢是可以 在,就比如说这个啊, kelly 啊,对不对啊?命令行里面来进行调用,可以在 id 里面调用,也可以使用这 sdk 啊,也就是这个 opencloud 啊, cloudcode, 不好意思啊, cloudcode 官方他们推出这个 sdk 对 不对啊?来进行调用等等等等。 然后同时啊还有这个运行十层啊,这个运行十层其实主要就是我们之前所说的啊,它的这 agent look 啊,这样的一个这个环节啊,只不过呢它的运行十层里面还包括啊,比如说这 r e p 啊,交互式的这样环境,还包括啊这个后壳的一些这个钩子,还包括它当时运行的过程当中状态的管理等等啊,这个呢是所谓的运行十层,那 再往下啊,就是这个推理的这个引擎层,对不对啊?主要是 q r n g 呢的管理以及呢 compact 非常非常重要的关于上下文压缩的 这样的一个工作的啊,这个实现,然后再往下啊,就是关于工具和能力层啊,内部工具怎么样进行实现,怎么通过啊?插件来进能力拓展啊,还有 m、 c、 p 跟 skill 如何来进行接入, 多 agent 啊,如何来进行复制和分发啊等等等等啊,相关这个内容啊,再往下还有更加基础的一些基础设施啊,什么什么的存储的格式啊,还有这个缓存的这个内容啊等等等等啊,这怎么一系列的这个总共啊,是这么五层啊,来进行的一个架构,当然我们这里啊,接下来重点是来探讨关于它的引擎层和工具能力层啊, 这两层呢,就是主要去解决我们上面所看到的这四个方面核心问题的啊,这两层的这个基本的架构 ok, 行啊,那么首先啊,第一个我们先来看啊,他的上下文是如何来进行管理的, 这个呢,其实是涉及到我们上面啊,关于这四层里边第一个啊,关于约束工作台啊,他的上下文管理的第一个模块的一些扣扣的一些这个措施。那么首先啊,这张图其实非常形象哈,就是它的适用于来去描述啊,关于你现在的 a 证在进行运行的过程当中啊,可能最开始 运行的还不错,对不对啊,是一个非常整洁干净的这个宽敞的这个桌面啊,运行了一段时间之后呢啊,这边乱七八糟啊,你就根本不知道如何进管理它整个的 a 阵呢,进行运行的过程呢,它的这个性能也会下降啊,这是一个非常形象的这样的比喻, 当然我们这里是以以两百两百 k talk 为例来进行的这个说明哈,实际上最新的这 cloud code open 啊, cloud open 四点六,实际上已经是全面升级到一兆风向文了啊,相当于是拓展了这个五倍, 那么这对于这个上下文来说哈,首先啊,两百 k 肯定是一个这个硬的这个极限,然后同时呢,大家也需要知道是他的这个整个 agent 啊,在进行运行的过程当中,他只要啊超过了差不多百分六十之后,他的整 个模型的这个注意力啊,实际上就会被稀释掉啊,也就是他的这个呃呃,他去进行长段内容的输出的意愿就会下降啊,然后同时呢,他对于之前的很多内容的记忆呢,也会下降啊,是那么一回事, 所以哈,也是因为他存在这两方面硬的杠杆啊,一个呢是他两百 k 只有那么长,或者一照他只有那么长哈,那么第二个呢,是你伴随增加的越多,哪怕你没有突破他的这个呃,最大上下纹的这样的限制啊,实际上他也会系的越来越模糊啊,也是因为这有这两层的这个限制,所以呢,我们才需要非常谨慎的啊,给每次的 运行啊,去构建一下上下文,对不对啊?那么在我们现在这个视力项目里面,就是这个 learn cloud code 啊,这个项目里面呢,它呢实际上是提供了一个叫三层压缩的这个策略的一个简单的代码的这个实现,具 体代码实现啊,上面有这个对应实现的这样的脚本啊,大家有感兴趣可以自己去这个运行一下。那么总的来说呢啊,我们说在一个简单的环境下啊,注意哈,一会我们会说哈,这 cloud code 实际上是这个五层实现啊,在简单的环境下啊,实际上大家需要知道是,首先呢是有这么三层的 这个压缩的这个策略是可以来进行选举的,第一个呢叫做微压缩 micro compact 这一点啊, cloud code 也有,那所谓这个 micro compact 它呢实际上指的是我运行很多轮之后,我就把之前的工具调用这个结果给它删了啊,是这样的这个情况, 那么呃,这一点其实也可以理解哈,因为很多时候我们在进行工具调用的时候啊,工具返回的信息其实是非常非常多的啊,就比如说我们查询的天气对不对啊?使用什么 api 查询天气,那么这个时候呢,那他在这个实际工具返回回来这个信息会很多,但 但是呢在当时那一次的绘画过程里面啊,你就必须得包含这一个工具返回的这个信息的这个内容啊,因为它需要依据这个内容呢给用户来进行回复,但是呢伴随着运行的时间越长啊,那么之前的工具 加载这个这个加载的这个内容呢,可能就不是那么重要啊,所以呢我们就可以把它删掉。一般来说呢,是在三到五轮对话之后,那么之前的工具调用这个结果就可以直接把它删了啊,这个呢是指的是这个微压缩,那微压缩基本上是一种无损的一种压缩这样的方法哈,因为毕竟那些工具调用这个信息可能也会不变的,不是特别重要,但这里有一点其实是需要这个, 那这需要说明的一点就在于说我们现在去使用一些 agent 的 skill 啊,大家都知道啊,这个这个 agent 的 skill 啊,它呢是一个灵活自动加载加载的这个上下文,它是一种提示增强了这个策略啊,有了这个 skill 之后呢,这个模型啊,它就它就具有某方面这个能力了。但是这里呢,需要知道的是这个 skill 的 这个加持啊,它呢实际上 也是通过外部工具这样调用啊,通过这个 function response message 的 方式加载到当前的上下文里面来的啊,所以你的这个 skill 啊,它也是会伴随着我多对话几轮之后,它之前你加载调用过的那个 skill 就 忘了啊,会存在这样的这个 情况啊,所以呢,这也是提醒我们在使用 cloud code 的 过程当中啊,你如果你总是需要某一个 skill 啊,你下一次再进行运行的时候,那还需要再把这个 skill 加载加载进来啊,因为它运行两轮之后,就会把之前加载进来这个 skill 给它删了,以维持上下文的,这个对不对啊,不要太长了这样的状态,这是第一个, 第二个呢就是关于自动压缩啊,第三个是手动压缩啊,当然这两种压缩呢,其实呃,都是这个压,都是呃这个同一套流程啊,只不过他们各自压缩的这个方式不一样啊,这种压缩往往是采用这个摘药这样的个形式对之前内容来进行个总结啊,你可以 这么来进行这个理解啊,只不过呢,一个呢是到达预知之后自动来进行处罚,一个呢是手动来进行处罚啊,但是总的来说它都是 compact 这样的过程, 那么这三种压缩策略可以说是非常典型的啊,也非常呃,这个非常通用的啊,这么个压缩策略啊, cologold 是 这样啊,我们现在这个势力项目是这样啊,然后这个 open cologold 也是这样啊,基本上都是这样的一些这个压缩这个策略啊,这种其实属于 一个非常通用的啊,压缩这样的方法。当然啊,下面其实还有啊,具体的代码实现的这个过程啊,大家感兴趣啊,可以自己去运行一下,我们课程就不展开讲啊,因为 cologold 它这个架构内容很多啊,很多手动实践的内容,大家可以去进行实践一下, 然后具体它的 compact 啊,这部分的这个内容,尤其比如说我们刚刚说不是说这个 micro compact, 对 不对啊?这个运行几轮之后,把之前的这个工具栏给它删了哈,这个,呃部分这个源码呢,是在这个 service, 在 s r c 啊,然后呢 services 啊,下面 compact 啊里面这部分这个内容啊,你看它这个 compact 啊,光是这 compact 就 有这么多 哈哈的这个内容啊,这个其实这段原码非常精彩哈,因为之前很多同学一直在问啊,说 cloud code 它是怎么样来进行压缩的,为什么感觉我们会感觉 cloud code 压缩了之后呢,效果性能非常不错啊,跟这个普通的比如说 open code 压缩之后,他基本上记不得之前的这样的信息了。那么其实,呃,大家如果对这种感兴趣的话,就可以看一下啊,它这个 compact 的 这部分原码里面到底怎么写? 这部源码其实非常复杂,它还包括一些康啊,一些这 compact 过程当中的一些这个 prompt 啊,它内部的这个 prompt 是 怎么写?因为它在进行压缩的时候,其实并不是一个机械的压缩的过程啊,由于它需要涉及到这个 summary 嘛,所以呢,它是内部会调用这个 sanate 那 个模型,就中杯那个模型啊,来围绕你之前的这个信息内容来进行一个提取,来进行一个格式化的这个提取, 同时呢,他还会留下你最近那几几次对话的这个 to do list 啊,就是没有完成这个事项,所以呢,你才会觉得说啊,一方面他好像也记得之前这样的事情,一方面又帮我腾空上下文啊,同时呢还能够顺着你这 compact 的 之前的这个事项来进行运行,哎,感觉非常不错啊。其实这样的一个这个原因在里面啊, 这里面大家看的清楚的话,可以自己去看一下啊,这部分,这个原版啊,这部分其实还还是非常精彩的哈,当然就对于 o o cloud code 来说啊,它会啊,什么最近三个工具这个结果不压缩啊,之前都压缩啊,是不是这个 读文件的这个结果永远不压缩啊,然后呢,这个因为这个读取进来这个内容嘛,所以不能压缩,等等等等啊,有很多这个具体压缩规则啊,这个呢是第一个 micro compact, 这个呢叫做自动压缩啊,自动压缩就是指的到达预值之后呢,哎,自动给它来进行压缩啊,当然这个 auto compact 啊,在这 compact 里面啊,在 cloud code 里面也有对应的这个原码,对不对啊?到达预值之后呢?哎,自动的啊,来进行一个这个 来进行一个压缩啊,这里面有非常多的啊,它这个什么预值的这样的一个设计啊,然后呢啊,到多少的时候就来进行触发,等等等等啊,一般来说啊,差不多在百分之八十 到九十左右,它就会触发自动的这个 auto compact 的 这样的过程啊,它是不会到百分之百才进行触发的啊,因为它在它在进行,在在进行最后的 compact 过程当中,它还需要腾出一部分上下文来围绕之前内容来进行一个总结啊,所以一般来说是百分之八十,百分之九十啊,当然我记得最新的这个呃 cloud code 也是呃 二点一点九零这个版本啊,应该是百分之九十二啊,作为预值啊,这个大家感可以感兴趣的话自己去看一下啊,然后呢来进行一个这个压缩啊,差不多这么样的情况,然后除此之外呢,还可以手动压缩,对对,手动压缩跟这个自动压缩跟这个 autocap 的是有一样的这个过程啊,只不过的手动手动压缩呢,是通过 这个斜杠命令来进行的这个触发哎,然后呢它这个手动压缩呢,跟这个 auto compact 啊,基本上是完全一样的这个流程啊,只不过它是允许你在任何时候啊都来进行一个啊 compact 这样的一个操作啊。当然其实如果你不需要这 compact 的 话,你可以直接杠 clear 就 把它删了啊, 这个也是可以的。好,那上面呢是关于这个 open cloud 啊,关于 cloud code 啊,它的一些基本的一些实现方法啊,就我们刚刚所说的 micro compact 啊,然后呢 auto compact 啊,还有这个 menu compact。 那么除了这几种 compact 之外啊,我们说其实 oppo 还有很多的非常精彩的关于它来进行压缩过程当中啊,一些这个啊,所谓的这个防御策略啊,或者说它在压缩过程中可能出现的问题,如何来进行解决啊?你可以这么来进行理解 啊,这里也有四层压缩防御策略。首先啊,第一个肯定是 oppo compact 啊,它会临临临临近上下文的时候呢,自动啊来进行触发。然后呢, oppo 这个 micro compact 当然也是啊,全自动的来进行一个这个触发啊,但是呢,我们说你 compact 可能会 存在一些这个问题,对不对啊?所以呢,当它当它你的 compact 没有办法来进行这个 summary 总结的时候啊,它还会有一个叫这个 reactive compact 啊,这样的这个流程啊,指的是 api 调用,呃, api 调用这个 sunny 的 这个模型 api 来进行 summary 的 过程当中,如果报错了啊,它呢就会啊,这个触发叫所谓的啊,这个 reactive 啊,叫呃 reactive compact 这样的这个流程。 而 reactive compact 这样的这个流程啊,它呢,实际上一旦出发了之后,它就会使用这个 snip 的 这样的方法啊,直接呢大刀阔斧的啊,来进行一些这个压缩啊,或者直接删除上下文啊,这个呢,是有可能来进来这么来进行操作的。 它一般来说哈,这个 reactive compact 其实并不会特别常见啊,因为其实对于现在的这个 sna 的 这个模型的调用来说,相对来说还是比较保险啊,但如果确实是没法出现的话,它就会使用这个 snip, 对 不对啊?来进行一个简单粗暴的啊,这个 完整的呃,大段大段的原始内容的这样的一个这个删除啊,当然在 compact 过程当中呢,它还会出现这个啊,出现一些这个循环啊,因为 compact 的 内容呢,很有可能再次被 compact 啊,这个呢也是有可能的啊,然后呢 它对于啊这个地规呢,还有一些地规的这个防护啊,所谓地规防护指的是我上一次 compact 的 这个内容,这次呢如果按照正常 compact 的 这个过程来说的话,它呢可能会被 大幅的这个降低权重啊,但是呢之前 compact 的 内容往往它可能是比较重要的这个内容啊,所以呢它在下一次 compact 过程当中啊,会尽量的保存你上一次已经 summary 之后的啊,这样的一些这个内容啊,是 这么样的一个这个情况,但是这么样的个情况大家也能够感受到,对不对啊?它迟早有一天会 compact 不 下来啊,就是我们的 compact 之后呢,你的上下文并没有压缩特别多啊,这个时候呢可能就会触发我们上面所说的啊,叫做这个 reactive compact 这样的这个流程啊,它就可以开始给你直接删了啊,是 什么样的这个过程啊?所以呢这个 reactive compact, 它不仅这种是 api 要用调用错误的时候可能会触发啊,你这个 compact 不 下来的时候,它也可能会进行触发, 对不对啊?然后呢这里面啊 compact 这个代码大家可以自己去看一下啊,总之呢这都是在这个原始文件里边啊,然后同时呢除了啊它的 compact 这个策略之外呢,它还有啊叫五步流水线的这样的一个这个处理策略啊,这个呢实际上是它的每一次消息在进行构建的时候,它还会走一遍这样的这个流程啊, 这个流程呢跟上面这个流程其实很多是重复的哈,只不过上面这个流程呢是呃跟着你现在到达某一个预值或者手动输入一些斜杠命令来进行触发啊,来进上下文字压缩。然后下面这个流程呢,实际上是你每次在 在构建这个 system 啊,在构建你的这个 message 的 过程当中呢,会这么样啊,来进行一个这个处理啊,这个呢,大家可以啊自己来去看一下啊,那么其中呢 compact 也是一样的啊,因为你 compact 不 仅仅是在到达预值的时候会会这么来进行一个处理啊,你每次构建构建上下文的时候,它也会啊来进行一个啊简单的一个 compact 的 这样的过程。 然后同时呢啊这里有一些非常有趣的一些地方在于说对于当前的 cloud code 来说,在某些情况下啊,它呢实际上是会把你输入的问题来进行一些重写,可以进行一些优化的啊,这个呢其实是一些 非常细节的一些这个点啊,然后呢他会觉得你这样的这表述其实是会存在一些问题的啊,所以他会对你当你的这个原始这个问题呢啊,来进行一些这个优化啊,当然他也会有这个 prompt catch 啊,对吧?啊,提示词缓存的这样的个策略啊,提示词缓存我们会放在后面统一来讲啊。那总之呢,大家需要知道的是啊,它的这个 compact 啊是 怎么做的啊?然后呢啊,它这个整个的啊,是如何来进行上下文的啊这个压缩的啊?当然其实啊,不管怎么样啊,我们说 compact, 它呢肯定是进行有损的啊,肯定是这个有损类啊,肯定也是这个不可逆的啊,因为之前其实经常有同学会问到啊,说这 cloud code 啊,这 compact 跟是不是这个无损这个压缩啊,但其实只要是压缩它就是有损啊,这个其实 啊不用考虑啊,它肯定是这个无损啊,只不过呢,对于现在的啊这个 cloud code 来说啊,它呢其实并没有采用像 openclock 啊这个 rack 解锁这样的一个这个方式啊,它呢实际上就是单纯的压缩,压缩完了之后呢,把所有上下文带入来进行压缩 啊,代入呢来进行一个这个问答。而啊,就比如说像,呃,这个,呃 open clock 啊,它呢实际上是先它是,它呢实际上是超过了预值之后呢会对它的这个 memory 啊,来进行这个 red 的 这个解锁啊,是这么样的一个这个这么样的这个情况,这 两者他们的技术方案呢,实际上是有区别的啊。当然其实就目前的实践情况来看,如果是普通用户在进行使用的话,肯定会觉得这个 clock code 其实会更加的这个友好一些, ok 啊,怎么样这个情况? 那当然下面还有一些具体的这个细节方面的这个展开的这个说明哈,我们就不继续来进行讲解了啊,大家感兴趣的话自己看一下里面的这个文字。好,然后呢,有一个非常有趣的地方,我们刚刚不是说到 这个 cloud code 啊,它呢实际上是会对用户输入这个内容啊,你在构建上下文的时候,它就会来进行一轮感知,甚至是来进行一些这个修改啊,甚至是把一些重要或者不重要上下文的来进行加载和这个删除,去构建你当前这一次绘画的这个 message 这个列表,这里面操作非常多哈,我举一个小例子啊,大家能感受到它是怎么样 去啊,做到这个非常细节的这一点的这个优化的,就比如说如果你对 cloud code 骂街了,哈哈哈啊,就比如说你说啊,这不不是,就比如说 啊,那就用户的这个情绪啊,上头了啊,对不对啊?用户觉得说啊,你这个做的简直是垃圾啊。那个你这个完全不懂我的这个意思,跟你说了多少次,然后晚上你还是做不对啊,对不对啊?就是如果用户骂街了啊,那这个时候呢,扣扣的就会自动的去检测你上下文,会发现,哎,这个时候呢就触发了啊,所谓叫做这个 沮丧检测的这个机制啊,之后呢啊,他呢实际上就会迅速的啊,来进行一个这个 经典上下文,然后围绕当前这个问题来进行快速的响应啊,他会做这样的一个这个事情啊,并且这个过程他是使用 这个呃正则呃观正正则表达式来进行的剪辑和这个匹配啊,他会有这样的一个啊响应的这个方式啊,这个呢,其实是一个小这个小彩蛋啊,这个大家发现了之后呢,发现啊,这个有这个技术人员发现这个细节之后呢,会觉得很有意思啊,这个 open club club 呢,它其实进行了非常非常多细节方面这个优化, 这个呢是第一方面这个优化啊,总共四个方面优化哈,我们讲完第二个方面,我们再啊中场休息,然后再来进行一个这个啊,再来进行答疑,然后第二方面这个优化呢,实际上啊,是更好的去每一次去 folk 啊,或者说或者说去实力化多个 agent 啊。那么这个呢,也是呃, cloud code 的 一个非常核心的 一个架构方面这样的一个亮点吧,那比如说啊,我们现在呢,每次开启这个 agent 啊,由于呢他其实并没有上下文啊,所以呢他其实什么都不知道啊,这个时候呢,你可能就需要按需呢,对他对这个上下,对当前这个 agent 来进行一个知识的这样的这个贯注,对不对? 那么呃,我们之前在讲 opencll 的 时候啊,其实当时讲过 opencll 的 内部有非常复杂的提示词模板,然后呢我们需要去组建非常复杂的内部这个提示词,然后才能够去开启一个又一个的这个一个又一个 opencll。 那么对于 cloud code 其实来说其实也是类似的啊,然后呢 cloud code 它内部呢,也是啊,每次在运行之前呢,会有非常多的啊,一些这个扫描,我们下面应该会有一个完整的一个这个层级记忆的这个层级的这个图啊,那么 cloud code 呢,是按照这样的个记忆层级来进行剪辑跟架构的。 上面哈,其实有一些啊,上面我们讲的它什么自动加载 system prompt 啊,自动加载这个 skills 啊,然后呢是如果有需求的时候才会去加载对应的这个 skill 啊,这个呢是属于所有的 agent 呢,基本上都是这么通用来进行的。这个执行我们直接看它,像它 对于 cloud code 来说,它的这个整个的新开启的这个 a 阵的记忆架构差不多是这么三层啊,第一个呢叫做 memory 点 m d 永久记忆。第二个呢叫 topic files, 按需加载啊。第三个呢叫 transcripts 啊,只只搜不加啊,差不多是这么三个不同类型的层级的这个记忆。 那么 memory 点 md 这个很明显对不对啊?每次呢它都会啊这个来进行一个加载,那么一般来说哈,呃,当然我们我觉得现在可能很多大家在使用在 cloud code 的 时候,可能压根就不知道啊,它有 memory 点 md 这样的文件,是的,这个文件不对用户开放啊,这个文件呢,是纯粹的,它内部会通过一个非常精妙的过程来去维护的一个高质量的这个记忆文件, 它不是简单的啊,你要记住什么,它就把它写到哪啊,不是这样的,它内部有一个记忆的加载、清洗、分门别类存储,然后记忆的优化,一整个非常复杂流程,共同去维护这个 memory 点 md, 所以 这个 memory md 呢,对用户是不开放的啊,你就去改了,很容易把它改毁了啊,你也不能够去改它这样的文件 下面啊,这个所谓的 topic files, 它呢指的是针对不同的这个事项啊,它呢其实是会有对应的这个存储的文件的,然后这个存储的文件是可以通过 memory md 来进行锁影的,比如说你哈记住一百件事情啊,那一百件事情可能都没有办法全部给它放到这个 memory md 里面,它就需要分门别的来进行存储,然后呢按需来进行锁影, 那么再往下啊,这个 scripts 啊,那么 scripts 呢,实际上就是关于历史的这个绘画了,那么历史绘画其实大家都知道啊,一旦我们现在在 carco 进行 compact 之后呢,历史绘画就不会再再进行加载了,但是呢,历史绘画它是会在本地来进行一个永久的这个存储的啊,所以呢,如果有需要啊,它呢实际上是会通过这个 啊, grab 这个非常简单的这个匹配解锁这样的方式呢,去找啊,你之前的历史对话啊,这也是通过命令行工具啊,直接使用这 grab 的 这样的脚本啊,就可以去匹配啊,去寻找你的一些历史对话。差不多是这么样的这个情况啊,这个呢,就是整个的啊,关于 cloud code, 它的一个永久记忆的这样的一个基本的这个架构啊,当然其实 除此之外啊,这个我们刚刚也说啊,它的什么啊, system prompt 呀,它的这个 skill 啊,也是按区加载的呀,那块其实我们刚刚跳过了啊,大家如果感兴趣可以翻到前面来去看一下啊,那我只觉得这段呢会非常精彩啊,所以呢,给大家来进行一个分享。 ok, 好, 那我们先看啊,这个 memory 点 md 啊, memory 点 md 呢,实际上都是通过啊这个 memory 的 direction 点 ts 啊,这样代码来进行的这个维护啊,它里面呢,实际上是有一套啊,非常精妙的这个维护的这个过程哈, 那么它在记忆的过程当中呢,它会不断地去识别 user 啊,不断地去啊,记住你的行为偏好啊,不断地记住你当前的这个 project 啊项目这样的信息啊,然后呢会去记住资源的位置,这个呢是它构建它当前的这个记忆最为核心的四个要素啊,当然这个四要素它实际上是会伴随着这个运行不断不断来进行加深的。 举个例子啊,就比如说我们在使用 cloud code 的 时候,其实你会有这样的感受哈,就比如说你最开始没有跟他讲过你叫什么名字啊?但是呢,如果在某一个项目里边,哎,你透露了你叫什么名字,你是在干什么的啊?那么其实哪怕你没有让他记住这个信息呢,也会啊,在他的这个漏斗状的这个筛选的过程当中,不断不断的啊被筛到这个 memory 点 md 里边 这么样的这个情况,然后呢在这样的一个啊,这个 memory 的 这个记忆的过程当中啊,它不仅仅是说会围绕这四个非常核心的记忆类型的,有针对性的啊来进行一个这个记忆,然后同时呢 它有很多的啊,一些写入记忆的一些这个纪律,对不对啊?比如说它这个这个很多时候啊是先 先进行缩影啊,再去先创建这个缩影,就是创建这个 topic 的 这样的文件,然后呢再写入到这个 memory 里边。再比如说对于 memory 来说,它呢只会解锁前两百行啊,超过前两百行之后呢,就需要啊给它进行一个这个归类,就需要来进行一个精简,就需要把它放到比如说某一个 topic 里边去, 不断不断的啊来进行一个这个精简跟迭代,然后这个呢是它的这个 memory 啊,部分的这个文件的啊,文件的修改这个流程, 当然下面其实有一段哈,就是关于它的 auto dream 啊,这个 auto dream 呢,实际上是呃整个的 cloud code 非常精彩的一个这个设计啊, 当然上面还有一个关于 cloud cloud 点 md 这个文件,这个加载啊,这个我们就不说了啊,因为这个文这个呃记忆文档,其实是我相信大家其实用 cloud code 其实都会用到过,对不对?你需要在根目录里面创建一个 cloud md 这样的文件,然后它呢其实就是你的 system prompt 啊,的一个最核心的加载的这样的这个文档。 那么呃我们现在来看啊,惯常的 auto dream 啊,这样的一个这个自动的去清洗啊和沉淀记忆的这样的一个流程。 哎呀,说是这个流程,其实上非常的这个魔幻哈,就是我们在实际上呃 cloud code 的 时候,如果它是在你当前进程持续运行啊,但是呢某一些间隙的时候,实际上这 cloud cloud 呢,它是会开始做梦的啊, 它是会有叫睡睡眠记忆巩固的这个时间的,它会在内部悄悄咪咪的 fok 一个 agent 啊,然后呢去审查自己的这个记忆,再根据我们当前白天对话的核心内容去选择性的巩固或者删除一些记忆 啊,这个呢叫做 oto dream 啊,在这个做梦哈,那在利用睡眠来进行记忆巩固啊的这样的一个非常神奇的这个流程, 这东西其实确实这个说起来非常的这个魔幻啊,但是呢它确实是会这么做的啊,首先呢在它空闲的时候啊,就会自动的来进行这个触发啊,然后呢呃它呢?这个呃会单独的 fork 啊,单独创建一个 agent 来去做这样的事情啊,不影响主程序的来进行这个运行。 然后呢,接下来啊,它会去看啊,你当前对话所有这个时间戳对不对?就我们刚刚所说的啊,你越近的这个对话呢,它的这个权重就会更重一些,然后来进行一些这方面这个梳理啊,然后最后呢,单独的啊 for 可以 一个这个 agent, 然后呢通过当前这个 agent 去整理你的 memory 点 md 这样的文档啊, 所以呢,它的这个 memory 点 md 呢,是一个非常非常复杂而且精妙的这个设计的过程啊,不像 openclo 一 样啊,你让它写入它就写入,写入完成之后呢,这个 memory 太长了,就直接来进行 rec 解锁啊,并不这样啊,对于 cloud 来说啊,由于它是通过这样的一个可是非常神奇的这个维护 memory d m d 这样的一个文档的方式啊,所以它其实并不需要啊,所谓的这个 rap 这个流程来进行解锁啊,因为它的上下文呢,其实它的这个上下文其实能够被能够来进行非常好的这样的控制的, 而且 cloud code 本身它对用户的要求也会非常高啊,就比如说我们上面所看到的 cloud 点 m d 这个文件,对不对?那么这个文件呢,其实是所有的 cloud agent 每次在进行运行之前,它都会加载的这样的这个文件。那么只不过啊,大家可能之前不知道的是,对于 cloud 点 m d 这样的文件呢,它和其他的 skype 一 样,只会最多加载五百行, 更多它不会加载了,哈哈,所以呢,你对于 cloud md 来说,你写的再多啊,这个这个意义也不是特别大啊,所以呢,它呢, cloud 它是会盗弊用户,我们在进行实际使用过程当中呢,你得想办法啊,去 主动地去精简这样的一些这个记忆,主动去精简你希望主动让他记住的这样的些这个东西。而它自己维护的这个 memory md 啊,这个呢,是它自己维护的,他们共同构成每次对话这个上下文,那它呢,实际上就会, 对不对啊?这个什么 auto dream 啊,然后呢,它又什么这个啊,会呃,创建一些这个 topic files, 对 不对啊?分门别类的去存储记忆等等等等啊,这个呢,是它自己会去做的这个事情。而对于像 cloud 的 md 啊,需要用户去做的啊,它就没有太多的这个要求啊,跟你说,反正我只读前五百行, 那你自己看着办哈,对不对啊,你自己想办法来对它来进行优化啊。当然其实 cloud 它也有一些 skills, 能够去帮助你的 cloud 点 m d 来进行一些上下文章的优化啊,这个呢就属于应用层面上这个东西了啊,但不管怎么样, 对吧?啊,我们通过这样的一些这个流程啊,还有上面的源码的一些这个实现啊,大家能发现整个的 cloud 啊,它在构建每次对话啊,每个新的这个 agent 的 这个时候啊,它的上下文呢,是如何来进行的创建啊?这里面呢有呃呃,大家如果想看更加详细的源码的话,可以 去找到啊,我们的这 auto dream 啊,点 t s 的 这个文件里边啊,里面呢有非常详细的关于它是如何引导如何 fork 一个当前的 agent 去整理自己的记忆的啊,包括什么审查呀,强化一些东西啊,删除一些东西啊,如果存在矛盾应该如何来进行处理啊?然后如何啊?把 这个什么模糊洞察转化为确定事实啊,如何去重组当前这个记忆啊?哎呀,这个流程其实非常复杂啊,如果有机会的话,我其实还是非常 电影展开跟大家说的啊,因为这个其实还是非常精彩啊,去整理他这个记忆比简单的啊,什么寄到本地文档,再通过 red 来进行剪辑,要好的多啊,要好的多, ok, 当然下面还有一些这个安全的这个措施啊,当然他这个也会有一些这个啊,也会有些这个局限啊,因为他的记忆组装好坏,其实会跟他当前这个模型呢,会有直接的这个 啊,直接很大的这个影响啊,当前模型如果指令跟随能力强的话,那么他记忆组装的其实就会更好。但下面还有啊,什么分层的知识注入啊,然后呢,还有下面的什么提示词啊,什么六层动态组装啊,这些东西呢,其实都是属于怎么去更好的去维护他当前这个上下文的,那这部分其实并不会特别复杂啊,这个大家可以 自己回头去看一下。好,那么到这啊,我们就觉得基本上对于像 cloud code 啊,它的一些架构,就我个人觉得比较精彩啊,两个方面的这个内容啊,一个呢是如何来进行 compact, 对 不对啊?去压缩上下文,够压缩上下文啊,去构建更好上下文工程啊。第二个呢是如何修改它的这个像整个 agent 这样的个记忆, 这两方面的核心的我觉得比较亮眼,功能呢,都就都跟大家讲清楚了啊,那么接下来呢,还有两个方面, cloud code, 它的这个项目架构的优化,一个呢,是 啊,关于他是如何做这个安全检查的啊,第二个呢是他是如何去抵抗啊,一些这个知识的商增的啊,这两部分的这个工作啊,那么接下来啊,我们先稍作休息一下啊,然后呢,我们再来讨论啊,这两部分的这个内容。 ok, 那 我们说了这么多 啊,原理层面的这个,呃呃,原原,原理层面这个问题啊,我觉得很多同学可能都已经有点晕了啊,对于 cloud code 来说啊,它这个,呃,确实。嘿,我们接下来是讲 antispac 的 cloud code 的 最后两个非常核心的架构,一个呢是它的安全防御策略, 一个呢是他的对抗知识商商增的一个这个策略 pdf 里面图是,好,那我们就对着 pdf 来讲,大家看到这个 pdf 里面图应该也是也都是应该,应该也都是 ok 的, 我们是从安全, 其实这个安全呢,不仅仅是啊,它会被有害,而且很多时候指的是对他行为的一些这个约束。 ok, 好,从这啊开始继续好,那么了解啊,关于 cloud code 的 一些很精彩的一些这个架构,对不对啊?上下文怎么管理的呀?这些记忆是怎么约束啊?记忆是怎么优化的呀?之后接下来我们再来看非常重要的一个问题啊,就是 cloud code 啊,它的安全性啊,是怎么做的啊? 这也是我们现在很多在运行 agent 的 时候啊,开发者经常会非常头疼的一个这个事情啊,对不对啊?怎么确保这个我的 agent 它不会做一些有害的这个事情呢啊?那么其实 cloud code 开源之后呢, 泄密了之后,哈哈啊,是给大家有一个非常直观的一个这个感受啊,或者提出了一个非常通用的这样的一个范式啊。当然,其实我们 说伴随着你 a 证本身的应用面越来越广啊,你可能会面临的啊,什么投毒啊,或者其他的些恶劣的情况肯定会越来越多啊,这个属于魔高一,这个魔高一尺,道高一丈的这个事情啊,但是呢, cloud code 确实给你提出了一套作为基础的啊,所有的 a 证都可以上来就可以用的啊,这一套安全的这样的措施,我们看他是如何进行实现的。 首先哈,我们其实呃都知道啊,对大模型来说,他他他有智能啊,所以呢,他的这个安全措施跟跟普通的安全的这个软件啊,可能会不太一样啊,我们其实更多的是需要去约束好当前的 a 阵的这样的行为,才能够防止他作恶。 那么对于像 cloud code 来说啊,他是怎么样啊,来进行的这个思考呢?或者他整个架构是什么样的,基本上是按照这样的架构来去走啊,这个架构应该还是非常清晰的一个这个一个架构哈, 首先第一层啊,自我穿匹配啊,然后第二层呢,正则匹配啊,第三层呢是白名单分类啊,第四层呢,是独立的大模型的对抗审查啊,第五层呢,是人类来进兜底啊,差不多就这么五层的,这个五层的这个措施啊,但这五层措施呢,从上往下啊,这个难度一次增加,然后同时呢它的工程实现的这个复杂度也是在逐渐增加的。 首先啊,第一层啊,关于这个自产匹配,这个其实非常简单啊,就比如下面有个,有一个这个代码啊,基本上就是类似于类似类似像这个代码就可以,就可以就可以能够来进行实现了啊,就比如说无论如何都不能出现在你命令行里面的啊,这样的一些这个 呃这个命令的关键词对不对啊?什么 rf 啊, r m 啊等等等等啊,类似这种啊,然后呢直接把它过滤掉啊,这个呢是第一层啊,直接呢通过自传的自创的这个黑名单啊来进行匹配。那么除此之外,我们还可以更加复杂,通过正则来进行匹配啊,对不对啊?这个正则呢,就比自创表达式来进行匹配啊,它的本质呢仍然还是来进行的匹配。 那么第再往下一层啊,就是关于白名单啊和这个命令分类器啊,就它呢会我们会给出一个接下来啊,或许某一些这个命令呢,是 可以直接啊来进行这个执行的,然后同时呢会对所有这个命令来进行一个这个分类啊,如果你分类呢,最后呢是落到白名单这里,我们接下来就可以直接的来进行一个放行来进行运行。 那么再往下啊,就独立大冒险来进行审查啊,这个其实也会非常关键啊,因为大冒险他就会呃,从一个独立的这个角度啊,就不带入你当前上下文的这样的这个角度,他是一个独立的一个这个 sub agent, 然后呢去审查你当前这样的命令,是不是可以来进行执行的啊?这是第四层,然后第五层啊,就是关于人工来进行判断啊,差不多是这么五层的这样的这个架构, 那么在这五层架构里面啊,刚刚我们也说了这个审查的这个 a 证呢,其实审查大模型呢,跟你执行大模型,实际上它是完全隔离的啊,这两个大模型,一般来说审查大模型是不会带上下文来进行一个这个运行的。 那么最后啊,还有一层啊,关于这个人人类的这个兜底啊,所谓这个人类兜底,就指的是如果有确实不知道啊,这样的这个情况,不管怎么样,最后我们都会有一层啊,让人类来进行审核的这样的一个这个,呃,这样的一个空间啊,或者这样的一个通道。 这个呢,其实我们在平时使用 cloud code 的 时候,我相信大家应该也会遇到过类似这样的情况哈,就比如说哪怕啊,我们给他输入了一些这个指令啊,跟他说,他启动的时候跟他说这个, 呃,这个,呃, skip dangerous 啊,类似这样的这个命令啊,跟他说啊,我们这个他可以直接跳过人类审查这样的环节,直接自动来进行运行,但是你会发现他遇到很多他吃不准的这个东西哈,或者遇到一些比较高权限的这样的问题, 他还是会啊,来进行这个啊,就他还是会来进找人来进行审查啊。所以呢,其实关于这个人类兜底啊,实际上是他的一个不管怎么样都绕不开的一个。最后的这层的这个策略 ok 啊,是这样的一个基本的分类,这样的方式,然后他直接进行审核的时候呢,也都是啊,先看规则啊,再看这个有没有风险啊,再看白名单啊,再看这个大模型分类啊,通过一层一层来进行筛选啊,然后呢,如果规则没问题就直接走了啊,如果规则有问题,我们再来看啊,是不是有 风险啊?有风险我们再看看它是不是白名单啊,白名单就可以放行嘛,对不对?如果还不行啊,就大模型对抗啊,来审查一下啊,然后最后呢啊,还再不行,交给人类来进行审查啊,就这样的一个逐层的啊,来进行审查的,这样的,这管线, 这个实际上是一个非常通用的哈,基本上所有 agent 你 如果要考虑这个啊,考虑安全性的话,都可以这么来做哈,然后呢,对于 cloud code 来说,它的这个 security 点 gs 这样的一个呃,点 ts, 这个呃 代码里边哈,这个大家可以自己去看一下,里面它有非常非常多的啊,一系列的这个安全审查的一些这个事项。然后呢,这些安全安全审查的这个事项啊,其实是我相信对于很多现在做 a 证安全的同学来说,是个巨大的数字资产,因为它这里面很多的 这个安全审查的这个事项哈,都是之前长期的被攻击过之后积累下来的这些规矩或者经验哈,这个其实我们很难一条条跟他讲清楚哈,但是这里面确实有非常非常多安全审查的这个事项,也就是他第一层啊,这个规则啊,他就积累了很多之前踩坑的被攻击的这样一个经验啊,你想想这些经验对于很多的 a 证的开发者来说,当然是这个 这个这个无价之宝这样的一个东西啊,当然这里面大家可以在这呃原码里面能够看到哈,它里面到底是 啊怎么样去进行的这个审查啊?然后同时呢,呃,他还有很多的啊,他真的是这个属于这这被攻击久了就攻击出来这个经验啊,什么临宽制服与控制制服的啊,这样的一个这个防御啊,什么这个什么这个制服里面啊,由于由于我不是做安全的,所以我不是特别了解 啊,这里面到底是什么什么个这个情况啊,但是大概能够明白啊,是说一些非常特殊的攻击的这个指令啊,他其实会通过啊,里面去加入一些什么临宽制服啊,或者控制制服啊, 能够去规避掉啊,它的一些基于规则或者基于准则的这样的检测啊,从而绕过它的这样的防御,然后呢去攻击当前这样的系统啊,所以呢才会基于这样的个问题啊,再来增加对应的啊,这个防御的这个措施等等等等啊,总之呢,其实都是在 这个啊, best security, 点 g s 的, 点 t s 的 这个文件里边啊,这个大家可以自己去看一下,然后呢在这个文件啊,然后呢现在其实对于像 cloud code 来说,它的核心的 c m d 啊,防御它的这个 best 命令行相关的这样的攻击啊,其实其他方面的 攻击并不会涉及到你本质电脑上的这样的一些数据的这样的损坏啊,或者他直接盗取你一些这个文件等等等等啊,这个其实做不到的,其实它最核心的攻击的这个点啊,或者是 它的这个最大的风险这个点啊,所以主要还是要命令行工具的这样的一个使用啊,所以你会发现它基本上所有的这个 security 呢,都是围绕着命令行的这个 best tour 展开的啊,其他的一些这个 tour 呃问题不大啊,其实它往往没有被攻击的这样的一个这个价值。 然后同时呢对于 cloud 呃扣子来说,他的实现这样的这个方式,当然我们刚刚说了,对不对啊?这个总共是这个五层啊来进行的对抗,那么除呃五层来进行的这个审核分别是规则啊,然后呢是这个 啊,正则啊,然后呢是这个白名单,然后呢是大模型,最后呢是这个人工来进兜底,通过这五层来进行的一个这个搭建的一个基本的安全的防护网络。 那么除此之外哈,其实对于 klopp 来说,由于他现在还提供了很多那些企业或者团队内部的这个定制这个版本啊,所以呢他还有很多的围绕的一些给企业提供定制款版本的时候啊,他的些企业的一些特定的啊,一些这个呃安全的这个措施,他其实也会 写在 club code 现在的这个圆码的这个项目里边啊,这个的话就如果是大家去开发企业级定制的,并且是允许啊,企业里边我们去单独的给企业内部的这个企业内部的 a 政设置一些防御测试的话,那么这部分啊,是非常值得大家来进行一个这个学习跟观看的啊,就是什么呃企业内部有统一的什么策略呀?然后呢?有什么 这个呃规范的命令行参数的书写格式啊,还有个人默认的啊,这个纸等等等等,会有这么个五层的 这样的一个这个权限的这样的一个设计啊,这个其实更多的是一些定制化开发这个场景啊,这个大家如果感兴趣的话,可以在这下面能够看到啊,但总之呢他的这套这个防御的这个措施还是非常完善的, 那么除了可以提供一些定制化的防御措施之外,还有什么?这个三三个平台啊,各自有各自平台的这个沙河环境啊,可以来进行一个这个运行啊,沙河环境这个我们之前讲过很多次了,对不对啊? 沙河环境呢,相当于是提供提供一个隔离的独立的一个虚拟环境啊,来进行运行,那么你在这个环境里面进行运行的话,任何的一些有害的指令都影响不到你当前的这个主命令啊,主系统啊,这样的一个这个情况啊,这个呢是他的沙河环境啊里面来进行运行,然后同时呢他还有啊这个默认的一些安全检查啊,这个安全检查呢,实际上是每次启 动过程当中啊,他其实都会默认来进行一轮的这个执行,那么这个安全检查啊,实际上也都是他之前啊这个积累下来的这些坑,对不对出现的这样的这个问题, 然后同时呢它还会有一个啊断路器这样的机制啊,所谓断路器这个机制指的是如果我的 a 证在进行运行过程当中连续撞墙啊,就是他反复去尝试一些这个问题呢,他始终没办法得到解决啊,那么他就会判断,哎,你当前的这样的一次这个尝试或许是有毒有害的,那么之后呢,就会尽量避免出现类似这样的情况, 那这个断路器这个设置和安全这样的问题呢,因为他可能会存在一个暴力破解的这样的情况 啊,所以呢,它的这个所谓断路器这样的设置哈,其实它是一个强硬的这个规定啊,就出现连续三次被拒绝啊,或者连或者累积二十次被拒绝啊,那么它呢就会自动降级你当前的这样的一个这个命令的这个权重啊,换而言就是它会更加倾向于去拒绝执行当前这样的一个这个命令啊,是这样的这个情况, 这呢是一个断路器的一个设置,会在实际运行过程当中不断的来进行积累,当然它的这个氧氣的防御措施,还有一个还有一个方面的这个防御啊,确实是这个久经沙场 积累他的经验啊,就是他还有一个反蒸馏的这个防御啊,这个其实出来之后也非常精彩啊,这个因为安萨佩前段时间还说啊,他的这个模型啊,这个很多被被别人的壳扣子反复吊用来进行蒸馏,对不对?蒸馏别人家的别人家这样的模型啊,然后呢,呃,这个这个大家这个网友就批判批判他啊,说你的这个模型难道不是蒸馏来的吗?对不对? 嗯,这个也不太好说啊,那但是呢,现在对于 cloud code 来说,他确实有一个反真流防御的这样的这个措施啊,就是他呢实际上会去判断你现在在进行调用的过程当中到底是真工具还是假工具啊?如果呢,你是一些假的工具啊?来接。如果呢?呃, sorry, 不是 判断真工具假工具哈, 他是会判断你现在的调用工具这样的一个模式,那么他如果识别到啊,说你现在呢是一个真实的用户在使用 cloud code 的 话,那么他呢就会以真实的用工具这样的流程来进行响应。 如果他现在去判断啊,你现在这个调用工具这个流程呢,是一个蒸馏的这样的过程,你会围绕很多场景会去穷举他的可能性啊,然后呢会围绕一个问题的反复来进行这个运行, 那么这个时候啊,他其实内部会有一套识别这样的一个流程哈,这个我没有展开讲啊,但这个识别流程实际上是个比较精妙的一个这个识别的过程,他既会有一些基于规则的这样的判断啊,他也会 有这个 sanit 这个模型,主观的这个模型的这个识别啊,两层的这样的识别。那不管怎么样识别了之后呢,他会觉得啊,你现在呢就是一个机器人啊,在操作你的 cloud code 啊,然后呢就是为了去获取一些这个数据啊,然后用你这个用这个数据去接下来训练我的呃,去训练别的模型,这个时候他就会 非常激贼的啊,在你在他实际运行的过程当中呢,给他给你手动给你自动的去注入一些假工具的流程啊,就是这工具根本就不存在啊,或者说就直接就给你去 这个创建很多的一些工具调用失败啊的这样的一些这个这样的一些这个数据啊,从而呢他会生成一个这个有毒的这个训练数据啊,防止别人家去进行蒸馏啊,就这么一回事 啊,哈,这个其实还是很有意思的一个这个点哈啊,但如果这个大家确实面临的类似于这个蒸馏或者反蒸馏这个场景的话啊,这块确实是值得学习。 最后呢,就是关于他的这个对抗的这样的一个问题啊,这个点呢,其实是非常值得拎出来来进行单独的这个探讨哈,就是因为其实现在关于双 ai 对 抗的这样的场景,我目前其实在很多地方其实都会有用到过啊,比如说像这个 啊,像我们啊编程的时候对不对啊?有在编程的啊,有在进行审核的啊,包括我们在解决些问题的时候啊,是比如说你做些科研的工作啊,有提出结论的,包括比如说我们现在啊,如果使用 ai 去生成一些这个内容啊,那么有生成内容的,有去批判内容的, 那么现在呢,对于 ans 来 pick 来说,你会发现它的这个双 ai 对 抗这个策略基本上是贯,基本上是贯穿它整个 cloud code 的 各个方面的啊,如果遇到一些你当前大模型它自己不太好判断是不是有问题的这个点的话,那么它就会其实就会启动啊,双 ai 对 抗的这个策略。那么 比如说上面我们说这个安全方面的这个双 ai 对 抗这个策略,这一点我觉得还是比较好理解啊,因为其实一方面提出啊,一个 agent 来负责来进行审核, 那么除此之外呢,其实像 cloud code 里边儿啊,我们之前就有谈到过它的这个命令啊,它的这个压缩呀过程,其实也都会啊,有这个双 ai 双 ai 对 抗的这个影子啊,就一方提出主张啊,一方面提出质疑啊,然后呢,最后综合出一个结论,差不多会有这样的一个这个过程。 而这个双 ai 对 抗啊,实际上也是现在的关于 harness engineering 啊,他的这套体系里面提出来的一个非常有价值的一个观点啊,就是他会觉得啊,在这个多个 ai 从不同角度啊来进行,呃,那他们分别带有不同上下文啊,然后呢,去协助去完成一个事项的时候,往往有助于啊,提升你最后这个作品的这个质量。 举个例子,比如说啊,我们现在经常会使用 ai 去生成一些这个内容,那么生成内容之后呢,如果你让自己让他自己去 去对自己东西来进行审核的话,其实往往就审核的就很一般啊,但如果你有多个 ai 来进行对抗的话,来进行对抗审核的话,他就往往啊就能够提出很多很正确的意见啊,帮你的内容呢朝向更好更更好的方向去发展啊,差不多就这样的一个过程。 总之呢,其实在 cloud code 的 内部,它其实也是广泛应用啊,一些双 a 对 抗这个策略呢,去约束它内部的这个行为啊,这点确实是,呃,很有意思的一点啊,也是我觉得是一个性价比很高的一个策略啊,因为它其实并不会特别复杂啊,但是它能够显著提升你当前 agent 的 这样的一个这个效果,哈哈,是这样的一个情况, ok, 好, 这个呢啊,是关于安全是怎么做的, 那么紧接着还有最后一个问题啊,就是关于他的这个知识商增怎么去解决?哎呀,这个知识商增呢,其实是个非常呃困扰大家的一个这个问题哈,就比如说, 那我们现在啊,假设开发一个项目,呃,这个开发这个项目使用 qq 的 开发一个项目啊,那么呃,前一两千行代码写的可能还是比较顺利的啊,也不会出现什么知识商增的这样的个问题啊,反正就是代码也不是特别多啊,大家一看也能明白是什么样的东西做的呢,可以说是又好又快。好,那接下来 这个两千一两千行代码到一两万行代码的时候,哎,你会发现管理就会很混乱啊,一会我这个 a a 阵子就记不得之前的这个信息了啊,一会这 a 阵子 忽略了某些信息啊,给我堆出一个十三代码,然后呢一会啊,这个呃,这部分修改了之后,关联的那部分也没有修改,等等等等啊,就会出现很多很多这样的问题。而如果进一步的到十万行,到这个一两万行,到这个一二十万行代码,这就更加复杂了。 所以呢,其实现在啊,我们在使用这个 agent 在 进行这个开发的过程当中啊,其实很多时候都会遇到啊,他这个知识双增的这样的个情况,那么对于 cloud code 来说也是类似的啊,那么用户在使用 cloud code, 当然他自己其实是个工具啊,他并不是这个项目本身啊,对 cloud code 来说他是个工具,但是呢,这个这样的工具必须要给用户提供 应对,非常复杂,大规模知识商增这样的情况怎么样?很好的去控制你接下来未来 agent 的 长期这样的运行,就比如说我项目可以很复杂啊,对吧?你可以是一个一二十万行代码这个项目,但是对于 agent 来说,你得有能力去解决这个项目啊, 你不,你不能说这个,我,我上来这个上手这个项目就是一团糟啊,乱七八糟啊,然后呢?这个,呃,也也搞不清楚上下文什么啊,然后呢?也写不明白啊,这可能就不行,那么要做到一个围绕着巨大的这个知识体系来进行管理哈,来进行内容输出啊,代码也可以把它理解成是内容生产的一个缓解嘛, 来进行有效的啊,这个内容输出的话,那么其实对于你当前 a 阵的架构就会提出很高的要求啊,这个其实不仅仅是说我需要有更强的这个模型,有更强的模型只是一方面啊,除之外呢,还需要有 harness engineering, 对 不对?约束好他,好让他好好的哎,去做这些事情啊。所以接下来呢,我们需要解决解决第四个问题啊,就是去看如何通过啊,这个 color code 内部如何通过这 harness engineering 呢?去更好的去实现面对知识商增这样的情况,他如何分文别类的来进行很好的这样的处理。 那么首先哈,我们说对于现在的这个比较复杂的任何比较复杂的任务啊,基本上肯定都不是一个 agent 来进行处理了啊,肯定是很多个 agent 来进行协调的这样的一个处理啊。所以呢,对于 carco 来说啊,他去应对啊,这个知识商增这样的个情况,应对比较复杂,大型代码的或知识类的这样的项目,那么他肯定也是会考虑啊,使用多个 agent 来进行运行。 那么在 cloudco 内部,它的 agent 的 运行模式,其实现在啊,总共是有两种模式啊,一种呢叫做 sub agents 模式模式啊,一种呢叫做这个 agent teams 模式啊,这两种模式其实是不一样的。那么所谓 这个 sub agents 这样的个模式呢,在 cloudco 的 内部,它的这个运行的逻辑是,它会把这些 agents 把它看成是呃这个主 agent 的 一个可以调用的工具啊,它它它它 agent 当然是可以是一个工具了啊,对不对? 那么它如果我的 sub agent 作为主 agent 一个可以被调用的工具的话啊,那么接下来我在运行的过程当中啊,这个过程其实就会呃非常的简单,对不对?我需要它, ok, 我 调用它,然后给它,给它输入上下文,然后它就进行运行就可以了, 那么这个时候 sub agent 跟主 agent 是 不会共享上下文的,那么 sub agent 它不管运行了多少,它最后呢就会把它最终运行这个结果提交给原来的主 agent。 举个例子啊,比如说 大家都知道,对于现在的 cloud code 来说啊,它有这个非常强的呃这个 deep research 这样的能力,对不对啊?非常强的这个呃深度调研的啊,广泛来进行一些搜索这样这个能力。但是其实在呃这个 呃 cloud code 的 内部,这个 deep research 是 由一个单独的 agent 来完成的啊,只不过呢,这个 agent 是 一个 sub agent 啊,它呢是能够被工具呢,能够被各个不同的 cloud code 来进行调用啊, 么样的一个这个情况,也就是说当你如果你需要围绕一个东西来进行深度调研的话,那么这个时候呢,主 agent 啊,实际上是会给一个 sub agent 啊,去发布这样的命令,让他呢去调用自己的网络工具来进行海量调研,调研完了之后呢, ok, 把信息在汇总给你。原来的 agent 是 这么样的一个过程, 当然除了啊这个,呃 sub agent 啊,呃,除了这个 deep research 这样的 agent 之外呢,其实对于 cloud code 来说,它还有很多内置的一些这个 agent 啊,还有这个 plan 啊,它也是一个 agent, 等等等等。 那么不同的这个 agent 啊,它和你现在用的这 cloud code 之间唯一的区别就在于说不同的 agent 呢,它可能它的这个上下文哎,就是 agent agents 点 md 呢,这个东西呢,是不一样的啊,你可以这么来进理解啊,只要它的 agent 点 md 是 不一样的啊,或者它的这个 cloud md 是 不一样,那么它呢在运行的过程当中所调用的上下文,其实就跟你是不一样的啊,你可以这么来进理解,那这个时候呢,这个 agent 啊,就是个全新的一个这个 agent, 这个呢是第一种模式叫 sub agent 的 模式,那么说实话还有种模式啊,是呃,在呃这个今年年初啊,伴随着 cloud 四点六啊,这这个这一系列模型发布的时候呢, anselp 一个主推的一种新的这个模式啊,叫做 agents team 这个模式, 当然哈,这个 agent teams 这个模式呢,其实现在也被称为叫做这个呃,这个 agent swarm 啊,这样的个模式啊,对不对啊?这个 a, 呃,刚刚我们说了,这个子 agent 呢,跟父 agent 呢,它之间没有上下文共享啊,这个我们刚刚也说过了, 那么第二种模式呢,叫做这个 agent 子 agent teams 这个模式啊, agent teams 这个模式呢,它呢其实就不再是这个副 agent 的 调用子 agent 的 这样的一个这个这样的一个这个过程啊,那子 agent 也不是说以工具这样的形式被副 agent 的 调用 它的所谓 agent team 四个模式呢,实际上所有的 agent 呢,都是平等的啊,都是有一个自己维护的独立的上下文的啊,然后呢会有一个主 agent 啊,通过对话啊,去调用不同的这个子 agent 来完成对应的这个事项。然后呢这个子 agent 呢,跟跟主 agent 的 之间这样通近呢啊,实际上是只会发送结论啊,但不会发送上下文。 那么通过这样的个方式其实也是能够很好的去进行不同 agent 的 分门别类的上下文的这样的管理啊,以免上下文交叉啊,所带来的这个呃知识的商增啊,或者这个这个行为轨迹的这个爆炸呀,类似这样的情况。并且呢,目前来说对于 cloud code 来说,它 只有啊一个呃,它它的这个 multi agent 的 这样的模式啊,觉得 agent teams 这个模式啊,只有一种架构的方式,就是一个主 agent, 然后连接一系列一系列的这个 agent 啊,一系连接一系列的这个 team mate agent 啊,就一系列的队长啊,剩下全部都是队员,队员, 然后呢队员跟队员之间啊,是不能够相互通信的啊,然后呢队员跟队长之间啊,是可以相互通信的,所有的工作或者所有的结果都是由主 agent 啊,去给各个不同的子 agent 来进行分发啊,它目前呢是这么两种模式,那么为什么会有这两种模式出现哈,其实也是基于现在的 cloud code 啊,他们可能长期的这个实践 啊,之后最后得出来的这个结论啊,就是会发现我们刚才的啊所说的这两种模式啊,这个是我们刚刚所说的第二种模式 发现。哎,这两种模式呢,其实是最呃能够结在这个确保稳定性的这个情况下去节省 talkin。 而其他啊,大家也知道有很多的一些这个,比如说现在这个 multi agent 呢,有很多的这样的架构,对不对啊?刚才这个架构呢,是一种指挥官式的这样的架构,一个 agent 连接多个 agent 的 这个架构啊, 除此外还有啊,类似于这个蜂巢这种架构,很多 agent 呢之间呢都可以彼此相互通信的啊,这样架构像这些架构呢,目前还没有去集成啊,他也可能也是觉得说这些架构呢,可能运行起来目前来说还不是很稳定。 那么通过啊,我们现在的啊这两种基本的这个模式呢,可以说 cloud code 啊,就能够解决在不同场景下使用不同的 agent 的 一个基本的这样的一个流程,但是呢这个流程还不够啊,我们这个流程,其实所有的咱们的用户啊,只要你使用了这个 cloud code, 都能够感受到 有这样的一个这个流程,那么除了啊有这个流程之外啊,我们说对于 cloud code 来说呢,它还有非常强的一个 talkin 的 一个管理的这样的一个机制啊,哈哈,这里其实就涉及到啊,非常有趣的一个点啊,就在于说有很多同学经常说啊使用 cloud code 啊,这个 talkin 爆炸啊,是吧啊,这个这个动不动这个 talkin 就 不够用了, 哎呀,但实际上 talkin 已经尽力了啊,因为它在它的这个系统里面其实已经有非常非常多啊,这个关于如何去 啊,如何去节省,你当哎,不好意思啊,如何去节省你当前的这个呃 token 的 一些这个措施啊,但是呢仍然啊还是会面临着啊,大家经常会使用这个 token 的 时候感觉 token 包大这样的这个情况啊,当然这个其实也不是很重要啊,重要的是我们需要去看啊这个 anselpik, 那 他们的 cloud code 是 怎么去尽力去节省你的这个 token 啊?那么懂了我们刚刚所说的他们这两种 cloud code 啊,这样的 agent 分 配机制之后,我们接下来看啊,它是怎么样去很好的去啊,把控你现在整体的这个 agent 消耗的。 那么首先哈,我们说刚才的这个副 a 证跟子 a 证的上下文隔离啊,这个呢,其实呃就能够很好的去这个呃避免啊它上下文交叉感染,然后同时也能够去避免单个 a 证过长上下文的这样的一个问题。当然最最最最精彩的实际上是这款就是 关于它的共享 talkin 经济学,哈哈哈。啊,什么叫共享 talkin 经济学啊?这个是什么样的一个意思?那么我们都知道啊,现在对于一个 agent team 的 这样的一个系统啊,实际上你的 这个 agent 呀啊它长什么样的都有啊,对不对啊,我各式各样的这功能的 agent 都有啊,那呃, agent 一 号啊,一号跟 agent 二号啊,它们呢,或许有一些内容是一样的啊,那么或许有些内容呢也是不一样的啊,有的时候呢,这个啊,它有一部分啊是重叠,有一部分也是不重叠的, 那么在这样的一个基本的的这个形态下啊,其实呢, cloud 内部,它会有一个非常巧妙的一个这个分辨啊,它呢会把所有的 agent 稳定的缓存的一些指令区都是共享一套存储策略,你可以这么来理解, 就相当于是一个模型,它运行的时候呢,它有一个快照啊,然后呢从这个快照的时间节点开始啊,那么接下来或许会分呃,或许会分化为很多不同的这个 agent, 那么在这个快照内部,它们的记忆是完全一样的,只不过呢是基于这个快照这个点哎,有的 agent 输入了 a 指令,有的 agent 呢输入了 b 指令啊,然后有的 agent 呢输入了 c 指令, 那么在这快照之前,它们其实保存了同一个这个模型,那么它们通过输入不同指令之后呢,才演化出不同的模型去维护不同的线来进行服务啊,你可以这么来进行理解啊,所以呢,它会在里面,它会在整整个 agent 运行内部去构建一个啊,所谓叫稳定区 的一个全局缓存的这样的一个东西啊,这里面就是会保存所有的 agent 啊,大家共有的相同的这样的一些这个内容啊,然后同时呢, 每一个 agent 都是在全局缓存的稳定区基础上啊,加上一些自己动态的一些这个指令啊,或者自己不一样的这样的一些这个东西啊,然后呢再构成它的上下文啊,咱俩进行不同的这个响应啊,以此呢去构成啊,它的一个提示词这样的一个缓,类似于像提示词缓存的这样的一个机制,去节省它整体的这样的 talk, 其实哈所谓提示词缓存也是这样的过程,对不对啊?就是我们在调模型的这个时候呢啊,你有的时候输入的后面这个提示词呢,跟之前提示词一样的,有些提示词呢,是已经加载到你当前上下文里面之后啊,已经加载到当前上下文里边了,你接下来就不用重复来进行加载啊,这个这个过程其实跟 cloud code 的 内部所建立的啊,所谓这个稳定区跟动态区呢,基本上是 啊差不多的这样的一个这个状态,然后对不对啊?他他有很多的啊,这个这个稳定区指的是什么啊?什么基础指令啊,工具定义啊,全局规划呀,这个都他他不会在绘画中这个反复的变化的啊,都是稳稳定区内容啊,然后动态区指的是绘画特定上下文呐,这个环境状态啊,用户的不一样,这样的个指令啊,等等等等啊, 会有这样的一个这个方式,那么通过这样的一个啊, fork 共享这样的一个方式哈,它呢其实比普通的啊,这个 agent 如果我们在进行多 agent 运行的时候呢,它的这样的状态呢,其实会节省非常非常多的这个成本啊,这个呢,其实是它开源了之后有很多人在进行计算啊,计算它现在内部的多 agent 的 协助过程当中所消耗的 talk 的 这个成本 差不多啊,五个子 agent 约等于一个额外的 agent 的 这个成本,呃,这个五个子 agent 约等于一个一个额外的 agent 的 这个成本,它并不是说我增加了五个 agent, 然后呢就跟一个 agent 的 成本是一样的,不是这样的啊,它指的是如果我额外增加五个 agent 啊,那么就跟,我,那么就跟啊这个呃,在我们现在的这个共享缓存的这样的个 之下啊,那么呢这五个 agent 这个成本差不多能够降低百分之八十啊,你就这么来进行理解就可以了啊,那么这个呢是关于现在的 cloud code 啊,它的内部提示内部的啊,这个提示缓存的这样的一个这个技术啊,那么这个这项这个技术呢,实际上在它内部的这个实现,实际上非常的这个巧妙哈, 完整的这个实现的内容在啊,我们的这个呃题日词缓存的啊,这样的个 t s 文档里边啊,这个大家回头可以自己去看一下啊。总之呢,现在面对着多 agent 里边的非常复杂的啊,系统题日词,它也是采用类似题日词缓存这样的个技术啊,然后呢来进行一个 呃费用上啊,或者 talkin 上的这样的一个这个优化,那这个呢?好,我觉得也是。呃,这个这个功能其实属于一个非常进阶的一个功能哈,我们现在很多大家的这个普通的一些 a 智能在进行架构的过程当中,可能暂时都还用不到啊,这么复杂的一些这个功能啊,但但这功能确实也是我就觉得非常精彩,然后值得大家来进行一个学习的 这样的功能, ok, 好, 那么最后呢,还有关于啊,它的各种子 agent 运行这样的个模式啊,什么在呃县城内来进行运行啊,翼步后台来进行运行啊,远程执行啊,都是可以的啊,然后呢,这个进城内和翼步后台都是你可以操作的啊,远程执行呢,是需要放在 i s r t。 的 服务器上来进行运行啊,这个呢, 也都是 ok 的 啊,总之它的很多的 agent 呢,是支持不同类型的这样的个运行的模式的啊,然后呢,下面还有这个 mailbox 啊,关于它点对点通信的这样的格式。呃,这个的话大家可以自己去看一下哈,这个的话,它主要是些工程上的一些这个说明啊,我们就不展开说了。 那总之呢啊,其实它现在啊有非常多的一些对于当前 agent 的 一些提示词缓存的这样的一个这个技术,然后呢去减少你整个的在面对知识爆炸的这样的情况下,对不对啊,深层非常复杂,多 agent 的 写作体系的过程当中啊,减少整体的 talk 的 这个消耗,这个呢也是呃,我会觉得啊,非常精彩的一个这个实现, 当然最后我们还有一个啊,非常有趣的一个,哈哈。啊,也是最近啊很多同学这个热议的一个这个话题啊,就是关于说你的这个 apple pick 现在一不小心开源了自己的 cloud code 啊,那你的这之前发的那么多技术报告对不对啊,个个看起来都很厉害啊,你的技术报告在你的 cloud code 里面实现了吗?哈哈,这里其实是非常有趣的一个这个啊,有趣的一个 东西哈,首先啊,对 antalfa pig 来说,他的这次开源还是能看得出来他还是非常实诚的啊,因为绝大多数的他之前自己提的这些技术方案啊,在 cloud code 里面都有非常非常好的这个实现啊,教科书般的这个实现。比如说他 最开始讲的啊,这个 context engineering 啊,这个呢,是他去年十月份发的一个这个技术博课啊,然后讲他自己内部他自己的 context engineering 怎么做的,这个是对应的我们的整个的。呃 呃,这个 cloud code 的 架构解读第一部分啊,当时我们去讲的那部分的这个内容,对不对啊?这个呢,他技术报告里面提的内容哎, cloud code 里面都实现了,然后同时呢,他的安全与成本控制,就是我们三四部分讲这个内容啊,他在里面也实现了, 然后呢,多 a 证的对抗啊,他其实也有一部分的这个实现啊,只不过呢,他现在这个多 a 证的对抗没有他现在这个博克里面这个讲 那么强就是了啊,他博客里面说这个,呃,这个 g n 对 吧啊,生成对抗网络的三 a 阵的这个对抗的这样的一个这个形式,目前这个形式呢,在卡扣的内部还没有实现啊,但是未来呢,应该是会逐渐来进行这个实现的啊,这个大家若感兴趣的话可以去 看一下啊。然后同时呢,对于当前的 color code 来说,还有些同学会比较关注于说他现在啊,勇于他,其实,呃,尽管他这个泄密的是二点一点八八这个版本哈,但实际上这个版本里面其实有很多未来的功能,这规划啊,也能看得出来未来 color code 他 会朝哪方向去进行发展啊?就比如说像主要的啊,这个最为核心,也是大家最 看好的一个方向啊,是叫做主动式的这个 agent 啊,什么叫主动式的这个 agent? 这个说起来啊,这个这个说简单一点啊,感觉就像这个定时任务一样啊,就是他呢会这个定时来进行响应啊,但实际上主动式的 agent 呢,没有那么简单啊,他呢实际上是会主动发现问题啊,然后再来 主动的来进行处理啊和这个解决啊。那比如说我们现在去构建很多的开发很多项目,或者做很多的这个事情,你要用这个 agent 做很多事情啊,你往往是 先跟他说怎么做,做完了之后你跟他说你再检查一遍啊,他再检查一遍,检查一遍之后呢,你运行了一下,发现出问题,你跟他说, ok, 你 再写几个测试这个视力,然后他测试视力,测试完了啊,发现有问题去解决问题啊,然后呢你再不断跟他说啊,然后他就不断去解决各种各样的问题啊, 这个呢,其实是属于你问我答的这样的一个状态。而主动式的这个 a 阵呢,他呢其实会发现当前运行过程当中所存在的问题啊,或者他觉得他现在需要去解决的一些这个问题啊,会主动的向你啊来发起这个请求啊,会主动的去完成一下这个事项啊,这个呢,是所谓的这个主动模式啊, carras 的 这样的个模式 啊,这个模式呢,现在还属于规划的过程当中啊,这个呢,其实未来啊,应该会这个上健啊,应该又是一轮不一样的啊,这个 a 政策的使用范式的 这样的一个调整,那么除此之外啊,还有啊,这个什么循环的这个引擎啊,循环这个引擎应该很快就会上线啊,这个其实就跟这个 heartbeat 啊,或者是 crm 定时任务其实是比较类似的啊,就是这个,呃,以这个持续不断的啊,来进行一个运行啊,还有呢,关于这个,这这什么成本 感知让步等等等等啊,这个呢,其实是关于他的一个成本优化的这样的这个策略啊,指的是我提示词换成,如果换成特别久,但是始终没有用到啊,他可能就考虑把这个提示词换成给删了啊,这样的一些这个小的优化,这个点啊等等等等。 然后同时啊,它还有一些啊,这个呃,这个呢,其实主要是它的这个云端的啊,就是服务器上的这个 cloud code 的 一些优化的这个工作啊,这个呢,我们就呃不不 展开来进行讨论了啊。然后呢,这个 skills 的 这个显见的这个显示,这个其实是一个非常非常有效的一个功能哈,这个功能我相信之后上线之后呢,肯定也会对我们现在开发工作会有很大的这个很大的一个促进作用。那么对于多 呃工具啊,或者多 skill 的 管理啊,实际上是现在所有的 agent 都会面临的很大的一个这个问题啊,那么对于像多 skill 的 管理,之前有很多的不同的厂商些提出不同的这个方案啊,然后呢?呃,那么现在啊,对 anfropack 的 他们其实集成了一个更加前沿,他们也会觉得很有用的方案,叫做 skill 渐近显示, 就是在未来啊, clock code 在 运行的过程当中,你甭管你给它绑定了多少个 skill 啊,你给它绑定了一百个也好,它在运行的过程当中,它会根据我当前这个项目推进的情况有选择掉一些这个 啊,然后呢让他每次运行的过程当中去选择那样的这个 skill 这个时机啊,或者选择这样的一个 skill 的 这个时间点来进行一个缩短。好,这个呢是所谓的 skill 渐近渐近的这样的一个显示啊,它呢是能够去进一步的优化你当前每一个 agent 的 上下文啊,同时也能够提升 agent 的 响应速度啊。这个刚刚有同学问到说 cloud 为什么响应速度这么快啊?他代码这么多,为什么响应速度还这么快啊?这个,这个对吧?还有很多这方面优化这个措施啊,所以他响应的速度 啊,是这样的一个这个情况。 ok, 好 啊,这个呢是关于啊他现在的很多未来功能的一些规划啊,当然还有一些这个有趣的功能,对不对啊?赛博宠物啊,赛博宠物呢,这个我们刚刚看过了啊,这个赛博宠物大概就长这样啊,大家可以自己看一下啊,这个呢就是 cloud code 的 一个这个页面啊,然后呢就输入这个呃,八底之后, 然后他就会给你整出一个呃,这个出来一个这个小宠物啊,差不多这样的一些功能等等等等, ok, 行,那这个呢就是关于整个的啊 cloud code, 我 们在今天有限的这个时间点时间里边啊给大家去讲解的 cloud code, 就 我个人认为非常精彩的一些这个架构啊和我觉得啊会对我们后边的啊,这个主要是非常进阶,非常顶尖的,大家来进行 the agent 开发的时候啊,一些这个启发,但是下面啊还有一些可以附用的一些 ai agent 开发的这个模式的一些这个表格啊,大家如可以去看一下,如果你们现在进行开发的时候有类似的一些需求的话,那么你可以考虑参照 cloud code 啊来进行实现。然后同时呢关于 cloud code 啊,其实我们之前没有讲过的一个点呢,暂时说有很多同学会呃比较 关注于说,哎,我现在有拿到克拉扣的这个原码,之后怎么样来接在在本地来进行一个这个部署,对吧?啊,那么首先好,我们说克拉扣的你是可以在本地来进行一个这个呃 build 来进行一个部署的,那么我们再给大家参考资料里面其实有啊,这个是没有什么问题的,但是呢,你的实际的运行过程当中仍然还是需要访问远程的 ansore pick 的 这个模型的这个服务啊,才能够来完成响应和完成认证啊。当然如果你是使用国内的模型的话,可能就没有这样的一个问题,这是起的这是一个, 第二个呢是呃这个东西哈,你最好用的话还是这个呃低调一点啊,因为他确实不是一个 呃完完全全的符合版权的这样的一个这个事情啊,这是为什么?我公开课可能没有去讲啊,拿着原码怎么去进行这个部署,跟本地运行的非常核心的一个这个原因不太适合啊, 这么公开这个场合啊,大唐起鼓的,我们来讨论这样的问题啊,但是呢,我们出于学习的目的,对不对啊,好好的研究一下内部的这个架构啊,给予我们未来开发的一些这个启发啊,以及呢积累一些这个经验。哎,这个还是非常不错的啊,这是没有什么问题的。所以啊,这里啊他有这个八个架构模式啊,如果大家感兴趣的话啊,可以考虑啊,去进行一些 啊,进行一些这个选举啊,或进行一些这个实现这八个架构模式基本上也就是啊,我觉得我们在读完啊 cloud code 的 这个架构之后哈啊整个的这个原码之后,最核心的一些这个启发啊,首先第一个分层降级防御策略啊,第二个呢,分层知识注啊,第三个知识商的这样的一个管理啊,认知商的管理,对不对啊?这个后台做梦啊,整理记忆 啊,还有什么众生防御啊,这个双 ai 对 抗啊,还有感知缓存架构啊,还有这个编排者模式啊,编排者模式,我们刚刚说的这个 multi agent 啊,一个主 agent 分 配多个 agent 来干活这样的个模式。 然后呢还有这个能力边界啊,既架构边界啊,等等等等这样的一些这个模式模式啊,这模式下面都有对应的他的一些这个啊使用的方法和对应的这个方案啊,大家如果感兴趣的话,可以自己去看 下。然后呢我在我们前文里面也都给大家指明了对应的不同的这个方案里边啊,他对应的这个原码的位置啊,大家可以去看一下。总之呢其实对于这个原码来说,你是很难 这个啊,通读的啊,这个其实非常非常困难啊,你只能够根据说 ok, 我 们现在啊,可能大家提炼出了一些比较好这样的模式呢,顺藤摸瓜啊,然后呢来进行一个读取啊,来进行学习,来进行借鉴, 好,那么到这啊,关于 cloud code 啊,它的一个源码的一个这个解读啊,我们这里是拎出了一些这个亮点,对不对啊的这样的这个解读呢啊,就差不多啊,告一段落了啊,我们就打一波广告, 那么也欢迎大家啊,报名由我跟沐雨老师啊,还有啊,还有志杰老师,我们共同来主讲的啊,二零二六大模型 agent 开智能体开发实战课啊,这样的一门付费课程 课程啊,是我们三位老师共同来主讲啊,是一门一百个小时以上的完整体系大课,那么今天我们其实讨论了非常非常多啊,关于大模型 a 智能开发相关的一些这个内容啊,当然我们今天讨论的呃,可以说非常难啊,非常复杂,而且很多都是行而上啊,都是一些理论层面上的啊,这样的一个这个东西, 那么啊,大家如果接下来想进一步的来进行深度的时间落地啊,或者你是想从零开始来学习大模型 agent 开发,就未来想要去参与到啊这个大模型 agent 技术岗位当中去的话,那么那么也非常欢迎大家啊,报名这样的一门啊,由我们三位老师共同来主讲的大模型 agent 的 开发实战课, 那么课程是一百个小时以上的完整体系大课,能够帮大家零基础入门,然后直达目前顶尖大厂大模型 agent 的 开发中高级岗位能力要求的这样的一门课程, 那么这门课程啊,其实我们现在已经开设到第二十四期了哈,这今年的这个春季班啊,已经是第二十四期了,我们从二三年的这个五月份啊开设第一期到现在啊,已经 这已经是将近三年的啊这个时间了啊,三年的时间里面已经也是有两万多名的学员报名了我们这样的一门课程,也有非常非常多的学员啊,现在是已经是加入到啊我们大魔仙 a 智能开发的这样的一个技术岗位当中来了,那么这门课程呢,是可以帮他零基础入门来进行的学习,然后呢可以全方位淬炼大家 大模型 a 证的开发的啊能力的技术体系啊,那么这本课程是可以帮大家零基础入门,然后直达目前顶尖大厂的五十万年薪的大模型 a 证的开发岗位能力要求的 这个五十万年薪啊,这个我们不是随便说说啊,我们也不是随便糊口的个周了一个这个数字出来啊,是因为我们团队其实也是在进行大模型 a 证岗位这样的招聘啊,我们 课程里边讲解的内容就是我们团队的岗位的要求啊,那么那其实我们今年金三银四的内容就是我们团队的要求啊,那么那其实我们今年金三银四的学员群里先 已经进行了很多轮的这个招聘啊,我们招聘要求非常简单啊,大家只要是学了我们的课程啊,学了百分之六十到百分之七十以上啊,就可以啊加入到我们公司团队里面啊,来进行一个这个工作了啊,就可以顺利的拿到大模型 a 证的开发的岗位的这个 offer 了啊,所以呢,我们这样的一门课程是完完全全严格按照目前顶尖的 大厂的技术岗位的要求呢,进行的内容的设计。那么这门课程啊,总共呢是六个模块,我们先给大家看一下啊,现在这门课程完整的课程介绍。 首先啊,第一个模块呢,是来会讲解啊,关于现在顶尖的大模型的一些基本的技术入门啊,包括顶尖的在线大模型的 a p i 的 接入使用,本地开源模型的部署和使用。然后呢,智能体 a 证的开发的理论基础和基本开发工具,然后呢, rack 解锁增强技术啊,开发入门等等等等啊,这是第一阶段,然后第二阶段我们会进一步的来探讨啊,关于热门的 a 证的开发框架的上手实战啊,包括一些零代码啊, d 代码的开发工具啊,像这 codes, define, 还有 n 八 n 呐,也包括那一些顶尖的 rack reg 框架啊,主要是拉玛 index 啊,在开发时代也包括新兴的 agent 开发框架时代啊,像这 agent sdk 啊,还有 agent school 啊,还有 adk 等等等等。然后同时啊,还包括工业级的 agent 开发框架啊,这主要是 long chain and long graph, 那 么这个当然是我们会准备主讲啊,这样的开发框架,那么刚刚啊,我其实 弹幕上啊,有同学在问到啊,说啊,我们能不能够使用 long chain 来复现一版的 cloud code 呀等等等等啊,其实我们课程里面已经使用 long chain 就 复现了一版 open cloud 了啊,然后呢,我们课程里面也有啊, cloud code 的 这个复现啊,只不过呢,使用 agent sdk 去进行的这个开发。 然后呢,当然底层开发思思路其实是一样的。好在我们课程里面啊,我们会从头跟大家去讲啊,关于最新版 long chain 应该做出来进行使用啊,然后呢,如何啊?去复刻这些顶尖的这个,呃, agent 啊,就是这一些像 open cloud 呀,还有 cloud code 呀,这一系列 agent 复刻的这个核心的思路啊和方法 啊,同时第三个第三个板块,我们会进一步来讲解啊,关于工业级的 agent 开发境界的这个技术,包括智能体的内部的啊,多工具的管理呀, m c p 工具的这样的一个使用啊,包括啊,这个 agent, 呃, reg 进阶的这个技术实战呢,包括纯文本的解锁优化啊,包括图文混排的 pdf 解锁啊,多多多模型的 pdf 解锁,结构化数据的解锁和 graph reg 基于知识图谱的解锁啊,还有视频信息解锁等等等等。 那刚刚啊,就有同学问到啊,说我上下文特别特别长啊,然后呢,呃,我们怎么样啊,去这更好的去读取啊,或者是去获取上下文这样的信息啊,那么要么你就是进行 compact 啊,压缩对不对?要不的话,你可能就是采用 reg 技术啊,来进行更高精度的这样的这个解锁。 好,那么再往下啊,还有关于智能体长短期记忆的这样的管理啊,和智能体上下文工程,这都是构建我们智能体直观重要的相关的这样的技术。再往下啊,还有关于多智能,多智能啊,记忆多智能 某体 agent 的 系统开发啊,对不对?然后呢,像对于现在的啊,这个 cloud code 来说啊,它呢其实只有一种啊,这个某体 agent 的 系统就是所谓的 supervisor 这样的架构,一个主 agent 不 负责干活,负责分配活啊,剩下很多的啊,这些 agent 负责来进行干活。 那么除此之外啊,我们说其实还有啊,像这 handoff 的 这个架构,还有这个 router 架构啊,还有 network 架构等等等等啊,有这四种主流这个架构,那么这些架构呢,都会在我们正科里面啊,来进行讲解介绍。那么 再往下啊,还会包括啊,会讲解关于大冒险高效微调啊相关的这样的内容啊和呃,紧接着啊,我们这这个呢,就是我们第三个模块内容啊,第四个模块呢,我们进一步来讲解关于工业级的大冒险 a 阵的部署上线啊相关的一些这个内容,包括 啊,像智能体项目部署上线的这个基本理论啊,包括智能体开发部署上线全部的这个流程对不对?好,从最开始的前后段功能设计啊,到这个接口的这开发啊,到前后段的连调,到最后的项目上线,一整个完整这个流程啊,然后也会来讲解关于两大的 容器啊,交啊,两大容器化啊,这个交付工具这样的实战啊,主要是刀口跟 kbs 的 这样的使用,同时也会来介绍关于智能体的追踪和优化相关的这样的内容。 同时这门课程我们呢现在总共呢还有啊,总共呢是十大项啊,工业级的这个实战的这个案例啊,分别是长文档啊,定制化文档编辑 agent 啊,然后文档审核 agent 啊,图文视频 agent, 语音交互 agent 啊, deep research agent 啊,然后呢数据分析 agent, 然后啊数据分析格式化 agent 啊,垂玉的 agenta reg 系统啊,多模态 reg 本地知识库解锁系统啊, nintendo pro ppt 生成系统啊等等等等,然后同时还会有四大项, 这个百万用户级别的啊,这个商业化的项目,工业级项目实战啊,分别是企业级多模态啊, rek 支付解锁实战项目,然后全新一代智能客服 a 智能开发项目啊,其实我们所有项目都有对应的演示视频啊, 这这这演视频可能会比较长啊,我们这个啊就不展开给大家看了啊,大家可以自己登录我们的主页来进行观看,然后啊包括一比一复刻 mana 通用智能体的啊,这样的项目和啊这个 ai 编程啊跟数据分析 a 阵的开发项目。当然在我们的春季版里面,我们还新增了啊丛林去赴县 open club 啊这样的个项目,完整的相关的内容啊,那么在我们的这个春节班里面,我们是完整的大家去复现了一个啊,这个复翻 openclo 啊,这样的一个这个项目啊,然后呢所有功能呢,都会从零来进行实现啊,这个项目其实就是 呃使用 long chain 啊来进行的开发啊,在开发过程当中呢,我们就跟大家详细去介绍啊,它背后的核心的啊这样的一个理论知识体系。 那么除了啊这样的一门呃大冒险 a 型开发实战课之外呢啊,我们说还有两门课程啊,一门课程呢是 open core 啊,这个技术实战课啊,这门课程呢是由我来主讲的一门啊,这个总共呢是二二二十到三十个小时的啊,这样的 open core 智能 体的应用实战课啊,这门课程是目前是呃,我正在讲解啊,这样的一门联赛更新这样的课程啊,但这门课程其实主要就是来讲解关于 open core 啊,这样的 这个技术应用啊,实战相关的一些这个内容啊,那么 openclaw 这个定位呢,其实和呃 cloud code 还是有些区别哈, openclaw 其实是更加通用的一个智能体啊,它呢其实是更呃有更低的这个使用这样的个门槛,对不对?然后同时呢也能够覆盖更多的啊,一些实际应用的这样的岗位。 那么这个 openclaw 啊,实战课里面我们会给大家介绍各式各样不同类型的这个应用范式啊,和基本上所有工作的各个不同类型的应用范式啊,和基本上所有的课程呢。最后我们还会介绍目前四个 核心的啊,这 open 可捞商业变现的啊,一些这个流程啊,包括全自动的 ai 内容工厂啊,包括这个全自动的啊,公司网站运维和建设啊,包括这什么呃艺人公司的啊, ai ai 员工团队啊,如何进搭建啊,以及呢,包括垂雨 ai 自动化的啊,这个服务开发等等等等啊,这个呢是属于 open cologne 啊,相关的这个技术内容啊,但是 open cologne 其实是一家更加通用的一项啊,技术开发这样的工具啊,或者说一项通用这个智能题使用的这样的个指南,那么和我们刚刚大家所看到的啊,这个 agent 开发实战课其实完全不一样的方向哈,因为 agent 开发实战课其实是更加硬核的 这样的一门啊,这个主要是面向技术人啊,大家如果未来是想做 a 证的开发啊,来去量身定制的这样的课程。但是除此之外,我们还有第三门课程啊,是由木鱼老师来主讲的 web coding ai 编程实战课啊,这个课程,这个啊,重要性就不言而喻了,对不对?这个 web coding 嘛, 哎,这个,这个,去年我们这个时候啊,大家说 ai 编程可能会还会觉得比较早,早啊,时间还比较早,那么到现在啊,大家如果说自己不会 web coding 啊,这个,这个属于是古法编程啊,是不是啊,人类手工编程啊,这是属于非遗传承的这个技术 啊,所以现在我们基本上所有场景里面啊,我们很都会呃,会用到啊,这个 web coding 这样的这个技术啊,都会来进行 ai 编程啊,那这门课程呢,是沐浴老师来主讲的啊,一门可以说啊,已经是开设第二期的 完整的 web coding 的 体系大课啊,然后呢,能够帮大家零基础啊,零门槛啊,上手 web coding 这样的工具,然后呢,开始啊,你的 ai 编程之旅啊,这可以说是现在所有程序员必备的这样的技能了,我们 可以讲解啊,像 course code code 啊,这一系列 ai 编程工具这样的使用啊,然后我们也会来讲解啊,关于像 open code, 对 不对啊,这样的开源的 ai 编程工具,这样的这个使用啊,然后呢来介绍啊,关于 ai 的 skill m c p 啊,这样使用啊,和 像 figma 啊, pencil 来进行前端设计的一些工具啊,然后呢,像以及啊,像这个 openstack, 还有 superpowers 啊,一些非常有用的,非常实用的,能够提升你的 ai 编程的水准的啊,一些这个 skill 的 这个使用啊,也包括像现在 cloud code 啊,它的 agent teams 啊,多智能体协调来进行开发的一些这个方法等等等等。 那么这门课程啊,是由沐雨老师来去主讲的啊,一门课程啊,这个对不对啊?关于 ai 编程的这个重要性啊,这个其实呃已经是非常非常重要的哈,因为其实呃这个不仅仅是现在啊,像 anthonpick 啊,像在国外顶尖的大厂啊,大家是在使用 ai 编程,国内大厂也在用 ai 编程哈, 不仅国国内大厂在用 ai 编程啊,基本上所有的岗位大家都是在用 ai 编程啊,很就是除非一些特特定的这个情况啊,这可能还需要手工编程之外啊,剩下的 ai 编程呢,它已经是属于大模型 a 智能应用的啊,一个非常成熟的这样的一个领域了。 那么在这个课程里面,我们不仅会教大家啊,怎么样从零开始去使用这 ai 编程工具上手来进行 ai 的 编程外部口令啊,同时呢,我们也会 从头啊开始教大家啊,怎么样从最开始能写高质量代码,到做出 demo 啊,到精准的输出啊,到完成一整个完整的应用啊,到推送产品上线啊,到产品二十四小时的这个运行, 到最后啊,对不对啊,全站的开发啊,到运维的完整的这个技能体系啊,写在这么课程里面,我都会来进行详细的这个介绍, 那么刚刚我们给大家看到的啊,像这样的一个复饭,呃呃呃, cloud code 啊, web 这样的一个这个程序啊,其实就是我们当前这门课程里面给大家提供的一个应用的一个工具啊,这是其中一个工具啊,我们这门课程里面其实还很多其他的工具 啊,当然其实这门课程里面我们重点是来讲啊,像 cloud code 怎么样去用好它,去完成一系列的啊,这个开发的这样的一个项目。而啊这是我们的 agent 开发实战课,那门课程里面主要是会讲它底层的原理,一个呢是 进行使用啊,一个呢是底层原理的这个介绍啊,这个呢其实是各不相同,有所侧重的这样的点。当然对于 ai 编程来说,我相信很多同学可能也会有这样的误解,大家会觉得 ai 编程吗?有嘴就行啊,对吧?只要跟他说我要开发什么,他就能完成开发,其实并不是这样,哈哈,现在其实对于很多的 a 证的使用来说,还是有不小的这个门槛的话, 你可能还是需要掌握很多的一些这个技术,然后同时也得积累一些这个经验,然后才能够完成一些很好的产品这样开发。 大家现在看到的都是我们当前课程里边会给大家讲解的啊,一系列这个产品的这样的一个这个开发,那么这门课程啊,我们就会好好的跟大家来介绍啊,关于从工具的使用啊,到我们现在前沿的实践经验的沉淀和总结啊,一整套完整的 web coding 相关这样的内容。好,那么以上啊,就是我们这三门啊,付费课程的内容介绍啊。
1183九天Hector 02:14查看AI文稿AI文稿
很多人用 cloud code 大 半年都不知道它的终端里藏着一堆能直接拉满效率的隐藏命令,只会打字发需求,不仅效率低,还总踩坑。 ai 乱改核心代码绘画聊多了就跑偏,改崩了还不知道怎么撤回。今天一次性把 cloud code 的 十二个实用终端命令分三个梯队讲透,从新手入门到高手进阶,看完直接照着用。 第一梯队,新手零门槛必用,日常开发天天都会用到。 init 是 项目出土化神器,一键识别技术站和目录结构,自动生成标准。 cloud md 项目记忆文件,新开项目第一条命令就用它。 cap 就是 官方自带的命令说明书,忘了任何命令怎么用,直接输入它功能和用法,一键调出 clear, 可以 一键清空当前绘画记录,重置对话状态,换新需求,换项目,不用新开窗口,直接重新开始。 ios 一 键列出项目完整目录结构,不用手动翻文件夹,快速让 ai 了解项目全貌,也方便自己核对文件。第二梯队是开发高频刚需,也是最能帮你避坑的几个命令,建议直接背下来。地图是代码改动核对神器,实时查看 ai 改了哪个文件、哪一行什么内容,确认没问题再保存,避免偷偷改乱核心代码。 安卓就是改崩救星,只要 ai 改完代码不满意甚至改崩了项目,直接一键撤销上一次所有文件改动。 compact 是 上下文救星,绘画聊得越多, ai 越容易跑偏,它能一键精简,无效上下文,保留核心信息,让需求重新聚焦。 mod 可以 快速切换 plan、 edit、 esc 三大模式,比如输入 free mod, esc 就 能切到只问答不改代码的安全模式。第三梯队是进阶高手,私藏命令冷门一点,但在关键场景特别实用。 group 后面跟上要锁定的文件或目录路径,就能禁止 ai 修改这些内容,比如核心配置和底层依赖,杜绝乱改关键文件 reset 比 secure 更彻底,不仅清空绘画记录,还会重置项目临时状态。换项目时用它全新启动,不串旧上下文。 get, 可以 一键查看指定文件的完整内容。后面跟文件路径不用手动打开文件,快速核对代码内容, reload 会重新加载整个项目文件。如果你手动改了项目里的文件,输入它,就能让 colot code 同步最新状态,不再用旧代码干活。 这十二个命令覆盖项目初识化,日常开发还错避坑和安全管控没有花里胡哨,全是能实打实提升效率的干货。收藏起来,用的时候翻出来照着书就行。关注我,带你吃透更多 colot code 的 高阶玩法!
4193阿森编程日记(AI自动化) 01:49查看AI文稿AI文稿
大家中午好,我想了想,我还是要跟大家录一下,因为最近 codex 跟 anthropic 的 cloud code 真的 太火了,昨天晚上 openai 也发布了 codex, 现在已经可以直接支持谷歌的 chrome 以及 windows, 就是 chrome 在 macos 和 windows 情况下,呃,可以直接调用 codex 的。 我快速录一个视频,教一下大家怎么把这个功能激活。首先呢, 我们要打开最新版本的 codex, 如果不是最新版本的,可以在这里去检查 update, 就是 要确保更新到最新版本的 codex。 更新完之后,打开这个插件 plug ins, 打开这个插件, plug ins, chrome 的 这个选项就会出现了,点击这个 chrome 点击吧,因为刚才我已经点击了啊,可以直接点打开, 打开它会直接跳到你默认浏览器的这个 codex 的 激活界面啊,如果你默认的是 chrome, 就 会正常蹦到这个 chrome 的 界面 crom 蹦到之后直接点击艾特 crom 就 ok 了啊,因为我认为接下来会很精彩的。其实 cloud 大家能看到我的 cloud 已经支持了,就当我点开这个 cloud 的 时候, cloud 的 无论他调用自己大模型也好,还是还是 cloud code 也好,他可以直接操纵我的 crom。 那 现在呢,就是我把 code 也加入到 crom 之后, open up code 也可以直接调用我的 crom 吧。因为今天我想录这个视频的原因就是我认为接下来整个电商的搜索逻辑都会因为世界头部的几个大模型公司会带来天翻地覆的变化。 比如我现在自己日常的使用已经不用去打字了,我调用的是 tapis 会比较多,所以现在目前,哦,现在才五月份,我觉得其实 ai 的 风向已经调了好几次了。比如年初的 open code 火了一阵子, openclaw 就是 龙虾。 那其实我认为到现在为止了, open opencloud 的 风风口或者说营销热度已经完全消退了。那接下来就是 webcoding。 那 目前最主流的就是 codex 和 android 的 cloud code。 就是 cloud 的 code 啊。好吧,今天就跟大家快速录一下。我估计可能很多伙伴不知道怎么在 codex 里面去添加 chrome, 在 chrome 里面去激活 codex。 好 吧,那今天先这样,拜拜。
170凯文不要嗨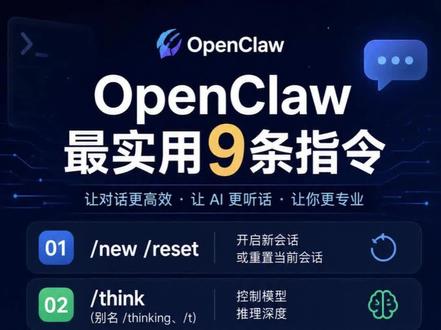 01:53查看AI文稿AI文稿
分享 open color 最实用的九条指令首先是杠 new 和杠 reset, 开启新规划,或者说重置当前规划。当我们需要开启一个新任务的时候,就可以用这条指令舍弃前面不相关的上下文来重新开始对话。第二个杠, think, 可以 用来调整啊模型的推理程度, 如果呢,你想让它去做一个深入研究的问题啊,那就可以调到 high。 如果呢,是做一个简单的问答问题啊,就可以直接 off, 省钱省时间。 第三个杠, compact, 压缩上下文,当上下文太长一出的时候,你就可以输入指令哎,让其压缩上下文,并且呢可以附带要求,比如说重点保留数据分析结果的部分啊,其余的简化他就可以按照你的要求进行压缩。 第四个杠, model, 查看或切换当前模型,直接在后面加上模型名称,即可快速切换到新的模型。第五个杠, btw 白泽位这是一个非常有意思的技能,打开一个题外化的问题,不会污染主上下文。 比如说你在做一个复杂任务期间,想问一下天气啊,就可以用这条指令,不会打断当前的对话,保留原来干净的上下文。 第六个杠, status, 查看当前绘画的运行状态,去看一下用的什么模型,剩下多少配额等等,非常方便。第七个杠, usage, 查看 token 用量和费用统计,每次回复底下都有 token 的 显示,我们可以在这里去调整。 第八个杠, tools, 查看当前 agent 使用的工具,有精简和详细两种显示方式,如果怀疑哪个工具没有被调用,可以使用这个指令,先看一下,非常的方便。第九个杠, context 查看上下文情况,想知道模型获取了哪些内容,或者 token 消耗异常,需要排查的时候,就可以用这条指令查看和排查好了,这就是我最常用的九条指令。
58言井AI职场提效 10:39查看AI文稿AI文稿
最近啊,我帮几个朋友看了下他们平时是怎么使用 cloud code 的, 结果发现大家踩的坑都差不多,比如说在 contacts 都快满的情况下,还在疯狂地向 cloud code 输出,甚至还问我他的 cloud code 怎么越用越笨,还有装了 skill 的 有没有用上都不知道。 那对于这种把 taco 用在刀背上的做法,我只能说一个字,绝。所以今天就给大家分享一下我自己使用 clotco 的 过程中的几个小技巧,听完包你满意,赶紧点赞收藏。当然,大家也可以在评论区分享一下自己的经验。 第一个,上下文管理这个道理啊,很多人都懂,但很少有人会注意到上下文污染的严重性。如果说你也有这样的毛病,我建议赶紧去看一下。前两周 cloud 发布的这篇关于绘画上下文管理的文章,里面讲的是非常详细的。 特别要注意的是啊,文章里面有提到,当上下文窗口开始占到百分之三十到百分之四十的时候,就会出现一定程度的上下文腐烂。这个其实对我自己也是有点启发的,你像我之前就是用到百分之六十可能才开始做一些上下文的管理,那现在可能百分之三十到四十就要开始做了。 那我平时做上下文管理无非是用到这三个命令,第一个, compact, 当任务跑了很长时间,进行过多轮的对话之后,使用这个命令,让他把前面的对话压缩成一个摘样,清掉容易的信息,只保留关键的,这样的话,你的 contacts 就 会变得很干净,他后续的表现也都会回归正常 我的使用习惯啊,同一个任务超过二十到三十轮对话,或者说我当前的上下文窗口已经占到了百分之五十以上,那我就会进行次压缩。 又或者说当我发现啊大模型开始回答一些奇奇怪怪的答案了,那我的第一反应也都会先去 compact 一下。第二个 clear, 那 这个相较于 compact 会更加的直接,把当前的对话直接清空掉,重新开始, 或者说你开一个新的对话窗口也是 ok 的, 这个适合一个任务已经完全跑偏,或者说你就想换一个新任务的场景。 对比的话, compact 就是 整理桌面, clear 的 话就是清空桌面重新来。那用哪个还是要看当前的任务有没有值得保留的上下文来决定呢? 第三个命令 by the way。 这个命令一般会出现在你不想去侵入当前上下文窗口的情况下去使用。举个例子,比如说你现在正在 web coding, 但是你又想到一个产品的逻辑上面会有点问题,就可以使用 by the way 去跟它进行讨论, 这个是不会记录在上下文的,或者说你使用 by the way 把你这一次的需求让它记录在某个文档里面。当你手头的这个 web coding 的 任务结束之后啊,接下来的任务你可以再调用原来记录下来文档里面这个需求继续展开工作。 那说完了我常用的这三个命令之后啊,还有些关于上下文管理的我的个人的使用习惯。第一个,引用文件的时候,指定路径和文件名,不要让大模型自己去扫描文件,扫描整个仓库,他有的时候如果找不到的话,甚至还会去写一个脚本去帮你去找到这个文件, 所以说这样的托克消耗是得不偿失的。第二个,我相信大部分人都会知道,长任务或者复杂任务的时候,用 plm 的 模式可以大幅度的减少托克的一个消耗。 第三点,尽量让 cloud code 完成一整个工作流,而不是一步一步的告诉他去做什么。因为 cloud code 是 非常强大的一个 agent, 你 给他一个超级复杂的任务,他也能从第一步到最后一步完美的给你执行出来。如果说你每一步都拆开,那首先上下文会变得非常长,那上下文一长,你的大模型就会出现幻觉,你的上下文就会出现丢失,被污染。 那讲完了上下文管理之后,接下来这个 prom 的 缓存本质上和上下文也有一定的关系,那我为什么会单独拎出来讲呢?因为它会直接影响你用 cloud 的 速度和成本,也是大家特别容易忽视的一个问题。 c c 的 一个 prom 的 缓存机制啊,如果说你上一次请求里面的内容和这一次请求的前缀是一样的, cloud 的 就不会重新处理那段内容,直接用缓存速度更快,托克的消耗也会大幅度的降低。 在 cloud code 里, cloud 点 md 的 内容和项目文件的内容在同一个绘画里面是可以被缓存的,但缓存会失效。最常见的失效场景有以下两种。第一个, cloud 点 md 这个文件啊,在 cloud code 的 缓存架构中是被视为一个整体的模块的, 由于它位于缓存前缀的中间位置,一旦你改了文件中哪怕一个标点符号,系统也会判定从 cloud md 这个文件的模块开始,到后续所有的内容,包括历史对话的缓存都会全部失效。 第二个,对话的间隔太长, cloud 的 缓存默认有五分钟的超时时间,超过五分钟没有新的请求,缓存就失效了。 如果说你再做一个任务,保持对话的节奏要比长时间等待更好,所以说每次离开之前先 come back 一下是最好的。理解这个机制之后,你就会开始有意识的组织 cloud d m d 这个文件的结构,让 cloud code 的 能够持续的用到缓存,整体的速度就会明显快一些,托管的使用量也会少很多。 那接下来第三块的使用小技巧,就是我自己平时经常会使用到的一些 skill。 skill 是 cloud code 的 可安装能力包,把一套提示词和逻辑打包成一个命令以后就可以直接调用。那我现在用的最多的就是以下几个。第一个, planning with fire。 当你有一个复杂的任务,不想让 cloud code 直接开始乱动,那就先用这个,它会把任务拆解成结构化的计划写进一个文件里,当你 review 确认之后啊,它再按照文件里的计划一步步执行。这个是我目前使用频率最高的,甚至说我所有偏复杂的任务都会先用这个 planning with file 的 这个 skill。 那举个例子,比如说我现在做 webco 顶,那原本开发的流程,可能说花一天时间去想一下架构,然后再花几天的时间去开发,那现在就反过来,我会先花大概几天的时间去跟他去跟 cloud 的 去聊我会怎么样去设计,然后聊的过程中去把这些我的想法全部记录到文件, 那之后我再做 webco 顶,让他去生成代码的时候,那整个的代码的结构,包括代码的约束,代码的规范都是非常工整的。 那接下来第二个 skill, 那 其实是一整套啊,基本都是偏向前端界面设计的,像 fronten design, 还有像 ui ux pro 这两个 skill 啊,还有一个就是我现在做视频基本上都会用到的 remotion skill 啊,都是我自己高频在使用的。 那这种是专门为前端界面设计调优过的 skill, 我 觉得对于很多开发人员来说,因为对一些 ui 的 设计都不是很 make sense, 我 觉得用这些 skill 可以 帮到你们很多,并且他们的官网也是提供很多的素材和模板 啊。再结合像现在的,比如说 stitch 啊这种圆形的设计软件啊,那我觉得再配合这些 skill, 那 可以起到事半功倍的一个效果。 第三个 notebook lm skill 啊,那对于这个 skill 我 原本是不怎么开始用的,因为像原来的 gmail 可以 直接去连到这个 notebook lm, 因为都是谷歌的全家桶嘛,呃,都能够直接去输出我想要的结果。但后来大家也都知道 gmail 降至比较厉害, 我发现我的结果就我的要求他不太能满足到了啊。后面我就尝试着把 nosbook lm 生成的结果给到 cloud, 让他去帮我进行接下来的任务执行啊,效果也非常的好。然后到后面也发现现在是有这个 skill 的, 那我就直接拿过来用了。 第四个 everything cloud code, 那 这个 skill 汇总了 cloud code 的 目前所有功能的一个用法,相当于一个随时可查的内置的使用手册啊,不确定某个功能怎么用的时候,你就可以直接调用它,比翻原本的官方文档要快很多。 那这边有一点要说明啊,这个 skill 会比较消耗托肯啊,你一定要去关闭它的一些 mcp 啊,你哪怕关了的话,它的托肯消耗也是会比较大的。那如果说没有碰到一些复杂的任务,我觉得是用不上的,但是整体的质量还是非常好的。 第五个, superpowers, 那 这个也是老朋友了,我相信很多人都在使用这个 skill, 那 这个 skill 对 我来说最重要的一点就是它的脑爆啊,这一个技能。 呃,而且这个 skill 是 非常适合小白的,因为它是包含了一整个完整的软件工程的,一个生命周期的一个 skill 的 一个全集啊。所以说,如果你是小白,刚刚入手 web coding, 我 觉得你用这一个 skill 就 足够了。 第六个,卡帕西的这个 skill 啊,那这个 skill 我 觉得是相较于前面 superpower 和 everything, cloud code 的, 它更像是一个靠谱的资深工程师啊,它会强调先清楚再动手,不乱猜啊,能简单的就不要搞得太复杂啊,改动都是以最小的成本去改的,而且每一步都是尽可能的去做验证, 所以说啊,它特别适合去修 bug, 改老项目,做一些重构。那接下来第四块, hux 啊,那 hux 的 定义的话就是钩子啊,它允许你去自定义一些触发器啊,在卡拉扣的做完某件事情的时候,会自动的执行一段啊,你所定义的无论是脚本啊还是命令, 那我最常用的三个场景,第一个,我每次让卡拉扣的修改了代码之后,就会自动的去提醒,也不用担心它改完之后代码的格式会乱掉。 第二个,任务结束的时候自动发通知啊,比如说你在跑一个时间比较长的任务啊,那你可以去做别的事情,那任务完成的时候可以触发一条系统通知到你的手机上, 那为什么会举这个场景呢?啊?之前在用 open call 的 时候,因为像 open call 它本身可以去调用 call 的, 但是它怎么去监控 call 的, 它会一直去用轮询的这个方式去做,会非常的消耗 token。 那后来我就自定了一套我让 openclaw 去触发 claw 的 code, 之后我通过 claw 的 hook 去回调来通知 openclaw, 使用这样的方式之后啊,就可以减少掉不少的 token。 第三个场景,那像工具的调用前后会去自动的记日制啊,你想知道 claw 的 在一个任务里面到底做了什么,那 hux 就 可以帮你在每次工具调用的前后去协调日制,任务结束之后就能够看到完整的执行过程。 第五块, cloud code 的 插件,那说到插件啊,前面提到的像 skillbox, 包括没有提到的 mcp, 其实都可以揉在一块成为一个自己的插件 啊,所以我说我这边就分享我经常使用到的三个。第一个 cloud hard 啊,这个的话可以去实时的监控你自己套餐的一个使用量啊,包括你目前这个 session 的 上下文的一个情况啊,再配合前面上下文管理的一些方式组合起来,那效果是非常的好的。 第二个 figma 的 mcp 啊,那这个很适合前面讲的 fronten 的 design u i u x skill 啊,特别是如果你在工作中啊,你们的产品用的是 figma, 那 你直接可以通过 mcp 的 方式直接把设计搞给搞进来啊,从设计到实现会剩很多。 第三个三 tree, 那 这个也是 mcp 啊,这个比较适合去排查线上的 bug 报出错来以后啊, cc 能够更快地结合异常的信息对账和上下文去定位问题啊,可以省掉自己去翻半天的一个日记。 ok 啊,那以上就是关于本次我自己在使用 calco 的 过程中总结出来的小技巧的一个分享,希望能对大家有所帮助。如果说你看到了这边,证明你是一个非常求学的人,在此我也希望能够得到你的一箭三连和关注。那本期的视频就先到这,我是布鲁,我们下一期视频再见。
3.5万布鲁404
