你的 harmless agent 在 执行任务的时候,是不是经常出现任务中断或者跑偏的情况?玩转 harmless go 这个技能将解决这个问题。大家好,我是香豆,前三期视频为大家分享了 harmless agent 零点一八版本的三个核心功能, moa 模式、 n 技能和 journey 技能。 今天这个视频将为大家分享零点一八版本最后一个重磅功能, go 持续目标技能。 我们将从下面四个部分为大家讲解 hermesgohermesgo 的 核心概念, go 的 常用的配置和使用技巧,不同应用场景的应用示范和针对程序员和工作流的高阶使用技巧。那首先我们来搞懂 go 的 核心工作原理。 我们大部分 hermes agent 的 用户都会遇到下面三种情况,第一种是当我们执行复杂任务的时候,我们的 hermes agent 经常会出现中断的情况,我们只有给 hermes 发送继续完成或者继续做的指令之后,他才会继续地执行,而且我们需要全程的人工进行盯守, 就像大家经常在视频网站上看到的,程序员坐在电脑面前刷着视频,盯着 ai 智能体进行工作。第二种情况,对于复杂的任务, harms agent 在 多轮对话之后可能中途会跑偏,遗忘掉了我们对任务的要求和核心的约束条件。 第三种情况,如果我们关闭了当前的对话或者重启了 harms 的 进程,那我们的任务就会完全的中断,我们只有从头开始执行。所以为了解决这个问题, harms agent 的 作者专门开发了 go 这个功能。 那什么是 go 呢?其实 go 就是 持久自主执行目标的一个功能,它和传统的对话有非常大的区别。我们传统对话是我们问 ai 答,在每一轮对话结束之后,这个任务就会中断,我们只有增加新的要求指令之后,它才会继续执行。 那 go 模式呢?我们只需要设定我们的目标, ai 智能体会自动的执行,并且自动的判断是否完工, 几乎不需要人工的指手。其实 hermes agent 的 go 的 功能在零点一七版本就已经更新,但为什么豇豆在零点一七版本的时候没为大家进行讲解呢?因为那个时候 go 的 功能还不是非常的完善。 在零点一八版本更新了 moala 模式、并行调度功能和自动降权功能之后, go 这个技能才能够完整的发挥。当我们把 moala 技能和 go 技能进行组合的时候,才是全自动执行任务的王炸组合。 harmsgo 采用的是工作模型加裁判模型的双模型循环的任务执行机制。首先在执行层, harmsgo 可以 配合我们前期设置好的专属默啊 路由模式,让我们的主模型拥有完整的文件终端外部工具调用的权限,负责拆解目标分布,执行修改文件、运行脚本并输出中间的结果。 harms 还特别设计了一个判定层,也就是说我们在判定层设置我们的判定模型。我们通过独立轻量化的辅助模型,它只做单向的判断,对比当前执行结果与原始目标输出已完成和未完成,我们的裁判模型不参与任何任务的执行, 每一轮执行结束都会自动进行调用,那通过工作模型和裁判模型这种双模型循环执行加监督的模式。通过工作模型加裁判模型这种双模型循环的工作机制,让 harms agent 在 任务自动化运行这块儿比大部分的 ai 智能体 的执行效果都好很多。好,接下来为大家讲解 go 功能的完整的执行流程。我们的 hermes go 分 为五个执行步骤,首先是下达任务目标,我们的用户通过斜杠 go 加上我们具体的任务描述来对 hermes 进行任务目标的一个下达。当 hermes 收到我们的任务目标之后,我们执行成的主力模型就会自动拆解任务并分布去执行任务。 在执行任务的过程中,每个子任务都会去调用相关的工具并进行结果的输出。第三 步,在每一轮子任务执行完毕之后,他会自动调用我们的裁判模型,对每一个子任务的执行结果进行一个叫验,并对我们的执行结果是否达到目标进行一个判定。当我们的裁判模型发现我们的任务并没有完成之后,他会自动进入到一个新的执行循环。 好,如果它判定执行完成,就会终止循环并输出我们的总结。最后,当我们自动化任务达到最大的执行回合之后,它会自动地暂停,防止无限循环消耗我们的头等。 armosgo 除了在工作原理上和其他 ai 智能体不一样, 它还特别增加了六大核心功能。选第一个,我们所有的任务它都会独立的并且持久的存储, 那目标的状态会写入到我们本地的 c 型的数据库。当我们重启 harness 或者关闭终端之后,我们的进程不会丢失。第二个 harness go 有 一个指任务追加的一个功能,就是我们 sub go 这个技能 好,当我们任务执行过程中,我们可以通过 sub go 这个指令新针对我们任务的要求和约束,无需重新建立我们的目标和重新打开窗口。第三就是特别重要的裁判模型的机制, 我们可以单独的指定低成本的轻量模型作为整个任务执行的一个裁判模型,来降低我们 token 的 消耗。第四个也是非常重要的一个功能,就是我们的构技能, 可以自动化去匹配我们针对不同场景设置的 moa 模型组,既兼顾我们任务执行的进度,又降低我们任务执行的一个成本。第五个 hermsgo 可以 通过指令进行精细化的状态管理,它支持任务进度的查看,暂停 恢复、一键清空目标的全套的指令。最后 hermsgo 还有一个循环的安全保护机制, 我们可以针对不同的任务制定以最大执行的回合,防止我们模糊任务无限的进行迭代。好,那在我们正式开始使用 go 这个技能之前,也希望大家对自己本地的哈姆斯 agent 的 环境进行一个检查。当然在前三期视频我都带领大家对我们的哈姆斯环境进行了检查。 好,如果已经完成配置的小伙伴可以直接跳过这个部分,那为了我们高效的使用 go 这个技能,我建议大家都把 home 设置升级到零点一八点零这个版本。虽然说我们零点一七版本也有 go 这个功能, 那零点一八八米的慢模式并行调用模式和自动降权模式配合我们 hermes go 才能发挥最大的作用。所以对于环境检查六部分,大家可以看一下前几期视频的详细的一个讲解。好,那接下来给大家讲一下 hermes go 的 详细的配置和使用技巧, 我们今天为大家讲三种配置方式。好,那首先为大家讲解一下,我们通过命令行的方式来进行配置。我看到在之前的视频,有很多小伙伴在评论里面问豇豆,为什么我在 hermes 终端里面输入你说的这些指令他都会报错? 那今天我特别为大家做一个解释,我们讲到了命令行交互模式,不是在 hermes 的 终端或者是在 hermes 的 客户端里面输入这些命令。 好,这些命令是我们在系统的终端里面,比如说类似于 windows 的 cmd, share 这些窗口里面输入这些指令。那这种方式呢?是适合于不想打开 hermes 终端来进行任务执行的小伙伴,所以它不是使用在 hermes 的 终端或者 hermes 的 客户端里面的。 那首先我们的第一个指令, hermesgo configlist, 通过这个指令我们能够查看 hermesgo 技能的全局的配置项。 harmsgo configure max turns, 这个指令我们可以配置我们任务执行的最大的一个回货数。第三, harmsgo configure judge model 可以 设置我们的裁判模型。 harms go configure persist enable two 可以 设置我们是否将自动化任务进行本地持久化的一个存储啊?最后一个指令, harms config reload 可以 重载我们全局的配置,让我们修改过的 go 模块进行立刻的一个生效方式二,就是我们直接修改我们的 gmail 文件。 ok, 那我们的修改方式和之前默认模式的方式是一样的,我们只需要找到我们 harms 的 配置文件的文件夹,打开我们 config demo 这个文件,然后搜索 go 这个字段,我们就能够跳转到我们 go 的 这个代码段。好,接下来我为大家解释一下每段代码的意思。 先 go enable 冒号处就是我们 go 的 全局的开关,关闭之后,所有的 go 的 指令将会失效。第二个 max turns 啊,这个是我们最重要的一个设置,就是我们的 自动暂停的一个上限啊,这个值呢,我建议大家不要设置太大,如果你设置太大的话,那任务执行的回合数会非常多,我们的 token 消耗也非常的大。第三个是 persist state, 好, 这个指令呢, 是我们是否开启任务进度的持久化的本地保存的这个功能,我们不是重复性的一些工作,其实这一步大家都可以不用打开。好,第四个是 auto continue, 这个主要是用在当我们的裁判模型发现我们任务并没有完成的时候,是否自动地继续执行 好下一个指令。 strict 价值啊,那这个呢,是我们是否要求我们的裁判模型严格的校阅目标的全部条件啊,不提前判定完工。那这五项设置呢,是我们构技能的最核心的基本的配置。那接下来我们讲一下我们针对裁判模型的一个设置。 好,我们的裁判模型是在构价值这个字段下面,首先我们要设置我们裁判模型和我们的模型温度,包括他最大的输出制服。 那针对裁判模型的选择呢?我建议大家选择具有代码编写能力,但是他的费率相对较低的一个模型, 那特别在裁判模型的温度上面,我建议大家尽量调低,设置到零点一就可以了,因为他是作为整个任务较验和检查的一个功能,所以我们要求模型的温度要降低,他要 提高它的严谨性。第三部分呢,就是我们购任务自动绑定我们设置的专属的 moira 全局路由的这个模式。好,那关于怎么去设置 moira 路由的配置,那大家可以看 moira 路由的这一期专题的一个视频进行一个了解。 好,第四部分就是我们要结合到零点一八版本的故障降级这个功能来配合我们购任务的一个执行,那关于故障降级的配置其实和我们默尔模型的配置是一致的。好,在这里大家可以直接截图做一个配置的一个参考。 那第三种方式呢,是适合大部分的小伙伴,我们直接在 harms 的 终端或者是在 harms 的 客户端输入以下的指令,就可以启动和使用我们的购技能。 我们直接在对话里面输入斜杠 go 加具体的任务描述,就能够让我们的 harmony 执行 go 这个功能,比如说斜杠 go 重建 s r c 下面的所有拍摄文件啊,修复全部 rough 报错, ok, ok, 那 其实大部分的小伙伴都可以通过这种方式,斜杠 go 加空格输入你详细的任务描述,让我们的 harmony 进行自动化任务的一个执行。好,这里呢,我也为大家整理了一些和 go 功能相关的一些指令。 第一大类是创建和执行 go 任务的相关指令,比如说我们可以查看整个任务的进度,临时暂停或全部保留我们的进度, 从暂停的位置恢复任务的执行,清除当前绘画所有的任务目标啊。第二大类就是我们任务状态的一个管理,包括我们任务的查看,任务的暂停,任务的恢复和任务的清空。对于任务状态管理这块,我们可以使用 stop go 这个指令对我们的任务 啊进行一个管理。那 sub go 这个指令呢?我们可以用在,比如说当我们的任务正在执行的过程中,我们突然又想起对这个任务新增的一些要求和描述。那就可以通过 sub go 来插入我们对主任务的一些补充的一些要求, 或者我想对某些任务进行一个修改,我们也可以使用 sub go 这个指令来进行一个修正。那豇豆建议大家一定要把 hermes 更新到零点一八版本之后,再来使用 go 这个功能。 因为经过豇豆的测试,当你把你的摩尔全局路由和 go 再加上并行调度和自动降权的这四大功能结合到一起,那你的任务自动化执行这个功能几乎就能够达到百分之九十九的执行结果。 ok, 那 接下来我针对不同的应用场景为大家做一下 go 配置的一个示范。那首先我们讲一下程序员的一个应用的示范。 首先我建议大家我们的执行回合数设置到三十啊,不能设置太低,也不能设置太高啊。第二个呢,就是我们严格的判断一定要打开啊,因为我们毕竟是代码的检验。第三呢就是我们的判断模型尽量选择低成本的,但是要高速的这种模型, 而且我们整个任务执行一定要绑定我们的 code one 啊,这个全局的路由。最后呢就是我们的温度啊,那建议我们把我们的模型温度调到零点一到零点三这个区间,这个呢针对我们自媒体的小伙伴给大家一些建议, 首先我们最大的回合数建议大家设置到十五左右是比较合理的,如果太少呢,可能我们的长文本编辑那它就会跑偏。然后呢我们也要绑定我们之前设置好的 专属的写作的默契全书目录,那我们的模型呢,温度可以调高一点,比如像调到零点六到零点七这个范围 来提高整个文案写作的一个创意。然后第三呢,针对自媒体的小伙伴,我们的裁判模型那就可以选择轻量的低费的这个模型, 对模型的这个要求就不会太高,因为几乎所有的语言大模型在文本写作这块都相对比较强,但作为裁判模型,他只需要检测我们的写作结果和我们的写作目标是否一致就可以了, 那在这个部分没有必要选择高费率的模型作为我们的裁判模型。好,接下来为大家分享一下 harman score 的 一些高阶的使用的一个技巧。那首先是我们裁判模型选择这块 好,如果是大家使用了 harman score 这个技能之后,你会发现你的投分消耗会大大的提高。好,为了降低我们的投分消耗,我们裁判模型的选择就尤为的重要,我们针对不同的任务场景,一定要选择合适的裁判模型。好,大家一定不要使用高费率的模型作为我们的裁判模型。 第二个呢,就是我们目标文本的编辑一定要精准,比如说我给大家做一个错误的示范,我们斜杠够优化项目代码好,那如果我们是这样去执行我们的自动化任务, 那你就会发现你的 harmmas 会进入一个无限循环,有可能导致整个任务执行非常长,而且执行效果也不是很好。所以我们应该对我们的任务进行精细化的一个描述,比如说 斜杠 go 优化全部代码,修复五处已知的 bug, 运行测试无报错后即完成。所以大家在使用 go 这个技能的时候,一定要把你的任务描述写得越具体越详细越好。 好,第三个呢,就是关于子任务目标追踪的这个技能,大家一定要把它学会,如果你能够善用三不够这个指令好,那你就会发现你的自动任务执行的效率、结果和 token 消耗都是最佳的一个状态。 第四个技巧呢,就是大家一定要在我们使用构建的之前,那一定要设置好我们的专属 moala 全域路由好,设置好 moala 全域路由的意义,第一是提高我们任务执行的效率,第二个是大大的能够缩短我们任务执行的时间和 token 的 消耗。 ok, 第五个呢,大家一定要学会啊,斜杠 go resume 这个功能啊,这个指令呢,主要是使用在当我们关闭了我们的 harness 终端或者我们当前的规划之后,我们可以通过斜杠 go resume 这个指令来恢复我们任务的执行啊。因为刚才我们讲了, harness go 会把我们所有的自动化任务全部进行本地的存储, 所以我们通过 go resume 这个指令啊,读取之前的自动化任务进行继续的一个执行。好,最后一个是我们关于自动化任务的 执行回合次数的一个设置啊,这个设置次数一定要相对的合理啊,不是回合次数越高越好,也不是越低越好,我建议大家针对一般的文本拷写的回合次数设置到十到十五次就可以了, 针对我们的代码编辑和 bug 修复这样的任务设置到三十次左右就可以了。 ok, 那 这里呢,豇豆也为大家整理了一些关于 harmos go 相关的一些指令啊,大家可以直接截图。 最后我也为我们的程序员和生产级的 partners 用户整理了一套专业版的配置文件和相关的使用说明。在视频里面我就不详细讲解, 豇豆已经把我们这一期 partnersgo 的 完整的配置和相关的指令已经发布到了我们的教程文章里面。好,大家可以打开教程文章进行详细的阅读啊,复制粘贴就可以使用了。 ok, 那 今天这期视频就到这里。好,豇豆通过四期视频为大家完整的讲解 harmless agent 零点一八版本的四大核心功能,建议所有的小伙伴把这四期视频能够认真的看完,并把我们的摩尔路由 learn 技能、 journey 技能和 go 技能 结合起来进行使用,你会发现你的 harmless agent 又进行了一个大大的进化。 ok, 今天的视频就到这里,如果觉得豇豆的视频有价值,请不要吝啬大家手中的点赞、关注和收藏,拜拜!

粉丝4585获赞1.2万
相关视频
 09:52查看AI文稿AI文稿
大家好,欢迎收看本期解读,今天呢,咱们来聊点儿特别实在的。如果你平时经常用 hermes 去跑一些复杂的长任务, 那这期内容你绝对不能错过。咱们要从新手的视角出发,彻底搞懂在 hermes 里跑长任务时,那些用来保命的刹车系统和安全带儿。说白了,就是手把手教你掌握 hermes 的 反悔机制,保证你下次翻车的时候再也不会手忙脚乱。好,咱们直接开始 想象一下这么个让人崩溃的场景,你放手,让 ai 去跑一个挺长的大任务,眼看着跑了几轮,你突然发现,哎,不对,方向完全跑偏了,参数不对,甚至他还误删了东西。这时候你手速极快,果断敲下斜杠 n 度, 看着聊天界面瞬间变得干干净净, ai 也乖乖回到了几轮之前的状态。你长舒一口气,以为万事大吉了。 但是呢,半小时后,当你满怀期待地打开本地文件夹,心凉了半截,那几轮瞎折横产生的测试目录依然完好无损地躺在那儿,被删掉的配件文件根本没回来,改乱的代码也是一塌糊涂。 聊天记录是干净了,但你的本地文件已经成了一片废墟。这就直接引出了咱们今天要面对的一个残酷真相,可以说是个极其关键的现实,你撤回的仅仅是对话,而不是那些已经发生的操作。 很多人刚用 hermes 的 时候,直接拿默认配置上真强撸,把安度当成那种万能的后悔药。但其实啊,咱们得彻底弄明白 hermes 底层到底是怎么运作的。要是没搞懂这个长任务,翻车时,你损失的可就不仅仅是几分钟的时间了,那是你珍贵的文件、项目进度,甚至是一整晚的心血。 所以你是不是也体会过那种敲下安度却绝望地发现文件依然报废的崩溃感?今天咱们就是要彻底把这个问题给解决了。 我们要掌的不是什么炫技的高级玩法,而是你开车上路前必须摸熟的刹车后视镜和安全带。有了这些工具在手,咱们就能确保你对自己的工作区拥有绝对的控制权。 来看一下咱们今天的路线图。首先,我们会打破撤回的幻觉,接着认识四大刹车系统,然后解析忙碌状态下的操作,带你做个三分钟的恢复演练,教你找回丢失的技能。最后再梳理一份防数据丢失清单。 好,咱们进入第一部分撤回的幻觉,来看看为什么光靠一个简单的斜杠安度是远远不够的。 说白了,当你输入安度的时候, hermes 只是在当前的对话分支里把你俩刚才的聊天记录给软删除了,然后把终端的输入框还进你。它处理的纯粹是聊天层面的东西。 至于那些已经真刀真枪写进工作目录里的文件呀,发出去的网络请求啊,通通都不会自动倒退。相反呢, rollback 这个指令才是处理文件层面的阵家伙,它是根据你之前保存的检查点,把磁盘上的物理文件实打实地恢复过去。 所以大家一定要记住这个核心点,聊天记录变短了,绝对不等于任务被复原了。接下来是第二部分四大刹车系统,咱们来彻底弄清楚你的工具箱里到底都有啥? 其实在赫米斯里,你一共拥有四种完全不同的反悔机制,分别是 on do、 steer、 control、 c, 还有刚才提到的 rowback。 千万千万别把他们搞混了。到底该用哪一个,完全取决于你现在的目的是什么?你是想修正刚才聊错的话,还是想调整 ai 下一步的动作方向?或者你想直接掐断正在狂飙的进程?又或者是想把弄坏的文件救回来?一定要对症下药,这可是咱们安全指南的核心。 这里咱们重点聊聊 sir, 这个指令,也就是引导。有个比喻特别绝用, sir, 就 像是你站在厨房门口,对里面的大厨喊话,师傅,你手里那口锅里正在炒的菜继续炒完,但是下一道菜请按我的新配方来做。 所以, steer 的 关键在于啥?它不会立刻打断当前正在执行的动作,而是把你的新要求悄悄塞进工具的下一步里。如果当前这个工具还要再跑个十分钟,那你提的新要求也得等着十分钟跑完才会被模型看到。 那万一危险已经发生了呢?比如,一个错误的命令已经在终端里狂跑,正在眼睁睁地闪你的目录,怎么办? 这时候,你最好的朋友就是那个经典的 ctrl c, 这就是纯粹的紧急制动。但是注意了啊,这里有个极度关键的实操细节,按一次,然后就死死盯住状态,千万要有耐心,绝对不要在两秒内啪啪连按两次, 双击 ctrl c, 弄不好会直接让 hermes 彻底碰溃退出,那乐子可就大了,稳住节奏,按一次就好!好了。到了第三部分,忙碌状态分解,咱们来看一看在任务执行中途该怎么拿倒。 当 hermes 正在后台疯狂转圈处理任务的时候,你有三个非常精准的选项。第一,如果你发现当前命令正在后台用 interrupt, 它会立刻马上终止当前的工具。 第二,如果是 ai 正在跑测试,你想说等着跑完下一个步骤,别连数据库了,那就用刚才说的 steer 去修改它的方向。第三,如果你想说你先把这一整轮全都干完,然后直接给我个总结报告,这时候就用 q 安安静静地排队等它执行。 根据情况选对这三个动作,你在应对长任务时就能游刃有余。第四部分,三分钟恢复测试在翻车之前,咱们先来实操演练一下。 说实话,理论听得再多,都不如自己动手试一次。我强烈建议大家在开跑下一个大项目之前,花个三分钟把这个简单的演练做一遍。非常简单,第一步,让 hermes 随便借两个测试文件。第二步,你敲个安度撤回对话,这时候去文件家看看,亲眼确认一下那两文件是不是还在。 第三步,找个无害的任务跑起来,然后自己按一次 ctrl c, 找找那个中断的手感。最后一步,把检查点功能打开,让 ai 改改文件,然后敲 rollback, 看看文件是怎么被完美复原的。只 要做完这一套,你就能真真切切地体会到,修聊天记录和修硬盘数据根本就是两码事,想要真正纠篇,永远得看真实的文件,继续看。第五部分,恢复丢失的技能,咱们聊聊升级后如果出了小故障该怎么修复? 大家可能遇到过这种让人心跳漏一拍的情况,刚升完级,一登进 hermes, 哎,我的那些 skill 插件怎么全没了? 这时候先别慌,第一步绝对不是上网搜个命令盲目乱敲,而是得先弄清楚这些 skill 到底是啥类别的。其实就三种系统自带的 beauty in, 从 hop 商店安装的以及你自己手搓的 custom。 搞清楚它们是从哪儿来的,咱们才能用对的姿势把它们找回来。 在这里啊,大家特别容易犯一个直觉上的错误,很多人一看到 skill 没了,第一反应就是,哎,我跑个 reset 命令试试是不是就能恢复出厂设置了? 大错特错!其实 reset 只是清空了同步记录而已,如果文件本身就不见了,你就是 reset 坡踏天它也回不来。正确的方法是什么呢?看这里,用 restore 这个参数 这个命令,才能真正穿透你现在的乱糟糟的配置,直接跑到 hermes 的 安装包老家,把那些内置的 skill 文件硬生生的给你拽回来。 最后,咱们来到第六部分,防暑具丢失预防清单,是时候系好安全带了! 大家听好屏幕上这四条儿,千万别当成是什么即刻玩家的高级把戏,它们真的就是你每次准备踩油门飙车之前必须得做的基础安全检查。 首先,针对危险命令,一定要起用 shell hooks 进行拦截。其次,不管什么新配置,永远先拿假数据去测一下。 第三,一定要养成开启文件检查点功能的好习惯。最后一点非常重要,千万千万别闭着眼,直接把所有的辅助模型全给设成 auto, 这其中有两个核心机制,咱们得稍微展开细说一下。 咱们先说 shellork, 平时大家可能习惯在提示词里苦口婆心的嘱咐 ai, 千万别碰我的生产目录啊,但这说到底还是在拼模型的记忆力和理解力,他要是脑子一抽,可能转头就给忘了。 但是啊, hock 可不一样,这就是一根极其厚重的物理手刹。你看,通过设置 pre two call, 一 旦 ai 想要执勤的命令踩到了你设定的危险红线, hock 会直接摔给他一个粗暴的 block, 强行切断操作,不讲道理地拦住他,这才是能真正保住你服务器的底线防线。 另外一个要展开的就是辅助模型, hermes 提供了十一个辅助模型槽位,比如专门看图的视觉处理啊、压缩上下文的等等, 很多人图省事儿,一键全改成 auto, 听着是爽了,但这不仅会让你的 a p i 账单直接起飞,而且在跑某些专业任务时,主模型自己去干,效果可能反而不一定好。 所以一定要听全。对于像 vision 视觉或者 compression 压缩这些特定的草位,老老实实地单独去测一下,做个精细化的配置才是王道。 好了,听完今天的内容,在开启下一次 hermes 长任务之前,你的刹车和安全带都准备好了吗? 只要真正吃透了今天咱们解读的这些底层机制和实操工具,你就不再只是一个傻乎乎盯着 ai 聊天的旁观者了。 你已经正式成为了一位能够安全、军准高效地指挥这台强大本地引擎的硬核指挥官。非常感谢大家收看本期解读,赶紧去给你的系统上个保险吧,咱们下期再见!
 02:18查看AI文稿AI文稿
大家好,上期我说哈密斯为零点一八,之后要切回 deepsea, 很多人不理解。第一期我刚说完 deepsea 做主脑不行,怎么又回头用它了?最近国内用 cloud 的 环境越来越紧,不少人开始自建工作流,我刚用完哈密斯零点一八,搭好流程, kimi 就 让我踩坑了。 那下面给大家讲讲我使用 kimi 当主脑遇到的问题。第一个问题,因为 hermes agent 跟 kimi api 经常断线。 第二个问题,因为 kimi 的 模型在训练时被鼓励多思考和补充细节,所以任务完成, hermes 就 在等他返回结束指令, 不过他认为还能做得更好,于是就陷入了死循环,试了一圈只能回头看 deepsea。 但第一期的核心问题依旧还在,于是我根据 deepsea 出现的问题跟我的工作流中出现的问题,总结了十九条规则限制, 并且为了避免模型不执行和假执行,就分三层锁死整套系统。启动层, harmis config 点 p y 文件。规则层, agents md 文件,记忆层, memory 文件。 第一层,启动层,只要 type c 违反十九条规则,就自动拦截违规行为和输出。第二层,规则层,只要每次新开一个绘画,就自动给 type c 注入这十九条规则。第三层,记一层,为了避免上下文太多, type c 将规则遗忘了。所以我的个人观点, kimi 的 断线原因是 hermes agent 的 框架灵活但娇贵,进程与状态管理脆弱,错误分类与重置机制缺陷,认证与凭证管理混乱,集成适配层不完善。 第二, kimi api 官方限制与协议适配的摩擦,严格的 user agent 白名单啊,复杂的 token 认证机制,其一字断不兼容 pro wide 的 路由错误。 这三层虽然将 deepsea 限制的来说已经很听话了,但是 deepsea 的 底层框架在训练时已经写入了这种推理逻辑, 所以目前来说只能做到限制的情况。并且 hermes 变得越来越笨的原因是因为记忆经常会被 deepsea 塞得很满,在第十八条规则中的记忆线容也解决了这个问题,超过百分之七十就自动删除多余内容。这就是 hermes agent 与 kimi 之间断联的主要原因。 两个极端对工作流都是灾难,但 deepsea 暂时能被规矩管住。 kimi 的 断线是协议不兼容工作流要的是靠谱,不是积极。 因为暂时我没有找到更合适的 home studio 大 脑,所以只能被迫换回 deepsea。 大家如果有更好的建议也可以发到评论区进行讨论,我再给大家测试,点赞收藏,我们下期解忧!
250愈解忧咨询工作室 01:56查看AI文稿AI文稿
新版本 v 零点六点一八以上线,请在版本管理内进行更新。 这次更新优化了 hermes 绘画中断的问题,还有工具调用过程的优化。 m c p 拆分为 api、 devices 和 use, 工具级聊天和群聊历史更可靠。 ui 历史与模型上下文离 空消息处理更安全。 roundfield 不 再覆盖已有助手回复, reasoning 回放也更一致,设备登录更稳定。 in line ip 长文本支持滚动 语音涵消息工作流,新增自定义 h t t p t t s t t。 端点桌面与 roundtime 设置更安全。 windows path 注册支持 u n c s 支持发布 hermes agent 零点一七点零 wrong time 并补齐移动端 pwa 元素,聚含多项 profile oops 恢复修复与各项细节的优化处理, 等待下载完成设置,下次启动使用 重启 hermes studio 即可体验全新版本。新版本介绍就到这里,谢谢大家!
212Ekko Studio👾 02:00查看AI文稿AI文稿
hermes agent 授权提示配置指南三招,彻底关掉授权提示第一,理解背景, hermes agent 在 执行关键任务时会请求授权,避免误操作,但频繁输入 approve always 会打断本地测试自动化和 c i c d。 第二,判断适用场景,适合关闭审批的是本地开发 fork 测试机、临时服务器和 c i c d。 前提是任务来源、可信生产服务器、重要数据机器、多人共用环境和未知脚本来源,不建议直接关闭。 第三,使用命令行全局关闭,执行 hermes config set approvals dot mode off, 然后执行 hermes config migrate off 表示关闭 hermes 自身审批提示, 也可以手动编辑配置。执行 hermes config edit, 把 approvals mode 设置为 off, 保存后 migrate 并重新启动服务。 如果不想完全关闭安全审批,就使用 smart 模式, smart 会让低风险操作自动通过,高风险操作仍然保留提示适合日常开发 三种模式这样选, menu 适合生产和重要数据环境。 smart 适合日常开发, off 适合可信自动化环境。 修改配置后记得重新启动 hermes agent, 让配置生效。关闭审批意味着文件写录、命令执行和自动化操作可能不再询问,所以建议只在隔离环境中使用重要目录提前备份,需要恢复人工确认时改回 menu。 如果只想减少提示,可以改回 smart。 还要注意 hermes approvals mode 控制的是 hermes 自身审批, cloud code 的 权限确认需要单独处理。 最后记住测试环境 off, 日常开发 smart, 生产环境 manual, 用审批模式换效率,也要保留安全边界和回滚方案。
16奥力呦给 02:12查看AI文稿AI文稿
今天一条视频教会大家如何去安装最新的 hermes 零点一期 ai agent, 怎么去连接 detect, 怎么去自定义模型?我们在百度搜的话是很难搜索到的,所以我们先去并我们得进入 hermes agent ai 的 官网,选择这个国际档, 我们可以看到这个网址, hermes agent nas research dot com, 这个网站才是 hermes agent ai 的 官方网站。然后呢,安装有两种方式,第一种呢是下载他们的安装器。第二种方式呢是我们直接复制这串代码,然后找到 photoshop 粘贴,然后回车就可以直接看到它在安装了。看到这个界面就代表 hermes 已经安装好了。这里的几个选项不用管,我们现在可以直接在 power shell 中输入 hermes, 回车就能打开 hermes 的 操作界面。接下来我们安装它的桌面端,它的桌面板已经下载好了, 点击安装。由于所有的配置环境都已经安装好,程序会自动跳过,直接进入到安装桌面端流程,等待一会安装完成。这时候我们就可以在桌面找到 helms 的 桌面端程序了。打开程序,在右上角找到设置, 在左边找到 appearance, 这里你可以将程序的文字改为中文。接下来我们还不能让 ai 工作,我们需要将模型连接上这里,我选择的是 deepsea, 我 们先去到 deepsea 官网,点击 api 开放平台,我们先在这里充值十元,然后点击 api case, 点击创建,输入名称,创建成功, 我们复制这串钥匙代码,回到 home, 在 设置里找到提供方,点击 api 钥匙,点击 deepseek, 在 右侧填入你的钥匙。同时我们还需要将接口链接填上去,回到 deepseek 页面,在左侧找到接口文档,这里就是接口链接, 同样将其复制粘贴过去。这个时候我们可以在聊天界面测试 deepseek 是 否连接成功。 好的,这里代表成功了。那么如何接入其他的模型呢?这里我以免费的 agnes 模型为例,去到 agnes 官网,以同样的方式创建 api 钥匙这里我们会发现 hermes 模型列表里面没有 agnes。 这个时候我们需要手动操作,我们找到这个文件, 然后把以下的代码粘贴上去。最后我们就可以在 hermes 工作界面选择自定义的 ai 模型了。
236安德鲁老师 07:28查看AI文稿AI文稿
咱们今天直接切入正题啊!我猜屏幕前的很多朋友肯定都有过这种感觉。你满怀期待地装好了 hermes, 在 网上看各路大神跑 ai agent, 那 操作简直丝滑得像魔法一样。 结果呢?自己一上手瞬间蒙圈了。是不是感觉他根本不像个得力助手,反而像是一堆乱七八糟、让人完全摸不着头脑的技能碎片? 你想让他帮忙干活,又特别怕他像脱缰的野马乱改你的本地文件。最后的结果往往是,装了一大堆 skill, 却连哪怕一个最简单的完成任务都没跑通。如果你也有这种挫败感,别急,你绝对不是一个人。 其实啊,这真不是咱们用的 ai 功就不够强大,而是我们一不小心掉进了这三个特别常见的新手陷阱。第一,一上来就毫无计划地一桶乱装。第二,对着 ai 下达那种极其宏大又特别模糊的指令。 第三,跑任务的时候提心吊胆,生怕他把系统搞崩溃了。这些错误会让你产生一种我正在搞自动化的错觉。但说句实话,你并没有真正在编排他,你只是被他牵着鼻子走而已。 所以呢,在今天的深度解析里,我们要来一次非常关键的大脑系统升级。我们要把那种毫无章法、乱七八糟的盲目尝试,彻底转变成构建一个稳定、可预测并且完全攥在你手心里的任务闭环。 这其实才是你真正驾驭赫米斯乃至任何强大 ai agent 的 核心秘诀。今天的路线图非常清晰,第一,咱们先聊思维转变,构建任务闭环。第二,看看步骤一和二, 看见生态与说清需求。第三,也是今天的核心,建立任务执行规则。第四,工作流的可识化与长期稳定。最后,我们会奉上一份避坑终极指南,咱们一项一项来 好。第一部分,思维转变,构建任务闭环。所谓的新手闭环到底是个啥呢?其实它就是由五个极其贴合实际操作的阶段组成的,看解生态、说清需求、规范执行、可量化管理以及最后的持续优化。 这正好严丝合缝地对应了 hermes 里面的五个王牌工具, atlas、 idea workflow、 superpowers、 control interface, 还有 maestro。 这可不单单是个工具情端哦,它更是你每天实操的必备拿航地图。 接下来是第二部分,也就是闭环的前两步,看见生态与说清需求。作为新手,你的第一步绝对绝对不是马上让 a 一 的 atlus, 你可以把它当成你的专属生态地图。在你盲目去抄别人的代码作业之前,你得先用阿特拉斯摸清底细, 这池子里到底有些什么,哪些是还在测试的实验项目,哪些是已经很成熟的工具?它的核心作用就是帮你建立起我到底能用 hermes 搞点啥的基础认知,帮你找到真正适合你当前阶段的路子。 摸清了底盘之后,咱们就来到了第二步。很多时候 ai 大 翻车,其实就是因为你的需求太含糊了。你想想,如果你直接扔过去一句帮我做个 ai 工具, a 进的听完绝对是一脸懵的,他哪知道你的边界在哪儿? 这时候你就需要请出 idea workflow 了,它就像个超级翻译官,能把你脑子里那些庞大但是特别笼统的想法梳理成一份逻辑极其清晰。第一部非常明确的可执行说明书,记住,别直接下命令,先让 idea workflow 帮你把话理顺了。 紧接着是第三部分,也是最核心的重头戏,建立任务执行规则。 刚才说到,新手都怕 ai 闯祸对吧?怕他乱删正要文件,或者把一个小需求搞成了大工程。所以这里必须隆重介绍咱们的第三个神器 superpowers, 他 就是专门用来给 agent 带上紧箍咒的。他立下了铁律,干活前先出计划,想改代码必须先经过我确认,要做什么重大操作,必须老老实实等我的授权,他强制 ai 在 拿到你的通关文碟之后才能真正动手。 这句话大家一定要深刻理解。咱们在使用这些高级 ai 代理的时候,追求的最核心价值,真的不是让 ai 跑得多猛多快,而是让它变得绝对可控。 真正的自动化威力永远来源于你手里的绝对控制权和清晰设定的边界。只有当你知道 ai 绝对不会越界的时候,你才能真正安心地把它当个助理来用。 第四部分,咱们来看看工作流的可试化与长期稳定这个问题。我敢说每个新手在跑任务的时候都在心里疯狂默念过,也是最让抓抓狂最没有安全感的地方。 任务到底跑哪了?是不是报错卡住了?他刚才到底改了我哪行代码?这就是典型的黑箱恐惧,你根本不知道这个自动化流程是不是已经像脱轨的列车一样飞到不知哪里去了。 为了彻底掐死这种恐惧感,我们就需要第四个工具出场了, ctrl interface, 它直接把 agent 从一个深不见底的黑箱变成了一个全透明的玻璃盒。你可以实时盯着录制,清楚地知道它改了啥文件,明白它为什么要改,甚至连它下一步准备干嘛你都能提前看到。 最关键的是,一旦你觉得苗头不对,啪!随时暂停或者回滚!这对新手来说简直就是一个超级定心丸啊! 等你前面这些步骤都跑顺了,那些小任务都不在话下了。如果你想搞档大的,比如那种从选题到发布,或者收集资料到优化这种跨越多个步骤的复杂长线任务,这时候老大哥 maestro 就 要登场了。 它其实不是给新手第一天准备的,但绝对是你日后进阶的必经之路。它就像个总指挥官,专门负责调度多 a 阵的协助任务进度,还有从失败里恢复,确保你的复杂流程哪怕跑上一整天也不会崩盘。 最后第五部分给大家总结了一份避坑终极指南,大家回想一下咱们最开头提到的那三个新手大坑,经过刚才这一路的拆解,解药是不是已经自动浮现出来了? 用 atlass 先去摸清生态,你就绝对不会再瞎装技能了。用 idea workflow 去理清需求,你就彻底告别了那些让人摸不着头脑的空泛命令。最后加上 superpowers 立下的铁律, 你对 ai 搞破坏的恐惧感也就烟消云散了。这说白了,不仅是教你怎么用工具,更是帮你重塑整个工作流。 所以呀,这也是今天这期解析想传达给您的最核心的理念,千万别去迷信那种所谓无拘无束的纯自动, 想要真正玩转 hermes, 秘诀其实就藏在这个由 atlas、 idea、 workflow、 superpowers、 control interface 和 maestro 组成的闭环立, 去选择稳定,选择绝对的可控。只有当 ai 像齿轮一样死死咬合住并可靠执行你的工作流时,它才真正成了你的得力干将。希望今天这套框架能帮你彻底走出新手村,咱们下期解析,不见不散!
 10:19查看AI文稿AI文稿
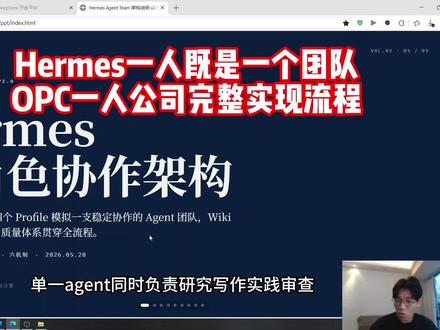
hello, 今天给大家带来一期关于 hermes 的 究极进阶使用指南,有人跟我说 hermes 不好用, 今天我呢就给大家完整的拆解我是怎么让 hermes 从一个初中生变成一个研究生团队的,这中间其实只差给它搭建一个完整的架构,搭建完成, hermes 就是 一个一整个团队,在结尾的时候我会放出文档的获取方式。 你有没有遇到过这种情况,就是你让 ai 帮你做一件事情,他自己查资料,自己写,自己审,最后交上来的东西你总觉得哪里有点问题,但是又说不出来。这其实不是 ai 能力不够,是架构出了问题。 当 ai 整同时负责研究写作,实现审查,他的认知就会改化,信息会污染,角色也会混乱。自己查的资料自己写进文章,自己审核通过了,然后整个流程其实缺了一个最重要的东西,就是歪不四脚。 所以说如何让 hermes 一 人胜任这些东西呢?结论就是用四个不同的 ai 角色模拟一支稳定协助的 agent 团队,这就是 hermes agent team 的 架构。这个架构本身我就是为了 hermes 量身定做的,因为它有一个非常棒的上下文的存储机制,就是 memory。 为什么需要 agent team 呢?就是因为我们这个单个 agent 会存在的一些问题。单个 agent 同时负责研究写作实践审查会有三个严重的问题。 第一个问题就是研究时下结论,查着资料就忍不住开始啊,我觉得怎么怎么样,而不是证据显示。第二,写作的时候不研究,当写到一半的时候发现证据不够,然后呢,他会回去再去查,流程全乱。 第三个实践时自我辩护代码跑不通的时候,他第一反应是,而我的逻辑是对的,不是我的代码可能出现了问题。他们这三个问题的根源其实都是一个,就是没有一个人在中间进行一个审查。 ok, 这一一页是整个架构的全景图,最上面的是 coordinator, 是 协调者,他是整个团队的入口跟调度中心。每次对话开始,他会先做一件事情,就是先 找到你现在的当前对话是归属于哪个项目,确认当前项目目标,然后加载正确的上下文。然后他把任务拆成小块,根据自信度路由到对应的角色身边 去。中间一排呢,是三个执行的角色,一个是 research 研究员,一个是 writer, 一个是 builder。 research 研究员他的工作只有一件事情,就是收集证据,多元对比,自信度打分,标注可信度,他不做结论,他只提供证据。一个 research 给出结论的时候,必须附上自信度分数和来源的标签。 writer 呢,就是写作者,他拿到 research 的 材料之后做结构搭建,内容转化、语言优化,写完之后有是来源引用,事实 一致,自动回查 research。 然后呢,修改标注它的输出是成品。 ok, 就是 builder, 是 构建者,它负责实现 测试,调试。当它卡住的时候,会有一个五步自救的流程,停止区分已完成跟未完成,然后把那个未完成并且有误的东西写补回报告,让上一层重新调研,重新提供材料。然后我再续着完成后续的工作,路由只修改一部分,然后 后续直接进行下一个循环,这个机制防止 build 在 同一个问题上面卡死死磕,或者说最后死机。这三个角色之间可以互相协助, writer 可以 回查 research 做事实的核查, build 可以 请求 research 补充技术资料。最下面这层是 wiki 共享知识库,所有信息唯一的存放位置,分三层,分别是宪法层定义,局的结构运,还有运行时层放项目的空间和局的规则。还有一个是数据层存放可附用的方法,任何原始的素材。 最底部呢是质量的保障体系,分别是对应找到当前的项目目标,然后呢,就下一步就是进行一个自信度分级,下一个就是自救的流程,下一个质检清单跟协助检验跟 污染的预防 agent team, 四个角色各司其职,这个协调者负责项目的拆解跟调度,研究员管 资料的调研和解剖。然后呢,这个写作者就广表达跟写作,这个构建者就广技术的实现,所有人通过一个共享的 viki 进行一个协助。 最核心的转变是什么?把一个全能的自己拆成四个专精的人,每个角色不需要全能,他们只需要把自己的那一部分做的最好交给下一个人就行。这就是四角色的协助架构模型。 标准的工作流,这是标准的七步工作流,从需求到规划,第一步呢就是确认项目目标, 加载对应的文件。第二步,任务拆解,写一个文件,然后呢,路由到对应的哪一个角色身上去。 第三步,角色执行,他们可以进行一个并行工作, resite 还有 build 的 直接并行工作。第四步,自信度审核,高于八百分之八十可以直接采用,低于百分之四十呢,需要暂停进行一个人工判断 它。其实这个自信度分了四层,具体的后面再说。第五步是质检跟回查, read 是 从检查完成这个 完成后进行一个回查 research。 第六步,产出规档,从 in books 到 outpost, 进行一个产出规档更新内容。第七步,复盘记录,它们会持续进行一个改进循环, 当你使用的次数足够多,他能够越来越完善,然后呢,越来越符合你的使用习惯,他会自自己迭代。 ok, 刚才那一幕是讲的是角色怎么进行协助,然后第二幕写的是背后的基础设施 profile 怎么定义角色身份? wiki 怎么承载这个共享的知识?然后呢?质量保障体系怎么确保输出可靠? 先看这个左边 profile 的 六个文件,这个受点 md 是 定义,这个 agent 是 谁,他的核心身份是什么,就要做什么事情。然后呢?这个用户偏好,他服务的对象是谁?这个 memory 是 跨项目的经验,他学到的东西。 skill 是 技能清单, 这个是运行配置跟认证的凭证。每次切换角色的时候,只需要加载不同的 profile 文件夹,整个 a 帧的视角和行为就会变了,不需要改代码,不需要改系统提示值,换一组文件就行了。所以说 这些在建成之后完全不用管了。现在我只是在跟你讲搭建时候的逻辑,搭好之后,你拿过去这一套逻辑直接就能用,它自己会归档,自己会找对应的文件夹,自己会产生,把那种各个文件归档到只专属的位置就可以了, 所以说拿过去就能用。然后看一下右边微机的知识库商城就是我刚刚说的这个宪法城,运行城可附用方法论跟这个原始资料跟素材跟规档,他所有项目所有的文件有且仅有一个文件夹, 他只能够对应的文件只能够放到对应的文件夹中,不能够乱放,乱放就会会有这种项目污染,还有这个上下文污染,各种各样的污染问题,反正我们只需要在前期就把它这个所有的路径卡死就可以了,这就是我设计的一个内容。 嗯,最上面这个宪法层相当于整个系统的总览地图跟这个宪法,任何新成员先读这两份新文件就知道整个系统是怎么运转的。商城之间的信息有非常严格的流向规则,只能从上往下去引用,而不能从下往上面污染。 ok, 下一个是质量保障体系,这也是我改进的一个非常重要且保障质量的一个很好用的系统。六大机制逐个看,这个是确定项目目标, 每次对话先确定当前的项目目标,防止跨项目污染。第二个是自信度分级,它总共有四级,我刚刚也说了,第一个是自信度大于百分之八十可以直接饮用,百分之六十到百分之八十是标注 信息来源,百分之四十到百分之六十呢是进行一个双盲交叉验证,百小于百分之四十是暂停进行一个人工判断的环节,就是当你这个内容真实性比较低,他直接就跟你说他低于百分之四十,你自己判断让你,他就会问你要不要继续执行。 ok, 下一个就是呃, build 的 自救流程分别分五步,上面也说了,就是先停止,然后区分完成,且不会报告路由。修改部分第四个 writer 的 自检清单事项就是来源引用的事实一致,自动回查跟修改。 b 标注 信息污染,防止信息污染,有四层隔离,所以说 profile 及一整个团队,四个角色各司其职,一次对话就是一个一次稳定的协助。 wiki 就是 中控所有的信息,尤其只有一个存放位置,项目隔离经验附用。还有质量是设计出来的 六六大机制,在每个环节设置检查点,然后进行一个必完检验证。这套架构的设计初衷是把开放性的问题变成可控的协助流程, 当你把能不能做好这件事情变成流程有没有走完,那么它的质量就不再依赖于运气了。 ok, 主要就是这一些要原文件跟 ppt 的 朋友,评论区可以留下 hermes 后台找我拿,我已经把它这个 hermes 的 架构说明写成一个完整的文件, 你只需要把这个文件丢给 hermes 或者其他的 agent, 它都可以按照我这个逻辑,结构非常细致,它就按照这个去搭建一个完整的架构。 ok, 需要的评论区留下二 miss 后台找我拿,免费分享。关注我,下期讲我是如何使用这套架构并行完成我多个项目,并且他们之间互不污染的,拜拜!
1821小屿AI实战笔记 02:33查看AI文稿AI文稿
也就是说他会把我们 default 的 配置,所有配置进行一个复制过来,那么这个时候呢,我们要去修改,比如说人格, 我是数学老师,我是 数学老师,主要减减六年级的。 好,我们输入完它会自动保存啊,这是人格,然后记忆呢?它也会复制我们这个啊 default, 那 么它使用红色,使用蓝色,我们就改一下,把它删除或者编辑也可以, 五颜六色,好,保存, 我叫王王老师。哎,好, 好,我们保存一下。好,那么这里面会有一个本地模型把它激活 啊,那我们刚才把它的这个人格及记忆都已经啊切换了,大家看一下啊,我这模型也是使用的,我们的本地是模型是开着的,大家看一下,当我们切换一下它的联动之后,它的这里面 网关也是关着的,我们开启,开启之后我们这个点击一下,好,那就开启了,开启了我们再去问他,你是谁? 好,那么他会说我是数学老师啊,主要讲解六年级的内容为主啊,好,那么这次我们来切换一下,比如说我们切换一下这个答案的 这个现在本地的,让我们看一下他的人格,他是一个程序员,然后他的记忆是喜欢蓝色,好,我们切换一下,关闭重启。好,好,我们再来回问他。 好,那么他这里面输入了正确的记忆啊,我是工程师,喜欢蓝色, 那么从这两个相互切换,我们看到他确确实实通过技能,人格啊,人格跟记忆啊以及网关都已经达到了切换。
17AI小蜜蜂 07:32查看AI文稿AI文稿
咱们今天直接切入正题,跳过那些吹得天花乱坠的 ai 炒作。说句实在话,现在市面上绝大多数关于多智能体的讨论看着都像是演话剧,几个 prom 的 在那互相聊天儿。 demo 看起来确实很酷,但你敢把它放到生产环境里吗?根本没法用。 作为开发者,咱们真正觉得头疼的,即使是怎么拆解任务,怎么做物理隔离,以及怎么严格验证输出结果。所以今天咱们就硬核一点儿,拆解一下 harm's agent, 看看一个能在生产环境落地的多智能体系统在底层到底是怎么运转的。 接下来咱们会快速过一下多智能体的现实困境,然后深入了解 hermes 的 三层协助架构,看看任务到底该怎么拆,系统怎么部署。当然,我也会非常坦诚的聊聊这里的坑和失效模式。最后分享几个真实的落地场景以及未来的演进方向。 好,首先来看看咱们面临的多智能体现实,现实情况是真正的难点从来都不是怎么去增加更多的 ai worker, 瓶颈在哪?在协调成本。如果你只是让一个大模型扮演十个不同的角色,在一个巨大的上下文里面自说自话,那根本不叫多智能体,那纯粹就是上下文污染,最后大概率会跑飞。 在实际工程中,真正的挑战在于你如何把任务干脆利落的隔离开,并且确保他们之间的工作交接是百分之百可验证的。 为了解决这个协调和隔离的问题,我们需要从操作层面重新定义基础建设。 hermes agent 并不是什么神秘的分布神魔法,从架构上看,它极其务实,它本质上就是一个单一的 python 进程,外加一个持久化的 web socket 网关守护进程, 底层依赖两个 sql lite 数据库,一个存状态,一个做任务队列刊版。它把持久化记忆、可附用的技能,基于强大的工具调用能力全部揉在了一起。这是一个真正为了干活而伤的底座。 那么基于这个底座,它是怎么协助的呢?咱们进入第二部分,三层协助架构。面对不同的业务迸发需求, hermes 给了三个非常落地的协助成绩。第一是同步的职能体委托,直接调用 delegate task。 第二是孵化出完全独立的 hermes 进程,走 hermes chat q 模式。第三是通过底层的 chrome job 来实现持久化的定时工作流。 这前两种模式的对比非常有意思,咱们展开说说。当你用 delicate task 的 时候,它其实是县城级的隔离,所有的 worker 虽然上下文干净了,但都在同一个进程里,这会导致它阻塞主对话,万一负极对话断了,此任务也就跟日挂了。 但如果你换一种思路,通过触发 terminal 并带上 background equals true 和 notify uncomplete equals true 这两个参数,情况就完全不同了。你实际上是零代码,拉起了一个月后集坟的独立后台进程,它拥有决绝的进程隔离,你甚至可以关掉聊天窗口去喝杯咖啡,它在后台默默干完活之后,会自动把结果推回给你。 对于长任务来说,这种真正的异步才是生产级的做法。弄懂了底层机制,咱们来看看第三部分任务到底该怎么拆?系统怎么保证可不属现。听着,千万不要为了用多智能体而硬上多智能体。好的拆解一定是为了降低认知负荷。 比如最经典的流水线,让一个智能体专门去扫网,也收集原始数据。另一个拿到纯文本去做总结。第三个只负责排版打包,或者在 devops 场景里,一个负责去 server 扫日制,找出异常交给第二个去审查源代码。最后第三个提出修复方案。 这里的核心价值是什么?是减少每个智能体的上下文污染。你绝对不希望那个在网上到处乱爬自捞的研究型 agent 同时拥有修改你生产环境代码的权限,对吧? 要想让这套系统在生产环境里活下来,操作护栏简直是重中之重。这里有几个关键配置你一定要知道。首先严格限制工具级,比如配置 toolset, 等于 file web, 直接锁死智能体的爆炸半径,防止它误删文件。 其次是角色分离,如果你把一个 worker 的 角色设为 role, 等于 leaf, 它就被剥夺了继续往下派发任务的权限。这从物理上读绝了智能体无限地归延伸的灾难。 还有处理代码的时候,利用杠 w 参数开启 gitworkchain 模式,让不同的子智能体在隔离的工作区里改代码,完美避开 git 冲突。这些都是甄种踩过坑才总结出来的工程经验。 另外还有一个无情但极其必要的原则显示验证。作为一个 orchestrator, 你 永远永远不要相信一个子智能体发回来的任务已圆满完成。这种规划,你必须强制它交出具体的剧本。 修改了代码,把文件路径发过来,部署了服务,把 url 给我跑了。测试,我要看到红的白字的测试输出日期,没有这些具体的交付物,交接就绝对不算完成。聊完了,好的方面,第四部分,咱们坦诚地扒一扒它会怎么崩溃。 多智能体谐同其实非常脆弱,头号杀手就是刚刚提到的交接幻觉大模型,太喜欢在没做完的时候假装成功了。其次,如果你任务拆得烂,你可能会发现三个窝壳其实在疯狂扫描同一份文档,全在做重复劳动。 再比如刚才说过的,用同步的 delegate task 去跑一个超长任务,随便一个网络闪断,任务就直接灰飞烟灭。 最后,如果你把验证流程设计的过于复杂,验证本身的算力和时间开销甚至会远远超过你搞病发省下来的时间,这就本末导致了。 给大家看个数字三,在 hermes config 里, max concurrent children 的 默认值就是三。 这不是拍脑袋定的,在现实的 a p i 环境里引发,一旦太多,你的 toc 燃烧速度或呈指数级上升,而且马上就会触发严重的 a p i 线有延迟。工程师的现实是系统资源是有物理上限的那种。动则搞几十个智能体蜂群的演示,在现有的基础下,也就是看看而已,别当真。 那么避开了这些坑,到底哪里才是多智能体的用武之地呢?第五部分,真实落地场景。 在这些场景下, hermes 的 模块化和多阶段执行能力是真的香。比如代码库的深度审计 orchestrator, 把要求分发下去,几个 worker 分 头去查不同的微服务,最后回总回归, 或者是做长篇内容生产流水线。再比如,利用 cron 定时任务,让智能题每天半夜自己醒过来扫一遍系统日制做个数据分析,然后把预警报告推送到您的手机上。这些任务天然就具有阶段性和独立性。 但是咱们得说句公道话,千万别把手里拿个锤子,看什么都像钉子。如果你的任务很小,必须严格篡行或者极其敏感,比如直接修改核心数据库。拜托别搞什么智能体集群, 给一个能力强的单一智能体配备好名权的计划和合适的工具,往往比一群吵吵闹闹的蜂群要靠谱、高效且安全的多。多智能体指在任务本身就具备模块化,需要并行研究的时候才能真正置回票价。 最后一部分,我们来看看这条路接下来该怎么走。要想让类似 hermes 这样的系统变得更强大,未来框架底层必须直接内置更好的验证源语,不能光靠写 prompt 去约束 隔离的上下文之间状态交接,也需要更文件的机制。还有个绝对绕不开的痛点,那就是可观察性。当一个智能体的一步操作可能触发一连串内部 api 和微服务反应时,没有让时流量控制,没有详细的审计链路是绝对不行的。 只有当这些基础建设完善了,编排开销账下来了,多智能体才能走向真正的低成本富用。咱们用一句话来总结今天硬核的工程哲学, 多智能体从来不是为了炫技,只有当它能实实在在的把你从查日制、处理、合并、冲突这些繁琐的日常中解放出来,真正降低了人类的协调成本时,它才有存在的价值。如果它只是给你增加了一层需要时刻紧盯的 cyber 表演,那咱们就彻底走偏了。 好了,今天的拆解就到这里,最后留给大家一个思考题,在你接下来的业务系统里,你是愿意去管理一个充满不确定性的智能体蜂群,还是去踏踏实实构建一条拥有绝对隔离护栏的流水线呢?欢迎在评论区聊聊你的架构哲学,关注我,一起学技术,咱们下期再见!
138古法编程-小周 01:05查看AI文稿AI文稿
直播用这个大家开心看到没有画面,但是这个画面他不动卡了,我就用这个哈莫斯,应该叫哈莫斯给我给我诊断了一下,他说这个是 win 加 r usb 的 连接,然后我设置了一下,感觉能用,然后跟着他这个设置我重启了一下 obs, 现在呢?看这里手它还是能动了, 设置了一下这个 obs, 现在应该可以了,等一会试验一下效果怎么样。 用了一下这个 obs, 已经过了三十分钟了,没有掉线,之前的话 不管怎么用他就直接就像视频之前就卡住了,所以说还是挺管用的。然后的话这个哈密斯吧,应该叫哈密斯,叫爱马仕吧,他说已经帮我把这个问题处好了,下次我直接问他就能帮我排查了,还是比较智能的。
24打工没人要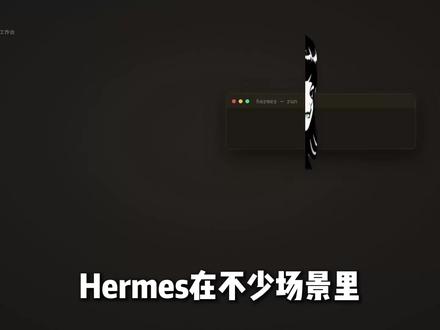 02:02:171118九天Hector
 04:06查看AI文稿AI文稿
大家好,我是沐辰,好东西我只用最便宜的。这期我们把 hermes 接到微信上,以后微信一句话,电脑上的 hermes 就 能替你干活。 先说清楚,这里接的是微信 waxing paste, wechat 不是 企业微信 we com。 hermes 用腾讯 iinkboard api, 消息走 long polling, 不 需要公网服务器,也不需要 webhook。 还有一个坑要提前知道,扫码后连上的不是普通个人号,而是 i link bot 身份。它通常能稳定处理私信,但普通微信群大多收不到。时间开始前先装依赖,最少需要 a l h t t p 和 cryptography。 命令是 pip install a l h t p cryptography 二维码显示不出来,再安装 messaging 扩展 正式配置从 hermesgiveaway setup 开始,它会打开消息平台配置向导这里选择 wechat。 选中微信后, hermes 会向 i link 请求二维码,终端能显示就直接扫,显示不出来就复制终端打印的链接到浏览器打开,再用手机微信扫码确认后,屏据会自动保存。这里的关键不是自己写接口,也不是逆向微信。 hermes gateway 已经把平台适配层封好,你只需要把微信 bought 身份接进去。接下来是私信策略。第一项, use dm pairing approval 是 陌生人先申请,你批准后才能用。 第二项, allow all direct messages 是 所有私信都能触发。第三项, only allow listed user ids 是 白名单。第四项, disable direct messages 是 关闭私信, 然后是群聊策略。第一项, disable group chat 是 忽略所有群消息,默认最稳。 第二项, allow all group chat 是 所有收到事件的群都响应。第三项, only allow listed group ids 是 只响应指定群 id, 但 i link bot 通常收不到普通微信群事件 home channel 决定 hermes 主动通知和 crown 定时任务默认发到哪里。个人助手场景直接用当前 wiki user id 最省事。 配置完成后,平台列表里会看到 vision configured。 首次扫码后至少要有 w e xine account id token 通常会自动保存。 如果你要手动调权限,就写到 hm s k n x。 然后常用的是 w e x n d n policy, w e x n allow users, w x n gop policy 和 w x n home channel。 最后启动网关,看到 start gateway, now after install。 选 y 就是 马上启动,方便立刻测试。看到 automatically on windows login or scheduled task。 选 y 是 开机登录自启,长期使用可以开临时演示,可以选 n。 看到 pid 就 说明 gateway 已经跑起来了。 启动后,微信消息会通过 long polling 进入 hermes。 hermes 处理完之后再把回复从同一条微信链路发回来。先测清任务,我在微信里问,简单介绍一下,你自己能正常回答,就说明微信到 getaway, 再到 hermes 再回微信,这条链路已经通了, 再测真实任务,我发帮我查今天微博热搜前五, hermes 会先确认当前时间,再抓微博热搜数据,最后整理成微信消息返回。 这套东西最有价值的地方是微信只负责入口,真正干活的是你电脑里的 hermes。 查网页,读文件,跑命令,写代码,生成图片,做定时任务, 照着做就记住这条路线,装依赖 getaway setup, 选择 wiki 扫码登录,按需求选策略设置 home channel, 启动 getaway。 好 东西,我只用最便宜的,我们下期视频见。
25木辰 02:44查看AI文稿AI文稿
大家好,我是八六,今天呢跟大家分享一下怎么去节约 toc 的 四种方式啊,为什么会说这个呢?就是我在做文字知识库以后呢,发现我的 toc 的 消耗量呢是越来越大, 因为我有一千三百万字的知识库,在有这么多知识库的情况下,如何去节约 toc, 这是一个很重要的事情,要不然的话你每个月呢至少要花费成百上千的 toc 的 费用。 那第一个呢,就是如果你发现你每次打开你的 codex 或者 sims, 发现你第一个问题的时候,他就已经消耗百分之二十到百分之五十的头肯,这时候说明你的背景信息太多了, 还有你的装的 skill 太多了,就是你每一次问的问题,他都要读对应的 skill 跟背景信息,所以这个呢,你一定要去做检查跟内容的缩减,就是不要使用 aso 呢,就读完你整个人生。 然后第二个呢就是扫开工具,把不用的 skill 呢,会把不用的工具别默认挂上去,因为工具它的我们叫 screamer, 本身呢也会带住上下文,就包括浏览器中断文件的各个方面的,这工具他都会有一个说明文档,这个文档他每次读的时候也会消耗图片,即使你不用这个工具,但是呢他同样会消耗,所以 这个是大家要注意的,少开工具,别默认挂上去。然后第三个呢就是少读全文, 提炼要点,这个就是为什么我一直推荐大家用 angelica 的 这个知识管理的方式,因为他会把默认把你保存在知识库里面的文章做成一个什么卡片,知识卡片精华, 京剧,然后带有缩影,这样的话呢,你不是每一次都是去读原文,而是从缩影里面去读一些关键要点,再考虑要不去读原文,这样的话你的头可能也会大幅减少。 然后第四个呢?就是,呃,优先用代码脚本来考虑用大模型去做。什么意思呢?就是我会在我的 type n d 文档里面去给 ai 做要求就是如果我任何要求他做的事情批量化的, 如果能用代码脚本解决的,就不要用大模型去解决,这也会解决你头等舱的问题,而且非常好用。
 03:50查看AI文稿AI文稿
大家好,关于上期我介绍 homemi 四版本的重大更新后,今天有小伙伴问我零点一七中内置的仪表盘好不好用,该怎么用?那本期我就来给大家重点讲一下 homemi 四仪表盘的详细使用教程。 那首先呢,我们要先开启 homeis 的 仪表盘,只需要一行指令,大概等个两秒他就直接跳转浏览器打开仪表盘了。那我们首先要做的第一件事呢,就是将整个页面设置成中文,在左侧下面有一个 e n, 我 们点击它切换成中文,设置好后,整个页面的操作选项就一目了然了, 那我们就来介绍一下整个仪表盘的优缺点,然后再讲讲里面每一个选项它们大概的作用。那首先呢,整个仪表盘最大的优势就是可识化, 以前我们所有在终端看不到的内容,它都集成在了一块,做成了一套可视化的 ui 界面。现在你能找到以前找不到的历史对话和以前看不到的扩展功能, 还能切换模型啊,查看你有什么技能包,甚至查看你以前的自定义规划任务等啊,都能在这里面查看。但在原本呢,退出终端界面后啊,需要告诉 harry 帮我保存一下数据,再次打开软件后还就要再说一遍, 其实这一点在以前就已经让我头疼很久了,但是现在的这个仪表盘就完美的解决了这个问题。那 现在我们就来介绍一下整个网页的选项功能。首先我们进入页面后,中间这个就是 homeis 的 对话框,在右边有两个选项,一个呢是切换 ai 模型, 它的原理也是根据你 homeis 中配置的地址通道来查找其他可用的大模型。左边呢就是你目前可用的模型,有非常多的类型可以切换, 包括如果你已经有了欧拉玛啊,下方还有离线本地化 ai 模型可供你切换使用,体验非常不错。下面呢有一个思考档位选项,你可以选择 ai 思考设备程度, minimo 就是 轻量化思考, low 跟 high 就是 低阶高阶思考啊。中间呢这个就是均衡思考, max 就是 深度思考,我们选择中间均衡思考就可以了。第二个呢就是历史绘画,跟我开头讲的一样,这绝对是仪表盘设计最好的地方。上面的数字就是你一共有多少个绘画,绿色就是活跃的 八千六百五十七,就是我向 homeys 一 共发送过多少条消息。上面的两个小数字启动类型呢,一个是 t u i, 一个是 c l i, t u i 呢,就是适配 homeys 桌面可识化的启动模式。 c l i 呢,就是极简桌面快速启动模式。当前呢就是最近使用的对话。右边呢就是历史对话, 我们可以找到我们以前的历史去选择一个起用,也可以编辑标题,也可以导出和删除对话。 else 就是 开发者将我们的 harmony 文件目录内置到面板里了,这个其实就没有什么可讲的。 第四个 model 就是 模型管理中心,我们看上面有七 d, 三十 d, 九十 d, 七 d 的 意思呢,就是七天内使用下方这些模型的频率, 我们也可以看到模型名字右边有一个数字,我这里是一百五十四,三十 d, 九十 d 也一样。下面的 models setting 就是 当前使用的模型啊,当然我们也可以在这里切换模型。下面的这个 t a s k s 就是 辅助扩展的功能,我们可以看到里面有 hms 自带的网页搜寻,还有 m c p 服务,还有搜索 skill 技能, 这里面都是内置的辅助能力。上面的这个 alt 选项就是智能适配的意思, ai 需要对应能力时会自主适配起用啊,我们也可以指定优先适配 ai, 当然这个指定只是优先调用啊,其余 ai 运行时也可以兼容使用。然后我们看到下面有几个标签,第一个透彻的标签呢,就是是否可以调用工具的标签,这个标签呢,就是深度思考的意思, 这个 a s 的 按钮是选定优先适配扩展能力的 ai。 第五个呢,就是运行日制啊,这个大家可以略过,里面包含了 harmony 运行时或者运行异常提示的内容。 那本期呢,就详细讲一下这几个工具的作用,那下期呢,我再给大家讲讲其他工具的作用和能力。本期视频就到这里了,如果对你有帮助的话,记得点赞收藏,我们下期见解忧!
316愈解忧咨询工作室


