基于lda的教育学选题,lda什么意思
粉丝2.2万获赞15.0万
相关视频
 07:02查看AI文稿AI文稿
在这里呢,我来简单的介绍一下什么叫主题模型,那主题模型呢,我们把它叫做 lda, 英文叫 latent dslay allocation。 那主题模型经常用在一些文本处理的任务里面,比如在一个分类问题上,那我首先通过主题模型来去得出每个文档的主题项链, 那这个项链呢,我们可以把它看作是这个文档的一个特征,然后接下来呢,把这个特征放到接下来的咱们的分类器里面去训练或者是预测,最终我可以得出这个文档到底属于什么类型。 所以在主题模型里面,一个比较重要的一种场景,就是把主题项链当做是一个特种项链。那主题模型本身呢,它是属于生成模型, 也就是我通过主题模型可以生成很多的文档。然后另外呢,主题模型它本身也是属于涂概率模型, 因为在主题模型它的细节里面有很比较复杂的一个生成的过程,那这个生成的过程里面,我们会涉及到一些文档的主题,包括单词和啊这个主题的分布, 然后呢以及他们之间的一种生成的过程,所以它是属于一个概率图模型范畴里面的啊,一个经典的算法。然后另外呢,主题模型其实我们可以把它归类为贝耶斯模型, 那这个杯子模型呢?他其实跟我们之前谈论过的像最大自然还有最大后眼估计是不太一样的,因为在杯子模型里面,我们更多去关注的是一个模型概率的 厚颜概率。但是呢,在最大自然和最大厚颜估计里面,我们更关注的是它让一个模型最优化的,其就是其中的一个纸。但是在贝斯模型里面相当于说把很多的模型融合在一起,所以它是一个类似于集成式的模型。 然后具体的细节呢,我觉得比较复杂,所以我们不会放在呃这个机学系课程里面去讲。如果大家感兴趣的话,你也可以去 看一下咱们后续的高阶的课程,在那里面我们会详细的讲解 lda 那些细节,比如说如何去理解 lda, 那他的涂膜型到底是什么样的?那如何去训练 rda? 如果去使用 rda 以及怎么去,怎么去用来去预测一个一个一个新的文档。 那首先我们这里面主要关注的点其实就是 led 模型的输入和输出是什么?那在这里呢,我们列了几个训练数据,就是文档, 所以文档里面可能有很很多的单词,那假如我这里面有三个文档,然后呢我通过一个 at 模型,那训练出来的其实就是每个文档的或者叫文章的主体分布。 所以这个分布呢就是依次为零点一、零点三、零点五和零点一。然后呢这里是零点二、零点一、零点一和零点六,所以这些都是主题的分布,那我们如何去理解这个主题的分布呢?其实这个是一个项链, 那假如第一个位,第一位,那他呢?是我们把他叫做第一个主题,叫主题一的 一个权重,你可以把它理解成一个权重,为什么?因为它的加权平均是一样的,就是全部等于一,然后呢零点一就意味着百分之十的一些权重它是归属于主题一的,然后第二个位置呢,其实就是主题二, 然后第三个他是主题三,然后最后一个是主题四。 那这三个主题或者四个主题到底指的是什么主题呢?那是不是主题一的话是属于科技类的,那主题二是不是属于娱乐类的?那主题三是不是属于?呃,这些 自然科学类的或者工程类的?其实我们不知道,那通过 rda 我们得出来的这个主题的分布呢? 那针对这个主题来讲,它是一个看不见的一个东西。那我怎么去理解零点一到底指的什么主题? 我们只能去去可视化这些结果。那通过可视化的角度,我们其实可以大致的可以判断,比如第一个位置到底属于什么主题,那第二位置呢?属于什么主题?所以很多的时候还是能看出来的。 但是呢,我们训练的过程当中,其实我们不会指定啊,咱们的第一位就是体育类的,第二位呢属于科技类的, 所以我们我们不会走,不会这么做。而是我训练完之后呢,我再把每一个主题呢做一个可视化,然后可视化的过程里面可能会发现,那每个位置,这个项链的每个位置到底属于什么样的一个主题?所以这种变量呢,我们也把它叫做类似于隐藏或者隐私的变量,因为是我们看 看不到的,是我们通过这种,我们只能比如说通过一些分析的方法,大致的去理解到底是什么。那当然我们在训练主题模型的时候,有一个非常重要的参数,叫做主题的个数,我们一般通过 care 来表示, 那在这里呢可以等于四,也就是我告诉咱们的文本,就是告诉咱们的主题模型,我要把每一个文章呢,从每个文章里面抽取四个主题,然后呢按照每个主题的权重把他们标记出来, 所以这里的 k 是我们把它叫做超残鼠,那当然有些时候我们可以把它选择选,选择稍微小一点的纸,有些时候呢可以把 k 纸弄得更大一点,比如说 k 等于一百、两百、三百,那具具体的 k 怎么去选呢?那这个 k 的选法其实 跟我们之前讨论过的其他一些啊,这个参数的选法是一样的,就是超参数的选法是一样的,我们需要做很多的一些测试,叫做这种交叉验证也好,还是尝试也好,我们需要做大量的尝试。但是很多的时候呢,其实在工业界的任务当中 啊,这个主题个数我们大致可以猜出来,那怎么去猜呢?比如说我,我有手里面有一百个文档,那我可以把比如说其中的十个文档大致的去扫一遍,那在大致的扫一遍的过程当中可能会发现,那这个十个文档呢,那基本上可能属于这几大类。 然后呢我基本上有了一个呃,这种思路之后,我可以把主题再慢慢的去改造一下,然后最终我想我我们会得到一个最理想的主题的, 所以这是主题模型,他所做的事情输入呢就是文档,就是很多的文档,然后输出呢是每个文档的主题叫做主题的分布。 所以这是为什么我们把它叫做主题模型的主要原因,因为所有的细节其实围绕着单词主题来去开展的。
327文哲聊AI 02:57查看AI文稿AI文稿
大家在做机械学习或者数据处理时,肯定听过 lda 现行判别分析,名字听起来挺高大上,其实他干的事情特别简单,就是帮你在乱糟糟的数据里找一个最完美的观察角度,让不同类别的东西一眼就能分的开。想象一下, 你手里有一堆红豆和绿豆,他们摊在桌子上,位置乱七八糟,你想来个挡板把他们一分为二,发现怎么放挡板都会压到豆子。 这时候如果你能把这些豆子投影到一条线上,是不是就容易多了?但是随便找条线投影,比如横着或竖着,红豆和绿豆可能还是会记在一起。 lda 的 终极目标就是找到那条黄金曲线, 把豆子投影过去后,红豆缩成一团,绿豆缩成一团,且两团之间离得越远越好。要实现这个目标, lda 只有两个死理,你记住了,面试官都难不倒你。一、 背内方差最小,通俗点说就是自己人要抱团投影之后,同一类的数据点要尽量挤在一起,别到处乱跑。二、背间方差最大,通俗点说就是对手要离远点,投影之后, 红豆的中心和绿豆的中心距离越远越好。口诀,总内要团结,组建要对立。很多人分不清 lda 和 pca 主成分分析, pca 是 瞎子摸象, 他不管你是什么类,他只看哪里数据波动大就往哪里投影,他追求的是保留原始信息的完整性。而 d a 是 戴着眼镜找不同,他是有标签的,他专门看哪里能把类别分得最开。打个比方, p c a 像是给你拍全身照,要把你整个人拍清楚。而要 d a 像是给你拍证件照,只要能一眼看出是你还是吴彦祖就行。虽然咱们说是大白话,但 u d a 背后的工程咱得提一下,那就是 face 判别准则。他把我们刚才说的两个绝招写成了一个公式,分子是两类,中心点的距离越大越好。 分母是两类,各自的散步程度越小越好。我们要做的就是找到一个投影方向 w, 让这个分数 j w 跑到最高分率,效果就越牛。哎呦, da 虽然强,但也不是万能的。一、它是个直线思维,它只能处理先行分类。如果你的数据像个太极图一样嵌套, lda 就 抓瞎了。二、类别限制。如果你有 n 个类别, lda 降维之后最多只能剩下 n 一个维度。三、 正态分布。假设它默认你的数据分布是比较规整的中型曲线,如果数据太离谱,效果会打折扣。总结一下, lta 就是 通过组内抱团、组间隔离的方式,把高维数据压缩到低位,同时还要保住分类的特征,它是数据预处理阶段的 姜维打击神器。如果你觉得这期视频讲清楚了 lda, 记得点赞关注,我是机器学习的故事,一名爱讲大白话的博主,咱们下期见。
74机器学习的故事 02:16查看AI文稿AI文稿
你的导师丢给你一千四百九十篇新闻,限你两天回答几个问题。这些文章在讨论什么?每类话题占多少?话题之间有没有联系?结果是否真实? 你需要的是主题建模。他不帮你读懂每句话,而是先帮你回答这些文本大致在谈哪些话题。 i d e a。 全称 latin de russia location 钱在迪丽克雷分配一种统计学模型,专门从大量文本中发现隐藏的主题结构。简单说,给你一堆文章,他帮你找出他们大致在谈哪些话题。不用读懂每句话,而是通过词的统计模式来推断。聊 d a。 怎么工作的?先看直觉问题。 如果面前有很多文章,你怎么判断它们在讲什么?你会注意到词的组合, economy, growth market 常一起出现,那就是经济。 film actor award, 那 是娱乐。你通过词贡献模式判断话题。 l d a。 就是 把这种直觉变成可计算的数学模型。计算机不认识经济,电影只认识数字。第一步,把文字变成数字,分词拆成一个个词,建立词典, 给每个词唯一编号,每篇文章变成一个向量,比如 battery 两次, screen 一 次, camera 零次。这就是磁带模型丢失语序和语法,但保留了最关键的信息。 词频对所有文章做完转换后,得到文档。词矩阵表格里,每一行是一篇文章,每一列是一个词,数字是这个词在这篇文章中出现的次数。这个矩阵就是 lda 的 真正输入。注意,从这一刻起, 模型已经不看文本了,它看到的只是一个高维数字矩阵。 lda 最核心的思想, 一篇文章不是只属于一个主题,而是由多个主题混合而成。比如一篇文章百分之六十经济,百分之二十五政治,百分之十五科技,主题不是标签,而是概率分布。这个假设很重要,因为现实世界的文本来就是混合的。
 12:59查看AI文稿AI文稿
在文本挖掘中,我们经常有文档集合,例如博客文章或新闻文章。我们希望将它们分成自然组, 以便我们理解他们。主题建模是一种对此类文档进行分类的方法。在本视频中,我们介绍了潜在迪丽克雷分配 lda 模型,并通过 r 软件应用于数据,即来理解它。 什么是主题建模?主题建模是一种对文档进行无监督分类的方法,类似于对数字数据进 定型。剧类, 一个文档可以是多个主题的一部分,有点像模糊剧类或软剧类,其中每个数据点属于多个剧类。 简而言之,主题建模设想了一组固定的主题,每个主题代表一组单词。主题建模的目标是以某种方式将所有文档映射到主题,这样每个文档中的单词大部分都被那些虚构的主题补货。 主题建模的工具和技术将文本分类或分类为每个主题的单词,这些是基于迪丽克雷分部建模的。 什么是钱在迪丽克雷分配?钱在迪丽克雷分配是一种无监督算法,他为每个文档,为每个定义的主题分配一个值。 潜在是隐藏的另一个词及无法直接测量的特征,而迪丽克雷是一种概率分布, 我们要从数据中提取的主题也是隐藏主题,他还有待被发现。他的用途包括自然语言处理、 nlp 和主题建模等。这种方法遵循与我们人类相似的思维方式,这使得 潜在迪丽克雷分配更易于解释,并且是目前最流行的方法之一。不过,其中最棘手的部分是找出主题和迭代的最佳数量。 不要将潜在迪丽克雷分配与潜在判别分析也称为 lda 相混淆。潜在判别分析是一种有监督的降维技术,用于高维数据的分类或预处理。 为什么要进行主题建模?主题建模提供了自动组织理解、搜索和总结大型电子档案的方法。他可以帮助解决以下问题,发现收藏中隐藏的主题。新闻 提供者可以使用主题建模来快速理解文章或对相似文章进行剧类。另一个有趣的应用是图像的无监督剧类,其中每个图像都被视为类似于文档。 将文档分类为发现的主题,历史学家可以使用 lda 通过分析基于年份的文本来识别归类为历史上的重要事件相关的主题。 使用分类来组织总结搜索文档。基于 web 的图书馆可以使用 lda 根据您过去的阅读内容推荐书籍。例如, 假设一个文档属于主题食品,宠物狗和健康。因此,如果用户查询狗粮,他们可能会发现上述文档是相关的,因为他涵盖了这些主题以及 其他主题。我们甚至无需浏览整个文档就能够计算出他与查询的相关性。因此,通过注视文档基于建模方法预测的主题,我们能够优化我们的搜索过程。 潜在迪丽克雷分配及其过程潜在迪丽克雷分配是一种将句子映射到主题的技术,它根据我们提供给它的主题提取某些主题集。在生成这些主题之前, lda 执行了许多过程。 在应用该过程之前,我们有一定的规则或假设主 题。剑魔的 lda 甲设有两个。首先,每个文档都是主题的混合体。我们想象每个文档可能包含来自多个主题的特定比例的单词。例如,在双主题模型中, 我们可以说文档一是百分之二十的主题 a 和百分之八十的主题 b, 而文档二是百分之七十的主题 a 和百分之三十的主题 b。 其次,每个主题都是单词的混合。例如,我们可以想象一个新闻的两个主题模型, 一个主题是政治,一个主题是娱乐。政治话题中最常见的词可能是主席和政府,而娱乐话题可能由电影、电视和演员等词组成。重要的是,单词可 在主题之间共享,像预算这样的词可能会同时出现在两者中。 lda 是一种同时估计这两者的数学方法,找到与每个主题相关联的词的混合,同时确定描述每个文档的主题的混合, 并且这些主题使用概率分布生成单词。在统计语言中,文档被称为主题的概率密度或分布,而主题是单词的概率密度或分布。 主题本身就是词的概率分布,这些是用户在应用 lda 之前必须了解的。假设 lda 是如何工作的。 lda 有两个部分属于文档的词,我们已经 应知道这属于某个主题的词或属于某个主题的单词的概率。我们需要计算,找到后者的算法,浏览每个文档,并将文档中的每个单词随机分配给 k 个主题之一, k 是预先选择的。 对于每个文档 d 便利每个单词并计算。 现在,我们尝试了解他的完整工作过程。 假设我们有一组来自某个数据级或随机来源的文档,我们决定要发现 k 个主题,并将使用 lda 来学习每个文档的主题表示以及与每个主题相关联的单词。 lda 算法循环 便利每个文档,并将文档中的每个单词随机分配给 k 个主题中的一个。这种随机分配已经给出了所有文档的主题表示和所有文档的单词分布以及所有主题的单词分布。 lda 将便利每个文档中的每个单词。已改进这些主题,但是这些主题的表示并不合适,所以我们必须改进这个限制。为此,对于每个文档中的每个单词和每个主题 t, 我们计算 文档 d 中当前分配给主题 t 的单词的比例。主题 t 的分配在来自这个词的所有文档中的比例。将单词重新分配给一个新主题,我们以 p 主题 t 文档 d 乘以 p 单词主 题 t 的概率选择主题 t, 这实质上是主题 t 生成的单词的概率。在多次重复上一步之后,我们最终达到了一个大致稳定的状态 及分配是可以接受的。最后,我们将每个文档分配给一个主题,我们可以搜索最有可能被分配到某个主题的单词, 我们最终得到了输出。例如,分配给每个主题的文档。主题的最常用关键词由用户来解释这些主题。两个重要说明, 用户必须决定文档中存在的主题数量,用户必须解释主题是什么。所以,通常如果我们有文档集合, 我们想要生成一组主题来表示文档,我们可以使用 lda 来执行它,因为 lda 将通过便利每个文档来训练这些文档,并将单词分配给主题。但这不是一个循环过程,这里是一个学习过程。 他将便利每个文档中的每个单词,并应用上面讨论的公式。 我们将尝试通过 r 软件将 lda 应用于数据来更简要的理解他。 本文仕途从马蜂窝旅游官网上就新疆这个旅游目的地的游记进行主题分析。 读取邮寄政文, 去除标点数字字母,根据空格分裂词语后,将对象转为 utf 八编码 指定编码建立此库,否则磁条文档举证会乱码。 建立文档磁条矩阵, 然后进行主题建模。 基于对数自然核复杂度判断主题数量, 得到模型结果创建这样对象进行可视化, 得到主题关键词, 得到文档主题概率举证。
30拓端tecdat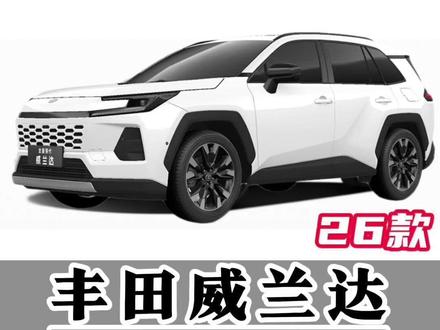 01:39查看AI文稿AI文稿
看完这条视频,您再也不用担心不会开车了,今天会为大家带来二六款全新威兰达车型,它的 l d a 车道偏离警示系统的功能讲解,很多朋友发现在转弯时或者变道时自己压线了, 车辆会滴滴滴一直响个不停,方向盘也会微微的去纠正,那不知道什么原因,接下来我们看一下 l d a 车道偏离警示系统的操作方式吧。 首先二六款威兰达都是通过上方单目摄像头来识别前方道路线,如果车辆识别到有可能偏离车道或者道路线的时候,系统会给我们驾驶员发出滴滴滴滴这样的鸣笛提示, 并且执行一些转向操作进行辅助,避免我们去偏离车道跟两侧护栏或者说两侧车辆发生到剐蹭。那很多朋友呢,说自己一直开车也是老司机了,不想用这个功能从哪里关闭呢?那么我们只需要通过中控屏进入我们左侧的车辆设定, 点击进入后,我们看到右侧这里呢有一个车道偏离警示系统,那么这个界面也是在我们的行车辅助界面, 点击我们的车道偏离警示,将它呢变成白色就代表关闭了此功能,那么您的仪表上此时也会显示一个 off, 如果开启的时候这个标识是没有的,关闭的时候他就弹出了,那么您的车辆在行驶时,他将不会在压线时发出滴滴滴这样的声音。包括呢?进行到一些转向辅助操作, 再来聊一下他的介入条件,车速达到五十千米每小时及以上,如果车辆识别到驾驶人员注意力不集中,那四十千米每小时及以上也会介入。像这项功能,他只是智能驾驶,辅助人车搭配才能更安全、更科技、更省心。 哎呦,养成良好的驾驶习惯,在你变道时打上转向灯,他将不会一直滴滴滴的去响了。好的,你学会了吗?关注我,带你了解更多丰田用车小知识!
138丰田弋锋 10:20查看AI文稿AI文稿
今天想给大家分享一个批判性思维的综述探讨,主题是 ai 时代的批判性思维是工具赋能还是思维异化?这是基于一项包含十九项实证研究的系统综述所做的一些反思。首先我们来看这个问题的提出。关于 ai 时代下的批判性思维, 其实是一场未完成的学术辩论,它里面是有两个非常明确的二维对立的观点。 综述里面是引用了 melazar 在 二零二五年的一个结论,那他们认为有的文献是呈现出了多样化的观点,一部分学者是警告 ai 工具可能会阻碍批判性技能的发展,而另一部分则主张有效应用时 ai 可以 促进学习。 一边其实是属于乐观派,他们会把 ai 看成思维的脚手架,能够去提供一些多元的视角,辅助分析、 支持论证鉴构等等。那另外一派是属于忧虑派,他们则是在做一些警告,这种行为是一种认知外包, 一键生成的完美答案正在消解学生的深度反思动机。那像现在让 a i t 我 想正在成为新一代学习者的一个默认模式。但现在我想追问的是,为什么同样的技术在不同的研究者那里得出了截然相反的结论,这仅仅是研究方法的差异,还是隐藏在背后的教育哲学假设在起作用。 要想回答这个问题,我们首先要看清楚 ai 对 批判性思维的一个双重效应。首先,好看好的那一面, ai 作为 助推机制,主要体现在 ai 作为思维延伸的三条核心路径。第一条路径是多元视角的快速接入批判性思维,它的本质是什么?就是对思考的再思考, 而这个前提是你能够接触到不同的观点。比如说我想要写篇关于教育公平的论文,那 ai 可以 在几秒内给你 自由主义、社群主义、批判理论等等不同流派的视角。你本来可能要花一周的时间查资料,但现在一秒钟就可能有一个观点市场,拥有各种各样的观点,这样的话,你就能够快速的去对接非常多的视角, 能够为你进行思考,甚至说进行再思考提供非常丰富的材料。第二条路径是认知复合的合理卸载。 anis 在 二零一八年说过, 批判性思维是理性的反思的技能,那其中反思是需要足够的认知空间。如果学生把大量的时间花在信息检测、格式排版、语法修正上,深度思考的空间就会被挤压。 ai 工具把这些低阶认知任务自动化了,释放出来的认知资源就可以投入到高阶的思维活动, 比如说像论证逻辑结构啊,去做证据的质量评估,以及去找到观点之间的内在关联等等。那第三条路径是原认知的外部出发。当学生要求 ai 批判性的评价我的论证时,它就是在进行一次外部化的原认知练习, 用 ai 来提供反馈框架,提供证据的充分性、逻辑的一致性以及反例的可能性等等这些,那这些都能够帮助学生去内化批判性思维的标准。 这像这种使用的话,就不是 ai 替你想,而是让 ai 帮你学习如何更好地想从。但是从对立面来说,也一定会存在一个意志机制, 过度依赖 ai, 它一定会产生一些认知代价。那这里引用综述当中的一个 warning, 过度依赖 ai 会阻碍学生自我反思和批判性评价的动机,这是最值得警醒的信号。具体来说,这个意志机制它会带来的代价有三个。首先第一个代价, 自我反思动机的消解。那如果我们花三个小时自己想出来的东西, ai 花三分钟就能给出看起来更加专业的答案,你还愿意去花那三个小时吗? 必然是不会。那当一键生成成为习惯,学生就会逐渐的失去苦思冥想的耐心,这必然会造成自我反思动机的消解。第二个代价是学术诚信的边界模糊。 当 ai 生存的内容与你自己的思考交织在一起的时候,什么是我的原创?这个层性清晰的问题现在可能会变得模糊不清,那这种模糊性他不仅挑战学术诚信制度,更深层次的,他也是在消解学生对思想所有权的一个认知。 你可能都不觉得你和 ai 共创出来的东西是你的想法了。那第三个是批判性判断能力的退化。那验证 ai 生成内容的准确性本身就是一种批判性思维练习,但是如果学生他默认 ai 说的都是对的,那这种验证能力就会逐渐退化。 大家也可以反思一下,你上次认真检查 ai 给你答案的是什么时候了。以上双重效应讲完了,我想带大家进行一些深层次的追问。第一个我想要提出的视角是学科差异,中数当中 指出了一个重要的方法,论的局限就是大多数研究都集中在 steam 领域,对人文社科领域影响的研究是非常有限的。那这不仅仅是一个研究空白,这可能也反映出了一个深刻的问题, 批判性思维它在不同学科当中的内涵是否相同?那在 steam 领域,批判性思维更多的会体现为逻辑推理能力,那在这个能力上, ai 的 辅助作用是相对直接的,因为它的对错标准是相对明确的。但是 在人文社科领域,批判性思维更多的可能会体现为价值判断能力,那 ai 在 这里能够走多远?多元的一个评价标准和解释空间, 这个可能是在这个领域里面使用 ai 的 一个很大的未知。所以在这里想留一个问题给大家,那如果一篇文学评论的观点是 ai 生成的,它究竟算不算是批判性的思考? 这个可能就会触及到人文教育的一些本质。第二个想要探讨的层面是能力的分层,就是高阶思维,它真的能够被增强吗?我们用布鲁姆的认知目标分类学来看,易理解层是 ai 可以 显著增强的,应用风险也是很低的。然后应用和分析层 是中等,但是到了评价和创造层这个地方打了一个问号,所以系统综述的发现正好是一个很好的证据。那研究表明,虽然 ai 可以 增强低阶的认知技能,但是它可能挑战高阶思维的一个发展。 我觉得这里的问题是在于,如果学生在低阶思维上越来越依赖 ai, 他 们是否还能够发展出高阶思维所需要的一些认知肌肉?就你不可能一辈子都在健身房里面用辅助器,你自己需要去练自己的力量,那思维同样也是一样的。第三个 层面的追问是一个比较根本的教育哲学层面的问题,就是当教育越来越强调效率和产出, 当 ai 被当做是提升学习效率的工具,那我们是否是在不知不觉当中接受了工具理性对教育的一个指引?那批判性思维从起源来看,本来就是对工具理性的一种反抗, 因为它是强调怀疑、反思和价值判断的。但具有讽刺意味的是,现在我们试图用最具工具理性特征的 ai 技术来培养本应该超越工具理性的批判性思维,那这个中间是否会存在一些不可调和的矛盾?我觉得是非常值得进行一些研究的。 那么我们应该走向何方?这个批判性思维的系统性综述最后提出要最大化 ai 的 教育效益, 教育者必须提供负责任使用的指导,并且鼓励学生运用批判性判断并验证信息的准确性。 我觉得负责任的使用不应该仅仅停留在操作层,他可能需要从三个层面去进行一些教育干预。首先第一层是,呃技术素养层, 我们要从会用到善用,学生不仅要知道怎么用 ai, 更要理解什么时候不应该用 ai, 那 这需要一种新的技术素养,我称之为技术节制力。那第二层的教育干预,我觉得批判性思维本质上也是远认知能力, 与其我们去教学生如何用 ai 写论文,不如教学生如何监控和评估 ai 辅助下的自己思维, ai 评估下自己的思考过程。比如 我们可以引导学生去思考一些关键的原认知问题,比如说在使用 ai 之前,我自己对这个问题有什么初步的想法,然后进一步的去看 ai 的 观点在哪些地方和我的想法不一致。那我最后采用了一个什么样的判断?我是否是因为 ai 的 权威性而放弃了自己的判断? 最终的成果当中,哪些是 ai 的 贡献,哪些是我的独立思考?我觉得这个可以作为引导学生去锻炼自己原认知能力的一个框架。 第三个介入的层面是价值澄清。我们需要去追问什么是好的学习,那最重要的是要回到教育的根本问题,也就是在 ai 时代学会学习究竟意味着什么?还有我们的学术诚信的内涵是否需要重新定义,以及原创性的标准是否需要调整。 因为我们教育的目的不是为了去培养高校的一个信息处理器,而是想要去培养有独立思考能力,能够去做出价值判断的完整的人。那这些问题可能都没有标准答案,但是对这些问题进行持续的追问,其实也是构成了 ai 时代批判性思维教育的一个核心。 那其实这篇系统综述它的一个答案是开放的,因为它没有给出简单的答案, 但它一直都在提醒我们 ai 与批判性思维的关系,它不是非黑即白的一个二元选择,而是一个需要持续协商的动态过程。在 ai 时代是应该包含一个终极命题的, 就是如何让我们的学生在享受 ai 带来的认知便利的同时,能够保持对思考本身的敬畏和热爱,以及如何在技术赋能的时代 不忘记人类思想最珍贵的品质,也就是怀疑、反思和独立判断。这不仅仅是教育技术的问题,更是每一个教育者和学习者必须面对的时代命题。 正如论文最后暗示的 ai, 它能够帮你构建论证,但是不能替你选择相信什么。能够给你提供多元的视角,但是不能替你形成自己的立场。 它能够帮你优化表达,但是不能替你承担思想的责任。那这份选择、立场和责任,可能才是批判性思维真正的一个内核。我非常建议大家去看一下这篇 ai 与批判性思维的系统性的综述。
111西里马拉 01:11查看AI文稿AI文稿
我卡姐到长沙去录节目的时候,居然遇见一个老乡,大家好,我叫易达,作为中国人,你们可能很难理解啊,因为全球每个角落都有中国人,但是芬兰人在全世界只有五百五十万, 所以我到长沙的时候能遇见老乡,那真的是两眼泪汪汪。这个小姑娘呢,是到长沙去工作,在 长沙跳芭蕾舞,所以长沙的朋友,如果你们以后在街头上遇见这个小姑娘,记得一定要给依娜打招呼。因为我去长沙的时候是我第一次,我对长沙也不了解,所以正好借这个机会呢,让我的老乡带我了解长沙。 了解什么呢?长沙的美食,可以跟老乡一边聊芬兰语,一边了解长沙的美食, 是不是很哇塞,喜不喜欢辣?我喜欢,人家特别喜欢湖南菜,好不好吃?好吃啊,真好吃。我在这里我就得批评你们中国男人,人家小姑娘长得那么好看, 居然没有人追她,你呢?你有没有男朋友?我没有,人家能在长沙没有男朋友,这是咋回事啊?
1.3万芬兰卡姐🇫🇮 东北话最6的芬兰人 02:13查看AI文稿AI文稿
我的鱼鳞焊怎么样?粉丝告诉我一个合成黄金的办法,它是由百分之八十九的铜、百分之五的铝、百分之五的锌和百分之一的硒构成,外观上和黄金非常相似,携带在身上不仅身价拉高好几个档次,还具有防敏抗菌的功效。 把这些金属全部融合在一起,就可以得到黄金了。哦对了,还需要一副药影子, 把它们全部装入干锅。要注意啊,心一定要最后夹,这个很容易上火的。 为了保证成功率,我决定用我二十多年的鱼鳞焊给实木磨具,再加一组钢铁盔甲。我的鱼鳞焊怎么样啊? 最近有好多粉丝都瞄上我的小骷髅,我知道你们都想要这个,我会把它放在闲鱼上,免费送给大家。最近大家都在用咸鱼卖闲置,很多都是九成新甚至全新未上风的,价格特别划算。我也经常在闲鱼卖闲置,点击链接搜老丹南就可以找到我了, 真丑。
3.1万老大南


