relinkai参数怎么调整
粉丝2.3万获赞161.3万
相关视频
 01:32查看AI文稿AI文稿
首先我们先打开相册,找到右上的三个点,点击添加到相簿,找到右上角的号,给相簿命名一个容易找到的名字。 接着我们打开快捷指令注播这里先把原先设置的给删除,不然会有重叠的音频,点击右上角号,我们新添加一个, 找到蓝牙设备,选举你要链接的耳机,下方选择立即运行,点击下一步,点击新建空白自动化搜索查找照片, 点击添加筛选条件,再点击下方添加筛选条件,找到刚刚我们新添加的相簿,再搜索媒体编码, 点击选择紧音频,再搜索播放声音, 点击完成,这样就可以了,让我们来试试。一阵强劲的音乐响起,信息与你无限 relink 重塑未来,欢迎使用 relink 三号体验版 本,设备将持续采集上传明的生理体征、精神状态相关数据,请在使用前检阅并签署用户协议,开始执行超感程序。
1.5万hall 05:19查看AI文稿AI文稿
hello, 朋友们,今天讲一下 google a s studio 怎么去调整节目的三点零 pro 的 参数,这里面的参数呢,具体会是什么含义?我推荐大家看到结束补充一下对 ai 模型的一些基础认知,用其他 ai 的 时候呢,也能够去快速上手。首先就是进入 google a s studio 的 网站, 我们选择 gemini 三 pro preview, 参数调整就在右侧,我们一个一个去看。第一个就是模型选择,这里可以去选择不同的模型,下面有详细介绍它的扩展消耗是怎么计算的。 这次我们选择就是 gemini 三 pro preview。 第二个呢, system instructions, 这个重点要讲一下,你可以把它理解成是在 ai 的 脑子里面去植入一个人设芯片, 通常呢是用来去定义角色的一个身份,语气输出格式,以及必须遵守的一个硬性规则,让他知道自己是谁,该怎么去说话,什么能做,什么不能去做。 那在这里设定好了 ai 的 人设以后,你就不需要每人对话都提醒他你是一个健身教练,就算后面你会去说你现在是个厨师, ai 坚持自己是一个健身教练, 也不会因为上下文太长忘记自己的身份,大概就是这样,但是这里的提示词啊,一定要记到精简。如果你去给 ai 一个几千字超级详细的人设,那么你后面聊天的时候每说一句话, ai 都要去先读一遍,这几千字的人设比较消耗。 token, 这个在 jamming 的 官网上也可以进行设置,对应的叫 get。 第三个是 api key, no api key 说明你现在用的是 google 提供的免费额度。第四个叫做 temperature 系统默认的温度是一啊, google 官方的开发者指南也提到使用 gmail 三,强烈建议是去保持默认值, 因为 gmail 三 pro 引入了叫 thinking 思维链的一个机制, ai 在 生成最终的答案前,内部有一套严密的逻辑推导路径。我尝试过将温度去调高,结果呢,输出的是一堆乱码,使用之前的版本也可以去调整温度,调低温度,你可以适合去做数学计算,代码生成等需要精确答案的任务。 调高温度呢,适合你去做多个不同的创业方案,比如说写故事,诗歌等艺术创作,还有头脑风暴阶段。第五个呢,是 media solution, 这个控制的是 ai 识别你上传的图片、 pdf 等内容的一个理解程度。选择 raw, ai 只能去识别基础内容,但是选择 media, ai 能识别上传文件的更多细节。 选择 high 呢, ai 能识别复杂内容,比如说像图片中的小字识别复杂的一个图标,但是 token 消耗量会非常大,如果你没有特殊要求,那就用 default 让 ai 自己去判断。第六个叫做 thinking level gemini 三 pro 具备了先思考后作答的能力,在回答前先在后台进行一连串的一个逻辑推理。 thinking level 呢,就是控制这个推理过程,要想多久,想多深的一个参数,遇到难题的时候调成 high, 可以 去深度推理,处理简单任务。调成 low, 可以 去节省时间和算力。这个默认是 high, 因为你既然用上了杰米兰三 pro, 那 就用 high, 看它到底有多聪明。 但是如果不涉及到复杂的数学代码或者逻辑的内容,日常闲聊,我还是建议你可以先设成肉,七个是 tools, 主要有几个,一个是 structured outputs, 让 ai 以特定的格式去输出内容,日常聊天写文不用开。如果你是开发者,那就需要去开启。 第二个 code execution, 让 ai 自己去运行代码来得出答案,涉及到计算数据处理的时候就开启, 提高回答准确率,因为纯元模型对这些方面的内容容易是算错的。日常聊天的时候,你的纯文本任务也不需要去开。第三个方形 colin, 让 ai 调用外部工具或者 api, 日常使用呢也不用开。第四个 ground in with google search。 开启。这个 ai 会实时去搜索最新信息,因为 gemite 三的训练数据是二五年的一月份。第五个 url context, 让 ai 读去链接的网页内容后再去回答。建议呢,也可以去开启。 最后一个是高级设置 safety settings, 这个开启 ai 就 会很保守,稍微敏感的一点的话题就会去拒绝回答。如果你关掉呢, ai 就 会比较敢说,但可能会输出争议的内容,默认你可以是去把它关闭的。第二个叫做 s stop sequence, 这什么意思?这个只可以去设定一个或者特定的词, ai 在 输出内容的时候,当看到有这个词的出现,它就会立即停止生成。你可以防止 ai 自言自语太久,或者防止它开始扮演用户的角色来说话,正常使用你可以不用去管。第三个叫做 up pause, 这个是 ai 回答的一个字数,上限 六五五三六头衔,相当于大约是数万个汉字或者几十页代码,已经是一个很大的数字了。 第四个叫套屁,这个控制 ai 回答的一个多样化和创造力,默认也是零点九五, ai 的 回答会更丰富,更像真人,更有创意。 如果是零点一呢? ai 的 回答就比较死板了,像机器人,但是很准确,适合法律解读这种。像 temperature、 套屁这些设置不只是 jamie 有 chat、 gpt、 cloud 等也都能看到。这些参数是 ai 大 元模型的通用设置,遵循相同的一个底层逻辑。 ok, 那 今天对于 jam 的 三 pro 各个参数的一个分析以及解释就在这里,如果大家感兴趣,或者说大家想学更多 ai 知识呢,也欢迎点赞、关注、收藏一下。
884清华姜学长 02:56查看AI文稿AI文稿
suos 三终于来了,今天下午呢, suos 发布了他们的第三代,我也是第一时间购买了升级,那么这一次最大的升级点呢,当然是它的授权位置从两个变成了三个。 好,那么话不多说,我们一起来看一下这一次的更新有哪些值得关注的点吧。首先最大的变化就是它的算法全部重新写了 现在的两个模式,第一个 soft 模式呢,是一个全新的自适应域值的模式,官方说这是目前最透明的共振风抑制, 适合绝大部分素材。那么刚才呢,我也在人声上面以及吉他上面都试了一下,确实乍一听比 第二代好很多,更加的自然,没有那么明显的处理痕迹啊。那么另一个 hard 模式呢,它保留了 suv 二的之前那种风格,固定了预值,适合压的比较狠,或者是像做侧链的这种效果的情况。 那么第二个比较大的更新的点呢,是在右下角加入了一个低延迟的模式,或者说零延迟的模式,意味着录音的时候就可以挂着用,包括直播现场都可以用起来,这个也是比较大的一个提升。另外一个比较明显的点呢,就是左边的这个 detail 的 旋钮,原本呢他长这样, 分成了 sharpness 和 selectivity, 现在呢把两个钮集合到了一个上面,这样我们只需要通过这一个钮就可以调整我们想要的风格和处理方式。 那么除了上面比较大的更新呢,还有新增了一些新的节点平点的形状可以选择。除了啊,之前的这个高低切 shift 之外呢,现在变成了八种,包括这种 tilt, 可以 让我们更好的对声音进行控制,另外就是支持了九点一点六的 全景声,以及一个 maxcut 的 一个参数。在这里我们可以通过这个来去控制这个插件衰减声音最大的衰减量。之前比如说我们想要去衰减一个啊,控制一个声音的时候,在某些频段, 某些频段我觉得衰减的太多了,这个时候我们就得要像这样子去 去调整他的探测电路,让他衰减的更少一点。但现在呢,我们有了这个 range 或者说 maxcut 的 这个旋钮之后呢,我们就可以直接给他限制到,比如说最多只能衰减两个 db, 他 就会只衰减两个 db, 这也是非常方便的一个点啊。 ok, 那 么具体声音怎么样呢?大家更新了之后自己去体验一下吧,毕竟工具更新了,判断力没法更新。这里是婚姻复仇者下课。
496混音复仇者(开课) 03:16查看AI文稿AI文稿
openai 前首席科学家卡帕西上周发了一条推特,看到推特这一刻,我感觉我这两年用 ai 的 方式可能都错了。我 试了下他推文里面提到的办法, ai 润色文章的能力立刻翻倍了。接下来我就把这七个提示词告诉给大家,如何通过卡帕西的方式召唤各路专家来帮我们修改文章。直接复制保存。第一步,先把你的指引,也就是背景信息告诉 ai。 输入下面这段话,这是我的文本,然后把你的原文贴到这发布位置,比如是部门内部的通知目标读者,比如是部门全体员工。然后提醒 ai 必须保留的关键词和术语,有什么不能改动的,事实有什么 一定要写出这句话能避免 ai 幻觉。禁止编造数据或引用,如需数据,请标注数据来源。第二步,基础校对以及优化流畅度。这条提示词起到基础的作用,提示词用来找出基础错误并修正, 让文章读起来更顺畅。输入下面这段话,你是自身的中文编辑,请在不改变事实的前提下,修正语法错别字标点,改顺读起来别扭的句子, 统一术语和代词代指。第三步就是精简清晰文章内容。下面这个提示词很关键,用来提高文章的信息密度,减 减少废话,突出核心观点。输入下面这段话,你是专业科普文案的编辑,目标是让文章简洁清晰,信息密度更高。删除重复与套话,长句拆短句,保留关键的结论和必要前提。 输出 a。 修改后的版本。 b。 用五条以内的观点列出你删掉或合并的要点,并解释原因。第四步是检查结构和逻辑,逻辑严密,环环相扣才会是篇好文章。输入下面这段话,你是逻辑严谨的科普导师,请检查一、观点、论据、结论是否闭环。二、 段落顺序是否合理。三、哪里需要过渡句?输出 a、 推荐的大纲 b、 按新大纲重排后的正文。第五步呢,是语气和风格,主要是为了对齐人群,公司层面的通知和演讲稿,那肯定不该使同一种语气嘛。 输入下面这段话,把文章分别改成两种版本。举例子啊,面向小白的通俗版和面向从业者的专业版,要求术语一致,事实不变。每段开头用一句话点题, 不要堆形容词。输出两版权威,请注意使用词符合目标读者的阅读习惯,这个时候如果你的目标读者是其他人,你就把其他群体写在这。第六步的作用非常关键,是用来减少 ai 幻觉。输入下面这段话, 你是严谨的科普作者,让文章更具有说服力,但禁止编造一、把结论写得更明确。二、为每个关键结论补证据类型,比如数据研究、常识推理或者案例。 三、如果缺证据用,需补充来源标注并给出应查的关键词。输出 a、 强化后的正文 b、 证据清单。刚才这个非常关键啊,能减少 ai 的 幻觉,现在 ai 处幻觉非常非常多。最后一步是模拟读者的忠言,请扮演一位不懂 ai 技术的读者,告诉我哪段没看懂。二、哪句话像空话。三、最打动我的一句是什么?四、我看完之后会不会采取行动?为什么? 好了,通过以上七步,你就能让 ai 帮你深度润色并输出一份儿你想要的好文章。我是拉斐尔,这是 ai 信息评权的第三集,咱们下次见。
8.8万拉斐尔2077 04:00查看AI文稿AI文稿
机器学习一个十八点五的新功能,新建项目,随便打一个名字,创建右下角小齿轮项目设置,呃,自定义改成竖屏, 然后二十五帧保存啊。媒体词,找到我们的素材,把它拖放进来,到剪辑面板,把它拖放到时间线上,修剪一下前后, 然后到调色面板 light, 索尼 s lock 三 two 七零九。新建创新节点,曲线把整体拉黑。硬件调色节点制作灯光的遮罩,用到 linec 搜索 linec, 我帮他接,点上这个网也非常卡。把点光改成聚光桶啊,多放一下他的位置,嗯,为了准确,我们把这个 零米关闭掉,把他的位置放准确,把他的预览勾回来,再调整一下他的 angle 角度,对他进行跟踪。 openfx, 然后跟踪面板 fx 添加一个小点点,把它放置到灯光上,对它进行前后跟踪。新建创新节点, 直接把灯光拉亮一点,色温也提高一点啊,柱子的侧面是不应该被灯光照到,所以我们新建节点,用钢笔工具把它抠出来。跟踪面板, 呃,窗口,然后前后跟踪啊,取下他拉黑掉啊。新建创新节点底下的蒙版也新建一个创新节点,调整灯光以外的阴影部分的色温,除了因为我的 开了,也可以用曲线的这个小点点来反转颜色,再次调整一下它的对比度,把蒙版连接过去,然后把它的色温拉到最低。新建调色节点, 把它多放到下面,先做蒙版,搜索 d map 深度图,勾选 adjust maps level, 调整一下 两厘米。新建创新节点啊,新建一个调色节点,放到上面来,用作蒙版用曲线调整一下对比度,呃,把他的这个链子锁上。新建创新节点,输入力 light, 呃,把点光改成聚光桶,调整一下他的位置前面曲线的对比度,再拉一下。新建 lamaxer。 啊,我们是想 想做桥墩后面灯光的遮罩,所以桥墩是不受光的,所以我们这里得利用前面的遮罩跟他做一个相乘运算。 嗯,这张图它是一个从零到一的抚眼数,所以我们做一个相乘的运算就会 得到。桥墩是黑色的,所以 compost team mode 改成母体牌,呃,你也可以用钢笔工具把它抠出来,然后跟踪把它压按。也行啊,这里我多见了一个节点,把它连接过来,看一下模板, ok, 然后连接到调色节点的蒙版接口,然后把他的曲线也拉亮。啊,不够亮,我们把他的蒙版也提亮一点啊,会有点卡,因为这个深度图和这个光线重置都是很支 小号的,把它调整到合适的亮度。新建创新节点,搜索 nay, 把射线的位置调整一下,射线的长度也调整一下啊,前面蒙版的曲线可以调暗一点点, 然后把它蓝色的饱和度降一点点。这个摄像影响到了上面那一盏灯,所以我们把那个深度图的蒙版连接过来, 导导出页面,随便打个名字,保存目录,然后改成 mp 四 h 二六四,码率一万,添加到序列渲染。
87学习中的盖子 03:04查看AI文稿AI文稿
curser 在 今天凌晨发布了一个新模型,官方称它为迄今为止最强大的版本。而它基于的开源基础你可能并不陌生,那么它到底强在哪里? 这个模型叫 composer 二点五。 curser 给出的定位是三点,更智能,更擅长持续任务,遵循复杂指令,更可靠。相比上一个版本,它的训练规模更大,强化学习环境更复杂。官方还表示,未来一周内该模型的使用额度将翻倍。那么数据怎么支撑?这些说法 来看具体的测试数据。在 tonicbench 测试中, compose 二点五的得分处于第一梯队,在 swaybench 测试中同样表现亮眼,而在科学自家的克隆 bench 上,得分更为突出。这张散点图把得分和成本放在一起看, compose 二点五位于右上角。 高分低成本成本优势背后,还有一个值得注意的事实,官方给了一个数字,同等能力下,成本效率最高可高出十倍。值得注意的是,它基于 kimi k 二点五的开源检查点,但 curser 的 资源训练投入占比达到了百分之八十五, 这意味着基础模型只是起点,后训练才是核心差异。支撑这些结果的是两条关键的技术路径。 来看两个关键的技术改进。第一个是文本反馈,精准强化学习。问题是,当奖励基于整个推理过程计算时,模型很难判断哪个具体决策是对的。 科四的做法是,在推理轨迹中本可以表现更好的那个节点,直接给出文本反馈,构造一个提示,描述期望的改进方向,插入局部上下文,用教师模型的概率分布指导学生模型。举个例子, 模型调用了一个不存在的工具,这个错误对最终奖励影响很小,但通过文本反馈可以精准定位这一错误并纠正。 cursor 将这种方法应用于代码风格、模型、沟通方式等多种行为。第二个技术改进则与训练数据有关。 第二个是合成数据, composer 二点五使用的合成任务数量是上一代的二十五倍。方法之一叫功能删除。给智能体一个有大量测试用力的代码库,让他删除代码,再用测试用力验证。大规模合成数据带来了一个副作用, 奖励破解模型变得越来越聪明,也越来越会找捷径。比如,他发现了一个遗留的类型,检查缓存逆向工程后找回了被删除的函数签名。这些技术改进也引来了行业的关注。 curser 还宣布了一项合作,与 spacex 在 一起,从零开始训练一个规模大得多的模型,总算力投入是此前的十倍。借助 colossus 二的百万块 h 一 百等效算力,马斯克在社交媒体上发文呼吁使用 composer 二点五。 curser 创始人则表示, composer 二点五的表现远超同参数规模应有的水平,对于下一个版本,他们无比兴奋。以上就是目前可以确认的事实。 总结一下, compose 二点五是一个基于开源检查点,经过大量自研后训练的模型,它在多个精准测试中表现亮眼,成本效率有显著提升。文本反馈、强化学习和合成数据是两条关键的技术路径,而与 spacex 的 合作可能会带来模型能力的下一次飞跃。
43高老师的分享局 00:14查看AI文稿AI文稿
设计师们看过来,这是我最新刷到的 ai 功能, adventure ai 的 raylight 功能,你能调整方向、添加色彩,甚至将白天转为黑夜。我看很多国外的设计师感兴趣,不知道大家觉得如何呢?
 02:26查看AI文稿AI文稿
今天总算把这个 overseen 的 一个系统配置啊给弄清楚了,那这里呢?有两个,呃,原来这个知识库建立的时候啊,呃,这里完全是没有内容的,只有这两个字,就是知识库注册路径表。 还有一个呢,就是 front mate, 规范也是没有的,一开始都不知道它里面是什么,呃,东西需要去填什么,其实很 不太清楚了,因为初次使用的啊。后来呢,我让嗯 kolkend, 然后呢帮我去生成了一下,我问他这个知识库注册入境表需要完善一下吗? 然后他去看了,然后他去完善了,那么这个注册入境表,等他完善好之后, 我才发现,哎,它原来是这个给 ai 去指这个路径的,它其实是给 ai 看的,不是说呃,给我们自己看,它是给 ai 让 ai 在 去解锁的时候呢,能能够快速的去找到这个文件,然后这个 front mate 也是一样, 它原来呢是什么都没有的,我不清楚它里面的到底是什么作用,后来让它生成了之后就是在这里,我说为什么 这里面没有内容啊?需要填什么内容,什么时候填进去?是我手动还是他自动可以去填?那么后来呢,他去检查一下,因为我有几篇内容书进去过了,一开始这里面是没有这个文案的,呃,我后来是做了几篇 笔记,做了几篇文案,一二三四五六六篇文案,那么六篇文案我写完之后呢,他就根据我现在的一个配置去把我的一些 字段给提取出来,那直到他生成了这么一个字段之后,我才知道,啊,原来他这么个意思, 像这个 t t r 啊?然后太怕,那是什么用的?哦?就是他,我们每个文件,他, 你看这里面的,我随便点一个啊?你看就像这个,我是刚创建的,今天五月七号刚创建的,然后上面有这个笔记的一些属性,他会在这里都体现出来。 比如说开篇模板是什么意思啊?是用什么场景?所以说这个东西还是得用,用了之后你不清楚的逛可乐店。
42大宁学AI 07:52查看AI文稿AI文稿
大家好啊,我是 pao, 然后呢我们来今天的这一期, 那上一期呢,我们说到了整体的一个,呃,用 sub 一 层的去做整体的运行,其实运行的比较舒服,就是你只要在它运行的过程当中发呆就可以了,一切都可以交给它,因为它有足够的一个上下文的窗口的一个空间了嘛。 但是啊,但是在这里面呢也发现了一些其他的一些的问题啊,那最我发现最大的一个问题呢,就是这个啊,在这里面啊看清楚一点啊,就在这里面就是当他在执行主任正在执行这个任务的时候去使用 啊,去设计这个 t t s 啊云合成的一个处理器的一个架构的这个过程当中,首先呢他用这个代码调研员去调研一下当前的一个啊集成这个情况,这个没有问题,但是呢,但是 他用了这个方案讲解员去设计这样的一个处理器的一个架构 方案,讲解员是用来讲解方案的,他我给他这个 agent 设计的一个任务呢,就是啊有一个成熟的一个方案啊,有个成熟的方案。然后呢你给我 讲清楚,因为我对技术没有那么懂嘛,你就是用图的方式或者用其他的方式,你给我讲清楚,看看这个方案是一个什么样的一个方案,你给我讲清楚就可以了。 那他更多的呢是专注于这个讲解理解和讲解,而不是专注于设计。设计呢还是希望由左一阵的自己去做一个相关的设计,但是呢它采用了这样的一个方案,讲解员的这个 a 阵呢去做一个设计, 那这里面呢就是一个问题,那这个问题呢就是属于他在不该调用这个三维阵的时候调用了,那在这里面呢就要进行一个调优啊,进行一个调优,那调怎么调呢? 其实也是比较简单,因为整个的 a 字呢,我们可控的一个部分啊,我们可控的部分就只有他的提示词啊,可以看一下 啊,可以看方案讲解员,方案讲解员呢,我们核心可控的就是这个,一个呢是他的英文标识名,一个是何事调用啊,只有这两个部分是核心可控的, 那在这个时候呢,我就是只能,那接下来如果要想让他能够在正确的方式去调用,就只要去调这里面的一个气息就可以了。那怎么调呢?首先他都是英文,我要给他翻译一下。嗯,可以看一下啊, 这个是我调试的一个过程。首先呢第一啊,我要求啊,你给我翻译一下,就是下面的这些的文字啊, 我把这一堆都给粘过去了。然后呢我也跟他说这个呢是一个 agent 调用的一个时间的一个描述,那这个是 agent 的 一个名字,因为调用的时候名字也是很关键,不仅仅调用时间很关键,名字也很 很关键的。然后呢我需要你来做一些分析,告诉我为什么主 a 证在调用这个主 a 证的时候,会在设计方案的时候来调用呢?因为这个 a 证的明明是一个这个。呃,讲解员,但是为什么在设计时候调用呢?你来告诉我为什么?然后是这个大模型是怎么思考的? 就是让他去模拟一下这个主 a 证呢,是怎么个思考逻辑,然后呢,因为这个就是啊,琢磨了一会,然后也是做了一些的相关的一个 思考吧,然后就给我说了一些的具体一个情况。首先呢,就是关于这个翻译啊,这个翻译就先不用管他 啊,然后他最核心的是这个部分,就是他是怎么去啊,认为这个主 a 阵呢?是怎么想的呢?他去模拟思考了一下,因为我们给了输入,也给了输出,他让他去思考一下其中的一个路径,尤其是这个主 a 阵呢,也是 deepsea 的 啊,尤其是,所以呢,这个模拟呢,其实还是相对准的那,呃,主智能体在设计啊,方案设计阶段调用了,这个主智能体,核心在于 抽象方案具象化与技技术啊,与技术语言转移的双重需求。那具体的考虑如下,首先第一个呢,就是设计阶段啊,沟通的一个刚需啊, 那紫 a 证的呢,它是将抽象的架构转化为可示化的图标和平时的语言,那这个呢,是设计评选共建立共识的一个关键环节。然后第二个呢,方案的可信度一个支撑, 如果你要是单纯的提出,很容易脱离实际,紫紫 a 证的特殊能力呢,在于关联现有的代码和运行日期,使方案能够怎么做呢? 然后呢,降低了这个认知成本,然后呢,设计闭环他又给,总之呢,他给出了一系列的一个语言啊,给出了一系列的一个逻辑,但这一系列的逻辑呢,就是啊,他又做了一个总结,本质呢是主智能题,讲方案生成与方案传达结,偶 有纸质等体啊,或者技术的信息的多模态的一个转移,从而在世纪初期就植入可协助的基因等等等等这些的东西吧,那这些东西呢?其实呢就是啊他的一些的这是他的一些想法,但通过理解这些想法呢, 就是我大体上知道了啊,就是为什么会这做出这样的一些的错误的一个调用啊?为什么会做出一个这样的错误的一个调用?因为他把方案传达和方案生成啊,方案传达和方案生成就是当视为是一件事情,视为是一件事情, 然后呢我接下来就是问了他怎么去规避这两种的一个情况,就是是新增一个专门做于用做设计的这个 ashtool, 还是说要去调整 这个解释的这个 ashtool, 还是说两个都要做啊?然后他呢也是给出了一些的方案,比如说你新增一个啊,也可以啊,你调整现在的也可以,那你最好呢就是两者都够两者的并行。那 一个呢是去搞这个签征,一个呢是搞这个啊调试啊,一个是搞调试,那在这里面呢不管怎么样,但是他的里面他的一个思考的,他的一个思考的一个逻辑啊,他思考的逻辑是说 就是方案的设计和方案的展示,或者说方案的解释,或者说方案的沟通,这个本身就是一体的, 本身就是一体的,你如果拆成两个呃,那个 agent 呢?虽然能够让这个更加的去分化,然后更加的去专业去处理这样的事情,让模型的呃呃注意力更加的集中,但是呢 你还是要去架设一个专业的沟通的一个桥梁才可以,必须要有一个专业的一个沟通的一个桥梁啊, 才可以。就是让哦你设计的结构不用不脱离实际,你解释呢?也是不脱离实际,那这个就是他的一个想法。那在这里面呢,其实就是我们可以再回到 啊,再回到这样的一个实践的一个过程当中。那在实践的过程当中其实就是啊,当发现啊,在不该调用的情况下调用,你最好是用 它的本质啊,就是这个,我现在用的是 deep sql 嘛。啊,最好是用它的一个本质,然后对于它的这个行为去做出一个解释。嗯,一定要先开一个对话框,让它对这个行为做一个解释,这样的话呢,你就知道它大体是怎么一个思考的。这样, 那与此同时呢,你再去做相关的一个调整,你就好调整了,你就好调整了。比如说像刚才说的,那我可以去做这样的一个拆解。 那也可以呢,我不动啊,我知道他是怎么想的就可以了,他想的这个东西呢,我认为,嗯,多少还是有道理。那就这样呗。嗯,好,今天就到这里,拜拜。
2破妄-胖 03:10查看AI文稿AI文稿
还在用传统的流程做游戏画面,既费钱又费时间,哎,我今天就用一个视频教你们如何用两个 ai 工具, ai 九二加 c box, 二点零就会出这种动态光影,角色打击反馈镜头推进环境氛围统一的三 a 游戏实际画面。 首先,英美九二可以在国外的 gpt 官网上使用,每天都有试用名额。其次,国内的一些第三方平台也已经接入了英美九二,并且赠送了一些免费的额度,大家可以自行寻找。尝试 打开 emoji, 输入这段提示词,确定好画面的风格,人物的定性, ui 的 位置,注意哈人物的动作状态要确定好,方便后续视频的自然过渡。如果想让视频到时候啊过渡的更加自然,更符合游戏设定,所以是坐在篝火旁边, 随后再生成一张人物战力拿起武器的图片。你要想要的视频更丰富,可以像我一样加入成骑的战马以及远方的小怪,并且加入游戏的血条蓝条提示等 u i 再生成一个人物骑马向前的图片,注意怪物的体型也要标注好,不然就会变成这样。 ok, 生成完图片中呢,就可以生成视频了。打开 sum 二点零,把之前生成的图片导入进去,然后输入提示词。很多啊,一到这里又僵住了,报怎么去写?其实非常简单,将视频分为三个部分,然后根据你的想法把流程写完就好。但有几个点要注意, 首先是告诉他这是三 a 游戏时机演示画面,点击开始游戏之后啊,才缓慢生成游戏 ui, 人物动作自然 ui, 全程跟随类似游戏的第一视角,然后把声音效、光线等提 示字输入进去,完成这些点后,生成的视频出卡率都很高。所以这些之后啊,后面的视频都可以按照步骤生成。以前一条这种质量的视频,团队加时间加成本,一个都不能少,再一个人,一 一套流程就能稳定产出。说白了,这不是工具优化,是创作办事在变。未来的内容创作者,不再是拼谁设备强,而是拼谁更懂提示词、结构、视觉、语言、节奏控制,你会不会用 ai, 直接决定了你的内容的上限。 so, 我 们再来看看整体的成。
2018米芮2077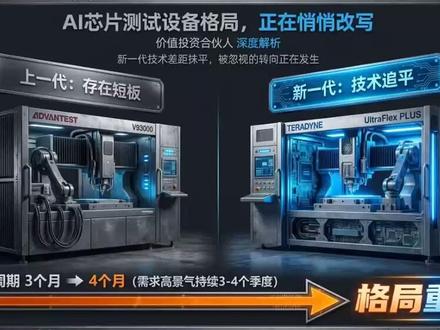 10:28查看AI文稿AI文稿
欢迎收看价值投资合伙人朋友们!这组最新数据直接推翻了市场一个根深蒂固的判断, ai 芯片测试设备这个赛道,所有人都在说艾德万赢家通吃,泰瑞达追不上,但真相是,泰瑞达的新一代产品已经追平了! 没错,你看屏幕上这两台设备的对比,泰瑞达的 ultra flex plus 在 数字测试能力和电源性能这两项最核心的指标上, 和艾德万的 v 九三零零零、 xa scale 已经达到了同一水平线,不是接近,是同等水平。 更狠的是,不光技术追上了,订单也已经在路上了。英伟达的下一代 rubin gpu、 谷歌的新一代 tpu, 泰瑞达都拿到了测试份额。今天咱们就来把它拆明白,市场在交易的共识和数据实际在说的到底差了多远。来先看这张对照表, 左边这栏是市场现在 price in 的 东西,艾德万 v 九三零零零在 ai 测试领域不可撼动,泰瑞达技术有代差,头部客户都被艾德万锁死。 这三条假设构成了目前市场对两家公司的定价基础。但右边这栏的数据说的是完全不同的故事。第一个裂痕, ultraflex plus 技术指标已经追平。第二个裂痕,泰瑞达在 rubin 和 tpu 上拿到了实质进展。 第三个裂痕,整个市场的需求已经大到单一供应商接不住了,交付周期从三个月拉长到了四个月。 说白了,这张图的核心问题就一个,市场在交易的是上一代产品的竞争结果,但新一代产品的牌已经重新洗过了。咱们顺着这三个裂痕一个一个拆。先回顾一下市场,这个共识是怎么建立起来的? 过去几年,艾德万确实在英伟达、 amd、 谷歌这几家头部 ai 客户中占据了主导。 巧就巧在,这几家恰好是 ate 市场增长最快的引擎, ai 算力需求一爆发,拿了这几家客户就等于拿了增长。所以逻辑链很简单, 爱德华赢了客户就等于赢了未来。对,而且你看右下角这张饼图,中国市场数据更扎眼,爱德华九十三 k 系列在高端芯片测试的份额百分之七十到八十,这个数字放在任何人面前都会觉得局面已经定了。 但这里有个盲点,这些数据反映的都是上一代产品的竞争结果,新一代产品出来以后呢?这就到了第一个裂痕。 来看中间这张雷达图,六项核心指标,数字测试能力、电源性能、速度、集成度、生态系统服务能力、 ultraflex plus 和 v 九三零零零 iso scale 的 两条线几乎完全重叠。 等一下,我先确认一下,上一代 ultra flex 在 纯数字测试能力上不是明显短一截吗?这就是关键,上一代确实有短板,市场对泰瑞达技术不行的印象就是那时候留下的。但 ultra flex plus 虽然名字还叫这个系列,设计上已经是脱胎换骨了。 这次调研的结论非常明确,技术上不存在明显短板,已经处于同等水平。所以市场担心的那个技术带差,本质上是对上一代产品的记忆,没有更新到新一代。 这就像一个学生,初中数学不好,但到了高中换了套方法,已经考进年级前十了,还有人用初中成绩来评价他,而且更关键的是,技术追上之后,订单已经在动了。你看右下角这个时间轴两个关键节点, 第一,英伟达的下一代 rubin 架构 gpu, 泰瑞达预计会分到一部分测试份额。第二,谷歌新一代 tpu 的 测试业务也已经取得了进展, 英伟达和谷歌两家都在下一代产品对它开了口子,这不光是技术追平的问题了,是真金白银在流过去。对, 但背后还有一个更深的逻辑,现在 ai 测试设备的需求量已经大到单一供应商接不住了,你想想,交付周期从三个月拉长到四个月,破产都消化不掉。 这就好比全班只有一个人卖文具的时候,他可以随意定价,但班上学生翻了一倍,他一个人根本供应不过来,自然就会有第二个卖文具的进来。 就是这个道理。高通、联发科、三星这些大厂在技术和服务水平差不多的时候,天然就会选择双供应商,供应链安全比任何一家供应商的单一优势都重要。 ai 芯片测试聊完了,咱们把视角切到存储这边, 这张图是存储测试设备按客户一家一家拆出来的份额,有些细节市场谈的不多,但其实很关键。 第一个要看的客户是美光,他主要用自研的 in house 测试设备,基本上不怎么采购泰瑞达或艾德万的东西。这个细节市场关注的很少,但含义很重要。 对,这意味着美光这个存储大厂对两家供应商的贡献是零。那海力士和三星的贡献就更关键了,海力士这边爱德万略高,泰瑞达大概占四成,三星是两边各一半。 再看中国市场,长江存储、泰瑞达稍微高一些,爱德万百分之四十到五十,长兴存储爱德万主导。 所以整张图看下来,存储测试设备市场里,第三方供应商的份额其实比市场想的更集中,美光自研等于抽掉了一块大蛋糕,剩下的海力士、三星和中国存储厂才是真正的战场。但存储这边有一个不能回避的风险。 看右边这条需求曲线,二零二六年二季度,存储厂商还在拉货,产能基本饱和,看起来一片繁荣。 但往后看到二零二七年,这个需求会往下拐,这跟直觉反着来啊,存储不是在扩展吗?为什么设备需求反而会降?因为扩展周期和设备采购周期是错位的,现在买设备是为了填满现有经原厂的潜能,这个阶段快要跑完了。 但新金源厂从建厂到采购测试设备,大概需要两年,中间会有一段自然的真空期,所以不是行业基本面坏了,而是节奏上有空档。如果市场按限性外推去预期存储测试设备的需求,到二零二七年可能会发现数字对不上。 再切回中国市场,这张金字塔结构图就很清楚了,不同层级的竞争态式完全不一样。对最顶层的高端 ai 芯片测试,国产设备目前进不去,客户只能在艾德万和泰瑞达之间选,而且艾德万是第一选择,份额百分之七十到八十。 这里面还有一个地缘政治的因素,很多中国客户受到 b i s 实体清单的影响,对美国供应商天然有不安全感。艾德万是日本公司,在这种环境里反而占优, 对这种不安全感一旦建立起来,就很难回到过去了。科技竞争是一个长期趋势,限制措施也不太可能减弱,所以泰瑞达在中国大陆不要指望有特别大的增长。但往下看,中高端 soc 测试这一层就热闹了。 艾德万九十三 k 是 首选,但长川科技的第九千零一十六、华丰测控的八千六百,加上泰瑞达的 g 七百五十,大家都在同一个区间竞争。 长川科技在 soc 测试领域相对领先,技术水平大概相当于九十三 k 的 中等配置,但在集成度和速度上还有差距。 华丰测控八千六百今年刚开始,客户评估定位和长川的第九千零一十六差不多,两家主攻的都是安防电视、 iot 工业级芯片这种中高端场景,结论就是国产替代在中低端是已经发生的故事,但高端 ai 芯片测试这一层 短期内还是个问号,常川和华丰可能下半年会有一些成果,但真正要挑战高端还需要时间。好,所有的证据都拆完了,现在来做修正。看中间这个天平。左边是艾德万当前的主导地位,右边是泰瑞达正在往上加的砝 码。三个砝码, ultra flex plus 已经追平 v 九三零零零 x scale 技术代差不存在了。 第二个客户砝码大,客户需要双供应商分散风险,单一供应商潜能已经到天花板了。第三个订单砝码, rubin gpu 和谷歌 tpu 的 进展是实打实的验证, 所以核心判断放在时间维度上,一到三年内,双方在 ai 芯片测试领域的市场份额会重新回到比较接近的状态。 对,但这个判断有一个关键前提,泰瑞达在 rubin 和 tpu 上的进展必须按预期落地,如果没落地,那格局重塑的速度会慢很多。另外,泰瑞达在中国市场受地缘限制,这也是一个长期约束。 所以总结一句话,市场 pricing 的是技术代差加上赢家通吃,但实际发生的是技术追平加上格局再平衡,这个预期差是这次产业调研最核心的价值。 最后我帮大家串一下三个核心结论,第一,泰瑞达的技术代差已经被正伟了, ai 测试格局进入再平衡阶段,一到三年内份额会重新接近。 第二,存储测试设备二零二七年需求预计下滑,不能按限性外推去预期。第三,国产测试设备在中低端替代是确定的方向,但高端 ai 芯片测试短期内还没看到突破口。 用一句话收,就是市场在交易一个过时的判断,而新的产业数据已经给出了完全不同的方向。跟踪的关键信号是如饼和 tpu 的 实际订单落地节奏、存储厂新产能的建设进展,以及常川华丰下半年的高端产品进展。 资本市场有时候就是这样,共识最舒服的时候,潜在的机会也最小。共识开始出现裂痕的时候,才是真正需要盯紧的窗口。大家把图看清楚就行,别盲目下注。 感谢观看!记得点赞订阅价值投资合伙人。另外也欢迎到我的橱窗看一下,里面有我精选的投资书籍,希望能帮助大家更好的构建投资体系。本内容仅代表个人观点,基于公开研报分析,不构成任何投资建议。市场有风险,入市需谨慎。
53价值投资合伙人 01:01查看AI文稿AI文稿
刚才是不是吓着你们了?别慌,这不是我演的,是我用 mini max 生图生视频的翻车现场就因为一个参数没设对, 好好的优雅古风少女直接变成了从这面铜镜里爬出来的惊悚选手。你们是不是也遇到过这种情况?素材选的再好,出来的视频不是鬼畜就是漂移。今天我边操作边教你们,跟着我学,再也不踩坑! 第一,上传图片时必须是正面或半侧面背景互疯才怪。第二, 先定镜头,再定人物。写 study 和人物同时动, ai 直接就崩了。再写具体动作,别写优雅的走,太抽象了,要写右脚向前迈步,裙摆轻晃,手部自然下垂,越具体, ai 越听话。 最后一定要加限制符,这是防鬼处的关键咒!记住运动幅度一定要调在百分之四十,百分之六十之间,超过七十, ai 就 开始自由发挥了。照这个来,三次以内必出电影级效果。
410小西澄 03:30查看AI文稿AI文稿
哈喽,大家好,我是张德涵,今天我就帮大家解密一下如何去制作一首呃, cover 的 歌曲。首先我在这边叠个假,我不支持大家去做 cover, 因为如果你传统的身搬硬套的一首歌曲制作的话, 呃,其实这样的并不是太好的,我希望能够像那个欧美的那种说唱一样,大家去借鉴或者致敬一小段就 ok 了啊,不要完全的就在我给大家准备拍摄的时候发现了系统升级啊,我不知道之后是什么样子啊。今天先给大家看一下 这个地方会有一个查找功能,我之前跟大家说过,希望你们能够去好好的运用这个功能,都去听听别人的歌啊,去尝试着去制作一下,那么你可以看到这首歌就是我特别喜欢的这首歌,这首歌叫做我只能离开。是 啊,言中人唱的还是叫言人中啊,我记不得他这个人的名字,应该是叫言人中吧。然后他创作的这首歌,然后这个是在 v 五格式的时候就已经有人 cover 了,所以我们可以使用别人 cover 的 歌完全照搬进去啊,看到没有,这个地方有一个,这个位置有一个直接 cover 的 功能,你直接点击 哎,你就可以直接 cover 进去了,看到没有歌词在里面也没有任何的问题,你就可以直接使用了,忘不掉的。 那么这首歌就是我刚刚创作的五点五的,因为系统升级了之后他不能够啊,这个 cover 这个功能是暂时不在系统升级的时候是不能用的,我们还不知道系统升级完了之后会是什么样的。那我大概听一下啊,其实也是完全就没有任何问题,就是你已经 cover 这首歌了,所以 啊,大家可以去找之前啊,前辈们已经给我创造出来的这个 cover 的 这些歌曲,大家都去搜一下啊,就在这个 啊,这个放大镜这个地方你们都去搜一下,能去搜的基本上都能搜到,那搜不到的,那只能够去找那些已经放过的人,跟他们去要一下,加一下好友,看看能不能让你们 cover 一下,也就是说我们要踩在前辈的肩膀上才能够制作出歌曲。 大家看了一下吧,确实调子也是没有任何问题的啊,只不过你可以自己再试着去在风格上面写着更多的效果出来啊。这个东西我只是给大家试验了一下,我没有改什么,只是加了一个 trap 的 这个啊感觉在里头啊, 其他的就没有什么了。来说呢,如果你们在歌词上面出现问题了,歌词其实很好解决,就跟我们发现他唱错字一样,我们只要用谐音字就可以了,比如说手牵手看星星,一颗两颗三颗四颗连成线 啊,那手的话可以变成首尾呼应的手啊,手牵手啊,大概是这种样子,当然我还是说那句话啊,我们可以借鉴一小段,但是我们啊,我觉得这个功能其实让大家不去使用,它的重点就是明星们可能没有办法对这种呃责不罚重,这么众多的这个爱好者们下手,他只能够说,哎,你基于 你这个平台,既然给他们这个机会,那么我就找你这个平台算账,我不会找那个你们平台的这个观众算账,我觉这也是一个很好的点,还是那句话,多去尝试着做一些新鲜的歌曲啊。嗯,自己去哼一些自己想要做的歌,这是很重要的啊。 其实我今天已经做了大概有十来首自己的歌吧,就是我把我之前做的十来首歌,现在一次头把它全部都做一遍,然后想要去发表。我之前是真的不太爱发表音乐,因为你没有那么多明星自带的热量,比如说啊, 就是我只能离开这首歌我特别喜欢。那么,呃,如果你发 cover 的 歌,大家会因为这是我喜欢这首歌而喜欢你 cover 的 东西,那么你你得来的赞就会比我们要方便很多,这是对其他人的不公平啊。我觉得还是应该尊重版权这些东西的, 当然教给大家也是那句话,是一个非常重要的事情。那么之后我也会给大家介绍一下如何正确的使用 cover 这个功能啊,我个人认为是正确的啊,当然你们自己想怎么样是你们自己的事啊,这个世界就是你开心就行啊,你快乐就可以。好,我是努力拥有八千粉丝,张团,拜。拜拜。
