个人本地部署大模型英伟达推荐吗
为什么感觉身边突然好多人都开始搞本地大模型了?那跑本地硬件到底怎么选?跑什么模型?公司真的需要吗?其实很多人根本没搞清楚,目前本地大模型主流就两套方案,英伟达的 n 卡和苹果的 max studio 价格差不多,三万多块钱就能拿到不错的配置,那怎么选? 如果你是个人创业者,一人公司, max studio 就 很合适,它本身就是一台性能非常强的电脑,像这台 m 二 ultra 六四 g 版本 openclaw 装千万 jam 完全够用。但要注意 max studio 的 回复速度,尤其是处理大数据时,会比 n 卡慢一些。 个例子,行业每天要分析几十张报表, max studio 可能一分钟才出结果,而五零九零这种 n 卡二十秒就搞定了。如果你公司多人同时用,或者对响应速度有要求,那 n 卡基本上是不用犹豫的选择。那 max studio 就 没有优势了吗? 不是,它统一内存,能跑非常大的模型,就像 mini max、 gpt 之类,很多电商和律所的客户都这么做。而我们平时给客户装的是什么模型?装的最多的就是千万三点六三五 b a、 三 b 和二七 b 的 全量模型,对于电商行业来说,基本上就是降维打击了。
粉丝133获赞757
相关视频
 06:12查看AI文稿AI文稿
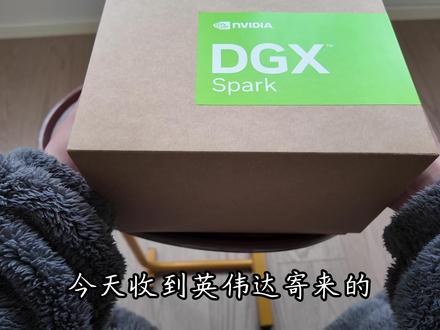
今天收到英伟达寄来的桌面级 ai 超级计算机 d g x spark, 老黄也给马斯克送了一台同款,用一句话形容它是一台极其便携、自带英伟达显卡的乌邦图迷你主机,国内售价三万五千元,来看看发布会上老黄是怎么说的。 we call it d g x spark20 cpu cores and now the gpu has 128 gigabytes one petaflots who is a software engineer or ai researcher? or you know just data scientist and you would like to give them you know what the perfect christmas present。 我 实测下来, d g x park 有 四个核心优势,首先是很轻很便携,塞到书包里就能直接带走到各种展会,线下布展都非常方便。 第二是算力强,号称有一千 top 的 f p 四算力和五零七零显卡差不多。第三是显存大, cpu 和 gpu 共享一百二十八 g 内存,可以在本地端测训练和推理大模型。 第四是预装了扩大和 nvcc 环境,直接省去了几个小时的安装配置时间,而且丝滑兼容英美达生态的各种物理、 ai 和机器人仿真工具。 这四个优势让 d g x bug 非常适合大模型和机器人玩家。这期视频就来盘点一下我发掘出的五个邪修玩法。 第一个玩法,部署优乐二十六目标检测模型,不管是视频还是摄像头,实时画面推流速度都很快,特别适合工业质检的终端设备。关于优乐二十六后续会出一系列的训练和推理教程。 第二个玩法,本地部署开源大模型 d g x bug 上可以丝滑运行欧拉玛 v l l m 这些本地大模型推理工具, 我用摩达社区开源的模型压力测试工具 evo scope 测试了一下,千问三零点六 b 首投肯时间只要五十毫秒,每秒钟输出一百一十五个投肯延迟和吞吐的分布也非常集中,没有明显的肠胃抖动。本地部署开源大模型有八大好处, 最大的好处就是无限免费调用,没有 token 焦虑,哪怕是 open cloud 这种 token 核弹也能随便用。另一个好处是局域网里的所有用户都可以共用。 我在 d g x bug 上本地部署了面壁智能开源的全模态大模型, mini c p m o 四点五 omni, 连上我家 wifi 的 所有用户都可以通过 ip 地址访问 d g x bug 的 推理接口,摄像头,电脑屏幕、手机 ai、 眼镜、 esp 三二,任何带摄像头的设备都能调用这个模型。 这个模型是一个参数量九 b 的 全双工实时模型。 ai 持续在听看书,你现在听到了什么声音?我又听到敲门声了。如果宝宝哭闹了或者出现意外情况,就请告诉我。好吧, 好的, 你看宝宝开始哭闹了呢。 好家伙,开局就到 c 一 点,这也太顶了,快跑啊,有个狙击手,这个狙击手还在 看,我来攻略了他。是的,狙击手还在, 他好像已经死了。小心你被急火了。 哎呀,你这局打太烂了,敌方坦克在这。漂亮,我镭射锁定了,很安全,给他来个雷。好,先清人漂亮,收掉一个 又一个,再来一方。哎呦,这把太牛了,完全没给对方任何机会,真是太强了, nice。 推理如果放在云端,通信延迟和 token 消耗就很大了。放在端侧,本地部署推理是最佳的方案,因为达还专门给 d g x spark 做了一个仪表盘,方便随时查看显存和 gpu 占用情况。 另一个本地推理的刚需场景是机器人 d g x spark, 既可以直接作为机器人的上位机,比如 hackincase 发布的桌面陪伴机器人 richie mini, 也可以作为具身智能的端侧大脑,借助 hackintosh 开源的机器人工具包 la robot 以及 groot 这样的 vla 视觉语言动作大模型, 配合英美达 jackson soren 或者 d g x spark 作为具身大脑,就能让机器人自主完成叠衣服、收纳桌面、夹取物品、双臂协助这类长系列模仿学习任务。 去年我在深圳柴火窗口空间看到不少了 robo 的 机器人项目,我自己也写了一整套了 robo 的 保姆级教程,手把手带你丝滑跑、通摇操作、采集数据训练、本地推理模仿学习的全流程。我最近做了一个具身智能握手交互装置,探龟之握, 人类一握手,他也热情伸手,人类缩手,有的时候也会竭力挽留,想和人类贴贴,仿佛具有灵魂和情绪。 用到的 v l a 模型是字面量开圆的握 o s s, 参数量三点九 b。 还有 physical intelligence 开圆的派零,参数量三点三 b。 在 以前,我只能托一台笨重的四零九零主机,机 器人插到主机 usb 口,每次扳机枪胳膊都要疼好几天。现在直接把 d g x park 塞到书包里带走,随便找个插线板就能开机玩起来。 总结一下,英伟达的 d g x park 是 一台极其便携、自带英伟达显卡的乌邦图迷你主机,重量轻、算力强、显存大,是本地部署大语言模型、多模态模型、 open cloud 聚深智能 v l a 模型的绝佳选 择。程序员、机器人、工程师、艺术家、音乐家都可以拥有自己的端侧最强大脑。
5.5万同济子豪兄 01:39查看AI文稿AI文稿
跟大家分享一下最近部署本地大冒险的这样一些的一个事情吧。就是谷歌不是那个 g 万四开源出来的本地部署的。 呃,我们就自己零成本试一下,用自己现手头的硬件,一个是 i 七,然后四零六零太八 g 三十二 g 内存的,我平常办公的电脑, 这个电脑呢,基本上四四 b 的 模型的话大概十五到二十秒左右吧,你问他一个问题,能回你两 b 大 概能便宜个能快个三分之一左右吧。然后用我们同事的那个十六 g 的 麦迷你统一内存的那个部署一下二十六 b 的 那个根本就没法用。呃, 半死机状态吧,你半天蹦一个字出来。后来我们就卸掉了。当时部署这个大模型的目的是想训练一个专属的模型在本地,一个是他可能比较专,比较专一,再有一个可能省点偷分吧。 嗯,但是后来发现第一个就这种小模型还是不够聪明的,还不如你去大模型里优化它的那种提示词或者 skill 的。 然后第二个就是如果你想跑动稍微大一点的模型,就是二十六或者三十一的话,你可能就要买到这种 max studio 啊,或者英伟达那个那个那个机器了,那个那个就两三万甚至三四万了, 如果你不是特别高频的使用的话,你拿它来买托克应该用能能用顶级的大模型比较长的时间,而且更聪明。 所以目前这个事情就是如果你对本地的这个数据安全没有那么敏感。呃,而且你想训训练他也会花费到很多精力。呃,我觉得暂时还是不要碰本地部署了,挺不会的。
 01:56查看AI文稿AI文稿
n 卡的本地大模型部署好了,对比我之前给大家讲到的这个 max studio, n 卡和 studio 在 价格上差不太多,但是如何去选择呢?如果你是家庭使用它又可以当电脑,性能是非常强的。然后它拥有六十四 gb 的 显存部署,像 opencloud 这样的机器人,它的回复速度肯定是没有 n 卡快的。但是好在它的显存比较大,六十四 gb 你 能 能够跑更多的模型是大于英伟达的这个模型的。但是如果你和我一样对性能要求极高,那你可以考虑一下英伟达的这套解决方案。至于这个 n 卡的解决方案和 max studio 在 速度上到底差距多少呢?拿这个五零九零来说,如果你问他一个复杂的数据,比如说帮你看十到一百张表,那这么多的数据, mac 基本上要一 分钟才能给你回答,但是 n 卡的话,二十秒直接给你数据,那毫不犹豫肯定 是 n 卡。我刚刚用这个 n 卡输出了一篇关于短视频运营的报告,可以看一下,输出是非常细化的,而且像这样的内容在实时生成中,大概也就是十到二十秒就可以出一个这么详细的日报。然后我也给他安排了多个 agent, 比如说我用我的 max studio 作为 主对话,他做我的 ceo, 那 像英伟达性能比较强,他要采集大量的数据,运营比较复杂的这个预算,那我就会把他很多关于一些公司的重要财务数据, 可以帮我查 erp 吗?嗯,可以看到它已经在调用我本地的这个模型了,然后一堆的数据表格正在输出,也就是说我们正常在使用它,无论是一台机器还是两台机器或者是混合使用,你的体 验都可以是非常好的。通过这样的多 a 检测的智能体,你还可以创建多个角色,然后每个角色也有自己的 skill, 你 让它做短视频运营的数据分析以 及做你的财务报表都是可以搞定的。而且像这套算力全部都在自己家里或者是在自己的公司里面,你的重要的合同数据都不会留到网上。所以说各位企业的大老板,如果你对本地算力和数据安全也有要求的话,像这样一套混合解决方案,你的企业也可以安排上。
14案上AI智能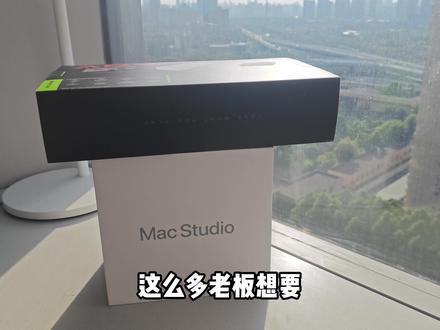 01:08查看AI文稿AI文稿
这么多老板想要搭建本地 ai 模型,那到底该选什么硬件?选哪些模型?今天一次性讲清楚!目前本地模型主流方案 n 卡和 max studio 该怎么选呢?那如果你是小型团队或个体老板,优先选择 max studio, 体积小,颜值高,首选 m 二 ultra, 六十四 g 版本两 万多,价位,对比 m 四 max 性能更强,内存待宽能达到八百 gb 每秒,对比 m 三 ultra 性能差距不足百分之五,价格更低,性价比极高, cpu 和 gpu 共用内存架构,六十四 g 全部可以当显存,适合日常办公与轻量化 ai 预算。那如果你是多人团队,想要并发使用 max studio, 预算速度稍弱,复杂数据处理多任务并发场景下效率不足,所以就得考虑 n 卡方案了。以电商行业为例,日常海量报表整理、 数据分析、多表格批量处理,因伟达设备响应速度更快,大幅提升工作效率,满足企业高频预算需求。模型适配方面,这两套都可部署 q i 系列模型、 g m 系列等主流开源模型,像电商、利索、服务行业等多领域都能适配。像无缝对接 erp 系统,自动统计销量成本利润、智能分析、爆款单品 类数据精准预判市场趋势、节日热销品类,为运营决策提供数据支撑,这些都能实现。而且本地模型数据安全、算力自由无限、 toker 等优势能够杜绝云端数据泄露风险。那如果您还不知道怎么选模型,关注我,看更多行业案例!
139郑工说AI+ 01:21查看AI文稿AI文稿
针对电商老客户提出的本地部署生图生视频需求,我们已完成整套流程的全面实测,整体运行稳定可靠,完全适配电商日常商用场景。本次采用 n 卡方案,实测数据表现优异,三十秒以内就能快速生成三到五秒的高质量视频, 可实现二十四小时不间断运行,批量生成需求完全能够满足,无需担心卡顿、中断等问题。大家可以近距离观察实际出图效果,尤其是和咱们电商行业的产品图制作,即便只用最简单直白的基础提示词,无需掌握复杂繁琐的专业指令,也能生成高质量的产品图, 省去专业操作的门槛。同时,我们也生成了多个人物视频片段供大家参考,画面质感细腻,细节处理到位,呈现效果完全符合电商商用标准,无需额外厚积优化。相较于大家平时常用的云端线上 ai 模型,这套本地部署方案的优势尤为突出。 首先,彻底摆脱排队等候出图的困扰,高峰期也不会出现废片、风格跑偏等问题,不用再担心花费成本却只拿到无效素材,大幅提升创作效率。其次,全程不消耗任何流量额度,无需充值抵扣 token, 没有任何隐性额外扣费,彻底降低使用成本。 除此之外,不受平台规则限制,可实现全天候不间断运行,无论是批量生成图片还是视频,都能拥有极高的创作自由度,性价比直接拉满,完美适配电商批量创作的核心需求。
10寻路AI 01:00查看AI文稿AI文稿
一般人我是真的不建议部署本地 ai 算力了,特别是不懂技术的朋友,本地部署真的很麻烦,但是本地 ai 确实香得很,不管你是公司还是个人,他都能做你二十四小时不休息的专职助理,性价比非常高。首先在数据安全性上就完胜线上,像今天给义乌服装电商的老板准备发走的这套设备。举例这位粉丝给我说,每天都有很多店铺爆款数据,客户资料、定价策略、供应链底价。如 如果用人来看,不仅耗时,还容易出错,跑线上呢,精密数据又不敢上营,毕竟他可不想辛苦琢磨出来的成果被收入给同行当案例参考,那本地 ai 所有数据全程不出内网,不担心泄露。其次,他想每天二十四小时盯同行的爆款产品文案标题, 让 ai 来帮他分析未来女装的爆款趋势。那我们现场给他演示了一下,自动开网页,自动盯竞品,自动整合分析,以及提出优化建议。再就是老板还有做主图,生产品视频需求,那么训练完成之后, 你可以看到输出非常稳定,一天一百条都绰绰有余,还不用排队,不会限速。最主要的不接入外网, a p i 不 消耗 token, 一 次部署永久免费,而且最核心的商业数据都跑不出这台机器。本地 ai 部署真的是非常好的想法,而我们做的就是提前配置好这套模型的框架,也不需要你懂技术,我们提供整年的陪跑服务,教你怎么去用它。
84郑工说AI+ 05:03查看AI文稿AI文稿
你的 openclaw 和 hermes 还在花钱调用大模型的 a p i 吗?今天我教你用零成本本地部署奥拉玛,在你的电脑上直接跑大模型,还能无缝对接 openclaw 和 hermes, 实现免费玩 ai 智能题工具。首先介绍一下欧拉玛,什么是欧拉玛呢?欧拉玛是目前最简单的本地模型工具,在 windows、 mac 和 linux 上都支持,几分钟就能装好,八 g 内存就能跑。当然了,还是建议最少要安装十六 g 内存, 这样体验起来更加流畅。如果有英伟达的显卡,还能够使用 g p u 加速。了解完了欧拉玛是什么之后,我们来看一下欧拉玛如何安装。首先我们要访问欧拉玛的官网欧拉玛点 com, 它的首页是 一个羊驼抱着一个龙虾,下面的英文是 power open claw with ollama, 中文的意思就是使用 ollama 为龙虾赋能,从这一点我们就能看出它是全面的拥抱和支持 open claw 了。这也是为什么今天我要在 open claw 的 专栏里专门做一期 ollama 视频的原因。 废话不多说了,首先要下载欧拉玛,点击右上角的 download, 这里我们可以看到它有 mac os、 linux, windows 的 下载方式自动已经给我们定位到了 windows, 点击这个黑色的 download for windows 按钮, 就会弹出下载框,点击另存为保存,有点大,两个 g, 这个网速非常感人,所以我建议大家用迅雷来下载。 我们已经下载完了欧拉玛的这个安装包,下面我们就开始安装欧拉玛的安装有一个问题,就是它没有让你选择 需要安装的文件夹这个选项,它默认是安装到我们的 c 盘 user 底下的,如果你想安装到指定的文件夹,那你需要换一种方式,我们先把这个安装过程停止。 我们找到拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇 斜杠 d i r 等于这里写上我们的安装地址,也就是记盘的欧拉玛文件夹。打回车就跳出来安装界面,我们点击安装,大家可以看这里已经安装到记盘的欧拉玛这个文件夹下面。 进了这个界面,就代表着欧拉玛已经成功安装并且启动了。安装好了欧拉玛,我们再来看如何下载模型。在欧拉玛的网站上点击这个 models, 就 可以进入模型列表,这里都是可以使用欧拉玛直接下载使用的模型。我们来找一下 谷歌的 jam 四,这个是最近小模型中比较好的,可以通过这一句欧拉玛 ram 四来进行下载。 输入奥拉玛 ram 捷摩斯回车运行。安装完了,我们来跟他说一句话试试。我们在这里输入一个,你好打个回车。 好的,扎马四已经回复了我们,虽然有点慢,但那是我电脑性能的问题。大家可以看到现在已经成功地让大模型在我们的电脑上运行起来了。再下一步我们就来看如何把欧拉玛接入到 open cloud 中。 ctrl d, 我 们来退出欧拉玛,然后输入 openclaw config, 进入 openclaw 的 设置,这个我们直接选择本地运行,这个我们选择第二个 model, 打回车进入,然后我们要在这里找欧拉玛, 这个就是欧拉玛提示我们欧拉玛不可用。我们来重新编辑一下 openclaw 的 配置文件。 openclaw 的 jason, 这个就是 openclaw 的 配置文件。我们来找一下 allow 这一项,这里就是扩展的 allow 这一项,我们要在这里添加上 alama。 我 们来运行 openclaw config 来设置 openclaw 的 大模型。 选择默认的本地模式,这个我们选择第二项 model, 就是 设置模型,这个是选择模型的提供商,我们来找一下 alama, 这个是询问我们选择云服务还是本地模式。我们选择最后一个本地模式,这个是欧拉玛默认的 b、 c、 l。 回车,这个是有哪些可用的模型?只有一个,我们按空格选中回车确认 提示,我们已经把模型信息写入了配置文件,我们退出。我们回到 open 可乐,这里是我们 问了 openclaw 一 句你使用的什么模型,他们回,他回答,我使用的是谷歌的伽马四。我们这次的 olamata 下载安装以及安装模型,以及如何在 openclaw 中使用 olamata 模型。到这里就结束了,关注,我每次 都给大家带来一个 ai 的 新知识,感谢大家的观看,再见。
1698波哥的AI课 01:56查看AI文稿AI文稿
今天来了一个客户啊,他带走了一个五零九零的一套配置,然后还带走了一套 max studio 的, 那么为什么他会一样买一套呢?那么我给大家说一下啊,首先 max studio 这一套他是给自己用的,那么五零九零呢?是给他五个那个各部门的负责人去用的。那么首先我们说他自己会用便宜的,那么给 部门负责人用贵的原因就是因为很简单啊,因为 max studio 这一套他只需要自己一个人去使用就够了,那五零九零呢?需要满足他三到四个人的一个并发症, 那么这个是很重要的。九十 max 六它只能一个人用,你多人用的话,它会非常非常非常卡,卡到没法用,但是五零九零的话,它是可以接受多并发的, 那么三到四个人并发是完全没有问题的。然后它把它拆分成物理的两个,是因为首先它的这台是需要访问它很多财务数据以及公司内部一些比较隐私的数据的, 那么这个是他需要做的,那么呢这一套呢,他需要去给部门负责人他们之间去做一个更好的联动,以及平时啊工作效率的一个提高。比如说要查询一个什么公司的文件啊,查一个合同,然后想要一个具体的报表以及分析一些事情,那么这个是需要,这个是需要提高效率的, 那么所以他会用到这一套,那么他各个部部门负责人他们可以各个联动,然后全部在这里面用这一个 ai 是没有问题的。那么他自己用这个之后啊,可以在物理上做一个区分,那么所有的数据是不会贯通的,比如说有一些私密一些的财务数据,那么如果你放在这里面,那你的其他使用者也可以去访问,也可以去阅读,就是问他问题的话, ai 会谁告诉他? 所以这个是没有那么安全的,那么所以他自己会配一套 max 六单独用,然后呃其他的部分负责人会做一个五零九零, 这样一起去联动使用,提高效率。那么所以我说,呃, ai 这个东西是为了服务于人,方便于人的,那么它不能直接给你带来一些很多的经济效益啊,这些是肯定不可能的,但是它可以极大地提高你的工作效率,以及你访问所有东西的一个便捷性,那么这个我觉得是非常有价值的。
26老K的Ai服务站 00:47查看AI文稿AI文稿
给大家看一下最近很多粉丝提的本地部署生图生视频的需求,整套流程已经全部实测完毕了,非常稳定。用的是恩卡的这套方案,实测三十秒不到就能直接生成三到五秒的视频,二十四小时不间断,日常商用,批量使用是完全没问题。大家可以近距离看一下实际出图效果,特别是咱们做电商行业产品图的, 哪怕只用最简单直白的基础提示词,不需要复杂繁琐的专业指令,都可以生成这样的效果。人物视频也生成了几个片段,给大家看一下整个画面质感、画面细节依旧做得非常出色。本地部署的优势真的特别突出。 首先不用长时间排队等候出图,不会一到高峰期就开始出废片,风格跑偏等等,完全不用担心花钱买废片,效率大大提升。全程不消耗任何流量额度,不用充值抵扣 token, 没有任何额外扣费成本,不受平台规则限制,全天候不间断运行,批量生成图片,视频创作自由度和使用性价比直接拉满了!宝宝们晚上好呀!
488郑工说AI+ 01:26查看AI文稿AI文稿
线上模型参数那么大,点开就能免费用,为啥我花三万多做本地部署,反倒只能跑中小模型?我先跟大家说句大实话,模型真不是越大越好。很多人有个误区,只盯着模型参数看,线上模型看着厉害,一到高峰期就压缩,直接把精度压到最低。 ai 混觉,逻辑混乱,答非所问,内容跑偏太常见了。而且还有个致命问题,云端容易数据泄露,还有各种权限限制, 长期充值扣费,公司的私密业务数据、核心客户资料,谁敢随便往上传?但本地 ai 就 不一样了,核心就三个词,稳定、安全、可控,不用依赖外网无线 token, 所有数据全部本地闭环,机密不外流。像这套英伟达五千零九十文文跑通 q n 三点六二十七 b d s 模型, 比一百二十二 b h b 的 m o e 还要强,全套落地三万多,算力、精度、速度全部兼顾,直接拉满了。而且各行各业都能用文生图图生图图生视频, 建立本地知识库,一键生成沟通话术对接 erb 自动统计每日业绩分析部门利润波动,智能盘点库存生成补货计划,定制高利润营销方案。包括 crm 客户管理系统,智能提醒跟进客户二十四小时检测同行竞品, 而且手机随时随地就能用。从硬件选型、本地模型部署、私有知识库搭建,再加上全年维护和版本升级,全套一阵式搞定,哪怕你是零基础小白,也能直接落地即用。
43寻路AI 01:31查看AI文稿AI文稿
为什么好像很多人都做本地大模型,那用什么硬件跑本地大模型,搭建什么模型,以及为什么公司需要它,其实根本不清楚,那今天我来简单讲一下。首先本地大模型我们主推因为达安卡和 max studio 这两种解决方案,这 两价格上也差不多,要如何去选呢?如果你一人公司老板,那么 studio 这个又可以当电脑,是个非常强大的一个性能的慢系统,两万多价位的 m r ultra 六十四 g 系列,内存带宽八百 gb 每秒, 我拉的对比表大家可以看一下 m 二和 m 三以及 m 四, m 二和 m 三 ultra 系列的内存宽带只相差不到百分之五,而 m 四 max 宽带速度只有他们的三分之二。像类似于 open cloud 这样的机器人的话, studio 的 回复速度各方面肯定是没有 n 卡快的。但是如果你和我一样对这个性能要求极高,那你可以考虑一下英伟达的这套解决方案。就拿这个五零九零 d v 二来说的话,像电商行业每天要处理大量的数据报表需要处理, 比如说帮你看十个到一百张表,这么多的数据, studio 基本上要一分钟直接给你数据,这个差距就非常的大了。 如果你还考虑企业并发或者是更多的用户同时去使用的话,那用 n 卡是你基本上不用考虑的一个选择。但是 max studio 它就可以跑这种 mini max 这种非常大的模型,像我们平时电商以及律所这种客户非常非常多。那么我们平时装的什么模型呢? 我们装了很多的,比如说千万三点六三五 b 的 这二七 b 的 m o e 模型千万三点五,二七 b 这个是氮四模型。然后再就是比如说 g m 的 二十六 b 也是一个氮四模型。 对于电商行业的朋友来说, erp 就是 电商的命脉嘛,接入 erp, 比方说你到底卖出了多少?你的成本是多少?那么你的利润是多少?哪哪个 sku 的 产品是卖的最多的?哪个给你创造更多的价值?然后包括比如说今年双十一或者双十二啊,哪个可能会成为爆品,哪个趋势会更好?那么这些 ai 全部都会给你答案。 当然决定权最后还是在你,但是它能给你一个非常好的方向。如果你是一个老板,也是一个管理者,那么你可以在深思熟虑之后,再去思考是否要配置到模型。
878小辰Ai智能 01:02查看AI文稿AI文稿
这次我们直接用两张 nvidia h 两百 nbl 第一时间把 deepsea v 四 flash 模型本地部署了起来,吐字也是相当哇塞,单并发下输出吞吐达到九十八个 token 每秒, 而在两百并发下更是达到了两千四百 token 每秒,还得是 h 二零了啊,这个数据相当猛啊! 而且这次英伟达的测试可以说是地狱级难度,截至我们视频发布之前,大家最熟的 rtx 五零九零, rtx pro 六千目前基本全军覆没,还没人跑通,问题也不复杂,本质就三点 一,框架适配还没跟上,二驱动加 c u d a 生态还在追,版本三官方文档 说实话有点点到为止,所以我们也在测试尝试使用深腾九一零 b 以及双台 g g x spark 部署 deep sea v 四 flash。 感兴趣的话可以点个关注,我们马上更新。
46珑京科技 00:44查看AI文稿AI文稿
今天为大家带来了一款新鲜出炉的工作站,这台工作站是采用一体式液冷系统,对这个机器的特点显而易见,就是它的空间非常小,然后我们通过液冷系统可以很好的控制整机的一个散热跟它的一个满载的温度。采用的是这八九零的芯片组合了英特的二八五 k 内存呢,是适配了两 两根三十二 g 的 海盗船, ddr 五的那种,呃加了一块 rtx 五零九零的 gpu, 三十二 g 的 显示屏,目前测试下来的话,呃非常稳定。呃 gpu 在 满载的工作情况下面控制在七十五度以内。呃这个机器非常适合呃一些图形渲染, ai 本地大模型部署。 我们是做高性能呃工作站跟服务器定制的,如果你也对呃这种部署空间比较灵活,然后呃性能比较强劲的工作站可以对接我们。
1044赋欣科技服务器 00:55查看AI文稿AI文稿
还有人在说本地模型不聪明?错,那是因为根本没用。对,今天给医美行业粉丝搭建的这套本地 ai 大 模型已经准备发走了。向粉丝公司笔下的咨询师平均每天都要跟进一百多位客户,客户案例照片补正整理,竞品项目解锁摘抄、查产品资质、查医生排期, 根本看不过来,还非常容易出错。积累下来的上万份客户档案,想要实时调取对比差异,简直是大海捞针。他想要 ai 能二十四小时在线实现大数据的自动分析,客 户档案整理并立文书排版,写回访报告,做客户需求分析和订单规范。我给粉丝现场演示,做企业自有知识库解锁,配合接入 erp 或者 crm 系统,随时可以去问他,我有哪些客户的疗程要到期了?我需要定期回访的老客户有哪些? 这个客户的具体情况是什么?帮我分析一下,用什么话术促进复购成交,粉丝心里就很有底了。而且粉丝特别强调有客户资料都属于隐私数据,那这套方案就完美适配了本地部署,不会上传云端,杜绝泄露风险。而我们做的就是帮你部署好整套本地 ai 大 模型,怎么跟着 ai 专家训练沟通,搭建好公司的知识库,教你训练 agent 和一对一的陪跑加落地。
115郑工说AI+


