openclaw u盘靠什么模型
还有人在说本地模型不聪明?错,那是因为根本没用!对!今天给武汉医美行业粉丝搭建的这套本地 ai 大 模型准备上门安装了,向粉丝公司底下的咨询师平均每天都要跟进一百多位客户,客户案例照片补正整理,竞品项目检修摘抄、查产品资质、查医生排期,根本看不过来,还 非常容易出错。积累下来的上万份客户档案,想要实时调取对比差异,简直是大海捞针。他想要 ai 能二十四小时在线实现大数据的自动分析,客户档案整理并立文书排版,写回访报告,做客户需求分析和订单规章,现场给客户演示了企业自有知识库解锁,配合接入 erp 或者 c r m 系统,随时可以去问他,我有哪些客户的疗程要到期了?我需要定期回访的老客户有哪些?这个客户的具体情况是什么,帮我分析一下用什么话术促进复购成交,客户就直接定了。而且客户特别强调有客户资料都属于隐私数据,那这套方案就完美适配了本地部署,不, 不会上传云端,杜绝泄露风险。而我们做的就是帮你部署好整套本地 ai 大 模型,怎么跟着 ai 专家训练沟通,搭建好公司的知识库,教你训练 agent 和一对一的陪跑加落地。
粉丝134获赞758
相关视频
 06:46查看AI文稿AI文稿
部署本地的 openclaw 已经可以剪视频了,大家都知道了吧, 这个让硅谷大佬每日一封的 openclaw 阿月,我呢也是拉到本地试了几天,现在就带大家把本地部署和接入飞书每一步都走明白。为了防止偶然性啊,我呢也是连续测试了四台电脑,确保每一步都可行,接下来你们只要跟着做就可以。点好关注收藏, 我这里依旧用的是 windows 系统来操作,因为 macos 系统呢,环境相对比较简单,不像 windows 这么复杂。首先呢,我们要确认好 windows 的 安装环境,安装的时候呢,全部都点 next, 一 直到完成即可,建议呢,不要去变更中间的安装路径。 呃,安装完成后呢,我们可以检查一下环境,我们在命令提示符的窗口输入这两个指令,如果输入指令后跳出版本号,那就说明安装已经成功了。这里提到的两个环境文件呢,我在文档里面也全部都准备好了。 好,接下来呢,我们就开始全区安装 oppo 卡使用管理员 c m d 指令输入,这个指令安装完毕后呢,再输入这一条指令, 好开始了。 ok, 这一步跳出来的呢是风险提示,我们直接选择 yes。 然后呢我们选择 quickstart, 这一步呢是选择大模型,我这里呢用的是千万,因为他是国内的,如果大家有惯用的呢,也可以自己进行勾选好,然后我们这里模型选择默认的即可。 之后呢会跳转到大模型的首页进行授权验证,大家验证通过就可以了。那通过后呢,这里也同样有一个选项,我们直接选第一个默认的模型。 ok, 下一步呢,这里可以看到很多的应用选项,这其实呢就是指令输入的终端,因为这些都是国外的,所以我们先不管,选最后一个,跳过,后面呢我会给大家介绍如何接入国内的飞书。 ok, 继续,这里会问你需要配置什么 skills? 呃,我们也跳过,没问题,因为这个不着急,后面都可以手动去配置的。 好,这个也不用管我们用不上,直接跳过。好,然后我们稍等一会,会自动弹出一个网页,然后你会发现这个网页是打不开的,没关系,我们这个时候呢,再运行一个 c m d 的 指令, 好,这就是欧奔 cloud 的 兑换框了,我们来尝试和他打个招呼, ok, 他 回复我了,那到这里呢,其实基本上就成功了,还是比较简单的啊。然后呢,我们再来尝试为大家接入一下飞书,很多小伙伴呢,在这一步呢,其实就被劝退了,因为怎么样都接入不了这里,大家看好我怎么操作。 首先呢,我们进入飞书的开放平台,我这里呢用的是个人版,我们来创建一个企业自建应用, 进到这个凭证与基础信息界面,把你的 app id 和密钥保存下来,这个很重要啊,后面会用到的。然后 我们添加一个机器人,再到权限管理这一步,为他添加一些权限。这里的权限列表呢,其实官方呢是有指导文件的,但是呢就藏的比较深,我呢也是给你们找出来,直接放到文档里面了,你们直接一键复制过来就 ok。 好,然后我们需要配置一下这个事件回调功能,在这里的订阅方式选择长链接这一步呢是必须的,而且是绕不开的,也是大家碰到卡点最多的一步,很多小伙伴呢在这里呢就是一直报错,好,不用担心,我呢,已经整理了一份非常长的傻瓜教程,大家直接照做就 ok 了。 然后选择以后呢,我们添加事件,然后添加搜索接收消息, ok, 然后我们就去点击创建应用,然后再发布就 ok 了。 好了,配置工作完成之后呢,我们就要开始给欧邦克劳接入飞速杀键了。由于 windows 的 系统环境问题呢,所以大家的电脑情况都不太一样,所以会出现不一样的报错问题。网上的很多视频呢,也没有把这个问题针对性的讲清楚,我自己呢也试了三到四台电脑来做尝试,都非常有挑战。 如果你手边也报错的话呢,不用担心,我这里想到了一个邪修的办法。好,那既然 oppo klo 可以 控制我的电脑,那为什么他不能自己安装飞出插件呢?我们来试试看吧,直接和他对话。呃,你自己安装一下飞出插件,然后呢,他就会开始疯狂的工作,并自行去验证安装环境和插件配置 啊。五分钟左右后呢,他就会告诉我,他工作完成了,需要我提供给到他飞出机器人的 app id 和密钥。这个呢,其实我们在上一步已经有了,我们直接复制给他,让他呢继续去工作。这里的工作过程当中呢,我们的机器人可能会下线几次,原因呢是他需要去重启网关, 如果呢,你感觉他下线太久的话呢,我们可以用 open cloud get away 这个指令重新把它呼出来。最后呢,他会要求你在飞车上和他对话进行测试,并为你排除最终的一些故障。 ok, 全部搞定,已经可以在飞车上正确回复我了,并且呢,刚才在外部的对话记录他也全部都记得, 呃,我们这里呢,再用手机给他发一条消息试试看。好,他也同样接受成功了。好了,这里欧本卡接入飞书的配置呢,就完全对接成功,基本上都是他自己完成的,我呢只是配合他提供了一些必要的信息, 妥妥的全能小助理。接下来我们来看看他能为我们做一些什么吧。比如呢,我现在想要订一张机票,我就让他帮我查询一下最便宜的航班,他立刻就给我列了具体的信息,包括航班号,价格以及其他的一些航班信息。不过这一步呢,是需要接入 api 的, 大家可以自行去网上找免费的接入就可以。 好,那现在过年了嘛,马上大家呢也会送礼嘛,那我就让他去浏览电商的页面。呃,不过这里呢,需要先安装一个 oppo club 官方的浏览器插件,我们直接从官方渠道进行安装就可以了。具体的步骤呢,已经放在文档里了,大家直接照做就可以。我让他给我打开。 ok, 成功,呃,然后我继续让他为我搜索燕窝。好,也成功了。 好,那我们现在在拿最近小伙伴在学习的 ai 的 线上作业丢给欧本克,看他能不能帮忙完成。 首先我们要让他找到作业的本地目录,并让他完成里面的题目。他立刻就找到了,并且迅速告诉我,完成了。啊,这速度还是真的蛮快的啊,但是呢,人呢,还是比较懒的。如果呢,你抄作业都不想抄啊?没事,直接让他把填完的东西返回给我。好,他已经做完了,我们来看看啊。 呃,代码呢?全部都完成了,不过呢,我也是看不懂啊。看懂的高手可以来说说他完成的这个准确率怎么样。 好了,那这次安装说明就先讲到这里了,关于 open cloud 的 更多能力,有时间呢我们可以再去测一下。好,那既然已经部署成功了,有兴趣的同学呢,也可以再去深度探索一下 啊。对了,现在呢,各大厂呢,也出了针对 open cloud 的 云端部署,我这个呢,也可以跟大家快速的分享一起。好,这里是阿月,希望我的视频能够帮助到你,让你更了解呀,我们下期再见。
1.7万阿悦很严格 07:37查看AI文稿AI文稿
大家好,在你装完 openclip 之后啊,第一件事要做的事情就是去选择一个模型,那模型作为 openclip 的 大脑,它起到一个非常关键的作用,那这么多模型,那他们之间有什么区别呢? 那为什么你的模型只能识别文字,不能识别图片呢?那本期视频呢,就跟大家讲一下不同的模型之间能力的区别,以及怎么去配置模型。那对于一款模型来说,它的能力有接收信息,那信息类型啊,有可能是文字,也有可能是图片, 也可能是视频、音频或者其他就是你发的信息的内容可能包含这些类型。那么大模型在接收到你这些信息之后,他对你的信息进行回复,也有可能有这些类型,比如说他回复文字,给你回复图片,给你生成一张图片,或者说做出来一个视频, 或者说做出来一个音频音乐,那么也有可能是进行一个网页的搜索,你让他调用了搜索的工具进行一个网页的实时搜索, 那么这这两个东西就是一个输入和一个输出,那不同的模型之间的差异啊,就表现在接收和回复这个信息的内容区别上。那么 open core 官方呢, 截止目前也统计了一个模型的一个使用的一个排行榜,那么这个排行榜里面的模型的排名,不是说我们传统意义上那种模型的一个综合排名,它更多强调的是在 open core 里面的任务的完成的成功率和这一个排名,大家可以看一下, 就是平均的一个排名,就是比如说第一的是 gemini flash, 那 么第二的是 mini max 二,二点一,那么对于 mini max 它现在已经发布到二点五了,但是二点五的表现是在这个排行榜是比较差的, 这个也是非常奇怪的。那么前面还有这个 kimi 的 k 二点五,就这些模型在任务完成的成功率是比较高的,所以这也可以作为啊模型选择的一个参考。 接下来我们就来说一下不同模型在接收信息和返回信息之间的差异,大家可以去选择。就是你在完成任务的时候,为什么有些模型处理的不好,那比如说我们 dbisc, 那目前 v 三点二版本它只支持一个文本的输入和文本的输出,那么对于千万三点五 plus 来说,它能接收文本,也能发图片,它也能去理解这个图片是什么。比如说在我的这个 openclip 的 这个非书的聊天里面,我上传一张图片,那模型来识别一下图片中的文字, 如果你的配置的模型它不支持这种啊图片的识别,那么它出来的结果就是跟实际的结果是有很大的差异的, 那么可以看到它识别出来了这个图片里面的所有信息是完全非常准确的。那么在刚刚的演示里面,我们可以看到千万三点五 plus 它是有一个图片理解能,所以大家在用的时候一定要注意自己的业务的场景 啊,选择正确的模型。那么这里边除了图片理解呢,这边还有一个网页搜索,就是说它本身模型它本身支不支持这种搜索这种内容,因为对于模型来说,知识库它是有一个截止时间的,比如说你可能你 模型的训练数据可能只是截止到二零二五年,但是你现在搜索二零二六年的,那就有些模型他是具备这样的网页搜索能力,他就可以调用这种 实时搜索能力,那么有些是不支持的,那就要配置这样的 m c p, 官方也出了这样的工具,比如像豆包系列,二点零最新的模型也是一样支持文本和图片,那么他这边也是可以单独去开通网页搜索的能力啊。 那我们可以看一下,就是啊这几款国产的,比如说 mini max m 二点五、 m 系列和这个智普的五点零,他们这个图片的识别是需要单独去配置 mcp 的, 不然的话他是没办法去识别的。 那 timi k 二点五的话是原生就支持图片识别,那么国外的模型,比如说 colossal 四点六和 jpeg 五点四,还有 jimmy 的 三点一 pro, 那 么它们都支持图片识别,也支持这种啊网页的实时搜索,那算是这个综合能力算是比较好。那其他的比如说你要去让模型去申请个图片, 那基本上我们现在用到的这主流的这个啊主模型啊都不具备,那么你就可以去调用他们专门的图片模型。比如说像千万,他有专门的万象系列的生成图片的,那么都包括有纪梦相关的模型,那么像 jimmy 的 话,有专门的这个深图的模型也是可以的。就是这些 又需要去单独去配置,在你去生成图片的时候去告诉他去调用这个模型去做这个事情,那像这个火山,这个 cds, 二点零系列都是可以去生成视频的,那么这个就是一定要知道,就是一款模型,它不是万能的, 你可能需要不同的模型来配合去完成你的业务的场景,所以一定要一定要弄清楚你的业务场景里面涉及到了文本、图片、视频、音频, 就把这个东西先想明白了,再去找对应的模型配置好,就才能去把整个东西,整个东西串起来。选好模型之后,很多模型厂商都会有两种购买方式,一种叫做按 token 购买,就是 按用量购买,用多少啊你就付多少,这种方式是比较自由的,它是不受任何限制的。那么第二种就是按这种 coding plan, 就是 套餐的方式,那这种套餐是什么样子呢?一般是有 有限制,比如一个月能用多少次,然后一周能用多少次,然后五小时能用多少次,它是有一个这样的一个限制,会每隔五小时会刷新,每一周会刷新,然后总流量是不超过啊,每个月总流量那么像智普啊, mini max, 豆包,还有这个千万 都出了相关的这种啊这种代码的套餐啊,就是可以可以编码,又可以用在 openclo 里面,那每一个套餐这个量是不一样,大家一定要注意去看,它可能在官方的介绍里面会说啊多少多少次请求,但是要换成就是你的一次对话,就是你跟 openclo 对 话一次,可能要 调用很多这样的一个请求,那么这样的次数是没有他说那么多的。最后呢,就是我们选择好了模型之后啊,我们怎么去配置?第一种方法就是啊原声的就是它 openclo, 它本身你在配置的,你在安装的时候它是有模型的一个列表的,比如说你输入这个 openclo config menu, 那 么 到这一步的时候,你选择这个 model, 就是 你需要去配置这个模型这边的话就会选择很多啊,它本身的支持这个 pro i 的, 就是它本身已经内置了这这些模型的链接,那么你点进去之后,你就可以去输入你的 a p i t, 或者说输入你的这个认证授权的一个链接啊,那这能快速的去完成。那还有一,还有一些它可能是不在这里面的,比如说像千万千万的这个 codeplain, 还有一些其他的这种模型的配置啊,那么你就可以使用这种 cc switch, 那 这款软件,那这款软件呢?有一个单独的一个菜单,那么点进去之后你可以去进行配置,也是一个图形化的界面。那接下来就是这种比较繁琐的,就是去编辑这个这个 配置文件,那这个是 openclip 的 一个啊,总的一个配置文件,那这里面的话,你就要去修改这个 providers agents 里面的内容。一般是 如果你选择哪个模型厂商的话,它会提供这样的配置文件修改的,这个啊完整的字幕串,你直接去给它修改掉就行了。那么如果你自己改这个接线文件,因为这个接线文件非常大, 嗯,不太方便了,你可以借助这个 ai 编程工具,比如像 tree 啊,像 cos 啊去帮你去修改它,它这边是可以去给你修改,而且可以去给你修复可能修改出来的问题啊。 那除了这上面的方法之外,那就可以用它自己的这个外部端里面的设置里面找到这个 modus 的 节点啊,但是它这个说实话非常非常难用啊, 我觉得用上面的方法都比它这个官方这个界面用的会可能会更简单一点。那你如果配置完之后啊,最好是重启一下,那么你在页面上可以点去重启,或者说输入这个 open curl, get away restart 这些命令去重启,重启完之后,那么你就可以去使用新配的模型了。 ok, 那 本期视频到这,希望这个视频对你有所帮助。
1916随风 05:03查看AI文稿AI文稿
你的 openclaw 和 hermes 还在花钱调用大模型的 a p i 吗?今天我教你用零成本本地部署奥拉玛,在你的电脑上直接跑大模型,还能无缝对接 openclaw 和 hermes, 实现免费玩 ai 智能题工具。首先介绍一下欧拉玛,什么是欧拉玛呢?欧拉玛是目前最简单的本地模型工具,在 windows、 mac 和 linux 上都支持,几分钟就能装好,八 g 内存就能跑。当然了,还是建议最少要安装十六 g 内存, 这样体验起来更加流畅。如果有英伟达的显卡,还能够使用 g p u 加速。了解完了欧拉玛是什么之后,我们来看一下欧拉玛如何安装。首先我们要访问欧拉玛的官网欧拉玛点 com, 它的首页是 一个羊驼抱着一个龙虾,下面的英文是 power open claw with ollama, 中文的意思就是使用 ollama 为龙虾赋能,从这一点我们就能看出它是全面的拥抱和支持 open claw 了。这也是为什么今天我要在 open claw 的 专栏里专门做一期 ollama 视频的原因。 废话不多说了,首先要下载欧拉玛,点击右上角的 download, 这里我们可以看到它有 mac os、 linux, windows 的 下载方式自动已经给我们定位到了 windows, 点击这个黑色的 download for windows 按钮, 就会弹出下载框,点击另存为保存,有点大,两个 g, 这个网速非常感人,所以我建议大家用迅雷来下载。 我们已经下载完了欧拉玛的这个安装包,下面我们就开始安装欧拉玛的安装有一个问题,就是它没有让你选择 需要安装的文件夹这个选项,它默认是安装到我们的 c 盘 user 底下的,如果你想安装到指定的文件夹,那你需要换一种方式,我们先把这个安装过程停止。 我们找到拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇拇 斜杠 d i r 等于这里写上我们的安装地址,也就是记盘的欧拉玛文件夹。打回车就跳出来安装界面,我们点击安装,大家可以看这里已经安装到记盘的欧拉玛这个文件夹下面。 进了这个界面,就代表着欧拉玛已经成功安装并且启动了。安装好了欧拉玛,我们再来看如何下载模型。在欧拉玛的网站上点击这个 models, 就 可以进入模型列表,这里都是可以使用欧拉玛直接下载使用的模型。我们来找一下 谷歌的 jam 四,这个是最近小模型中比较好的,可以通过这一句欧拉玛 ram 四来进行下载。 输入奥拉玛 ram 捷摩斯回车运行。安装完了,我们来跟他说一句话试试。我们在这里输入一个,你好打个回车。 好的,扎马四已经回复了我们,虽然有点慢,但那是我电脑性能的问题。大家可以看到现在已经成功地让大模型在我们的电脑上运行起来了。再下一步我们就来看如何把欧拉玛接入到 open cloud 中。 ctrl d, 我 们来退出欧拉玛,然后输入 openclaw config, 进入 openclaw 的 设置,这个我们直接选择本地运行,这个我们选择第二个 model, 打回车进入,然后我们要在这里找欧拉玛, 这个就是欧拉玛提示我们欧拉玛不可用。我们来重新编辑一下 openclaw 的 配置文件。 openclaw 的 jason, 这个就是 openclaw 的 配置文件。我们来找一下 allow 这一项,这里就是扩展的 allow 这一项,我们要在这里添加上 alama。 我 们来运行 openclaw config 来设置 openclaw 的 大模型。 选择默认的本地模式,这个我们选择第二项 model, 就是 设置模型,这个是选择模型的提供商,我们来找一下 alama, 这个是询问我们选择云服务还是本地模式。我们选择最后一个本地模式,这个是欧拉玛默认的 b、 c、 l。 回车,这个是有哪些可用的模型?只有一个,我们按空格选中回车确认 提示,我们已经把模型信息写入了配置文件,我们退出。我们回到 open 可乐,这里是我们 问了 openclaw 一 句你使用的什么模型,他们回,他回答,我使用的是谷歌的伽马四。我们这次的 olamata 下载安装以及安装模型,以及如何在 openclaw 中使用 olamata 模型。到这里就结束了,关注,我每次 都给大家带来一个 ai 的 新知识,感谢大家的观看,再见。
1835波哥的AI课 00:38查看AI文稿AI文稿
我们这款 open 框龙虾跟市面上一些封装版的一些龙虾 u 盘不一样,市面上很多那些封装版的一个 u 盘龙虾只是简单把一个安装包安装到我们一个 u 盘里面,回去还要我们 自己安装啊,自己配置相对一些模型参数 api 这些。但我们这款的话呢,就是我们已经把所有一个需要的一个完整一个环境啊,还有模型参数 api 这些已经全部预设装好了, 您不需要再去自己去操作,自己去装,您只需要把我们这个龙虾 u 盘插进我们电脑里,就可以实现一个一键启动,然后的话就可以来直接上港使用了啊,非常的方便。
 03:25查看AI文稿AI文稿
前面的几期视频,我们聊了奥拉玛的相关技术,并在奥拉玛中安装了大模型。今天的话,我们来看一下如何在 openclaw 里面来连接奥拉玛里面的大模型。首先的话我们打开命令提示符。 好,首先的话我们先看一下 openclaw。 好, 这里安装的是二零二六五点幺二。接下来的话,我们看一下奥拉玛 奥利码的版本是零点二四点零,我们看一下奥利码里面安装了哪些大模型, 这里我安装的是天文三八 b。 接下来的话,我们来看一下我们安装的大模型是否支持在其他工具里面来进行调用奥利码 show, 然后我们把这个大模型的名称给它拷贝过来。 好,我们粘贴一下。好,敲回车。好,这里的话我们要看一下那个 capabilities 里面有没有这个 tools, 如果有的话,我们在那个 openclaw 里面就可以直接调用了。 如果没有这个 tools 的 话,大模型是不支持在 openclaw 里面来进行调用的,那么我们使用之前的话,我们先通过奥拉玛秀,然后加上那个大模型的名称,我们看一下有没有 tools, 有 的话我们就可以在 openclaw 里面进行调用了。好,接下来的话我们给它配置 openclaw。 openclaw 好, 敲回车, 这里的话我们选择 local 这一项,这里的话我们选择 mod 这一项。好,这里的话我们选择木,然后我们来找到那个奥利码。 好,在这里。好,我们敲回车。好,这里的话我们就用本地的奥利码就可以了,我们选择最后这一项 local on 这一项。好,那么奥利码的那个本地的这一个地址的话,就是默认的这一个,我们敲回车。 好,经过一段时间的等待的话,我们已经找到那个我们安装的这一个大模型,那么我们选择那个奥乐玛下面的千万三八 b, 这里好,往下面移动,然后我们在那个呃千万三上面我们敲一下空格,选中,然后我们敲回车, 好,这里的话我们选择那个 down, 就是 我们已经设置完成了,我们退出来。好,接下来的话我们把网关给它启动起来, open close get away run, 好, 我们的网关已经启动完成了,我们通过命令行来打开 open close dashboard。 好,那 openclock 已经打开了,我们把这里关闭掉,然后我们选择一下我们的模型,这个是我们通过奥拉玛在本地安装的大模型,请问三八 b, 然后我们选择一下,然后我们来跟它对话。 好,到这里的话,我们用 openclock 连接本地的大模型就已经成功了,那么我们在使用之前的话,首先要安装那个奥拉玛,奥拉玛安装完了的话,我们要下载那个对应的大模型, 那么我们使用之前的话,首先要把那个奥利码给它启动起来,有没有启动的话,我们看一下就是那个右下角这里有没有这一个图标,那么这个是奥利码的图标, 那么启动完了的话,我们要看一下我们下载的大模型有没有那个 toos 的 功能,如果有的话,我们就可以在那个 openclaw 里面来使用,如果没有的话,我们就要换一个版本再来进行使用,那么这个就是在那个 openclaw 里面连接本地大模型的一个简单的步骤。
149川大猿 01:07查看AI文稿AI文稿
最适合 oppo 酷路的一个天选基座模型,我想除了阶梯五点四应该没谁了吧?一个优秀的一个 ag 的 基座模型, 我的理解是需要三个方面都比较优秀,一个是代码能力,一个是世界知识,一个是多模态理解。当这三个都能达到 s o t a 的 时候,那它几乎必然是一个最流的 ag 的 模型。当然还有一个重要的因素,那就是使用的一个价格。在过去的话,酷路的 oppo s 四点六,它几乎是 ag 的 模型的一个代名词,因为它在上述三个方面都特别的强, 但是它的一个使用价格真的很高,所以使用起来真的很肉疼。而这一次 g p t。 五点四的一个出现,真的就补齐了这个短板。 g p t 五点四,它在代码能力方面是和 g p t。 五点三 code x 是 齐平的,然后在世界知识方面,它比 g p t。 五点二要更加强大,同时它还能使用订阅额度,二十刀就能让你使用的超级爽。可以看这张图,在八个评估指标里面, 五个它都是达到一个最优的。总结一下, g p t 五点三,更强的一个视觉支持,加上更多的一个工具模型调度能力 机,超级便宜的 codex 额度,这四样加在一起,这就是一个完美的 code cool 的 一个天选基座模型,所以现在在使用 open cool 的 你们,可以尝试把模型换成 gpt 五点四,我相信你会发现一个新的大陆。
30Ning好 03:29查看AI文稿AI文稿
哈喽,大家好,今天来跟大家聊聊模型怎么选啊。现在网上的模型像 cloud、 杰米尼、 gpt 啊,大家都说特别强啊。我先来聊聊这个公认最强的几个啊。 cloud, 我 觉得是写东西, 他的语感是目前公认最强的,然后他的代码逻辑和他的结构优化,让人都特别的舒服啊。杰米啊,谷歌的亲儿子,他的联网能力天生的最强啊,多模态全能 啊,作图也非常厉害,然后如果你开的会员的话,用起来也相对比较划算。 gbt 生态最全 啊,用它的 codex 去配合你的 cursor 一 些插件,它效率很高啊。其实除除了这三家以外,咱们国产的模型在某些地方也不是比国外的模型就差特别多。像 deepsea 啊,它的推理能力其实不输一些付费选手, 价格也相对便宜,简单的一些逻辑推理和日常的工作都可以用。 kimi 啊,他是长文总结的一个神器,几万字的论文扔给他,他能从头到尾看完并且给出总结啊。豆包啊,字节的生态,适合做一些生活的琐事,闻一些菜谱 啊,识别一些动植物,写个周报翻译之类的啊,还都挺不错的。然后阿里的通用千问啊,他的综合实力很稳啊,不容易翻车,啥都能干一点。 呃,像 mini max, 我 这个用的也比较多,它的中文语理解能力比较强啊,便携、口部,高脚本一些都非常的不错,包括咱们国产的小米也出了他们的 miimo v 二 pro 啊。这个模型虽然我作为一个资深的米粉,但我确实还没有去亲身用过, 如果有用过的兄弟,可以在评论区评价一下对这个模型的一些真实感受。 呃,接下来就分享一下我是怎么选的,我怎么来配置我的模型的啊,我主要用的就是 cloud, gpt, 然后还有的 hermes, 包括一些国产的 mini max 啊,我的逻辑,首先模型不是一个全能的,他不是什么都能打不同的任务,你要选择不同的模型,就像你装修,你不可能只用一把螺丝刀就用完了啊。我首先像 cloud, 它主要用来优化我的一些代码,解决一些复杂逻辑的一些问题 啊,它的代码逻辑和结构优化都会特别的舒服啊。 gpt 就是 我用的是 codex 啊,日常用它是最多像一些简单的程序的开发和一些日常的工作都会去用它。 呃,我的手和脚就是 open club 啊,还有我们的 hermes, 这个是来用来我的执行落地的啊,他是会把我脑袋里面的想法去真正做落地的一个很好的工具啊。在上期视频我也给大家做了一个分享,有兴趣的话可以去看一看。 嗯,像 mini max 这个是我用来写口播稿或者一些脚本,一些长文案的,嗯,它价格也比较亲民。然后在国产品牌里面的中文优化是做的比较出色的啊。所以说我的配置逻辑就是 cloud 来负责深度思考, gbt 来负责日常开发, hermes, open call 来负责执行落地, 然后 mini max 来负责我的一些中文文案的内容啊,大家也可以去试一下。然后兄弟们你们的这个模型是怎么配置的,也可以在评论区来聊一聊啊,有兴趣。
19懒人程-‖ 01:31查看AI文稿AI文稿
兄弟们经历了多少个日日夜夜,我终于把这个 u 盘码一键启动版给它搞定了,然后给大家看一下,然后正常情况的话我们就是下载以后就是一个这样的包,然后里边有个程序,然后完了你双击运行,然后它就 一下他就会把这个服务拉起来啊,进来以后他就是这种样子的,然后在这里的话我是做了很多内置的功能,在里面也很方便的啊,这里可以去看一下运行日制啊,这个运行日制的话就是判断我这个项目就是这个 u 盘码它到底有没有启动起来,然后完了的话这里还做了这个 模型更换,他这边支持就是可以在这里去换,然后你这边配置好的模型,然后这里还可以去进行一个新增模型啊,这些都是有坐在里边的 啊,主要的话在这里的话就是往下的话就是做了这个呃,微信的一键接入跟飞书的一键接入都很方便,就比如像飞书这里,他因为我已经配过了,然后他这边就会提示现在已经配置了,如果是你要新配的话,你就可以在这里填写你飞书的一个这些信息, 然后填好了之后的话啊,然后你这边就是可以去看一下我们的一个这个技能市场,然后这边我是内置了一个四点六万个的技能的一个技能市场在里边,然后安装技能这一块也是非常的方便啊 啊,反正整体的这个项目他已经是写完了,然后有没有就是想要去测试的,有的话到时候可以找一下我。
12p-claw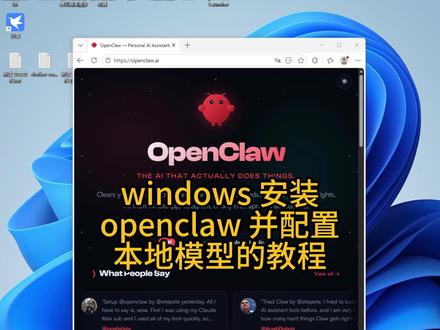 14:18查看AI文稿AI文稿
hello, 小 伙伴们,这一期我们来讲如何在 window 下面安装部署这个小龙虾 open crawl, 首先检查你的 window 下面的那个依赖,一个是 not not 杠 v 显示没有,这是正常的,如果有的话,我建议把它卸掉,重新安装最新版,然后再检查 open crawl, 应该是肯定不会有的, 杠 v 都是没有。好,我们先安装这个 not js, 打开浏览器,直接搜索 not js 这个,然后可以看到这里有一个 download, 我 们直接下载这个 window msi 文件 m s i 文件,我们下载之后会得到一个 note j s 的 二四 v, 二四点幺五这个 m s i 文件,我们双击打开 next, 然后同意 next 默认就行了。 next, 然后这个自动安装其他那个所需掉的工具,然后 next install ok, 它会自动跑完, 跑完之后完成,完成之后他会打开这个命令框,他说点击任意键,继续我们空格,空格两个空格,他就会安装其他所需要的工具包,因为我已经安装过一次了,应该是很快就会跳完。 如果你们没有安装过的,那可能这个过程会有点长,而且保持你的网络畅通。我个人建议是你的电脑要 个权限,因为安装这种 ai 软件的话,很多时候都需要能访问。 好了,他说按回车,那我们直接回车,这样你的 note js 就 已经安装完成了。好,我们关闭浏览器,重新打开这个终端管理员, 然后再检查一下这个依赖的 note, 杠 v 显示二四点幺五是正常的。 m b m 杠 v 显示幺幺点幺三。 ok, 这两个是正常的。 好了,我们安装完这两个之后呢,我们接下来就安装 openclaw, 我 们使用一键安装的命令来到 openclaw 的 官网, o p e n c l a w c l a w 点 a i 这个是 openclaw 的 官网, 然后我们回车来到这个官网,也可以去 getop 的 那个它的地址,那么我来到往下拉,可以找到这里有一个一键安装的命令,选择 window, 这边是 windows, 这边是 window, 然后把这个命令复制 复制到,我们打开这个终端管理员复制到这里,刚才我们依赖已经安装完了,那我们就把这个一键安装的命令复制到这里,咆哮回车,它就进入到 opengl 安装的页面, 因为有时候拉取拉取这个镜像的话,尽量还是需要一点点, 我们等待它安装。实际上这个安装速度取决于你自身的一个网络环境,如果慢的话,大家可以尝试不同的一个时间段,比如说早上五六点钟,这个是服务器比较 比较好连接的时候去安装的话,有可能会快一点。 好了,到这一步, starting set top 实际上已经安装完毕了,可以看到它有一个这个是安装的版本五点二,现在是五点三,那就是昨天的版本,这是最新的版本了, 四点二九呢,是有点问题的,但是五点二我不清楚,应该理论上应该是已经修复了。好,我们这个时候就不要等它 starting up, 不要等它跳转,因为它不会跳转的,我们关闭整个窗口,关闭整个窗口,然后 我们这个时候呢就需要去设定这个,退出这个, 然后我们这个时候就去设定重新开一个终端管理员,然后我们检测一下这个 open crawl 的 版本 杠 v, 可以 看到是二六点五点二,那我们直接 open crawl, 记不住命令的话,我们就直接 reset s e t openclock reset, 它会告诉你这个重置的命令 full reset。 yes, 好, 这个就是我们要的这个重新安装的这个设置的命令,然后我们回车, on board is done, 然后再 yes, 快速快速启动就可以了啊。这个时候我们需要把本地的模型打开,如果你不想联网,如果你有联网的话,你也可以按我上一期的一个教程去接入其他的 其他的供应商的 a p i。 那 本地模型的话,我可以加载一个,加载一个小一点的嘛,三点五千万三点五,设置一下上下文的长度,上下文的长度,然后加载模型。 好,等这个本地模型 l m studio 加载完之后, 加载完之后周围有一个连接跟一个模型的那个,那我们把它把这两个复制, 然后再回到这一边,选择会 star, 回车下来。看什么?这个呢?其实是属于一个万金油的一个状态,什么都可以。哎,怎么退出来了?是时间太久了吗? win 加 e, 哦,好像退出来了,可能太慢了,刚才我们重新试一下 open claw, open claw c l open claw on ball 哎,忘记了,抱歉抱歉抱歉,我们重新执行这一行命令,可能刚才不小心按到哪里了。回车, yes, 然后 quick start。 好 的好的好的, custom custom, 然后把刚才的这个 这个复制上去,加上一个 v 一 要一个 v 一 后缀,然后回车, a p i k 跳过, a p i k 跳过, open a 跳过, 然后输入模型,模型刚刚是九 b, 三点五千万,三点五九 b。 要连接成功,那我们直接本地 l m studio, l m studio, 然后回车,这个是千万千万三点五 这个字自定义的,就是用来识别你自己的一个模型的标志,随意填都可以。 好了,我们直接跳过先,先不连接飞书,我们先把它跑通了,因为飞书那些后面都可以连接 好的,没有问题,那我们再次跳过到了这个 skill 这里。 skill 这个我是强烈建议大家安装一个 crawl, 或者说反正任意一个都可以,但是千万不要说一个都不安装,因为我问过他,在安装 skill 的 时候,他会需要一个创建一个文件夹去参考,你如果第一次安装的话,他会有创建文件夹跟安装路径, 它去再安装那个 skill 的 时候,它就有了参考的路径,就比较没那么容易出错。好了, no no no skill 好 到这一步就安装网关, 它会自动的打开一个新的网关,我们等它自动打开,还需要进行下一步。好,它问你是不是进行聊天呢?我们直接 do it later 就 可以了,或者直接打开也可以,没问题的。 我是等它跑完整个过程再去打开这个对话框,好了,显示到这里,它显示到已经 company 就是 完成了,这个时候就可以进入对话了。实际上你打开了这个对话框,你不要关掉它, 我们保持这个打开,就是这个网关保持打开,然后我们 open curl o p e n c l a w 然后 t u i 进入到聊天对话, 可以看到它整显示正在 connecting, 我 们稍微要等待一下, 好出现这个错误。一千不用管,不用着急,还需要再等待一下,这是二九版本之后出现的一个网关连接超时的问题,可能他还没修复,但是我们只需要等待就行了,等他连接模型 好,可以看到这样子重新连接成功,它显示,但是我们的模型这个四 k 太小了,我们需要重新设置一下,因为我们之前这边的话设置的是一千一百六十 k。 那 我们把这个 打开我我们的安装目录,然后来到这个用户来,然后点 openclock 这个文件夹,打开这个专属文件,打开这个专属文件之后找到这个模型, 找到这个模型这里有个四 k, 把这个四 k 改成一百六十 k, 有 些可能就是一百二十八 k, 看你的模型那个接受的那个大小,然后保存,保存之后关闭就可以了。 好,关闭之后它会看到可以看到这个网关这边,它说你的那个 copy 文件 copy 文件已经打已经变更了,它说正在尝试 reload, 又重启又重启,已经成功了。然后我们就直接重新来到对话框这一边,然后我们新建一个对话杠六, 杠六有没有发送一个 test, 看看他有有没有回复,如果有回复的话,证明我们的那个 初次设置已经成功了。剩下的就是一个对话的问题, 很好,看到他有正常回复,然后你好,你好, 你是谁?我们以后使用中文交流。 好的好的好的好的好的好的好的,我没有,那我帮你。 ok, 看到他已经回复了,到这一步我们已经成功的完成了一个 opengl 的 安装,并且这个模型的配置这些都已经完成了,剩下的就是一个详细的一个设置。好的好的 好的啊,老李这一期就到这里了,关注我,后续继续教大家怎么去玩这个 ai, 大家共同探讨吧。
849菜鸡的老黎 04:08查看AI文稿AI文稿
深度使用 openclaw 的 一段时间之后呢,我得出了一个结论,对于程序员来说,别在它上面浪费时间了,这玩意就是个玩具,我们有更好用的工具,可以高质量的使用。 我知道这句话说出来可能很多人不服,但你先听听我的理由。 openclaw 做的事情呢,说到底就三件事,一个是定时触发条件判断、流程编排, 此外呢,它也负责任务之间的衔接和调度。第三个是遇到需要理解、分析、统计的节点呢,交给 ai 来决策。你看前两层,贝斯脚本全都能做,而且做得更快、更稳、更可控。真正需要大模型的只有第三层,也就是需要思考的节点。 但是 open clone 呢,把这三件事打包成了一个黑盒,看起来很智能,实际上是一个非常不稳定不可控的,就是个玩具。当你深度使用它做一个实际需求的时候呢,问题就暴露出来了,你会发现,刨着刨着,它开始失胶,开始跑偏。一个任务交下去, 回来一看,方向根本不对,你去 debug, 发现根本没有抓手,因为中间发生了什么你完全不知道。这是他的设计就有问题,他把不该交给 ai 的 事也交给了 ai, 一 旦你把确定性的流程塞进一个不确定的系统里, 误差就会一层一层往后传,越跑越歪。对不会写代码的人来说呢,这个代价是可以接受的,因为他们没有别的选择。所以你看市面上那些买了 mac mini, 部署了龙虾的人,现在在闲鱼上都很活跃,因为这东西呢,根本没用,就是玩具,就是噱头。但我现在的做法呢,是这样的, 我把三层拆回来,各司其职。 face 脚本呢,负责所有确定性的部分,比如定时触发、文件操作条件判断、流程衔接这些东西,逻辑清晰,执行稳定,没有任何理由交给 ai。 只有当任务走到一个需要理解上下文,分析情况,做出判断的节点,我才把这个节点交给 cloud code。 这也是我推荐用 cloud code 代替 opencloud 的 第二个原因,它支持脚本的 api 调用,它处理完把结果吐回来,背死脚本,接着往下跑, 完美内嵌。于是呢,我的项目的整个链路呢,长这样。 face 脚本定时触发,跑到决策节点,调用 colode 思考,然后结果交回 face 脚本,继续执行。 ai 只在该出现的地方出现,其余全部是确定性的脚本。 总结一下我的这个 ai 最佳实践,我实操下来呢,有几个优点,第一个就是稳,每一步都可建,每一步都可控。出了问题呢,我知道去哪找,不像 opencloud 那 样, 出了事只能对着黑河发呆。第二个呢,是快,贝斯脚本本来就比任何封装过的工具呢,跑得快,你没有多余的调度程,没有多余的 a p i 调用,该快的地方就是快。给你说个我自己已经跑了一个月的例子,做这个自媒体账号呢,最让我头大的其实就是选择题。 我之前一到这个环节就头大,没思路,没想法。于是我呢,就写了一个脚本,每天定时去爬音,小书, read apps, 还有 get 爸爸的热门内容,爬取清洗,整合,全都是 base 和 python 脚本在跑,不需要任何 ai, 跑得又快又稳。但爬完之后,有一步, 从几百条内容里面判断哪些有价值,哪些值得写,哪些符合我的方向?这件事呢,需要理解,需要判断,需要结合上下文做决策。这一步呢,我交给 cloud code, 他 晚上分析完直接给我输出一份整理好的 选择题文档,分好类标,好理由,我早上上班打开就能用我这个账号。目前有很多选择题都是这么来的,你看,整个列录里, ai 只出现了一次,只在那个真正需要思考的节点上, 其全是脚本在跑。这就是我说的 face。 管躯干, cloud code 呢?管大脑。所以我的结论是,对程序员来说,我们不需要一个帮我们把所有事都 包办的黑盒,我们需要的是在正确的地方,用正确的工具。确定性的问题呢,用确定性的方案来解决。只有真正需要智能的节点才值得接入 ai。 贝斯脚本加 cloud code, 一个管躯干,一个管大脑,这才是 ai 的 正确使用方式,你说对吗?
179橙光的交叉路口 01:52查看AI文稿AI文稿
今天我们来测试一台已经搭建好了的给家电商公司的一个本地大模型,然后我们来看一下大模型都给我们电商公司去带来一些什么方便以及便捷啊?首先我们可以看用的是千元炮, 因为,呃现在千元炮比 oppo pro 要好用多,而且很方便啊。然后我们搭配的模型呢,可以看到是千元三点六二十七 b 的 一个氮次模型,然后因为用的是五零九零啊,所以可以跑二十七 b, 这个全量是非常好的。然后我们可以问他, 比如说二零二五年八月利率有多少,你可以随时查你任何时间段的一个 erp 的 系统,然后当然这个这个是假的,这是我们做的一个演示。然后我们可以看, 因为桌面上会有 erp 啊,然后包括你自己公司的知识库啊,这些都是有的。然后你可以去根据你自己的公司情况,然后去写你整个的薪资架构啊,人员结构啊这些全都可以写进来,然后让 ai 去学习。然后包括 erp, 这个也是可以,比如说你拉拉出一个表单,或者直接对接你 erp 系统的 api, 这都是 ok 的。 那我们可以看他现在已经在思考了,然后并且给出一个答案。那么你可以看到他整个啊,你会有一个相对 一个比较明确的一个表格,然后他会给你整个都列出来,然后他会他会给你一些其他的你可能会知道的东西啊,需要我对其他月份进行进一步分析吧。然后你比如说需要 大家可以看这个速度还是非常快的啊,然后需要之后他就会直接去分析你整个的数据,然后再去给你一张更加详细的一个表格, 这其实是比你去找财务去拉表格啊,去找财务去,对,这些是要方便很多的,而且整个效率会提高非常非常多, 看整个他全部都会给你列出来,这就像你的一个助手一样,是非常方便的。
71老K的Ai服务站 02:36查看AI文稿AI文稿
openclaw 视觉模型配置教程, ai 助手读不了图,三分钟搞定, 从零开始,一步到位。今天分享一个实战经验,怎么在 openclaw 里配置图片识别模型,让 ai 助手能读懂你的截图,全程真实踩坑记录,跟着走不会错。 第一步,在 open k o n g s o n 里添加模型定义,找到 models providers alibaba a models 这个位置,加上通一签问 vo 的 配置。 这里有个关键点,阿里 descope 的 open ai 兼容接口,路径是 compatible mode 下的 v e base url 必须写成 descope 点 l e n c s 点 com, 下面带上这个路径,不然会报四百零。四、 模型 id 是 cribo max, 输入类型标注为 text 和 image, api 格式用 open a completion 二部配 api key, 在 agent's 目录下的 os profiles gson 里添加一个 alibaba 的 profile, 类型是 api 下划线 key, 把你在阿里云 appscop 申请的 t 填进去,如果已经有阿里云账号,在控制台开通模型服务,就能拿到 key。 第三步,设置默认图片模型,在 agents defaults 里把 image model 设为 alibaba 杠 quanview max, 然后在 models 允许列表里也加上这个模型名称。注意不要加额外的字段,加了 vision 冒号 true 会导致启动失败。 接下来是踩坑记录,第一个,配置文件里不要出现不认识的字段,否则 gateway 启动会挂。第二个 base ur l 一定要带兼容模式路径,不是跟路径。 第三个, models g s o n 会被自动覆盖,一定要改 openclaw g s o n 这个源头,改 models g s o n 没用, 配置完之后内置的 image 工具就能正常读图了。实测四 k 截图任务管理器网页截图都能准确识别。还准备了一个 python 直调脚本作为备选,防止内置工具抽风。 好教程就到这里,如果你也在配置 openclaw 视觉模型,照着来就行。
71全栈二把刀 06:58查看AI文稿AI文稿
openclaw 当中如何免费的使用顶级大模型呢?我们知道 openclaw 本身是比较消耗 talking 的, 原因是在于当你和 openclaw 聊天的时候,它会使用上下文的 talking 调动大模型,从而导致我们使用 openclaw 会消耗大量的 talking。 那 问题来了,免费的大模型不好用, 付费的大模型又用不起,那有没有折中的方案可以让我免费的使用顶级的大模型啊?答案还真有,那接下来就给大家分享一个价值几千甚至上万的方式,可以让你免费的使用大模型,少花很多钱,所以大家先点赞再观看吧。那么怎么免费用啊?这里呢就给大家去说一下。我们只需要去 n 平台, 然后 n 平台里面是提供了很多顶级的大模型的,而这些大模型都是可以免费去调用的,给大家来看看都有哪些啊?比如说像国内的顶级的 mini max 最新版,二点一可以免费的调用,还有像智普的 四点七的门学版也可以免费调用。那么像 deep sync, 三点二, kimi 的 模型更不用说了,全部都是免费的。那么我们只需要去平台申请一个 api k, 有 了这个 api k 之后呢,接下来将这个 api k 的 方式使用 open ai 的 方式啊, 配置到你的龙虾的配置文件里面就行了。龙虾的配置文件在哪呢?给大家说一下啊。龙虾的配置文件呢,是在当前的用户底下有一个 opencloud 的 接收,然后这时候打开你的接收啊,因为它内置是不支持这个平台的部署的, 所以我们手动去配置它就行了。手动配置呢,总共有三处地方啊,那么第一个地方呢,就是咱们在 models 供应商里面去添加一个名称,这个名称呢,其实叫啥都无所谓啊,只要后面和咱们的 agent 去对应起来就行了,然后在里面呢, ok, 去写他们家的地址。然后呢,重点这块来了,要去写你的 a p i k 的, 换成你自己的,使 用 open ai 的 方式进行调用,然后你调的模型是啥?那比如说我这儿呢,就是 mini max 二点一的最新版本。好,然后底下呢进行一个设置啊,导到你的 agents 里面,然后将你的 default model 设置成你要调用的模型啊,设置完了之后呢, ok, 在 models 里面同样把这个名称再进行复制一下就行了。这三个地方全部设置完成之后, ok, 这时候回到咱们的 open cloud 里面,将服务关掉,然后这时候使用命令 open cloud get ready, 重启你的服务啊,重启完你的服务之后呢,接下来你就可以去问一下你的龙虾你使用的模型到底是啥了。好,那这时候呢,咱们回到龙虾的 使用界面啊,那么咱们去问一下他,我为你设置了新的大模型,告诉我你使用的大模型是啥,咱们来看一下这个大模型是否是我设置的那个大模型呢?好啊,咱们等待片刻,看到没啊,这就是我设置的 n 公司的 mini max 二点一了,那么到这咱们就可以免费的白嫖顶级的大模型了,我是磊哥,每天分享一个干货内容,在 opencloud 当中 如何免费的使用顶级大模型呢?我们知道 openclaw 本身是比较消耗 talking 的, 原因是在于当你和 openclaw 聊天的时候,他会使用上下文的 talking 调用大模型,从而导致我们使用 openclaw 会消耗大量的 talking。 那 问题来了,免费的大模型不好用,付费的大模型又用不起, 那有没有折中的方案可以让我免费的使用顶级的大模型啊?答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!我们只需要去 n 平台, 而 n 平台里面是提供了很多顶级的大模型的,而这些大模型都是可以免费去调用的。给大家来看看都有哪些啊?比如说像国内的顶级的 mini max 最新版二点一可以免费的调用,还有像智普的 四点七的满血版也可以免费调用。那么像 deepink, 三点二, kimi 等模型更不用说了,全部都是免费的。那么我们只需要去 n 平台申请一个 api k, 有 了这个 api k 之后呢,接下来将这个 api k 的 方式使用 open air 的 方式啊, 配置到你的龙虾的配置文件里面就行了。龙虾的配置文件在哪呢?给大家说一下啊。龙虾的配置文件呢,是在当前的用户底下有一个 opencloud 的 文件夹,然后在这个文件夹底下呢,有一个 opencloud 的 js, 然后这时候打开你的 js 啊,因为它内置是不支持这个平台的部署的, 所以我们手动去配置它就行了。手动配置呢,总共有三处地方啊,那么第一个地方呢,就是咱们在 models 供应商里面去添加一个名称,这个名称呢,其实叫啥都无所谓啊,只要后面和咱们的 agent 去对应起来就行了。然后在里面呢, ok, 去写他们家的地址,然后呢,重点这块来了,要去写你的 a p i k 的, 换成你自己的,使 用 open ai 的 方式进行调用。然后你调的模型是啥啊?那比如说我这儿呢,就是 mini max 二点一的最新版本。好,然后底下呢进行一个设置啊,导到你的 agents 里面,然后将你的 default model 设置成你要调用的模型啊。设置完了之后呢, ok, 在 models 里面同样把这个名称再进行复制一下就行了。这三个地方全部设置完成之后, ok, 这时候回到咱们的 open cloud 里面,将服务关掉,然后这时候使用命令 open cloud get rid 重启你的服务啊。重启完你的服务之后呢,接下来你就可以去问一下你的龙虾你使用的模型到底是啥了。好,那这时候呢,咱们回到龙虾的 使用界面啊,那么咱们去问一下他,我为你设置了新的大模型,告诉我你使用的大模型是啥,咱们来看一下这个大模型是否是我设置的那个大模型呢?好啊,咱们等待片刻,看到没啊,这就是我设置的 n 公司的 minimax 二点一了,那么到这咱们就可以免费的白嫖顶级的大模型了。我是磊哥,每天分享一个干货内容,在 opencloud 当中 如何免费的使用顶级大模型呢?我们知道 openclaw 本身是比较消耗 talking 的, 原因是在于当你和 openclaw 聊天的时候,他会使用上下文的 talking 调用大模型,从而导致我们使用 openclaw 会消耗大量的 talking。 那 问题来了,免费的大模型不好用,付费的大模型又用不起, 那有没有折中的方案可以让我免费的使用顶级的大模型啊?答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!答案还真有,那接下来就给大家分享一个价值几千甚至上万的大模型啊!我们只需要去平台, 然后 n 平台里面是提供了很多顶级的大模型的,而这些大模型都是可以免费去调用的,给大家来看看都有哪些啊?比如说像国内的顶级的 mini max 最新版二点一可以免费的调用,还有像智普的 四点七的满血版也可以免费调用。那么像 deepink 三点二, kimi 的 模型更不用说了,全部都是免费的。那么我们只需要去 n 平台申请一个 api k, 有 了这个 api k 之后呢,接下来 将这个 api key 的 方式使用 open a 的 方式啊,配置到你的龙虾的配置文件里面就行了。龙虾的配置文件在哪呢?给大家说一下啊。龙虾的配置文件呢,是在当前的用户底下有一个 opencloud 的 文件夹,然后在这个文件夹底下呢,有一个 opencloud 的 json, 然后这时候打开你的 json 啊,因为它内置是不支持这个平台的部署的,所以我们手动去配置它就行了。 手动配置呢,总共有三处地方啊,那么第一个地方呢,就是咱们在 models 供应商里面去添加一个名称,这个名称呢,其实叫啥都无所谓啊,只要后面和咱们的 agent 去对应起来就行了,然后在里面呢, ok, 去写他们家的地址,然后呢重点这块来了,要去写你的 a p i k 的, 换成你自己的,使 用 open ai 的 方式进行调用。然后你调的模型是啥啊?那比如说我这儿呢,就是 mini max 二点一的最新版本。好,然后底下呢进行一个设置啊,这是第一处,先把它进行设置,然后设置完了之后呢,接下来第二处啊,找到你的 agent 里面,然后将你的 default model 设置成你要调用的模型啊,设置完了之后呢, ok, 在 models 里面同样把这个名称再进行复制一下就行了。这三个地方全部设置完成之后, ok, 这时候回到咱们的 open cloud 里面,将服务关掉,然后这时候使用命令 open cloud get 为 重启你的服务啊,重启完你的服务之后呢,接下来你就可以去问一下你的龙虾你使用的模型到底是啥了。好,那这时候呢,咱们回到龙虾的 使用界面啊,那么咱们去问一下他,我为你设置了新的大模型,告诉我你使用的大模型是啥,咱们来看一下这个大模型是否是我设置的那个大模型呢?好啊,咱们等待片刻,看到没啊,这就是我设置的 n 公司的 minimax 二点一了,那么到这咱们就可以免费的白嫖顶级的大模型了。
114金翔元优选 00:55查看AI文稿AI文稿
兄弟们,上期说了 a p a 就是 软件调用大模型的点单窗口,那在给预年纳什上部署的 opencloud hammers 配置 a p s 为什么要填一堆东西呢? base, url, api, key, modisk, token 什么的 密密麻麻,看着就头大,其实很简单啊,还是拿点奶茶来举例。 su 幺幺呢,就是店铺地址,你要先告诉软件,我要去哪家模型厂商点单,是 dsp 还是豆包。 a p i k 呢,就相当于你的支付密码,输入支付密码才能付钱,就是利用这个模型,所以这个东西如果你给别人了,他拿到你的 k 去点单钱,算你头上目的 id 就是 你具体要点什么奶茶。同一家厂商呢,有很多的模型,有的便宜,有的聪明,有的能看图,有的呢 适合写代码。具体的呢,可以去模型厂商的官网 a p i 文档里去查,也可以去问 deepsea 或者是豆包配置到模型 a p i 核心呢,就是这三样。这三个填好之后呢,其他的选项都可以让它帮你设置,学会点赞。
658绿联NAS头号玩家

