你有没有遇到过这种情况?用 cloud code 改了半天代码模型,突然变得健忘,忘了你五分钟前明确要求的接口签名,甚至重复建议你已经否决过的方案。这不是模型变笨了,是上下文窗口满了。自动压缩刚刚触发。 今天我们来拆解 cloud code 的 自动压缩机制,搞清楚三件事,什么时候触发?怎么压缩?出了问题怎么办? 第一,什么时候触发核心公式很简单,当前 to 整数超过预值就触发压缩。 以二百 k 上下文窗口为例,预值怎么算?两步减法,先扣掉二十 k 作为压缩输出预留,因为压缩本身也要占上下文空间。再扣掉十三 k 作为缓冲区,确保预值触发到实际执行之间还有余量。 二百 k 减二十 k 减十三 k 等于幺六七 k。 也就是说,你用了大约百分之八十三点五的上下文窗口时,自动压缩就会启动。 如果你想提前触发,可以设环境变量。 cloud 下划线、 auto compact 下划线、 pct 下划线 override 等于七十,让压缩在百分之七十就开始。注意这个值只能让压缩更早,不能更晚。 第二,怎么压缩?压缩的本质是让模型把整个对话浓缩成一份结构化摘要, 关键是那个压缩提示词。九个段落,每段有明确的保留目标。第一段,保留你的显示请求,防止跑题。第三段,保留文件和代码,注意它要求完整代码片段,不是摘要。 第四段,保留调试历史,防止重复犯错。第六段,保留所有用户消息。哦,大写强调。第八段,保留当前工作的精确状态。 还有一个巧妙设计模型,在生成摘要之前,要先写一个 analysis 草稿块,按时间顺序便利对话。但这个草稿块不会出现在最终上下文里,写完就被删掉了,相当于白嫖了一次。思维链提升摘要质量,但不占空间。 第三,出了问题怎么办?最严重的问题是压缩也压缩不动,对话太长,连压缩请求本身都超过了 a p i 限制。 这时候 cloud code 会丢弃最旧的消息,重试最多三次。更极端的情况是,压缩完成后上下文仍然超标,下一轮又触发,形成死循环。真实数据有绘画,连续失败了三千二百七十二次,每天浪费二十五万次。 api 调用 解决方案是一个极简的熔断器,连续失败三次,自动压缩停止,用户仍然可以手动执行斜杠 compact 的 命令,但系统不再自动重试,宁可让你手动处理,也不用注定失败的重试,浪费预算。 最后,给你三个实操建议。第一,别等自动压缩完成一个子任务后,主动执行斜杠 compact 命令,还可以加字定义指令,比如重点保留文件、修改历史和错误修复记录。 第二,关键约束,写进 cloud 点 md 文件, cloud 点 md 不 受压缩影响,你早期对话中的偏好可能经过多次压缩后消失。第三,把不可压缩的内容迁移 系统消息、附件、编码数据,这些压缩不掉的东西越少越好,否则容易触发熔断。自动压缩的设计体现了三个工程原则,多层缓冲,防止溢出,渐近降级,逐层兜底,用户可控,避免黑盒。

粉丝76获赞424
相关视频
 03:29查看AI文稿AI文稿
cloud code 到底有多少个命令?官方近百个,但真正让效率翻倍的只有十九个。今天我就把这些核心命令全部讲透,还有避坑指南,帮你少走弯路。从对话管理开始,你有没有经历过跟 cloud code 聊了两个小时, 忽然模型开始给你烂代码?这不是 cloud 变傻了,而是你的对话太长了,模型注意力被分散了。 clear 就是 清空对话历史,完成一个功能模块后,新开对话, 保持模型思路清晰。但如果信息还重要呢?用 compact 压缩对话历史,同时保留摘要,上下文占用达到百分之六十到百分之八十使用,这是我用过最高频的命令。 resume 恢复之前的对话,快速继续中断的任务。 b t w 在任务运行时快速提问,不打断流程。 revend 是 时光机回退到之前节点,代码同步恢复。接下来讲设置调整 effort 设置模型思考深度,复杂任务用 effort high 深度思考,简单修复用 effort low 快 速响应 config, 打开设置面板,修改主题模型、版本界面语言。新手建议日常用 opus 四点七,只有复杂问题才用 effort high。 现在讲实用工具,这部分命令用的特别频繁。 id d 二,添加额外工作目录,关联多项目 copy 复制,最近回复到剪贴版。 export 导出对化为文本文件,永久保存重要记录。 innit 这个很关键,新项目必须跑它,让模型快速理解你的项目结构、技术栈和代码规范,跳过这一步,后面代码质量会大打折扣。继续讲实用工具,还有权限和调试这一块。 permission 给常用工具设置免确认执行,减少弹窗干扰。 review, 提交前审查 pull request, 发现 bug, 风格问题,安全隐患,这是一道保险杠,强烈推荐每次提交前跑一遍。 m c p 连接外部工具,接入 gitup、 slack 数据库等,打通工作留边界。 chrome 连接浏览器,调试前端页面,实时访问元素和控制台 loop, 按时间间隔自动运行命令,比如每三十分钟检查一次服务。 memory 编辑记忆文件, 让模型记住你的偏好和代码风格,越来越懂你。接下来讲插件和洞察。 plug in 进入官方插件市场安装推荐插件扩展能力 insights 生成使用分析报告,每周看一次,它会告诉你编码习惯, 还能推荐你没用过的高效命令。三个新手最常犯的错误错误一,跳过 enit, 新项目不跑它。模型对项目一无所知,后续代码质量大打折扣。正确做法,每个新项目第一步就是 enit。 错误二,对话越对越长,上下文越长,模型反而变傻,注意力分散,所以百分之六十到百分之八十时就要 compact 或 clear。 错误三,提交前不审查,直接部署代码,潜在 bug 流入线上, 每次提交前必须 review, 记住这个顺序,开始用 init, 过程中用 compact, 结束时用 review, 就 能避开百分之九十的效率陷阱。 这十九个命令我总结成了速查表。对话管理有五个设置调整,有两个插件和洞察,有两个使用工具的快捷操作,有五个权限调试和自动化,有五个建议截图保存,随时查看。 掌握这十九个命令,就能超越百分之八十的用户。三个立即行动。第一,打开 cloud code, 输入 help, 看完整列表。第二,每个新项目先跑 init, 让模型认识你的项目。第三,截图保存速查表,有问题随时查好了,希望这些能帮你提升效率,谢谢。
623AI编程-鹏宇 03:15查看AI文稿AI文稿
给大家介绍一个欧邦扣的一个插件,欧邦扣的里面有很多的各种各样功能的插件,今天我们给大家介绍一个省钱的插件,动态的上下文裁剪的一个插件。因为我们在 使用这些写代码的软件过程当中,他的上下文其实是非常多的,你可以看到他有用户有回答,当然他有大量的是调用工具,所以他这个上下文都会很多。那么这个插件的功能是什么呢?他可以把 像非常多的这种 token, 它可以帮你节省下来做一个压缩,那这样一方面你压缩完了之后,你可以让你更省钱,让你的大模型在解决一些问题的速度和效率会更高,它是等于是这样。这个插件我们今天就给大家介绍一下, 看看怎么来装。这个插件叫 dynamic context 这样一个裁剪的一个插件,这个插件安装起来是非常简单的,我们给大家讲它只要是在 open code 的 这个配置文件里面,你自动的加上这样一段代码, 自自自动加上这个插件的这段代码,你启动这个欧奔扣的之后,他自动的就会根据你的上下文的实际情况,他自动的会做一些裁剪。像我这个里面原来大概有十九点三个托肯,他可以一下子帮我做压缩,压缩到二点七个托肯, 那这样我就可以在用这些工具的时候效率就会比较高,同时也比较省钱。那它的原理是什么?它的压缩的原理是什么? 它压缩它有三种方式,这第一种方式就是帮你把上下文生成一个摘要,这极端的压缩方式,把你的大模型调工具的这些内容全部删掉,这是一种压缩方式。第二种压缩方式,它把保留一部分的上下文的内容,它把你的 message 基本上都会保留下来,那但是它在工具的调用过程当中,它只是会保存一部分,它等于是只保存比如说最后的几个,那这样它也起到这个上下文这个字托肯压缩的这样一个能力。还有一种就比这个压缩更叫裁剪,裁剪应该用的最多的一种方式,就是 把错误的这个大模型调用的这样一些内容,它称之为叫 noise, noise 的 这个工具的内容从上下文里面把它给删除掉,删除掉之后,那么它也是一样做到这个上下文 talk 的 这样一个精简,那么可以帮我们节省这种算力,同时减少哦这个 talk 的 消耗。因为大模型用的 talk 也会比较少,同时它的目标需求也比较明确,相反它的效率包括它的准确率反而会提升,那么这个插件就是这样的一个东西,那么我们简单给大家看一看它这个插件到底是怎么来用,怎么来安装,我们给大家看一下 它本质它就是个配置文件,这个它在 config 下面你只要加这样一段话就可以,那么它就可以帮我们去实现这样的一个上下文的这样的一个 context 裁剪压缩的这样一个能力 还是非常简单,也不需要下载任何软件,它自动的会连上网去下载这样的一个软件,加载在你的这个上下文里面,它可以去处理,它也是有些指令的,它有一个叫这个,它有各种各样的指令, 那当然你也可以去看一下他的目前的这样一个情况,告诉你他裁剪的这个情况,他也可以去给你看,这是他的指令,我用的是一个自动的一种方式,这个就是前面讲的他手动他可以有裁剪、有压缩、有蒸馏,这多种方式他其实都是可以的。 好,那么如果大家有兴趣也可以去尝试一下这样的一个插件,他主要是在 open code, open code 的 这样的一个工具里面去使用的,去帮你减少上下文的托管。好,那这样的一个工具我们今天就给大家就介绍到这。
150小工蚁 01:08
 00:41查看AI文稿AI文稿
我之前是介绍过有一个上下文压缩的一个工具啊,叫动态上下文压缩裁剪插件,你可以用一下。我自己是没有感觉的,因为我一般用的模型都是我们公司独立部署的模型,所以我是不太关注透肯的使用量的。我比较关注的是延迟,他速度快不快,这个我会比较关注。 那个工具我看是他项目上说他至少能够帮你节省百分之三十到百分之四十的透肯的消耗。 具体我没有测过。还有一个减少 token 的 方式,要增加 memory, 要增加一个跨 session 的 memory。 那 那你这样,你不需要把很多共用的那些东西你反复地喂给这个大模型的上下文里是你不需要。
20小工蚁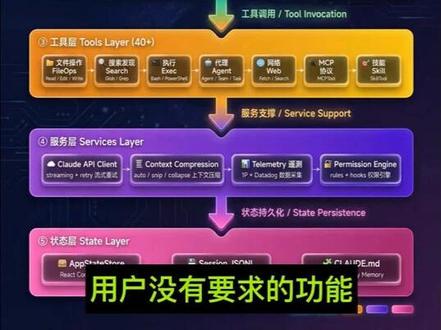 05:55查看AI文稿AI文稿
今天咱们来聊一聊这个 cloud code 为什么写代码又快又准?对,其实这个的核心原因并不是因为它的大模型有多么的厉害,而是因为它的工程包装和系统设计特别的巧妙。没错, 对,这是一个经常被大家忽略的点。 ok, 那 我们就开始吧。我们先来看看就是 cloud code 的 核心架构,对它的这个循环设计到底是怎么回事?为什么可以让它扩展新功能的时候特别的灵活?其实它的核心就是一个很简单的无限循环。对, 然后所有的复杂的逻辑都被委托到了工具层和外面的十二层包装里面。所以说你想要加一个新功能的话,你要么就加一个新工具,要么就加一层包装,就 像你给手机装一个 app 一 样,你根本不用去碰核心系统哦,这样的话就真的很方便,对升级和维护都特别省事。是的,而且行业媒体都已经讲了,就是这种设计可以让新功能的迭代成本直接降低一大半, 他的这种灵活性在页内真的是非常非常少见。接着我们要讨论的就是这个十二层包装里面的一些非常实用的设计。那首先就是这个前置规划 这个东西到底给任务完成率和代码的成功率带来了什么样的提升?这个前置规划其实就是在原码里面强制要求任何任务都得先列出步骤再执行,就像写论文要先写大纲一样, 有了这个规则之后,任务完成率直接翻了一倍。然后科技媒体也证实了这个优化,解决了大部分 ai 写的代码跑不起来的问题。 然后子智能体机制和上下文压缩机制这两个设计到底怎么让这个 cloud code 可以 一边查资料一边跟你继续聊天,还能让对话长度几乎没有限制?子智能体机制就是说他可以创建独立的小助手,有自己的记忆,所以比如说你让他去后台查个资料,他派个小助手去就行了, 你还能继续跟主程序聊别的,他们之间是不会互相干扰的,挺厉害的,这个多任务真的挺吓人的,对,就挺聪明的感觉,对。然后那个上下文压缩机制,他是一个三重的策略,就是他会自动的给旧的消息生成摘药, 然后把一些没用的消息删掉,所以整个对话他既能保持很流畅,又不会爆掉你的这个计费的额度,你也根本就不会察觉到他在后台其实做了这么多的操作。下面咱们来看看工具系统的安全设计和提示词的优化 这两个地方的优化到底是怎么让 cloud code 可以 又安全又省钱的运行呢?工具系统的安全设计这块呢,他做的非常的细致,就是每一个新加入的工具默认都是不安全的, 然后他会一个一个的顺序执行,并且在执行的过程当中自动的进行权限检查,只有你明确允许了他们可以并行,他们才会并行,所以这样的话就不会出现说因为工具的调用混乱而导致系统崩溃,同时他的效率也很高, 比如说多文件搜索这种就会非常的快,听起来就很可靠。对,这个确实挺让人安心。然后提示词优化这块呢,它是把系统提示词分成了固定的和可变的两部分,那固定的部分它是会缓存起来的,就不用每次都重新传输,这样就省了很多的计费的成本。 然后可变的部分呢,就是每一个对话独有的内一些内容,他还专门加了一些规则,就是让 ai 不要去写一些荣誉的代码,比如说不要去实现一些用户没有要求的功能啊,或者说不要去写一些没有用的错误处理啊,这些都直接切中了大家经常会遇到的一些痛点。 然后我们要讲的是全线系统的设计,他是怎么通过这种分级的方式来保证操作的安全性,他是把所有的操作分成了三个等级。绿色的话就是本地的一些可逆的操作, 比如说像编辑文件啊,跑测试啊这些就不用你确认,他可以直接做。然后黄色的话就是会涉及到向外输出的,比如说像提交代码或者发消息啊这种他就会弹一个确认框。 红色的话就是一些高风险的,比如说像删数据库啊,或者是强制推送代码啊这种他就会反复的跟你确认。 对,他完全是按照量两次切一次这种原则来做的,所以你就很难会因为误操作而造成一个严重的后果。好的,咱们现在要讲的是一些未上线的功能和内部版的一些独家能力, 这些新的特性将来会怎样改变我们使用 ai 编程工具的体验,现在我们从源码里面发现了几个还没有上线的功能,比如说全自主智能体模式,就是他可以自己定时的唤醒,然后自己去寻找任务并且执行,就你甚至都不用守在电脑前面。 还有一个就是集群协助模式,就是多个智能体可以组成一个团队,然后他们会自己去扫描任务版,接着自己认领任务,完全不需要你手动的去分配。哇,那真的是解放了双手啊。对, 感觉以后编程真的就是设置好就可以等结果了。还有一个技能系统,它是可以按需加载功能的,就你什么时候要用这个功能他才会去加载, 这样的话就可以节省你的计费额度,也不会有什么多余的东西来干扰你。将来还会有一个远程功能商店,就类似于手机应用商店一样,你需要什么功能就下载什么功能,用起来非常的方便。听起来非常实用,那这个内部版本和我们现在用的这个外部的版本, 他们之间到底有多大的差距?现在我们用的这个外部版本其实只是看到了冰山一角,内部版本比他多了一百零八个模块,然后像什么后台守护进程啊,多智能体的协调器啊,还有远程功能搜索啊,这些都是内部才有的。嗯, 所以未来这些东西如果逐步开放出来的话, ai 编程工具的体验应该还会有一个非常大的跃升。明白了, 那我们最后再给大家讲一个小技巧吧,就是大家在下次用 ai 写代码的时候可以怎么去做,让它的准确率可以变得更高。你可以让 ai 先列出一个三步的执行计划,然后再让他去写代码,这样的话一般都会提高它的准确率。好的,那今天我们跟大家一起拆解了这个 cloud code 的 背后的一些工程的秘密, 然后也看到了这些系统设计上的巧思是怎么让它变得又快又可靠的。嗯,感谢大家的收听,然后我们下期再见吧,拜拜。拜拜。
79AI大白话 01:25查看AI文稿AI文稿
今天呢给大家介绍一款解决 cloud code 思域的一个插件, cloud m e m, 它能够自动的呢捕获编码绘画中的所有的操作记录,通过 ai 呢智能压缩,并在未来的绘画中注入相关上下文。 这款插件呢解决了 ai 编程助手最棘手的问题之一,上下文的连续性。在传统的这个 cloud code 的 使用中,每次开启新绘画 ai 呢都需要重新了解项目背景,这不仅仅浪费了时间,还容易导致信息丢失。 通过一套精密的记忆系统,让 cloud code 能够记住之前的对话和操作,实现真正的智能辅助编程。 我们来看一下它的核心功能呢,主要呢就是自动获取上下文。第二个呢就是智能的压缩与存储,使用伺候奈的数据库呢,存储绘画,观察和摘药。 第三个呢就是强强大的这个搜索能力,自然语言查询支持,支持渐近式信息展示。第四个呢就是 web 可丝化界面,内置呢 http 的 一个服务,提供直观的这个 web 查看器的一个界面, 安装好以后呢,就可以在这个界面当中可以看到我们对应的这个绘画。
76老码AI驿站 04:32查看AI文稿AI文稿
大家好,我是安逸,今天跟大家聊聊 code to code 的 上下文压缩机制,这是一个让 ai 能处理超长对话的关键设计,主页有更多技术架构解析,感兴趣的朋友可以点个关注。好,咱们直接进入主题。 code to code 会做的事情越多,上下文膨胀的越快,读个大文件会塞进很多文本,跑一条长命令会得到大段输出,多轮任务之后就结果越堆越多。没有压缩机制的话,问题来了, 模型的注意力被就结果淹没, a p r 请求越来越重,越来越贵,最惨的是直接撞上上文,上线生物直接中断。这一章要解决的就是怎么在不丢掉主线连续性的前提下,把活跃上下文重新腾出空间。 先讲清楚三个概念,上下文窗口就是模型的这一轮真正能一起看到的输入容量。它不是无限的活跃上下文,不是历史上所有内容都要一直留着,而是当前这几轮继续工作时最值得模型马上看到的那一部分。 压缩呢?不是 z i p 压缩文件,而使用更短的表示方式,保留继续工作真正需要的信息。比如大输出只保留预览文,写到词盘,旧工具,结果改成占位提示。整段历史总结成一份摘要。理解了这三个词,接下来讲三层架构就顺了。 这一章节你先记三层,不要一上来七八层十层。第一层大结果不直接塞进上下文,写到词典只留预览。第二层旧结果不一直原样保留,替换成简短占位提示。第三层整体历史太长时,生成一份连续性摘药,手动触发 compact 工具,本质上也是走第三层,这三层是从小到大的递进关系, 前两层是日常,第三层是兜底。先看第一个关键数据结构, persisted apple mark。 当工具输出太大时,不要把文强塞进当前对话。它的最小标记结构是这样的,用 xml 标签包裹,里面写明文保存到了哪个路径,再附上一段预览。 这个结构表达三层意思,权威没有丢,只是搬去了词盘。当前上下文里只保留一个足够让模型继续判断的预览。核心思想就一句话,让模型知道发生了什么,但不强迫他一直背着整份原始大输出。 第二个数据结构是 compact state, 教学版建议显示维护一份压缩状态,它有三个字段, has compacted, 标记这一轮之前是否已经做过完整压缩。 last summary, 存最近一次压缩得到的摘要 recent files。 这通最近碰过哪些文件,方便继续工作。还有个 microcompact boundary, 就是 一条简单规则,只保留最近三个工具结果的完整内容,更旧地改成占位提示。这已经足够让初学者理解,不是所有历史都要原封不动地一直带着跑。 讲完数据结构来看,最小实线分五步,第一步,大工具结果先写磁盘,判断长度,超过预值就保存到文件,返回一个 persistent auto 拨记。第二步,旧工具结果做微压缩,把超过保留边界的那些改成占位提示。第三步,当整体历史过长时,做一次完整压缩,用摘要替换整段对话。 第四步,在主循环里接入压缩逻辑,每次迭代都先做微压缩,然后检查上下文大小是否超线,超了就触发完整压缩。第五步,手动压缩和自动压缩附用同一条机制,用户主动触发 compact 命令,不需要重新发明另一套逻辑,做到这一步最小实现就完整了。 这里有个地方特别容易讲虚,压缩不是把历史缩短这么简单,真正重要的是让模型还能继续接着干活。所以,一份合格的压缩结果至少要保住五大类信息,第一,当前任务目标是什么?第二,已经完成了哪些关键动作?第三,改过哪些文件或重点看过哪些。第四,做过什么关键决定和约束。第五,下一步应该做什么? 如果这些没有保住压缩虽然腾出了空间,却打断了工作连续性,那还不如不养。从这一章开始,主循环多了一个很关键的责任管理,活跃上下文的预算 agent loop。 现在同时维护两件事,任务推进和上下文预算这步非常重要,因为后面的很多机制都会和它联动。 记忆系统决定什么信息值得长期保存。系统提示词 apply 决定哪些快,应该重新注入错误恢复会处理压缩不足时的恢复分支。上下文,压缩就是整个系统里的空间管理器。 讲完正确做法,再来看初学者最容易犯的五个错。第一,以为压缩等于删除,不是的,压缩是把不必常驻的内容换种表示。第二,只在撞到上限才临时乱补。更好的做法是从一开始就有三层思路。第三,摘要只写成一句空话,没有保住文件决定下一步,对继续工作没帮助。 第四,把压缩和 memory 混成一类。压缩解决的是当前绘画太长怎么办? memory 解决的是哪些信息?跨绘画仍然值得保留?第五,一上来就给初学者讲过多产品化层级教学主线,先讲清最小正确模型比堆名次更重要。 最后一句话,记住这张的核心上下文。压缩的核心不是尽量少字,而是让模型在更短的活跃上下文里仍然保住继续工作的连续性。 proceed out top 加 micro compact, 再加 summary compact。 能做到这一点,这章就到位了。我是安逸,下期我们聊权限系统,不是所有工具调用都能直接执行,高风险操作必须先过安全关。主页有完整系列,感兴趣的朋友可以去看,咱们下期见。
59安逸 i 03:09查看AI文稿AI文稿
agent 越跑越慢,不一定是模型差很多长任务,真正的问题是旧结果和大输出把上下文塞爆了,模型看不清下一步 到了 s 五, agent 会读写文件,规划步骤,派字代理,按需加载, skill 能力越多,副作用也越明显。读大文件跑长命令,多轮推进都会让上下文越来越重。 三个词先讲清。 context window 是 模型这一轮能看到的容量, active context 是 继续工作最值得马上看到的部分。 compact 不是 zip, 而是用更短表示。保住必要信息, 最小心智模型记三层就够。第一,大工具结果不要直接塞进上下文,先写到词盘,只留预览。第二,旧工具结果不要一直原样保留,改成占位。第三,整体历史太长时,再生成连续性摘药。 第一步,大工具结果先写词盘,如果输出超过预值就保存到文件,只在 messages 里放一个 persisted output marker 模型,知道发生了什么,但不用一直背着完整原文。 第二步,旧工具结果做微压缩教学版可以先设一条简单规则,只保留最近三个工具结果的完整内容,更旧地改成一句占位提示。 第三步,整体历史还是太长时才做完整压缩。这里最重要的不是摘药格式,而是保住当前目标,做过什么,改过哪些文件,关键决定和下一步。 这一张如果只记一个结构,就记 compact state has compacted, 记录这轮之前是否压缩过。 last summary 保存最近摘药。 recent files 记录最近碰过哪些文件, 接近主循环也很直接。每一轮先做 micro compact, 再估算上下文大小,超过限制就执行 compact history, 然后再调用模型 agent loop, 从这里开始,同时维护任务推进和上下文预算。 压缩后真正要保住的是连续性。当前任务目标已完成的关键动作,重点文件,关键约束,下一步这些不能丢,否则字数少了,工作线也断了。 最容易踩四个坑。第一以为压缩就是删除,第二只在撞上上线后临时乱补。第三摘要写成一句空话。第四,把压缩和 memory 混成一类。 最后记住一句上下文。压缩的核心不是尽量少字,而是让模型在更短的活跃上下文里仍然保住继续工作的连续性。下一章,权限系统会继续解决另一个问题,哪些动作 agent 不 能直接做?
 01:08查看AI文稿AI文稿
我用 cloud code 跑通了视频自动剪辑,给大家实操展示一下,现在的 cloud code 太牛了,我深度使用了一个半月了,它能解决电脑上百分之九十的事情,我养过小龙虾一阵子,那 open clock 就是 个智障儿童。 这个剪辑软件已经开源了免费软件,我放在了评论区,给大家看一下。剪辑过程简直是自媒体的福音,从此不用再吭哧吭哧花时间剪视频了,开始实操。 运行了这个免费的开源工具以后,他开始帮我解析视频,看到我的视频有十二秒我的视频一个内容的结构,这是我拍的一个口播的数字人,他分析完我的视频以后,因为我全程没有口气词, 嗯,十秒一进到底,语速偏快但清晰,所以他给出了一个建议,方向,加字幕调色,加动画叠层,想问我往哪个方向走。接下来他就自动开始写脚本,写代码,我全程没有操作。 然后他开始生成三个动画,进行一个渲染,现在到了渲染环节,这是最终的一个产物,这是最终的视频,我们拉到最下面啊,直接直接丢出来了一个这个视频,结果牛不牛?现在 ai 太牛了,卡的酷的,赶紧用起来,点个关注,谢谢!
2.1万潮蜜商务 02:50查看AI文稿AI文稿
我们知道 cloud code 不 同于普通聊天应用,可它是怎么工作的? 解释 cloud code 最好从智能体循环说起。你先在 cloud code 里输入提示词,然后它会收集完成任务所需的上下文。它会和模型交互,模型会返回文本或返回可执行的工具调用, 接着它就会行动,比如编辑文件或运行命令。最后它会验证结果,判断是否达成了你最初的要求。 如果可以, cloud 就 结束等下一条。如果没有, cloud 会重新进入循环,直到结果完整且可验证。在整个过程中,你都可以补充上下文,中断它或引导模型靠近目标。 cloud 有 上下文窗口,用来决定能保存多少对话和文件内容, 还有命令输出等信息也能保存并回看。一旦达到上限, cloud code 会压缩你的对话,并自动判断 哪些内容能移出上下文窗口,哪些内容可以总结,从而把上下文窗口降回合理大小。 工具是智能体工作的核心,现在大多数 ai 助手只是输入文本再输出文本, 中间没有工具。让 cloud code 和其他智能体知道何时执行代码来推进任务,比如读取文件工具或联网搜索工具。 cloud code 会用语义搜索判断何时调用工具并获取结果。 cloud code 还有权限模式,默认情况下,编辑文件或运行 shell 命令前,它都必须明确请求许可。 你可以用 shift 加 tab 在 不同模式之间切换。自动接受模式会直接改文件,但运行命令仍会询问计划模式或用止读工具先帮你整理行动方案。 跳过权限时还是要谨慎,如果让 cloud code 随意运行命令,出错时可能更难提前发现,甚至在发生前就拦不住。 cloud code 把多种智能体概念结合进终端,智能体循环,可管理的上下文窗口工具以及可配置的权限, 他能读取你的代码库,执行操作并验证自己的工作,这让他和聊天窗口有了本质区别。视频。
129AI 工具集 08:01查看AI文稿AI文稿
招聘一个顶级程序员 cloud code, 用七天的时间,从基础入门到熟悉精通,把它一步一步打造成你的超级员工。上一期视频呢,我们学会了 ai coding 的 工作方法, 今天你让他开发一个复杂的新功能,一开始很顺利,聊着聊着,你发现它开始降智了, 聊过的信息转头就忘了,因为上下文快满了,之前的记忆被压缩或者丢失了。今天我们就解决这个问题,管理 cloud 的 工作记忆,让它始终保持在一个高效的状态。 那视频呢?最后还有几个我私藏的上下文管理小技巧。 cloud 是 最早提出来 context 这个概念的,让 agent 从 prompt engineering 到 context engineering。 那 到底什么是上下文呢? 简单的来说,上下门就是 cloud 的 工作记忆,就像是人类的大脑,你这一天你需要记住自己今天早上吃了什么, 今天的工作计划是什么,我正在做的任务是什么?以及一些临时的文件。我刚才看了十个文件,分别是什么,以及在过去的六个小时,我都跟谁开了会,讨论了什么问题。信息量这么大,你肯定记不住所有的细节,于是你就拿了一个小本本,把这些都记下来。 但是这个本子的容量也不是无限的,他就只有十页纸。当这十页纸都用完了,你要接触新的东西的时候,怎么办呢?可能就会随机撕掉某几页,或者是把某几页压缩成一页,给你腾出空间,这就是上下纹衰退。 cloud 的 上下文窗口也是完全一样的。那上下文具体包含什么呢?主要是由四部分组成,第一部分是 cloud 点 m d 就是 系统指令,它包含你的基础站的约定,编码的风格,是 cloud 的 长期记忆, 每次对话都会加载,它是不可压缩的。如果你的 cloud 点 m d 很 长,就会非常消耗头衔,那怎么写 cloud 点 m d? 可以 看我的 day one 视频。 第二部分是对话历史,就是你跟 cloud 来回的一些讨论,聊的时间越长,上下文占用的就越多。 第三部分也是占用最多的是工具调用的记录,包含你读取的文件内容、运行的命令结果、搜索的代码片段等等,是上下文快速增长的主要原因。 比如你改 bug 期间反复多次的扫描代码,那上下文就会急速膨胀。第四部分是临时的数据,包括你正在编辑的一些文件调试的信息。 cloud 的 窗口通常是二十万头克,大概是十五万个英文单词。当这四部分加起来接近限制,就会出现上下文衰退的问题。上下文衰退会有什么影响呢?当你的上下文充足的时候, cloud 反应会非常迅速,非常准确。 当上下文快满了的时候,那他可能就要搜索半天,记忆会模糊,反应就会变慢,或者改 bug, 改半天也改不对。当上下文爆满的时候,降脂感就会非常明显,甚至会出现失忆,忘记之前聊的重要信息。 同样的问题,上下文不同,效率差别就会非常大。那重点来了,上下文的影响这么大,我们要怎么管理好它呢? cloud code 提供了很多跟上下文相关的命令,行,我们一个一个来看。第一个命令是 context, 要管理好上下文,首先你就得了解它的使用情况,运行 context 命令,你就可以看到上下文的使用情况,分类占比的比例。第二个命令呢,是 compact 压缩对话, 它适合的场景是你的上下文使用量过高,或者是工具调的结构过高。那就可以用 compact 命令对上下文进行压缩,这样既可以保留关键信息,删除了一部分不需要的细节。第三个命令是 clear 重启, 它的作用是清空所有的对话历史,从头开始。上下文呢,只保留 cloud 点 m d。 那 什么时候用这个命令呢?它比较适合的场景,一个是做任务切换,比如说你上午做用户管理,下午做支付功能,那就可以用 clear 清空清空上午的记忆。 另外一个场景是对话跑偏了,你跟他跑讨论了半天跟主线开发无关的内容,也可以使用 clear 重新开始。 第三个场景是做了一些实验性的工作,你尝试了很多的方案,这样会记忆特别混乱,那也可以使用 clear 整理思路。四个命令是 btw, 这个是二零二六年三月新增的一个功能,专门用来问一些临时性的问题,用完即走。比如说你刚才说的数据表有哪些字段,你现在用什么模型在写代码,你刚才提到的某个记住术语是啥意思, 这种快速的实时查询或者是解释型的问题,就可以使用 btw, 它的特点是不进入对话历史, 问题和答案都是临时的,看完就消失,也不占用主对话的上下文空间。主对话的上下文占用零透肯,他也没有工具的使用权限,不能读文件,不能运行命令,只能基于对话上下文进行回答, 而且可以并行使用。在 cloud 工作期间,你也可以提问,互不干扰,既节省上下文,又不打断工作流。第五个命令是 resume 恢复对话。 你昨天开发了一个新的功能,干了一半,今天想接着干怎么办呢? cloud code 会自动保存,每次对话到本地使用 resume 命令,就会出现一个近期的 对话的选择器,选择你想要恢复的对话,就可以完整的恢复上下文了。那平时的使用过程中,我们要怎么管理优化上下文呢?送上八个我自己私藏的小技巧。 第一是要定期检查,在密集开发的时候,每两个小时或者每完成一个功能,就要查询一下 contacts 的 使用情况,超过百分之七十就压缩,不要等到 cloud 反应慢了,降至了再压缩。第二个是体温要具体。 cloud 的 查询是通过政策匹配进行搜索的,模糊搜索可能要搜二十个文件,精准搜索可能搜两到三个就可以了。 引用文件多用艾特文件名,指定文件,比描述哪个哪个文件效率要高很多,尽量减少 cloud 的 猜测和搜索的开销。第三个如果有多个改动,合并成一条消息发送,不要一条一条的发, 解释型的问题,临时性的问题多用 btw 的 命令。第五是调试之后要及时清理 bug。 调试的过程中特别容易产生大量大量的代码差错和日制输出 bug 调试之后要及时的 compact, 不要把噪声留给下一个阶段。 第六是长期记忆要写入 cloud 点 md, cloud 点 md 呢?建议分层管理项目的根目录放一些全局的规范子目录放 模块级的说明, cloud 会按目录层自自动读取,力度会更准确,避免每次都加载全部的内容。 第七是可以使用 sub agent 处理探索一些方向的探索,或者不依赖主流上下文的任务,比如说代码审查,就可以交给 sub agent 进行探索,会节约主 agent 的 上下文,这个后面我们会再详细的讲。 第八是善用 checkpoint 做阶段性的总结,在完成一个比较大的功能之后,可以让 cloud 输出一段当前的状态。摘要,你已经完成了什么,遗留了什么,下一步的计划是什么。然后你把这段内容保存起来, 下一次开始对话开始的时候就可以作为第一条消息贴入,等于手动的接上了上下文,比依赖 cloud 的 自己的记忆更靠谱。 那今天我们通过主动的管理上下文,让 cloud 始终处于一个最佳的状态,你已经能非常熟练高效地使用 cloud 了。 但是真正想要发挥 cloud code 的 价值,就不得不提到 scale 和 m c p 了。那接下来就是入职第四天, scale 把专业的知识封装成可以服用的技能包。
88AI产品千媚 06:09查看AI文稿AI文稿
今天和大家去聊一下 starbucks 在 上周发布的一篇文章,关于大项目里边实际去使用 cologne 的 一个最佳实践。那这篇文章里边其实大概讲了 cologne 怎么来用,然后后边呢?其实主要去讲 harness 为什么重要? harness 工程怎么来去做? 这里面其实我认为有很多东西的话,我们之间已经讲过很多遍了,那这里面非常关键的一个点呢?我认为是有两张图的,那一张图呢,其实是关于 colaco 的 这个 harnis 的 一个 session 里边,不同的这些组件在整个 session 里边占的一个周期和量级是什么样的?那第二个呢,就是这些组件 有很多地方其实是被我们误用的,那误用的地方呢?是有哪些?那所以我认为这两张图是非常关键的,我跟大家先讲一下整个的一个流程和这篇文章的主 主要的骨干,然后我们去主要介绍这两张图非常有价值,非常有收获。其实整个文章啊去讲 cologoth 在 一个大型编码中的一个最佳时间,实际他去讲的其实是 harnes 的 一个最佳时间。这边在说为什么我们使用 cologoth 的 时候,我们再用本地的代码去剪辑啊?因为这个 public 呢,其实它是有一定的一个时间周期的, 那这个时间周期下的一个处理呢,其实会让我们误读很多文件,所以会导致代码的不实时性,所以呢他就直接去使用读代码这个 grab 的 方式去读取。 那如果我使用直接读的一个方式呢?那其实我更希望的话是他能知道我现在的代码呢,到底的结构是什么样的?那这个呢,就是我们多次去提到这个 cloud 点 md 的 一个文件,它就隐身出了一个 harness, 那 harness 它的核心的组成呢?其实是有五大部分的,那 这五大部分呢?就是一个是 cloud 点 md, 我 们知道整个的这个目录的信息和需要注意的关键点是在哪些,还有呢就是在整个 a 阵生命周期里边的 hook 我 们怎么来做?然后能做哪些功能? 还有一些呢?我们认为是一些流程性的一些东西, work flow 的 东西,我们把它变成一个 skills, 然后这些 skills 是 人来去使用也好,是给 ai harness 去用也好,这也是非常关键的一部分。 还有呢就是我们要把这些搭建好的东西进行一个组织和团队的一个传承,那就用到一个 plagis, 把它进行一个打包和一个分发。 还有呢有一些工具呢,我们需要把它进行一个结构化,暴露出来之后呢形成一个服务,那这个服务呢通过 m、 c、 p 的 一个协议呢接入进来,那除此之外呢, l、 s, p 呢,也就说我们知道整个代码里边的关键定位是怎么样的,而不是说通过整个的字母串呢,就去读这些代码的 l、 s、 p, 然后和里边的 sub agents, 这两个呢,又把上面的整个能力呢,又给它进行了一步的增强。那所以呢,这就到了我们非常关键的两个对照表了。那第一个对照表呢,我们就讲这些组件儿,它其实误用的地方是在哪儿?我认为这个其实是非常关键的,你比如说 cologold 啊,它最常 见的一些误区呢,就是我们把所有东西都放在 cologold, 那 这个不其实是不对的,我们应该把一些 skills 这些东西呢,我们应该放在相关的一个技能里边,比如说它是一个 workflow 型的一个东西,我们应该把这些东西拆出来,而不是说全都放在 colog 点 m d 中。所以对于 cloud 点 m d 的 误区呢,就是我们把 skills 的 一些东西其实也放在 cloud 里边儿,那我们 cloud 点 m d 里边儿应该保证它非常简洁。那 第二块儿呢,就是关于 hux, hux 里边儿其实最适用的其实是在固定的一个生命周期里边儿,我们触发一些事情,比如说 commit 啊,或者固定的 t d d, 固定的 review, 那 这些是比较适合于整个生命周期的一个触发的。那对于一些提示型脚本,比如说提示词的一些东西的话,其实我们不需要去放在 hux 里边儿,我们更多的话是把它放在一些 一致性的一些检查呀,然后还有一些固定化的一个,嗯,陷入到生命周期这种调用我们才使用 hux。 那 skills 呢,就是我们保证专业的东西呢,可以让它专业化的这些东西呢,我们就放在不同的这个 skills, 而不是说把它全都放在 collab 里边,这个跟我们上面说那点是一样的。 然后 plugins 呢,我们就发现啊,有很多我们自己用的已经很好的东西,但是如果你要让它去呃团队扩扩展起来去用的话,其实你最好的方式是把它进行了一个打包,然后团队呢都有相同的一个环境,那这是 plugins 的 一个应用,那很多时候我们其实是放在呃本地的一个环境里面,大家其实是无法进行复制的。 那对于 lsp 呢,其实我们最多误解呢,是以为这是 coloclo 自带的一个一个方式,其实并不是,它更多的话是基于现有的一个环境,然后我们可以通过伏尔级的东西去固定的呃,去准确的定位到相关的目录里边,所以呢,这类能力其实不是模型本身的一个能力。 那对于 mcp 的 这个 server 来讲的话,就是我们的 harnis 其实还没有搭建好的时候,其实我们就着急去建很多的 mcp servers, 其实我就见过很多企业,他们在做一个东西,就是 呃,我现在要把所有的接口都进行 m c p 化,其实这个呢,对应这一条来讲,它其实也是错误的,就没有必要把所有东西都建成 m c p, 你 需要把它的基础设施啊,然后它的约束啊,它的 hux 啊,生物周期的侵入,把这些东西先做好,然后慢慢呢,我们一步一步再结合 m c p servers 来做。对于整个 seven ages 啊, 我们最大误区呢,就是我们不见 sam 一 阵子,我们把所有的这里边的探索,呃目录啊,探索项目啊,然后呢,包括改 bug 呀,包括主流程的一些设计思考和编码工作,我们都放在一个对话中了,那这个其实是错误的,其实更多的时候,比如说我们再探寻一个项目也好,我们再写一个测试用力也好, 那这个过程呢,我们需要给 subordinates, 让主 agent 呢有更干净的一个上下文,那这个呢,是非常重要的一个点,那这些点呢,其实就促进了我们可以把整个的 harness 做好,那所以为什么我认为这张表呢,其实是非常关键的。 除此之外呢,这还有一张它整个的一个 harness 的 一个 session time, 它们所占的时间,我为什么觉得这张表是非常关键呢?其实你会发现啊,这里边占的时间越多的地方呢,其实是我们更多应该花时间去做的一个地方,就它收获会比较大。呃,比如说我们会把 cloud 点 m d 这个文件呢,它在整个绘画中它占的这个比中是非常大的, 我们就把这个文件需要给它好好去设计一下。其实所以你会发现之前我在讲很多关于 cloud 三层设计也好啊,其他设计方式也好, cloud 点 md 这个文件其实我们经过了很长时间打磨和探索,然后除此之外呢,有一些固定化的东西,可以沉淀化的东西呢, 我们要嵌入到生命周期中,所以你会发现 hux 也是非常重要的。我们比如说,呃,沉淀的一些复利工程也好啊,然后去做 ttd 也好啊,然后去做 review, 自动化的一些 review 也好,我们把 hux 做好。那其实你哈尼斯这两部分其实你已经完成很多了嘛? 还有一部分呢,就是关于我们要把上眼纹做的比较干净的情况下,我们把问题解决。所以呢,你如果可能情况下,你多做一些 sub agency, 因为它也是在整个 section time 里边占了很多的周期的。那剩下其实就比较符合我们的直觉了,就是我们 lsp, 我 们开了之后呢,然后固定了 workflow 呢,我们就变成 skills, 然 然后有一些需要提供服务,需要让模型去掉,我们就变成 m, c, p, 然后最后呢把这些所有做好的东西呢,进行一个打包分发和共享,让团队呢都可以基于这一套 harnis 去做,有效的去做开发。所以这两张图呢,我觉得是非常重要的,那这些内容呢?分享给大家,希望呢?对大家都有收获,关注雷哥,关注 ai 工程化落地。
605雷哥AI 00:36查看AI文稿AI文稿
你知道 cloud code 还能这样玩吗?最近有个大神开源了一个叫做 everything cloud code 的 项目,直接把 cloud code 武装成了一个专业工程团队,内置了四十多个 a g 的 专家,有 a g 的 架构师、安全专家,代码审查员,全部给你安排的明明白白, 平时怎么用呢?超简单,想规划项目直接输入命令。想审查代码,直接输入命令。想单元测试,直接输入命令!不用再费劲写一大堆复杂的提示词,一条斜杠命令直接启动。最牛的一点是什么呢?彻底解决了 ai 的 鲸鱼记忆 毛病不断,新开对话还是重启项目, ai 都能牢牢记住全程上下文,再也不用反反复复,这个神器值得折腾!
118老码AI驿站 01:07查看AI文稿AI文稿
分享一个 kol 的 小技巧,在你这个 kol 的 code 里面,使用第三方模型的时候,比如说 deepink 四 v 四 pro, 它明明是有一千个 k 的 上下文,但实际上这里它只会写成两百,为什么?因为 你的这些第三方模型的 kol 它不认识,它并不知道你的上下文是多大,所以它默认都是给两百,直接切成两百,这样的话你问一个问题就能耗掉接近五十,你这个一个对话 基本上四五个问题,他就要被墙压住了,那肯定是很不爽的,那怎么办?有个小技巧,其实就是你要选择模型的时候, 你要跟他讲你的上下文长度是多少,那怎么讲呢?他是这么约定的,你后面跟个中括号就这样子, 如果你是要改成三百 k, 你 就改成这样子,如果你要一千个 k, 你 就直接写成一个 m 就 行,这样子他就会被识别的一千个 k 就是 一个 m 的 上下文, 这样的话,你记在这个里面,可以完整的问他几十次问题,五十次问题,他才会触发上下往下缩,这样的话你的这个使用的会很舒服。对,就这么一个小技巧,一分钟教给大家。
432教你宇宙级AI编程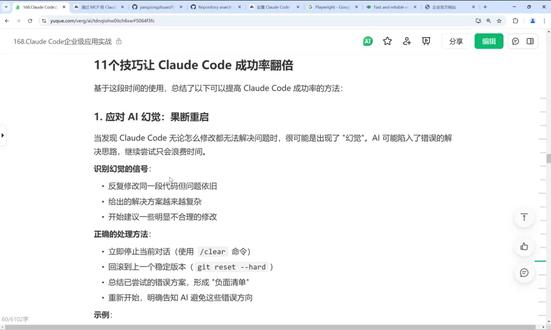 13:46查看AI文稿AI文稿
给他分享十一个技巧,让 cloud code 的 成功率翻倍。首先是应对 ai 幻觉啊,就是我们遇到一些幻觉问题的时候,可能是 ai 啊,陷入了一些错误的一些解决思路啊,就像我们刚刚那个,它一直报错,一直连接不上, 那可能不是网络的问题了,可能是你本身这个对同一个问题给出解决方案越来越复杂了,跑不下去了,或者说一些头肯管管理啊, 超过了上下文的一些限制了,所以他永远永远是报错的啊,那这个你再怎么弄下去的话,也是浪费时间,那你就得果断去做一下可令把大家绘画清理一下,重新来跑啊,这样效率还快一些。然后第二块的话就是版本控制啊,是生命线。 这个时候啊,是我们做好版本控制的话,其实是一个良好,可以具备一个良好的一个习惯啊。然后 比如最佳实践,我们希望每一次提交都是一个完成一个小功能去提交啊,就我之前一直强调的,不要让 ai 一 次性做太多事情,完成一个小任务的话就提交,去做一个推送,那确保每一次迭代功能完整性啊,就是尽量不要提交太多内容,不要生成太多内容 有意义的提交信息啊,就是描述让 ai 去写清楚这个到底做什么改动,有没有什么问题,然后以及它的一个分支策略是怎么样的,为每个新功能创建一个独立分支, 为重要的版本去打标签。然后我们推荐的一个工作流是这样的,那这套工作流的话,大家可以去把它整合到 啊, cloud code 它的一个就是那个命令里面去,或者是整理到 cloud 的 整个 md 文件里面去,把规范给它列好。那以后这个 git code 跟 githop 那 个插件协助的时候,就按这套工作流给你来做一个处理,把我们规范两个都定下来。这样的话,按照这么一个标准的工作流去做的话,整体我们啊出问题的概率就会小一些。然后可以试一下啊, 帮我打开这个页面,看一下这个效果啊。 然后计划模式的话,就是,呃,大家比如说你只想做计划,不想生成代码的,你就可以切换到这个模式,用这个艾特加 m, 大家看左下角这里面啊, 这个模式就是计划模式啊,艾特加 m 快 捷键切换到这个模式啊,拍,哎,是一个百叶窗的效果吧,但这个百叶窗效果是做出来了。 嗯,这个就是整个协助的一个过程。这个 plan 模式主要是用什么呢?它主要是用来去生成一些计划啊,就是我们切换到这个模式的话,首先,哎, 你可以说一个需求重构用户模块,提升查询效率啊,比如说我们就把这个提示加上,让他在这个洛伊这个模块下面重构用户管理模块,提升查询效率和查询性能。那但是我们前提啊,大家看啊, 你要退出去啊,这里我们先切换到计划模式啊,切换到计划模式再来跑这个, 那 ai 就 会输出类似的计划。首先它会去分析分析现有的一些情况,你看分析现有用户管理模块的一些结构啊, 识别出查询性能、评级点有哪些设计数据库锁影优化、方案优化、 mybidis 查询逻辑添加缓存机制重构、 service 层业务逻辑 优化、 control 层响应、性能测试响应啊,就是这个里面的话,就是我们他是按照一个做计划的方式给你,把计划给你输入出来。 关键点的话就是我们要仔细去审查一个计划,确保方向的一个准确性。因为 ai 给你的一个计划的话,可能会有一些误差啊,跟你实际想做的一个内容的话可能会有一些偏差, 我们需要确保方向的一个正确,然后可以要求 ai 调整或者是细化某一些步骤。 第四块的话就是大家在开始编码前,先让 ai 编辑详细的产品规格说明书,好的文档的话是成功的一半。 那这个产品规格说明书里面可以包含什么内容?第一块的话是这个功能规格啊,就详细的功能描述,加上用户故事和使用场景,再加上输入输出定义、边界条件处理等等。技术规格的话,比如说技术架构、 数据模型、 api 接口规范、性能指标等等啊,实施细节就是开发步骤分解、测试策略、部署方案、规范计划等等。 那下面就是一个我们去做需求文档啊,做一个定义的这么一个处理啊, 这个就是我们在开发的时候一定要把这个需求文档写清楚,那 ai 编码的时候参考我们这个需求文档去做啊,这样的话它出来的效果的话就会好一些,比较匹配我们的一个要求。 那大家可以单独的在这个下面建一个 word 文这个文档啊,先建一个文件夹,叫 docs fox, fox 下面建一个这个文档啊, requirements 点 md 文档, 然后把这个文档新的内容啊加进去, 然后让 ai 帮你去 参考这个文档,帮你去做一个需求开发啊。 嗯,刚刚那个优化是做什么优化来着?用户管理模块的优化啊,这里我们让它自动去优化吧。 好,然后这个计划就这里就很简单啊,就是你让 ai 参考你这个 docs 下面的一些需求文档,帮你去做一个开发啊。然后第五块的话是建立这个项目的一个记忆的规则, 那这个的话就是我们要充分利用 cloud code 的 一个本地配置文件啊,那个配置文件我之前也讲过很多次,就是这个你写的越好的话,其实让 ai 去阅读我们的需求啊,比如说你把代码规范 呃, get 规范开发规范个人编号写好的话,整个它生成代码的呃风格就会比较偏向于那个。所以我们现在在这个下面可以建一个文档啊,建一个文档叫 cloud cloud, 点 md, md 文件啊, md 文件这里我们把这个拷进去啊, 就他会按照你这个项目的方式去规范的方式去开发啊,然后全程啊,我们可以使用中文交流跟文档啊,同样的也是修改 cloud md 文件, 把这个啊所有的语言规范啊,比如说这里复制一下,把这个语言规范也要求一下,所有的对话跟文档都使用中文注式,也使用中文错误提示也使用中文 文档,使用中文 markdown 形式,就是把这个语言给改一下,然后以及命令行形式。好处的话就是可以降低理解成本,避免语言输,切换它的一个认知负担,更准确的去表达需求,方便团队的一个协助。 然后就是我们啊,我比较喜欢用的一个叫免授权模式啊,这个就是可以提高工作流畅度, 当我们的一个代码仓库已经有 get 管理的时候,且没有敏感内容的时候,大家可以使用这个 bypass 啊,也就这个优乐模式去提升我们的一个效率啊,就不需要授权了, 那并且是异步任务执行的更流畅的工作体验,接近于完全自动化。但是风险的话,就是 cloud 可能会在 啊你未预期的文件里面去做修改,也就是少了一个人为的检查的话,他可能会把你的代码改出问题出来啊,会有这个风险,点赞 可能会执行一些系统命令啊。建议的话只在个人中项目里面去使用,重要的项目的话一定要做好备份啊,就是改了之后没关系啊,就大家一定要去做一个什么呢?做一个 check 啊,就你认为做一个审查,如果他改的有问题的话,你就给他要还原一下,改到没问题你再推上去 啊。所以说这个模式大家一定要分情况去用啊,不是所有场景都能用,要用到啊,我们在改一些比较重要的内容的时候, 我一般建议还是用手动模式会比较好一些啊,因为出了问题至少有一个确认过程,你能够及时发现,如果全自动的话,万一啊你要是没去 check 有 遗漏的话,这提交上去的话,很有可能就是一个 bug 啊,这一定要注意。 然后我们要确保有完善的 get 的 一个备份,就大家即使改坏了也没关系,我们要能备份还原啊,定期的去检查 cloud 的 一个操作日期,发现异常的话立即终止, 所以这一点非常关键啊。然后第八点的话,我们要去多用可令及时清理上下文,保证上下文的一个窗口的清洁是提高效率的一个关键点。 清理时机的话,就是完成一个独立任务之后,切换到不不相关的一个新任务,发现 ai 开始毁消概念啊,就是我们一旦发现 ai 开始啊,有点胡说八道了,有点偏离方向了,你就赶紧要清理一下绘画了,说明它已经话题已经聊偏了, 那清理策略的话就是好处,可以提高 ai 的 响应速度,减少无关信息的一个干扰,避免上下文的一个溢出,保持对话的一个专注度。 好,然后第九块我们可以加入一些审核的工作流啊,就是我们要去建立高效的 ai 辅助代码审查流程,确保代码的一个质量。 三层审查模型,第一层功能验证大概要花百分之三十的时间,运行代码,测试功能是否正常,检查是否满足需求,验证边界的一些条件。 然后第二层的话是 ai 自审,大概要花百分之二十的时间, ai 通常能发现一些性能优化的机会,代码重复的一些问题,潜在的一些 bug, 不 符合规范的一些地方。 第三层人工审核要占到百分之五十的时间,这个我们要重点关注业务逻辑正确性、安全性的一些问题,包括代码可维护性、架构合理性, 以及一些审查清单与说功能是否完整,有没有性能问题,错误处理是否完善,有没有安全漏洞,代码是否易于理解?是否符合项目规范 啊?然后第十点我们要去合理设定 ai 的 一个参与度,不要期望 ai 生成百分百的完美的代码,合理的期望能够带来更好的体验。那 ai 擅长领域是有很多,但是不擅长领域的话也有很多啊, 那他擅长就是样板代码生成, cud 实现,常见设计模式,应用测试,用力生成 文档编辑,代码重构。那需要人为介入的领域就是复杂的业务逻辑,角色, ui 的 设计啊,一些细节的像素级的调整,特定的性能优化,架构级别的设计决策由外部系统的一个特殊集成, 这个就是架构师的这个工作的话,他还蛮没有完全替代,因为他对你业务的一个理解肯定没有你那么深,他只是对一些通用的技能这一块可能掌握的比较深而已。 最佳的一个写作模式,让 ai 完成技术框架啊,实现用户管理的一个 cud 接口,人工调整业务逻辑, ai 完成测试,修改了代码,添加单元测试啊, 就有一些让 ai 来做,有些人为来做,然后让 ai 最终来做一些测试啊,这样就是 一个比较好的一个写作模式,然后效率最大化,就是我们首先要考虑到啊, 一个及时止损,不要在细节上死磕,发挥各自的一个优势啊,就是 ai 跟我们啊,这个时期的开发人员,他们都是有各自的一个优势的, 就是它是可以互补的,可以保持灵活的一个协助的。然后最后一点是要了有良好的架构跟命名的重要性,清晰的一个代码结构的话和命名规范可以显著提高 ai 的 一个理解能力以及代码的一个生成质量。 那么命名规范这一块的话,就是我们在一个实际项目中,我们发现前端部分仅用了十分钟就完成全部功能,这后端就耗费了两个小时。 深入分析的话,发现是后台某些地方概念比较模糊,不同的功能使用了相同的命名,导致 ai 产生理解方面的一些偏差啊,这个是就是一些细节地方啊,我们需要完。
54热点个人看法 02:50查看AI文稿AI文稿
今天我用 curl code 帮我做一个中等以上需求的一个需求说明书,考虑到 curl 的 像大模型都是一个注意力机制的这么一个大模型,那我可能我的第一步就是在 tst 里边先把整个需求的背景,包括需求的功能点,包括让它呃要设计的一个注意注意要点,然后包括我对这个需求的整体的一个理解,把它呃列举成一二三。然后我在 tst 文档里边 梳理一下整个需求,然后就让 clark called 帮我做做一个详细的设设计说明书,然后他做完做完出来之后,他给我设计的相关的表结构,然后接口说明文档,包括还有时序图,包括还有那个注意事项,甚至还有一些测试的案例。 那设计完了之后,我就会对整个文档做了一个呃快速的呃浏览之后发现它里边其实还有一些设计的点比比较粗,比如说有一些定时任务,它可能是就默认了就每五分钟执行一次,但是它和实际的那个 呃时间是有冲突的。比如说我定时计划是一个随机的九点十三分来执行一个任务,如果他每五分钟来执行一次的话,他在极端情况之下,他可能会在九点十七分才会执行到我九点十三分的一个任务,那在这种情况之下就会造成那个任务的延时, 所以我就让他,我说,我就让他呃做任务的一个前置,然后再呃单独再做一个派发的任务,那就显显著的降低了这个任务的 呃时效性。然后在关于这个 clock code 帮我设计的需求说明书,他也是不断地在从事啊,不断地在迭代,然后最终把这个设设计说明书呃给出出来 啊,最终呢,有一点就是因为它设计说说明书里边本来我已经配置了很多的呃本,本来我已经配置了基本的 clock code 点 m d, 包括 enigma 点 m d。 在 这个不断的对话的过程中,因为这个需求的文档在不断的迭代,也触发了它好几次的那个压缩机制。 所以我觉得就是有一个技巧,就是当你把那个设计说明书如果说多次绘画呃到一定程度的时候,可以执行一下杠 clear 来,嗯,把那个上下文给清空一下,然后再基于它现在生成的那个文档来继续来生对文档进行处理,这样可能 呃让这个自然理更聪明,不会让它产生幻觉。呃,我从这个计划说明书的这个实践过程中,我觉得 clockcode 呃做设计说明,然后再让 呃,比如说 ctrl 或者是去来编编辑代码会更加的呃快速和有效。你们觉得呢?欢迎评论留言。
54飞向蓝天的8鸟 00:57查看AI文稿AI文稿
你以为 cloud 扣的没有对手?一个国产开源的 ai 编程工具来叫板了?百万上下文大项目,整个塞进去,一次跑完,一周内暴涨二点五万 star。 他 只做一件事,替你写代码,改报错,跑测试管版本,说一句话,回车开始读文件翻报错,定位问题动手改, 改完自跑,测试没过,接着修报错,直接喂给下一轮,形成闭环任务复杂,拆成十个子任务同时跑,各自独立完成了汇总回来,中途关掉。没事,下次打开,从上次停的地方接着干,改坏了也没关系,每一步都打了,快照 一个命令回到改之前 get 历史,一行不动,推理过程时时流出来,看得见它怎么拆,问题怎么做,决定不用选模型,自己判断,简单问题省钱。跑复杂任务,全力上支持连接外部工具,支持自定义技能包,支持本地部署。你的工作流怎么设计它就怎么跑。
3541开源项目盘点
