什么mcp或者skill可以优化前端
hello, 欢迎大家来到用翠开发微信小程序第七期,上一期呢,我们用一个 ui scale 加一个 ui designer 的 智能体,完成了我们前端初步的交互和视觉, 但实际的结果非常的丑啊。同时呢,上期我们也用 a、 d、 b 尝试结合微信的帧机调试,想让 ai 完成一些自动化的调试和优化,最后在我的尝试下放弃了。主要的两个原因是,第一个,微信小程序甄姬调试,每次都要打包上传,然后扫码才可以, 这样的话,我们的自动化还是要由人工去介入,而且效率很慢。第二个呢,是因为小程序是运行在微信的 app 里的,所以我们的 idb 不 能像原生的安卓程序一样拿到它的页面和布局信息,只能通过大模型的 ocr 识别去读取, 这样的话既浪费时间,效率又低,而且容易出错,烦死了。因此呢,我们这期的内容呢,主要还是回归到我们的主线,就是前后端连条。当然在这开始之前,我也会介绍如何使用 pencil 的 mcp 在 在 tree 里面完成我们现有的交互界面的视觉优化,然后分享 tree 前后端联调的一些实战心得,尤其是当 ai 反复卡壳的时候,如何高效的排查并指导它解决问题。 ok, 那 我们现在就开始吧, 上期我们的界面太丑了,然后我最终使用 pencil 重新设计的一个发票助手的交互。先给大家看一下, 这里呢,我们可以用微信一键登录,然后这我已经接了很多后端的接口,所以说这都不是加数据了,那我是怎么把我的账户变成这样子的 呢?首先呢,我们在群里面切换到这个 id 模式,然后这里有一个扩展,在这里搜 pencil, 然后看到这里有两个我们可以装这个,这是一个插件,安装完毕以后呢,它就是这个样子的,这里我的这个插件正好更新了,那我们就重新装一下,然后它这里要求我输一个 token 去使用, 但实际上我去查了下官网,现在还没有这个东西,它现在是免费的,所以我们就按 esc 取消就可以了。然后安装完怎么用它呢?我们 可以在 id 用,也可以切换到 solo 模式,在 solo 模式里我们要先去配置它的 mcp 服务,这里我已经配置好了,然后给大家看一下整个配置的方式,我们要把这个 mcp 服务找到,然后放上去, 这个配置我会分享在评论区里,然后这个 mcp 服务配置好以后,我们就可以开始使用它去帮我们完成设计了。 nice, 这里可以看到我给他的任务是调用 pencil server 服务,要求他先仔细阅读我们之前 p r d 文档中关于发票管理小程序的交互设计规范,这是一个相对来说比较详细的一个要求,然后我们就让他去开始工作, 这个过程比较久啊,我大概等了可能有半个多小时,然后他基本上把我们要的页面都已经生成好了,但是有一些重叠是因为前面一些失败的, 最终呢,我是整理了一下,然后他给我的设计文档最终是这个样子的。牛逼,因为上次我们已经有了小程序的界面,所以这次我们应用设计稿是希望他能跟代码比较,然后把这个新的设计应用到我们的小程序上, 所以我们给他的指令是让他和现在的代码去做比较,把新的设计稿应用在上面。去,这里呢也不是一次成功,因为我们现在是微信小程序,他不是一个标准的 web 小 程序,所以有一些布局和样式的出入。 因此呢,我们也是做了很多轮的对话,才把整个设计稿初步的应用到了我们的小程序中。 那接下来呢,我们就进入到今天的前后端连条,这里的调试过程呢非常的繁琐,我使用的步骤是一个模块一个模块去调 试,然后我会集中展示我们的登录和用户信息,获取相关的模块的连条。在这个过程中呢,我遇到了前端 ai 和后端 ai 互相扯皮的现象,都说应该是对方要去排查, 但实际上问题到底是什么?我们通过自然语言的描述,或者说直接去让 ai 修改,已经没有办法去解决这个问题,因此需要我们进入项目,然后去排查,或者说给予 ai 更多的思路去排查这个问题。好, 这里呢,我先让他整理一版微信小程序的 sdk, 这样的话方便我们用微信小程序去接入 a few moments later。 好 的,这里呢,他已经把 sdk 创建好了,我们可以看一下,只需要去 将这个 readme 和 sdk 里面的这个慢点 gs 压缩版呢,复制到我们的微信小程序即可, 这个 readme 也传给我们的 ai 就 可以了。我们就要告诉我们的前端, 因为我们的前后端状态可能不是很一样,特别是我们看到前端实际上有很多界面,有可能后端没有接口,所以这里呢就要求它适配的过程中, 要将前端的需求,要将 sdk 未满足 需求的接口整理出来,生成一个 markdown 文档, 方便后端进行评估和开发。这样一来呢,我们先进行第一轮适配,然后在适配过程中呢,会去检测我们的 s, d、 k 是 否满足我们前端的需求,如果不满足的话,那我们就让 ai 生成一个 markdown 的 文档, 将这些不满足的需求全部整理出来,这样的话我们可以拿着这个文档再交给后端去评估,然后进行二次开发。好,现在开始工作了。 later, 我 看他们回到正题,我刚才看到他已经把 sdk 的 适配做了一遍啊,但是呢,缺失了这么多。我们先不管,我们先调登录 在这里的连调呢,实际上我们不能完全大规模的交给,这样容易出错。这里我常用的方式就是一个接口一个接口的去调,或说一个模块一个模块去调,比如说现在我们要去调登录,我们先来重新编一下,看一下现在小程序是一个什么情况, 这里我看到还是用了很多 mac 数据啊,所以这里我们要求呢前端清除所有假数据的调用。 那这一步呢,主要是把原来 g s 和布局里面所有塞的我们的假数据全部清理掉,让它去调用我们真实的接口。如果我们真实接口没有提供呢,就让它去调用我们提供的备选接口,备在备选接口里面返回假数。 这样的话,我们可以统一将所有业务逻辑的调用都归纳到 api 点 g s 和我们自己的 s、 d、 k 里面,然后后后续呢?方便我们去调试排查,这里先让他去干吧。 ok, 我 还没干完呢, later, ok, 现在他第一轮呢,这个 s d k 是 配按照我们的要求是改完了啊,我们先来看一下整个这里有很多错误,我们先全部甩给他,让他去 修复一下。然后与此同时呢,我也看了一下我们前端整理的后端缺失的清单,这里其实都挺全的,但是有一些我认为是不需要的, 比如说这个发票的收藏,因为我们是希望把所有的发票包括发票的管理全部放在本地来做,这样的话我们服务器不会占用太多的存储,这个我们到后面再去做调整。现在先让他去修这个 bug, 刚才看到这个 bug 实际上有一个是 sdk 的 问题,但是 前端又去修复了,所以我们得把这个问题发给后端。 嗯,在后端去修改这个的时候呢,因为前端刚才已经改了,我们先接着调,我们先看下微信小程序报了什么错。首先第一个就是不让你去请求不在合法的域名列表中,这里面有两个问题,第一个是我 的小程序这里要勾选这个不叫验合法域名,这样的话我们才可以在本地做调试。然后第二个是这个幺 server 点 com, 我 们需要改成我们现在虚拟机的 ip 地址,我们自己直接改吧。保存一下以后呢,这里它先出了一个 这个啊, ok, 刚才是我们这里少写了端口,现在的话 on override 的 就就算是正常了,因为四零幺是一个正确的一个返回, 那我们直接把这个甩给 ai, 让它去处理,因为在我的经验里面,就是因为小程序还没有走整个登录和认证的流程, 就直接去调用这个发票列表的请求肯定是不对的。但如果大家是小白或说没有相关的这个 认知的话,那就可以直接把它丢给 ai, 让 ai 去处理。那我们这里偷个懒,直接让 ai 去处理。这里可以去看一下代码,代码里面微信小程序实际上启动运行的第一个是在我们这里是这个,然后它首先去触发了这个 s d k 传入了请求的这个 a p i 地址以及超时的时间。然后这里它实际上是调用了 s d k 的 get token 去获取 token, 如果 token 获取成功了,去检查这个 登录状态是否有效,否则的话应该我们应该是要去登录的,但是这里就没有去写,所以这个 logging 这个 和 logout 没有被调用。然后我们看一下 ai 是 怎么处理这个事情,这里就是他已经观察到了是一个四零幺的未授权错误,然后发现了我们缺少登录页面,后端需要身份验证,创建一个简单的登录页面。 这里呢我们看一下他创建登录页面在视觉上是不是和我们整个 app 是 相符的,如果不相符的话,那我们还有进一步的要求,要让他创建的是相符的,你看他说要一个微信图标,我们先去给他找一个微信图标。 我们认为在这个 web coding, 实际上我觉得大家如果想去学的话,那就要紧盯这个 ai 的 整个思考过程和它在做什么。因为现在如果有 ai 的 话,我们整个学习的方式可能要做一些改变,现在我们先来看一下啊,它没有登录的话,我们就 登录一下,我先把这个图标告诉他,让他先把图标切换一下,我们来测试一下微信一键登录,这里显示登录成功,其实这里我们要去确认一下后端的日制是不是正常的。登录成功了,我们可以看一下这里有没有日制是 出的。 new user create 三月十二日十七点三十四,这里看到是成功的啊,那说明我们这个 a p i 是 没有问题的,那说明我们之前的整个测试是有效的,因为接下来我们调用这里是看不到的,正常我们调试是要加一些日期的,所以在这里我会要求他, 要不然的话我们实际上他不报错的话,不知道他到底运行了什么,所以让他先去加一下。 这里我们需要去改一下这个后端接口需求文档,对于发票的收藏,还有发票筛选这些呢,我们需要把它放在本地来去做这些我们是不要的。这里呢等会我也让 ai 来去改,这里我们可以再加一个任务,然后告诉他 这里呢,我们回到刚才那个任务啊,前段还是在疯狂的去改这个 sdk, 那 这个我们一定要在项目里面做一些限制,要不然的话是非常的不合理的,我们 在这里加一个,我让他这样啊,一定要把他限制住。 tomorrow, ok, 登录成功以后呢,我们先来调这个,我们先来调这个界面啊,这里看到这些都还是有问题的,我们先把这个报错先解决一下, 你们也不要让这个直接把这个文档丢给我们的后端 ai, 然后告诉他,让他按照之前前端给的后端接口确实文档来开发新的接口。 ok, 这边他修复好以后,我们再编一下, 然后点到设置这里的用户,一二三四五六。嗯,我们看一下这边返回的结果啊,这个 nick name 是 no, 所以 我们可以在这里去测试一下改昵称行不行? 这里我刚才尝试修改昵称是 ok 的, 然后现在测试一下上传头像,我们随便找一个这里上传图片是有问题的,然后再把它甩给 ai。 接下来呢就是对一个功能一个功能的测试,现在大概就是这样的一个过程啊,那在这个过程中呢,我们也可以把这些错误呢认真的去看一下,然后看下 ai 是 怎么去分析,然后 怎么去解决的,这样的话也有助于我们去学习,比如说学习微信小程序,或者说去学习 java script 这些语言。 这里可以看到实际上我们要调用这个上传头像的接口,但是我们的 a p i 里面没有,所以造成了刚才的错误。他的修复呢是用一个临时方案,用模拟实现,这个是不符合我们预期的。那现在呢,我们就要去看一下我们后端的适配是不是完成了,因为我们 刚才有一个,我们刚才有一个后端接口需求,文档里面已经标记了我们需要上传头像,修改密码和推 去登录这三个接口。那刚才呢,我已经让我们的后端 ai 拿着这个文档开始开发了,那现在我们就是等它全部开发完,然后做一轮简单的测试,再更新给前端, 然后接着去调试 later, 这里呢,后端已经按照我们这个发票助手后端接口需求文档做了一波更新,然后也做了一波自测。现在呢,我们就让前端再重新 进行适配。这里因为我们在做用户和登录这块的调试,所以要求他,特别是这块的要关注一下 later。 ok, 现在他适配完了啊,我们先看一下。这里呢,我们每次都重新编一下,这里可以看到这样用这个出了一个 internal server error 的 这个, 这个是需要后端去解决的,然后把这个错误发给后端。 好,我们来试一下啊。 ok, 这里看他已经改好了,我们先不管他,看这里这个地方没有去主动拿用户的信息啊,这拿了,但是他的显示是有问题的,看到这里我已经将昵称改成了 苦苦菜,所以我们要他来修改这个页面。这里呢,我建议大家一定要把这个页面的名字告诉 ai, 所以这里的提示词呢,我们要写的尽量详细一点,比如说并没有按照 get all the default 接口返回,当然是假数据, 这样的话他就知道是这个页面里面,包括就是之前都用的这个接口的数据并没有正确的展示,那我们给到这些信息尽可能多的话, ai 分 析起来会快一点。 我们看到它的处理实际上是修改了这个 settings user info 中 log settings 的 方法,然后继续去掉 sdk 里面的接口去获取用户信息,这样虽然能解决问题啊,但是我们发现在日制里面 之前已经调用过,说明这个信息是被拿过的,但是他为了在这里显示他会又掉一次,那这样的话,有一个问题,就是我们其实在展示这个业务的时候,请求了两次同样的接口,这个是不合理的,所以我们继续跟他对话,然后我们就告诉他 这个用户的数据呢,应该是在小程序验证 token 之后呢,立即获取,并且是一个全局变量在全局保存的,这样的话就不需要每次使用的时候再去调用接口请求我们的服务器, 同时需要他注意,就是我们修改了用户的昵称或者头像的时候呢,本地的这个全局数据也是要去更新的。所以这也能看出来,我们用 ai 去编程,并不是说跟他讲完以后就不管了,去等结果,而是要去看他是怎么做的, 他的做法是否符合我们的预期,这个非常的重要啊,厉害。 ok, 他 已经按照我的要求做了重构,嗯,这样看上去就优雅一点啊。然后我们来验证一下, 这个名字还是张三是不对的,但是这个交给爱去做,我感觉有点,怎么说呢?有点没有必要啊, 所以我们直接在这里看一下,这个是兜底的优乐音否,然后我们在这里可以看到 user info 的 nickname, 如果是空的话,它就会用张三,所以我们得去查一下这个 user info 的 nickname。 我 这里有一个 load user info, 然后从这儿获取后呢, 它的 user info 的 name 又变成了 nickname, 这个是有点问题的啊,没有对上,这正常,我们希望它能对上吧,我们都用 nickname, 然后再改成 nickname, 刚才这里也改成 nickname, 让我们找一下所有的是不是都改了, 编辑一下, ok, 这个我们自己手动解决一下这个 bug, 然后油箱管理这里也有问题啊,这个应该是空的,但是它有一个 user s qq dot com, 这个是,这个是在 item 的 email 里面,看一下这个 item 是 email list, 去搜这个 email list, 因为我们现在是在 sentence 里面是没有这个 email list, 他只有在叉秒里面去用了,但是我们的 gs 里面是没有去用,那这个说明缺失的太多了啊,我们直接告诉 ai 去修复这个问题, 烦死了,我们看到他改了以后,这里还是有一个 user qq 的 这么一个邮箱,我们看一下是怎么改的。为什么还有这个问题?看一下这个 email account 是 怎么用的啊?这里面是两两个 email, 看,我们把这个, 把这个 account 打印出来看一下啊,让它再调用一下,看一下这个是空的,所以这个 email account 是 空的,这个应该是零,但是我们的这里呢?叉 ml 这里并没有用到 email account。 邮箱管理这里有个邦的 email, 他 是用的这个东西,这没有对上啊。 no no, no no, 所以 我们要给 ai, 嗯,我们现在要他以 gs 为准, 可以看到很多时候我们没有办法去很快的修复这些问题,就是因为这个 ai 有 时候确实对我们上下文理解不是很透彻啊,然后它确实去在 g s 里面修复了功能,但是 ui 是 没有修复的。看现在这里 已绑定零的邮箱, ok, 现在这个是对了,先不管他,我们继续看一下这个这个用户界面,用户界面现在更换头像这个功能,我们再测试一下,随便选一张可以,他这里不支持的文件里仅支持 g p g 拼机,但是我这个是拼机的,让他修复一下, 我们让后端整理一下整个服务的日制输出,然后创建一个日制输出等级的管理方式,方便我们前后端连调的时候 bug。 现在我们先回到前端的任务,我们看它判断是 sdk 的 文件类型判断有问题,然后它现在确实按照规则它不会去更改我们的 sdk 了。 现在它的解法是把前端调用的微信 pos 一 麦换成微信 pos 一 点,我们现在来先测试一下,必须用这个还是一样的啊,还是不能上传头像,换一个看一下 也不行,那我们找一个洁癖肌的也不行,所以说这个是有问题的,那我们就只能等后端把日历整理完以后再去弄。这里我们看到这个 uplog, 这里并没有打印它的 message 是 什么东西, 这个可能是有问题的,所以这个还是要后端去检查。 s d k later, 然后这里他已经把这个做好了,我们看一下吧, 服务也已经重启了,之前后端还有一个上传头像的问题,我们还是要后端去修改的。这里我已经让前端把邮箱授权的功能调试的差不多了,把它复制过来,然后告诉后端,让他去排查一下这个问题。 later, 他 已经修改了哈,然后我看一下他修改的是 是后端的无法识别的,这测速已经用 cpu 来判断我们两个是不在我们家扩散。这个前端是调 sdk 的, 所以它要更新 sdk, 所以 这里我们要它更新一下 sdk, 然后重启服务生效。 later, 现在我们再把这个 redmi 给它更新一下,然后告诉前端,让它继续去修这个头像的 bug。 现在好像有点问题了,很多都打不开了, 这个还是有问题。知道,所以我们一换新的对话,他把很多东西都忘了,之前出现的问题他又出现,所以我推荐大家用翠的话,还是建议大家能在这里去压缩上下文。就压缩上下文,如果是新建任务的话,一定是 要做一些跟原来关联性不大的东西,要不然的话他很容易忘记他这一忘我们就要再重新再搞弄过来试一下吧。 ok, 我 们现在来他已经编辑成功了,我们再重新再编 一下,然后来去检测一下这个更换头像的这个功能。还是不支持啊?还是不支持呢?还是在 s d k 里面 告诉他问题?依旧让他去看服务器的日制排查问题,因为我们刚才不是做了一个日制系统,现在这个日制就记录的比较完善,我们看到他们两边是都想通过自己去解决问题,这个实际上是不对的啊,后端应该对前端 出一些要求啊。嗯,我们再试一下吧,然后如果不行的话就告诉他,这还是不行哦。但现在这个问题又变了,又变成一个调用,这个应该是一个自创分割的, 我们应该让后端给前端提些需求,而不是让后端一直去适配前端。这里 我想去看到前端到底传了个什么玩意。这个 sdk 和这个日制看的不是很清楚啊,等下再 看一下他这个修改。我只能说后端不报错而已,但是能不能成功报说仍然是不支持的文件类型。那现在有一个问题就是我们看不到他到底是怎么请求的,所以我需要这个, 我需要他在 sdk 中加入明显的 api 调用时请求和响应的具体数据, 要不然的话我们不知道他发了什么,就没有办法去指导 ai 去做。现在就是变成了两边在磨洋工 可以尝试把这个把这个错误再丢给前端呢,前端又说是后端的问题,然后后端说前端的没有传递,就变成两两边扯皮了,我们就改不好这个问题了。这里我让他把所有的 ipi 的 雕像都加一下吧,要不然的话我没有办法知道我们到底请求了个什么东西。 ok, 我 刚才让他把这个 sdk 里面所有调用 api 的 日期呢,给我整理了一遍啊,我们现在更新一下,然后让前端呢给我好好的把这个 bug 的 字输出出来,要不然的话他们就会一直扯皮啊,两边一直扯皮就就改不好代码。这里他提示我达到五十轮新建任务效果更好,我就不建啊,我就压缩一下。更新了以后呢,我们先重新编一下,确认他是没有问题,有打印的,这个之前也是有打印, 现在我们来看上传头像这个问题,更换头像点一下,我们看一下啊,我们是传了一个 http 的 tamper 这么一个拼机,然后它 response 的是不支持的类型,仅支持 gpg 拼接 gif 和。这个这里我感觉这个我感觉怪怪的,我觉得是后端实现的问题,我觉得这个这个上传头像实现的问题是有问题的。 我们现在不用这个 auto 了,这个 auto 有 点太笨了,我让他看一下这个方案,但是他这里我感觉他也只理解了一半啊,他这里只把这个下载的给做好了,但是我们上传的还是没有做好,等他弄完以后我们再测试一下,如果不行的话再让他,哎呀,好累啊, 你看他只做了这个后端的返回啊,这个肯定也不对啊,测都不用测了,肯定不行的,所以现在我们要非常清晰明确的告诉他,我们让这个接口能够提供一个文件上传的符,这里他检查完认为这个符是正常的, 但是问题还存在,所以这里看到他加了一些日制来去排查问题,我们现在又加了一些日制, 现在呢,我们可以看到后端这里是有一些新的日制人,让他再去看一下到底什么问题。目前看应该是 m i m e 类型不匹配,就说这个扩展是没有的, 所以说要求他们把这个完整的请求全部都打印出来才能看得到,要不然的话没有日制是没有办法 de bug 的。 这就解释为什么大家 web coding 很多时候也没有办法去让 ai 自主的完成, 因为有时候就是要去看日制,那有时候 ai 也会说去添加详细的日制,但是这些日制出来以后,我们还是要通过提示词的方法告诉 ai 去阅读这个日制,它才能判断,这样的话我们按照他说的,我们再请求一次, ok, 然后看一下日制,这里呢就已经打印出来了 它的这个上传信息,因为我们调用的是微信 upload file, 这个是微信封装的接口, 所以说有可能跟 ai 认为的通用的一些是不一样的,有出入的,所以要去兼容这个他收到节气后收到的实际上和他想要的是不一样的, 所以他需要修改代码来兼容不同的这个情况。 later, ok, 这幅重启了,我们现在直接在这里保险起见把前端重新编一下,就更换头像这功能。 好的,现在这个错误是变了啊,错误变了就好,他不是那个错误就好。这里呢,我们看到这个报错还是在 s d k 里面,所以继续把它交给后端去分析, 我感觉就是怎么说呢,明明上面有这些,但是他只修改了一个地方,修改了这个,但是这个他也没有修改,一点也不聪明,我觉得 每次都要确认一下,我们的服务器已经启动了哈。 ok, 现在现在我们看到我们传这个图应该是成功了哈, 但是呢,这里图片链接这里报错了,这个是前端的,包括这个有一个配对使用的问题,我们把它全部都甩给前端去解决。 后面呢,我们还有很多要去连调的地方,这里我就不会在视频里面给大家去记录了。然后相信在我刚才介绍的一些调试过程中呢,大家也能学到一些与 ai 写作编程去调试的 bug 的 技巧。 这里面其实也没有什么深奥的东西,说白了就还是回到最原始的信息差和沟通的问题,我们一定要想方设法的去抹平信息差,然后把事情状况搞清楚,描述清楚,这样的话 ai 才能 准确地去帮我们解决问题。因为现在很多情况,比如说我们的代码在运行的时候,只单纯从逻辑去判断的话,很多情况是不能 cover 的, 我们一 要从实际的表现拿到实际的表现的结果,再反过来去分析问题,才能得到最终正确的答案。现在这个头像呢,我们是没有办法下载下来的,是因为这个 http 我 们没有配,所以说这个 这个地址好像也不是很对啊,我们要让后端去排查一下, 我们让他去排查一下哈。 ok, 我 们来试一下他这个正确的 u i l。 先试一下能不能看到这个绿坨坨,这就对了嘛,这是我们传的绿坨坨, 那这个问题基本上就解决了哈。好的,我们也来重新试一下啊,直接看这里啊,这还是 up 啊,这肯定还不对,我们再上传一下试一下啊。 啊,我知道了,我们换了图是对的,是他这个获取用户信息的这个接口返回的是错的,那还有一个原因是因为之前错过的东西已经存在数据库了,所以没有更新啊,我明白了,应该是这个原因, 那我们再试一下现在这个应该就是这个头像,那就没有问题了。 ok, ok, 搞定。开不开心? ok, 视频到这里呢,我们来做个小小的总结。 这天其实调试了很多功能,虽然这期最后详细展示的只是一个更换头像的功能,没有什么技术含量,但是整个调试过程恰恰能反出很多朋友用 ai 编程时候 bug 的 痛点,尤其是没有编程基础,缺乏调试经验的朋友,往往只能告诉 ai 最终的结果和表面现象,却忽略了代码 运行过程中的关键信息,导致 ai 反复的卡壳一直打转转,问题始终没有办法去解决,本质上就是微信小程序分装的数据格式和后端期望的不匹配,只要能看到日记里的关键信息,问题就会一目了然。所以这里我也想重点强调, 制系统对于的 bug 来说真的非常的重要,而且非常的实用,它能够快速帮助我们精准的定位问题,少走很多弯路。最后和大家分享一些我对项目规划的理解。有些朋友可能会把前后端放在同一个工程里维护,说实话,对于 ai 编程而言 的确有优势,一个 ai 能完整的读取前后端所有的代码,反而前后端分离呢,人为上制造了一些信息隔离,两个 ai 有 可能无法高效的协助。但这里有一个非常现实的问题,就是上下文的限制,因为如果是前后端都在一个工程,由一个 ai 负责的话, 他每次读取的信息可能会非常的多,有非常容易导致上下文的截断,最终导致结果出现偏差。所以从这个角度出发呢, 我建议大家至少要做到前后端的分离开发。除此之外呢,做好有效分工其实也非常的关键,一来能让 ai 负责业务模块,有效的结偶,二来呢,能锻炼我们自身的系统架构思维,最后就是提升开发效率, 可以并行推进。当然分工之后呢,不同模块之间的信息交换就非常的重要,就像我们这个项目产品的 pid 文档是所有模块的共识。 前后端呢,则用 sdk 作为沟通的桥梁,前端只负责调用,后端负责实现和维护,这样能够避免信息的脱节。这期视频呢,确实很长,能看到这里的朋友真的非常感谢大家的耐心。下期内容呢,我们就把核心的邮箱发票整理,发票识别功能全部打通, 让整个小程序的核心功能真正跑起来。如果屏幕前的你也对 ai 编程非常感兴趣,想和我一起实践学习,欢迎点个关注。非常感谢,拜拜。
粉丝8308获赞2.3万
相关视频
 00:30查看AI文稿AI文稿
ui 动效终于可以由 agent 一 键搞定了,这是我用 cadx 给我的 ai 外贸网站做的落地页, 可以看到效果还挺一般的。然后我使用 j s a p 新发布的 skill 安装到 cadx 里面优化我这个落地页,可以看到它添加的动效以及配图都挺不错的。 大家如果有前端 ui 动向上的优化,也可以试试用这个 skill, 直接去让你的 agent 自动帮你优化。
181朝朝AI工坊 01:33查看AI文稿AI文稿
五个前端顶级 skill in tagble 这是一个专为 ai 编码工具设计的 skill 合集, github 上已经收获超二十五 k star, 用于提升 ai 生成界面的设计质量。内置前端设计反模式词典,明确告诉 ai 绝对不能犯哪些低级错误,生成的代码不仅功能完整,且更具备高级的视觉质感。 task skill 同样是一个能够提升 ai 前端设计品味的工具,只需一个 skill 文件就能让你的分为编码 ai 不 再每次都生成千篇一律、毫无新意的作品,同时支持 react、 vivo 和 spell 三大主流框架中使用,给 top 上已有一万五千多人疯狂收藏。 skills 由前端大神安森尼夫精心挑选的技能,合集 y 和 nars 开发人员的一站式资源库,把官方文档、最佳实践、个人经验结构化,让 ai 的 生成代码更符合社区规范,同时处理生成代码不规范、不符合现代前端最佳实践、配置混乱等问题。 高德地图 skill 它将高德地图 g s a p i 二点零的官方文档、最佳实践和代码模板集成到结构化的技能文件中,利用 ai 编辑器自动生成符合官方规范的地图代码包, 包含地图初识化、覆盖物、世间布局等模块核心 a p i 帮助开发者快速集成高德地图,并遵循正确的使用方式。 u i u x pro max scale 如果你的 ai 写 ui 还达不到这样的设计标准,界面丑得像二十年前的网页,并且还不支持自定义配色方案、自己搭配和图标类型等操作,这个 scale 就 可以彻底解决这些弊端。目前 gigap 已经超七点四万人收藏,可实现在跨平台和八个前端框架中使用,几个简单配置步骤即可开始。
1.6万茄子懂编程🙈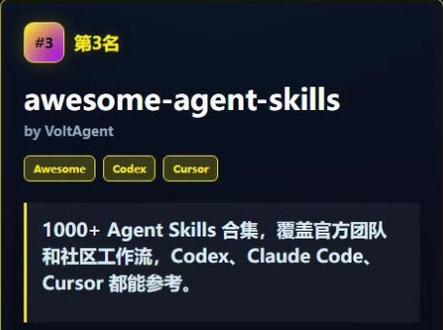 01:14查看AI文稿AI文稿
get up ai skills 热榜 top 十来了,这期从第十名倒数到第一名,建议先收藏。第十名, pga wide, 他 把 postgrace 文档和 mcp 能力打包给 aai, 适合写数据库代码的人。第九名, expo skills, 他 专门服务 expo 项目,让 ai 更懂移动端构建、发布和 eas 工作流。 第八名, appify agent skills, 做网页抓取和自动化的人,可以直接给 agent 补上采集能力。第七名 agent scan, 他 扫描 ai agent m c p 和 skills 的 安全风险,装技能包钱,很值得跑一遍。 第六名 and few skills, 前端大佬 anthony fu 整理的技能库,偏开发日常小而精。第五名, ai research skills, 他 把模型训练、 rack 和论文流程做成技能,适合研究型 agent。 第四名, openai skills, codex 官方技能目录,想学 codex 怎么组织工作流,先看它。第三名, awesome agent skills, 上千个 agent 技能合集,兼容 codex、 cloud code 和 cursor。 第二名 agents, 它是 cloud code, 读智能体工作流,把复杂研发任务拆给不同 agent 执行。 第一名 agent skills, 生产及工程技能包,把规范测试、凭审核发布都变成 ai 可执行流程,这就是本期 getopai skills 热榜 top 十,下期继续挖真正能提高效率的 ai 工具。
157阿吉AI日记 04:59查看AI文稿AI文稿
再然后就是记忆层和那个持久化层啊,记忆层的话我们一般要分几个层级啊?像短期记忆、长期记忆,还有包括呢核心记忆跟系统记忆。这里我给大家分了四层。绘画级记忆呢,就是当前绘画的,绘画一关没了啊,这是绘画记忆。绘画记忆呢,包括比如说我现在这直接 exit 退了, 那接下来那我再去打开当前的这个绘画呢?你要去恢复或者去重新把它加载,属于绘画记忆。还有项目级记忆,就是对于当前项目的一个结构化认知,它会存储啊, 有这个记忆文档,团队型的或者用户型的这种呢,我们一般可能会沉淀在呃那个 skill 里面,当它提取加载的时候会去存储。再然后呢,系统记忆,那个记忆,就是我们说底层记忆,一般它的存储方式是什么样子的,那这里我给它去做了这样一个 归类啊,做了这样一个归类,比如说像项目目录下的隐藏文件,比如在 call 里面有对应的 memory 来去通过 json 结构化的方式来去存储的。核心文件里面也有啊,就大家可以整体把这个表 详细去看一下。那每一部分呢,都给大家去详细介绍,比如规划机、项目机,包括呢?还有团队用户机和系统机等等。接下来呢,这是第六层,重点呢,我们回到拓展层,拓展层其实是最重要的,因为我们真正在做智能体开发的时候,你会发现,呃,这个工具层啊,包括呢你整个智能体的架构呢?它其实如果一旦你 确定好之后,或者你基本的这个架构设计思路有了以后,基于这个底座在上层去封装高拓展性的那个工具啊?或者说,呃, skill、 mcp 都要有对应的思路。比如说像这个 skill 或者 mcp 呢,其实就是对于工具的一个 顶层的抽象,怎么抽象呢?像以前如果说我们去调用工具的话,都是本地工具调用,对吧?比如说我读文件,写文件,这工具呢?我可能要写一堆的这个脚本啊,让他去理解,理解之后呢?去调用本地的,呃,那个不管是 batch 命令还是脚本执行,都是由模型去决策以后来去调用的。但是我们会发现有个问题啊, 有些工具呢,比如说我要获取天气,从来想我现在智能体想获取天气,但这个天气这个东西呢,它不是在你本地就能够得的数据,它是属于远端数据,对吧?我查快递,快递我这里又不知道我这个快递到底在哪里了,对吧?我上菜鸟看一下,或者我在其他的这个快递平台看一下。 那我们怎么样去才能够让 ai agent 能够查快递,能够点外卖,能够去执行这个查天气,执行这些任务呢? 都必须要有对应的服务,这些服务呢千变万化,比如说高德提供的,呃,那个导航服务,对吧?什么比如墨迹天气啊,这些提供的天气服务,天气查询服务啊,快递一百提提供的快递查询服务,这些服务它都是由不同的服务商来开发的, 一旦 ai 来去接入这些数据的时候,就会发现,以前大家开发是不是最痛恨的就是跟后端的哥们去对对代码对接口,对吧?你后端说啊,这个你这样写,我这里解析不方便, 大家有没有这样的一个情况,有同学扣个一,对吧?是有这种情况吗?那这个时候我们需要想有没有一种标准化的结果,标准化能够去减少很多的沟通成本。 一旦标准化以后,那比如说我整个后端跟前端约定好的这个字段应该怎么样去写定好,确定好啊,后面就不要改。 那像这种约束如果要用在 ai 这一层去使用啊,或者叫 ai agent 要去理解的话,那其实就要上升到 mcp 这个概念,全称叫 model context protocol 啊,就是模型上下文通用协议,这种协议它其实就是为了不管是你来哪个商家或者提供商,你提供的接口应该是一个标准化的接口,它其实就是起到一个约束的作用,一个标准化约束的作用, 这样的话远程的工具就能够在我的智能体中间去使用了。我智能体里面一旦接 mcp, 我 就可以去就说,呃,搜导航,对吧?我就可以去查快递,都可以,那这就是 mcp 他 做的事情。 好 m c p 做完了我们再来看到 skill, skill 呢?更多的是偏本地化的操作,包含哪些呢?比如说我可以在这个 skill 技能里面来让他去帮我做 ppt。 那 怎么做呢?大家想没有 ai 的 时候,你是不是可以用 python 来去做 ppt, 对 吧?你也可以用 word gs 来去做 ppt, 比如说你用 word gs 的 话做 ppt, 那 就 ppt 点 gs 拍照的话有对应的啊,那比如说你要去做图,做图的话,拍照里面像那个图片处理那一块,最知名的一个是 open cv, 对 吧?那比如说还有其他的在 node js, 呃,比如说还有 pin, 那 在 node js 层呢?有 sharp, 对 吧?这些都是一些标准的 库能够去实现的。那这个时候其实我就要想,我能不能让 ai 也能够去调用这些代码,这些呢?其实都是脚本啊, 这是脚本,我现在能不能想办法让 ai 智能体来去调用这些脚本是可以的, 怎么去掉呢?先要知道我要做的事情就是去做图,或者说呢去生成图片。好,一旦他在决策的时候发现了你的这个意图,接下来他就可以从你的 script 脚本中间来去调用这些脚本执行来生成对应的 skill 呢,职责就是这样。那刚才有同学提到 skill 到底是呃这个 node js 来写还是 python 来写?都可以,这个没有问题啊, py 的 c g s, t s 的 g s 都可以啊,但是一般前端同学自己来写的话,大部分基于 g s 的 话,基于 node g s 的 话是更好一点的,这是第六部分。然后完整的这个念度呢,我们可以串联一下,从用户指令输入到 cy 引导层啊,再让它到交互 到执行内核啊,这个里面呢其实就包含了记忆,包括呢模块那个拓展,拓展的话我们说有 skill m c p 层啊,工具层,工具调用层,包括呢环境的执行,文件命令代码的执行,这些呢,其实都有专门的项目环境。
 01:31查看AI文稿AI文稿
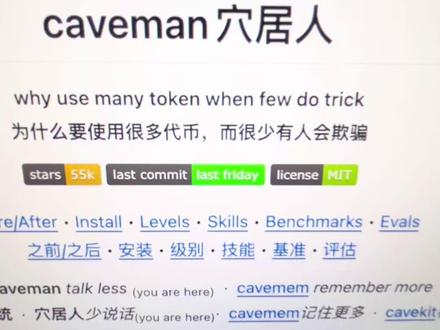
excel 让你的 cloud code, codex token 消耗量减少百分之六十五,这个 github 上面五十五 k 的 一个项目,就是这个 qman, 这什么意思?这个这个项目做了什么呢?他说他把你的普通的上下文的书,对话的文本做了一个极致的压缩,它是怎么压缩?类似于 现在的简体中文,他给压缩成文言文,你可以这样去理解,你看他举的举的这个例子,你看这个是那个 u i 渲染的这个例子,你看这个英文非常长,是不是?中文也很长,但是他压缩完之后,用文言文之后,竟然是你看悟出新参照致重会, 这个英文也是一句话,这个很有意思哎,这个作者是一个外国人,他竟然支持了文言文,而且他这个 文言文竟然还有三个模式,有那个我看一下好像有那个,你看这个文言文这个经典版,你的不要压缩太多这种, 还有全版,还有凹凸版本,就是极致压缩那种。但这个场景,比如说你要是那个做深度研究,做分析,很多的那种文本多轮对话的,你编成是不是你用可拉扣的,你肯定会不停的修改你的提示,是不是?这个就很非常完全适合?但是如果你是简单的一轮对话,两轮对话,这种 其实就没什么意义。想想你,因为你是你一轮对话,你要把你的文本发给 ar, ar, 然后把它转为文言文,文言文再得到处理完结果之后,再把文言文再转成白话文,再转给你,这一过程相当于多做了一次转换,是不是? 所以说你单词对话的话肯定不合适,但是你多次对话,这种有多轮对话这种场景,这个是非常非常好用的, ok。
316AI学不懂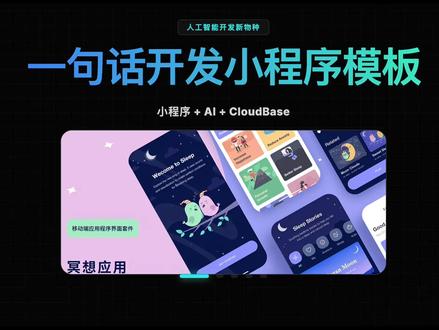 01:16查看AI文稿AI文稿
为了提高小程序开发效率,我直接整理了一套小程序加 cloudbase 加 ai 的 全能模板,今天分享给大家,你不用再去研究 cloudbase 怎么对接,怎么管数据库怎么部署,只需要打开这个模板,跟 ai 说清楚你的需求,所有和 cloudbase 相关的代码对接部署, ai 全都帮你自动生成。那么怎么做到的?我们看一下这个模板。首先,模板呢,已经内置了 cloudbase mcp 的 配置 ai 工具,可以直接连接到你的云服务。其次,里面写了完整的 cloudbase 开发规范, ai 读取后自然就知道怎么写 cloudbase 代码,怎样提交部署。更关键的是 它支持 cloud code、 cursor、 灵码、通用键问等等市面上所有的 ai 工具,对接好模型直接使用,无需任何其他配置。而且里面还内置了大量的小程序专用的 skill, 一 句话就可以生成企业级的小程序页面。 还有 ai 大 模型 skill, 一 句话接入大模型,使你的小程序智能化,可以用到智能客服、机器人等场景。 还有超多的小程序专用技能,后面我会一一拆开讲。有了这套模板,你只需把需求丢给 ai, 前后端自动生成,自动部署,你只管提交上架,小程序开发门槛大大降低,效率大大提升。
643AI 落地老魏 02:36查看AI文稿AI文稿
给大家看一下 overseat 里面的第三方茶剪刻店里面的 skill 到底有多好用。首先那个一个是 ai 的 一个工具,手把手教学这个 ip 的 一个线索挖掘,我在前几天已经讲过了,真的非常强大,能出一个人生自传, 非常好用。还有 windows 一个性能优化,清理字牌,对吧?然后个人信息引导,让 ai 又认识我。 那么还有像这个公众号的一个排版,公众号爆款的一个生产,尤其这个敏感词的一个检测,这个真的是非常棒,就是你写完这个内容之后,他会自动帮你去呃,检查一遍有没有敏感词,到底哪些需要改的, 呃,下一篇我会把这个怎么生产篇。呃,公众号,他的公众号也好,还是说他的一个文案内容也好?呃,一个整体的经过,我给他录制一下,还有教你这个知识的文案配图,生成 标签标题啊,尤其这个比较厉害啊,就是这个灵感碎片的这个文案,就是你有灵感,你有想法,你在任何地方,你输入给他,或者说你们有一个对话,你们在聊天,聊了这一段对话输入给他,他都可以帮你做成这个内容, 好用。还有像这个爆款的一个呃,拆解,这个也好用啊,这个比如说你看到一个好的一个链接,或者说呢,你的一个对标的一个视频,你觉得他说的非常好,或者说你非常感兴趣的事情,你直接分享给他,让他去帮你进行一个拆解。 那么还有聊观点,讲故事的,这个都是呃次要的啊,尤其是这个什么选举的一个评分,他会呃给你去考虑哪些选举好坏,应该发哪个?到底能不能发,对吧?这个都会给你进行一个做一个评分, 评分高的你再去发那个爆款的成功概率也就高了。还有像这个风格的一个萃取,这个风格萃取就是你的一个风格,这个是非常重要的,让这个 ai 在 学写这个,呃,文案的时候,他可以依据你以前以往 所写过的一个输出风格,那这个 ai 写出来东西就是你写的,就就这么回事。 我觉得这些视频都非常的好用。所以呢一个工具好不好用啊?不是在于它有多少先进的功能,最终呢?就是如果说能把这个工具用到你的实际工作或者实际生活中呢?呃,能够应用起来,它就是一个好的工具。
252大宁学AI 04:40查看AI文稿AI文稿
从零自学 ai 之 agent skill, 这次吴文达联动 anthropic 官方一起出了一个一小时讲透 agent skill 的 官方教程,我也用 notebook lm 帮我一起学习了一下,今天我会总结里面三个关键点分享给大家。 首先第一个官方给到了一个官方的 skill 库,这个在 github 里面,这里面我们可以看到有非常多比较丰富的这些 skill, 包括像文档、 ppt、 pdf, 还有 excel 等等这样的一些很好用的大家经常用到的一些办公软件。那强烈推荐大家去再下载一个叫 skill creator 的 这样的一个, 它可以帮助你自己自定义和创建更多更好用的一个 skill。 那 这个 skill 的 一个安装方式很简单,我们就在 github 里面把它的地址复制下来,我打开 cloud, 我 们在这个里面直接啊把这个地址复制给他,我告诉他安装这个 skill, cloud 就 会直接帮我们去跑这个任务,我就直接可以把它安装到我们的 一个电脑里面,你可以看到这里面它的这个 skill creator 就是 一键安装了。第二个值得分享的呢,是这个课程里面举了一个例子,去解释多个 skill 加 mcp 怎么样组合构建成一个成熟的工作流。那这个里面举例了一个,就是 通过最原始的一些营销数据,那最终能够输出一版符合公司整体 ui 标准的 ppt 这样的一个例子, 它像有一个这数据分析的 skill, 再加上一个这个 company brand skill, 也就是符合公司品牌 ui 的 这样的一个制作 skill, 再加上 ppt 的 这样一个 mcp 能力,那最终它其实在这个里面一步一步带着大家去解释了 如何去生成这些 skill 和这个 skill 是 怎么工作的,那最终就可以看到我们可以通过一个原始的数据最终输出。这个例子里面举例了向右边这样的一个完整的 ppt, 而且是符合公司标准的一样的一个 ppt。 之所以 skill 这么好用,我觉得也是因为 skill 和 skill 之间是可以相互串联的。那我之前其实是出了一期关于怎么去一键拆解爆款脚本也好,口播也好,我其实也是串联了两个 skill, 第一个是视频 内容提取 skill, 另外一个是它可以去针对一个原视频,它能够去进行视频内容整体的一个分析和提炼的 skill。 那 这两个 skill 加到一起,我们就可以实现 给到 ai 一个视频链接,它能够自动帮我们去解析里面的内容。在官方的教程里面也举了这个例子,我觉得还是蛮重要的,这样可以让我们的 skill 话说非常多的话,解决我们很多的复杂问题。 第三点我觉得很值得分享一点,这个教程里面它让我这个文纯文科生小白理解了为什么 skill 这么好用,它解决了哪个很关键的问题。这个里面可以看到竹子稿里面还有提到 skill, 它其实我也有几轮交互, 就是他会提到说健宁市批录的好处是不占用这个 ai 的 上下文窗口。什么是上下文窗口?上下文窗口就是 ai 的 一个大脑的短期记忆, 那我们可以把它理解成一个办公桌的大小,我们所有丢给 ai 的 这些提示词或文档数据信息,包括 ai 返回给我们的这些内容,它其实都会占用这个桌面上的一个空间。 那如果我们不使用 skill 的 话,我每次想让 ai 去分析营销数据,我们必须都写下一长串的这个提示词,就在还没有开始工作前,可能我们这样的一些数据啊,这些提示词就已经占满了整个桌面,就没有什么空间返回了,占用了这个上下文窗口之后,会放大的影响 ai 的 工作效率。 所以在渐近式批录,其实我觉得更简单易懂的一个叫法应该叫做按需加载,它可以比较省空间,而且说白了就是能省偷懒,省钱,就不用每一次都是把长篇大论的这个提示词塞给他。 ok, 如果有对这个视频的逐字稿和重点感兴趣的同学呢,可以进群讨论。那现在 skill 确实是我用非常多的一个工具,那如果你还不会用 skill, 可以 看我这篇视频已经帮助很多小白成功安装上了,走出了自己的个人 a 阵的第一步。 那到最后我还想有一点碎碎念。在看这个视频课程的时候,我有一点我还挺感慨的,因为这个讲解的小哥,他应该是 antarctic 的 官方工作人员, 他讲解的其实是用了这个 cloud ai 客户端产品去做演示,但这个产品因为现在是国内是不能用的, 所以我就会感觉还挺有落差的,因为我知道现在国内我自己也用过嘛,去用这一套 agent skill 其实还是挺麻烦的,有一些成本。当我看到他演示的那一套 cloud ai 的 一个桌面端,看起来非常的丝滑好用,非常可交互,就是一套可交互的纯面向小白的一个 agent skill, 包括刚刚所有官方推荐这个 skill 已经内置好到这个应用里面了,所以这里面还是心情还挺复杂的。我觉得在二零二六年发生这种事情还是挺离谱的, 但是我觉得也就这两年了,希望国内的这些大模型再加把劲,让我们这两年能够更快的用上国产的这样的一些大模型。好了,我是小姚,如果你对自学感兴趣的可以关注我,拜拜。
200科技小妖 00:31查看AI文稿AI文稿
今天给大家分享一款简约高级 ui 风格 skill 来 ios 风格设计,视觉质感耐看。 copy 这个技能链接,添加这个技能包发送安装,添加后我们测试一下输入杠 up, 选择 ios 格拉斯 ui 技能,让它设计一个 cms 后台, 等待 ai 生成。生成好了,看下效果,整体风格跟 ios 接近,看下内容管理列表与表单,风格不错,再看下数据面板,符合预期,大家赶紧去试一下。
310瀚辰电商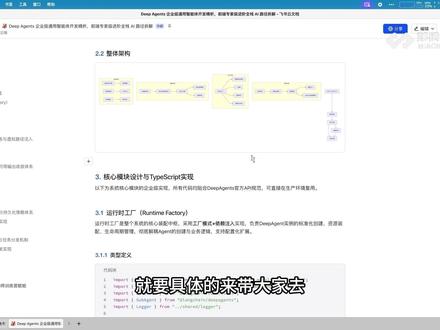 07:11查看AI文稿AI文稿
就要具体的来带大家去通过 type strip 来实现一下,把这个效果给大家来实现,告诉大家在这个调用层这一块我们可以做哪些处理,那我们来先看一下这边实现的这个效果,我们直接 yes, 现在应该把,马上帮我生成出来了, 好,现在还没有生成,待会儿它最后一步会帮我们输出,我们等它输出之后再来看啊,等到最后一步输出之后我们再来看, 应该还在,还在执行,还差一点点。好,已经生成了啊,直接,呃,他现在想完成这个使用,我们看点一下,点到这边来,接下来他会帮我们生成出来,直接输出到我当前 输出到当前这个内容里面,当然我我会把它叫它把它移过来啊,生成到我当前的这个项目下面,生成到当前项目下面, 需要稍等一下啊,这个执行的过程的话,有时候相对耗时间一些,当然我这里可以提前把问题提给他啊,完成后将 skill 呃移动到当前项目,然后呢这个 codex 中啊,就直接, 然后等它完成之后我们再来看。好。那这个具体的 skill 调呢?是力呢?主要是想通过这种类似于 codex 或者 open code 给大家先演示一下,待会它创建完之后再来看。但我们假设现在自己要去实现一个这种类似于 codex, 比如说或者叫妙码 open codex, 这种效果我们怎么来做啊?因为刚才呢,其实给大家去给大家演示了一下,不知道还记不记得,我这里重新给大家演示一下。 好在这呢,我直接执行它,就这个执行的过程,从输入到模型的加载,到技能的文件加载到整个工作区的印刷,这就是我们所说的沙箱啊,然后呢到 de patient 的 整个出场,完成流逝执行,然后呢到输入 就是事件啊,接收到这个事件,事件呢是用户搜索 nonchain, 然后接下来就去搜索,搜索完之后呢,它会识别到,你看需要调用工具这里呢,它会识别, 需要调用什么工具呢?调用搜索工具,那这搜索工具叫 internet search 搜索工具,那接下来它就会去搜索这个网站,链接是它,然后呢摘要是什么会搜索到,搜索到以后呢?把结果最终输出,加上完整的执行链度,这个中间一共经过了哪些环节呢?第一个是智能体的加载, 智能体加载或者要抽象啊,然后呢模型抽象, 模型出场之后,其实到这一步就完成了,到模型啊,然后呢接下来再就是 skill 加载, skill 加载完,接下来呢再就考虑到要去做规划了,当然在规划之前呢,这里还有一点就是当前 workspace 的 映射, workspace 映射,这映射是为了什么呢?其实就是为了我们整个沙乡的 抽象,就插纱箱机制啊,抽象好,接下来后面就用户输入,这其实就是提示词层面的,提示词层面的处理,比如用户的输入,然后呢把这个输入交给大模型教,大模型接下来就去读取,读完之后他发现,哎,要调用工具, 叫识别吧,叫工具识别啊,识别一般我们可能会识别出来,要么就要去调用 tool, 要么调用 m c p, 要么调用 skill 啊,这是工具识别。识别完之后,接下来我们发现它要去掉 internet search 这个工具,这个工具呢,其实我们通过 skill 来实现的啊, 接下来就去读取,这时候呢读取那肯定要用搜索引擎吧,搜索引擎呢,我们可以选择有很多种选择,我们比如说这里可以选择 tablie 来做啊,那接下来呢,就搜索把结果拿到,拿到获取,要获取, 获取所有的结果,然后呢,接下来再进一步的将结果使用大模型加工,最后,哎,就来到这一步了,为什么要做沙箱触手画,就是为了将文件操作存储到本地的文件系统, 那这就是完整的啊,一个过程,当然这个里面可能还会有很多点,我们没有办法在这么短的时间给大家全部具,那个每一步都具体的来说明,我们只是做一个整体的梳理,从智能体加载、模型抽象、 skill 加载,再到 workspace 印刷、沙箱抽象,题旨词呢,就开始工作了,要去识别要用哪些工具,要用哪些 m c p, 要用哪些。 skill 定好之后,将来我们识别到要用搜索引擎,它就会通过 tab 搜索引擎去搜索,搜索获得结果之后通过大模型来加工,最后输出到本地文件系统,那输出了什么呢?就这一堆,这是它搜索的结果,帮我们改写写出来的内容啊,已写入 hell 点五 md 就 完成了, 这是它整个执行的过程啊,那如果落到代码上面,我们要去实现的话,怎么来做呢?我们来重点去看啊,当然在看之前呢,我们可以看一下在这个里面 skill, 我 把我把这个 skill 呢移到里面去啊, 好,同学们可以看到我那个笑话, skill 其实是已经定义出来了,我们来看一下,将中国唐诗宋词改成现代中文笑话啊,干嘛干嘛。最后呢?写写东西,马克汤,包括诗丽都有, 比如说我输入月落乌啼霜满天什么什么的啊。当然这个笑话其实也不好笑,因为我们没有去改造它 写完之后的这个创作的效果,它其实就是通过这一个 skill 来实现的。当然这种 skill 呢,它不只是文字的加工,还能够去做图片生成,还能够做视频剪辑,所有的工作,只要是以前能够脚本化的工作,现在都可以基于 skill 来做,为什么呢?因为在 skill 这一部分,我们其实可以创建一个 script, 对 吧? script 在 script 中间,你可以定义很多的逻辑来保证你当前这个 skill 功能完整。那你还有,比如说有一些额外的依赖的一些其他东西,在 reference, references, reference 里面啊,可以放在 references 里面,比如有些 data 有 一些额外的描述文件数据都在这个里面,那这就是一个比较完整的 skill 的 一个结构,唐宋 poetry, 什么 joe, joker, generator 叫这个名字啊?这个 skill 就 这个名字, skill 的 名称, 它的描述什么时候要用这个 skill 给它定义好,那么接下来其实就是去调用它了,那我们来试一下案例,比如说我在当前这个内容里面啊,输入了,比如说,嗯,床前明月光, 好,我就说这样一句话,看他接下来会干什么,直接通过我这一套 skill, 那 他会先去思考,对吧?你输入的内容,那直接帮我输出来,这很简单啊,因为这个工作比较简单。白话。然后呢?笑话, 我半夜差点拿拖把去擦霜,走近一看,原来是月亮把地板打高光,还有点押韵啊。 这个其实就是 skill 的 一个简单用法。那我们现在来看了,我们怎么样自己去调用这个 skill, 就 比如说我现在 skill 呢?一样不变,对吧?我假设也是写这样一套 skill, 我 现在可以把这个 skill 呢移到我的 open codex 里面来。那接下来我就直接用这个 skill 来调用它,看能不能生成结果,这就最重要的好。
 03:05查看AI文稿AI文稿
最近 superpowers 这个 skill 被吹上天了,其实它的核心设计理念是强制工作流,把软件开发变成方法论,让强制触发的机制运作在 agent 的 行为里面。这就造成了 superpowers 有 几个弊端, 第一,他把你当成不知道自己要做什么的人,每次你开始一个任务,他都会先打断你,问你到底想做什么,然后帮你梳理需求。如果你已经知道自己要做什么,甚至对业务流程非常清楚,这一步对你来说纯粹就是浪费时间。 第二,他强迫 agent 在 做任何事情之前先翻译遍所有的规则,他自己在原规则里面就写到某个词, q, 哪怕只有百分之一的可能性会被用到, agent 就 必须先去检查,而且检查在你回忆你之前就发生了。 你让 agent 改代码,他就会被强制规则控制,做各种考虑。每次都这样,整个开发流程的体感就变得特别迟钝拖沓。 第三就是规则是强制的,没办法商量,你作为开发者有自己的节奏,但是 agent 被训练成必须先走它规定的流程,你的想法和 skill 的 流程在同一个 agent 里面打架,导致结果就变得没办法预测了。 最后就是它是一整套方法论,不是一个工具,先讨论再计划,最后 staff agent 去执行。我在项目里面处理问题很多时候都是探索型的,经常需要快速的去测试一个方案能不能跑通,所以就不需要约束的很死板。 skill 本来应该把我已经在做的某些流程自动化,不是给我添加更多本来就不需要做的事情。 一个好的 skill, 它不应该是默认就打断用户,在用户目标已经非常明确的时候还要重新做需求梳理,也不应该把每个问题都拖到流程里面。 skill 的 价值是减少做重复的决策,缩短路径,提高成功率。 有点像快捷键,在规定的时候触发,不相关时候就保持沉默,强化某一个具体的环节,不是接管整个任务。我个人认为,真正值得使用的 skill 是 能帮用户把重复的、机械性的、容易错的部分自动处理掉, 最好是在整个流程当中,你几乎都感觉不到它,这才是 skill 应该给用户的体验。例如烧一壶热水的流程是拿上电热水壶,打开盖子接水,接满之后盖上盖子放在底座上,打开开关,然后等待水烧开,我自己就是 agent, 这一个流程就是一个 skill, 如果在这个流程里面增加一些没必要而且无法优化流程的动作,就会变得非常的奇怪。例如接水的时候我给水壶跳一支舞,烧水的时候我在旁边鼓掌, 这些行为对烧水这件事本身毫无帮助。我说这些并不想完全否决掉 skill, 现实是大多数 skill 根本没有使用的必要,效果还不如你自己写的提示词。
131也覌 01:55查看AI文稿AI文稿
如果你正在使用 cloud code, 却还没装这些 skill, 那 你可能只用了它百分之三十的能力。今天分享七个最值得安装的 skill, 尤其是最后一个,能让 cloud code 从能用的 ai 直接变成懂行的队友。第一个,社区最火的全能 skill superpowers, 它不是单个技能,而是一整套开发全流程 buff, 包含项目规划、代码编辑、 code review 等十几个子技能,能帮你梳理需求、拆分任务、系统化调试,程序员必装,省超多梳理时间。 第二个,文档处理神器, pdf, 它能直接读取、合并、拆分。 pdf 还支持 ocr 扫描件识别,写代码间隙处理文档,不用切换软件, 不管看技术文档还是办公文件都好用。第三个,去 ai 位神器 whoman the zh, 它能把此外综上所述,这类生硬表达换成接地气的人话,写项目文档、副业文案都能少一点模板位, 不容易被看出是 ai 生成。第四个,大项目救星, planning with files, 大 型项目经常中途打断,回来 ai 就 往上下闻。这个 skill 会持久化项目规划,画绘画不丢进度, 特别适合碎片化时间开发。第五个,前端颜值救星, fronten design, 它让 cloud code 写的前端不再是 ai 烂活,而是带着专业设计规范,后端程序员也能做出好看规范。 第六个,代码质量守护神 code review, 它会派多个子 a 证,并行审查代码、找 bug、 查安全漏洞、优化代码规范,每个问题都带知性度评分, 赶项目时不用逐行排查,能大幅减少代码出错率。第七个,压轴神器,也是最能提升体验的 skill creator, 前面六个不够用,它能让你自己定制 skill, 把自己的开发习惯、 重复性工作封装成专属功能,彻底让 ai 适配你的需求。这就是让 cloud code 变成懂行队友的关键。 这七个 skill 覆盖开发全流程文档处理前端优化代码质量,还有能自定义的压咒技能,装完之后你会发现 cloud code 的 能力直接翻倍!收藏起来直接去 skill 商店搜英文名就能安装。关注我,带你了解更多 skill 使用技巧!
8.1万阿森编程日记(AI自动化) 01:34查看AI文稿AI文稿
很多人在面试中被问到性能优化问题时,他只会罗列技术名词,其实这类问题会有一个统一的解法,两分钟我帮你掌握这个高分打法。当面试官问你,我们的页面加载很慢,脚本是主要原因,你该怎么优化呢?那么你千万别着急说,我们用比尔属性高手的回答,永远都是先定义问题。 那么这个问题的核心就是浏览器渲染被堵塞了,浏览器默认遇到 screw 标签,会暂停一切工作去下载和执行,所以这就是造成白屏的元凶。 所以接下来我们要针对性地给出解决方案。首先,首先识别问题,确认脚本是否依赖动或者其他脚本,这是我们决定策略的一个唯一标准。如果你的脚本不依赖动是完全独立的,比如说一些分析脚本或者广告脚本,你完全可以用 assign 属性,它是病情下载的,下完就执行。 但是呢,我们要强调的是,如果滥用 assign 属性,会导致执行顺序混乱,是偶发性 bug 一个常见的地方。 然后我们的 default 属性,对于绝大多数业务脚本来说, default 是 一个正确的选择啊。 default 并行下载,但是是在 html 解析完之后按顺序执行,它既不阻涉渲染,又保证依赖关系。 所以我们总结一下你的回答,不应该只是 a sync 和 default 的 功能对比,而是应该展示一种诊断思维,我们先看依赖,再定策略。所以这才是让面试官眼前一亮的一个高分打法,它证明你不只是会用工具,而且能从根源上解决问题。 所以我建议你收藏这个思维框架,我们下期再来拆解其他项目优化的具体方案。我是方格,我们下期再见,拜拜。
55赛博程序员 01:18查看AI文稿AI文稿
今天给你们挖到一个能彻底终结 ai 塑料味儿的开源设计神器!用过 ai 写代码的都知道,逻辑写得再好,深沉的 ui 界面往往丑的千篇一律。但今天呢,介绍的这个叫 harmark 的 爆 火开源技能包,绝对会颠覆你的认知。它完美适配 cloud code、 coser 和 code。 它不是那种烂大街的 top 模板,而是一个专门为了反 ai 廉价感而生的顶 级设计师大脑。它最逆天、最降维打击的功能是一个叫三 d 的 模式。是不是很眼红? 需要把那个网站的截图或者链接直接发给他 mark, 就 能像顶级艺术总监一样,精准地提取出那个网站的设计 dna。 注意,他绝不是傻傻地去抄袭代码或像素,而是去拆解他的排版节奏、色彩、锚点和空间布局,然后用这套高级的 dna 为你量身重构出属于你自 己的网页。为了保证你的网页足够高级,它甚至在内部设立了六十五道严苛的测试闸门。从字体搭配、对比度到微交互的延迟,只有完全通过这六十五项测试,没有任何 ai 机器味儿的设计,它才会把最终的代码交到你的手上。无论是从零 搭建、见面审查还是彻底重构,它都有专门的模式帮你搞定。而你要做的,仅仅是在终端输入一行代码代码。在这儿, ai 时代的下半场呢,拼的就是审美!如果你也用 coser 这类的工具,千万别错过这个神器,现在就去给你的项目注入灵魂吧!
216Summer不夏天 00:38查看AI文稿AI文稿
跨的写前端走向模板,先别急着怪模型,很多时候是第一步就错了。你直接说帮我做个高级一点的 ai 工具首页,它很容易写成大标题, 三张卡紫色渐变。我的做法是先调用官方 frontend design skill, 先说清楚人群气质限制,再让它写页面。比如给开发者看的工具首页气质要冷静可靠,像生产工具,不要营销大卡片。这个 skill 真正有用的地方 不是让 ai 乱加特效,而是吧,能不能看提前变强硬要求。
167飞雪ai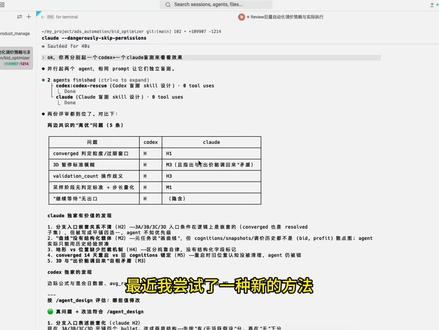 06:33查看AI文稿AI文稿
最近我尝试了一种新的方法,让 agent 自动帮我去优化 skill。 不知道大家有没有遇到像我这样的问题,就是 线上有些 skill 我 们已经在业务里面去跑了,但它的推理效果有时候会让我不太满意。就以前我的做法都是自己去跟 agent 一 轮一轮的反馈,让它去改, 然后我也会去看它改完之后的那个 skill 点 md 或者是其他的一些文件来判断,说是不是符合我的一个想法。后来我发现这个方法有两个挺明显的问题。 第一个就是我们本身并不是 skill 的 使用者, skill 的 真正的使用者是 agent, 所以 我们人觉得有问题的地方,它不一定是这个 skill 最本质的问题,只是我们觉得它不符合我们的一个业务预期,但具体它的问题点在哪里, 其实我觉得用 agent 来判断其实是更合理的。第二个就是人去一轮一轮的改其实真的太慢了,而且很容易漏掉一些潜在的问题。 我们指出了 a 问题,可能又忽略了 b 问题。这种优化其实很多时候是不全面的,而且效率也低,效果也很难做的很到位。所以我现在是用了一种新的方法,就是让两个全新的 agent 互相去盲测,帮我把 skill 一 轮一轮的迭代到位。 试下来我觉得基本上迭代个三轮左右效果就挺不错了。这期就具体讲一下我具体是怎么做的。这里有一个前提需要说清楚,就是双盲测这个方法只针对推理类的 skill, 它才是有意义的。 如果你的 skill 它是这种纯脚本类型的,比如说去采集某个渠道的数据,如果跑出来不对,那肯定就是脚本有 bug, 我 们直接让这个 cloud code 或者 codex 去修脚本就完事了,没有必要去做这种双盲测,因为起多个 agent 的 去盲测,这个 token 消耗还是挺大的。 盲测其实要解决的是这种推理类 skill 优化的场景,就是 skill 已经写了,也已经在业务里面跑了一段时间,但是推理的结果在某些场景下依然不符合我们的业务预期,这种时候盲测才是比较有意义的。 那在启动盲测之前,有两件事情是 a i t 带不了我们的,必须我们先去讲清楚的。第一件事情就是 当前的这个 skill, 它的问题到底是什么?我演示的这个例子就是我有一个自动化广告出价的 agent skill, 它的工作流呢,我是希望它能够多去探索一下不同的出价区间后,去找到我的广告毛利最大化的那一个出价点。跑了一段时间之后,我发现它的探索动力不是很足, 经常是找到一个 roi 一 点二,一点三的一个点之后,他就觉得,哎,不错了,能赚钱,然后就收点了,他就不会再主动地去做探索了。虽然我在 skill 里面也写了一些方法论,让他要多去探索,但是他最终并没有 去落实,所以这个就是我想优化的一个具体的问题,我想让它能够真正地更主动地去做探索,不管是涨价还是降价,我希望它能多去试一些不同的价格,然后去找到一个权取毛率最大化的一个点。第二个我们需要去定义好的点,就是这次 skill 优化它的约束是什么? 这一步我觉得也特别关键,因为如果我们只是把问题抛出去而不给约束的话,那么 agent 对 于 skill 的 改动很容易变成一个反方向的硬规则的这种 补丁。比如说我指出的问题是,他不愿意去做探索,那他可能就会疯狂写一些提示词,让他疯狂的去做探索, 那可能有一些确实不需要探索的地方,他又花了很多成本去探索,这等于就是从一个极端跳到了另一个极端。所以啊,在这个例子下面,我给的约束很明确,就是不管是 skill 的 描述还是工作流的设计,只能给 agent 教方法,不能给他加一些死规则。 因为加死规则的话,像 agent, 他 碰到规则之外的场景他就懵了,他的推理,他的出价逻辑直接就会崩掉,完全没有任何逻辑。 但是如果我们教方法的话,他不管是遇到什么样的情况,他都能用这个方法去帮自己去找到一个合适的解法。所以我在这个 skill 优化环节里面主要就做这两件事情,第一个就是定义问题是什么,第二个就是定义我的约束是什么。 那把问题和约束想清楚,定义好了之后,盲测的迭代其实就是三步。第一步我们在主对话里面把问题和描述一起交代清楚, 让主对话先帮我们去改一版方案,这一版改完之后,我自己都不会怎么去看这个结果改的结果对不对,而是直接进入到第二步,就是让主对话起两个全新的 agent 去盲测, 我一般会用一个 codex 和一个用一个 cloud, 这两个 agent 是 没有我跟主对话之间的这种上下文的,主对话会把这个改完的这个 skill 和我最开始提到的那个问题一起,会给这两个盲测 agent, 让他们独立地去判断这版改完的 skill 到底能不能解决我一开始提出的那个问题, 因为他们没有任何鲜艳的认知,这其实就是我们常说的这个 harness engineering 里面非常重要的一个点,就是做开发任务的 agent 和做 review 的 agent 不 能是同一个 agent, 一个 agent 不 能既当裁判又当运动员,所以盲测的意义就是在这里。到了第三步的话,就是两个盲测 agent 会把他们认为还不到位的地方,需要优化的地方再返回给主 agent, 那 主 agent 会判断这个问题它是不是一个真问题,如果是的话,会按照我一开始给的这个约束,教方法 不交死亏者这样的一个约束继续去优化这个 skill, 那 么这一套反复跑个两三轮盲测和迭代优化这个 skill 基本上就优化的差不多了,这个时候我们就可以把它放回到生产里面,再去看它的实际表现。 那么如果还有问题的话呢,就还是再走一遍这套流程,继续去磨这个 skill 的 一些细节。那么整个迭代过程中,我觉得我作为人的这个工作边界就更加清晰了,就是我只需要去定义我发现的这个 skill, 它的存在的一个问题,以及我在业务上 的一个约束,然后 skill 到底怎么改成什么样子,提示词怎么调,工作流应该怎么设计去编排,这些全部交给主对话和两个盲词 agent 去模。这里面的细节我只关心一个事情,就是这个 skill 再次投入到生产中去应用的时候,最开始提出的那个问题有没有被解决? 说实话啊, skill 跑了一段时间之后,其实这种长推理流程的 skill, 它的啊 skill 点 md, 还有一些 reference 的 文件,一般都还是比较长的,文件也比较多,我们自己去读都还是挺费劲的,更别说一个一个去优化它们。 所以让盲测 a 检测帮我们去找问题做优化,效率我觉得比人手动的去做真的高太多了。如果你们也遇到了这种推理类 skill, 跑了一段时间,但是业务上有一些不满意的地方,我推荐大家按这个方式去试一试。
261新也诚🦞

