谷歌omni实测效果如何?
谷歌 omni 被吐槽翻车,但别急着下结论,这次大家拿它和 cds 二点零比打斗,视频效果确实不算惊艳。 omni 真正值得看的,其实是视频编辑能力。它支持文字、图片、音频、视频多种输入, 还能用聊天方式直接改视频里的背景、季节、时间、角色,甚至局部细节。比如你拍了一段庭宴视频,直接告诉他把白天改成夜晚, 把夏天改成冬天,原来的物体还能尽量保持不变。这段儿广告出海、 ai 短剧、素材、二创产品、视频剪辑都很有想象空间,目前上线的只是 flash 版生成效果,还有短版成本也不低。但如果后面 pro 版补上稳定性, omni 可能会成为视频内容团队做素材微调和批量编辑的新工具。

粉丝1046获赞5949
相关视频
 01:14查看AI文稿AI文稿
dance 二点零这次终于有对手了!谷歌刚刚发布的视频模型 omni 到底行不行,我们一试便知。先来看 omni 强在哪里?首先是视频编辑能力, omni 能够在改变画面元素的同时,保持角色和场景的一致性,比如把现实中的雕塑变成泡泡,一触即破, 把自拍里的镜子变成液态,让人碰到就变成终结者。或者是把小提琴手从音乐厅挪到草地上,再变换一个拍摄角度,不过他好像忘记把琴带出门了,真是尴尬。其次是物理引擎更加精准,那说人话就是重力、速度和碰撞之类的效果更加真实。 另外,奥尼也拥有了全能参考的能力,除了能够参考图像、视频和音频合成最终效果之外呢,还能给视频加上指定的特效包装。正为我的动销同事捏一把汗, 那接下来我们看看同框对比 omni 和 c dance 二点零谁的效果更好呢?实测下来, omni 的 物理效果确实更加优秀啊,画面风格也更加丰富多变,但中文能力就远远不如国产模型 c dance 了,这些有机材料就能自醒发光,而且 c dance 的 人物位置更加稳定,画面更有影视风格。 目前这面的 omni flash 模型已经正式上线,不过每天只能生成三条视频,你觉得 omni 能够和 c dance 一 战吗?来评论区咱们接着聊。
616APPSO 02:06查看AI文稿AI文稿
谷歌最新的视频生成模型 omni flash 已经上线了,现在你在 flower 里面已经可以使用它了,那么它最后生成出来的效果到底怎么样?能不能撼动 c 但是二点零的王座? 我们一起来看一下。现在 flower 里面也是支持自定义角色形象了,你可以通过 nano banana 直接生成一个角色的形象,并且可以给他选定与和自定义语音啊。那么比较有意思的地方呢,是它这个有个角色个性的动作啊,它的这个文本呢,就会帮助模型去 呃决定这个角色的这个行为啊。好,那我们废话不多说,我们就来直接测试一下 omni flash 的 这个能力啊。首先我在 type n 里找到了一些案例啊,我用相同的提示词和相同图片去生成这个案例中的这种视频,接下来我就放出前后对比啊, for the empire we will not be defeated。 可以看到跟国内的模型对比其实现在还是有差距的啊,那么谷歌到底是不是在憋个大的,它的 v u 四能不能让它重返这个视频生成的宝座啊?那么这个就是后话了啊。关注我,带你看更多 ai 测试!
441Likely7玩Ai 01:30查看AI文稿AI文稿
jamn 欧米尼翻车了!就在昨天的 google i o 大 会上,全新的视频模型 jamn 欧米尼正式亮相发布之中呢,所有人都期待他能够创作出超越现有视频模型的作品啊,但现实似乎并没有按照大家想象的方向发展,就连 jamn 欧米尼一直强调的真实世界物理规律,在 cds 面前也毫无还手之力。 无论是画面、构图、分镜,还是单纯的生成效果,都显得一塌糊涂啊。讯息能力似乎与 cds 完全不是一个级别, 但詹姆尼真的很差吗?其实也不完全是啊,在连续编辑上,他的表现反而更加出色。以这段视频为例,将画面中的小提琴手所处的场景更换为草地,人物的动作、神态、表情都完整的保留了下来。 将手中的小提琴给去掉之后呢,仍然能够看出前后非常高的一致性。再看这段发布会上演示过的案例啊,经过欧米尼的多轮编辑后呢,人物会根据不同的设定做出不同的反应, 同时保留出真实的物理效果。由此可见, java omni 并不是专门用来做精美短视频的模型啊,更像是视频版的 nano banana, 它可以精准的根据用户指令修改视频,而不是单纯的创作虚拟型作品。 所以,如果你想通过 ai 一 键成片啊,我想 cds 仍然是现在的第一首选。但如果你追求可控编辑、灵活修改,那么 java omni 无疑更加值得尝试。 比 cds 那 种令人惊讶的视觉效果, jimmy 欧尼更像一个可控的视频工作站,你可以反复修改,局部调整,灵活性远高于 cds, 换句话说,欧尼的价值比生成画质本身更加突出。目前你就可以在 jimmy flow 里进行体验了,赶快试试吧!这是我还推荐第五百四十一个神器,关注我,解锁更多硬核 ai 工具。
210优设AIGC 02:36查看AI文稿AI文稿
兄弟们,沉寂已久的谷歌终于来炸街了,就在刚刚结束的谷歌 i o 大 会上,发布了天花乱坠的各种 ai 产品,但真正重点就两个,一个是独一档的多模态能力和超强的 ag 能力。 先来看个最狠的,谷歌发布了全新的世界模型 jimmy nike omni。 你 可以将任何形态的文件作为输入,比如文字、视频、图片、音频一起发给他。 jimmy nike omni 能以任何你要求的形式输出给你, 从此 p 视频就像 p 图一样简单。但如果说 omni 是 无敌的感官,那么同时发布的 jimmy nike 三点五 flash 就是 专为代码和 ag 的 优化的, 它的输出速度达到了同类前沿模型的四倍,每秒狂飙一千五百个 token。 谷歌在现场用全新的 ai 开发平台 anti gravity 二点零展示了它有多逆天。 杰米奈三点五 flash 仅仅持续工作了十二个小时,就从零首写出了一个完整的操作系统内核。它在开发时,后台自动派生出了九十三个 ai 子代理,总 token 成本低于一千美元。而同类型的任务如果交给人类团队,至少需要数月的时间。 更硬核的是这个首出的操作系统,既然能直接加载毁灭战士 doom, 现场就玩起来了。 随后谷歌顺势推出了 gemini spark, 你 可以理解,它是谷歌为你远程部署了一台七乘二十四小时,搭载了 gemini 全套能力的服务器。它能跨越应用,直接打通各种第三方软件。你只要给他一个目标,他自己就能拆解,步骤全自动帮你搞定。 比如自动检查信用卡账单里的隐藏订阅费,把货一记录整理成文档,然后群发等等。最后还有压轴亮相的谷歌智能眼镜,戴上它, jimmy 奶就变成了你现实世界里的专属管家。路过咖啡店,眼镜自动识别,你只要动动嘴, ai 就 把咖啡给你点, 还能实时 ai 导航和同城传译。从这次 ai 大 会上看得出,谷歌正在疯狂地将 ai 模型的能力产品化,毕竟用户真正需要的是能解决问题的产品,而不是 ai 模型本身。第二呢,谷歌之前明显在多模态发力过猛,在 ag 能力方面有点落后于 antropics 和 open ai, 现在眼看 ag 大 爆发,所以他就奋起直追。但即便是刚刚发布的 gmi 三点五 flash, 也依然和这两个头部公司的模型有差距。那么 gmi 三点五 pro 会不会惊艳全场呢?大家可以期待一下。好了,我是阿朱,关注我,让我们一起在 ai 潮头冲浪!
3633阿朱星际漫步 06:57查看AI文稿AI文稿
谷歌的欧米尼视频生成模型上线了,我们可以在这个 flow 平台上进行体验,同时 flow 平台也上线了很多的视频和图片编辑小工具, 那么本期视频我就给大家测试体验一下欧米尼模型还有这些小工具。首先我进行测试的时候,模型只开放了 fresh 模型, 目前最高能生成七二零 p 十秒的视频,每个视频消耗三十个点数, umi pro 会员一共有一千个 ai 点数,而且我在使用的时候,它的首帧参考功能还没有上线,所以我就简单测试了几个纹身视频的例子, i will send you back to the dark abyss。 好,提示词所要求的东西都有,但是动作,电影质感还有音效都差很多,可以看一下 c 带是二点零的, 而且在 flow 这个平台,我们可以在下面这里输入提示词,直接对视频进行二次编辑。比如我直接输入一条金枪鱼跳上船,我们来看一下效果, i will send you back to the dark abyss。 他 这添加的内容太生硬了,几乎是不可用的。当然有可能他是 fresh 模型的原因。我们再多看几个例子, 这条视频的话,飞机驾驶是还不错,女主的紧张感和节奏也还行,但最后飞机仪表盘反向了,而且多了一个人。下一个我们试一下著名 ip 加想象力 why won't this stupid code work? 暂停一下,这里电脑里表现的内容太棒了,连代码的说尽都像那么回事。 i refuse to do this? 直接切镜头换风格 anymore why won't 他 这条真人路飞生成的其实挺棒的,这是就中间莫名其妙多出来一个动漫风格的镜头,下一个是变形金刚的镜头, 这个表现就太差了,别说跟 c 站十二点零比了,连快乐马都比不过。 下面是一个著名 ip 加动漫风格, anya will defeat all the villains, 这个表现其实还算可以了,介于 first 和 cds 二点零完全体之间, 下一个是香港电影。如果记忆是一个管头,我希望他永远不回国。起 这个案例就表现的很差了,无论是中文音还是镜头都不符合要求。如果记忆是一个罐头,我希望它永远不会过期。来一个九比十六的变身镜头, 那就再来一次, 感觉能比快乐马好上一些,但是这种动作和特效还是 c 大 师您的拿手好, 再试一下科幻镜头, 这个表现太拉胯了,完全没有电影质感,比快乐马都差远。 总结一下就是 omni, 它的表现肯定是不如 cds 二点零的,但它毕竟还是 flash 模型,不知道它有没有正式版,如果有正式版还是未来可期的。它还有一个优点就是足够的便宜,性价比还是很高的,目前生产速度也快,而且目前还 现那些著名的 ip。 今天除了欧莫尼这个更新之外, pro 这个平台还上线了巨多的图像编辑和视频编辑小工具, 我也帮大家测试了一下,总结一下就是很鸡肋,就是看起来很厉害,实际上就是一些常见的开源项目整合而成的图像和视频编辑工具, 比如说编辑文字动画的呀,还有说像什么手绘转图片,从各个仕图和角度去查看原始的图片,这个就是千问的技术吧,我记得还有什么视频跟随音乐动起来,这样的就适合整活。 还有一个是上传三 d 模型,然后再转化为二 d 平面图片, 它的视频小工具还有一个印象比较深刻的是一个抽帧加抠图加重叠的技术, 其他的图像小工具的话,要不然就见太多了,要不然就完全没什么意义。总结一下的话就是 omni 未来可期,图像工具的话作用不大。 那么以上就是 jimmy 在 本次 flow 上的更新的测试结果了,我个人是比较失望的。好,如果本期视频对你有帮助的话,麻烦帮我点个赞。
2277实验式 02:23查看AI文稿AI文稿
大家好,我是可涩谷歌的视频魔仙 omni 上线了,还有 gimini 三点五也上线了,接下来我给谷歌的 omni 和 cds 二点零进行一个视频对比,在同样的职业词和脚本以及图片的情况下进行对比。我们先看一下 omni 生成的一个效果, 这是用力复出的一个, 这是横版的一个视频效果对比,然后再测试一下触感的 给大家看一下,七个是二点一出的, 为了测试不同的情境下的一个效果,我还用了九宫格的,这是 omni 的 一个视频效果 啊,再看一下用 c 点是二点零四的啊。 嗯,除此之外,我还给他上传了一个视频,进行一个编辑,他原视频是这个,让他给他换个背景, 他进行了一个修改的动作。 整体来讲这个说实话这两个模型没有办法对比,我迷你连 happy house 都比不 上。这个 jimmy, 它是可以免费用的,我们打开 jimmy 的 这个官网,然后找到这个 video 在 这里生成,你可以上传图片去 生成,也可以直接出提示去给它生成,这个是可以免费用的。还有另一个是它的 flow, 就是 jimmy 它本身有一个 flow, 你 在 flow 里面也是可以免费用的,但是它生成的比较慢, 目前来讲,他这个生成应该是一次出三个,然后出完之后你得隔一段时间他再次出,是可以继续的。
 04:23查看AI文稿AI文稿
今天凌晨,谷歌 i o 二零二六如期而至,随即宣布 gemini omni、 gemini three point five、 flash 等等一系列新产品。 这是什么?硅谷年夜饭?算粒满汉全席。媒体老师也非常懂事,标题直接起飞,谷歌亲手淘汰谷歌 视频版 nano banana, 全能 ai 创作引擎,全场最大的 c 位,毫无悬念给了 gemini omni。 这玩意号称是真正的全能大模型,能吃进任何形式的输入,拉出任何形式的内容。文本、图片、音频、视频,只要你敢喂,他就敢接, 而且首发支持视频输出,江湖人称视频版 nano banana。 你 看这个排面,劈柴哥和哈萨比斯同台登场,大招跟不要钱一样往外扔。他们说 omni 不是 在简单拼接素材, 他是在理解物理世界。以前的 ai 画个物理现象,重力和动能常常让牛顿想从苹果树下爬起来打人。但阿米不一样,哈萨比斯说他实现了阶跃变化, 氨基酸折叠都能给你干成科学准确的定格动画。甚至你拿个手机自拍,手心里画个圈,他就能立刻给你生成一个黑洞。看起来这不仅仅是降维打击,这简直是从四维空间扔了二象薄, 画面太美,数据太狂,狂到让人觉得好莱坞明天就得集体去送外卖。但这还不够刺激,发布会的另一个高潮是 jammer 三点五 flash。 只要你懂点行,你就知道现在的大模型卷速度卷到了什么地步。 三点五 flash 在 精准测试里,把自家前代旗舰 jammer 三点一 pro 按在地上疯狂摩擦,更离谱的是,它的输出速度直接翻倍,对比 gpt 五点五和 opus 四点七,速度快了四倍有余。这什么概念? 你这边的提示词刚敲完回车,他那边的答案已经糊你脸上了。天下武功,唯快不破, ai 界直接来了个闪电侠。 这还没完,谷歌还顺手倒出了一箩筐的重磅炸弹。 anti gravity 二点零桌面应用直接进化成 agent 的 开发平台。 james park, 七乘二十四小时在线的赛博打工仔。不需要五险一金,不需要情绪价值,只要服务器不断电,它就能给你打工到宇宙热季。 顺带把 jimmy 也改版了,代号 neuralexpressive, 改成算力计费。你以为他在做慈善,其实他在教你什么叫资本的洋谋。 甚至连搞了二十五年的谷歌搜索都迎来了史诗级升级。接入三点五 flash 智能搜索框,自动生成小程序。这一套组合拳打下来,干货密度堪称历年之最。大场发力,寸草不生。 那你说这东西真的这么神吗?往往打榜数据越炸裂,发布会的 ppt 越精美,里面的水分往往就越能养活一太平洋的鱼。 我怀着激动颤抖的心,拿着号称能改变世界的 omni 进行了实测。这需求可太真实了。毕竟咱们干自媒体的,天天盯着各种 ai 视频工具找灵感,就指望他们能帮着出大片,但结果给我看笑了。哎, 硅谷的公关稿还是太保守了。这哪里是改变世界,这简直是重新定义了拉胯。宣传片里是好莱坞质感,随手一划就能变黑洞。小提琴手在雪山和赛博朋克之间无缝切换。物理逻辑严丝合缝。 到了我这呢,我输入几段简单的指令,生成出来的视频,当场给我整出了工伤。说好的理解世界呢?服务员你好, 我想要一杯客了!好的,没问题!这一刻,我都怕他给我念出一段大悲咒来超度我的显卡。那些在发布会上惊艳全场的连贯性记忆力和物理法则,在实测面前碎的渣都不剩。 这不叫接月变化,这叫当场火化。网上的各路媒体还在疯狂吹捧热搜,通稿满天飞,但和实际效果一比,简直是截然不同的两个平行宇宙,那还能说啥了?看完这场魔幻的体验,我算是彻底清醒了。 现在的 ai 圈有一种极其不健康的畸形风气,只要打榜厉害,只要 ppt 做的炫,就能吹成天神下凡。 巨头们在台上拿着特供版的 demo 疯狂秀肌肉,底下的信徒们跟着无脑狂欢。 ai 好 不好用?只有我们这些一个个坐在电脑前疯狂敲着键盘,试图用它来铲除实际价值的用户给出的真实反馈才算数, 你数据再炸裂到了用户手里,变成了一坨赛博垃圾,那他就是毫无价值!请这些 ai 公司收起你们的滤镜吧!面对用户的实测反馈,少吹点牛,多打磨点细节,这才是对技术真正的尊重。这里是起点世界,聚焦最新 ai 资讯,我们下期视频不见不散!
 06:27292Deepwhite深白色
 00:30查看AI文稿AI文稿
google 昨晚发布了新的视频生成模型 omni, 他 宣称自己在多模态融合和物理模拟上都有明显提升,那我们就拿它和 cds 做个简单对比测试。
1040Luna的AIGC频道 01:54查看AI文稿AI文稿
谷歌今日凌晨发布了 gemini, 在 底层逻辑上简直就是一次史诗级的进化,瞬间引发了轰动,我们一起来看看实际的测试效果吧。哈喽,各位小伙伴们大家好,今天给大家演示一下最新的视频模型 omni flash 的 使用方法。 好,这个的话呢,它支持使用十秒啊,然后三十个积分这种方式操作好,那么怎么来操作呢?假如说我们要做这样的一个漫剧效果 好,那么首先第一个我们可以使用分镜啊,这个是我之前做的分镜。好,那么我直接把这个分镜的话呢,放到我的这个提示词里边啊,那么我可以直接到这里艾特一下就可以了。好,我艾特一下分镜,点击确认。好,然后的话呢,我可以直接说 啊,使用啊,根据分镜,或者我把它删掉啊,根据分镜生成动画。 好,然后我艾特一下这个分镜,这个分镜好,可以了。好,然后人物参考,使用这一个人物。好,然后场景参考,场景参考, 再使用一下这个场景。哎,我的场景也有了。好,这样子的话呢,那么就直接就 ok 了啊,然后我们直接来生成好生,呃,动画流畅,然后运镜流畅 就可以了。好,那么就直接点击生成好,这个的话呢,大家就可以看到一条非常运镜流畅的,并且呢有音效的这样的一个画面呢,就可以展示。 嗯,而且它的准确度是非常高的啊,就是没有脱离我们的这一个分镜,所以的话呢,这个是一个非常好用的功能。
493AIGC创意教育坊 03:59查看AI文稿AI文稿
最近呢谷歌发布了全新的 ai 视频生成大模型,也就是 jimmy 欧米尼是这样的一个模型,那么在官方的宣传页面里面可以看到这个模型呢,它的生成效果是非常好的,包括各种的动作, 各种的物体的稳定性都是非常好的。今天呢来实际测试一下它究竟具体的一个效果怎么样啊?我们呢可以先看一下别人制作的一个关于大模型对比的一个效果, 使用的呢就是谷歌新发布的这个欧米尼模型,跟我们国产的这个 c 弹子二点零的一个对比, c 弹子二点零呢是目前来说全世界范围内啊,它的效果是最好的。 然后呢我们来进行一个对比,看一下它的效果,究竟它的距离啊有多少?大家看一下这个整个的一个视频,那么上面呢是谷歌的模型,下面呢是 c 弹子二点零的,咱们看一下它跳水的这样的一个动作啊,非常的不自然,好再看一遍, 好看到这里啊已经落水了,然后呢他又重新回到半空中,并且呢这个人物的整个的一个姿势啊,非常的怪异啊,跟我们的 c 弹 z 二点零是完全没有办法比的,可以说在人物动态上, c 弹 z 二点零可以说非常的真实和非常自然。下面呢还有更多的一个案例,比如说像这种 双人就是两个角色进行一个大范围的移动啊,很明显的可以看到 c 弹子二点零呢,他的整个的一个环绕运镜和慢动作,对吧?和一个细节的整个的一个姿势啊,动态非常的流畅自然。上面呢就不用说了,非常的死板,其他的包括还有这种运动镜头的 啊,一样的运动镜头的 c 弹子二点零呢,同样的大家可以看到非常的自然,对吧?上面呢 整个的你看整个的动作,整个的非常的怪异,这个呢是网上别人的进行的一个对比,那么基本上不用咱自己的测试啊,非常明显可以看到 这个谷歌的模型完全跟这个 c 档三点零完全没有办法比,所以说呢 c 档三点零虽然说现在啊价格比较贵,但是贵有它的贵的一个道理啊,它的效果确实非常好的。那么下面呢给大家说一下咱们如何去 使用这个谷歌的新的大模型,现在呢谷歌模型咱们可以免费去用,这个呢,虽然说他效果没有那么好,但是啊他免费用咱们是可以去用一下的,咱们在这个谷歌呢直接搜索这个 flow, 在 这个平台呢咱们直接可以免费去用的,咱们直接打开一下,来到他的一个账号的这个页面主页,大家呢可以去登录一下,登录一下之后呢咱们可以看到在这里啊去选择这个具体的创作模式啊, 它默认呢是这个图片模式,大家可以看到,那么咱们把它选择视频模式,然后在下面呢就有这个具体的整个的模型的一个选择,那么谷歌的模型呢是 vivo, vivo 就是 vivo 三点一的模型,那么最新的就是最上面这个呢就是最新的欧米尼 flash 这样的一个模型啊,咱们可以直接去选择,那下面呢秒数啊,最长是十秒钟,上面呢这个生成的比例选择,这个九比十六 真和素材是什么意思呢?比如说你上传一个素材呢,上传一个图片,让他模仿这个图片里面的人物的长相啊之类的,这个真呢就是首尾针,对吧?首尾针去生成中间动态的一个视频。 好,咱们选择素材就可以了,这里呢选择好之后直接去书写咱们的题词,直接去发送。那么我之前呢也给大家做好了一个这个视频,这个视频呢就是一个女孩在滑板,就是在场地去做滑板滑板动作这样的一个视频啊,大家可以看一下整个的动作,我感觉啊 非常幅度非常的小,而且他的一个整个的动作非常的不自然,所以说呢还是大家呢可以去试一下生成一些动画动作幅度比较小的这种视频还是还是可以的,但是呢像这种大范围的动作 确实啊是不太适合的,在这个 flow 里面呢,大家直接可以免费的去生成,那么现在呢他是有送的,有这个积分。好,大家可以去测试一下。
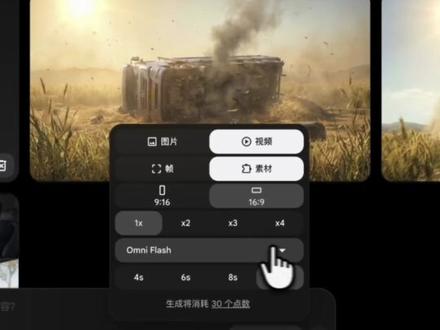 00:54查看AI文稿AI文稿
兄弟们,今天谷歌 gemini 生成视频发布了,给大家做个测试,看看效果怎么样。我做的三个主题分别是机械战士打斗仙侠人物打斗迪士尼皮克斯三 d 动画。想通过这三个场景来看 gemini 模型视频能力。接下来我们来看看这两个模型最终的表现,大家各自打分吧。 有请三位选手依次登场。 i don't want to go to school, but it's time to get up sleepyhead fine, i'm going! 各位看官,你觉得哪个好?
47极光 01:21查看AI文稿AI文稿
当你不小心打开 gemini, 又不小心打开里面的阿凡达,聪明的你发现,只要露入你的人脸,你就可以拥有自己的数字分身,它可以一键生成你的口播视频。 don't be trapped by dogma, which is living with the results of other people's thinking 演讲视频 it is the combination of years of work and i cannot wait to share it with you 带货视频 i feel like my whole body is relaxed friends who like it click the link below to buy it 以及专属于你的大片。 can you hear me is anyone there open the door open the door。 这就是谷歌刚刚发布的新的视频模型 omni, 它能从你的自拍里提取出一个数字分帧,让它替你出镜,你只需要把想法告诉它就行。我这几天用下来的感觉就是因为它录入的人脸信息还是比较多的,确实比之前 open at 的 sorry 要更加真实, 用它做口播视频和带货视频会更加自然一点。另外,它生成的视频成本还是比较低的,五个小时的额度可以让你生成三到四条视频, 而且生成的速度非常快,大约两分钟就能生成一条十秒钟左右的视频,那这是它的优势。不过它还有很多毛病的,一条视频最多只有十秒, 你的文案写的太长,它就会自动跳过,只保留十秒以内的内容。另外,虽然谷歌说这个视频模型是符合物理规律的,但是实际体验下来还是有很多 bug 了,因为它只露露你的脸。当你要生成全身的视频的时候,跟本人的差距还是挺大的。而如果你是做跨境电商的,可以用它来试试帮你做带货视频。
793麦克Mike 03:56查看AI文稿AI文稿
谷歌昨晚扔了一枚重磅核弹,但真正大的可能不是 openai, 而是你我手机里的每一个 a p p。 五月二十号凌晨呢,谷歌 i o 大 会连发三款的重磅产品, jimmy 欧米视频模型、 jimmy 三点五 flash 超高速模型,还有能在后台自主干活的助手 ai 的 spark 詹姆奶应用,月活冲到了九亿,一年翻了一倍,搜索 ai 模式用户超过十亿。但我今天不想只跟你复述参数,我想换个角度聊聊这三个产品的背后,一场正在发生的权力转移。 先说两个模型,詹姆奶欧米是谷歌目前最强的多肽系统核心,就一句话,从任何输入生成任何输出, 你给他文字、图片、视频、语音,他能够生成视频,还能用对话的方式进行改画面、换背景、换角色、换风格,一句话的事。 而且它不是纸堆画面,它用谷歌的物理知识做底座,它模拟重力动能、流体动力学这些真实世界的物理规则。这么在三点五 flash 呢,走的是另外一条路, 极致的速度和低成本输出速度呢,是 gpd 五点五和克拉的 opus 四点七的四倍,每秒有两百八十九个头,肯生成成本呢,只有同类前沿模型的一半或者是三分之一。 谷歌现场展示了一个炸裂的场景,九十三个智能体并行工作十二个小时,从零写出一个完整的操作系统的内核消耗还不到一千美元 a p i。 的 一个额度,现场还直接运行了一款三 d 游戏,非常非常的炸裂。 但这里我要说一句可能更扎很多人心的话,模型跑得越快,视频生的越真,普通内容创作者的存在感就越弱。这不是危言耸听,谷歌已经把 omni 免费接入了 youtube 的 shots, 你 想想看,以后刷到的短视频,可能一半是 ai 生成的。你费劲拍三天剪出来的片子, ai 三秒就生成了,你的优势在哪里? 那谷歌砸一千八到一千九百亿的美元搞 ai 的 基建,到底图什么呢?答案是,它要把 ai 塞进你的手机、浏览器、眼镜和生活的每一寸裂缝。新发布的 spark 智能体能,二十四小时后台运行,帮你监控邮件、整理文档、跟踪任务,不需要你盯着屏幕。 谷歌管这个叫做搜索进入智能启时代,但说白了,他在做的事情就是让用户从自己动手变成下达指令,然后等结果。这个转变一旦达成,过去靠用户停留时长吃饭的所有产品、社交内容、电商都得重新洗牌。 这也是我之前讲到腾讯股价下跌时提到的逻辑, ai 强的不是某个功能,是用户的时间结构。所以这场发布会真正让我警醒的不是谷歌有多强,而是一个已经加速到来的趋势, ai 负责生成,人类负责判断。 ai 负责效率,人类负责连接。 昨天是图片生成,今天是视频生成,明天可能就是全场景的 ai 代理。我讲过很多次,包括红山的峰会也说过, ai 不 卖工具,只卖结果。 当 ai 把结果做得越来越快,越来越真,普通人还剩下真正值钱的就两样,你的审美判断力和你客户之间那层真实的信任连接。这也是我们做无相机摄影一直坚持的逻辑。我们不做通用 ai, 我 们是帮实体店的老板把最复杂的视觉能力封装好, 只需要拍一张照片,不需要下达指令,都可以来去生成四 k 高清的商拍大片和文案。技术上的事让 ai 来做,你看一眼觉得行还是不行,怎么用更好,这事只有你能做。 谷歌把 ai 往世界模型推,我们把 ai 往帮老板省时间来拉。方向不同,底层逻辑一样, ai 负责效率,你负责人情,你负责关系。 五月二十一号晚上八点,我将在人大商学院分享我们的产品,欢迎到我的直播间一起聊聊。我是明哥,关注我,陪你一起看懂 ai, 用上 ai。
65明哥讲AI 01:14查看AI文稿AI文稿
cunes 二点零终于迎来真正的对手了!就在今天凌晨 google i o 大 会上, google 直接摔出了王炸全新的 jimmy 欧米妮视频模型,号称能从任何输入生成任何输出。我第一时间冲进去实测了,给大家来说点最干的。首先是欧米妮最牛的地方,对话式视频编辑 可以一句话改变视频里的任何东西,而且全程保持角色和场景的一致性。比如把现实中的雕塑变成泡泡,一触就破。把自拍里的镜人变成液态人,一碰就变成了终结者。甚至能把小提琴手从音乐厅直接挪到草地上,再换个拍摄角度。唯一的小 bug 就是 他好像忘了把小提琴一起带过去。 其次是物理引擎真的封神了,重力、速度、碰撞这些效果比现在所有的 ai 视频模型都要真实。而且它还支持全能参考,除了文字、图片、视频、音频,还能直接给视频加指定的特效包装。真为我的动校同事捏了一把汗,那和 cds 二点零比,到底谁更强?实测下来,欧米的物理效果确实更优秀, 画面风格也更多变,但中文能力就被国产模型 cds 吊打了。而且 cds 的 人物位置更稳定,画面也更有电影感。目前 gemini omni flash 已经正式上线,不够 google ai pro 的 用户每天只能生成三条视频。你觉得 google 这一波能打败字节吗?来评论区来聊聊你的看法。
35二团团长 00:42查看AI文稿AI文稿
谷歌 i o 大 会上发布的全新 omni 模型真的太萌了!这次活动之前,外界就一直有声音在猜测 jammer 今年会拿出什么杀手锏。而当我看完了发布会,特别是 demo 的 视频后,我脑袋瓜子真的嗡嗡作响。 虽然我不知道这背后的技术门槛有多高,但我能直观的看到它的效果有多好。每一帧画面都像是经费在燃烧, 不像这之前的 ai 视频,只是让人觉得画面动了起来。 omni 的 视频给的感觉就是电影级的 cg 特效。 还有个好消息是,对于 jammer 的 付费用户来说,新版本将升视频额度放宽到了五个小时的对话上下文窗口内。未来欧米尼的升视频能力还会接入 youtube shots 中,以后的创作者们都要杀疯了!
108Jason的AI思考笔记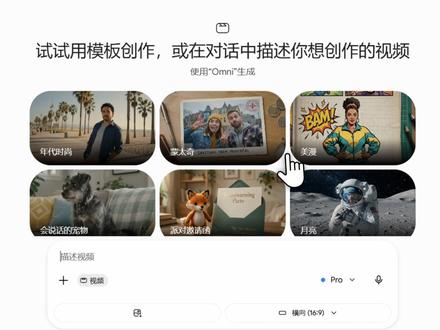 02:27查看AI文稿AI文稿
哈喽,早上好,现在是早上的七点,其实我五点钟就起来了,因为今天欧迷你上线,我就想看一下我的账号能不能有幸的去使用上它。在拍这个视频之前我已经嗯简单的探索了一下了, 所以现在的话呢,可以给大家拍一个视频。首先我准备了一段大概十五秒的一个脚本,脚本里面是包含了创意,然后就设计元素,因为早上试的时候呢啊,放了一个真人参考图上去是不过审的,那么我就把这个形象人物形象的 这些描啊特征我都用文字去让 ai 给我描述出来了。我试过有大概两个渠道是可以用上欧迷你的,详细的话我就视频里面不能讲了,你们自己看就好了。然后,呃,然后的话选择十秒,竖屏参数都是一样,然后把这个内容放上去,我们点开始 一次就呃生成两个哈,这一边是 c 档是二点零的,同样的 c 档是二点零,我们选十五秒,这边可以选十五秒哈,哦, ok, 呃,然后欧米尼这边的效果已经出来了,我们看一下哈,唤醒你的不该是喧嚣,而是对深度的渴望,掌管你的种熟时区 deep moment 咖啡。 然后这一次,呃,点进去之后呢,是要有一个像进度条的一样的东西,就是我可以随意拖动,随意拖动到每一帧的一个地方,然后刚刚我尝试一下这个,这个挺有趣的,就是我拖动到男主角的这个地方,然后跟他说把男主角的衣服改成黄色,其他 五遍,然后直接发送给他。这个就有点像我们在啊制作制图的时候啊,对话框的一个形式,告诉他我在哪里修改修改什么地方,然后就跟我昨天发的一个前三是很相似的,哎,你看他就把这个男主角的衣服改成黄色了。这时候我们回去看一看, c 档是二点零的,还在排队。好,现在 c 档是二点零的效果也出来了,我们看一下哈。 唤醒你的不该是喧嚣,而是对深度的渴望,掌管你的专属时区, deep moment 咖啡, 专注每一滴。然后两个模型对比下来的话, c 档子二点零的运镜还是比较优秀的。然后欧米尼的话呢,它就是中规中矩的一个感觉,在实际应用上面的话呢,它的效果也已经不错了。 呃,今天演示的这个还相对比较简单的,动作幅度小,场景简单。呃,那么在后面的话,还会在实际应用上面去看一下动作幅度大,场景切换的比较丰富的情况下,它的一个表现是怎么样。 讲的再好,实际应用上面的体验感是非常重要的。那么在后面的一个广告片的时候,我也会融入到,如果使用 omini 的 话,它的效果会是怎么样?那么我们下期见啦,拜拜。
283花花AIGC研究室

