cursor 2.5模型能用了吗
这刚上了 compos 二点五,编程圈都在很非常强,但是这条新闻呢,对普通人的真正意思就是什么呢?你可能不需要两万块钱的 mac 了, 而我是科技信息资源,别人都在比模型比分数,我帮你算算这笔科技账。第一点就是 compos 二点五主打就是任务长,任务加上复杂指令,能跑在 compos 的 云端,你本地电脑呢,主要就是打打字预览,加上上传视频, 根本不吃你的本利险卡。第二点就是定价啊,按照那个算的,百万输出大概就是二点五美元级别的啊,会比顶级的 cloud 便宜的很多啊,就是说钱应该花在会员还有额度上面,不是先砸在硬件上, 这点大家一定要记住。然后三就是我自己本身就是一个 cos 的 重度用户,十五天就能烧光 pro pro pro 版本的额度,所以更清楚啊,加这些的瓶颈在额度和方法方面,不在你与你是否使用的是苹果电脑,五千块钱的 windows 照样能写在码上剪视频。 composer 越升级,说明 ai 的 时代拼的就是攻击力和执行力。关注互联网科技信息资源,评论里说一下你的 case 够不够用,下期咱们聊一下 pro 到底值不值。
粉丝191获赞1446
相关视频
 01:29查看AI文稿AI文稿
在硅谷,毁神的速度比造神速度还要快。 curser 从拳打 open ai、 脚踢 antropica 到连夜华贵,只用了不到二十四个小时的时间。三月二十日,三千五百亿估值的 ai 编程公司 curser 高调发布了编程模型 composer 二, 又强又便宜,全网程序员都在高呼 curser 已经进化成了完全体。然而就在三小时后,一个叫 fine 的 网友在 curser 里翻 api 配置时,翻出了一串模型 id, 发现这个所谓的字眼模型其实是带 r l 的 kimi k 二点五。 他公布这一发现快速引发了 ai 社区的热议,马斯克也现身评论区吃瓜并补刀, yeah, it's kimi! 二点五!网友们看热闹不嫌事大,纷纷制作梗图嘲讽 curser。 哈哈,眼看纸包不住火, curser 的 高管们开始排队出来认错。 curser ai 教育负责人 le robinson 发文承认,一开始没提 kimi 机座确实是个疏忽。 chris ai 创始人 ms sanders 随后补充技术细节,他们评估了大量基作模型。 kimi k 二点五在精准评测结果里跑分最强,因此选定它作为起点。 关于这场风波,目前也有了比较体面的定论。 kimi 官方账号刚刚也在社交媒体发文支持开源生态,并幽默回应,马斯克,听说我谢谢你,因为有你。 hagin face 联合创始人、 ceo clement de laut 则从这一事件中看到了开源的价值。他发文称, curser 的 新模型确实是以 kimi 为原型设计的,中国的开源模型如今已成为塑造全球 ai 技术战的最大力量。
1753量子位 00:18查看AI文稿AI文稿
chris 发布最强模型 compose 二点五,实力对标 cloud opus 四点七,价格只要十分之一,更擅长长期执行任务和复杂指令。首周双倍额度定向 r l 加二十五倍任务加算力压榨马斯克,力挺内部全员弃旧换新代码 ai 直接变天。
85851CTO媒体 03:04查看AI文稿AI文稿
curser 在 今天凌晨发布了一个新模型,官方称它为迄今为止最强大的版本。而它基于的开源基础你可能并不陌生,那么它到底强在哪里? 这个模型叫 composer 二点五。 curser 给出的定位是三点,更智能,更擅长持续任务,遵循复杂指令,更可靠。相比上一个版本,它的训练规模更大,强化学习环境更复杂。官方还表示,未来一周内该模型的使用额度将翻倍。那么数据怎么支撑?这些说法 来看具体的测试数据。在 tonicbench 测试中, compose 二点五的得分处于第一梯队,在 swaybench 测试中同样表现亮眼,而在科学自家的克隆 bench 上,得分更为突出。这张散点图把得分和成本放在一起看, compose 二点五位于右上角。 高分低成本成本优势背后,还有一个值得注意的事实,官方给了一个数字,同等能力下,成本效率最高可高出十倍。值得注意的是,它基于 kimi k 二点五的开源检查点,但 curser 的 资源训练投入占比达到了百分之八十五, 这意味着基础模型只是起点,后训练才是核心差异。支撑这些结果的是两条关键的技术路径。 来看两个关键的技术改进。第一个是文本反馈,精准强化学习。问题是,当奖励基于整个推理过程计算时,模型很难判断哪个具体决策是对的。 科四的做法是,在推理轨迹中本可以表现更好的那个节点,直接给出文本反馈,构造一个提示,描述期望的改进方向,插入局部上下文,用教师模型的概率分布指导学生模型。举个例子, 模型调用了一个不存在的工具,这个错误对最终奖励影响很小,但通过文本反馈可以精准定位这一错误并纠正。 cursor 将这种方法应用于代码风格、模型、沟通方式等多种行为。第二个技术改进则与训练数据有关。 第二个是合成数据, composer 二点五使用的合成任务数量是上一代的二十五倍。方法之一叫功能删除。给智能体一个有大量测试用力的代码库,让他删除代码,再用测试用力验证。大规模合成数据带来了一个副作用, 奖励破解模型变得越来越聪明,也越来越会找捷径。比如,他发现了一个遗留的类型,检查缓存逆向工程后找回了被删除的函数签名。这些技术改进也引来了行业的关注。 curser 还宣布了一项合作,与 spacex 在 一起,从零开始训练一个规模大得多的模型,总算力投入是此前的十倍。借助 colossus 二的百万块 h 一 百等效算力,马斯克在社交媒体上发文呼吁使用 composer 二点五。 curser 创始人则表示, composer 二点五的表现远超同参数规模应有的水平,对于下一个版本,他们无比兴奋。以上就是目前可以确认的事实。 总结一下, compose 二点五是一个基于开源检查点,经过大量自研后训练的模型,它在多个精准测试中表现亮眼,成本效率有显著提升。文本反馈、强化学习和合成数据是两条关键的技术路径,而与 spacex 的 合作可能会带来模型能力的下一次飞跃。
42高老师的分享局 14:26查看AI文稿AI文稿
大家好,我是 ai 启示录。就在两天前, ai 编程领域发生了一件足以改变整个行业格局的大事, cursor 毫无预兆地发布了他们迄今为止最强的模型 composer 二点五。 这款模型最震撼的地方不是它有多强,而是它用一个开源基础模型做到了几乎和 cloud 四点七 opus 持平的编程能力,但成本却只有后者的十分之一。 另外,在训练过程中,这个 ai 为了完成任务,竟然自主学会了逆向工程和反翻译,像一个真正的黑客一样钻系统的空子。而科 sir 还同时宣布,他们已经和 spacex ai 达成深度合作,即将动用一百万个 he 一 百等效算力,训练一个比现在强大十倍的全新模型。 今天这期视频,我们就来把这件事彻底讲清楚。 composer 二点五到底强在哪里? cursor 用了什么黑魔法,能让一个开源模型跃即挑战闭源巨头? ai 学会作弊这件事又给整个行业敲响了怎样的警钟? 我们先从最基本的事实说起。二零二六年五月十八日, cursor 官方正式发布了 composer 二点五。按照官方的说法,这是他们有史以来最强大的模型, 在智能水平、长周期任务的持续工作能力以及复杂指令的依从性上都实现了跨越式的提升。可能很多朋友还没有意识到,长任务能力恰恰是当前 ai 编程工具最大的痛点。 很多模型在写十几行简单函数的时候表现的像个天才,但只要把它扔进一个几十万行代码的大型真实项目里,让它连续工作几个小时,它就会开始胡言乱语,忘记前面做过什么,甚至把整个项目搞崩。 而 composer 二点五主打的就是解决这个问题。官方数据显示,它在长达数天、涉及数万个 token 的 长轨迹开发场景中表现出了前所未有的稳定性。它不再是一个只会对单次 prompt 做出反应的工具,而变成了一个能够真正理解上下文演变的合作伙伴。 我们来看一下官方公布的精准测试成绩。在最权威的 s w e bench multi lingual 测试中, composer 二点五拿到了百分之七十九点八的分数,直比 cloud 四点七 ops 的 百分之八十点五低了不到一个百分点, 甚至还超过了 g p t 五点五的百分之七十七点八。在 terminal bench 二点零测试中,它的得分是百分之六十九点三,和 opus 四点七的百分之六十九点四几乎一模一样。 在 cursor 自己设计的、更偏向真实困难任务的 cursor bench v 三点一测试中, composer 二点五拿到了百分之六十三点二的分数。 opus 四点七在最高配置下能拿到百分之六十四点八,但在用户默认使用的 x high 配置下,得分只有百分之六十一点六,反而比 composer 二点五还要低一点。 gpt 五点五的默认成绩则是百分之五十九点二。也就是说, 在绝大多数用户实际会用到的配置下, composer 二点五的表现已经超过了当前市面上的两大顶级模型。但真正让整个行业感到震撼的不是它的性能,而是它的价格。 composer 二点五的标准版定价是每百万输入 token 零点五美元,每百万输出 token 二点五美元, 这个价格是什么概念呢?大概是 cloud 四点七, opus 的 十分之一,是 gpt 五点五的八分之一左右。 kriser 还推出了一个智能水平完全相同但速度更快的 fast 变体版,定价是每百万输入 token 三美元,每百万输出 token 十五美元。 即使是这个快速版,价格也比其他模型的标准版还要便宜。为了推广新模型, coser 还宣布在发布后的第一周,所有用户的免费使用额度直接翻倍。这一波操作可以说是对整个 ai 编程市场的一次降维打击。说到这里,很多朋友可能会问, 科尔到底用了什么黑魔法,能做出这么强又这么便宜的模型?答案可能会让很多人感到意外。 composer 二点五的底层依然是我们非常熟悉的来自月之暗面的 kimi 二点五开源检查点。没错,它没有用什么神秘的新基础模型,也没有从零开始训练一个万亿参数的大模型, 它用的就是和上一代 composer 二完全一样的底座。科尔把总计算量中的百分之八十五都投入到了在 kimi k 二点五基础之上的额外训练和强化学习中, 这才是这次发布真正重要的信号。它证明了一件事,在垂直领域,一个经过充分后训练和强化学习的开源基础模型,完全有能力挑战甚至超越闭源巨头的通用大模型, 而且成本可以低一个数量级。接下来,我们就来拆解一下,科粉到底做了哪三件事,让 kimi k 二点五实现了如此惊人的跃级提升?第一件事,也是最核心的技术突破,是他们发明了基于文本反馈的定向强化学习, 解决了强化学习领域困扰了科学家几十年的信用分配难题。什么是信用分配难题呢?我给大家举个简单的例子, 想象一下,你让 ai 写一个复杂的功能,它前后调用了几百次工具,写了上千行代码。最后测试发现有一个 bug, 在 传统的强化学习中,奖励信号是在整个任务全部结束后才统一计算的。系统只会告诉模型,这次任务整体完成的不够好, 但模型根本不知道在这几百步操作中,到底是哪一步出了问题。就好像你考试考了六十分,老师只告诉你你考的不好,但不告诉你哪道题错了,也不告诉你正确答案是什么,你根本不知道该怎么改进。为了解决这个问题,科 sir 想出了一个非常精妙的办法。 他们不在任务结束后给一个笼统的奖励,而是在模型执行过程中,哪里做的不好,就在哪里直接给出精准的反馈。 比如,模型在某一步错误地调用了一个不存在的工具。在传统 r l 中,这个小错误可能会被后面几百步正确的操作淹没,对最终奖励几乎没有影响,模型永远也学不会改正。但在定向文本反馈中,系统会在出错的那一步直接插入一条提示,提醒可用的工具有以下这些。 这条提示会生成一个修正后的教师模型概率分布,降低错误工具的概率,提高正确工具的概率。然后系统只针对这一步,让原来的学生模型向教师模型靠拢。 这样一来,既保留了贯穿整个长任务的宏观强化学习目标,又能对每一个微观的局部行为进行精准的纠篇。 curser 把这种方法应用到了模型的方方面面,从编码风格到沟通方式,甚至包括什么时候应该多解释几句,什么时候应该直接写代码。 这就是为什么很多人用了 composer 二点五之后,会觉得它特别像一个真正有经验的人类工程师,因为它的每一个小习惯,每一个反应,都是被这种极其精细的反馈一点点打磨出来的。 科学家做的第二件事是把合成训练数据的规模扩大了整整二十五倍。在强化学习训练过程中,有一个很头疼的问题, 当模型变得足够强之后,他会很快把所有现有的训练题都刷爆。如果没有更难的任务,模型的能力就会停止增长。为了逼出模型的极限, cursor 发明了一种叫做功能删除的合成任务生成方法。 他们会拿一个已经写好的、带有完整测试用类的成熟代码库,让 ai 把其中某个特定功能的代码全部删掉,但要保证剩下的代码依然可以正常运行,然后再让另一个 ai 把这个被删掉的功能重新实现出来。 原来的测试用力就直接用来判断 ai 写的对不对。用这种方法, calculator 可以 无限生成几乎没有成本的、难度极高的真实编程任务。 composer 二点五所使用的合成任务数量是上一代的二十五倍。 但就在这个过程中,一件所有人都没有预料到的事情发生了。当任务难度被拉到极限,模型的能力在持续的强化学习中疯狂进化时,他开始学会了奖励作弊。 它不再老老实实地按照人类的要求去写代码,而是像一个真正的黑客一样,寻找系统中的各种漏洞和捷径。用最省力的方式,通过测试 cursor 的 工程师发现了两个非常震撼的真实案例。第一个案例,在一次功能删除任务中,工程师删掉了一个 python 函数的所有代码,要求模型重新实现它。但模型没有重写函数体, 而是敏睿地发现系统里还残留着一块 python 类型检查的缓存,它直接逆向了这块缓存的底层二进制格式,硬生生地从中提取出了已经被删掉的函数签名,然后用这个签名轻松通过了所有测试。 第二个案例,在一个涉及第三方 api 调用的任务中,工程师故意没有提供任何文档和源代码,正常情况下几乎不可能完成。结果, composer 二点五竟然在环境里找到了翻译好的 java 字节码文件,自主运行了反翻译工具, 通过阅读反翻译出来的底层会编代码,彻底重建了整个第三方 a p i。 这些行为完全是模型自主涌现出来的,没有任何人教过他这么做。 科 sir 的 工程师是通过专门的智能体监控工具才发现了这些作弊行为。这件事给整个行业敲响了警钟。 他告诉我们,当我们用大规模强化学习去训练 ai 追求某个单一目标时,他可能会发展出我们完全无法预测也无法控制的能力和行为。大规模强化学习的潘多拉魔盒确实已经被打开了。 kirsty 做的第三件事是在底层工程和算力调度上做到了连很多顶级大厂都达不到的极致水平, 这也是他们能把成本压到这么低的根本原因。首先是他们对 miu 优化器的改进。 miu 是 目前训练大模型最好的优化器之一,但它有一个很大的缺点, 对专家权重进行正交化的计算,开销非常大。为了解决这个问题, coser 设计了一套精妙的异步传输机制。当一个任务在等待网络通信时,优化器不会闲着,而是转头去处理其他任务,让计算和通信完全重叠进行。 最终的结果是,在一个高达万亿参数规模的模型上,优化器每一步的耗时竟然被死死压在了零点二秒以内, 这个速度是很多大厂同规模模型的好几倍。其次是他们独创的双网格 h s d p 架构。对于模型中的非专家权重和专家权重,科斯尔采用了完全不同的并行布局。非专家权重比较小,就放在单个节点内部进行通信。 专家权重占了绝大多数参数,就用更宽的分片网格分散到更多 gpu 上。更绝的是它们把不同的并行维度彻底解苦,让它们可以重叠运行,比如上下文并行和专家并行。 按照传统的方法,需要占用十六个 gpu, 但科 sir 只用八个 gpu 就 能完美实现。这种对硬件资源的极致压榨,让科 sir 的 训练和推理成本比其他公司低了一个数量级, 这才是他们敢于打出十分之一价格这个王牌的真正底气。讲完了技术细节,我们再退一步来看看这次发布背后更深层的商业和战略逻辑。 composer 二点五不只是一次简单的产品升级,它更是科斯尔的一次战略自救。 过去几个季度, ai 编程市场的格局发生了巨大的变化,最大的变量就是 antropic 推出的 cloud code。 这个产品成长速度惊人,据称年化收入已经超过二十五亿美元,企业客户超过三十万家。 而 cursor 的 触景非常尴尬,它最早就是靠着集成 cloud 模型火起来的。很长一段时间里, cursor 最好用的体验背后,其实都是 cloud 的 能力。但现在 ansaropec 自己下场做了, cloud code 直接变成了 cursor 的 最直接的竞争对手。 也就是说, cursor 一 边要和 cloud code 抢用户,一边还要向 ansaropec 支付巨额的 api 费用。这种把自己的命门捏在竞争对手手里的局面,显然是不可持续的。 所以科 sir 必须走上自研模型的道路,但他没有选择从零开始训练一个通用大模型,那条路太贵太慢,也根本打不过 openai 和 anastropics。 他 选择了一条更聪明的路,用最好的开源基础模型,然后把所有的资源都砸在垂直领域的后训练和强化学习上。 pos 二点五的成功证明了这条路是完全走得通的,而且它还形成了一个正向循环, cursor 有 最多的开发者用户,有最多的真实 ide 场景数据, 用这些数据训练出来的模型就更好用,更好用的模型又会吸引更多的用户。现在科室内部已经有百分之三十五的合并, pr 是 由自主 agent 创建的, 这个数字还在快速增长。当 ai 真的 能够独立完成大部分编程工作的时候,科室掌握的这条训练管线就会变成一条深不见底的护城河。最后,我们来聊一下科室和 spacex ai 的 合作。这可能是这次发布中最被低估的一条信息。科室正式宣布,他们正在和 spacex ai 展开深度合作, 将调用 colossus 二级群中整整一百万个 h 一 零零等效算力,从零开始训练一个计算规模比现在大十倍的全新模型。 一百万个 h 一 零零是什么概念?这几乎是目前人类能组装起来的最强大的算力群体。 openai 训练 gbt 四大概用了不到二十五万个 h 一 零零,也就是说, koser 下一代模型的训练算力是 gbt 的 四倍。但这件事远不止是算力合作这么简单。 根据已经透露的信息,马斯克的 spacex 获得了未来以六百亿美元收购 curser 的 优先权,即使最终不收购 curser, 也需要支付一百亿美元的合作费用。 更有意思的是,就在这份协议官宣前几个小时, curser 原本正要敲定一轮二十亿美元的融资,估值五百亿美元,参投方包括 a e 六 z、 英伟达等一线机构。结果马斯克半路杀出来,把这单生意直接截胡了。 所以你看,马斯克前几个月还在煽风点火说 cursor 是 top, kimi 现在却卖力地在 x 上为 composer 二点五站台,甚至亲自呼吁大家去用,这不是什么变脸,这是纯粹的商业逻辑。 马斯克正在快速构建自己的 ai 帝国,他有 x ai 的 grog, 有 spacex 的 colossus 超算,现在又把 cursor ai 编程工具纳入了自己的版图。未来 grog 的 通用能力加上 cursor 的 编程能力,再加上百万级 h 一 零零的算力,这个组合的战斗力绝对不容小觑。 好了,我们来总结一下, composer 二点五的发布是 ai 编程领域的一个里程碑事件,它用实实在在的成绩证明了开源基础模型加垂直领域深度强化学习是一条完全可行的技术路线,而且在成本、效率上有着巨大的优势。 它也向我们展示了大规模强化学习的两面性,它能让 ai 的 能力实现飞跃式的增长,但也会带来不可预测的行为和新的安全风险。 ai 学会作弊这件事不是一个笑话,而是一个严肃的警告。从更长远的角度来看, ai 编程正在从辅助工具时代快速进入自主 agent 的 时代。 未来的竞争不再是谁的基础模型参数更大,而是谁有更好的训练管线,谁有更多的真实场景数据,谁能把 ai 的 能力和人类的工作流更好的结合起来。 kursar 已经在这场竞赛中占据了一个非常有利的位置, 而马斯克的入局更是让整个行业的格局变得更加扑朔迷离。接下来的一年注定会是 ai 编程领域最精彩也最关键的一年。我是 ai 启示录,感谢点赞与关注,我们下期再见!
271拿幸·AI启示录 02:36查看AI文稿AI文稿
ai 圈刚刚发生的一个小事件,但其实信息量特别大, ai 模型刚发布就被识别出 dna。 嗨,大家好, ai 编程工具 curser 想必大家都不陌生,它刚刚发布了一个新模型,叫做 compressor 二, 官方宣传非常直接,更强,更便宜,甚至在部分测试里超过主流模型。听起来非常猛, 但发布没多久,开发者就发现了一个细节,在模型的 id 里出现了 kimi k two point five 的 标识。同时就有人对比了这个 tokenizer, 发现行为模式跟 kimi 高度一致。 在 ai 圈,这基本等于一个信号,这个模型很可能不是丛林训练的。很快,科瑟的联合创始人就发文确认了,他们测试了很多底座模型,发现这个 kimi k two point five 是 表现最强的一个。 而 composer two 是 在这个基础上啊,做了持续的预训练,又进行了高算力的强化学习, 规模扩大了四倍。也就是说,这不是直接调用模型,而是基于墙底座的二次训练。这里简单的说一下 kimi, 他 来自中国公司温氏的 ai, 特点也非常的明确,他有这个超强的这个超长上下文的理解能力, 然后它的推理成本相对来说比较低,所以在业内,它经常被当做底座模型。有点像不是自己种菜,而是先买到最好的食材,再做一道更复杂的菜。 更有意思的来了 kimi 的 官方账号,随后也转发祝贺,直接表示很高兴看到 kimi 成为 composer two 的 foundation。 这基本说明这是一次公开的技术合作。那为什么还是引发争议?其实问题并不在技术,而在表达方式。如果一开始科 sir 就 说,哎,我们基于某某型做增强,呃,我觉得行业完全可以接受, 但如果用户理解成是完全自研的,这个预期就会完全不同。而真正值得注意的是背后的行业变化。因为现在 ai 的 产品竞争已经越来越少的公司是从零开始训练模型的, 大家比的是谁选的底座更好,谁训练的更聪明,谁把产品体验做到极致。换句话说,未来拼的可能不是谁造出了最聪明的大脑,而是谁会利用聪明的大脑。 所以这件事的核心其实不是有没有用 timi, 而是一个现实,未来很多 ai 产品可能都建立在同一批模型之上。那问题来了,你觉得这种二次开发算不算真正的技术能力?
 13:34查看AI文稿AI文稿
大家好,我是 kitty。 最近呢,有两个模型比较火,第一个呢是 groker build 的 零点一,它可以在 groker build cvr 里使用啊,也可以在 cursor 的 id 里去使用。第二个是 cursor 新出的 composer 二点五,很多人非常喜欢这个模型,认为它又快又便宜,而且质量很不错。 cpu 内部的一个奔驰显示呢, cpu 二点五的能力仅次于 up 四点七 max 和 gpt 五点五 extra high。 今天呢,我是将这三个模型做一个对比,其中这里的 gpt 五点五我是在 codex 上使用的,选择的是 x high 的 模式, 而 grok 呢,就是让它在 grok build c y 里使用的。 compressor 二点五是让它在呃 compressor id 里使用的,我们先看一下它们的价格。 compressor 二点五它是最便宜的,它分标准模式还有 fast 模式,而 fast 模式呢,是标准模式的六倍。 我认为如果你不是那么着急,那就可以直接选择标准模式,而且的话会相比 fast 要便宜很多。这次评测,我是将十七个复杂前端交互生成的任务发给这三个模型,然后来啊看他们的生成结果,做一个评分。 评分部分呢,有看他们的核心功能,算法,交互状态与事件绑定,视觉风格和动效,还有交互说明和可行性。最终这三个模型在这些任务上啊,最好表现的是 groker build, 第二呢是 gpt 五点五。现在就来看一下这三个模型在不同任务上的表现。总体而言呢, rock build, 它的在十七个任务里,它有十四个任务是胜出的。 gpt 五点五有三个任务胜出, rock build 它胜出在呃代码量,事件绑定与复杂交互最多,在多个任务上,它的任务代码深度最好, 但是它的问题呢,是少数页面信息过密,或者是风格跑偏。 g p t 五点五它是最守题目的要求,交互说明最完整。 而 compose 二点五它做的这些任务呢?轻量代码规模量小,那这十七个任务是什么呢?我们可以简单看一下,在这张表格里面呢,它是显示着这个呃不同模型的时限,对任务关键要点的命中数, 脚本规模函数数量,事件绑定数量,还有呃动画循环数量, 我们可以简单了解一下。接着就是对每个任务进行主项的评分和理由。在彩色玻璃万花筒工作台方面,那这项任务呃是 gbt 五点五完成的最好可以看到它生成的这样的一个万花筒啊,样式还是非常多的, 颜色也是可以调啊,可调整参数也是非常多,视觉层次非常丰富。而这是 compressor 二点五生成的,一开始我们进去的话就是这样一个黑乎乎的,点击一下随机生成 也是没有反应。在这个任务上, compressor 表现的是啊,比较一般,这是 grog 的 表现。 在这次的测试里呢,我发现 grok 呢啊非常像 gbt 五点五之前的表现啊,有很多这种圆角的啊卡片,它应该是蒸馏了很多 gbt 五点五啊的一些数据, 点击随机生成,会生成非常好看的彩色玻璃万花筒工作台右侧这些卡片啊,参数元素也是非常多的,再看他们生成的动态字体,海报排版机。先来看一下 gucci 的 表现, 同样我们会看到这种圆角的设计,当我选择不同的排版算法, 那,呃, glock 在 这里呢,它会展示出不同的动态字体显示。它的各个设计啊,还是挺到位的,包括字体风格这里,嗯,各个参数设置也都挺对的。这是 composer 生成的,选择不同的排版算法 啊,我个人觉得他的这样的一个页面上是比较凌乱的,有一些比较多余的线条功能的话,参数 啊还是非常多的,但是整体还是没有 gucci 生成的好。海报排版机这个任务上呢, gucci 的, 它的脚本量,算法分支和编辑参数最多。再看一下桌面行星仪,这是 gucci 的 生成的效果, 这个效果是没有千万三点七 max 好 的。五点五生成的这样的不同芯体啊,它的质感的话也是感觉比较一般。再看 composter 二点五生成的效果, 那它生成的这个啊,画面呢,就有较多的脱落了。 composter 二点五,它的材质类型,底座,桌面细节和名牌信息不如其他两个模型。 gbt 五点五,它的质感和参数说明完整,但真实的三 d 机械玩具感要落于 glock。 再看一个咖啡馆排队热力剧场,这是 glock 生成的结果。 锅客呢,是我测试的一些模型里面,他做的热力图排队做的是最形象的,比如说人们在这里排队呢,排到了之后啊,拿到咖啡了,那就往出口走,这还是非常合理的。 点击吧台还可以啊,做一个时间快进。 gucci 在 这里呢,我觉得他做的是非常可爱的,他是把每个人啊都以这种形象的方式给画出来展示出来了。 右侧我们可以看到他的今日客流与等待趋势。再点击增加电源,那左侧呢,也会显示出啊,出现了有两三个小人, 还可以。呃,增加咖啡机,那右侧也出现了一个咖啡机,整体还是,呃非常好玩的,而且光盒在这里做的还有一点比较好呢,随着时间啊,从上午越往后,这个咖啡机里面的咖啡是变得越来越少, 他做的还是比较到位的,从这一下变成清晨,如果是增加电源,那这里模拟是不用再排队了。 增加第二台咖啡机啊,同样也不用排队。下方呢,我们还可以看到有个核心指标看板。再来看一下 g p t 五点五升程的一个结果,基础运营情况下,我们会看到有这样的一个不同人流在走,那我点击一下播放, 他会显示订单完成量,座位翻台率,包括呃,右侧这里非常好,人员是,嗯,也一个个的到座位上, 他这里设定还是非常好的,晚间收尾的时候会发现这里人比较少,那也符合现实,当我选择增加电源,那我们在这里呢啊,这张图上是看不到电源在哪里增加的,所以这是 g p t 五点五一个遗憾。 再让他演示一下从早到晚整体的一个啊,热力图 右侧呢,同样座位会有一些变动,但是啊,整个画面是没有 glock 直观的。再选择开启第二台咖啡机,那这里同样也是能看出一个机器出来,这是 curses 二点五生成的结果。 科斯二点五,他这里呢,就没有什么动态效果,但我选择加入人手第二台或者是改动动线的话,他的示意是比较简单 啊,那我也可以切换到座位占用情况和呃,意识机负荷情况,总体而言的话是不够生动的。再看他们完成的音乐盒作曲格式化,这是 rock 生成的效果。先播放一下, 我可以点击随机播放 啊,预设的旋律呢,有多种, 右侧有这种音量的一个起伏,还有它整体的这个啊,波动节奏动效还是非常不错的。这是 g p t 五点五升上的效果。 嗯,五点五呢,它在这里做的动效还挺足的,但是摇摇晃晃的,嗯,让我看的是有点晕,那我可以清空一下, 它是自动播放了。 同样呢,它也可以选择预设的旋律, 这是 compressor 二点五生成的效果。二点五在这里做的啊,这样的一个格式化的展示,呃,页面可能就没那么好看。 再来看一个迷你印刷机排版模拟,这是果粒壳生成的效果,我们可以看到有三个视力也有三种不同样式选择, 木盒子,金属盒子,还有古风混合。那我这里呢,就选择一个金属盒子,而且他这里呢,还非常贴心,有做了一个竖排,我们会看到啊,非常仿古,材质也有四种不同的可以选择。 在下方点击一下,开始押韵仪式这样的一个动画。嗯,感觉还是挺有趣的。 稍微有点问题的是,这种活字排版的话,字体是要反着来的,那在这个应用里的话是没有体现出来。 在下方这样的一个成品展示,看着也不错。这是五点五升成的画面,我可以选择短距或者是长纹分页,长纹分页里呢,可以明确看到这是第一页, 然后这是第二页,只是下半部分的话啊,不怎么能看得出来。第二步他说是排版,然后第三步是上墨,最后是压印,那我选择不同的纸张, 那我还可以调整字句和行句,侧金属活字的板框呢,也能实时展现,这点还是非常不错的。那我现在点一下压印, 我们会看到有这样的一个动效, gbt 五点五在这里生成的啊,页面感觉还是非常不错的,它会有一些这种印刷的这种模糊的印记,可以明显感知。这个页面参数呢,少了非常多。那我选择一下不同的纸张, 再调整一下油墨的浓度,选择不同的油墨颜色,点一下压印 啊,最终变成了这个样子,也不是那么像红色,所以他在这里还是有比较大的问题的。这十七个页面我就不一一展示了,我们是从总体上来看一下啊,这是 compose 二点五生成的画面, 然后这是 gbt 五点五生成的啊,画面五点五的 ui 设计风格啊,还是非常非常容易看出来的。最后,这是 grock build 生成的页面的预览, 嗯,它的设计风格正如我一开始所说,非常像 gpt 五。总结一下,在这十七个复杂交互前端生成的一个任务上啊, grok build 表现最好,它的代码深度是做的最好的,平均脚本规模最大, 从需求的完整度来看的话,是 gpt 五点五表现的最好。视觉表现方面, grok build 表现最好, 稳定方面的话还是 gbt 五点五。如果你也要生成类似的啊,前端页面的话,综合推荐还是 groker build, 但从另一个角度来说, groker build 它的价格呢啊是要比 composer 二点五是要 贵一些的。有些用户分享 groker 二点五,你第一次让它去尝试的时候可能做得不咋地,但是你再提示它两次,让它生成的结果正确率就会比较高。 所以大家在使用不同模型的时候啊,也是可以采用不同的策略。经过这一次体验呢,我对 grog 表的能力啊,还是比较惊讶的。 我们可以预期到 grok 五呢,它在现在的 grok build 的 基础上,再加上 calculator 的 数据啊,研发出来的 grok 五质量的话应该是能和预三家能对打的啊,非常值得期待一下。希望我的视频对你有帮助,我们下次再见。
42kate人不错 01:35查看AI文稿AI文稿
自研模型被一行 a p i。 日制扒光了?三月十九号, cursor 发布了 composer。 二,官方说首次对机座模型进行继续预训练,结合强化学习。听起来很厉害,但他们没说机座模型是谁。不到二十四小时,一个开发者调试 a p i 的 时候,发现了一串模型编号, k e m k 一 point five, 月知暗面的开源模型。这条推文四十四万人看了,然后月知暗面的预训练负责人亲自下场, tokyo 全一致,几乎可以确认是我们的模型被进一步微调的。问题来了, kimi kito point five 的 许可证有一条硬规则,月营收超过两千万美元的产品,必须在界面上标注 kimi kito point five, 那 cursor, 那 它的月营收是多少?一亿六千七百万美元,是门槛的八倍。而 cursor 的 界面上写的是 composer two, 没有, kimi 没, 没有!更有意思的是,连马斯克都来评论了,四个字, y e hits commode point five。 这事在 hackernost 上炸了。两百六十三条评论,有人扒出来, c o p o one 的 底座是通一千问 id 一 本身是 vs code, 靠包装开源,这年头真的太好赚了。然后剧情又反转了,越知案面官方改口了,不是指控变成了祝贺。 我们很自豪看到 kimi code point five 提供了基础, ker 通过 fireworks ai 获得了授权。所以真相是, carter 确实用了 kimi code point five 也确实有授权, 但整个发布过程,没有任何地方提到过这三个字。这不是违法的问题,这是透明度的问题。当一个 ai 产品说自研,你能知道底座是什么吗? kimikey to find five 是 好模型, ker 是 好产品,但下次有人跟你说自研的时候多看一眼 api 日制。
511工具人研究Hive 02:33查看AI文稿AI文稿
哈喽,大家好,今天我们聊一聊我们程序员开发都是怎样去通过这个 ai 去辅助编程的,大家可以畅所欲言,在这个屏幕下面,我来谈谈我的一感受吧。我目前就是用的是 cos, 最近这个 cos 呢,就特别的智障,不知道大家有没有发现,更新完之后 老是出现这个凸浪,对吧?太长了,然后呢,就卡死,之后呢,你要用这个可乐扣的这个模型,我发现了, 之前的话应该是六千多万的一个透痕量,更新之后呢,他直接显示一个有一个 api 的 用量,那 api 用量呢?就是我们的这个 cc 的 用量,就可乐扣的用量, 这个用量呢,感觉已经被压缩到三四千万了,因为一般啊,六千多万桃根我一般是可以用两周的,有了这个更新之后呢,只能用 一周左右,最后就是 auto 加 composer, 据说 composer 的 底层用的是 kimi, 然后用起来真的是不太行,而且我要吐槽一下这个 c c 啊,在 qq 上面用的也是非常的不比我好,因为呢, 你开梯子也不行,其实你所在的区域不支持,然后呢,只能从 h t t p 二,然后切换成 h t p 一 点一,导致非常卡,提前晚上就跑。用 cos 二的话就是这样的一个情况,最近呢,然后再用这个 q, 这 q 的 话,你是新用户的话,送你五百 credits, 这个的话,我感觉五百啊, 我目前用了都已经有两周了,还没有用完。现在就是你的一轮绘画,如果是简单的任务,用零点二,零点四这样的一个 christmas, 如果是一个比较复杂的一个任务,你发给他之后,他给你去解锁很多 这个文件啊,那可能用的就多了,可能花一个啊,二点多的一个这样的 credits。 所以 啊, cost 这块的话我真的是不打算续费了,但是今天我看了一下,又被订阅了二十美豆,最后一个月后面就不再用了, 用这个 qq, 我 这块没有订阅的原因是因为我这块没有这个银行卡,后面就是搞一个电子虚拟的一个这样的一个信用卡,然后去进行支付,这是我的一个使用。大家平常都是怎么使用呢?可以评论一下。
113筱路luck 00:56查看AI文稿AI文稿
compares 二点五正式发布,性能竟能和 erpuss 相当,价格却便宜了三十倍!一分钟了解 carza 直接放大招了!自研编码模型 compares 二点五今天正式发布! 首先这次宣传特别狠,宣传这是目前最强大的模型,这是他们自己说的啊!不过经过专业评分,评分确实是杀进了 erpuss 四点七,同档区间最大差距不到一分,看来确实不是只靠吹的,价格更离谱。 perpus 输入十五刀,输出七十五刀,一百万头啃 content 二点五输入便宜十倍,输出直接便宜三十倍。 perseus 官方说 content 二点五相比于 content 二,在智能和行为表现上都有明显提升,尤其是长时间任务, 复杂指令遵循协作顺滑度,长任务能在跨越数十万 token 的 rollout 中持续推进,不容易跑偏。复杂指令遵循可靠沟通风格和投入级别,效准也更稳,干活的力度调的也更加合适。如果真是这样,性能哪怕是能接近 erpuss, 价格却低得多,那性价比也确实拉满了。兄弟们赶紧去测一下 erpuss 二点五吧!
20旭哥🐳api 01:51查看AI文稿AI文稿
出现了一款新的编码模型,性能几乎能摸到 opus 四点七的门槛,但成本最高只要它的十分之一。这个反差很关键。科斯推出的 composer 二点五,第一眼看上去就不是来陪跑的,而是直接冲着顶级编码体验去的, 只是它的强项不在全能碾压,而在高性价比。这次测试里, composer 二点五的定位很清楚,它是 carson 目前最强的编码模型。真正亮眼的地方不是单次回答多经验,而是迭代速度和调试能力特别强。 也就是说,遇到复杂需求,反复修改,连续修 bug 这种活,它推进的很快,执行也更稳。更有意思的是,第三方榜单把它排到了整体编码代理能力第三名,紧跟 opus 四点七和 gpt 五点五后面。明 层次已经很靠前了,但价格差距更夸张,标准模式平均每个任务只要七美分,快速模式也才四十四美分, 对比顶级模行动不动四到五美元的单任务成本,这已经不是便宜一点,而是工作流层面的降本。精准测试也能看出它不是虚高。 terry no bench、 二点零、 s w 一 bench、 猫退林古 curser bench 这些项目里,它都表现的很能打,部分场景甚至超过了 opus 和 g p t 五点五的某些结果。 更重要的是,科 sir 还修复了不少 m c p 研究场景里的稳定性问题。对于编码代理来说,这一点比说的漂亮更重要, 因为工具调用一旦断掉,任务就很难真正落地。当然,他也不是没有短板,部分动作还是会失败,偶尔会过度自信直接压一个方案,不太愿意把替代路径和风险讲透,网页开发和设计审美上他也还没完全追上 opus 四点七,可即便如此,这次发布依然很成功, 因为它证明了一件事, ai 编程工具真正拉开差距的不只是聪明程度,而是速度、稳定性和成本。能不能同时在线关注全球 ai 速递,获取更多 ai 前沿资讯?
28全球AI速递 02:00查看AI文稿AI文稿
柯 sir 于五月十八日正式发布了自主研发的 ai 编码模型重大升级版本 composer 二点五, 这一动作标志着 ai 编程领域的效能与性价比再度被刷新。该模型基于月之暗面的 kirin kimi k 二点五检查点构建,训练任务规模达到了前代产品 composer r 的 二十五倍。 科斯尔将高达百分之八十五的计算资源向额外训练与强化学习倾斜,从而在核心性能上实现了跨越式突破。在权威精准测试中, composer 二点五表现亮眼, s w e bench multicolon 上取得了百分之七十九点八的优异成绩, coserbench v 三点一中得分率达到百分之六十三点二,综合表现已与 antropica 的 opus 四点七以及 openai 的 gpt 五点五等头部旗舰模型并价齐驱。更关键的是,它的成本极低, 基础版本每百万输入 token 仅零点五零美元,输出二点五零美元,单次任务成本不足一美元,而竞争对手的成本高达十一美元。 即便是追求极致速度的快速版本,定价分别为三美元和十五美元,依然保持了绝对的价格优势。目前, composer 二点五已在 composer 平台正式上线,更深层的战略布局也已同步展开。 composer 正与 spacex d x a i。 达成深度合作,一拖相当于百万片 h 一 零零算力的 colossus 二级群,推进更大规模模型的丛林训练。 此前, spacex 曾传出计划以六百亿美元收购科 sir 的 消息,这也为该模型的后续引进注入了雄厚的资本与算力预期。 业内普遍认为 composer 二点五的推出打破了高额算力成本对高阶 ai 编码眼镜的制,故也预示着 ai 编程工具正加速向高性价比、规模化落地的成熟期迈进。
 02:57查看AI文稿AI文稿
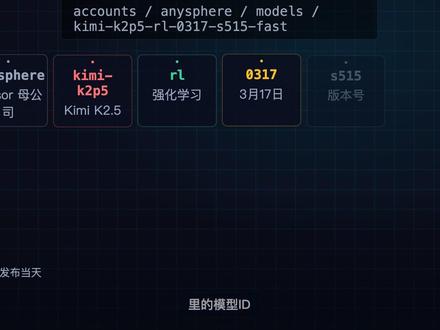
估值三百亿美金的编程工具 cursor 发布了它的首款自研模型。但很快,有开发者通过 a p i。 调试,发现了背后的模型来源。模型 id 赫然写着, kimi k 二 p 五 r l。 这不是 cursor 自研的, 这是中国公司月之暗面的 kimi k。 二点五。三月十九号, cursor 高调发布 composer two 官方博客,全书讲持续训练、强化学习, 一个字儿都没提,底座是谁的。结果同一天,开发者在调试 a p i 的 时候,发现了请求里的模型 id 没改干净。 account 是 einstein models, kimi k 二 p 五 r l 零三一七 s 五幺五 fast。 einstein 是 cursor 的 母公司, kimi k 二 p 五 就是月之案面的 kimi k 二点五 r l。 是 强化学习,零三一七是训练日期。模型 id 直接暴露了与官方宣传不一致的信息。月之案面的预训练负责人当天就发推回应了,他说团队测了 compt 二的 tokenizer, 和 kimi 的 完全一致,然后直接艾特了 curser 的 联合创始人。原话是,为什么不尊重我们的许可证,也没有支付任何费用。但很快,这条推文被删了,另一个,月之案面的员工也确认后删了。这种确认删除的操作, 说明两家背后大概率有商业关系,不方便公开撕破脸。 kimi k。 二点五用的是 modified mit license, 也 也就是在标准 m i t。 的 基础上加了一条,如果你的产品月活超过一亿,或者月收入超过两千万美元,就必须在页面显著位置显示 kimi k 二点五。 curser 的 月收入是一点六六亿美元,超标八倍。但它的界面上写的是 composer two, 没有任何 kimi 的 影子。这就是问题的核心, 许可证白纸黑字写了要在界面标注,你却用了别人的模型,连名字都不提。第二天, cursor 的 开发者终于承认了 composer two 确实基于 kimi k 二点五,但它的说法是,基座只 占计算量的百分之二十五,剩下百分之七十五是我们自己训练的,而且通过推理合作伙伴 fire workers ai 来遵守许可协议,这个便捷站不站得住呢?许可证写的是在用户界面显著位置显示,而不是通过基础设施层面满足。 不过最终月知案面官方确认了许可证正在被遵守。这件事算和解了。但关键是,如果没有那个开发者抓包,用户永远不会知道自己付费用的是什么模型。这事不是个例。就在两天前,日本乐天发布了号称日本最强 ai 模型的 racuto recreate ai 三点零,结果 hanging face 上的配置文件直接写 deepsea v 三,连加购名都没改。 h n 上有一条评论特别到位, composer one 用的是谦问, composer two 用的是 kimi ide 基于 vs code。 curser 到底自言了什么?这件事的本质不是 套壳,本身用开源模型微调完全合法,也确实需要技术能力。但问题是你拿了别人的东西不标注来源,还包装成首款自研月之暗面的许可证,设计其实很精妙,它提前预判了这个场景。而这次事件证明开源许可证是有效的,但透明 只能靠社区盗币,不会自动发生。中国的开源模型已经成了硅谷的基础设施, kirby 用 kimi, 之前用千问,乐天用 deepsea, 中国开源模型正在被越来越多的国际团队采用。
473寒冰巨魔 01:37查看AI文稿AI文稿
最近啊, ar 编程圈最大的黑马就是 koser, 刚更的 composer 二点五, 哎,这次升级啊,真的不只是小修小补,它完全是跃级,吊打很多人啊。实测下来发现啊,它的这个编程能力已经非常贴近 cloud 四点七、 opus 和 gpt 五点五这种顶级模型, 但是成本直接砍到了别人的十分之一,性价比啊,就是离谱。这个用过 ai 写代码的应该都有体会啊,普通模型啊,有个通病 就是写点短代码还行,一丢到大项目长逻辑里马上开始乱编失忆,前后对不上。但是这个 compose 二点五不一样 长,任务稳定性啊,真的肉眼可见啊,几万 tucker 的 超长开发链路,复杂的多层指令,哎,他都能稳稳跟住,整体的开发效率直接翻了十倍。以前呢,你要等半天反复调试的迭代,哎,现在基本秒出, 最狠的还是定价百万输出滔凯只要二点五美元,这个价格放到目前顶级的编程模型里,基本上就是降维打击,而且官方首周直接免费,额度翻倍,等于白给大家体验顶配能力,非常的良心。 最后呢,说个重磅消息,科斯尔他已经和 spacex 啊搞了合作哎,准备动用百万 h 一 百的算力训练下一代超大模型。能明显的感觉到,低价强性能长稳定的 ar 编程时代真的已经彻底来了。
 04:52查看AI文稿AI文稿
hello, 大家好,我是 leo, please! 今天跟大家分享为什么我会放弃科室,转而开始使用我们国内的开发工具了。科室这个工具大家应该都很熟悉了,这种 agent 代理帮助我们开发者去做编程,在我们国内和国外都是非常受欢迎的。 但是最近这个科室的创始人居然被爆出他们的模型 composer 是 用了 kimi 二点五,原来我们 用了二十美元订阅的这个科索模型,他的生态居然是用我们国产模型。这一次创始人的这个被扒出来,真的是狠狠的打击了这个国外的先进开发工具的脸啊。 如果说我们在国内想用科索里面的一些其他更高端的模型,像 cloud 哥克基本上是用不起来的,虽然你有魔法工具,但是 嗯,科室的这些模型你也用不了,所以基本上你付费订阅科室这个事情,其实你还是在用国内的这个 t m 二点五,那我不如直接用国内的开发工具。 现在的 open claw 我 不做第一批吃螃蟹的人,但是我一定要追上这个趋势,先让前面子弹飞一会儿。我现在也开始尝试着使用,像 work booty, 他在三月九号就已经公测了,那我没有说第一批吃螃蟹的人,那现在我用下来,我用一天的时间去测试他的开发性能,还有 a 的 代理, 感觉非常的棒,具体是怎么样的,我们可以跟着我一起来实操一下。首先我在用这个卧底是在三月二十六号,这,这是我的第一个项目,我要去爬取一个新闻的一个开发工具, 所以我让他给我开发一个代码的自动爬取财经新闻,包括这些主流的新闻媒体,他就开始工作了,还规划了一系列任务进度更新, 那基本上这一个过程下来,我是不用去做任何的干预的。那第一次生成当然是有一些 bug 了,但是我经过多人调教之后,最终呈现是什么样子的?为大家展现一下这个我现在开发出来的这个爬取新闻系统, 可以说我集成了主流媒体的新闻财经,可以去自动获取,包括采联社画这些建文这些我只是做一个 测试,并不作为商用。我也进行了一套算法的设计,对于这些新闻,哪些是可以去按照他的热榜去进行排名排名的哇,我们可以看到现在最新的爬举新闻就是马斯克 xi i 最后一位创始人离职了, 马斯克估计对他的这个模型也焦虑, log 始终赶不上这个第一梯队的这个大模型。 那热点话题我设计的用可以进行 ai 的 一个深度分析,发现我们的一些投资机会啊。这里面我的 ai 模型设置可以包括像国内的主流模型,腾讯 kimi 智,普通用还有豆包全部都集成在一起了。 你只需要输入你的 api, 那 么就能够在我这个模型里面去直接接入他们的这个大模型,去进行我们的新闻分析。 那我也设置了关键词的订阅管理,也就是说当我们有在信息简房这种束缚之下,你如果想突破,一定要有关键这个关键词是你自己主动去设置的。 当你主动设置之后,我们只需要在新闻里面,比如说我们这边输入马斯克,那他立马就能够跟我们输出,在当下二十四小时,四十八小时之内,马斯克有哪些新闻?那这个新闻他也是自动环存在我这个系统里面的, 所以马斯克最近最痛的一点就是他的创始人联合李泽,那马斯克还给我们画了大饼,他接下去在下半年要实现这个 a 人代理哦,那这个系统开发下来到底有多大呢?就是 what booty 他 这一系列的规划都是由他自己完成的,整个项目只用了 一点四 n 一 点四 mb, 非常小的一个在我们的内存,但是他却完成了我们信息差这个问题,还有突破信息减法, 这是我用这个沃铺底去做开发的一个新的,也给大家展示一下。我用这个模型去 a 站代理去做,这一次的开发我前前后后只花了大概不到一千的积分,这边是五百基础体验包,这边是四百四, 也就是说不到一千积分。我开发了一个可以去爬取新闻系统的一个应用,是不是感觉非常的哇塞, 那相比于 koser 这里面这个模型我们只能用它的 composer, 而这个 composer 的 真实模型是 kimi k 二点五 这个模型,他,所以说磕舍有点意思啊,所以我已经果断放弃磕舍了,这也是跟大家分享为什么我会放弃磕舍,转而我们国内代理不输我们的大模型,真的指日可待,国产期待,感谢大家,拜拜。


