confy ui仅模型怎么使用
粉丝3.2万获赞50.4万
相关视频
 06:15查看AI文稿AI文稿
hello, 小 伙伴们大家好,那么一直以来在 confluence 里边对我们的图片和视频进行放大呢,是一个刚需哈,那这次英伟达呢,它就带来了一个非常高效的这样一个放大工具啊,我们看一下 啊,就是这个 nvidia rtx note confluence 啊,这个是英伟达自己开发这么一个 confluence 节点啊,它其实功能就是一个,就是放大哈超分。 那么整个这个节点的安装呢?呃,它这边项目里面介绍的是我们直接去管理器,然后搜索 rtx 就 能搜到它这个项目哈,也可以正常地通过我们这个 git ur 安装哈,也可以。 那么这里有一点要注意一下,安装这个节点的时候,它会有一个呃,有一个依赖哈,依赖的话其实就是需要装这么一个 nvdia 的 vfx, 那 么这个安装呢?如果说你之前没有装这个依赖呢?那会稍微有点麻烦啊,就是说升级你的 type 和构建工具啊,其实就是你的轮子文件的构建工具啊,命令就在这里啊,命令就在这里, 那么还需要去呃把这个编辑轮子文件的这个相关的依赖呢,也进行一下升级啊,然后再执行我们这个命令就可以了, 就能够正常去安装这个依赖,然后就可以使用了啊,不然的话他可能会报错啊,那么我们看一下他这个核心节点,其实就这一个哈,这个使用起来的话,参数非常简单,第一就是他的一个缩放的一个方式啊,第一种就是说按照比例等比例缩放,第二种呢就是按照我们的输入尺寸缩放啊, 那我们可以看一下按照比例缩放的话,一般是我们常用的,对吧?就是说保持我们原图的比例或者原视频的比例,那如果是你要说按照你的目标的一个尺寸缩放,你就要需要手动的这边去输入这个尺寸啊, ok, 那 么下一个就是如果你选择了按比例缩放,那么就有一个比例选择啊,一倍、二倍,那么最大它是可以放到四倍啊,再大就放不了了啊, 再大放不了,最大就是四倍。然后下面就是一个质量选择啊,一个低质量,一个中等质量,一个高质量,还有一个 alt 啊,就是超高质量,你肯定我们就会选 alt 嘛,因为它非常非常快啊。一个图片的话,我们看一下啊,图片,我们这张就是爱大王的这张图啊,从六百多像素 直接放大四倍啊,图片我就直接放大四倍,我们可以看一下这个对比啊,这是原图,那么这个是放大后的啊, 他跟我们现有的一些的放大工具有哪些差异呢?我们也可以看一下啊,这是他的一个跟原图的一个对比,那么他跟我们常用的一些放大模型的一个对比呢?我这边也做了一下啊,比如说我们这个四倍常用的这个显示放大的模型,还有我常用的一个就是说 n m k d 这个赛两百 k, 这个哈,都做了个对比,我们先看一下这个跟我们这个普通的四倍的做一个对比的这个图哈,如果是用四倍这个写实类的放大呢?我们看啊,它的这个面部这些细节就会消失啊,服装的细节也都消失了哈, 他就有这种重绘的强度啊,就会把这个重绘的太厉害了,整个的话会显得非常油啊,那么这个英伟达这个新的呢,他就会保持这些细节保持比较好啊, 那么如果跟我们之前我常用的两百 k 呢来对比啊,我们看一下这个还是英伟达的这个啊,两百 k 的 好,它的细节 也的丰富程度也差不多哈。呃,而且呢显得图片更锐利些,但是他会有一点问题,我估计大家以前都遇到过啊,就是他这种细节会有点乱啊,这种地方会出现比较乱的细节啊,像这种地方也是啊,都是比较乱啊,他会有过分的一个涂抹感, 就经常会出现这种,但是这些地方呢,他就会表现更好一些啊,各取所需啊,这都是两百 k 这个模型经常会出现的一些问题, 那么其实这样就是建议大家做一个选择,但是我要说的一点啊,他这个速度非常快啊,他这边在我这边用五零九零 d 显卡的话,放大一张图,四倍放大只需要零点四秒到零点五秒哈, 我们这两个普通的模型放大速度都是他的好几倍啊,特别是个两百 k 放大啊,差不多要十几二十秒。 ok, 那 我们再来说一下这个视频放大,视频放大也是同样非常简单哈,直接加载我们的视频,然后把这个视频针直接放过来就行了哈,同样选择我们的这个倍数放大,然后选择两倍哈, 你选四倍也可以。那我们看一下他这边放大一个幺二八零乘七二零啊,二百四十一针的这样一个视频,他只用了八秒啊,放大到了一个二五六零的这样一个啊,我们看看二五六零乘幺四四零,只用了八秒哈,非常非常快。 再来我们看一下他这个一个对比啊,这个是我们原视频,原视频哈,原视频的话手针就是这样了哈,大家看一下这个服装的细节啊,这些服装的细节啊,包括这个马面裙这下边的细节,我们再来看他这个细节哈, 对吧?要比原来那个普通的锐利多啊,毕竟我们分辨率都上来了,包括这些纹理啊,也更明显。 那么它跟我们之前的一个比较知名的一个 flash vsr 对 比一下呢,我们也看一下啊, flash vsr 它的效果也不错,但是我们会发现它有个问题,它会把这种模糊的人脸,对吧?给它强行的去做这种,就是换成真的,因为它这个重绘的比较厉害啊, 这就是它的一个特点,它会尽量保持原图的一个或者原视频的一个整个质感哈,然后去进行这样一个尺寸的放大。 大家可能也会发现他这样有一些特点啊,就是他不会去对原来的视频或者图片进行一个过度的重绘啊, 所以说如果你的原图,比如说像我们这张啊,你原图本身就比较模糊的情况下,那么他放大以后本身也会比较模糊啊,即便是放大到高分辨率以后啊,他不是说把那种模糊图片变清晰,你看一下,即便是放大分辨率,他也只是局部的提升一些细节,而没有说让整个边缘变得更加锐利。 当然对于我们这种视频本身就呃细节比较多的情况下呢,它放大以后效果就比较好啊,大家可以试一试啊。那么这个节点呢,我也给温总那边说了啊, running hip 也会,今天晚上就会上啊。 ok, 那 么就给大家分享到这里。
125Aiwood爱屋研究室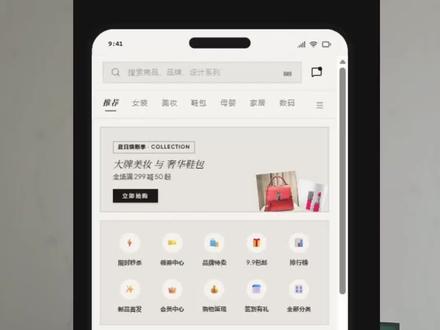 00:35查看AI文稿AI文稿
这是我花十分钟三个步骤做出来的 app 前端界面,可以看到界面都是可交互的,效果也是非常不错。来,我们直接上实操,给我三十秒,让你学会到底怎么做的。第一步,把你的产品需求文档发给 shift gpt, 让它给你生成 app 前端界面设计稿,你会得到这样的图片, 我们把这张图片下载下来。第二步,打开谷歌的 as do do 左上角,点击 build, 在 聊天框上传刚才的图片,让它生成 app 前端代码,中间会让你选择一次界面风格,你可以跳过,也可以选择一个自己喜欢的风格, 最终你就会得到视频开头展示的效果。最后一步,下载代码,刚才的代码只是纯前端逻辑,后续的开发和细节优化交给 cloud code 或者其他 agent 的 就行了。
553永远乐观的允执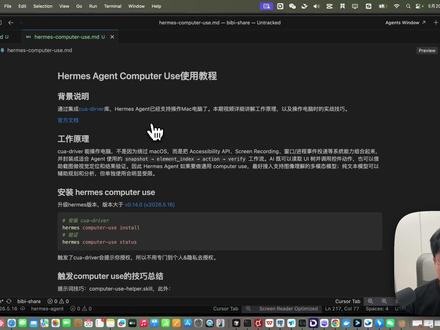 18:25查看AI文稿AI文稿
哈喽,同学们大家好,我是木贤,本期视频为同学们分享 harmony 的 computer user 的 使用教程,我们来了解一下背景, harmony 的 它通过去集成了一个叫 c u v driver 的 库,它就可以去操作 mac 电脑了。这个是 harmony 的 官方文档的说明,就是本次它支持的这个 computer user 仅限于 macos, 如果你是其他的操作系统暂时还不支持 好,然后他怎么去实现的呢?其实他就是通过这个 c u v driver 他 去提供的 m c p 来让这个哈密斯的对应的大模型能够去调用对应的 m c p 工具,从而去实现操作我们的电脑。然后我们来看一下这个 c u v driver 这个库, 这个目前是在 google 上面开源的, store 有 十七 k。 这个 cuv 给同学们解释一下为什么叫 cuv, c 的 话对的就是 computer u 就是 user a, 自然就是 agent, 就是 给 agent 提供了 computer user 的 这个能力 好,然后在文档里面其实我们可以看到就是这个 c u v driver, 它就是提供给 mac os 去用的,所以说自然 port 这边它就仅限于去支持 mac os 好。 然后本次给朋友们重点要去分享的就是它这个 工作原理,就是这个 cv driver 它的工作原理,以及我们使用 harp 机的去操作电脑时的一些实战的技巧。我们现在了解一下这个工作原理,其实这个工作原理它是比较简单的, 我们知道 harp 处理器它是集成了 mcp 的 功能的,所以它自然就能够去操作 mcp, 而这个 cv driver 它就提供了对应的 mcp, 所以 说 harp 处理器和 cv driver 就 通过 mcp 就 给建立起来联系了。然后就是 cv driver 它凭什么能够操作电脑来? 其实这个 cv driver 它不是因为它绕过了 macos, 而是它把 macos 开发出来的能力都给集成进来了,来去操作这个电脑 就包含了 icc b l t a p i, 对 应的就是 macos 提供的这个辅助功能,我们来看可以看一下,比如说我们在我们的设置里面,我们来搜索隐私和安全,我们就可以看到对应的有辅助功能,然后我这边的话已经把这个 cv driver 已经给它开启起来了。 这个辅助功能开启之后,对应的其实在 windows 上面也有类似的功能, windows 上类似的叫讲述人,就是他会把你的这个电脑,你当前打开这个界面,他长什么样,比如说我当前这个界面 在两边是空白的,中间有文字的描述,我的文档就类似这样子,通过语言的描述把你当前这个 ui 给你描述出来。 仅仅通过文字的描述,你担心这个屏幕长什么样?肯定还是不够的,因为很多时候很多 ui 它是文字描述是不够的,比如说一些视频剪辑软件,或者一些比较复杂的这个表格操作啊,这些就是通过 ui 的 描述是不够的。所以说还有一个 就是 macos 暴露出来的录屏的这样一个功能,我们同样的可以在这个里面看到,我们来搜索这个隐私和安全。这个下面 你可以看到有录屏和系统录音,就是比如说我们去用一些远程软件,比如说像向日葵啊,或者说 two disc 的 一些软件,它就会要求我们把这个功能给打开,其实本质也是把我们这个屏幕给录下之后,然后我们就可以去点击屏幕对应的位置去操作我们的电脑, 所以说借助于它重点就是这两个功能。但还有一些比如说窗口进程的投递,这些系统能力它全部给整合起来了,所以说这个 c u v driver 它就能够去操作我们的电脑,并且它还做了一个事情,就是把这些操作能力都封装成了 a t 的 能够使用的就是这样的一个步骤, 就是我们可以通过去截屏,然后截屏之后找到元素的这个位置,比如说这个元素它可以去点击,或者这个元素它是一个输入框,可以去输入文字就等等的这些操作,然后找到这个元素的,所以之后我们就可以去执行对应的操作,比如说去 鼠标点击或者敲回车啊这些,然后最后就会去验证这个操作,就整理下来就是 a 镜头的这个工作流,就查找我们店了这个工作流, 然后这样的话 ai 它既可以去读取 ui 的 数,并且可以去调用这个控件的动作,本质就是这两个能力, ui 数通过 x c b 二 t a p i 提供,然后调用控件就是结合 screen recording, 因为它读到屏幕之后,它可以去点击对应的所有的位置, 然后也可以借助于截图做视觉定位,做结果的验证。从前半部分来看,我们可以知道就是因为他要进行视觉的定位,还有就是结果的验证,所以他就肯定要这个大模型能够去理解视觉, 因此 computer user 如果要做通用的 computer user, 最好接入支持图像理解的多模态大模型,其实也不是说最好,就是应该是必须要接入, 必须要借助支持图像的一个大模型,它才能去做世界定位和结果验证。成人本的模型可以做辅助规划和分析,但是单独使用就会受到限制,那这个是它的工作原理, 那下面呢?我们来开始进入到实战环节来去实际看一下。首先的话我们需要升级哈密斯的版本,这个我们可以跳到哈密斯的 get 哈卜这边,它的描述 就是你得升级到大于等于这个版本的 harryson 的 就是零点一四这个版本,它对应的发布日期是二零二六年五月十六号这个版本在这个下面的描述里面,我们这里可以看到它就支持了 computer user 的 这个能力。 好,这是第一步升级,然后之前我给同学们分享过了 hermes 的 安装以及升级的教程,然后所以说这边如何去升级 hermes, 我 就不展开讲解了,我们可以打开我们的终端,通过 hermes 干大 v 可以 看到我当前这个版本就是满足条件的,现在我们继续来回到文档, 就是我们 hermes 满足之后,下面我们就可以去安装 cpu driver, 直接执行 hermes 提供的这样一个 computer user 的 命令,直接去执行 好,因为我这边已经安装过,所以说比较快,并且他提示我已经安装了,然后他就会提示我们需要去保证,就打开我们的系统设置,然后个人和隐私去把 cpu driver 对 应的这两个权限给打开,那同学们看到这个不要着急啊,就说你会觉得这个操作比较复杂,其实没有关系, 因为你再去使用这个 cpu 抓板,他只要触发了这个操作的时候,他就会弹出这个弹簧出来,那你去给他设置对应的权限就可以。好,然后下面是我们可以去查看我们安装的这个状态。 好,这个 status 这边我们可以看到已经处于 excel 的 状态,就我们就安装好了。安装好了之后,下面我们就可以通过 c u driver status, 你 可以检查你的 c u driver 是 否已经处于 running 的 状态,如果说它不是 running 的 状态,那么去执行这个 service, 把它给启动起来就可以了。我们看到我这边已经启动起来了,所以说 就重新再启动,就不会再发生任何的变化了。这个是安装仪检查我们的 c u driver, 那下面我们就可以来开始使用 computer user 了,使用之前要给同学们多讲一些东西了,就是我们使用 computer user 就 也也不是说那么多 简单,就是需要给同学们去讲一些技巧,这个技巧我把它沉淀为了一个 scale, 并且这个 scale 我 已经提前安装好了啊,这个 scale 也会直接给到同学们,我们通过 scale sniff grape computer 给同学们来看一下,对应的就是我去写了一个 computer user helper 的 这样的一个 skill, 我 已经把它安装到我的 harness 这个 default 这样一个镜头下面了。好,那么这个 skill 讲了什么呢?这边给同学们来看一下。 这个十六的核心就是我们用来限定和指导马克威斯的操作,根据操作类型去选择最合适的技术再执行啊。这边有很多内容,我就不带同学们一个一个看了,我们直接拿到下面这个表格,这边给同学们来看一下。 就是举个例子,比如说我们去打开一个应用,这个打开应用通过 c u driver 能不能实现呢?是能实现的,怎么实现?就是它会去读到你这个电脑的 u i, 然后比如说你要打开 wps, 那 么就点击这个 wps 就 去打开了,但是 有没有更快的方式来?其实有的,我们直接通过 open 干 a 指定我们用的名字,这个反倒是比 c u java 还要更快的,因为你没有去执行视觉的这个识别,以及去点击这个操作,这个直接通过 open 命令一含就可以实现,所以说我们就不需要通过 java 去 执行那其他的类似的,比如说我们要激活一个应用,我们要让应用去全屏,这些我们都不建议 去执行 c u a driver, 而是直接用最快的这种方式去操作。那什么情况下我们要使用 c u a driver 来,比如说我们要读起 u i 数,要点击按钮,菜单输入框这些,那么我们就要用到 c u a driver, 所以 说我的这个 skill 呢,就是 会分析用户的这个操作的诉求,然后给它执行对应的动作的时候,就会优先去选择最合适的操作的时候就说没有安装。我的 这个看屁了,用着黑粉的话,他就一味的去盲目的使用各种技术,这个我也是在这个地方踩了很多坑,就是执行了一个操作,执行了很多秒,最后还没有去完成啊。这个这个朋友们可以看到,我这边的就是这个操作花了很久的时间,但是没有完成, 然后就是建议直接通过聊天通道来去管理 computer user, 这样它不会导致光标输入、聚焦位置这些发生变化。因为如果说我们直接在这个终端里面去操作 hermes, 比如说来给同学们演示一下哈,好,我们直接终端里面输入 hermes, 那这个时候,比如说我们直接让他帮我们打开浏览器,帮我打开谷歌浏览器,然后在浏览器输入框 里面输入 b 站链接,好,就是这个操作,那这个操作因为我本身是在当前的这个 harmless ui 里面去操作的, 那这个时候因为你要操作浏览器,所以说这个时候他又跳到了其他的这个界面上,比如说我们可以了,刚刚我没有操作这个是他自动跳转过来的,跳到浏览器这边,然后下面就我们在这个时候你看,比如说我们通过这个终端里面又跳回来,并且他会询问我们各种权限,好,这个权限我给同学们来截个图啊,这里 再截个图给他定到这里啊,因为这个地方如果说我们六十秒不去允许这个操作,他就会超时了,所以说我先把这个图定下来, 然后给他们最大的这边我已经把对应的这几个权限什么意思给他们来梳理了一下。首先第一个就是允许一次,就是允许这个 come on l, 那 下一次执行 come on l 他 还会继续去问。第二个就是允许在这个绘画里面去操作,比如说我们这个地方后面再来一个 come on l, 他 一般就不会再问了。不像第一个每次都还要去问, 那对于其他的动作,比如说点击啊,输入啊滚的这些动作,那肯定是还会问的,只是说这个 come on l 他 不会再问了, 那 come on l 是 什么意思啊?其实就是比如说刚刚我们可以看到让他帮我们打开浏览器,如果在浏览器里面我们输入 come on l, 我 们我们可以发现就是把这个光标直接聚焦到这个浏览器的输入框里面去输入,所以它会提示我们需要这个权限。好,然后第三个就是 我们直接就永久的去加入白名单,这个是我比较推荐同学们去设置的,就如果说你在 通过终端里面去操作哈密斯的时候,他寻觅你这个权限,你就直接选择第三个,他这个的字面意思是永久加入白名单。在这个 computer user 的 场景里面,我分析了它的原码,它的实际的效果更接近一点就是你在本次运行哈密斯的期间,你后面任何的这个操作, 就包括你的这个 key, 就是 键盘嘛,然后点击 click, 然后这个 type type 就 type script, 就 打字去输入,它就是滚动,这些操作它都不会再问了,就说你就直接去允许一次,那后面就都不用允许了,这个是要同学们,同学们去做这个操作了。 第四个单就是去否定你的权限单,就是不不让他允许执行这个操作,这就是我们在这个中单里面去执行这个 哈密,随机的就插上电脑就有很多的这些材料框框的一些限制没有那么方便,所以我就比较推荐同学们直接就是我们通过聊天通道的方式去操作。好,那下面呢?我现在把这个截图给删掉了, 下面我们就来通过聊天通告的方式来去管理 computer user, 好, 我直接在手机上面进行操作。好,这边我就比如说我这边就直接进入到牛魔王的这样一个对话里面,因为这个就是我绑定的 default harness 的 这个 agent。 好, 然后我来给他说 帮我打开我电脑上的谷歌浏览器,好,直接来发送给他。 好,我们可以看到这边有对应的返回消息,这个时候你可以看到我这边手势没有做任何的操作的,我们等他去操作我的电脑。 好,这里我们可以看到就是已经触发了两个 skill, 一个是 computer user 的 skill, 一个是我们自己实现的, ok, 我 们可以把这个电脑它已经帮我们打开了,还是比较快的哈。然后现在我们再给他下载一个任务,就是在浏览器里面输入 b 站的链接,然后打开 b 站的网页, 在浏览器的链接输入里面输入 b 站的链接,打开 b 站。 好,其实这个其实它属于浏览器自动化的一个操作,但是我们可以通过 computer user 的 方式,同样的是能够实现的。 好,我们等待一会儿啊,等它去执行。好,这个其实同学们可以看到就是这边操作一步,它就会把这个日字给打出来,就这个也是我们 computer user helper 这个 skill 里面给写进去的,就操作一步就要把单行的 操作的信息给输入出来,这样方便我们用户看到他当前执行的是哪个操作。 好,我们稍等一会儿啊。 ok, 我 们可以看到这个 b 站也已经成功的去打开了。好,这个时候比如说我们再来给他下载一个任务,关于视觉的, 在 b 站里面搜索程序员儿目前查看他最新的五条视频,并且把他最新的,并且把他最新的这五条视频的名称发给我。好,然后我们再来发送。 ok, 我 们来看一下这个效果啊,这个时候其实我们可以看到它有点偷懒了,它就并没有去直接在这个页面里面去操作,而是直接走它内置的这个浏览器里面直接去搜索了。啊,我们那这个操作我们先给它结束一下, 那我们直接给它结束, 直接执行这个 stop 就 可以结束。 然后我们现在让他做另外一个事情,帮我打开电脑上的 wps 软件,来这里走一个。 好,我们可以看到他很快就帮我们把这个 wps 软件给打开了, 这边它也提示了它去已经找到最新的五条视频的标题,因为它这个地方它是直接走它内置的浏览器跳转过去,没有直接走我们操作电脑这种方式,所以我们直接给它停了,现在我们给它下到了另外一个任务。好,然后现在我们让它帮我们创建一个 excel, 点击新建按钮,帮我创建一个 wps 的 空白的 excel。 好, 直接走一个。好,它这边提示它会通过 g u i 帮我们在 wps 里面点击新建,创建一个空白的 excel。 好,这个时候我全程这个手是没有去操作的。好,注意,我们其实看这个里面就是我们要把应用置到最前面,这个是非常关键的,因为他去截图的时候,你要把你的应用放到最前面,这样才能更方便他去截到图, 我们可以让它找到了新建按钮,现在它点进去这个步骤啊,你可以看到其实对于人来说是很简单一个操作,但是对于 wps 它就没有那么的方便了。好,它找到了表格了,现在它要继续点击创建表格, 好定位到空白表格这个地方,一个日期里面可以看到它是在分析这个页面它是什么页面,然后再用,然后它再根据这个判断决定走什么操作。 ok, 我 们可以看最终它完成了把我们新建的一个空白的表格好,然后这就是 computer user 的 演示,就整体而言它是能做到 computer user 这个操作的, 但是就是每一个步骤其实并不是那么的快,有一部分原因就是我当前录制是用这个四 k 画质的,同给同学们去录制,所以说这个 他再去结合到我这个画面去识别画面的时候,这个图片比较大,就导致他推你的速度比较慢,所以就会整体而言执行的速度会慢一些。 然后另外的话就是目前就 computer 这一块我觉得还有很长的路要走,就是稍微一些复杂的画面,一个就是要么执行失败,要么就需要等很久, 后面 computer 又有一些更新的操作,也会及时给同学们更新上来,然后同学们有关于自己的一些想法,也非常欢迎在评论区留言讨论。好,我们本期视频就到这里,我们下期视频再见。
72程序员暮闲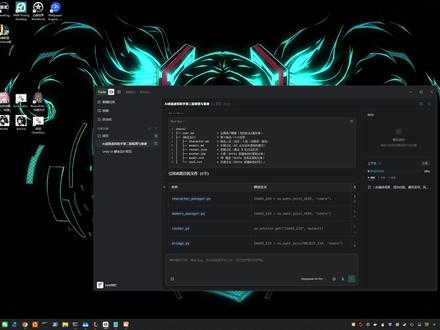 02:55查看AI文稿AI文稿
现在的 ai 工具如此厉害,决定做一个 ai 虚拟桌面伴侣软件,借助 tree 加 deepsafe v 四 p 实现即时语音对话,并可操控电脑自主动作和触碰反馈。 因为是零基础,前面几版全是试错和学习,烧了二十多亿头啃,不过学费交的值了,起码很有成就感。今天就先展示下做出的 ui 界面吧, 同一角色可有多种样貌模型备选,可随时更改角色语音输出时所用音色。记忆系统正在完善,打算采用两层纯文本记忆模式。头像仅是在选择角色时展示使用 灵魂、人设、性格、背景等等,随你怎么写。哦对了,名字仅限十个字幅,长度角色收藏可靠前排练, 对话界面丝滑展开对话窗体上右键弹出功能菜单,重新显示角色选项卡,对话界面丝滑隐藏并可拖动 笑像模式。设想中后续添加 好了, ui 展示就到这里了,下面说说整体目标。
77Fate绚烂 01:47查看AI文稿AI文稿
一分钟了解全球 ai 大 事!第一条,谷歌 alpha proof nexus 一 夜破解九道世纪数学难题谷歌 deepmind 发布 alpha proof nexus 数学 ai 智能体融合大语言模型,初代 alpha proof 与进化算法搭配 limb 编辑器,实现无幻觉形式化验证, 一夜攻克九道人类耗时数十年未解的 air dos 难题,最久悬案达五十六年,单题算力成本仅五到四百美元。第二 二条, open i g p t 五点六遭泄露极简 ui 封神 open i 未公布的 g p t 五点六内部代号 ares alpha 遭开发者泄露,预计六月正式上线,实现区块链化,零指令即可生成极简高审美商业级前端界面,解决 ai 生成垃圾代码痛点。 第三条,训练提速百分之四百 r l l l, 让英伟达 dream zero 一 月工作量一周完成无问新琼联合清华大学推出的 r l l l 强化学习框架,对英伟达世界近期发布的动作模型 dream zero 实现全链路系统级优化, 训练吞吐提升近四倍,将原需八张 h 一 百训练二十五天的周期压缩至约一周,大幅降低世界模型的研发门槛。 第四条,国产 agent 模型登顶全球第一梯队昆仑万维 skycloud 限时免费开放昆仑万维发布 skycloudy 一 点零及轻量版 skycloudy 一 点零 light 两款原声 agent 大 模型,性能机身全球第一梯队,可对标 cloud office。 四点六打破高性能、低成本、易接入、不可能三角, 可一键生成游戏、金融终端、电子捉虫、全自动 ai 周报系统等完整项目,支持定时任务与 skill 沉淀,费用仅为国际顶尖模型的二分之一左右,当前限时免费,未来计划逐步开园。 第五条,全球首例国产 ai 自己造 ai 面壁智能发布全球首个 ai 完全自主编辑的生产级大模型预训练框架 forging, 第一次框架训练出端侧小模型 mini c p m 五杠一 b, 实现 ai 造 ai 的 工程级突破。 mini c p m 五杠 e b 是 e b 参数端侧模型和在手机锂电本地运行。二 a index 超越所有二 b 以下模型,智能密度再创新高,支持装面宠物等轻量化场景。
10茉莉AI前沿资讯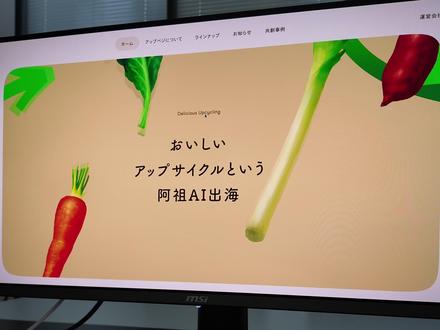 00:32查看AI文稿AI文稿
太炸裂了,兄弟们给大家看一下我们最新的站点,你所看到的这个站点的交互 ui 设计全部是由 ai 完成的,在这期间没有用到任何的代码开发,甚至连 ui 设计师都不需要了。 放以往这种效果的站点,光设计就要三到四周的时间,效果还不能保证,而现在通过 ai 总计不用一周。二零二六年使用 ai 建站的时代真的来了。
111阿祖嗨萌科技 00:30查看AI文稿AI文稿
一张照片如何转成这样的渐变插画或这样的海报效果?下面来个操作,切换图片生成,选择图片五点零模型,设置想要的比例。添加一张地标建筑照片,输入这段提示词, 这里可以自行调整喜欢的配色点,生成我们就会得到四张插画效果。接着我们选择排版简约的,然后将提示词替换为这段,稍等几秒效果就出来了,你学会了吗?
311武0感艺术家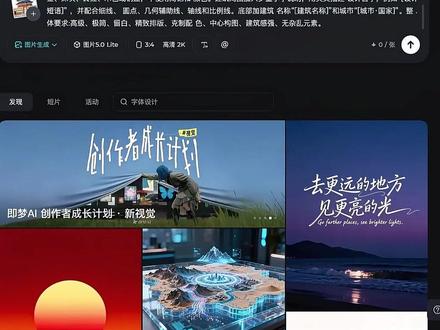 00:37查看AI文稿AI文稿
这个题词可以将图片转换成印刷版画风格。这个题词可以将图片转换成国潮插画风格。这个题词可以将图片转换成极简建筑插画海报。这个题词可以将图片进行拆解。 这个题词可以将图片转换成冰箱贴的效果。这个题词可以将图片转换成几何矢量插画风格。 只需要把图片拖进来粘贴提示词模型,选五点零比例,三比四点击生成,就得到了极简主义建筑插画海报。 ok, 下班!
629春草设计工作室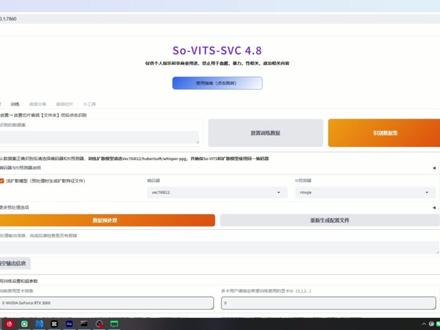 03:11查看AI文稿AI文稿
ai 翻唱 service svc 重大需求全面适配五零系以下全部的 n 卡界面全改了,老教程也不用看了,带你从头跑一遍。声明,本工具介于羽毛不团大佬的 service svc 二次开发,打开以后 ui 界面就是这样的,它包含 ai 翻唱 训练,音频分离、音频切片。第一步,模型训练。首先咱们把咱们录制好的干声撂在文件夹里,要注意一点,咱们的干声文件一定不能有中文,然后复制咱们的干声的位置,然后选择音频切片,把咱们干声的位置复制在这里面加载原音频,然后它就加载好了,成功的加载一条音频, 他自动切到十五秒到两秒的切片,然后咱们选择开始切片,然后咱们开始切片,已经切片结束了,大家可以看见切了二百九十一个片段,然后回到咱们训练这里识别数据集,他就识别上了,然后点数据预处理,点完数据预处理以后,等这个黄色的框框消失了以后,就证明咱们已经处理结束了,然后往下翻。由于我的显卡是三零六零八 g, 训练不了模型,所以给大家讲一下就可以了,等他处理好了以后,咱们点开从头开始训练,由于我的显卡是三零六零八 g, 无法给大家训练模型,所以说大家看一下就行了。数据处理结束以后,然后咱们从头开始训练就可以了,然后他有,然后选择八百步保存一个模型,然后咱们模型大概训练个两三万次就 可以使用了,这里就不给大家一一演示了,如果感觉你训练的模型次数不够,可以点继续训练,个人建议训练五万次到十万次以上才能出来一个比较好的模型。第二,音频分离,音频分离这边的预设是给大家调好的 u a r 五的一个分离模型,如果大家有懂的可以根据自己的情况去选择,当然最好的是下面这两个,但是这两个对于电脑配置要求比较高,建议大家 用我的默认就好。然后咱们把咱们要分离的歌曲拉到这里,我这里已经拉进来了,为了节省时间,然后我已经提前开始分离了,分离结果在这里,然后大家也是注意一下,这个黄色的框消失了以后,音频分离就结束了。分离好以后,咱们点分离,结果就直接来到咱们的分离界面了。第三步, ai 翻唱, ai 翻唱咱们把咱们的模型放到了咱们独立目录 models 下以后,咱在这边咱们这边就可以选择咱们的模型了,例如选择这个模型扩散模型加载,模型 加载成功以后这边会有显示,然后把咱们要需要的翻唱的歌曲,例如我这首老男孩,把人声拉进来,拉进来以后这里变调,如果咱们的模型音域不够,出现了哑音,这边可以负二负三的自己去调整他的一个调来减少哑音。然后咱们正常的点音频转化,转化的过程中咱们可以听一下他的原唱, 然后咱们这边音频转化已经转化好了,咱们下载保存,点开以后咱们的人声就在这里了,然后把咱们的人声拖入机架,然后再把咱们刚才分离好的和声还有伴奏全部拖进机架,我先开混响,大家对比一下声音。
123原力AI


