小米mimo怎么突然给这么多
粉丝160获赞1.0万
相关视频
 01:05查看AI文稿AI文稿
原本两亿的筹款,现在直接变成一百一十亿,还有三十二亿的补偿基分根本用不完! deepsea 宣布降价之后,小米的 mini 模型也宣布了永久降价,原本订阅用量提升到了原来的五到八倍,在今天零点正式生效,并且原有订阅的额度也全部重置刷新 上个月申请了雷总的免费 token 的 兄弟们,可以直接在订阅里面一分钱续费一个月。逻辑是这样的, miimo 的 套餐续费会重置这个月的账单日期直接重新算到下个月的。今天 本月没用完的积分可以折算抵扣下个月续费的价格。但是今天额度重置后,就是完全百分百的抵扣,而首月开通又有七七折的优惠,这导致雷总还欠你中间百分之二十三的差价。于是雷总不仅让你零点零一续费,还把这欠你的差价换成补偿积分,加到你下个月套餐里面。 开启自动续费后,扣零点零一即可续费。下个月一定要记得马上关闭自动续费,防止被返号。然后不要点第二次重新续费,这会取消补偿积分。原本两亿的扣款,现在直接变成一百一十亿,还有三十二亿的补偿积分,根本用不完!
1363𝑬𝒄𝒉𝒐.7 00:51查看AI文稿AI文稿
小米的营销是真厉害,我领到这么多算力额度,如果你是 ai 开发者,兴许也听说过小米官宣了咪某 ai 启动百万亿算力激励计划,面向开发者免费发放算力额度。 作为 ai 编程深度使用者,这种官方福利必须得试试。官方审核挺快,提交第二天凌晨一点半就通过了,第二天一早登录,十六亿 credit 的 额度就已经到账。这么多算力, 当然要好好测试一下。我打开 open code, 接入 a p i k, 测试 memo v 二点五 pro 的 编程能力,任务是修复一个软件界面的显示 bug。 memo 处理这个任务花了将近十七分钟,速度偏慢,完成后看控制台三千七百万 credi 的 直接消耗了,就修复一个 react 界面问题,花了三千七百万 credi 官方标注 credi 的 余算力单元的换算是二比一。他请教一下,是我操作问题还是什么呢?有大神解答一下吗?
139Wayne熊大熊 02:06查看AI文稿AI文稿
今天这期视频呢,来讲讲小米 mini v 二点五这个大模型的降价情况。现在呢,这个 mini v 二点五它跟 deepsea 已经是一个价格了。 mini v 二点五和 deepsea v 四 flash 是 一个价格,二点五 pro 跟 deepsea v 四 pro 价格一样, 之前我们都说 tbisc 的 价格很便宜,现在小米也便宜了,然后我测试了一下,随便跑了一下 agent, 然后它的缓冲泵动力呢,达到了百分之九十四,九十五,所以说就非常便宜。另外呢,小米有 tocom plan, tbisc 没有,所以说呢,小米现在呢,要比 tbisc 还要便宜一点点, 最低档呢,这个小米是三十九块钱,然后呢,你首次购买呢,有八八折,算下来就是三十四块多一点。然后呢,你可以用大概四十一块钱的 toc 的 量, 然后呢,你在晚上的零点到早上的八点,还有一个八折的额外的一个优惠,哎,所以说呢,你大概算下来就是你第一个月可以用三十四块三毛二买到大概五十一块钱的 talkin 的 这个一个量,所以说就是非常非常划算的。 那么它现在呢,对比来看,跟之前的 talkin plan 对 比来看,就是说呢,涨了大概五十到七十倍,可以说是非常非常良性了。 那今天的零点呢,他还把所有的额度给重置了,我今天上去一看,哎,我额度重置了。小米的大魔镜有两个隐形的好处,它的 v 二点五是多模态,但是这个 deepsea 呢,它就不是多模态。另外一个,它有一个语音的克隆的生成,它都是免费的,不需要花任何钱,所以说,比如说你的视频配音啊啊都不需要花钱的。 那假设呢?假设就是我们做到理论上的百分之九十五的缓存命中,大概这个三十四块钱的这个月卡可以买到 v 二点五五亿多的一个 top, 至少五亿的一个 top。 如果是 v 二点五 pro 呢,至少也能有一个一点九亿的 top, 可以 说是很实惠。 那就我个人来说,我现在主力呢还是 deepsea v 四 pro, 然后呢,我买了一个最便宜的一个小米的一个 mini 的 月卡,三十四块钱。然后呢为为的是什么呢?就是享受他的二点五的这个多模态啊。另外还有一个免费的语音克隆,那一个月三十四块钱还是非常便宜的。那这样呢,就可以覆盖我的绝大多数场景了。
130翔子玩ai,这也太好玩了 02:08查看AI文稿AI文稿
先说结论,小米 miimo 确实降价了,而且降的不少,但降幅百分之九十九这个说法,咱们得打个问号,因为没人知道它原来到底卖多少钱。 credit 是 怎么回事? 小米搞了个中间层,叫 credit, 你 先买套餐,比如三十九元,一个月给你六千万个 credit, 然后用的时候按 credit 扣。降价之前, pro 模型要扣两个 credit, 长文本甚至要扣四个。 降价之后,小米说取消了四倍 credit 的 计费方式,但具体 pro 模型现在是扣一个还是两个,官方没说清楚, 直接看价格更实在。小米公布了 token 价格,输入缓存命中零点零二五元每百万 token 输入缓存为命中三元每百万, token 输出六元每百万 token 输入只要两分五厘钱就能买一百万个 token。 和 deep seek 比怎么样?巧了, deep seek v 四 pro 的 价格完全一样。小米这是明摆着对标 deep seek, 价格完全对齐, 那到底降了多少?小米说最高降幅百分之九十九,如果这是真的,那原来 pro 模型的输出价格应该是六百元每百万 to 肯左右。 但问题是小米从来没公布过原来的官方价格表,所以百分之九十九降幅这个数字只能信一半。 普通人该怎么选?如果你追求简单透明,小米和 dipsic 价格一样,选哪个都行。如果你担心被套路,别买套餐,直接按量付费,这样就是明确的价格,没有 credit 换算的弯弯绕。 最终结论,小米 mimo 降价是真的,价格也确实便宜,但降幅百分之九十九的宣传,因为缺乏原价数据,没法完全验证,和 dipsic 比价格完全一样。 credit 机制有没有猫腻?官方没把降价后的换算比例说清楚,这是个隐患。
16投肯AI小刚 00:30查看AI文稿AI文稿
对不起了梁胜,雷军给的实在太多了,一觉醒来以为出 bug 了,百万头肯变成百亿头肯。五月二十七日,雷军官宣小米猫某永久降价,降幅百分之九十九,同时老用户额度全量重置 转角。 deepsea 刚把价格砍到四分之一,小米直接跟进,把大模型价格打穿了,地板输入百万 token 零点零二元。比 deepsea v 四更低更狠的是,小米 mini 是 多摩态输入,也就是说,你的文字、图像、音频、视频他也能理解实践真正的内容全流程自动化,而不是 deepsea 单单文本输入。这波操作到底是恶性价格战,还是说雷总想做普惠大众的 ai 呢?
1.7万美超半导体研发 00:29查看AI文稿AI文稿
我真的服了小米米某这个积分啊真的很虚,这两天我实际大约消耗了八千多万的 token, 但是积分已经消耗掉了二十二个亿,简单计算一下,积分大约是 token 的 二十六倍, 况且这是在大量缓存命中的情况下得出的。那么标准套餐虽然给到了一百一十亿的积分,换算下来也不过四个亿左右的 token, 照比之前两亿积分对一亿左右的 token 实际涨幅也有三倍左右。小米你真的有必要整这么唬人的数字吗?难道只是营销大于实际吗啊。
119龙虾 AI Claw 04:27查看AI文稿AI文稿
我拿到小米二十三亿 token 的 时候,其实是有点懵的,不是兴奋的那种懵事就这就这也能过迪那种懵?这个是 max 套餐的十六亿,这个是 pro 套餐的七亿。先交代一下背景,小米最近搞了个活动, 叫咪蒙 over 的 百万亿 token 创造者激励计划,三十天免费送一百万亿 token, 最高给到 max 上十六亿 cash, 等值六百五十九块钱。 这个话题已经有很多博主写过了,活动也快到尾声了,五月二十八日截止,还剩不到一周,按理说不该再蹭了。但我之所以还是写,是因为我发现了一个特别简陋 特别巧的方法,几乎百分之百能拿 max 档。这个方法我一会儿说,先把活动本身聊透。咪猫是小米自研的大模型,最新版本 v 二点五 分两个模型, pro 版面向复杂任务深度适配 a 剑客和编程,在 gdp v a l a a 和 clever 榜单上开源第一。还有一个是全模态版,文本、图像、视频、音频都支持 v 二点五, pro 用的 mo 架构,总参数三零九 b 激活十五 b, 原声支持一百万 to k 上下文推理成本只有国际币源旗舰的百分之二点五, api 定价大约是国际竞品的五分之一。 你可能觉得这不就是个国产模型吗?但坦率地讲,这次小米的成绩确实够硬。 texturina 全球综合第五, labyrinth 全球第四。 open route 上周以百分之三十多的试战率登顶第一 周条用量四点八二万亿 token, 而且它是开元的 mit 协议商用自由。说真的,全球前十开元模型里,中国占六席, 小米是第一个登顶开元榜首的手机厂商回到活动,这次 over 的 计划分两部分,一部分是面向开发者的百万亿 toc 创造者激励,另一部分是面向 ainc 框架团队的生态共建。我们聊的是前者,申请流程不复杂,去 mimo 填个表单,三个工作日出结果, 通过后邮件通知、登录开放平台等权益到账就行。但很多人卡在评估这步,拿到的是赠金,而不是 tiktok plan 或者档位很低。网上常见的建议是要写详细的项目描述,要有 github 链接,要做完整的项目, 有些教程甚至建议你前后端数据库齐活,搞得跟融资 b p 似的。我一开始也这么想,然后我发现了一个更聪明的路子,就是只做一个前端,一个用歪不扣定搞出来的非常非常厉害的前端不需要,后端不需要数据库,不需要部署上线, 就是一个纯前端页面,但视觉要炸,交互要丝滑,让人点开第一眼就觉得,卧槽,为什么这招管用? 你想啊,评估的人一天看几百份申请,大多数是 github 仓库链接和 api 文档,他点开一个仓库可能还没看完 readyme 就 关了,但你给他一个牛逼的前端,点开就是成品,视觉冲击力直接拉满,谁都能一眼看出来这东西好不好。后端逻辑写得再复杂, 评估的人不懂你的业务逻辑啊。但一个漂亮的页面,不需要专业知识就能判断质量。我自己 pro 档就是这么拿到的项目就一个纯前端页面,没写一行后端代码。我朋友按照我的方法拿到了 max 档。 噗儿当倒是我实打实拿作品申请的,自己写的 app, 还有几个 skill, 两者加起来一共二十三亿 token。 再说一个很多人踩的坑,一定要先注册好小米账号,绑好邮箱和手机号,申请表里填的邮箱必须跟小米账号绑定的邮箱一致, 如果不一致,或者你用的是手机号注册的账号,没绑邮箱,通知邮件根本发不到你手上,全一批了你也拿不到。 我一开始就翻车,在这折腾了好久才搞明白。所以正确顺序是先去小米官网注册账号,绑好邮箱,然后再去申请。操作上也不复杂,用 cloud code、 科斯尔或者任何顺手的 ai 编程工具,让 ai 帮你 vibble 扣度一个炫酷的前端页面,重点放在视觉效果和交互上,动画动效,享意识布局,这些能让页面看起来很贵的东西。多搞深情表里,把截图放上去, 项目描述写清楚,用了什么工具,做了什么功能,解决什么问题,就这样。最后说说这个 tucker 值不值得薅。 mmo v 二点五 pro 的 编程能力,我自己用下来的感受是比我日常用的 g l m 五车报强不少,跟 g l m 五点一比也差不了太多。 a p r 能直接对接 cloud code 浏览器, oppo 跨这些主流工具。十六亿 tucker 免费活动五月二十八日截止,池子部等人免费的羊毛,而且是比较厚的那种,不薅确实亏了。
255Ac的ai打工日记 00:25查看AI文稿AI文稿
大冒险价格正式开打,小米米某突然官宣大幅降价,最高降幅达到百分之九十九,同时托克帕伦加量不加价标准这一档的用量从原来的两个亿飙涨到一百一十 亿的积分。你没听错啊,一百一十亿翻了五十五倍。兄弟们,其他话不要多说了啊,赶紧去试一下。我靠,这个真的太太,小米太太牛逼了。
224龙虾 AI Claw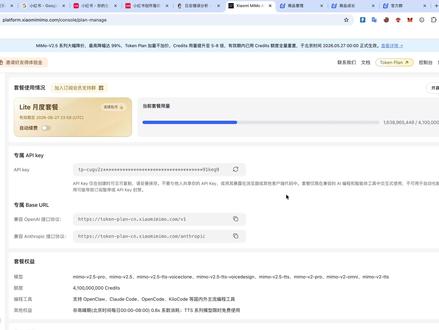 00:28查看AI文稿AI文稿
兄弟们,跟你们说个事情哈,昨天看到小米 mayo v 二点五降价,脑子一热就充了最便宜的四十块套餐,想着四十一亿 credits 怎么都够造的对吧? 其实到现在为止,我也就用了六七个小时,已经用掉百分之四十多了,你以为我干了啥大工程呢?其实就是让他读了个 github 仓库的代码,再扫了扫我电脑里的文件,就这点事,照这速度估计也就够用两天。所以打算入这个套餐的朋友注意下消耗速度啊,太惨爆了!
312AI好好玩 01:02查看AI文稿AI文稿
又在说小米的 mimo 是 套壳了 clou 啊,之前是套壳 deepsea, 现在是套壳 clou, 你 要知道有几个问题啊。首先第一个 clou, 它是一个世界顶尖的模型,国外的模型国内呢,使用起来相对麻烦一点,而且它的价格偏高。如果小米的 mimo 真的 是套壳 clou 的 话, 那么几乎国内所有的程序员都会将自己的 ai 模型使用转移到小米的 mini 上面。但很明显大家没有这么做啊,虽然说小米的 mini 很 强,但相距于 kl 还是有很大差距的。第二点,小米的 mini 为二点五,它已经开源了, 你不会连开源是什么意思都不懂吧,你可以扒一下他的开源的东西啊。最后啊,如果你非要去黑小米的咪蒙哎,你就实际去测一下, 你就去让他去做一些内容,你说他做的不成功,做的有问题,不要把你家做的一些事情给套在小米的咪蒙上面。
380觅涩 02:54查看AI文稿AI文稿
小米 miimo v 二点五大降价百分之九十九,很多大聪明的反应是,不就是降价吗?别家也能做啊?错!真正恐怖的地方,从来不是能不能做,而是敢不敢做!这才是这件事最炸裂的核心。 g l m kimi、 千万豆包这些大模型理论上能不能做缓存优化呢?当然能,甚至我怀疑很多公司可能早早就偷偷做了。为什么? 因为缓存优化这个东西,本质上就是把 ai 已经算过的内容缓存起来,下次再有人问类似的问题,直接读缓存。 那么以前 ai 每次回答问题都想重新做一遍高考数学卷,现在变了,这题老子做过了,直接抄答案,成本一下就暴跌,尤其是配合 ssd 缓存以后,显存的压力会下降的非常夸张。而显存才是一个 ai 公司最贵的东西。 所以问题来了,如果大家理论上都能做,为什么行业价格一直没有崩呢?那是因为没人敢。 你发现没有,现在很多 ai 公司表面上在卷模型能力,实际上拼的是什么?拼的是融资,拼的是利润,拼的是资本。故事 谁都知道价格还能降,但谁都不想第一个动刀,因为一旦有人掀桌子,整个行业的利润都会血崩。结果小米干了什么?别人偷偷优化,小米就直接公开砍价,这才是最狠的地方。 最离谱的是,他现在几乎做到同 deepsea 同价,同样 e m 的 上下文,而且他还有多模态,大家知道这基本上相当于 deepsea 四点一提前发布了。老铁 为什么这么说?因为过去大家一直以为 deepx 这么便宜,是因为他技术带差太大,别人短时间根本追不上,结果现在小米告诉行业不一定哦,别人可能也能做到,只是很多人不愿意降价而已, 因为他直接把整个 ai 行业的底库掀了。原来很多公司的护城河可能根本就不是技术,而是大家默契的维持高价。而小米最恐怖的地方是什么? 不是模型,不是论文,不是参数,他最擅长干一件事,那就是价格战。手机行业他这么干过,家电行业也这么干过,那汽车行业呢?他也在这么干。现在终于轮到 ai 了, 以后 ai 行业最可怕的事情呢,可能不是哪个模型更聪明,而是谁先把 ai 做成白菜价。因为当 ai 成本下降十倍的时候,变化的不是利润,而是整个世界的使用习惯。以前大家问一句 ai 嫌贵 以后可能默认全程挂着 ai, 那 时候真正难受的不是技术差的公司,而是成本明明已经降下来了,却还不敢降价的公司。兄弟们,你们觉得呢?
 02:51查看AI文稿AI文稿
今儿一大早起来发现小米的大模型 memo 也降价了,降得也挺狠,几乎赶得上 dexip 了,号称也是用了什么缓存优化技术,具体细节我还没有看,从这个角度看的话挺可怕的。大家降价幅度这么狠,首先我们要排除它是亏本销售的,这个很难的,因为成本压力太大, token 消耗应该 费用是很高的。那我们就要看真的是缓存优化技术什么的,还开始这种注意力缓存优化技术给搞的。那 我们要注意两个问题,第一,卖透肯这个生意可能不是那么好性感了,可能要作为议价贴到其他的设备上。第二,呢个行业需要去观察,如果真的卖透肯这个事情已经做到了价格战。这种情况下 也有两个可能性,一,一个是说需求增长已经到头了。其次就是说现有的 skinning law 远远还没到头, 这种工程的优化带来的成本下降是非常厉害的,这种成本下降很可能会大规模的冲击现在硬件端的 定价权,怎么能便宜这么多呢?我还是没想明白。昨天晚上刚感感慨了 ds, 今天 mimo 又来了,这个 mimo 确实好用啊,大家琢磨一下,如果真的向上冲击到了供应链的话,那影响可能会很大, 告辞。补两句说中国能做到这么低成本,老外会不会做到?我觉得会,中国敢这么降价,老外会不会降?比如 openai 和 astrafig, 觉得不会,因为你在需求稳定的情况下,资本主义国家是 不可能率先降价的,他们会先获取充足的利润,再会谈商业模式的变化,中国本身就是这几个模型厂商本身就是落后的,而且从 d s 之前的玩法来讲的话,他不会追求高毛利,这是一个很理想主义的行为, 所以即便是有技术进步的情况下,外国也不会降,但是呢,凡有一点点小进步,中国模型厂商也会降, 这个在历史上不是第一次了。 d s 曾经连续多次降价,把行业的价格都打串了,所以这次 d s 低成本销售,咪某跟他降,我觉得一定是技术上有突破,而且在第一时间 把这种技术突破落地到了销售的策略变化上了。补一句,按照这种逻辑的话,云厂商迈拓肯也不是那么性感了,有那种分成的模式,比如不比如了。
 00:21查看AI文稿AI文稿
谁把一百一十亿 token 塞我账户了,还以为小米后台出问题了个十百千万,一百一十亿, 今天一看是小米大模型全系降价百分之九十九,梁盛和雷神到底谁的恩情更多?目前咪某模型的审美很强。 pro 套餐三百八十亿 token, 九十九的套餐一百一十亿 token。 用不完,根本用不完。
11蒙多大调查员 00:57查看AI文稿AI文稿
高达百分之九十九的价格降幅,直接把大模型赛道的桌子掀了。小米这次真的给开发者发福利了。以前总会心疼高昂的调用成本,连跑个代码测试都要精打细算。 现在咪蒙模型的订阅配额直接暴利拉升了五到八倍,每个月最高拿到三百八十亿额度。这笔算力足够大家随心所欲折腾。最离谱的是那些已经用掉的额度。这种堪称作弊的配额刷新机制, 在二零二六年五月二十七日生效,团队底层通过持续优化推理性能,才换来这种极其耐用透明的定价。那些平时爱用的编码辅助工具,现在只需简单配置一下专属密钥,就能立刻接入这海量的低价算力。这动作根本不是简单的打价格战, 而是用真实价值重塑了行业规则,让接入门槛彻底变成了一纸空文。懂行的早就把代码工具环境配好,安静等待这场属于所有人的狂欢。
 00:35查看AI文稿AI文稿
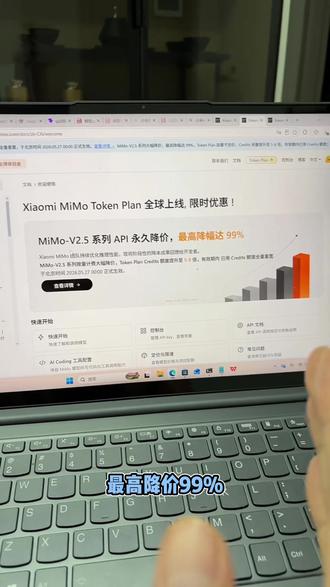
我就说为啥小米最近这么安静呢,原来是逼了波大的最高降价百分之九十九,原来是要硬钢 deepsea 啊。你看一下它现在的定价, 二点五 pro 输入零点零二五输出三。 好了,现在互联网不光有一个良胜了,现在又来了一个雷胜。
37迪哥来了 01:51查看AI文稿AI文稿
小米的 ai 大 模型 miimo 今天干了一件事,永久降价,最高降幅百分之九十九。你没听错,不是促销,不是限时活动,是直接改价。具体怎么降, miimo v 二点五全系列 api 从今天开始执行新价格,而且不再区分输入长度, 全球同步生效。如果你之前买过 token plan, 还有一个好消息,用量直接提升到原来的五到八倍!什么概念?我自己的实测数据,原来的最贵套餐六百五十九块钱一个月,十六亿 token 对 我来说撑不到一个月。 现在调整之后,最便宜的套餐三十九块钱一个月,给你四十一亿 token。 最贵的套餐呢?直接给到八百二十亿 token, 这不叫加量不加价,这叫龙虾自由。更猛的是,所有当前还在有效期的 token plan 用户,今天凌晨额度全量重置,不管你之前用了多少,直接给你清零重来,按新价格重新算。那问题来了,小米凭什么敢这么降?答案是推理技术的优化。小米技术团队基于 s g land high cash, 完整支持了滑动窗口注意力机制,把 kv cache 在 gpu、 显存、 cpu、 内存、 ssd 之间的数据搬运量压到了优化前的七分之一,可缓存的 token 数量提升到近五倍, 缓存命中率和推理效率都上了一个台阶。再加上专家并行方案和输入长度分桶策略的优化,集群吞吐能力进一步提升, 每个 token 的 服务成本就这么降下来了。说白了,不是小米在亏本补贴,是技术真的跑通了,成本结构变了。另外,之前那个百万亿 token 创造者激励计划,一百万亿个 token 已经全部发完了, 活动提前收官。不过 apache 软件基金会成员的专属福利不受影响,长期有效,历史付费,用户也别急。小米说,未来一周还有惊喜,小米自己说了一话,让更多的人能用到更好的模型,这是 mimo 不 变的使命。你现在用的是哪家的 ai 模型?评论区聊聊,看看谁的成本最高?
25AI-OPC飞哥