deepseek v4对比mimo
粉丝132获赞1371
相关视频
 10:21查看AI文稿AI文稿
deep c q v 四呢,终于发布了,各方面的参数啊,看起来都很不错,但实际使用起来又是什么水平呢?正好最近两周啊, g p t 五点五, opt 四点七, kimi k 二点六也都刚更新了,再加上之前的 g r m 五点一呢,凑齐了一大批的这个千元模型。很多朋友啊,都在纠结说自己的智能体里面到底应该用哪个模型呢?今天这个视频啊,我就会从价格,从速度, 从完成任务的质量几个角度来跟大家聊一下这几个模型,能够让大家在选这个模型的时候啊,会有个参考。我们首先来看一下各家模型 token 接口的这个价格,按照 token 输入输出七十比 七比二的这个比例来加全,这个呢大家可能如果不清楚的话,也不用特别的去计算,我是按照我自己的平时的账单的统计,然后调用的这个比例算出来的,每个人呢都或多或少会有些不同,但大概呢就是这样一个比例,然后用它来算出每百万 token 的 一个综合的价格,方便我们去比较。我们看到 v 四 flash 呢,零点三二元, v 四 pro 呢,原价是二点五六元,然后加上当前二点五折的发布活动啊,价格大概是零点六四元。 kimi k 二点六呢二点二三元。 jimmy k 二点一呢二点二九元。 opus 四点七十点六三元。 gpt 五点五呢十一点五二元。国产模型啊,大家看到大致呢都在同一个价格袋里面, opus 跟 gpt 呢,价格直接贵了一个数量级, 一次 flash 啊,价格最低,因为它的模型尺寸呢,也是最小的一次 pro 呢,能把一百万的上下文做到这个价格,是采用了新的注意力机制,一百万上下文呢,大概只需要前代的百分之二十七的算力, 百分之十的显存就够了。列出这个综合价格啊,是方便大家去理解,去比较,然后给大家做一个自己选择的参考。然后来介绍一下这次的这个对比的任务设计啊,我这次呢,是想让智能体啊去抓 hack news 上面前一百条的热贴,挑两到四条呢,值得说的话题,查背景, 生成图片,配音,最后用 hyperframe 这个 skill 呢,制作一条三十到六十秒的中文视频报告,中间怎么去完成啊?怎么去这个一步步的定任务呢,完全交给智能体自己去定,每家过程啊,稍有不同, 但大致的内部的流程啊是一样的。先写 python 脚本呢,抓帖子,做数据统计,再写分镜跟旁白,然后呢,生成语音跟图片。语音出来之后呢,来计算一下实际的长度, 重新去调整一下分镜,如果太长呢,就压缩一点,如果太短呢,就扩展一点。最后呢,再用 hyperframes 以代码的形式把这个视频完整的做出来。每个模型的任务呢,我都给它们建立一个独立的空白的文件夹,然后用 skill 去扩展它们 agent 的 能力。比如说像我这里用到了几个 s 册去查资料, gpt, imager 去申图,然后 edge tts 做中文的旁白, hyperframes 负责视频的合成等等,基本上就是四个。如果产出有明显的缺陷啊,我会反馈给 agent 一 次,但只给这一次的机会,只做一次的人工干预,还有一个比较重要的细节来跟大家分享一下。 这次实验用的 agent 啊,是叫做派,大家肯定没听说过,因为在国内还比较冷门。它是一个极简设计的 agent, 几乎不做任何额外的封装。我们平时用的比如说像 cloud code 啊 or codex 这种框架,它约束多,然后规划层比较厚,好处呢就是把那些比较弱的模型啊,能多浮起来走两步, 代价呢就是那些比较强的模型的判断力呢,可能也被一定程度上牺牲掉了。反过来说呢,薄的框架就是让弱的模型一步步能露出马脚,也让强的模型完全能够展示自己的规划跟纠错的能力。我们来大概的这个判断一下,这次一整条的这么长的这个工作流任务啊,需要用到这大模型的工具调用,多步骤规划 上下文,然后选题,判断出错的自己修复,单次跑下来我估计会用到上百次的工具调用,所以这六个模型的推理强度全部拉满,能够真实的展现它们在整个过程中的综合能力。 在最后比较这六个模型的这个能力之前,我们要先来看一下这次任务我们实际使用的账单跟这个生成的速度。 gpt 五点五呢,最快十六分钟 up, 四点七,二十九分钟 up, 开启了 x high。 这个之后啊,花费也是高的离谱, 比 g p t 五点五还贵了三倍多。然后其他的像 deepsea v 四 pro, 然后 kimi k 二点六, g r m 五点一,消耗的 token 呢,差不多,所以成本呢,也几乎差不多。但是 g r m 五点一啊,速度上比较慢, 花了四十四分钟才完成,这个原因呢,就是因为 token 接口的吐字速度太慢。因为之前就听说啊,这智普是国产模型里面比较缺算力的这个一家公司账单讲完之后啊,我们来看一下最终的成品到底是长什么样子。我想按两个维度来评价这次的任务啊, 就是排版跟内容,排版呢,是排版的结构,然后图案的比例,动画字幕这些内容呢,就是指选择题啊,旁白啊,判断力啊这些。然后六个模型呢,按照这两个维度的综合表现,我可以分成三档,第一梯队呢,就是 up 四点七和 gpt 五点五,大家可以看一下它们生成的视频啊。 h n 今日速览 top 一 百里三件事不讲废话第一件 deep c v 四,一千九百八十九分一千五百一十六条评论全列录零抠的跑在华为升腾上 pro 模型每百万输出 token 三点四八美元。 h n 原话从黑客到黑客 第二件, open a i 当天甩出 gpt 五点五,一千五百五十三分。记者分拣封顶贴 andropet missus, 但社区泼水幻觉率百分之八十六,是 opus 两倍多。第三件,最游戏九百零六分的热铁,在 bug 质量下滑。同一天, google 宣布向 andropet 注资最多四百亿美元,社区点透循环贸易, andropet 拿钱回头买 google 的 tpu。 全剧看 top 一 百 ai 话题十五条,却吃掉百分之三十一,得分百分之四十一。评论 谷里四条是 ai 域名榜第,靠十六次领跑。数据采自四月二十五日 h n 热榜,今天 h n 前一百条里, ai 大 模型占三十二条,合计一点一万分七千二百五十七条评论,榜首讨论集中在 deepsea v 四 g p t。 五点五和科沃质量风波。 deepsea v 四拿到一千九百八十九分,一千五百一十六条评论,社区最在意的不是发布会,而是低价好文档,以及跑在华为芯片站上的完整 阅帖。评论里的核心质疑是, ai 编程下的写代码时间是否又变成了独代码和审查成本工作计划最高头 n 四百亿美元, 把它看成供应商融资前 tpu 云和同要成闭环。如果模型商品化,真正的利润可能在算力入口比特和 c i l 供应链攻击,无科技拖拉机走红也只向同一个情绪。技术越强,社区越想要可验证,可修,少锁定系统。今天的关键词是可信。 从排版角度来讲啊,这一档的模型有完整的编辑自觉分进脚本呢,会自动标注 t t s。 实测的时长精确到秒,然后再去反推画面的时长。 g p g。 五点五的定稿啊,甚至自己列了这个时间码的对照表,图文的重点分明,然后动画的节奏也很合理。 t p t。 五点五的短板是首页的,这个数据格式化,没有正确的去渲染。然后从内容角度来说呢, oppo 四点七旁白其实是最讲究的,这可能跟大家的直觉上也比较吻合。 开场四秒钟就切入了三件事情,每一件呢都有具体的数据,加上一句这个嗨客女子原话做压轴,结尾呢,还单独留了十几秒钟做整体的这个全局的数据的复盘,然后这六个里面是唯一一个自己做了 结构化数据分析的这个模型, g p t 五点五呢,选题抓到了这个资本与算力的闭环这个独特的视角。别人都在讲模型本身,然后他呢,在讲生态,在讲一个大的宏观的这个这个角度,但结尾啊,那句就是今天的关键词,是可信。这样句话呢,我觉得就比较仓促了,像他感觉到时间快到了,然后硬切了一个结尾,这种感觉 怎么说呢,就是五十七块钱的 office 啊,贵是真的贵,但能力呢,确实也是最顶尖的。中间党的两个模型呢,就是 dipstick v 四 pro 跟 gim 五点一这一党的模型啊,都只是完成了整个工作的一半,但只是完成的一半不同。 v 四 pro 呢,赢在内容。 r m 呢,赢在了排版。 v 四 pro 的 排版呢,主体是左右结构的,图片被挤得比较小,文字也比较小,远不如第一梯队的那种舒展的,然后清楚的感觉,但有亮点啊,就是首页它做了一张热力图,是这六个模型里面我觉得最具设计感的这个开场,然后结尾这个转场,还用了这个色块动画,看得出来很有这个设计的意图啊。 然后字幕显示呢,我觉得就是比较正常。 v 四 pro 的 内容啊,我觉得它写的旁白是六个模型里面最像写给人看的一份。 d c v 四,近两千顶铁, 完全开源零抠的纯华为 samsung 芯片社区最镇的不是跑分式文档,开发者说比 open a i 好 太多。有人留了四个字, from hackers to hackers。 敢直接把这个 hacker news 的 评论原话当京剧引进来。 from hackers to hackers, 然后循环贸易 中表达呢,保留得很完整,四个镜头的每一个都有一句压得住的短句,然后开源再追,闭源再堵,开发者用脚投票。这句收尾呢,比 opus 我 觉得是最接近第 题。对的,开头有数据统计,然后文字跟图片都足够大,排版很舒服。唯一的问题呢,就是字幕遮住了这个皱纹。我反馈了一次之后呢,也没有修好,但是 g r m 五点一的内容啊,就差强人意了,基本都是新闻播报, 每个镜头的结构呢,都是谁发布了什么数据,多少社区说了什么东西,没有一句呢是自己的这个视角,自己的判断,也没有把几件事串联起来一起的。这个整体的视角只看排版呢。 g r m 真的 厉害,但是把旁白跟分镜如果也算进去的话呢,我觉得 v 四 pro 可能更好一点,所以我把这两个呢,都放在第二档。第三档呢,就是 v 四 flash 跟 kimi k 二点六这一档啊,为什么放在第三档呢?就是因为我觉得它在排版跟内容上面都有些硬伤。你比如说啊,像 v 四 flash 的 这个排版,所有的页面呢,都是同一个上下结构, ppt 模板, 十六比九的图呢贴在上面,然后有大片的空白,字也偏小,开头的数据呢没有渲染出来,字幕也缺失,反馈之后呢,还是没有修复好。至于 vs flash 的 这内容呢,它的旁白基本上也就是在复读这个帖子标题,然后像 deepsea vs 那 段,讲到 sweetband 突破百分之八十,适配华为升腾,这现在都是标题的原话。还有的那段呢,也只是把世界名完成了念一遍, 完全没有自己的这种视角跟判断。然后 kimi k 二点六的排版呢,深图有浓郁的这种 ai 的 味道,深图的提示词呢,也是比较差的,图片也被裁切了,没有完整的展示,然后字呢,也偏小。 kimi k 二点六的内容啊,比 vs flash 我 觉得稍微强一点。选题呢,选了卡尔的信任危机,然后谷歌的助资 把续命和买保险两层的意思呢,都点到了旁白,比较有节奏感。不过相比第二档的 v 四 pro 啊,我觉得还是有点差距的,大家也可以自己看这两视频对比一下。最后来跟大家总结一下,就 gbt 五点五跟 oppo 四点七呢,排版跟内容两件事啊,都非常在线,贵呢,确实有贵的道理。 然后像 v 四 pro 跟 g m 五点一呢,都只能做到一件事,然后卡在中间。然后 v 四 flash 跟 kimi k 二点六呢,在我这个测试当中,两件事都没做到,所以我只能把它排在第三档了。收回这个 dipstick, v 四本身啊,国产第一梯队我就完全是没有问题的。 v 四 pro 一 百万的上下文,性价比也非常的高, 从内容上来说呢,甚至有时候可以超过 g p t 五点五,但综合实力呢,跟 opus 跟 g p t 五点五我觉得还是稍微有点差距。但你聊一下这次测试的本身的局限性,因为六个模型都只跑了一次,会有很大的这个随机性,换一次呢,可能结果又不一样了。 任务设计啊,我这次也是比较偏重于这个视觉方面跟代码能力的,对纯文本推理能力啊,其实不是特别的敏感。真正严谨的测试呢,应该每个模型都去跑 n 次,然后去它的分布,然后再叠加这个盲测打分。这期视频呢,算一个不太严谨的这个测试, 给大家一个基本的这种参考。最后再跟大家说一下,这次测试呢,用的 agent 是 派,在国内还比较冷门,但我现在自己啊,就是内部几乎所有非代码的任务呢,都在它上面跑,非常的顺手,非常的听话,非常的爽。它是个开源项目,完全不是广告,感兴趣的朋友呢也可以自己去学习一下,自己去体验一下。好了,今天视频就到这里,我是李总,黑经理超,我们下次见。
9260第四种黑猩猩 01:50查看AI文稿AI文稿
小米模型降价百分之九十九,直接和 deepsea 硬钢,看来 deepsea 给的压力还是挺足啊。那小米的 mimo 和 deepsea 相比到底怎么样呢? 今天咱们就详细聊聊小米 mimo v 二点五 pro 和 deepsea v 四 pro 这两款国内顶尖大模型,帮大家分清两种的定位和适用场景。首先看基础信息, 两者上下文都做到了百万头肯,而且全部开放 m i t 开源协议,个人和企业都能自由商用,门槛很低。参数上, deepsea 整体规模更大,不过小米这边额外做了图像、语音一体的全模态,而 deepsea 目前只支持纯文本交互, 这是两者最直观的区别。接下来看核心能力比拼。第一块是智能体 app 的 能力,这一块小米眉目优势非常明显,在多项权威评测里得分更高,而且执行任务时投分利用力更高,能省下接近一半的调用成本,非常适合搭建 自动化工作流、智能助手等一类产品。第二块是代码的专项,榜单里表现拔尖,软件工程、算法编程、 实战写代码的能力目前位居行业潜力,是程序员开发团队的首选。第三块数学与逻辑推理,同样是 deepsea v 四 pro 更强数理计算、复杂推理的实测成绩非常亮眼,很适合科研和数理分析。总结一下,首先两款大模型都是国货之光,都很优秀, 如果你的需求涉及图片、语音、多媒体交互,或是要做智能体,首选小米 mini。 如果是专业编程开发、数学科研、纯文本内容创作、深度逻辑推演,那 deepsea 会更加适合你。关注我,了解更多最新资讯和实用技术。
399野大灰 00:30查看AI文稿AI文稿
对不起了梁胜,雷军给的实在太多了,一觉醒来以为出 bug 了,百万头肯变成百亿头肯。五月二十七日,雷军官宣小米猫某永久降价,降幅百分之九十九,同时老用户额度全量重置 转角。 deepsea 刚把价格砍到四分之一,小米直接跟进,把大模型价格打穿了,地板输入百万 token 零点零二元。比 deepsea v 四更低更狠的是,小米 mini 是 多摩态输入,也就是说,你的文字、图像、音频、视频他也能理解实践真正的内容全流程自动化,而不是 deepsea 单单文本输入。这波操作到底是恶性价格战,还是说雷总想做普惠大众的 ai 呢?
1.7万美超半导体研发 03:57查看AI文稿AI文稿
deepsea vise pro 编程能力竟然全面领先 mimo v 二点五 pro, 这是怎么回事?大家好,今天我就把这次的对比测试过程原原本本的跟大家分享一下。上个月底我申请了小米的百万亿 token 创造者激励计划,很幸运通过了,给了一个 standard 的 月度套餐 nice, 正好 deep check 最近也在打折透更,价格几乎等于白送。于是我就想着干脆把这两家的顶配模型拉出来,搞一场编程能力实战。说实话,测试之前我心里是更看好 mimo 的, 因为密码二点零的时候我在 open code 上白嫖过,当时写了个挺复杂的项目,几乎一遍过,印象非常好,所以看到最终结果居然是 deepstack 全面领先,我自己都挺意外。咱们一项一项来看,先交代一下测试环境,编程工具用的是 code code, 不 添加任何 scale 和其他工具, 两边参数完全一致,都开启了 plan 模式。测试题目是让 ai 写一个管理后台的脚手架,需求不算难,就是比较繁琐。提示词是 ai 帮我生成的,两边用的完全相同。 这中间还得先吐槽一下 open screen 这个录屏软件,录到一个小时的时候直接停了,录好的内容也没保存下来, 去一学期看,早几个礼拜就有人提这个 bug 了,没办法,整个编程过程就这么丢了,所以大家看不到实际的代码对抗了,我们直接上,结果从几个维度对比一下,满分都是十分六分算及格。第一项项目完成时间, deepsea 大 概耗时四十三分钟, nimo 花了六十一分钟。过程中其实能感觉到 nimo 的 思考更深,问题分析得更细, 可惜没录下来,但单拼速度 deepstack 明显更快。这一项, deepstack 给八分, memo 给六分。第二项,解决报错成功运行。这么搭完以后,两个模型都没能一次性跑起来,控制台一堆报错 主要都集中在数据库配置这块,基本上是依赖缺失和代码过时的问题,这可能跟我要求使用 spring boost 最新版本有关, 我处理报错的方法完全一样,都是直接把报错信息扔给 clothcode, 全程不人工改代码。 deepstack 大 概改了四次后端,三次前端就搞定了, mimo 那 边我都没心思数了,同样的问题反复出现,当时真有点崩溃,好在最后也解决了。这一项, deepfake 给六分,命妹给五分。第三项,代码质量。两边在模块设计和数据权限上差别不大,完成度都不错,但我明确要求 spring boot 版本用四点一点零。这是个预览版, deepsea 虽然没完全遵守,但用了四点零点六的稳定版,还算贴近 emo, 直接上了个四点零点零,偏差就大了。 这一项 deepsea 拿八分, miimo 拿七点五分。第四项,页面效果整体看着差距不大,但 miimo 在 给角色分配权限的时候,居然是要手动输入权限标识,而不是常见的勾选形式,用起来很难受, 而且代码生成功能的设计也不如镜像顺手。这一项 deepsea 给七分, mimo 给六分。第五项,价格咱们直接看真金白银的花费, deepsea 最近打折,整个测试跑下来才花了两块多,就算按原价也才八块出头。 nimo 这边消耗的 credits 超过了五千万, 按照雷总赠送的九十九元两亿快递费来算,费用超过二十五块。说实话,当初看到送两亿额度我还惊了一下,等测完看到消耗,只能说还得是雷总 价格这块, dpic 直接十分,密码给六分。总结一下, dpic 总分三十九分,密码三十点五分。 在我这套标准里, deepsea 表现中等水平, mini 表现刚及格。这根测试前我的预想完全反了过来, deepsea 几乎是全面压制的状态。当然还得说一句,这一次测试非常片面,完全不能代表两个模型的全部能力, 打分也纯属我个人的主观感受,大家就当个参考哈哈哈。好了,以上就是这次对比的全部内容,希望能给你带来一点帮助。
139赛博笔记 02:51查看AI文稿AI文稿
deepseek 终于发布了新版本 v 四,确定支持华为升腾芯片,官方表示性能比肩顶级闭元模型 agent 能力大幅提高一百万上下文成为标配。 ai 圈子里的人夸疯了,行业外的普通人看了新闻却还是有点懵,啥意思? 至于吗?一年多以前, deepsea 的 巨大行业意义,不搞 ai 也都能理解。中国在开局落后美国大模型技术两年左右时间,同时还被美国出口管制,封锁了芯片算力的情况下,终于出现一个天才选手,想出办法用较少的芯片算力训练出一个世界前沿的强力大模型,而 而且还开源,相当于他们开了一家特别好吃的馆子,不仅对所有顾客免费,还将关键的原材料、配料表做法公开。然而现在其他国产大模型多了, deepsea 这次还有那么惊艳吗?先说一个好理解的, deepsea v 四憋了这么久,是在憋一个之前没有国产大模型真正跑通的事情, 跟国产芯片做全面适配。其实 ai 公司和英伟达、 amd 的 合作不仅仅是买芯片,发布大模型前一般还需要提前把模型给它们做性能优化优, 有点类似于国产手机厂商跟沟通的合作关系。然而有外媒报道,这次 deep sec 之所以推迟了 v 四的发布时间,就是因为给了华为和韩五 g 这个早期的访问权限,花了几个月和华为韩五 g 合作,重写了模型底层代码的部分模块,来确保 v 四能在华为最新的升腾芯片上流畅运行。 其实去年 deepsea 刚刚横空出世时,曾经尝试过绕开英伟达,可当时客观条件还不成熟,反复失败后最终放弃了全面使用国产芯片的计划。但这次 deepsea 等到了刚刚公开亮相的华为升腾九五零 pr, 这件事一旦跑通,对整个中国 ai 大 模型、中国芯片的意义可以说是无法估量的。 一方面在军事、政企、金融这些相对敏感的部门,可以实现绝对意义上的全链路 ai 国产化,而且不影响性能。另一方面, gpu 的 特性决定了国产芯片一旦可用,就有机会在支撑较低的情况下,通过堆叠来解决算力问题,美国出口管制带来的消极影响将进一步降低。 如果这次 v 四的性能确实如传闻所说在长上下文编程任务上能和 cloud check gpt 掰手腕,那未来通过国产算力就能用上前沿模型,不用再担心美国芯片出口管制的影响。其实从适配国产芯片这件事上可以看出, deepsea 真正的意义从不仅仅是为中国人争一口气, 而是从更专业的角度拓展整个中国 ai 的 可能性,推动整个行业的发展。出了芯片, deepsea 在 去年的基础上进一步抬高了开源的标准,通过它可以看到中国大模型路线开始完整的成型, 不是单点追一个最强的跑分分数,而是把开源、低成本 agent、 国产芯片、适配基础设施公开这些东西捆成一整套方法。论圈内之所以热忱地追捧 deepsea, 是 因为它是极少数不被日活流水估值捆绑的中国科技公司,在它身上确实能看到新一代中国科技行业的更多可能性。
1.2万X科技实验室 05:01查看AI文稿AI文稿
大部分人把 deepsafe 用错了, v 四版本综合能力现在重回国产第一,今天直接给你出 v 四保姆级教程,先带你看它现在到底强到什么程度。二 零二六年四月二十四号刚发布的 v 四系列,发布仅三天,第三方 super 四 lue 精准实测结果就直接炸场。 pro 版以七十点九八分登顶国产大模型综合榜第一, flash 版以六十八点八二分紧随其后拿下国产第二。 双版本直接包揽了国产榜单的前两名,把一众老牌大模型都甩在了身后。六大核心能力的硬核增幅直接给你摆明白。智能体任务规划能力 七十七点四九分,国产第一,比上一代暴涨二十点八七分,是这次升级最大的杀招,大白话讲就是他能自己拆解任务规划步骤,不用你一步步盯着叫。数学推理能力八十七点三九分,同样登顶国产第一, 硬核数理能力直接拉满,从小学算数到考研高数,没有他解不明白的题。幻觉控制。八十点六八分,国产第三, 仅次于 glm 五和千问三点五,意味着他瞎编乱造的概率极低,给你的答案靠谱度很高。科学推理七十九点二七分,国产第二,仅次于豆包专家模式,专业领域的内容拆解、逻辑推演,他都能精准拿捏代码生成。六十三点二四分,国产第三, 似于 kimi 二点五和豆包专家模式,稳居开源模型里的代码能力第一梯队,开发者和普通职场人都能用精确指令遵循。 三十七点八四分,国产第三,比上一代暴涨十一点八九分,从之前的国产垫底,直接冲进第一梯队,你让他干什么,他就严格按你的要求来,不会跑偏,不会露相,实现了全维度无短板。那这么强的能力, 为什么你用着总觉得不好用?核心原因只有一个,你从跟上就把它的两个模式用反了。很多人用了一年 deepsea, 根本没搞懂哪个模式适合干什么,回头还骂他能力不行,这完全是把屠龙刀拿来切菜了。快速模式运行的是 v 四 flash 版本,主打响应快、成本低,全功能免费无门槛。它适配日常闲聊、简单提问、清亮文本处理、基础信息查询, 用它完全够用。但你要是拿它解高数,做复杂报告、写代码,那肯定会觉得它能力不行,这不是它的问题,是你用错了场景。而专家模式运行的是 v 四 pro 版本,是这次升级的核心杀招。佛有登顶榜单的硬核能力, 全在这个模式里,这才是你真正应该学会使用的方法。下面这三大专属用法,普通人直接照着用,效率拉满十倍。第一个,用它做全场景数学问题解答,学生党,职场人刚需中的刚需。他有着国产第一的数学推理能力, 不管是中小学数理化作业公式推导、大学高数微积分考研考公的数量关系题,还是职场人需要的数据分析、财务核算,他都能精准搞定。他不仅能给你标准答案, 还会拆解每一步解析思路,标注易错点,讲透底层逻辑,甚至给你同类型题的通用解析技巧,比网课老师讲的还细致。给你一个直接就能用的指令模板,我需要你讲解这道题,先给出标准答案, 再一步步拆解解析步骤,标注核心考点和易错点。最后给我三道同类型的练习题,附带答案和解析,直接复制粘贴就能用。第二个,用它的科学推理能力做内容校准, 做自媒体写报告的人,靠它彻底避免翻车。不管是视频内容的技术参数核对、 ai 测评、数据校准, 还是行业报告的深度拆解、数据交叉验证,又或是科普内容的真实性核实,独家细节挖掘,他都能精准排查数据错误,核实内容真实性,挖出同行没注意到的信息差,直接把文案丢给他,说帮我核对这篇文案里的所有数据 错误,给出正确数据和权威来源补充三个差异化独家细节,直接优化出有干货、有爆点的文案。最后给你一个高级玩法,用它的顶级智能体能力搭建你的专属数字员工。很多人到现在都不知道智能体到底是什么, 说白了,他就是把 ai 从你让他干什么他才干什么的被动工具,变成了你告诉他要什么结果他自己想办法干完的 主动执行者。之前你用 ai 做报告,得一步步给指令盯着改,随时纠错,前前后后要折腾十几轮。现在用 deepsea v 四的智能体能力,你只需要定一个最终目标,它会自己拆解任务 规划步骤,调用工具自主纠错,最后直接给你交付成品,全程不用你定 deepsea v 四在闲聊、语音交互、创意文案商品选择上,不如豆包千问顺手。本地部署对新手也有门槛,所以选对场景是你最应该注意的。 最后问你两个问题,你已经用上 deepsea v 四了吗?最让你惊艳的是哪个能力?评论区告诉我!收藏转发这条保姆级教程,下期带你解锁更多 ai 提效的隐藏玩法!
4570灵GO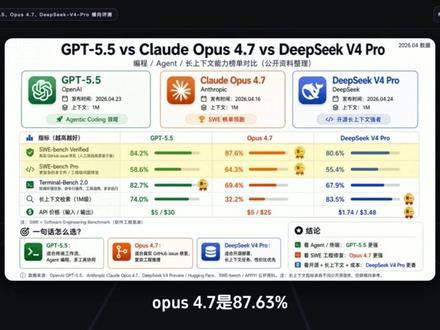 07:08查看AI文稿AI文稿
最近的 ai 圈啊, gbt 和 deepsea 实在是太火了,先是 gbt 五点五发布,号称在一些精准测试里击败了 cloud 的 传说模型 mesas, 紧接着 deepsea v 四也来了,继续保持开源跑分,直逼顶级的闭源模型,现在基本可以说是国内最好用的模型之一了。 那经过最近一段时间的高强度使用,今天我就把 gbt 五点五, dbc v 四 pro 再加上稍早之前发布的 oppo 四点七,放一起做个横向对比,看看 dbc 到底能不能追上顶尖的国外模型。那开始之前别忘了点赞加收藏。 首先我们看一下三家公布的跑分软件工程能力这块,也就是真实 get 上的代码问题修复, oppo 四点七是百分之八十七点六,三家里面最高,比 dbc 高出七个点, 更难更多的文件和复杂的工程问题也是 opus 领先,所以做复杂工程的代码修复 opus 还是很稳的。但是中单任务这块, gpt 五点五反超了百分之八十二点七,比 opus 高出十三个点,做命令行跑 agent 的 gpt 五点五会更加的优秀, 然后长上下文解锁 dbc, 竟然跑到了百分之八十三点五, opus 才三十二,差了一倍多,处理超长文档,显然 dbc 会更加的靠谱。 价格方面 deepsea 就 没什么对手了,输出每百万 token 才三点四八刀, gbt 五点五和 opus 分 别是三十和二十五刀,差了将近七倍,不得不说 deepsea 是 真的良心。当然了,榜单归榜单,实际用着怎么样还得看下面的实测。 好,那我们进入第一个案例,在这个场景中,我们先回归大模型最本质的使用方式,原声尺的对话框。虽然现在大家都在整 a 阵的自动化,但一个模型底层的逻辑素质和指令遵循到底行不行,尺的对话框还是能看出很多问题的。这边我把三家大模型的四号模式全都打开,并且都使用了最高的强度。 然后我的问题是提出一个我想做一个开源的笔记类 app 啊,对标 out 店这种本地优先的产品。在动手之前,我需要让三个模型帮我做一轮技术的选型调研。 那为什么会选择这个呢?首先第一步我让他去找资料,考验搜索和筛选能力。第二步是读代码读文档,考验技术理解的深度。第三步啊,则是去看产品,考验抽象和归纳能力。第四步则是给建议考验综合判断和落地的能力。 可以看到这边三家已经跑完了,我们先来对比一下生成的速度。首先最开始输出回答的是 deepsea 啊,接下来是 cloud, 最后是 gpt, 然后输出的内容最长的是 cloud code 啊。然后为了保证客观的公平性,我这边直接把三份三个模型输出的呃大模型的回答整理成三个文件,分别交给 gmail 和千文来进行一个分析。 先看一下杰米兰的回答,他这边选择的是模型币啊,因为他认为作为一个独立开发者,模型币的整体表现会更像是资深的架构师,而不是仅仅的是信息的搬运工。那模型币对应的就是科奥的 opus 四点七, 那 gpt 和 dpc 的 话,他会认为 gpt 的 表现更加优秀。呃, dpc 更多的是信息的一个搬运,并没有站在一个工程化运维的角度去看待问题。 接着我们再看一下千问啊,那他这边的答案跟 gmail 几乎是差不多的,他也认为是文件 b 对 应的 cloud opus 四点七写的是最好,其次是 gbt 五点五,最后是 deepsea 维斯的 pro。 第二个案例,我这边让三家大模型分别帮我实现一个类似杀入监塔的回合制卡牌游戏。这边 gbt 五点五用的是 codex, office 四点七,和 dbc 比四 pro 用的都是 cloud code 的, 可以看到这边三张模型都已经跑完了,跑的最快的是 office 四点七,用了一分半,接着是 codex 花了六分钟, dbc 则是用到了十五分钟。但我觉得这也是情有可原的,毕竟 dbc 的 价格摆在这边,使用的人是非常多的, 所以也会出现一些限速的情况。那接下来我们看一下三个游戏制作的一个效果是怎么样的。我们先看一下 gpt 五点五啊, 可以看到就是 gpt 还是一如既往的,他的这个前端的风格一直都不是特别好,然后做的这个虽然是游戏,但是看上去还是以前端的那种样式啊,用一种网站的那种方式来做的,然后整体的交互应该是都没什么问题啊,攻击重击, 每回合都能回复能量,所以说基本上都能够啊,打出所有的牌。好吧,这个是 codex 加上 gpt 五点五的。接下来我们看一下 cloud code 加上 opus 四点七啊,可以看到它整个页面的一个样式,相较于 gpt 五点五 啊,是要更像游戏一点啊。然后他整个的风格有点偏啊,像那个三国杀,对吧?然后我们来试验一下,我来尝试一下他这个攻击,然后结束回合。我这边量,哎,这个为什么是智慧的结束回合?敌方回合啊,我这边有三点的呢,哎,为什么是灰的 哦,但是我还能点哦,可以看到他这边是有一个显示的 bug, 就是 我虽然结束回合了啊,敌方回合结束之后,我这边能量是回满了,但是我这边前端的样式看上去还是不能点的。好吧,这个算是有一个小的 bug, 然后我们再看一下 cloud 加上 dbc v 四 pro 的 一个效果啊,可以看到它整个页面的风格跟前两个完全不一样的,它做的是偏手机端的,我们来试一下啊,然后它这个动画效果是做的比较好的,有一个高亮的一个提醒结束回合, 哎,我这怎么点不了了?再刷新一下结束回合, ok。 他 这个是有一个呃,比较严重的逻辑上的 bug, 就是 我打完之后我就不能再点下一个了,但是我如果不打牌,我直接点结束回合,我是能够一直点 的,是吧?可以看到有这个 bug 啊,然后这边结束了,敌方也对我造成攻击的,呃,新的回合,然后我是什么都点不了的。 接下来第三个案例,我让三家大模型扮演资深的供应链架构师,挑战一个综合的实战任务,涉及二零二六版全球自动化决策系统,他们需要同时处理欧盟碳关税的合规和苏伊世运河的罢工重油问题。 可以看到这边三家大模型都已经跑完了,那由于是文档的内容居多,我们还是让 jamie 来作为裁判评判一下。这边 jamie 已经跑完了,我们来看一下,先看最终的结果, jamie 认为第一名是模型 c, 也就是我们的 deepsea, 他 有说到这是一本可以直接交给 cto 的 方案,他不仅完成了任务,还在每一个环节都展现了深厚的行业洞察。 那表现最差的是 codex, 然后它的整个分析还是比较详细的,分别从呃合规于政策的分析,再从逻辑算法的建模,再到最后的系统架构和 a 智能的一个设计,都是呃 dbisc 会表现的更加突出,说明 dbisc 现在的一个综合能力已经是非常的强了。 ok, 这边三个案例都已经跑完了,我们来做个总结。首先三个模型在各自擅长的领域上确实表现很突出, 如果你要做深度调研,或者说选技术路线, oppo 的 四点七更好,如果是代码生成和稳定的实现,则可以选择 g p t 五点五。 如果你是常文本,需要做系统设计或者说企业的架构, deepsea v 四 pro 是 一个不错的选择,而且现在 deepsea 的 价格真的太香了。行,那本期的视频就到这,希望能帮大家在模型的选择上面提供一些帮助。我是布鲁,我们下期视频再见。
5319布鲁404 01:45查看AI文稿AI文稿
小米正在快速成为世界第一,今天是迷魔大模型降价第三天,他已经冲到了奥本如的排行榜的第七位,世界第七。最新一天的世界第七位是非常强的一个成绩,因为他之前已经完全掉出世界前二十了,在世界前二十里面看都看不到他,但他仅仅通过降价就重新回到了世界第七, 而且随着时间推移,我相信他很快可能在这周之内就重新登顶世界第一都有可能,但不仅即便不是世界第一,也会进入世界前三。我觉得他因为他效果,在同样的价格下,他是比这个 davidson 要更强一点的。 davidson 为四, 但很奇怪的是, davidson 的 四维斯 black 还能排在世界第二,那小米的 v 二点五居然根本就看不到他的痕迹。我都不知道为什么, 为什么会有这么多人用这个 v 四 flash, 居然就不用小米的 v 二点五呢? v 二点五的 flash, 或者它不叫 flash, 它也叫,就叫普通的 v 二点五。现在小米的活跃程度到了什么程度呢? 我现在配了在这个 oppo 扣的里面。配了这个小米的米某之后,我发现哪怕现在大半夜的它都调不通,但这可能小米的服务器有问题,也有可能是掉太多了,但它它都没有显示四二九二,直接显示了异常终止。 比如他在十七分的时候,本来现在在十二分的时候到十七分五分钟时间,他居然一一个回复都没有,到,最终他就被莫名其妙被扣的终止掉了。只能说现在小米确实用起来了,但有的人会觉得小米的这个被用了这么多,他可能信用卡会不够,其实根本就不用担心 小米,他不仅买了很多因为他的卡,而且他还投资了摩尔县城,摩尔县城他是有很多这种大规模的战机群,是可以对标菊花的征程九五零的,所以在性能上、在算力上是有保障的,是没问题的。只能说希望小米赶紧建设吧,不要再出现这种问题了。
664教你宇宙级AI编程 03:13查看AI文稿AI文稿
deepsea 的 官网最近出了一个关于 a p i 降价的新闻,说法也很有意思,说原定于二零二五年五月三十一日的二点五折的折扣优惠之后,正式调整为原定价的四分之一,用户可能还要思考一秒钟, 实际上意思呢,就是把原来的折扣价变成了永久定价,这个价格有多夸张呢?就目前的 deepsea, 我 们就看 oppo token 啊,输出的 token 成本,因为输入成本跟 cash hit 基本上都是这里面的一个比例。 oppo token 呢,是所有的模型公司的一个成本的衡量数字。那目前 deepsea v 四的 pro 呢,是零点八七,对比预参价,比如 g p t 五点五, oppo 四点七, jimmy 三点一,这三 增加幅面是三十美元,二十五美元和十二美元有接近五十倍的差别。即使到国内的大模型,按说通过来看, mini max 一 点二, kimi 三美元,小米 mimo 应该四美元左右,也是国内的这些以性价比为优势的模型的三分之二,四分之一和五 分之一。所以 deepsea v 四 pro 这样的一个一点六 t 的 模型价格能拉到这么低,对很多人来说都是奇迹。国内的很多用户说呢,是对学生党很友好,良甚大才。美国的一些用户呢,也非常的惊奇。知名博主与陈京发现, deepsea 词降价背后的两种可能性,要么是在虚拟优化上取得了重大突破,要么是华为的芯片成本比英伟达低很多。 在我看来,这两种可能性貌似都很难实现。目前的华为的镜片想超英伟达还需要一点距离,尤其是量产层面。而推理层面呢,我们也做过很多尝试,但是想把推理成本从目前市场成本的五倍降到现在的五分之一,目前看是一个短期无法实现的事情,无论 d p c 有 多大的技术的突破。 所以呢,我觉得这背后的更合理的解释呢,就像梁文峰本人在与头层洽谈中表达的,公司呢,将把突破性 ai 研究至于短期商业化之前,并以实现 agi 为最终目标。所以呢,梁文峰的逻辑呢,就是他是希望更快的于 open ai 和 anthropic 可以直接竞争,而更早更大规模的实现 agi, 那 对他来说成本优势就是一个巨大的实现垄断的一个手段。所以呢,目前来看的话,以我们对于一点六 t 的 模型和英伟达显卡的一切的调研和部署成本来看的话,目前 deepsea 给出价格 基本上只能覆盖他的电影成本,那他的显卡的成本很有可能是已经在过去的收益中回本,或者呢,就是得到一些补贴,如果电影成本也可以得到补贴的话,那他可能还是有些微利的。但是目前按照这样的模型参数呢,是沿 deepsea 这样报价的,几乎不可能。另外一个大逻辑呢,就是 deepsea 作为一家万方量化孵化出来的子公司,是不缺钱的, 无论是杨文峰在万方的收益,还是本轮按照一百亿美元的规模完成这份融资, deepsea 呢,目前看是不缺钱,这个对于市场上有什么影响呢? 我觉得 deepsea 的 目前所到之处,其他的玩家想进来了,基本上是寸草不生的,原因就是在一个一点六 t 的 规模的 pro 模型,有两百八十多 b 的 flash 模型。目前 deepsea 能覆盖的这个规模呢,已经差不多从一百 b 到三 t 之间。因为它的性能,它的报价,它的性价比,基本上呢是可以覆盖这个领域的所有的模型, 有它的能力的模型呢,报价会比它高很多很多,模型呢,比它贵的目前性能呢,都还不如它。再加上智能融资的话, deepsea 会不断地持续地优化它的 coding 和 ad 能力。 其实这次放出来 d p c。 还在招聘 harness 产品经理,我想应该是从模型到 coding harness, 对 标 cloud code 和 codas 的 coding harness 已经在全面的准备了。那未来呢,我们 d p c 很 有可能成为国内最有机会去对抗 open i 和 adopter 的 公司,因为它的模型在它的参数量,领域的制霸能力,以及它的下一步 对于 harness 的 认知和开展。再加上这一轮融资,很有可能让 d p c。 成为全球前三,也是中国唯一的一家最早成立 a g i 的 公司。很有可能让 d p c。 成为全球前三,也是中国唯一的一家最早成立的子公司。很有可能让 d p c。 成为全球前 a, 成为全球的公司。
332杨博士说AI 02:09查看AI文稿AI文稿
呃, deepsea 微四今天上架了专家模式,在网页端和 app 端都可以看得到,然后很多人说这个专家模式非常屌,就是脚踢 gpt, 拳打 cloud, 所以 我就好奇试了一下,然后我发现跑出来的结果可能没我想象中的那么好。 当然很多人会说,这个 deepsea v 四本来是在会度测试啊,然后那他跑了这个 svg 图,我觉得 svg 图它是没办法跑,比得过这个 gpt 还有 java 的 svg 图的。就是我简单的试了一下,呃,包括简单的提示词,复杂的提示词我都试了。 然后另外我想说的就是,截止今天,我不知道梁文峰会不会后悔,因为国内的开源大模型 mini max, 智谱,包括将来要上市的 kimi, 包括今月星辰,他们的有些市值已经上千亿了,对吧?大家也看到这个 mini max 和智谱。 呃,如果 deepsea 当时选择做成一个上市公司,我不知道会不会更好,它能不能享受到更多的资源,然后 deepsea 会不会进步的更快? 但显然我觉得如果 deepsea 没有商业化,可能会有一些资源没有那么好。 呃,也可能。当然我我不否认梁文峰是一个纯粹的人,我只是今天在想,如果 deepsea 商业化,会不会他做的会更好,或者是他的技术会更强? 呃,这都是不可而知的嘛,因为今天大家都知道 mini max。 呃,这个质朴,包括那个几月星辰,包括阿力的千问,再包括各家很多的模型,包括小米的 mimo, 对 吧?呃,包括 mimo 那 个主要的负责人罗浮丽也是从这个 deepsea 跳槽到小米的。 如果,假设,假设,可能这个 deepsea 商业化了,然后能给到这种研究人员更好的薪酬,会不会 deepsea 今天会不一样?或者是 deepsea 微四今天会不一样?嗯,可能会更好吧。就是我的一种假设嘛。
483MindPeak 01:00查看AI文稿AI文稿
big c v s pro 很 香对吧?但你不装 skills, 相当于买了台法拉利,只开市区,还没上过高速。我最近把全网翻了个遍,删了三十多个 skills 网站,最后能用的就三个。第一个,全网最大的 skills 仓库,一百五十二万个开源 skills 什么概念?你脑子里能想到的需求它全有,但大归大, 问题是质量参差不齐。上次我找个翻译 skill, 试了五个才找到能用的。适合什么人,你知道自己要什么,愿意自己挑,自己试的来。这就对了,不适合什么人,想即装即用,不想折腾的往下看。第二个, skill store 精品店,这个不一样, 里面的 skills 都经过审核,安装流程规范,不用担心踩雷,数量没那么多,但每个都能用。我最近几个主力 skills 全是从这装的。第三个 排行榜网站纯抄作业专用。你要是不知道装什么好,别纠结,直接上来看榜单,热度排序,质量评分,用户评价全列好了,我每周上来扫一眼榜单,看到感兴趣的直接装。最适合什么时候用,没想法的时候上来溜一圈,灵 感就有了。视频配套 skills 都准备好了,可以看一下,挑一个装上再走,不然明天又忘了二零二六年让 skills 给你打工。
3721唐宇迪AI入门课 03:44查看AI文稿AI文稿
前两天大家还在津津有味的吃着蒜粒互掐的大瓜, deepsea v 四前脚宣布自己降价至四分之一小米,米某反手直降百分之九十九直接掀桌。不玩了,觉得这不过是科技巨头们为了抢地盘在疯狂撒钱做慈善,普通人只要疯狂薅羊毛看乐子就行。 但当你还在跟着起哄的时候,残酷的真相是,有人在深夜扯下了这场降价繁荣背后的绝密遮羞布。 看完直接让我后背发凉,惊出一身冷汗。我在这段爆料里看到的根本不是什么技术普惠的乌托邦,而是一个正在疯狂吞食财富的算力黑洞。奥特曼黄仁勋这帮硅谷狂人到处给人洗脑,说未来的世界是属于智能体特工的,他们画的饼示未来每个人背后都有几百个 ai 特工在云端 二十四小时帮你全天候打工。而那帮网红为了制造焦虑,甚至拿出一张三十天疯狂烧掉一百三十万美元,吞食了整整六百三十亿个瓷元的极端账单到处炫耀。他们告诉你,月耗百亿代币是未来标配, 否则就活该沦为永久底层。 after being teased for nearly two months about the deep sea v for release the whale has finally dropped it the fourth generation of deepseek, and they never cease to amaze me alongside the two models they release, which are deep cv, four pro and flash they oh but。 当你理性的扒开这层营销外衣,你会发现,这所谓的带币乌托邦,在物理层面上根本就是一个天大的伪命题。模型的无限降价并不能抹去算力背后的能源死穴。 有人在视频里一针见血地指出,如果全人类真的按照巨头勾勒的蓝图去过上,人人拥有几百个特工,随时随地无限调用带币的生活, 地球现有的总发电量恐怕得活活翻上十倍,而且这些电必须全部拿去喂给 gpu。 在 能源和芯片潜能的双重绞杀下, 这帮巨头的疯狂宏大蓄势,不过是把人类绑在了一台无法落地的空中楼阁上。 this is all thanks to their new attention mechanism csa which is short for compressed sparse attention and hca short for heavily compressed attention let's talk about csa first in the stereotypical attention the kiwi cash grows one entry per token so if you have one million token。 更让人头皮发麻的是, 这种盲目的算力崇拜,正把职场变成一个扭曲的赛博牢笼。回想短短十八个月前,你作为一个普通员工,想要申请换个三十二级卡的内存,或者换一把办公椅,高管们还要层层卡审批,多花五十美元都像要了公司的命。可现在,高层被特工时代洗脑, 强迫大家在完全不顾及成本的情况下盲目去堆砌特工数量。但是这场狂欢很快就会到头。当老板们月底看到百万美元的磁源账单,却发现公司业务没有质的飞跃时,星算就会瞬间降临。到时候,一类全新的拿着审计表开除员工的 带比效率教练将接管职场,对每一个不够精省的肉体打工人进行降维打击,真正的职场屠杀才刚刚开始。 for the general structure of deep cv 4 series the models are interlinked with these two attention mechanisms at a one to one ratio however, an additional sliding window attention branch is added to both csa and hca because as the model is trying to predict the next token, the most recent few。 在 这场由盲目消耗走向冷酷清算的算力饥饿游戏里, 我想问你一个极具争议性的二选一灵魂拷问。一是你甘愿继续被巨头的洪大旭士洗脑, 在职场里盲目堆砌 ai 去迎合高层的焦虑,最终在带币效率的审计大清算中沦为被清洗的肉体傀儡。 二是你宁愿现在就看穿这个骗局,把精力死死盯在提升架构和算法的带币效率上,用真正的理性去捍卫专业工程师的底线尊严。这里是 ai 风向标,关注我,下期带你硬啃更多这帮硅谷狂人不敢告诉你的顶级内幕!
466Ai风向标 01:02查看AI文稿AI文稿
兄弟们,在 debecic vise 发布之后,这个事情在外面炸了。 debecex 团队,他们弄了几十页的技术报告,第一句直接说我们目前落后最前沿的闭缘模型,三到六个月。 你品一下这个操作,黑眼圈哪个不上来直接说自己无敌了,跑分怎么样怎么样对吧?嘴上没有一个认怂的,只有 dipsec 自己写论文承认我比别人慢半拍,那这三到六个月的差距真的是落后吗?仔细想一想,其实这三到六个月, dipsic 去干了什么呢?是全面适配的国产硬件 对吧?升腾九五零汉武纪摩尔现成芭蕉国产芯片发布,同一天,低龄适配,如果没有这三到六个月,你以为这芭蕉能同时接得住吗?这也就是广机良的思路对吧?我表面认怂,实际让对手降低了警惕,我承认没有你强。更狠的是,同一天, d bc 给 ai 装了根赛博手指,让我们 模型一边推理一边指向画面里的具体位置。迷宫导航测试,拿开源最强成绩单,这也是我们 ai 最聪明的玩法,回头上来喊我赢了还是先认怂,亮出底牌,让对面降低警惕性。
714奇大可 03:47查看AI文稿AI文稿
哎,今天这个视频只讲一件事情,国产模型和海外模型的差异到今天还大吗? 随着 dips pro 和小米尼莫二点五 pro 的 发布啊,前段时间 g p t 五点五和 wops 四点七也刚刚更新,国内代言模型的对比逐渐白热化。今天我们就用同一个任务来直观的来看,它们的之间到底还大吗? 大家好,我是 fred 啊,一个纯小白,学习 web coding, 帮助自己和团队提升了百分之五十以上,我希望将我过往踩过的坑全部分享给你。 ok, 我 们今天打开了四个模型啊,第一个是咪某二点五 pro, 第二个是 gpt 五点五,第三个是 dpc v 四 pro 啊,最后一个是 gm 五点一,我给他们同一个任务,就是帮我生成一个麦肯西风格的 html, 然后命名为对应模型啊,麦肯西, 然后他们花了不同的时间,最后生出了这五个不同的 html, 我 们来一起看一看。首先是小米的,哎, 整体小米的整个的好像还蛮符合小米他自己的一个风格哈,虽然说是看起来是迈腾七风格,但跟小米自己的风格还蛮蛮像的。这里面有索特的分析啊,战略的优先级 以及实施的线路图,包括风险的分析以及最后的行动建议啊。我觉得整体小米做的这一份还蛮不错的,包括大家看最后的结论,很像小米那个那种发布会的那种感觉哈,我觉得小米这深层的我自己能打个八十分吧。 ok, 然后我们再来看啊,智普五点一生成的这样一个前端界面,好像一眼看起来就会有些差异哈,然后这高管在药行业的格局, ok, 数字化的转型啊,关键风险的矩阵 以及优信奇。好吧,智普的这个我觉得跟小米的从纯从审美和 ui 前端上面来看,包括内容丰富度上面,我觉得还是会有些差异,如果打分的话,可能能给到个七十分吧。 ok, 我 们来看 deepseek, ok, deepseek 这个就有一点 ai 了哈,就感觉还是上一个版本的 ui 的 那种风格,不知道是我自己设置的有问题还是怎么样啊。这里也是精准格局的对比,然后加了一些 icon 的 东西,你看,其实智普和小米是没有加的, 因为常规的那四种 mac 七风格是肯定不会加这种 icon 的 嘛,对吧?啊?不确定,跟风险, ok, 我 觉得 deep six 这个怎么说呢?嗯,六十分吧。 ok, 我 们来就看 codex 这个,好吧,大家一看 codex 这种状态就还是 能够看到,就很明显是那种麦肯锡的专业报告的风格,毕竟还是海外的模型,可能在这部分训练还是会相对好一些。 ok, 但是内容相对会少一些,如果要打分的话,我觉得可能同样也是个八十分吧。 我们可以再跟小米的这个去做一个对比,我觉得整体风格不一样,但小米的内容丰富度包括 ui 啊,整体我觉得还是蛮不错的, 所以说我们可以看见在同一个任务下思考的时间可能有有所差异,但是也差不多,最终输出的效果,好像在最新的内饰质朴,包括小米输出结果跟 codex 也不会有太大差异,至少在深层看板这一块啊, 这就是我今天的分享啊,如果大家有任何的想法啊,或者说不一样的意见也可以,欢迎在欢迎在评论区里面去留言,这就是本期的内容,我们下期再见。
133FredTalk 01:29查看AI文稿AI文稿
哇,这个 deepsea v 四 pro 实在是太强了,我真的强烈推荐你们用,我给你们演示一下子。我们用 v 四来启动一个 ai 系统,启动中,正在进行自检,正在检查热点面板。 你们看,他调出了一个全球热点追踪系统,你们看这个过程完全没有加速,反应很快,而且所有的操作都是正常,没有报错。启动之后他一直在检查,在质检他的系统, 还能够打开视频。最近发现一个好玩的,国外的小博制作的一个专属资讯,他刚刚在检查他的视频模式,然后检查完之后他就关闭了。可以看到右上角这里他显示都已经检查通过了。我们来看看他到底能干些什么。你看看今天的抖音热点,看看有哪些好玩的。 抖音今天重头戏基本是硬新闻,轻松一点的有个尼克斯三比零骑士, nba 季后赛尼克斯横扫骑士,还有个男生变帅简直易如反掌。大概是穿搭改造类的内容, 要说好玩的话,就这俩还算轻松。要不要我把那个变帅的视频拉出来看看?关掉吧。 嗯,你找一个小樱说关于伊朗经济的视频。 嗨,来,朋友们,今天我们来聊一个神秘而又混乱的经济体。你老了。
2.9万远远Faraway 00:36查看AI文稿AI文稿
今天一早上我就看到了 mimo v 二点五系列模型开启的永久降价那而且有意思的是,它降完之后,那价格基本上就跟 deepsea 的 模型价格保持一致了。那因为就我个人体验来说,那 mimo v 二点五对比 deepsea v 四,那单论模型能力的话,两者其实并没有拉开特别大的差距, 那 mimo 唯一的优势也就是比 deepsea 多了多摩态的能力。那但 deepsea 降价之后,那这个价格就被定下来了,那会无形中逼着国内其他模型厂商跟着他这个价格走,那除非你们的模型能够比我强,而且还要强很多。 那从这个角度来看, deepsea 不 愧是国内大模型行业的价格屠夫,那国内公司做模型那也是真的卷。
13天真的AI世界 06:06查看AI文稿AI文稿
五月二十三号, deepseek 宣布 v 四 pro 永久降价百分之七十五。四天后,五月二十七号,小米 mimo v 二点五也宣布永久降价,最高降幅百分之九十九。 看数字好像小米降得更狠,但你把两家新的价格表放一起, mimo 杠 v 二点五 pro 输入三块,输出六块,缓存命中零点零二五元,一分不差。这不是各降各的,这是照着抄的。 再往前翻,四月二十五号, deepsea v 四发布当晚宣布二点五折促销,四月二十六号,追加缓存命中,降到原价十分之一。而四月二十三号,比 deepsea 还早两天,小米就推了一百万亿 token 免费计划,每次都是一前一后,节奏稳得像排练过。 这就很怪了,正常竞争是啥样? a 降价, b 得观望,算完账再决定跟不跟,跟多少。但小米每次四十八小时内就跟上,而且不是我比你还低那种抢客打法,是我跟你一样的对齐打法。降百分之九十九听着吓人,但那是跟自己原价比的。 原价本来就虚高,降到跟 deepsea 一个水位才叫真实定价。这背后有个人叫罗弗利。九五后, deepsea's 前核心研究员。二零二五年十一月,雷军以千万年薪把他挖到小米做 mimo 大 模型负责人。 他从 deepsea 出来,带了整套体系的理解,怎么调 moore 架构怎么定价格策略,怎么抢开发者心智他全知道。三月份有个事特别能说明问题, mimo 匿名上架 openroute, 代号 hunter alpha 社区猜了一周都以为是 deepsea v 四,结果揭晓是小米。两个模型像到连行家都分不清,因为这是同一个人带队,用同一条技术路径做出来的。这就解释了为什么两家节奏这么同步, 不是商量好的,是同一个人在两个时间点做了同样的判断。罗弗利太了解 deepsea 的 决策逻辑了,知道他们的成本底线在哪,什么时候会动,价格动到什么水位。所以 deepsea 一 出牌,小米不需要犹豫,直接跟到同一个位置。但最魔幻的反转来了, 罗富利之前公开怼过行业价格战,在 x 上发了一堆话,大意是恶性降价,不利于行业健康发展。嘴上说不要,身体比谁都诚实。先是一百万亿 token 免费冲到 hermes, 全球掉用量第一,现在又永久降价百分之九十九。 道理其实也简单,他怼的是无序价格战,他打的是有节奏的价格战,完全不是一回事儿。那这两家到底是敌是友? 我的判断是,表面竞争,深层默契,合力清场。先说默契,如果只有 deepsea 一 家降价,其他厂商可以观望,可以说我们拼能力不拼价格,市场就是分裂的。但如果 deepsea 降完,小米立刻跟,而且价格一模一样,这就形成了一个价格毛, 其他家的选择就被压缩了,要么跟到这个价位,那是赔钱卖,要么涨价保利润,那是把市场让出去,怎么选都不舒服。 你看现在行业已经 k 型分化了,降价派是 deepsea 和小米,背后一个是不盈利的策略型公司,一个是手机汽车 i o t 生态大厂,都不靠 api 赚钱。 涨价派是智普 q, 一 涨百分之八十三,阿里砍低价订金 plan 套餐,字节下价低价套餐,它们要么追求正向利润,要么收缩战线保现金流。 最讽刺的是,智普涨了百分之八十三之后,掉用量还增长了百分之四百,这说明什么?市场已经分层了, 通用任务卷价格,复杂任务卷能力。 deepsea 和小米抢的是量大管饱的基础市场,智普守的是贵但靠谱的高端市场,两条赛道可以共存,但中间地带会被挤死。那些既没有生态补贴能力,又没有高端模型护城河的中间厂商,才是这轮价格战真正的炮灰。 那 deep seek 和小米自己呢?小米 q 一 利润暴跌百分之四十三,三年还要投六百亿进 ai? deep seek 本身就是烧钱换规模。两家都在赌一件事, m o e 架构的推理效率能持续提升,把边际成本压到足够低,低到这个价格也能跑得动。小米说他们优化了 kvcash, 数据搬运量降到七分之一,可缓存 token 量提升五倍。 deepsea 的 mo 亿架构也是同样的逻辑,万亿级总参数只激活一小部分,推理时候真正在算的只是零头。架构优势给了它们降价的底气, 但底气归底气,这个烧法能不能持久是另一个问题。小米 q 一 营收九百九十一亿,同比降百分之十点九,一边利润暴跌一边降价,这是拿现金换规模。 deep sec 更狠,压根没想着在 api 上赚钱,要的是开发者和数据飞轮 两家都在用同一个逻辑,先把开发者圈进来,用量养能力,等模型拉开差距再谈利润。所以回到那个问题,是敌是友?他们既不是传统意义上的竞争对手,不会把对方往死里打, 也不是盟友,没有坐下来商量过价格。他们是同一套打法,同一个决策者,在不同公司的投影,形成了一种可控竞争。 对 deepsea 来说,小米的存在是好事,有个价格跟自己一样的玩家,价格毛就更稳固,其他家更难不跟。对小米来说,跟着 deepsea 定价,省去了试探市场的成本,直接站在已经验证过的价格带上。 而对其他所有大模型厂商来说,这两家就是一道封印,不是封死你,是封死了低价这条路的定价权。你想降价?不好意思,地板价已经有人定了,你想涨价可以,但你得证明自己值。那个价。 质谱证明了值涨百分之八十三,还能增长百分之四百,那其他家呢?能证明吗?这才是这轮同步降价真正值得琢磨的地方。 不是百分之九十九这个数字吓人,是两家一起把 ai 的 api 该卖多少钱这个问题的答案给锁死了。以后所有玩家定价,都得先看看这两家的价格表,再决定自己站哪边。这场游戏从今天起,已经不是谁想怎么玩就怎么玩了。
70改命奇悟 00:47查看AI文稿AI文稿
前两天 deepsea 在 官方平台宣布一条消息,外网这次真的坐不住了,原来是搞活动到五月三十一号的二点五折,现在变成了永久的正式价。想当初 deepsea 是 只花了三百万美元就训练出来的模型,而 chat gpt 花费了八百万至一个亿, 东方神秘力量暴打华尔街,国内全免费使用,逼的 chat gpt 原本两百美元一个月的费用干到了免费,国产 ai 一 出场就是人民的 ai 啊!现在 deepsea v 四又来一波永久打折,直接把电费他在告诉全世界, 中国的算力价格就这个价!你以为这是降价内卷,其实不是,他这么疯狂降价还赚钱的原因藏在他的 m v 架构里面,这个结构极大降低了训练推理的成本。中国大模型周掉用量已经连续四周超过美国,并稳居全球首位。国产 ai 把曾经外流的赔款全捞回这集你知道我等了多久吗?
530月儿看世界